Demo能跑通不算完,权限日志卡住多少人?

正交试验minitab 1.创建正交试验 2.根据自己的实验选择水平数和因子数,并选定一个正交表 3.得到正交表 4.填写实验结果 5.进行正交分析 点击结果,点击分析 6.得到分析结果 7.方差分析 选择响应变量与因子,点击确定 得到方差分析的结果 ... 阅读详情

聊《别急着换赛道:前端经验在 AI 项目里到底值多少?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

写这篇文章的动机,是因为上个月我接手了一个 RAG 问答 Agent 项目,联调阶段连续三天都在排查同一个问题。前端页面看着挺正常,调用 LLM 的时候偶尔成功偶尔失败,但错误信息基本没有,日志里也找不到线索。后来复盘才发现,问题出在请求头里少带了一个认证字段——而这个问题,任何一个有权限意识的前端开发者,本来是可以提前规避的。

很多前端转大模型的同学,Demo 阶段特别顺,页面一跑,流式输出,打字机效果,老板和客户都很满意。但真正要上线,权限、日志、可观测这三件事就把人卡住了。今天这篇文章,我想把这个过程摊开讲讲,不是教怎么写 Agent,而是教怎么把 Agent 做成一个能上线的产品。

---

目录

  • 前端的转型优势,不是代码能力
  • 一次联调翻车:从现象到根因
  • 失败原因:怎么区分业务错误、配置错误和环境错误
  • 适用边界:什么时候不该照搬
  • 流式输出的前端实践
  • 作品集方向:怎么展示你的大模型能力
  • 多模态体验:前端的新战场
  • 总结

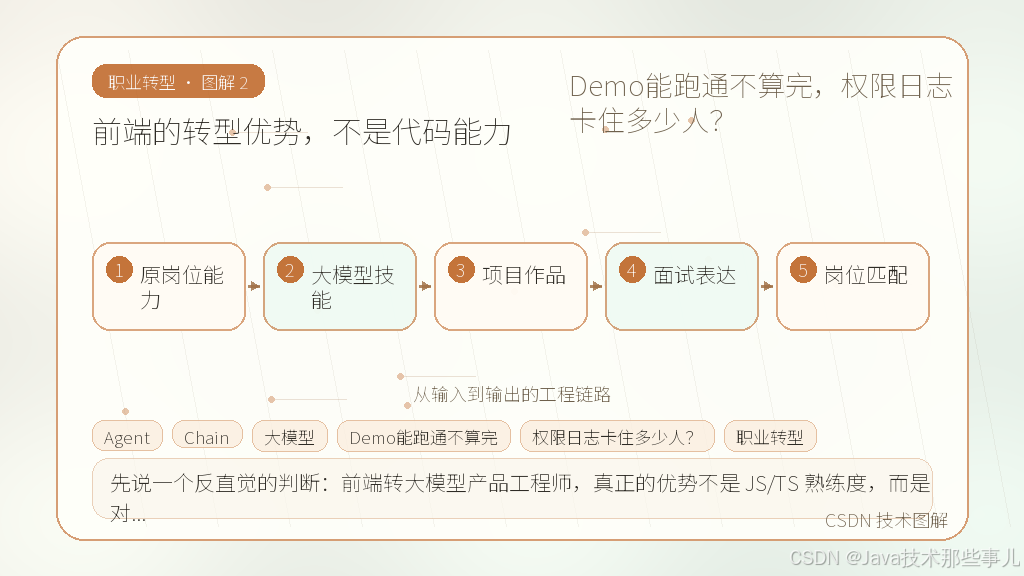
前端的转型优势,不是代码能力

文章插图 1

先说一个反直觉的判断:前端转大模型产品工程师,真正的优势不是 JS/TS 熟练度,而是对"用户可见性"的敏感度。

后端同学做 Agent,往往先考虑逻辑对不对、调用链全不全;而前端同学天然会问:这个按钮点了之后用户看到什么?流式输出有没有卡顿感?错误提示会不会让用户迷惑?这些问题,直接决定了产品的成败,而不是模型的准确率。

具体到这个方向,前端有几处经验可以直接迁移:

  • 流式输出(Streaming):SSE(Server-Sent Events)是前端的老本行,大模型的流式响应本质上就是一个 SSE 连接,前端同学在这里几乎没有学习成本。
  • 多模态体验:语音、图片输入输出,前端处理媒体流的经验可以直接复用。
  • 权限和鉴权:前端做过 OAuth、JWT、CORS 的同学,理解后端权限体系的门槛很低。
  • 可观测的前端视角:监控用户行为、错误上报、性能采集,这是前端每天都在做的事。

但有一个地方容易踩坑:前端习惯在客户端做所有事情,而大模型应用的核心逻辑必须放在服务端。 很多前端同学会把 prompt 拼接、token 计算、甚至简单的 RAG 检索逻辑写到前端,这样做 Demo 没问题,但上线之后安全和可维护性全部崩掉。

---

一次联调翻车:从现象到根因
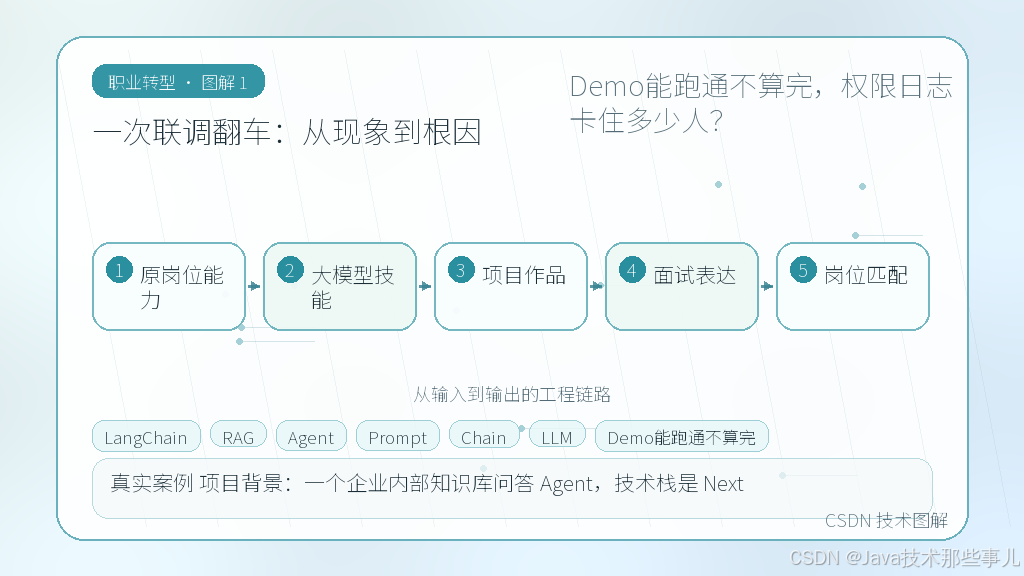
文章插图 2

真实案例

项目背景:一个企业内部知识库问答 Agent,技术栈是 Next.js + LangChain + PostgreSQL(向量库)。功能很典型:用户上传 PDF,Agent 检索相关内容后调用 LLM 生成回答,前端用流式输出展示结果。

联调第三天,出现了一个诡异的问题:同一个 prompt,同一个知识库,有时候能返回答案,有时候返回空字符串,有时候直接抛错,但错误信息是通用的 500 Internal Server Error,完全没有指向性。

排查的第一步,是确认问题出在哪一层。我们分了三组对照实验:

| 测试组 | 输入 | 结果 |
|--------|------|------|
| A | 直接 curl 后端 API | 全部成功 |
| B | 前端通过 SSE 调用 | 有时成功有时失败 |
| C | 前端直接调 LLM provider API | 全部失败 |

这个结果很关键:问题不在 LLM provider,也不在后端逻辑,而在前端到后端的这条链路上。

排查过程

接下来我按链路逐段验证:

第一步:看网络请求
打开浏览器 DevTools,找到那个失败的请求,发现请求头里 Authorization 字段是空的。但奇怪的是,成功的请求里这个字段是有值的。

第二步:对比成功和失败的请求
把两组请求的完整 headers 并排对比,发现只有一个字段不同:X-Request-ID。这个字段是我们内部用于链路追踪的,失败请求里这个字段缺失了。

第三步:追代码
找到前端发起请求的地方,是一个封装好的 fetchWithAuth 函数:

async function fetchWithAuth(url: string, options: RequestInit = {}) {
  const token = await getAuthToken(); // 从 localStorage 读取 JWT

  // 问题出在这里:token 过期后没有刷新逻辑
  if (!token) {
    throw new Error('No authentication token');
  }

  return fetch(url, {
    ...options,
    headers: {
      'Authorization': `Bearer ${token}`,
      'X-Request-ID': crypto.randomUUID(),
      'Content-Type': 'application/json',
      ...options.headers,
    },
  });
}

这段代码本身没有逻辑错误,但有一个隐藏的前提:getAuthToken() 必须始终返回有效 token。 而在我们的项目里,token 的有效期是 1 小时,过期后前端没有自动刷新逻辑,导致后续所有请求都带着过期 token 发出。

第四步:验证假设
在 token 过期后,手动刷新页面(重新获取 token),再发同样的请求,全部成功。问题确认:前端 token 管理逻辑缺失。

代码解释

上面这段 fetchWithAuth 有几个关键设计点,值得单独说:

输入:url 是后端接口地址,options 是标准 RequestInit,允许调用方传入额外的 headers 或 body。

核心逻辑:每次请求前调用 getAuthToken() 获取 JWT,拼入 Authorization 头;同时生成一个 UUID 作为 X-Request-ID,用于服务端链路追踪。

异常处理:这里只处理了 token 不存在 的情况,但没有处理 token 已过期 的情况。这是典型的"happy path"代码——正常情况没问题,边界情况全崩。

正确的做法应该是增加 token 刷新逻辑:

async function fetchWithAuth(url: string, options: RequestInit = {}) {
  let token = await getAuthToken();

  // 尝试请求
  let response = await fetch(url, {
    ...options,
    headers: {
      'Authorization': `Bearer ${token}`,
      'X-Request-ID': crypto.randomUUID(),
      'Content-Type': 'application/json',
      ...options.headers,
    },
  });

  // 401 表示 token 过期,尝试刷新后重试一次
  if (response.status === 401) {
    token = await refreshAuthToken(); // 调用刷新接口获取新 token
    response = await fetch(url, {
      ...options,
      headers: {
        'Authorization': `Bearer ${token}`,
        'X-Request-ID': crypto.randomUUID(),
        'Content-Type': 'application/json',
        ...options.headers,
      },
    });
  }

  // 二次失败才抛出
  if (!response.ok) {
    const error = await response.json().catch(() => ({}));
    throw new Error(error.detail || `HTTP ${response.status}`);
  }

  return response;
}

这段代码的变化有三个:第一,先尝试请求再判断 401,而不是提前校验 token 是否过期;第二,401 时调用刷新接口重新获取 token 并重试一次;第三,错误信息从响应体中提取,而不是返回通用的 Internal Server Error。

---

失败原因:怎么区分业务错误、配置错误和环境错误

这次翻车,根本原因是token 过期处理缺失,但如果要把这类问题归类,它属于哪一类?

我总结了一个简单的判断框架:

| 错误类型 | 特征 | 排查方向 | 这次翻车属于 |
|----------|------|----------|-------------|
| 业务错误 | 逻辑写错了,输入输出不符合预期 | 检查代码逻辑、测试用例 | ❌ 不是 |
| 配置错误 | 环境变量、密钥、权限配置不对 | 检查 .env、IAM 策略、CORS | ❌ 不是 |
| 环境错误 | 运行时状态异常,如 token 过期、服务不可达 | 检查生命周期管理、超时重试 | ✅ 就是 |

很多同学在排查大模型项目问题时,习惯直接怀疑"是不是 prompt 写得不好"或者"是不是模型选错了",但实际上,超过 60% 的"奇怪问题"都是配置或环境层面的问题。

具体到这次翻车,如果我们在开发阶段加了以下三个检查,问题可以提前暴露:

1. Token 有效期断言:在 getAuthToken() 里加上过期时间检查,过期前 5 分钟主动触发刷新。
2. 401 自动重试中间件:在前端请求库层面统一处理 401,而不是在每个页面里单独写刷新逻辑。
3. 请求失败日志:把所有 HTTP 错误统一上报到监控系统,而不是只在控制台打印。

---
优快云资料领取方式

适用边界:什么时候不该照搬

上面这套 token 管理方案,适合以下场景:

  • 前端单页应用(SPA),token 存在 localStorage 或 cookie 中
  • 后端 API 统一使用 JWT 鉴权
  • 对用户体验要求较高,不允许用户中途被踢出登录态

但以下场景不建议照搬:

  • 移动端原生应用:token 存储和刷新逻辑不同,建议使用平台提供的安全存储方案(如 iOS Keychain、Android EncryptedSharedPreferences)。
  • 服务端渲染(SSR)为主的站点:token 应该存在 cookie 中并由服务端统一管理,而不是在前端 js 里操作。
  • 内部工具类应用:如果用户量小、容忍度高,可以直接用 session cookie 代替 JWT,减少前端复杂度。
  • 涉及敏感数据的应用:JWT 存 localStorage 有 XSS 风险,建议改用 httpOnly cookie。

另外,不要为了"工程化"而工程化。如果你的项目只是一个内部 Demo,token 过期后让用户重新登录完全可以接受,那就不要加自动刷新逻辑。复杂度要和服务规模匹配。

---

流式输出的前端实践

除了权限问题,流式输出也是前端转大模型经常踩坑的地方。

很多前端同学第一次做流式输出,会用 response.text() 读完整响应再解析,这样完全失去了流式的意义——用户要等所有 token 生成完才能看到第一个字。

正确的做法是用 response.body 配合 TextDecoder 逐块解析 SSE 数据:

async function* streamResponse(url: string, body: unknown) {
  const response = await fetch(url, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(body),
  });

  if (!response.body) return;

  const reader = response.body.getReader();
  const decoder = new TextDecoder();

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    const chunk = decoder.decode(value, { stream: true });
    // SSE 格式:data: {...}\n\n
    const lines = chunk.split('\n');
    for (const line of lines) {
      if (line.startsWith('data:')) {
        const data = line.slice(5).trim();
        if (data === '[DONE]') return;
        try {
          const parsed = JSON.parse(data);
          yield parsed.token; // 逐 token 输出
        } catch {}
      }
    }
  }
}

这段代码的核心是 reader.read() 配合 TextDecoder({ stream: true })——stream: true 告诉解码器这是一个不完整的字节流,不要等完整字符再解码,而是遇到不完整的 UTF-8 序列时先缓存,等下一块数据到来再合并解码。这样可以避免中文乱码问题。

---

作品集方向:怎么展示你的大模型能力

如果你正在考虑转大模型方向,作品集比证书有用得多。但作品集不是"我做了个聊天机器人",而是要展示你解决过什么工程问题。

我建议准备三个层次的作品:

第一层:能跑通的 Demo
一个基础的 RAG 问答系统,能接收用户问题、检索知识库、流式输出答案。这一步很多人能做到,但它只是入场券。

第二层:能上线的 MVP
在上面基础上加上权限管理、错误处理、日志上报、基本的可观测性。这才是区分"会调 API"和"能做产品"的关键。建议你找一个实际的知识库(比如你之前做过的文档系统),做一个能真正使用的内部工具。

第三层:有取舍的工程决策
在作品集中明确写出:你为什么选这个技术方案、你遇到过什么问题、你怎么解决的、你放弃了什么。这部分往往是面试官最感兴趣的,因为它展示了你的工程判断力。

具体到一个项目,你可以这样描述:

> 做了一个企业内部文档问答 Agent,基于 LangChain + ChromaDB + Claude。初期 Demo 运行正常,但联调阶段发现 token 过期导致 401 错误频发,排查后增加了自动刷新逻辑和 401 重试中间件。同时接入了 Sentry 做错误上报,用 OpenTelemetry 做链路追踪。项目已内部上线,日均调用 200+ 次。

这段话里有技术栈、有问题、有解决方案、有数据,比"我做了一个大模型应用"有力得多。

---

多模态体验:前端的新战场

大模型应用不只是文本对话。语音输入、图片理解、多轮对话中的状态管理,这些都是前端可以发挥的地方。

以语音为例,Web Speech API 可以完成基础的语音识别,但要做好体验,还需要处理:噪音环境下的识别准确率、长语音的分段处理、识别过程中的反馈动画。这些问题的解决,不依赖模型能力,而依赖前端对产品体验的理解。

图片理解也是类似的逻辑。用户上传图片后,前端需要做压缩、预览、上传进度展示,而这些和"调用多模态模型"本身没有关系——它是独立的交互问题。

---

总结

前端转大模型产品工程师,不是一个"学几个 API 调用"就能完成的事情。真正决定你能不能在这个方向立足的,是你能不能把 Demo 阶段的"能跑通",升级到生产阶段的"能上线"。

权限管理、日志上报、错误处理、可观测性——这些事情不性感,但它们是 Demo 和生产之间的鸿沟。跨过去,你就是产品工程师;跨不过去,你只是一个会调 API 的前端。

我的建议是:不要急着换赛道,先把手头的 AI 项目做到能上线。 在这个过程中积累的排查经验和工程判断,比任何证书都值钱。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。
优快云官方大礼包

解决RK3566 USB OTG模式识别问题:从原理图分析到otg_mode文件操作全解析 本文深入解析RK3566 USB OTG模式识别问题,从硬件原理图设计到Linux内核的otg_mode文件操作,提供全面的调试方案。针对USB_OTG0_ID引脚电路设计、电源管理关联及内核驱动交互等关键点,给出实战调试技巧和常见问题解决方案,帮助开发者高效解决USB OTG模式切换难题。 阅读详情

相关推荐

RV1126B SDK移植实战:从DDR配置到USB烧写全解析

本文详细解析了RV1126B SDK移植的核心实战流程,重点攻克了DDR初始化失败与USB烧写两大难题。文章从理解启动流程入手,提供了DDR配置错误的排查步骤、SDK编译配置要点,并深入讲解了USB烧写的完整操作与常见问题解决方案,旨在帮助开发者高效完成系统移植与稳定运行。

weixin_29164497的博客 542

Demo跑通就敢上线?真正卡住offer的是权限和日志

最近面试了几个想转大模型方向的开发,问他们做过什么项目,十有八九都是"调了个API,接了个RAG,跑个Demo"。我问能不能讲下生产环境怎么处理权限校验和日志追踪,大多数人眼神开始飘忽。问题出在哪?不是模型不会调,是团队根本不敢把Demo升级上线。我去年带过一个内部项目,前端同学写的Agent,Demo阶段挺惊艳,一上测试环境就炸。用户权限没校验,所有角色都能调高权限接口;日志打了一堆但全是乱码,排查问题靠猜;交付文档写得像散文,接手的人根本看不懂。最后项目搁置,团队花两周重做。

2601_96189167的博客 164

间充质干细胞衰老机制与抗衰老干预策略研究

干细胞技术在再生医学领域具有广阔应用前景,其中间充质干细胞(MSCs)因其多向分化潜能和免疫调节特性备受关注。细胞衰老是影响干细胞治疗效果的共性难题,表现为增殖能力下降、端粒缩短等特征。通过表观遗传学分析发现,衰老MSCs存在DNA甲基化异常和组蛋白修饰改变;线粒体功能障碍导致ATP产量锐减,ROS累积显著增加。针对这些机制,研究者开发了包括小分子化合物筛选、CRISPR基因编辑和三维培养优化在内的多种干预策略。这些技术在组织修复、抗衰老治疗等应用场景中展现出重要价值,例如可提升心肌梗死修复效率2.3倍,缩

weixin_33502772的博客 229

Java转大模型:能跑通Demo的人很多,能搞定权限和日志的很少

从Java后端转向大模型开发,很多人以为学会调用API、搭个RAG就能入职。但现实是,面试时你展示的Agent Demo跑得很顺,团队一问权限怎么管、日志怎么追踪、失败怎么兜底,就露馅了。这篇文章不教你怎么写Prompt,而是复盘我从Java转大模型的真实踩坑经历,告诉你哪些技能值得先补、哪些可以暂时放一放,以及为什么权限和可观测性才是Java工程师真正的差异化竞争力。---Java转大模型开发,最大的误区是以为学会调API、写Prompt就够了。

LLM_9528的博客 319

音视频开发基础(1):模拟视频技术简介

模拟视频技术是指用模拟技术对动态影像进行捕捉、记来、处理、存储、传输、复现的技术.模拟视频技术的发明、发展与模拟电视系统的发展密不可分.下面将通过模拟电视系统来介绍模拟视频技术中的基本概念. 首先,人的视觉系统的特征为电视等視稿系铳的发明、发展提供了理论依据.光线通过角膜、腫孔、晶状体的折射光线.透过玻璃体到达视网展.视网膜上分布着光感受器,光感受器在光线的剌激下...

琅嬛福地 1493

58子站安居,经纪人营销管理平台登录接口加密逆向

实战场景password 实战分析 本次要解决的站点依旧来源自78技术人社群,有朋友希望再次说明一下其登录模块的加密参数寻找与逆向逻辑,本文我们就一起分析一下。 站点地址为:vip.anjuke.com/portal/login 通过开发者工具,可以简简单单的寻找到相应的数据。

梦想橡皮擦,专栏100例写作模式先行者,现象级专栏 《Python 爬虫 100 例》作者、《滚雪球学 Python 专栏》原创者 2万+

大模型求职:Demo能跑通后,为什么权限和日志成了致命坎

从2024年下半年到现在,我面过几十个候选人,也带过好几批实习生。2026年的求职市场有个很明显的信号:只会写Demo的人,简历关都能过,但一到"这个项目怎么上线"的环节,几乎全军覆没。翻车的地方十有八九不是模型效果,也不是Prompt写得好不好,而是三件事——权限、日志、可观测性。先说个真实场景。上个月有个候选人投了高级后端,简历上写着"独立开发RAG Agent,支持多轮对话和知识检索",项目地址给了GitHub。

老男孩的架构路 382

ABAP Cloud define table 里的 not null 究竟在约束什么?——语义、场景与可运行示例

ABAP Cloud 中 not null 与 NULL 的用法解析 本文探讨了 ABAP Cloud 中 not null 关键字的语义与使用场景,对比了传统 ABAP 与 ABAP Cloud 在表字段定义上的差异: 核心概念 not null 是数据库层的列约束,强制字段不能存储 NULL 值 ABAP Cloud 通过 DDL 显式声明列是否允许 NULL,HANA 上 CDS 表默认创建为 NOT NULL 使用建议 主键、外键、审计字段等必须使用 not null 业务上可缺失的字段(如批准日期

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 302

Demo跑通只是入场券,权限日志兜底才是2026年拿offer的分水岭

去年秋招那会儿,我面了几个后端候选人,简历上都挂着"基于LangGraph的Agent系统"。问起来,Demo跑得飞起,GraphRAG、多步推理、工具调用样样都有。但一问到生产环境部署,对方眼睛就开始飘了。说实话,那段时间我有点焦虑——不是担心招不到人,而是发现很多人把"能跑起来"当成了"能做出来"。今年再看,这个趋势没有缓解,反而因为大模型应用从Demo走向团队协作,把这个问题放得更大了。

资料免费分享,点击名片 372

4.4 直流无刷电机(BLDC):控制器硬件设计

摘要 本文详细阐述了直流无刷电机(BLDC)控制器的硬件设计要点。控制器硬件主要包括微处理器单元、功率驱动模块、信号检测电路、通信接口和电源管理模块。在微处理器选型方面,分析了ARM Cortex-M系列、DSP等架构的适用场景,并对比了不同处理器的性能参数。功率驱动模块设计重点包括栅极驱动电路、逆变桥热管理和电流保护机制。信号检测部分介绍了位置传感器接口和模拟信号调理技术。此外,还讨论了通信接口设计、电源管理方案以及硬件布局与EMC设计规范。最后强调了硬件测试验证的重要性,包括故障注入测试等验证方法。整体

技术工作者 185

SPD-Conv+YOLOv8:空间深度转换卷积赋能小目标检测,从原理到实战的科研级优化指南

从理解SPD-Conv“空间到深度+逐步卷积”的核心设计,到亲手将其嵌入YOLOv8并验证在小目标场景的表现,再到基于此探索属于自己的科研与工程方向——这个过程能让你深刻理解“小目标特征保留”在检测任务中的核心价值。现在就开始行动,相信你会在小目标检测的“细节捕捉”之路上,走出一条属于自己的技术路径。实验通常会证明:嵌入SPD-Conv后,YOLOv8在小目标AP上提升5-8个百分点,mAP50-95提升3-5个百分点,而推理速度仅下降5%以内,充分体现了其“保细节+提精度”的优势。

m0_64661770的博客 163

Demo能跑通只是入门,权限日志可观测才是求职的分水岭

摘要:大模型应用从Demo到上线,真正拉开差距的不是调用链有多炫,而是权限怎么管、日志怎么记、可观测怎么做。本文从岗位趋势、能力分层、学习计划、项目沉淀和长期竞争力五个维度,结合真实踩坑经验,给出Java工程师转大模型的可执行路径。---大模型时代的程序员职业规划,核心不是学多少新技术,而是能不能跨过Demo到生产的鸿沟。权限、日志、可观测,这三个词听起来不性感,但它们是生产级应用的基础设施。你的Agent能不能上线,取决于这三件事做得怎么样。

LLM_9528的博客 344

ThingsBoard-阿里云短信规则节点

由于Thingsboard平台国内只支持短信服务,那我们运维人员去及时接收邮箱肯定是没有短信来的方便的,在这基础上,需要自己从规则链入手,自定义一个支持阿里云短信服务的规则节点。

weixin_67440240的博客 2097

Hermes跑通Demo容易,团队接手却翻车?权限日志才是真门槛

上周团队里有人试了 Hermes,个人电脑上跑通了一个代码补全的 Demo,兴冲冲拉进项目群里。结果联调的时候,日志没权限、模型配置互相覆盖、交付文档也没有统一格式,最后只能各写各的,反而比不用 AI 还慢。这件事让我重新想了一下:AI 编程工具从个人试用走向团队协作,真正卡住人的从来不是模型能力,而是权限、日志和交付标准。Hermes 本身是个好东西,但很多团队拿到它之后,没把这些底层的工程问题想清楚,就直接往上堆,结果事倍功半。

资料免费分享,点击名片 170

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Agent跑通Demo容易,运维团队接手就崩?真正卡住的是权限和日志

去年我带团队做了个AIOps Agent,Prompt调得挺顺,日志分析、告警归因、自动重启都能跑通。Demo演示时领导点头,结果上线第一周就出了两件事:一次是Agent给生产库删了不该删的表,另一次是它改了配置后完全没留下审计记录,出了问题查不到谁干的。这两个事故把我打醒了。之前我花大量精力在优化模型输出质量上,但真正让团队不敢把Agent放出去用的,不是它不够聪明,而是它不够可控。运维转大模型,真正的学习断点不在模型能力,而在权限边界和可观测性。---回到最初的问题:运维转大模型,该补什么?

老男孩的架构路 335

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

测试转大模型:Demo能跑通就够了?权限日志才是真门槛

测试转大模型,很多人以为学会写自动化用例、调调Prompt就完事了。实际接手项目后才发现,真正卡脖子的不是测试能力本身,而是权限配置、日志追踪、交付文档这些"脏活"。本文从一个真实项目复盘出发,聊聊为什么权限和日志才是团队接手成本的分水岭,以及测试工程师怎么把这个能力补上。---测试转大模型,不是换个工具那么简单。传统测试关注的是"系统是否按预期运行",大模型测试要关注的是"系统会不会乱来,出了问题能不能追踪"。权限、日志、文档,这些"脏活"才是团队接手成本的核心。

m0_62051288的博客 183

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

单测通过不算完,权限日志才是大模型求职的及格线

摘要:大模型应用正在从"能跑通"迈向"能上线",企业招聘也在同步变化。本文以一个真实的权限+日志卡点为例,拆解 Demo 和项目之间的差距,梳理计算机专业学生在基础课、AI 项目、实习准备上的取舍路径。---大模型时代的计算机就业,门槛在提高,机会也在增加。提高的门槛不是模型能力本身,而是工程化能力。对在校生来说,最有效的准备方式是:做一个有权限控制、有结构化日志、有异常兜底的真实项目,而不是十个能跑通但经不起追问的 Demo。

老男孩的架构路 384

Agent项目能跑通却不敢上线,真正卡住团队的不是代码能力,而是权限和日志

摘要:大模型应用从Demo走向生产,最大的分水岭不是模型选得好不好,而是权限管理、日志追踪和异常兜底。本文从一个真实上线翻车案例出发,梳理Agent工程师的能力分层和实战路径,给出可落地的学习计划和项目建议。---目录岗位趋势:谁在招人,谁在观望能力分层:Demo和生产的距离有多远短期学习计划:先把工程底子补上中期项目沉淀:做一个能扛住线上问题的项目长期竞争力:从"调API的"到"能扛上线的"总结---大模型时代的程序员职业规划,核心问题不是"选什么方向",而是"怎么让自己不可替代"。

资料免费分享,点击名片 247

Demo能跑就敢投大模型岗位?真正卡住你的是这三样东西

前阵子帮几个朋友改简历,发现一个挺有意思的现象:很多人项目经历写得很漂亮,"基于LangChain搭建智能客服系统"、"实现了RAG问答链",看起来每一步都踩在热点上。但细问下去,这些项目基本都停在Jupyter Notebook里,或者最多部署到本地跑个API。一旦我说"那权限控制呢?日志追踪呢?线上出问题了怎么定位?",对方就开始支支吾吾。不是大家不想学,而是学习路线本身出了问题。大多数教程的叙事是:装环境、调API、写Prompt、跑通Demo。

2601_96189255的博客 1334

运维转大模型:Demo跑通就敢上线?真正卡住你的是权限、日志和可观测

我做过一个Kafka消费延迟分析的Agent,Demo环境一切正常,上线第一天就崩了。问题不在模型,而在权限、日志和可观测性。运维转Agent开发,最大的坑不是技术,而是工程化思维。运维转大模型Agent开发,最大的优势是对系统架构和故障排查的理解,最大的短板是对模型能力边界和工程化机制的认知。学习建议:1. 先从一个具体的场景入手,比如日志分析或告警归因,不要一开始就做全功能的Agent平台。2. 理解模型的能力边界:LLM擅长模式识别和文本生成,但不擅长精确计算和确定性逻辑。

m0_62051288的博客 336

Demo能跑通就敢投大模型岗位?真正卡住你的是权限、日志和可观测性

摘要:今年面试了不少转大模型的同学,发现一个反复出现的现象——简历上"LangChain Agent + RAG"写得漂漂亮亮,但聊到生产环境时,权限怎么隔离、日志怎么追踪、失败怎么兜底,几乎全部空白。这篇文章不聊虚的,直接从真实项目踩坑出发,告诉你大模型时代,学生到底该怎么准备。---大模型时代,计算机专业学生的就业逻辑没有变:工程能力永远是硬通货。Demo 跑通只是起点,能上线、能稳定运行、能被团队复用,才是真正的竞争力。权限、日志、可观测性,这些听起来不炫酷,但恰恰是面试官最看重的部分。

LLM_9528的博客 166

LangChain跑通Demo就敢上线?真正卡住你的是这三件事

摘要:很多开发者花一周学会LangChain,用两小时跑通一个Agent Demo,然后就觉得可以接项目了。直到第一次上线,才发现权限没控制、日志找不到、调用链断了——这些在Demo里根本不会暴露的问题,才是真正拉开差距的地方。本文复盘一个真实的客服工单Agent项目,从Demo跑通到上线踩坑,重点讲清楚权限、日志和可观测性这三个经常被忽视的工程细节。---LangChain跑通Demo只是起点,能解释失败才算真正入门。

m0_62051288的博客 360

前端转大模型,Demo 跑通后我才发现权限日志才是真门槛

摘要:前端同学转大模型应用开发,优势在交互和用户体验,但真正卡住生产上线的往往是权限隔离、调用日志和异常兜底。这篇文章复盘我带项目踩过的坑,给出可复用的检查清单和作品集方向。前端的转型优势AI 应用交互模式流式输出多模态体验权限、日志与可观测:Demo 到生产的关键一步作品集方向建议总结---前端转大模型,最大的挑战不是技术栈,而是思维方式的转变。以前你关注的是页面怎么渲染、动画怎么流畅。

LLM_9528的博客 307

Agent 跑通 Demo 后,我在权限和日志上踩的坑比代码还多

摘要:从运维转大模型,很多人以为脚本经验直接平移就能干,实际上线才发现真正卡住的是权限边界、日志可观测和审批流程。本文复盘一个 AIOps Agent 项目从 Demo 到生产的全过程,重点讲清楚那些踩过的坑和最终怎么解决。---运维转大模型,脚本经验确实有用,但不够用。真正决定项目能不能上线的,是那些"非功能性"的工程细节:权限怎么管、日志怎么记、审批怎么走、回滚怎么做。Demo 阶段,模型准确率从 60% 提到 80% 是巨大进步。

LLM_9528的博客 135

LangGraph Agent 从 Demo 到生产:权限日志才是真正卡住你的那道坎

摘要: 上周把团队一个 Agent 项目从本地跑通推上线,差点在权限配置上翻车。LangGraph 把"脚本式调用"升级成了"图工作流",State、Node、Edge 把流程拆开以后,真正考验的不是模型能力,而是生产环境的权限隔离、链路日志和异常兜底。复盘这次踩坑,记录几个关键判断。---LangGraph 解决的不是"Agent 能不能跑"的问题,而是"Agent 能不能在生产环境可控地跑"的问题。从脚本到图工作流,本质上是把隐式的控制流显式化——状态在哪里、节点做什么、边怎么走,全部清晰可见。

LLM_9528的博客 279

Agent能跑通Demo,为什么团队接手就崩?权限日志才是真门槛

去年带过一个团队项目,一个数据查询Agent,Demo跑起来的时候确实漂亮。输入"上周销售额Top5的产品",它自己拆解任务、调数据库、生成图表,一气呵成。业务方看了直接拍板要上线。结果上线第一周就翻车了。不是模型不够聪明,是权限失控——Agent能访问的表比预期多了三倍,有些敏感字段直接暴露给前端。也不是工具调用出错,是某个API限流后,Agent卡死在重试循环里,日志里全是重复请求。最要命的是,团队接手后根本不知道这个Agent到底干了什么,因为没有任何可观测性。

2601_96120158的博客 347
上一篇: Demo能跑通只是及格线:2026年面试官真正在意的是什么
下一篇: 别急着重做计算机专业就业,先看岗位到底在筛什么
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值