Cassandra分布式数据库

分布式数据库压缩策略:Cassandra与HBase实战对比 在当今数字化时代,数据量呈现爆炸式增长,分布式数据库作为存储和管理海量数据的关键技术,得到了广泛应用。然而,随着数据的不断积累,存储成本和数据传输效率成为了亟待解决的问题。压缩策略作为一种有效减少数据存储空间、提高数据传输效率的技术手段,在分布式数据库中显得尤为重要。它可以降低硬件成本、提升系统性能,对于企业的大数据应用具有重要的经济和技术价值。本文通过对比Cassandra和HBase的压缩策略,详细介绍了分布式数据库压缩策略的核心概念、技术原理和实际应用。 阅读详情

Cassandra 概述

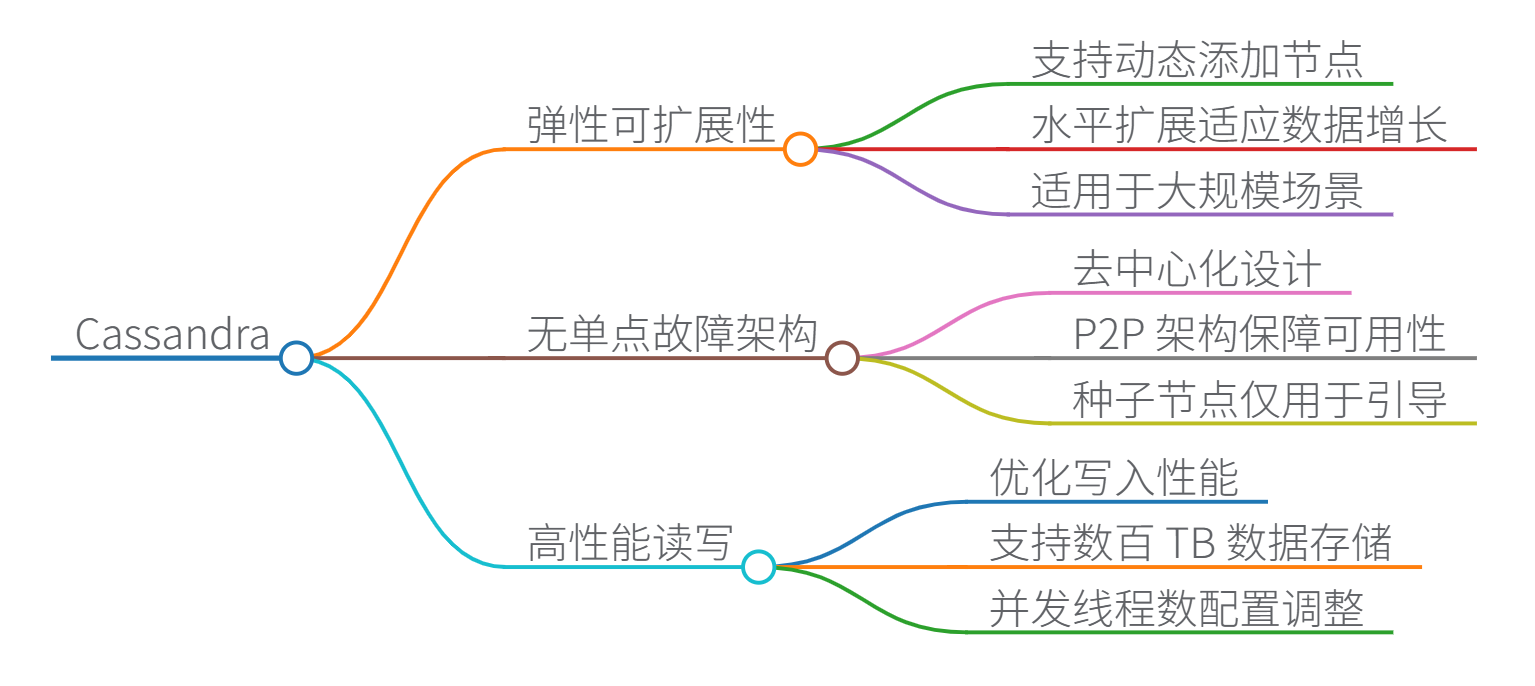
Cassandra 是一个高度可扩展的分布式 NoSQL 数据库,专为处理海量数据和高并发场景设计。其核心特点包括:

  1. 弹性可扩展性
    支持动态添加节点,通过水平扩展适应数据增长需求,满足大规模应用场景。

  2. 无单点故障架构
    采用去中心化设计(P2P 架构),确保关键业务连续可用。

  3. 高性能读写
    优化写入性能,在廉价硬件上支持数百 TB 数据存储,同时保持高效读取。
    例如配置参数:

    concurrent_reads: 256     # 并发读取线程数
    concurrent_writes: 192    # 并发写入线程数
    
  4. 灵活数据模型
    支持结构化/半结构化/非结构化数据,动态适应数据结构变化。

  5. 跨数据中心复制
    通过多数据中心数据复制实现灵活分发和容灾。

核心机制

1. Gossip 协议
  • 节点每秒与至多 3 个邻居交换状态信息(含版本号)
  • 新旧数据通过版本号自动覆盖,实现集群状态快速同步
  • 种子节点(seed)仅用于引导新节点加入,非单点故障
2. 数据分布
  • 分区策略:通过一致性哈希将数据分布到环状拓扑
  • 复制策略:支持 SimpleStrategy(单数据中心)和 NetworkTopologyStrategy(多数据中心)

典型应用场景

  1. 写入密集型场景

    • 日志存储(如应用日志、审计日志)
    • 时序数据(如物联网传感器数据)
    CREATE TABLE sensor_data (
      sensor_id UUID,
      timestamp TIMESTAMP,
      value FLOAT,
      PRIMARY KEY (sensor_id, timestamp)
    ) WITH CLUSTERING ORDER BY (timestamp DESC);
    
  2. 主键查询场景

    • 用户行为跟踪(通过用户 ID 快速检索)
    • 实时分析(如广告点击流)
  3. 低更新频率场景

    • 历史数据归档
    • 只读型数据仓库

安装与配置

1. 环境准备
  • JDK 8+(必需依赖)
  • 下载地址:Apache Cassandra 3.9
  • 解压命令:
    tar -zxvf apache-cassandra-3.9-bin.tar.gz -C /usr/local/cassandra
    
2. 关键配置 (conf/cassandra.yaml)
cluster_name: MyCluster
seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "192.168.1.10"  # 种子节点IP

data_file_directories: 
  - /var/lib/cassandra/data   # 数据存储路径

listen_address: node1_ip      # 当前节点IP
rpc_address: 0.0.0.0          # 客户端连接地址
3. 启动服务
bin/cassandra -f  # 前台启动(调试模式)
性能优化建议
  1. 内存配置
    heap_newsize: 800M
    max_heap_size: 4096M
    
  2. 并发控制
    native_transport_max_threads: 4096  # 最大客户端线程数
    
  3. 压缩策略
    compression:
      sstable_compression: LZ4Compressor
    
思维导图
在这里插入图片描述


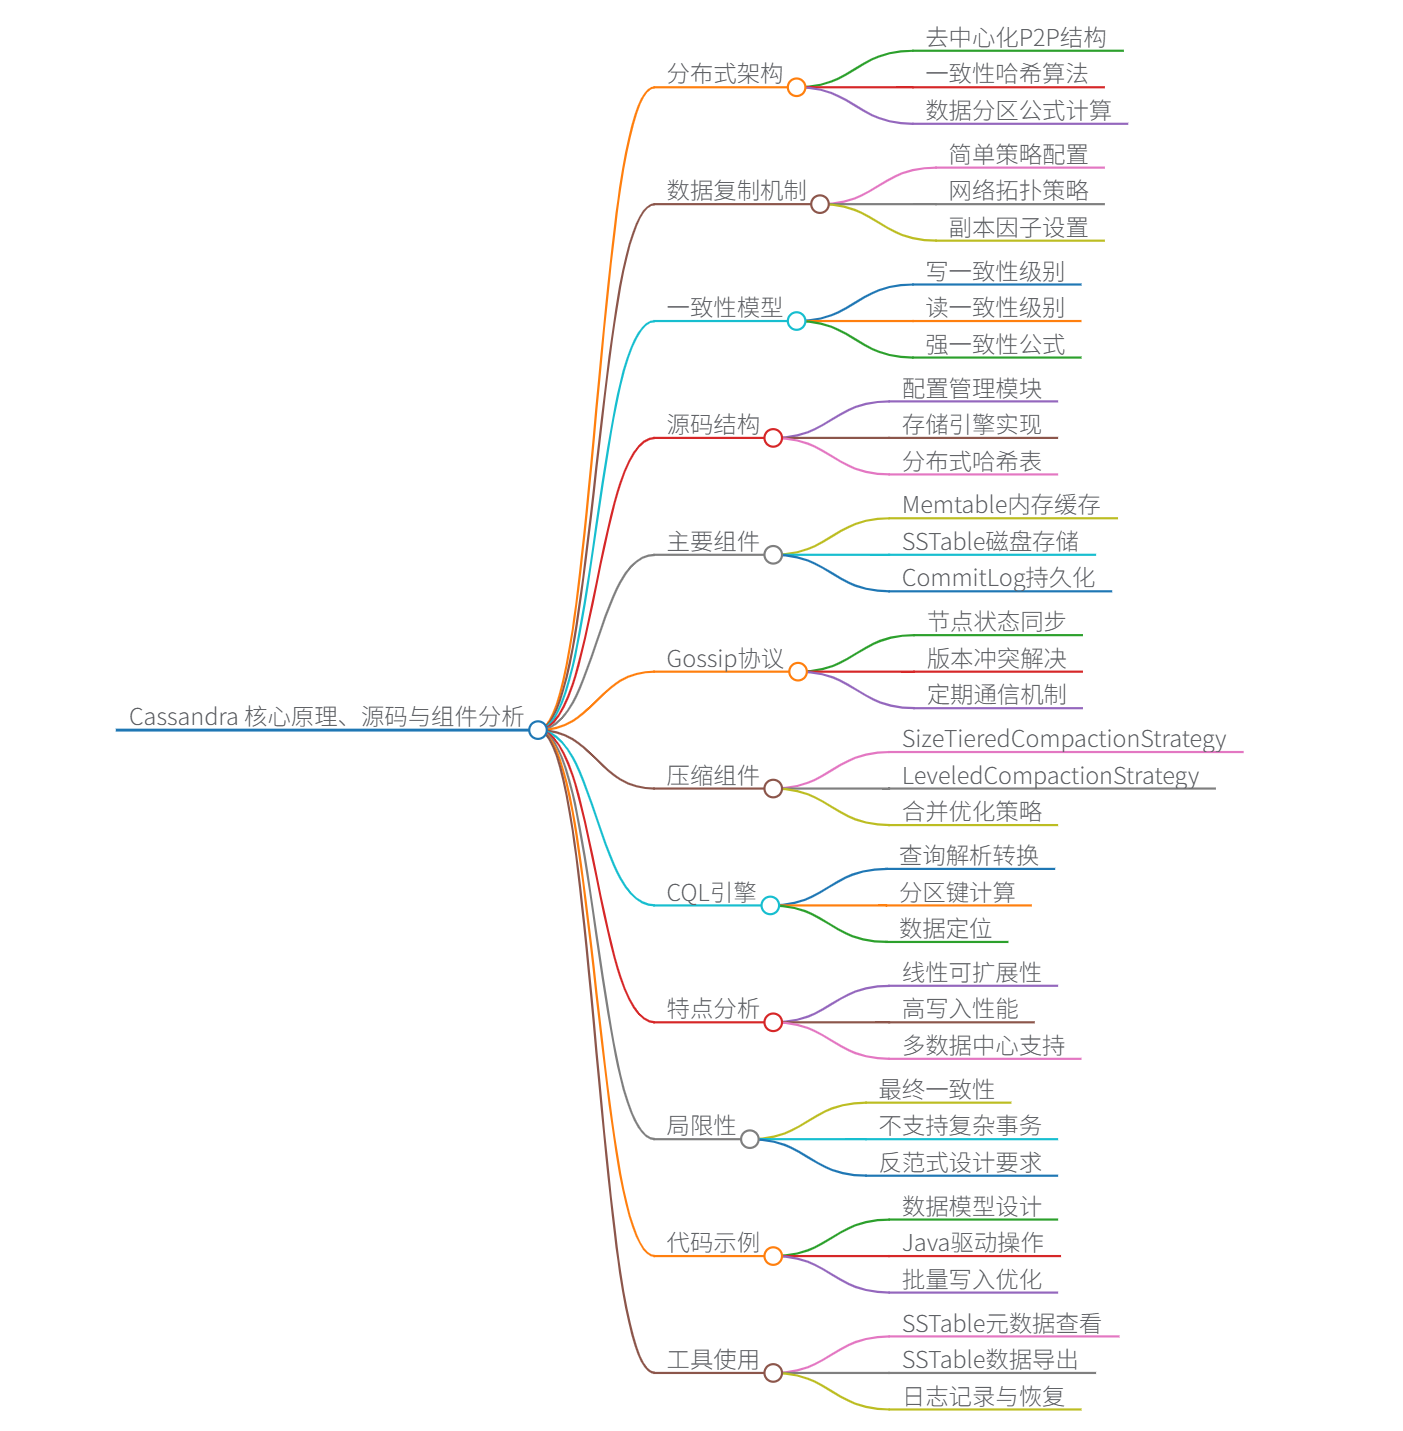
Cassandra 核心原理详解

1. 分布式架构

Cassandra 采用完全去中心化的 P2P 架构,所有节点地位平等(对等节点)。通过一致性哈希算法将数据分区存储在环状拓扑中,每个节点负责特定范围的 token 值。数据自动分区公式:
Token = Partitioner ( Partition Key ) m o d    2 127 \text{Token} = \text{Partitioner}( \text{Partition Key} ) \mod 2^{127} Token=Partitioner(Partition Key)mod2127
例如使用 Murmur3Partitioner 时,分区键 “user123” 的 token 计算为:

long token = Murmur3Partitioner.instance.getToken(ByteBuffer.wrap("user123".getBytes())).getTokenValue();
2. 数据复制机制

通过副本因子(Replication Factor)实现高可用性:

  • 简单策略:SimpleStrategy(单数据中心)
  • 网络拓扑策略:NetworkTopologyStrategy(多数据中心)
CREATE KEYSPACE my_keyspace 
WITH REPLICATION = {
  'class': 'NetworkTopologyStrategy',
  'DC1': 3,  // 数据中心1复制3份
  'DC2': 2   // 数据中心2复制2份
};
3. 一致性模型

提供可调节的一致性级别(Tunable Consistency):

  • 写一致性:ANY|ONE|QUORUM|ALL
  • 读一致性:ONE|QUORUM|ALL
    满足公式:
    R + W > N ( 强一致性保证 ) R + W > N \quad (\text{强一致性保证}) R+W>N(强一致性保证)
    其中 R R R=读副本数, W W W=写副本数, N N N=副本因子
4. 写路径优化
  1. 写入提交日志(CommitLog)确保持久性
  2. 写入内存表(Memtable)
  3. Memtable 满后刷盘为 SSTable
  4. 后台压缩合并 SSTable
// 源码片段:写操作入口(StorageProxy.java)
public static void mutate(Collection<Mutation> mutations, ConsistencyLevel consistency_level) {
    // 确定协调节点
    // 发送写请求到副本节点
    // 等待满足一致性级别
}

Cassandra 源码结构介绍

主要源码模块(基于 3.x 版本):

src/
├── java/org/apache/cassandra/
│   ├── config/       # 配置管理(YAML/属性文件)
│   ├── db/           # 核心存储引擎(Memtable/SSTable)
│   ├── dht/          # 分布式哈希表(分区器实现)
│   ├── gms/          # Gossip协议实现
│   ├── locator/      # 副本放置策略
│   ├── net/          # 节点通信(MessagingService)
│   ├── service/      # 存储服务(StorageService)
│   ├── utils/        # 工具类(BloomFilter等)
│   └── cql3/         # CQL解析与执行

主要组件及其功能

1. 存储引擎(Storage Engine)
  • Memtable:内存中的写缓存,使用跳表(SkipList)实现
  • SSTable:不可变的磁盘存储文件
  • CommitLog:崩溃恢复的预写日志
// Memtable 写入示例(Memtable.java)
public void put(PartitionUpdate update) {
    ColumnFamily cfa = get(update); 
    if (cfa == null) 
        cfa = create(update); 
    cfa.addAll(update); 
}
2. Gossip 协议

节点间状态同步协议:

  1. 每 1 秒选择 1-3 个节点通信
  2. 交换版本化状态信息(心跳、负载等)
  3. 基于版本号解决冲突
// Gossiper.java 核心循环
while (!shutdown) {
    // 选择目标节点
    List<GossipPartner> partners = selectPartner();
    // 交换状态信息
    for (GossipPartner partner : partners) {
        sendGossip(partner.endpoint, state);
    }
    Thread.sleep(interval);
}
3. 压缩组件(Compaction)

合并 SSTable 减少读取放大:

  • SizeTieredCompactionStrategy (STCS)
  • LeveledCompactionStrategy (LCS)
// CompactionManager.java
public void submitBackground(ColumnFamilyStore cfs) {
    if (!cfs.isCompactionDisabled())
        executor.submit(new BackgroundCompaction(cfs));
}
4. CQL 引擎

将 CQL 查询转换为存储操作:

SELECT * FROM users WHERE id = '123' 
→ 转换为分区键 token 计算
→ 定位数据节点

Cassandra 特点分析

优势
  1. 线性可扩展性
    添加节点时数据自动重分布(nodetool rebuild)
  2. 高写入吞吐
    优化写入路径(顺序写 + 内存表)
  3. 多数据中心支持
    跨 DC 数据同步配置:
    # cassandra.yaml
    endpoint_snitch: GossipingPropertyFileSnitch
    
局限性
  1. 最终一致性
    需要权衡一致性级别与延迟
  2. 不支持复杂事务
    仅提供轻量级事务(Compare and Set)
  3. 反范式设计
    需根据查询模式设计数据模型

相关代码示例

1. 数据模型设计
-- 时间序列数据建模
CREATE TABLE sensor_readings (
    sensor_id uuid,
    bucket int,       -- 时间桶(按天分区)
    timestamp timestamp,
    value float,
    PRIMARY KEY ((sensor_id, bucket), timestamp)
) WITH CLUSTERING ORDER BY (timestamp DESC);
2. Java 驱动操作
Cluster cluster = Cluster.builder()
    .addContactPoint("node1_ip")
    .withQueryOptions(new QueryOptions().setConsistencyLevel(ConsistencyLevel.QUORUM))
    .build();

Session session = cluster.connect("my_keyspace");

// 插入数据
PreparedStatement ps = session.prepare(
    "INSERT INTO users (id, name, email) VALUES (?, ?, ?)");
BoundStatement bs = ps.bind(UUID.randomUUID(), "Alice", "alice@example.com");
session.execute(bs);
3. 批量写入优化
BatchStatement batch = new BatchStatement();
for (int i = 0; i < 100; i++) {
    batch.add(ps.bind(...)); 
}
session.execute(batch);  // 单次RPC发送批量操作
4. SSTable 工具使用
# 查看SSTable元数据
sstablemetadata /var/lib/cassandra/data/keyspace/table-xxx/sstable-file

# 导出SSTable数据
sstabledump /path/to/sstable
思维导图

在这里插入图片描述

Cassandra数据库入门-1 Cassandra系列教程-1 ,入门介绍 阅读详情

相关推荐

Cassandra简介(概念篇)

Apache Cassandra是一个高度可扩展的高性能分布式数据库,用于处理大量商用服务器上的大量数据,提供高可用性,无单点故障。这是一种NoSQL类型的数据库。无单点故障。单点故障:是指系统中一点失效,就会让整个系统无法运作的部件,换句话说,单点故障即会整体故障。NoSQL 数据库:提供一种机制来存储和检索数据,而不是关系数据库中使用的表格关系。这些数据库是无架构的,支持简单的复制,具有简单的API,最终一致,并且可以处理大量的数据。

weixin_44699658的博客 4250

分布式数据库Cassandra

Apache Cassandra是高度可扩展的,高性能的分布式NoSQL数据库。提供高可用性而无需担心单点故障。具有能够处理大量数据的分布式架构。数据放置在具有多个复制因子的不同机器上,以获得高可用性,而无需担心单点故障。弹性可扩展性 - Cassandra是高度可扩展的;它允许添加更多的硬件以适应更多的客户和更多的数据根据要求。始终基于架构 - Cassandra没有单点故障,它可以连续用于不能承担故障的关键业务应用程序。

喝醉的咕咕鸟 5620

使用Spring Boot和Cassandra实现分布式数据库

Cassandra作为一种高性能、可扩展的分布式数据库,能够有效地应对大数据量和高并发的数据访问需求,为应用的稳定性和可靠性提供了强有力的支持。:Cassandra支持自动数据分区和复制,可以在多个节点上存储数据,保证数据的高可用性和可靠性。:根据应用的查询需求和数据访问模式来设计合适的数据模型,避免过度规范化和频繁的数据读写操作。:通过添加新节点,可以线性扩展Cassandra集群的存储容量和吞吐量,无需中断服务。:Cassandra支持广泛的数据类型和灵活的数据模型,适合多种数据存储和查询需求。

聚娃科技开发者博客 441

详解Cassandra数据库

Cassandra 凭借其分布式架构和高性能特性,成为处理海量数据的理想选择。通过 Docker 快速部署和配置,可轻松搭建单机或集群环境。结合 CQL 的灵活查询能力和 5.0 版本的新特性(如向量搜索),Cassandra 能够满足 AI、物联网等新兴领域的需求。在实际应用中,需根据业务场景合理设计数据模型,并通过安全配置和性能优化确保系统稳定运行。# 快速启动单机实例 docker run -d --name cassandra -p 9042 :9042 cassandra:5.0.0参考文档。

2302_79511370的博客 3167

Cassandra数据库从入门到精通系列之五:cassandra数据库启动命令和修改Cassandra数据库启动使用的内存

Cassandra数据库从入门到精通系列之五:cassandra数据库启动命令和修改Cassandra数据库启动使用的内存

zhengzaifeidelushang的博客 1267

李宏毅机器学习笔记第17周_概述领域自适应(Domain Adaptation)

Domain Adaptation

peaunt1的博客 1107

深入了解Cassandra数据库:原理、架构与最佳实践

Cassandra是一个开源的分布式NoSQL数据库,最初由Facebook开发,现由Apache软件基金会维护。它在处理海量数据时表现出色,特别适合需要高可用性和线性扩展的应用场景。在这篇博客中,我们将深入探讨Cassandra的架构、数据模型、应用场景以及如何优化其性能,以便更好地利用这一强大的数据库系统。

hello.reader 2634

别再乱刷了!《另一个伊甸》异节、改典、典录获取途径完全梳理,这些隐藏奖励你拿全了吗?

本文全面解析《另一个伊甸》中异节、改典、典录的获取途径,包括断章、外传、精灵试炼等高概率掉落副本,以及隐藏任务、限时活动和特殊挑战。提供高效收集策略和优先级建议,帮助玩家快速获取这些稀缺资源,实现角色真证和上限突破。

weixin_42699679的博客 599

Cassandra分布式数据库详解

Cassandra是由Facebook开发,后来成为Apache软件基金会顶级项目的分布式数据库。它基于Amazon的Dynamo论文和Google的Bigtable论文设计,融合了两者优点,具有高可用性、高可靠性和高扩展性。Cassandra适用于处理大规模分布式系统中的大量数据,尤其适合于实时数据处理和分析。Cassandra作为一种高性能、可扩展的分布式数据库,具有高可用性、高可靠性和高扩展性。它适用于处理大规模分布式系统中的大量数据,尤其适合于实时数据处理和分析。

emilio15979289的博客 512

基于Vivado2025的UltraScale+时序收敛优化实战案例

深入解析在Vivado2025环境中针对UltraScale+架构的时序收敛挑战,结合实际设计案例,分享关键优化策略与操作技巧,显著提升设计性能与收敛效率。vivado2025的更新特性为时序优化带来新机遇。

weixin_33660045的博客 347

TCP三次握手,四次挥手的全过程,为什么需要三次握手,四次挥手

文章目录TCP介绍三次握手四次挥手滑动窗口拥塞避免算法 TCP介绍 三次握手 四次挥手

热爱编程的菜鸟 1万+

Cassandra分布式数据库解析

本文对Cassandra分布式数据库进行了详细解析,从技术特点、性能优势、可扩展性与容错性、应用场景等方面进行了阐述。Cassandra作为一种高性能、可扩展的分布式数据库,在海量数据存储和实时数据处理等领域具有广泛的应用前景。在未来,Cassandra的发展将更加注重以下几个方面:数据模型优化:随着应用场景的不断拓展,Cassandra需要不断优化数据模型,以满足不同场景下的需求。性能提升:Cassandra将继续优化算法和实现,提高系统性能,以满足日益增长的数据处理需求。

2501_92489105的博客 339

AI应用安全 - Prompt注入攻击

随着大模型的爆火,各行各业都在使用大模型进行智能化改造。但是如何做一个可靠的大模型应用,就需要考虑各种安全问题。本文主要介绍一种常见的安全问题,即prompt注入攻击,并介绍一些防范手段。Prompt Injection Attack(提示注入攻击)是针对大型语言模型(LLM)的一种新兴安全威胁,攻击者通过精心构造的输入提示(prompt)来操纵模型行为,使其产生非预期输出或执行恶意操作。它主要包括两种注入方式,一是直接注入,而是间接注入。

sinat_28694519的博客 1932

Argo CD与Cassandra:分布式数据库管理

在现代云原生环境中,分布式数据库如Cassandra已成为处理大规模数据的核心组件。然而,管理这些复杂的分布式系统面临着诸多挑战: - **配置复杂性**:多节点、多数据中心配置难以手动管理 - **版本控制**:数据库schema和配置变更缺乏版本追踪 - **部署一致性**:确保所有环境(开发、测试、生产)配置一致 - **监控与健康检查**:实时掌握集群状态和性能指标 Argo CD作为...

gitblog_00068的博客 819

Windows 11 安装、使用 Git:下载、安装、概念、命令、分支模型

本文详细介绍了在 Windows 11 系统上安装与使用 Git 的完整流程,涵盖从官方或国内镜像下载安装包、关键安装选项配置,到 Git 核心概念(如工作区、暂存区、分支、远程仓库等)的通俗解释。同时梳理了常用命令与五种主流 Git 分支模型(如 Git Flow、GitHub Flow 等),帮助开发者根据项目规模选择合适的工作流,是面向初学者与进阶用户的实用指南。

寒水馨 · 轻量级技术文档 · hanshuixin.org 2400

芒果YOLO11改进81:主干Backbone篇之DCNv3结构:即插即用|使用pytorch代码实现,并针对YOLO11专门优化模块

芒果YOLO11改进81:主干Backbone篇之DCNv3结构:即插即用|使用pytorch代码实现,并针对YOLO11专门优化模块

包括YOLOv5、YOLOv7、YOLOv8等模型改进 744

Cassandra分布式数据库框架总结

框架介绍: 对cassandra分布式数据库的一些总结(由于cassandra资料比较少,总结只是个人理解,仅作为参考): Cassandra是NOSQL数据库的一种,是基于列族存储的轻量级分布式数据库。 thrift框架: Cassandra客户端和服务端是通过thrift框架进行通信的,thrift框架是一个跨语言的服务部署框架,使用了一种中间语言IDL来定义R

qq838642798的博客 2000

Vue3 - 完美解决html2canvas截图不全问题,截图只截取当前可视区域导出图片不全,截屏导出的图片显示不全只有一部分或缺一块,vue3移动端H5网页项目使用html2canvas插件长截图!

vue3,html2canvas,移动端H5网页,截图不全,html2canvas长截图不全,保存长截图,页面滚动导致截图不全,网页下方截屏不到怎么办,底部一部分无法截屏到,保存的图片少了一大块,H5海报截图不完整,怎么截取滚动条下方的内容,截图图时图片不全,截图图片只有一半的问题,底部内容空白,截图空白问题的解决,截图不全怎么办,html2canvas.js网页截图功能(解决截图不全问题,移动端ios系统截图不完整,html2canvas截图太长又不能删减截取不到,使用HTML2Canvas在H5页面上实

🏆 前端领域优质创作者 1万+

KCP与Cassandra集成:分布式数据库优化

在当今大数据时代,分布式数据库系统如Cassandra已成为企业级应用的核心基础设施。然而,随着数据规模的不断增长和实时性要求的提高,传统TCP协议在网络传输方面的局限性逐渐显现: - **高延迟问题**:TCP的重传机制在丢包情况下会导致显著的延迟增加 - **带宽利用率低**:拥塞控制机制在复杂网络环境下表现不佳 - **跨地域传输困难**:长距离网络传输中的延迟和抖动问题 这正是KCP协...

gitblog_00424的博客 737

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

分布式数据库Cassandra ppt

分享两个分布式数据库Cassandra ppt 转载于:https://blog.51cto.com/lubing/910721

weixin_34293246的博客 306

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Cassandra 分布式数据库 配置、启动与集群

本文转自http://hi.baidu.com/yandavid/item/caa255e98e8d21c3bbf37d08 Cassandra 分布式数据库 配置、启动与集群 Cassandra 的配置详解 了解一个软件的配置项的意义是使用这个软件的前提,这里详细介绍 Cassandra 的配置文件(storage-config.xml)中各个配置项的意义,这其中包含有

zhy_1201的专栏 1129

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

分布式数据库Cassandra配置文件详解

Cassandra常用配置及调优

阁下何不踏风起 1011

探索Cassandra:一个强大的分布式数据库客户端

**项目介绍** Cassandra是一个为Ruby编程语言设计的开源客户端,用于与Cassandra分布式数据库进行交互。它支持从Cassandra 0.7.x到2.0.x的不同版本,并且兼容多种Ruby运行时环境,包括1.8.7、1.9.2、1.9.3、2.0.0和2.1以及Rubinius。尽管这个gem目前的开发活动较少,但对于已经依赖它的应用程序,仍然是一个稳定可靠的解决方案。 **

gitblog_00087的博客 525

Cassandra 分布式数据库详解

Cassandra是一个开源的分布式NoSQL数据库,最初由Facebook开发用于处理高并发写入场景。它采用无中心对等架构,结合一致性哈希进行数据分片和多副本存储,具备高可用性和线性扩展能力。Cassandra使用列族数据模型,支持动态添加列,其写入流程先写内存和日志再异步刷盘,读取则通过合并多个数据源实现。提供可调一致性级别,并内置Hinted Handoff、Read Repair等容错机制。适合物联网、社交网络等高写入场景,与HBase、MongoDB等相比在写入吞吐量和可用性方面表现突出。

gopher123的博客 792
上一篇: ABAC 权限策略扩展
下一篇: 分布式数据库
HuiSoul200
博客等级 码龄8年 274粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值