


StableDiffusion,一款基于深度学习的图像生成模型,以其强大的图像生成能力和个性化风格迁移能力,在艺术创作领域掀起了一场革命。而LoRa技术,作为StableDiffusion的一项重要应用,更是让用户能够根据自己的喜好,生成专属于自己的女神形象。本文将带你深入了解Stable Diffusion -LoRa应用的使用方法,助你轻松实现这一梦想。
这几天我看到上海有很多活动例如BW、CCG、ChinaJoy之类的
看到网上有很多人上传他们和各类漂亮coser的合照,那可真是羡慕死我了。
这个时候我收到了我妈的消息,她问我为什么我“女朋友”的照片总是只穿一件衣服,不是给了我钱让我去买衣服吗?

我这才发现因为我偷懒的缘故,AI绘图的成品大多只是更换了动作和背景,衣服却是固定的样式。再加上我怕改了权重较高的提示词会导致AI直接帮我换个“女朋友”的缘故,一直不敢做大幅度的改动。
至于我妈问我为什么女朋友的脸偶尔会有些微小的变化,我只能说是开美颜和不开美颜的区别了。

这时我意识到了关于LoRa的学习迫在眉睫,得赶紧学会这个东西好给我“女朋友多换几件衣服”,当然我的初衷还是为了学会好分享给在座的各位。
**所以废话少说,**让我们开始今天的学习吧!

LoRa是什么
这个模型看过我前面笔记的同学们肯定不陌生,无论是在提示词、模型标题还是抄作业的时候都会看到这个词。

在AI绘画爆火期间,无论是精美的二次元插画还是堪比真人的虚拟博主,甚至是那些让老色批都直呼awsome的赛博coser。
虽然这个模型的下载只需要区区几百MB

但是当真正使用模型的时候就会遇到一些问题,在哪里找Lora、尖括号和数字是什么意思、调用Lora的扩展插件要怎么使用等。
当然这些问题都会在这篇笔记中得到解答,如果准备好遇见专属于自己的那个“他/她”,那么就接着往下看吧。

LoRa全称Low-Rank Adaptation Model,翻译过来就是低秩适应。
LoRa最早是由微软团队提出且应用在早期的大语言模型例如GTP2、GTP3中。而第一位将LoRa引入扩散模型并辅助图像产出的人叫做Cloneofismo

在这个大神之前的SD绘图方法只能通过Dreambooth进行绘画,也就是之前提到过的Checkpoint。
Dearmbooth是一种“个性化”文本到图像扩散模型的新方法,可以根据用户的需求将扩散模型“特殊化”。给定一个主题的几张图像作为输入,然后微调一个预训练的文本到图像模型里,这样AI就学会了将唯一标识符(某些词语)与特定的主题绑在一起。
如果对大模型的产出不满意就只能重新迭代、微调,在之前也提到过大模型的对设备要求高、消耗的算力大、速度慢。
于是这位大神在微软团队的论文启发下提出了一种“微调”扩散模型的方式,也就是现如今的Lora,Lora的诞生降低了模型训练的门槛并且拓宽了产出模型的适用范围。
训练大模型最低的要求是拥有12G以上的内存,这意味着显卡至少是N卡的4070起步。但是训练Lora模型只需要8G甚至更低一下也可以,这意味着我奶奶家电脑用来炒股的1070都可以用来训练。
并且大模型CheckPoint都是1个G起步的存储空间占用,而Lora模型则大多都是在200MB以下,这样无论是在网上下载还是上传都是要快得多。
由于训练门槛的降低,现在的模型论坛和网站上有着各种各样百花齐放的创作者自己训练的lora模型。

这些Lora模型下载下来之后格式基本上都是**.ckpt或者 safetensor**

虽然说Lora的出现带来了变革,但是Lora并不是来取代Checkpoint的,相反是来加入与Checkpoint一起使用从而实现特定方面的微调。

三种调用LoRa的方式
第一种调用方式:在提示词里输入
在下载了Lora的模型之后,将其放在WebUI-models-lora文件夹里面。

Lora的文件是可以进行重命名的,不过最好还是用英文,以免在调用时出现问题。
而使用方式则是在提示词中用Lora:文件名的方式输入。

这样就能实现想要的古风效果啦
正向提示词:
polaroid photo, lora:InsPX2:0.4, 1girl, cityscape backdrop, rooftop or high-
rise balcony, dynamic composition, engaging pose, soft yet striking
lighting, shallow depth of field, bokeh from city lights, sharp details,
highly detailed, hyper-realistic, 50mm lens, naturally blurred
background,lora:FilmVelvia2:0.15,lora:hanfuTang\_v35:0.65,(hanfu, tang
style outfits, white upper shan, multicolour chest po skirt, yellow
waistband),<nwsj_v3:0.5>**
反向提示词:
cartoon, anime, sketches,(worst quality, low quality), (deformed, distorted,
disfigured, bad eyes), wrong nose, weird mouth, strange ears, bad anatomy,
wrong anatomy, amputation, extra limb, missing limb, floating limbs, (bad
teeth, mutated hands, wrong fingers:1.2), disconnected limbs, mutation,
ugly, disgusting, badhandv4, EasyNegative**
第二种调用方式:附加模型选单
在生成按钮的下方有一个按钮

这个按钮点开之后左侧会多出一行选项

这个就是额外附加网络的选项,换句话说就是可以增加扩展模型,点击里面的超模型、模型、Lora就可以直接选取已经下载过的进阶模型,选择想要的文件后系统就会自动地将这个模型添加到正向或者反向提示词中。

当然关于这个参数的选择也可以在设置中进行调节,

可以这里调节权重、宽高、顺序等等。
如果觉得显示模型的缩略图不喜欢的话可以点击缩略图左上角一个小电脑一样的图标,点击这个图标就可以用该模型生成的图来作为示例图。


通过以上两种模式生成的图片在分享作业的时候分享会将这个图片的提示词权重、模型、种子等参数等都展示出来。
但是随着Lora的不断增加,有些图像在绘画的时候会用到多个Lora或者复杂的Lora提示词,这会导致AI读取困难,于是第三种方法应运而生。
第三种调用方式:附加网络扩展(秋葉整合包自带)
这个方法需要在扩展中添加一个外置扩展:Additional Network
代码仓库地址:
(需要的小伙伴文末可自行扫描获取)

在添加之后点击应用重启WebUI之后就可以在左侧下方的参数中看到Additional Network选项。

目前附加模型的类型只能选择LoRA,在右侧的模型1中选取想要的模型。
如果在模型1列表里没有看到模型的话不要紧张,这是因为Lora模型和这个扩展里面的Lora模型并不是放在同一个文件夹中。
这个时候去到自己放置Lora模型的文件夹,将Lora文件都复制上,然后回到最开始的界面,然后找到Extension

找到sd-webui-additional-network

找到models-点进lora


最后将有的那些lora模型都放进这个文件夹中即可。

如果列表里面还是没有的话,记得点击一次下方的刷新模型列表,有些Lora不仅仅通过文件名来调用,这些lora包含多个Trigger
World并且需要在提示词里写出才生效。
所以这两个Lora路径即使是统一了也会遇到无法生效的情况。

在右侧的权重设置中0是没有效果,数值1是等同于原始的效果,一般情况下的权重设置是在0-1之间。
在下方设置完之后就不需要在上方的提示词里再填写Lora模型名,但是缺点就是在抄作业的时候直接复制提示词可能无法达成作者演示的效果,其原因就是额外加载的LoRa不会以提示词的方式展现。
目前这个拓展还支持Lora作用于图片的某一个特定区域,不过这个就是更高阶的内容了。

使用Lora的方式就是简单地选择一个模型,然后输入提示词或者上传图片,之后对参数进行配置后点击生成。

这样一来一个略微带有些网红风格的小姐姐图片就基于Lora生成了。
但是这只是Lora最简单的应用,具体的Lora应用方向是什么呢?
Lora的应用方向
网上大多数的Lora模型都是针对某一个点例如画建筑、画衣服、画老婆等等,作为一名热爱学习的学生,我的眼光应该越过那些涩涩的东西,将目光放在Lora到底能做什么上。
目前市面上的创作者产出Lora主要分为五大块:character人物角色形象、Style画风、Concept概念图、Cloth服饰和Object特定的物品/元素。
这些都会用一个具体的例子来进行举例,同时我也会上传到我的百度网盘中可供大家下载使用,当然也希望大家能够多多支持这些创作者们。
- Character人物角色形象
目前市面上用得最多的往往都是针对人物角色形象的创作把控,老色批们从“what is her name”变成了"what is the prompt"。
大伙最熟悉的就是赛博Coser这么个东西,为什么这个赛博Coser能突然爆火成为开车群里面的Top1话题,究其原因还是满足了人们的对于二次元角色出现在三次元时形象的幻想。


这个由AI画出来的真实系人物形象满足了大部分该游戏玩家对于这一角色在三次元形象的想象,其真实程度以至于连视频平台官方都被迷惑了。
直到这件事情火出圈后人们才发现,原来AI不只是可以画漂亮的动漫小姐姐了,而是可以”造人“了。
而回到这篇文章的标题,想要“遇见”只属于自己的女神一点也不难,现在的模型网站上有着大量基于特定游戏动漫人物角色训练的Lora。
这里我用我最爱的八重神子作为演示案例,首先我找一张八重神子的图片,然后用Tagger功能反推出这张图片的大部分特征。

然后用这组反推的提示词直接出图看看效果

即使是提示词已经蛮具体的情况下,AI还是无法完全正确地还原我老婆的形象。
这个时候就需要用到Lora了,这里我用的是一个插画风格的模型:

添加上我下载的Lora作者提供的Trigger Word以及在底下选择上Lora模型。

这样一来生成的图片就比之前生成的更像是我老婆了。
究其原因就是这个Lora是基于很多个这个角色图片作为素材训练出来的,AI就会在训练的过程中记住这个角色的特征。
例如狐狸耳朵、粉色头发、别致的头饰、摄人心魂的眼眸、飘逸的长发、端庄典雅的形象构成了独一无二的八重神子。AI所知道的粉色头发有很多种,而Lora则是让我把带有狐狸耳朵的八重神子同款粉色头发拍到了AI脸上告诉它八重神子长这样。

接下来就是如何将我的老婆带到三次元中,之前也说过模型根据素材来源的不同也分为二次元、真实系和2.5D风格。
所以在这里就切换一个真实系的模型就可以,当然提示词最好加上**best quality, masterpiece, ultra high
res,(photorealistic:1.4), raw
photo,**这些可以帮助AI提高成品真实感的词。并且提高图像的分辨率有助于成品的质感,之前提到过的所有高分辨率提升手段都可以。
点击一下生成

这样一来我的八重神子老婆就来到了三次元啦!

其实归根结底就是一个真实系的大模型+特定角色LoRa就可以得到这个角色的真实形象。
这只是一个简单的操作示范,实际上要让一张图片能够成功骗过我父母的眼睛还需要不断地优化、提示词筛选调整等等。
还有一种情况是自己喜欢的角色太过冷门以至于在网上还找不到其对应的模型,这要么只能请大佬做要么只能自己来训练模型。
除了针对某一个角色形象以外,还有一种Lora来展示某一类形象,例如汉服类Lora

这实现的是一个大方向上的整体美化,绘制出来的人物角色都会穿着中华传统服饰。
当然还有类似带有亚洲女性面孔特征的Lora等,这些Lora都可以在打造赛博Cos的时候作为调味剂添加。
2.Style风格/画风
之前有提到过Hypernetwork超网络用于特定风格的塑造,但是在Lora诞生之后创作者们可以通过投喂大量同一风格的作品来训练出模型。

在AI绘画中当然可以同时使用多个Lora,一个用于实现人物形象的描绘,另一个用于整体画风的调整。
但是画风类Lora会对整个画面的影响更大,所以需要稍微降低一些权重。
这个蝴蝶花丛围绕着的画风再放到我的八重神子老婆上会是什么样的效果?
就变成了这般惹人怜爱的模样,这就是通过Lora实现画风上的转变。
基于不同的作品和艺术家概念训练,可以将这些艺术风格精髓给更好地保留下来。

3.Concept概念
这一点要描述比较难,有点像是某种特定画风或实现形式+形象的结合体。

这个是基于大量游戏角色模型中的三视图做成的模型,用了这个模型后无论是什么角色最后产出的图都会变成例图中的三视图样式。
这类概念Lora会实现某种特定形式输出,所以对提示词和参数的设置要求都会比较高。

在开始做图前最好都读一下下方的作者留言,一般作者会在这里讲解采样器、提示词等其它参数的设置,并且最好参考例图的信息。

像是这种其实不好说是一种准确的画风,但是看到成品都能够接收到作品想要表达的信息。
4.Clothes服饰
这一种其实就是通过Lora来定义角色人物身上的服饰,服饰在概念上就是具体到衣服、裤子、鞋子、袜子之类的实现。
大部分常规服饰可以在基础模型上直接用提示词绘画出来,但是有些独特且与众不同的服饰就可以通过Lora实现。
例如机甲+女孩子=男孩子的梦中情人。

在模型网站上用Mecha作为关键词可以找到很多关于机甲的Lora,如果要增强机甲这一元素,可以在已有的提示词上增加诸如cyberpunk,
futuristic 这类提示词作为辅助,如果想要那种机甲与人结合的义肢的感觉可以加上robotic arms/legs, mechanical
parts 之类的提示词。

这样一个机甲少女的形象就出现啦!

搭配这个Lora的Checkpoint有两个不错的选择,一个是二次元画风的CetusMix

另一个是带点科幻色彩的Experience

5.Objects元素
在搜索栏筛选Object类Lora时可以发现大部分的都是某一具体元素的模型,例如食物、乐器等

当训练的元素泛用性较强时就会从单个或单类元素变为蓝图。

在这里我先用上一步骤所使用的机甲少女提示词和Lora生成一个写实画风的机甲少女。

然后我找到了Civitai上有一个赛博风格头盔的Lora
https://civitai.com/models/25360

我想通过局部重绘的方式将上面的这个头盔放到机甲少女头上。

这个时候我要做的首先是将成品图片发送到局部重绘里。

然后在左下方的参数中添加这个头盔的Lora,如果在下方的重绘区域选择的是整张图片,那么上方的提示词只需要加入TriggerWord和一些形容就好:cyberhelmet,
a white cyberhelmet, head, close-up,
如果选择的重绘区域是仅蒙版,那么就需要把所有的内容型提示词都去掉,只保留Lora相关部分。
绘制重绘区域时最好把整个头部都画上,并且多画一点额外的区域,这是为了给可能出现的奇形怪状头盔预留充分空间。

然后点击生成就可以看到一个帅气的头盔带在头上了,虽然我觉得还是露脸好看些。

这样的模型是针对单一对象进行训练,其涉及的也只是画面中的一部分并不会影响整个画作的框架。
这样的Lora适合在没有开启Lora的情况下先画一幅大的画作,然后开启Lora去微调画作的部分区域。
今天的内容就到这里结束啦!
Lora作为现在学习AI绘画绕不开的一个知识点,还是需要好好学会的。
毕竟学习这个之前我老以为Lora就是漂亮小姐姐模型,只要用上了这个模型我家猫都能变成猫娘。

我要去研究怎么样让我家猫变成猫娘了,等到下周一我会专门写一篇文章将目前为止讲过的所有模型整合一下放到我的网盘里。
但由于AIGC刚刚爆火,网上相关内容的文章博客五花八门、良莠不齐。要么杂乱、零散、碎片化,看着看着就衔接不上了,要么内容质量太浅,学不到干货。
这里分享给大家一份Adobe大神整理的《AIGC全家桶学习笔记》,相信大家会对AIGC有着更深入、更系统的理解。
有需要的朋友,可以长按下方二维码,免费领取!

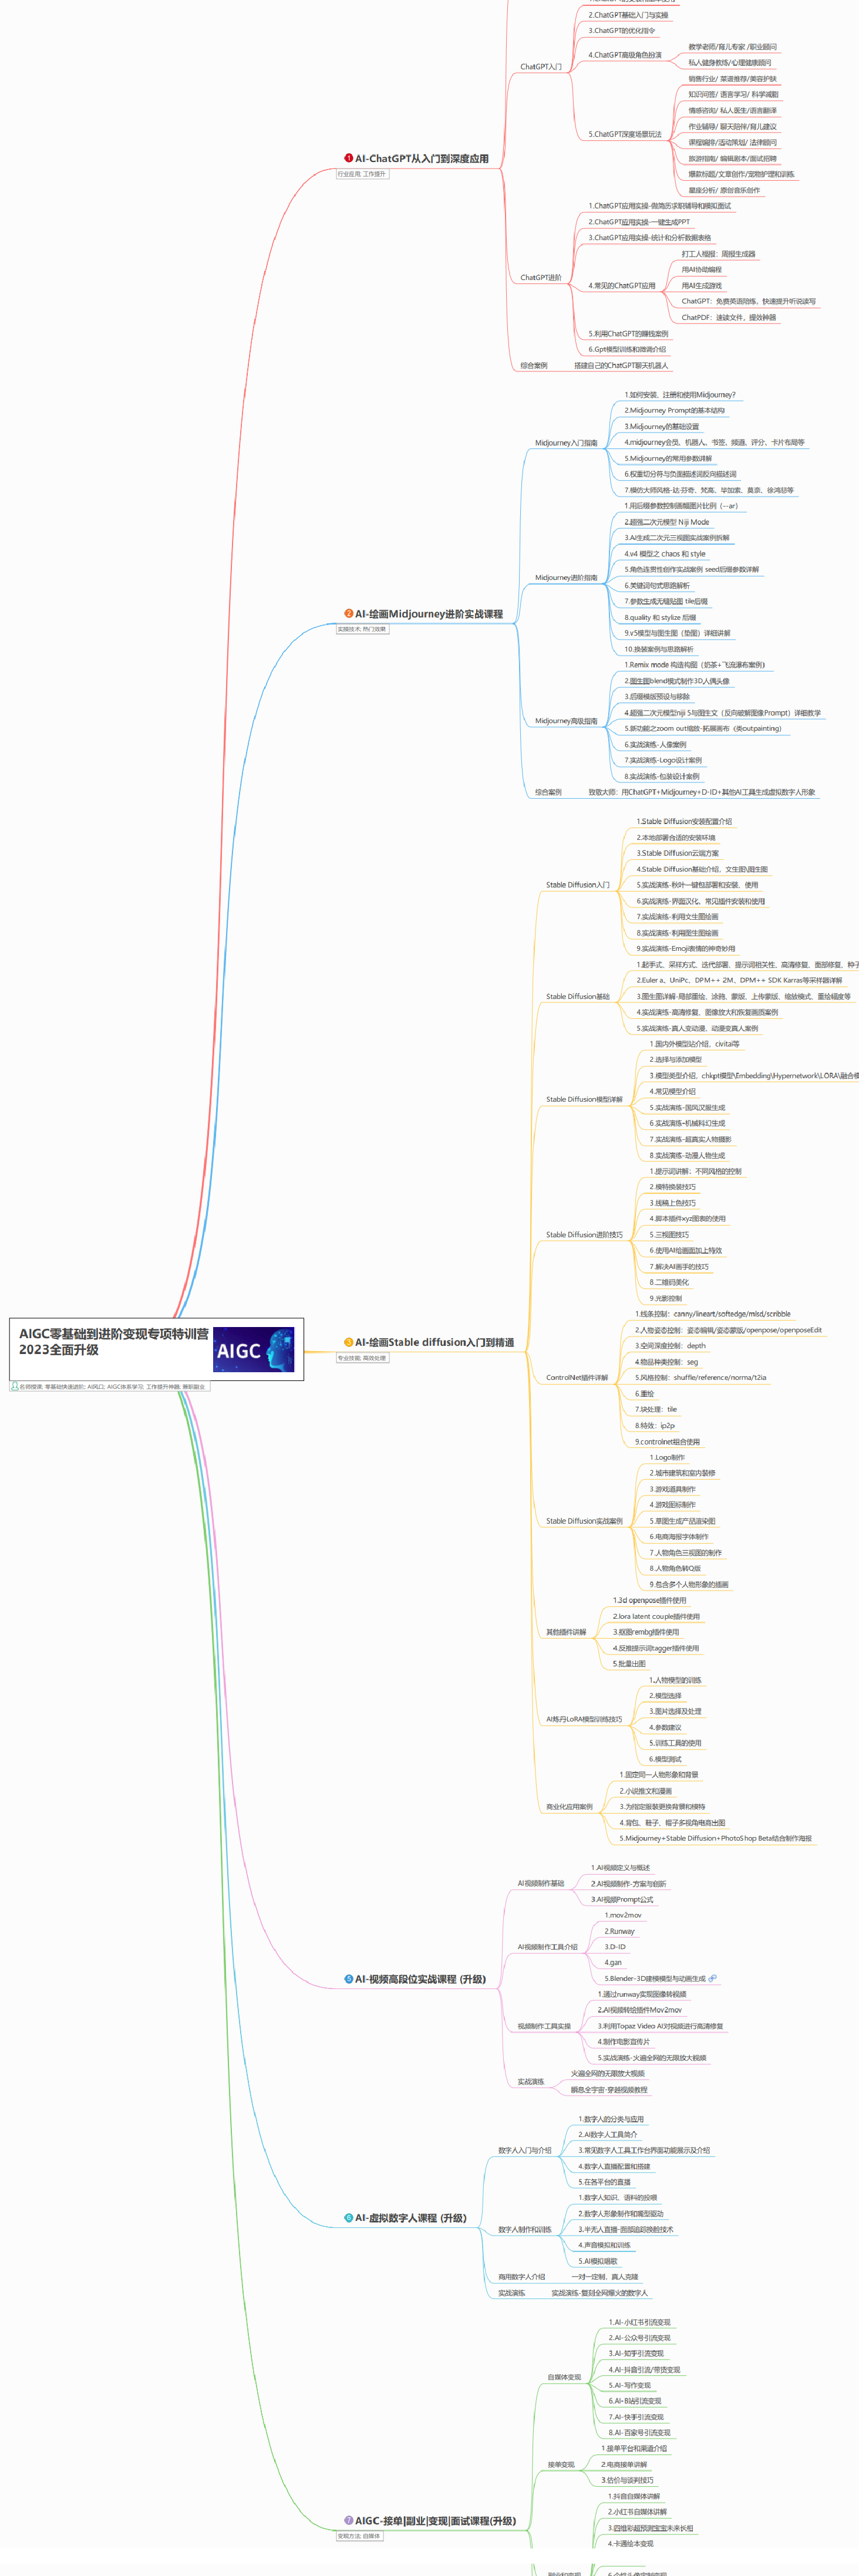
AIGC所有方向的学习路线思维导图
这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。如果下面这个学习路线能帮助大家将AI利用到自身工作上去,那么我的使命也就完成了:
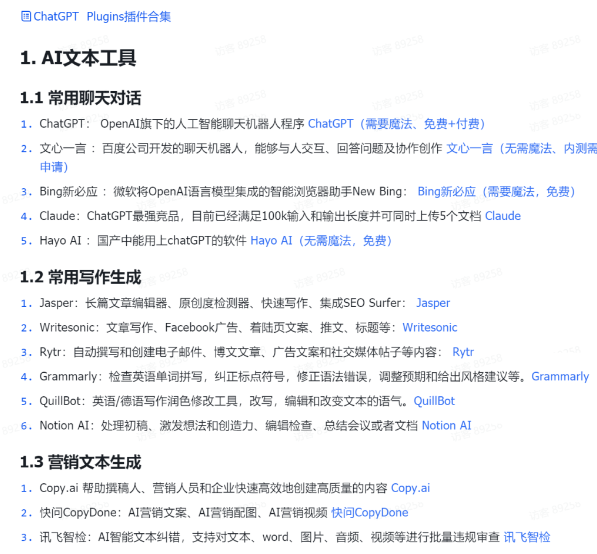
AIGC工具库
AIGC工具库是一个利用人工智能技术来生成应用程序的代码和内容的工具集合,通过使用AIGC工具库,能更加快速,准确的辅助我们学习AIGC
有需要的朋友,可以点击下方卡片免费领取!
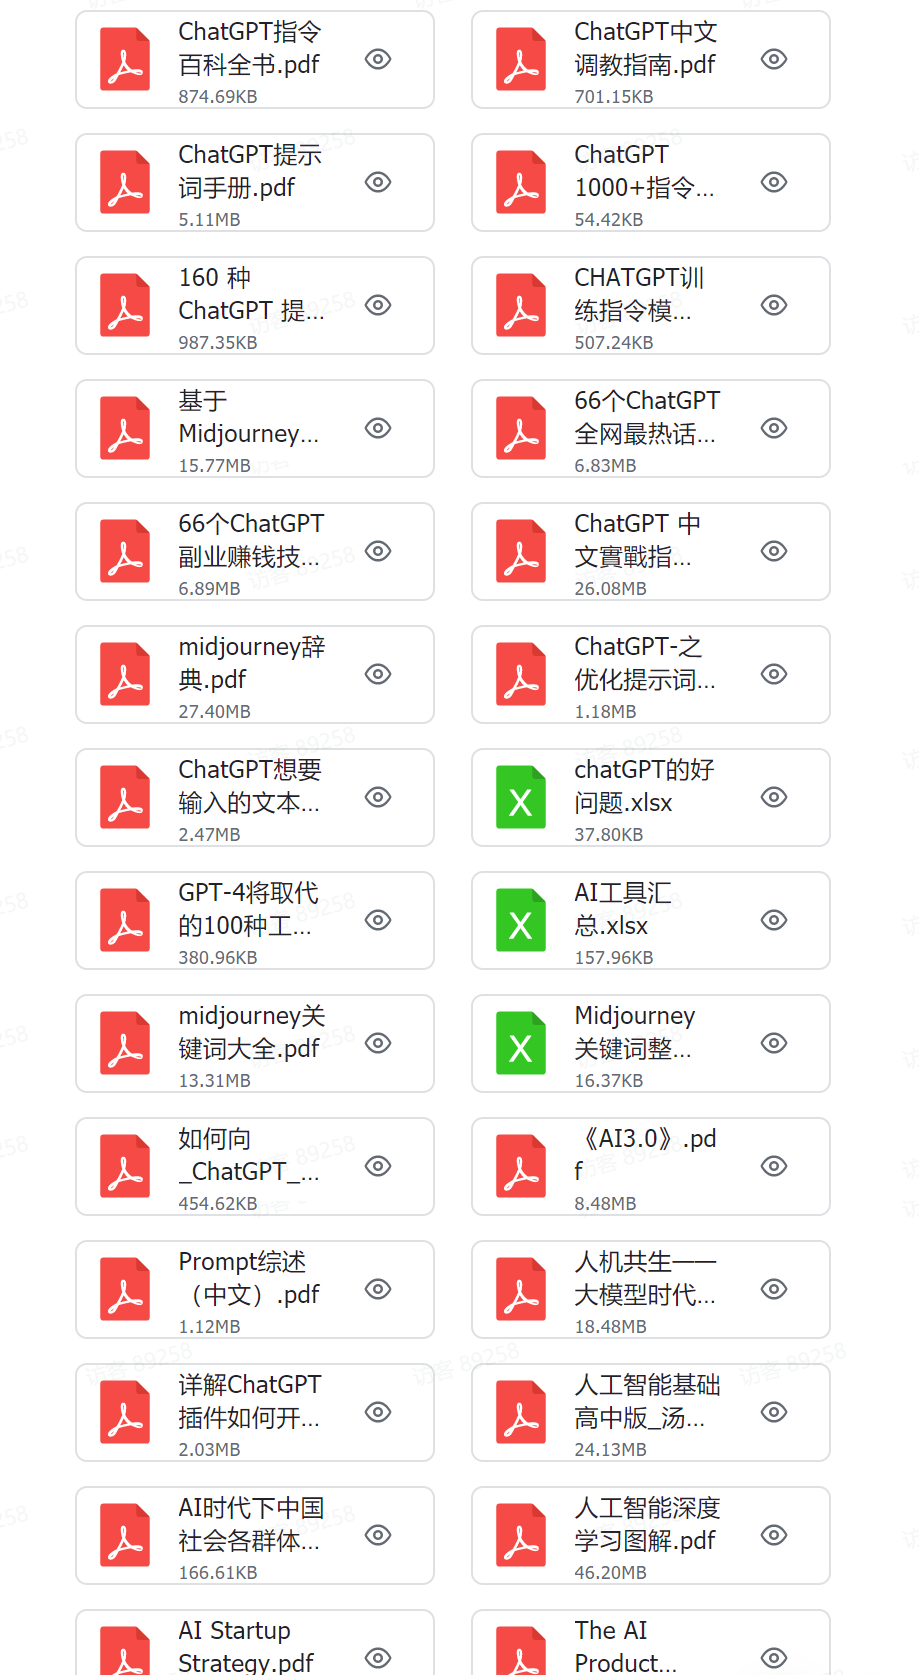
精品AIGC学习书籍手册
书籍阅读永不过时,阅读AIGC经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验,结合自身案例融会贯通。
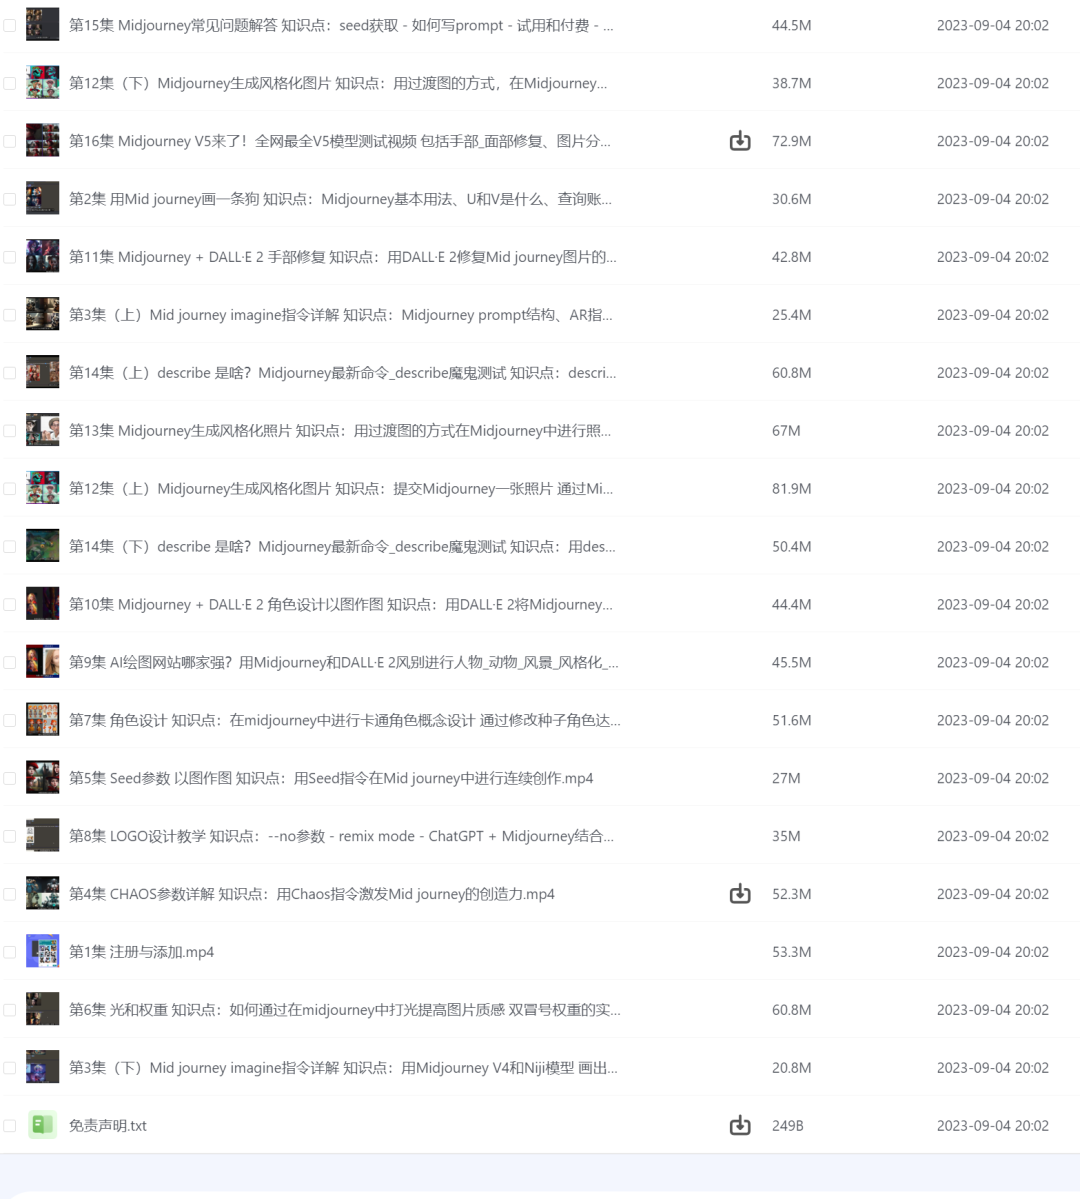
AI绘画视频合集
我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,科学有趣才能更方便的学习下去。
有需要的朋友,可以长按下方二维码,免费领取!




 1336


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


