Kafka是如何实现几十万的高并发写入

Kafka实现高并发的原理(消息中间件如何实现每秒几十万的高并发写入) Kafka: 是一个高吞吐低延迟的高并发,高性能消息中间件。配置良好的Kafka集群能够做到每秒几十万或者上百万的超高并发写入。 Produce 页缓存技术+磁盘顺序写 Kafka接收到数据的时候,都会往磁盘上去写 Page Cache 内存里面的缓存,是操作系统自己管理的缓存。 在写入磁盘文件的时候,可以直接写入到OS cache里。接下来由操作系统自己决定何时把cache里面的数据刷写到磁盘... 阅读详情

开篇

在初识kafka 一文中讲了使用MQ(消息队列)来设计系统带来的好处:业务解耦、流量削峰、灵活扩展

当下流行的MQ有很多,因为我们公司在技术选型上选择了使用Kafka,所以我就整理了一篇关于Kafka的入门知识。通过技术选型 我们对业界主流的MQ进行了对比,Kakfa最大的优点就是吞吐量高 。

Kafka是高吞吐低延迟的高并发、高性能的消息中间件,在大数据领域有极为广泛的运用。配置良好的Kafka集群甚至可以做到每秒几十万、上百万的超高并发写入。

那么Kafka是如何做到这么高的吞吐量和性能的呢?在入门之后我们就来深入的扒一下Kafka的架构设计原理,掌握这些原理在互联网面试中会占据优势

持久化

Kafka对消息的存储和缓存依赖于文件系统,每次接收数据都会往磁盘上写,人们对于“磁盘速度慢”的普遍印象,使得人们对于持久化的架构能够提供强有力的性能产生怀疑。

事实上,磁盘的速度比人们预期的要慢的多,也快得多,这取决于人们使用磁盘的方式。而且设计合理的磁盘结构通常可以和网络一样快。
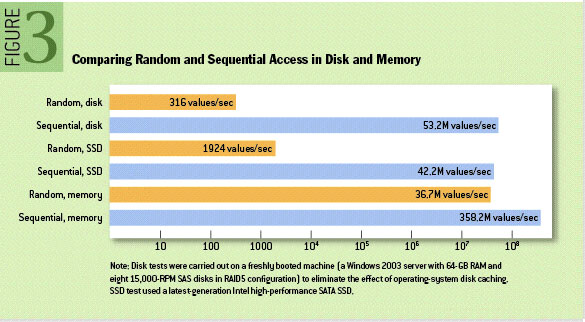
通过上图对比,我们可以看出实际上顺序磁盘访问在某些情况下比随机内存访问还要快,其实Kafka就是利用这一优势来实现高性能写磁盘

See:http://kafka.apachecn.org/documentation.html#persistence

页缓存技术 + 磁盘顺序写

Kafka 为了保证磁盘写入性能,首先Kafka是基于操作系统的页缓存来实现文件写入的。

操作系统本身有一层缓存,叫做page cache,

字节面试官: 让你设计一个MQ每秒要抗几十万并发,怎么做? Kafka是高吞吐低延迟的高并发、高性能的消息中间件,在大数据领域有极为广泛的运用。配置良好的Kafka集群甚至可以做到每秒几十万、上百万的超高并发写入。 阅读详情

相关推荐

大数据架构Kafka如何实现每秒上百万的高并发写入?

篇文章来聊一下kafka的一些架构设计原理,这也是互联网公司面试时非常高频的技术考点。 Kafka是高吞吐低延迟的高并发、高性能的消息中间件,在大数据领域有极为广泛的运用。配置良好的Kafka集群甚至可以做到每秒几十万、上百万的超高并发写入。 那么Kafka到底是如何做到这么高的吞吐量和性能的呢?这篇文章我们来一点一点说一下。 一、页缓存技术 + 磁盘顺序写 首先Kafka每次接收到数据都...

程序员生活网 1681

RocketMQ每秒要写入几十万并发,是怎么实现的?

Kafka是高吞吐低延迟的高并发、高性能的消息中间件,在大数据领域有极为广泛的运用。配置良好的Kafka集群甚至可以做到每秒几十万、上百万的超高并发写入。

石杉的架构笔记 784

JAVA面试相关六(kafka如何实现高并发消息推送)

今天把这两天学习的kafka知识点做一下整理,供大家参考。 1什么是kafka Kafka是分布式发布-订阅消息系统,它最初是由LinkedIn公司开发的,之后成为Apache项目的一部分,Kafka是一个分布式,可划分的,冗余备份的持久性的日志服务,它主要用于处理流式数据。 2kafka的特点 - 高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒,每个t...

进击的烧饼 2714

Hand-Eye 标定误差分析:从理论到 C++ 实现

本文深入探讨了机器人手眼标定中的核心环节——误差分析。文章从AX=XB方程的理论残差出发,详细解析了旋转与平移误差的数学定义与物理意义,并提供了一个工业级的C++实现代码,用于计算重投影误差。通过误差分析,工程师可以量化标定精度,诊断问题根源,从而确保视觉引导机器人系统在实际应用中的可靠性与精确性。

c7d8e的博客 698

电赛2024年H题智能小车基于MSPM0G3507主控MCU(利用8路灰度加上MPU6050的解决方式)

最后我觉得这个项目最重要的部分还是陀螺仪的精准度,如果一个陀螺仪的精准度高,这个项目就十分简单了,像mpu6050这种陀螺仪精准度就稍微差了一点,他有个最严重的问题就是温漂,偏航角会随着温度变化为变化,这一点在跑发挥项一的时候十分关键的,因为这个只差基督就会导致车子跑偏,导致无法完成 整个项目。如果条件足够的话建议可以换一个好一点的陀螺仪,然后就是灰度如果没有条件同样也可以换成红外。以上就是本次项目的一些小建议。

weixin_60991529的博客 6244

set_data_check专题[使用,report_timing,setup/hold检查]

set_data_check用于约束『数据-对-数据』的『建立保持』时间检查,通常被称为非时序约束 ( non-sequential constraints ), 理论上set_data_check 可以设在任意的两个data pin 上,其中一个pin 称为 constrained pin 类似于寄存器的data pin, 另一个pin 称为related pin 类似于寄存器的clock pin.

cy413026的博客 1万+

同步辐射材料科学应用指南:从XAFS原位实验到数据处理

材料结构分析是材料研究的核心环节,但传统实验室X射线受限于能量固定、亮度不足,往往难以回答原子局域配位、非晶结构及动态演变等关键问题。同步辐射光源以高通量、连续可调、偏振可控及脉冲时间结构等特性,将材料表征从静态观察推进到原位动态追踪层次。基于X射线吸收精细结构谱(XAFS)、原位实验、X射线衍射与散射、微区成像等技术,研究人员可实现元素选择性分析、近邻原子环境解析及真实工况下的结构演变监测。本文从技术原理出发,覆盖实验方案设计、样品制备、现场对光、数据处理与常见故障排查,并结合典型应用场景,为材料科学领域

weixin_32612263的博客 181

45、概率与模糊性:粗糙事件与模糊事件概率的探索

本文探讨了概率理论与模糊性理论在处理现实世界不确定性中的应用,重点分析了模糊事件和粗糙事件的概率定义、性质及其条件概率。同时,介绍了近似贝叶斯网络分类器在信息系统中的应用,以及如何通过概率决策约简提高分类效率。这些方法为处理不确定信息提供了灵活的工具,并在决策和数据分析中具有重要价值。

ik67890123的博客 135

数据治理路径之辩:从“先治后用”到“边用边治”,企业如何选择最优路径?

数据治理是企业在数智化建设中的核心挑战,主要涉及三种时序策略:先治理后使用、先用后治理和边用边治。先治理后使用强调在数据应用前建立完整的治理框架,适合高合规要求的行业,但可能响应滞后。先用后治理则优先释放数据价值,适合快速变化的业务环境,但可能累积数据质量问题。边用边治寻求动态平衡,通过持续改进实现治理与应用的同步迭代,适合复杂数据环境。技术选型决策矩阵和实施方法论提供了具体的操作指南,建议根据组织特性和业务需求选择适配方案,并通过渐进式演进路径实现治理与业务的共生演进。

石榴姐yyds 409

一文搞定 ST22 短转储 MEMORY_NO_MORE_PAGING:看懂 SAP Paging 机制,参数 rdisp/PG_SHM 与 rdisp/PG_MAXFS 怎么设才稳

SAP系统MEMORY_NO_MORE_PAGING错误通常源于Paging资源耗尽而非物理内存不足。关键排查点包括:通过ST22确认错误类型,ST02监控Paging使用情况,检查工作进程trace中的"no more free blocks"提示。解决方案建议将rdisp/PG_SHM和rdisp/PG_MAXFS设为相同值(如250000块≈2GB),使Paging完全在内存中运行。同时需优化易耗Paging的代码逻辑,如避免滥用EXTRACT命令和超大内存对象传输。典型案例如月末

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 336

2026 年 3 月青少年软编等考 C/C++ 三级测试题解析

摘要 本文包含三部分内容: 单选题(10题):考察C++基础语法和数据结构知识,涉及vector、栈、队列的操作和特性。 判断题(10题):测试对动态数组、栈、队列、字符串操作的理解,包括内存管理、访问方式和函数返回值等。 编程题(1题):模拟火车站售票窗口排队场景,要求根据输入输出各窗口的排队情况,重点考查队列的实际应用和边界条件处理。 答案解析详细,涵盖常见编程考点,适合检验基础知识的掌握程度。

发布少儿编程考级的真题和优秀竞赛题解析,以及一些讲义。 254

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

上一篇: 数据库缓存最终一致性的四种方案
下一篇: 集群、限流、缓存 BAT 大厂无非也就是这么做
JavaMonsterr
博客等级 码龄4年 211粉丝 481原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
