


训练数据正在成为大模型竞争的关键变量。当参数量不再是唯一壁垒,数据的质量、结构与任务适配性,开始决定模型在推理、代码、交互等维度上的真实表现。
NVIDIA 推出的 Nemotron 系列数据集,正是顺应这一趋势构建的数据资源体系。其包含超过 10T tokens 和 40M 条后训练样本,覆盖从基础模型到智能体工作流的完整训练生命周期。不同于传统预训练数据对规模的单一追求,Nemotron 系列更强调对不同能力维度的针对性覆盖,每个数据集都对应模型能力建设中的一个具体环节。
本文整理的 15 个 Nemotron 系列数据集,覆盖了当前大模型训练中的几个核心能力方向:通用文本预训练、监督微调(SFT)、代码生成、数学推理以及多语言 Persona 对话数据,为模型从基础能力构建到任务能力优化提供了系统性的数据支撑。
从这些数据集的设计思路可以看到一个明确的变化:大模型训练正在从「用更多数据训练更强的模型」,转向「用更精准的数据训练更适配的模型」。Nemotron 系列的做法正是这一趋势的缩影。这意味着,训练数据的设计能力,正在成为决定模型能力上限的关键变量。
以下数据集均已收录于 HyperAI(hyper.ai),希望为大模型研究者与开发者提供一份系统的数据资源参考。
更多优质数据集:
数据集推荐
1.Nemotron-CC-v2 预训练数据集
* 在线使用:
Nemotron-CC-v2 pre-training Dataset | Datasets | HyperAI
Nemotron-CC-v2 是由英伟达于 2025 年发布的基于 Nemotron-CC 的后续版本,相关论文成果为「NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model」。
该数据集在原有英文网页语料基础上,新增了 2024–2025 年的 8 个 Common Crawl 快照,并进行全局去重与英文过滤;同时使用 Qwen3-30B-A3B 对网页内容进行合成重述,并补充多样化问答(Diverse QA),进一步翻译到 15 种语言,用于强化多语言逻辑推理与通用知识预训练。其意义在于将「高质量英文网页 → 合成多样化问答」的有效做法,结合更新的网页抓取与多语言扩展系统化推到新阶段,并通过严格去重、过滤与可复现的发布,便于直接集成到各类预训练管线。
2.Nemotron-Pretraining-SFT 监督式微调数据集
* 在线使用:
Nemotron-Pretraining-SFT-v1 Supervised fine-tuning Dataset | Datasets | HyperAI
Nemotron-Pretraining-SFT-v1 是英伟达于 2025 年发布的一个合成生成数据集,相关的论文成果为「NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model」,旨在强化模型在指令跟随、推理、代码与通识问答等任务上的能力。
该数据集面向 STEM 、学术、逻辑推理与多语言场景,由高质量数学和科学素材扩展生成,并结合研究生层级的学术文本与已指令微调的 SFT 数据,构造出复杂多选题与解析题(含完整解答/思路),覆盖数学、代码、通识与逻辑推理等多类任务。 在 Nemotron 预训练数据的官方统计中,SFT 相关类别(如 Math SFT 、 Code SFT 、 General SFT)占据显著比例,便于用户按元数据筛选需要的子集进行复现实验。
3.Nemotron-Pretraining-Code 代码数据集
* 在线使用:
Nemotron-Pretraining-Code-v1 Code Dataset | Datasets | HyperAI
Nemotron-Pretraining-Code-v1 是由英伟达于 2025 年发布的一套基于 GitHub 构建的精选大规模代码数据集,相关论文成果为「NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model」。
该数据集经过多阶段去重、许可证强制执行和启发式质量检查过滤,包含 11 种编程语言的 LLM 生成代码问答对。数据不仅包含 175.1 B 高质量合成代码 Token 外,还包括元数据(约 747.4 B Token),便于用户复现。
4.Nemotron-Pretraining-Code 编程代码预训练数据集
* 在线使用:
Nemotron-Pretraining-Code-v3 Programming Code Pretraining Dataset | Datasets | HyperAI
Nemotron-Pretraining-Code-v3 是 NVIDIA 为 Nemotron 3 系列大语言模型打造的代码预训练数据集之一,旨在增强 LLM 的代码理解、生成、补全和推理能力,本数据集属于 NVIDIA Nemotron Pretraining Data 系列中的代码语料部分,相关论文成果为 Nemotron 3 Ultra: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning 。
该数据集共包含 1.463 亿个文件。数据采集截止至 2025 年 9 月 30 日,该数据集为增量版本,仅收录该系列相对于前序版本的新增源代码文件,需与 v1 、 v2 配合使用,方可构成完整的代码预训练语料库。
5.Nemotron-CC-Math 数学预训练数据集
* 在线使用:
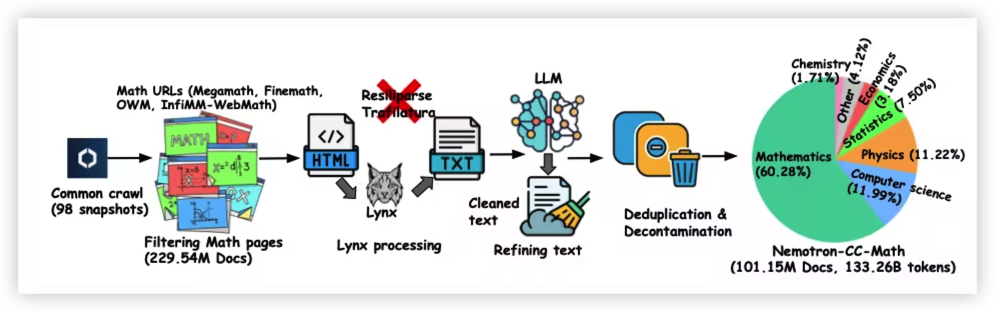
数据集构建流程
Nemotron-CC-Math 是由英伟达和波士顿大学于 2025 年发布的一个以数学为重点的高质量大规模预训练数据集,相关论文成果为「Nemotron-CC-Math: A 133 Billion-Token-Scale High Quality Math Pretraining Dataset」,旨在保存和展示高价值的数学和代码内容,从而推动下一波智能的、具有全球能力的语言模型。
该数据集包含 1,330 亿 Token,基于 NVIDIA Lynx 与轻量 LLM 的抽取与规范化管线自 Common Crawl 构建。在保留方程与代码版式结构的同时,将数学内容统一为可编辑的 LaTeX 格式,首次在 Web 规模上可覆盖多种(含长尾)数学格式;其优势已在多项基准中得到验证。
6.Nemotron-Personas-Korea 韩国合成人物数据集
* 在线使用:
Nemotron-Personas-Korea 是由 NVIDIA 于 2026 年发布的韩国合成人物数据集,旨在全面反映韩国人口的多样性和特征。该数据集是首个大规模韩语合成人物数据集,主要用于扩展主权 AI(Sovereign AI)合成数据的多样性,缓解数据与模型偏见,并提升模型响应的多样性。
该数据集包含 100 万条记录,每条记录包含 7 个虚拟人物角色,总计约 700 万个人物角色描述,共包含约 17 亿 Token,其中 10 亿 Token 为人物相关信息,数据覆盖韩国 17 个广域自治团体(시도), 252 个市郡区(시군区),包含 209,167 个唯一人名。该数据集基于韩国统计信息服务中心(KOSIS)、韩国最高法院、国民健康保险公团、韩国农村经济研究院以及 NAVER Cloud 提供的官方信息生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 19 岁以下未成年人数据。
7.Nemotron Personas France 法国合成人物数据集
* 在线使用:
Nemotron Personas France (French Synthetic Personas Dataset) | Datasets | HyperAI
Nemotron Personas France 是由 NVIDIA 联合 Pleias 公司于 2026 年发布的法国合成人物数据集,包含基于法国真实人口统计、地理和性格特征分布生成的合成人物数据,旨在通过反映法国的地理和人口分布,提供多样化的合成人物数据以支持模型开发。
该数据集包含 6,000,000 个法语人物实例,分布在 1,000,000 条记录中,每条记录提供 22 个字段(如姓名、性别、年龄、婚姻状况、职业等),包含多种人物类型(学者、体育爱好者、艺术爱好者、美食爱好者和旅游爱好者等)。
8.Nemotron-Personas-Brazil 巴西合成角色数据集
* 在线使用:
Nemotron-Personas-Brazil Brazilian Synthetic Character Dataset | Datasets | HyperAI
Nemotron-Personas-Brazil 是由 NVIDIA 联合 WideLabs 于 2026 年发布的巴西合成角色数据集,旨在展现巴西人口的多样性和丰富性,以更全面地反映多维度的潜在人口分布,包括区域多样性(如北部、东北部和中西部地区)、种族背景、教育水平及职业分布。
该数据集共有 1,000,000 条记录,每条记录包含 6 个合成人物,每条数据包括 6 个角色字段和 14 个上下文字段,这些字段在统计上基于巴西官方人口结构和劳动市场分布构建。数据覆盖巴西所有 26 个州及联邦区(Federal District)的地理和人口分布。
9.Nemotron Personas USA 美国人物画像数据集
* 在线使用:
Nemotron Personas USA (USA) Personality Dataset | Datasets | HyperAI
Nemotron‑Personas-USA 是由 NVIDIA 于 2025 年发布的一个大规模合成用户画像数据集,旨在支持大型语言模型(LLMs)和智能代理系统在对话生成、角色模拟、用户建模和多样化行为分析等任务中的训练与评测。 该数据集共包含约 100 万条虚拟人物记录,总计 600 万个 persona 字段与 16 个情境信息字段,数据覆盖美国全部 50 个州及波多黎各、维京群岛,包含 29,000 个地理邮区(ZCTA)与 15,200 个城市/区域,能够较为完整地反映美国人口在地理与社会结构上的分布。
数据集中共包含约 97 万个唯一人名,并涵盖超过 560 种职业类别,职业分布参考了真实世界职业统计数据,具备较好的社会代表性。每条数据由多维字段构成,包括年龄、性别、教育水平、收入、职业、所在地等结构化人口信息,以及兴趣、价值观、生活方式与个人目标等自然语言 persona 描述,形成结合结构化信息与非结构化文本的复合式人物画像表征。
10.Nemotron-Personas-Japan 日本合成人物数据集
* 在线使用:
Nemotron-Personas-Japan 是由 NVIDIA 于 2025 年发布的日本合成人物数据集,旨在展现日本人口多样性与丰富性,主要用于支持主权 AI 系统开发、大语言模型训练,以及降低合成数据中的偏差。
该数据集包含 100 万条记录,每条记录包含 6 个虚拟人物角色,总计约 600 万个人物角色描述,共包含约 14 亿 Token,其中 8.5 亿 Token 为人物相关信息,数据覆盖日本全部 47 个都道府县,1,500 余个职业类别及 95 万余个唯一人名,该数据集基于日本官方人口统计、地理分布及性格特征分布生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。
11.Nemotron-Personas-India 印度合成人物数据集
* 在线使用:
Nemotron-Personas-India Indian Synthetic Person Dataset | Datasets | HyperAI
Nemotron-Personas-India 是由 NVIDIA 于 2025 年发布的印度合成人物数据集,旨在通过反映印度真实的地理和人口分布,提高合成数据的多样性,减少模型偏差,并防止模型坍塌,主要用于支持印度模型开发者构建能够融入区域特定人口统计特征和文化背景的主权 AI(Sovereign AI)系统。
该数据集包含 300 万条记录,每条记录包含 7 个虚拟人物角色,总计约 2,100 万个人物角色描述,共包含约 77 亿 Token,其中 29 亿 Token 为人物相关信息,数据覆盖印度 36 个邦及联邦属地,640 个地区,包含约 56 万个唯一人名,并提供英语(English),印地语(Devanagari 天城文)及印地语(Latin 拉丁字母)3 种语言版本,每种语言版本约包含 100 万条记录。该数据集基于印度 2011 年人口普查及选举名册等真实人口统计与地理分布信息生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。
12.Nemotron-Personas-Belgium 比利时合成人物数据集
* 在线使用:
Nemotron-Personas-Belgium (Belgian Synthetic Human Dataset) | Datasets | HyperAI
Nemotron-Personas-Belgium 是由 NVIDIA 联合 Pleias 与 KU Leuven 于 2026 年发布的比利时合成人物数据集。旨在全面反映比利时人口的多样性和特征,主要用于扩展主权 AI(Sovereign AI)合成数据的多样性,缓解数据与模型偏见,并提升模型响应的多样性。
该数据集包含 120 万条记录,每条记录包含 6 个虚拟人物角色,总计约 180 万个人物角色描述,共包含约 19 亿 Token,其中 8.67 亿 Token 为人物相关信息,数据覆盖 581 个比利时市镇,3 个行政区,包含约 26 万唯一人名,并提供荷兰语、法语、德语、英语 4 种语言版本,每种语言版本包含 30 万条记录。该数据集基于基于比利时 2021 年人口普查数据及 2025 年人口结构数据信息生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。
13.Nemotron-Personas-Vietnam 越南合成人物数据集
* 在线使用:
Nemotron-Personas-Vietnam (Vietnam Synthetic Person Dataset) | Datasets | HyperAI
Nemotron-Personas-Vietnam 是由 NVIDIA 于 2026 年发布的越南合成人物数据集,旨在全面反映越南人口的多样性和特征,主要用于支持越南主权 AI 模型开发,缓解数据偏差并提升模型在越南文化语境下的响应多样性。
该数据集包含 10 万条记录,每条记录包含 6 个虚拟人物角色,总计约 60 万个人物角色描述,共包含约 1.18 亿 Token,其中 5,200 万 Token 为人物相关信息,数据覆盖越南 6 个中央直辖市和省份,包含约 1.3 万个唯一人名。该数据集基于越南官方统计数据和 FPT 集团提供的本地化专家知识生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。
14.Nemotron-Personas El-Salvador 萨尔瓦多合成人物数据集
* 在线使用:
Nemotron-Personas-El-Salvador Salvador Synthetic Human Dataset | Datasets | HyperAI
Nemotron-Personas-El-Salvador 是由 NVIDIA 于 2026 年发布的萨尔瓦多合成人物数据集,该数据集旨在全面反映萨尔瓦多人口的多样性和特征,主要用于支持萨尔瓦多主权 AI 模型开发,缓解数据偏差,以及提升模型在萨尔瓦多文化语境下的响应多样性。
该数据集包含 14.8 万条记录,总计约 100 万个人物角色描述,共包含约 3 亿 Token,其中 1.61 亿 Token 为人物相关信息,数据覆盖萨尔瓦多 14 个省及 44 个市,包含约 14.4 万个唯一人名。该数据集基于萨尔瓦多 2024 年第七次人口普查与第六次住房普查的真实人口统计学、地理分布及职业统计数据生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。
15.Nemotron-Personas Singapore 新加坡合成人物数据集
* 在线使用:
Nemotron-Personas-Singapore 是由 NVIDIA 于 2026 年发布的新加坡合成人物数据集,旨在反映新加坡真实世界人口、地理与性格特征分布。主要用于支持主权 AI 系统的开发,提升合成数据的多样性、缓解模型偏差并防止模型坍缩。
该数据集包含 14.8 万条记录,每条记录包含 6 个虚拟人物角色,总计 88.8 万个人物角色描述,共包含约 1.18 亿 Token,其中 4,800 万 Token 为人物相关信息,数据覆盖新加坡 55 个规划区,包含约 14.6 万个唯一人名。该数据集基于新加坡统计局 2024 年人口普查、国家图书馆管理局(NLB)姓名授权数据及建屋发展局(CEA)提供的官方信息生成,所有角色均为完全虚拟生成的人物,不对应任何真实个人身份信息,同时排除了 18 岁以下未成年人数据。

 113


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


