OCR 教程汇总丨覆盖长文档/端到端/多语言,百度/小红书/华中科大等面向不同场景开源高性能模型,实现多模态文档精准解析

告别报错!Win10下Autodock Vina 1.2.3保姆级安装与避坑指南 本文提供了Win10系统下Autodock Vina 1.2.3的完整安装与实战指南,涵盖环境配置、分子文件预处理、对接参数优化及结果分析等关键步骤。通过详细的避坑技巧和优化方案,帮助用户高效完成分子对接任务,特别适合生物信息学研究人员和药物发现领域的初学者。 阅读详情

在大模型快速发展的今天,大量信息虽然被数字化保存,却往往只是图片或扫描文件,无法被搜索,更无法直接进入 AI 工作流。如何将这些视觉数据转化为机器可理解的信息?OCR(Optical Character Recognition,光学字符识别)正是其中的关键技术。

近年来,多模态模型的发展正在重新定义 OCR 的能力边界。新一代视觉语言模型开始将文字识别、版面分析、信息抽取和内容理解融合到同一系统中,使 OCR 从传统的信息采集工具,逐渐演变为连接视觉数据与智能应用的重要入口。这一变化正在推动 OCR 在科研、金融、医疗和AI Agent等更多领域落地。

与此同时,开源生态的发展也让 OCR 技术更加易用。从通用文本识别到复杂文档解析,从多语言处理到结构化内容生成,不同方向的 OCR 模型正在针对细分场景持续优化。本文精选 5 项具有代表性的开源 OCR 模型,覆盖文档解析、复杂版面理解、多语言识别、手写文字处理以及结构化输出等多个方向。

HyperAI官网(hyper.ai)教程板块已整理多款 OCR 开源模型实践内容。本文将系统梳理这些模型的特点与应用场景,帮助开发者快速了解当前 OCR 技术生态,并选择适合自己的解决方案。

点击查看更多优质教程:

https://hyper.ai/notebooks

1.Unlimited-OCR 一键部署长文档 OCR 与版面解析

在线运行:Unlimited-OCR:一键部署长文档 OCR 与版面解析 | 教程 | HyperAI超神经

Unlimited-OCR 是百度团队于 2026 年 6 月发布的 OCR 及文档结构解析项目。该项目主要面向长文档 OCR 识别和结构化文档解析场景,核心目标是在长上下文或多页文档环境下,保持OCR 识别过程的稳定性和效率。

该模型针对实际的文档处理任务进行了设计,包括文本检测、结构化 OCR 输出、文档布局识别、PDF 页面解析以及 Markdown 格式结果汇总。与传统的单张图片 OCR 处理方式相比,Unlimited-OCR 在处理长文档、演示文稿、扫描报告以及多页 PDF 文件时更具优势。

2.Chandra-ocr-2 数学/表格/手写精准转结构化内容

在线运行:https://go.hyper.ai/zpuqa

Chandra-ocr-2 是由 Datalab 团队于 2026 年 3 月开发的新一代光学字符识别(OCR)系统,专注于复杂场景下的文本识别与结构化输出。该模型基于先进的视觉语言预训练技术(Vision-Language Pre-training)进行优化,具备多场景文本识别能力、结构化输出能力、高效推理性能、智能图像预处理、灵活的Prompt系统和简洁的交互式界面七大核心优势。

在实际应用中,Chandra-ocr-2 在多个领域提供了技术支持:文档数字化功能能够快速从扫描资料提取文本内容;在教育领域,该系统支持识别试卷内容、题目录入等任务;在科研领域,可以帮助研究人员提取论文图片和图表中的文字信息;开发者则可将该系统集成到自动化的文本提取工作中。

3.dots.mocr 多模态文档解析教程

在线运行:https://go.hyper.ai/JQt6b
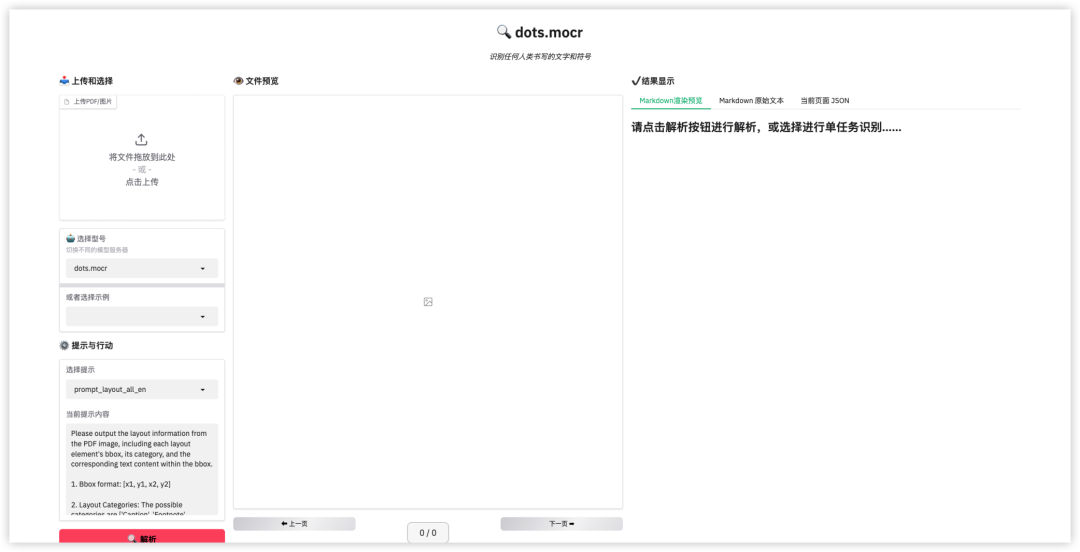
dots.mocr 是由华中科技大学与 Rednote HI-Lab 团队于 2026 年 3 月联合发布的一款多模态 OCR 文档解析模型。该模型在处理多语言文档解析任务时达到了 SOTA 水平。其主要技术特点为多语言支持、结构化解析、将图形转换为 SVG 格式、场景文本检测和网页解析。

除了文档解析能力外,dots.mocr 还具备强大的结构化图形理解能力,能够将图表、UI布局、科学示意图等视觉内容直接转换为 SVG 代码。在通用视觉任务上,dots.mocr 保持了与 Qwen3-VL-4B 相当的性能表现。

4.Qianfan-OCR 端到端文档智能模型

在线运行:Qianfan-OCR:端到端文档智能模型 | 教程 | HyperAI超神经

Qianfan-OCR 是由百度智能云千帆团队于 2026 年 3 月开源的一款端到端文档智能模型。该模型基于 40 亿参数(4B)的视觉语言处理架构,融合了文档解析、布局分析、文本识别和语义理解等功能。该模型通过提出「布局即思考」(Layout-as-Thought)机制,实现了对文档布局结构的显式建模,并支持复杂表格、图表等内容的理解与解析。

在 OmniDocBench v1.5 评测中,Qianfan-OCR 以93.12 分的成绩位列端到端模型之首。在关键信息提取领域的多个公开排行榜上,Qianfan-OCR 的总分也超过了 Google Gemini 3-Pro 等商业模型。

5.FireRed-OCR 文档结构解析模型

在线运行:https://go.hyper.ai/awl4v

FireRed-OCR 是由 FireRedTeam 于 2025 年 12 月发布的一款结构化 OCR 项目。该项目的核心目标是将复杂文档图像解析为高质量、结构化的 Markdown 输出。不同于传统的「检测+识别+布局分析」处理流程,FireRed-OCR 更注重对文档整体的理解,能处理多栏排版、表格、公式与图文混排内容。此外,该工具还支持直接导出 Markdown 文件,方便后续编辑、发布和迁移。

在实际应用中,FireRed-OCR 适用于论文、教材、扫描文档、产品手册、企业业务归档等场景,可快速将图片或扫描件转换为可编辑、可发布的结构化文档。用户可通过官方提供的 Gradio Space 在线交互界面完成「上传→生成→预览→导出」一系列操作,直观看到转换效果并下载结果,减少人工整理成本。

精雕软件(JDpaint) 5.5 绿色版 精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版 立即下载

相关推荐

SimpleFOC STM32实战:基于F103与HAL库,剖析速度环与电流环的协同控制

本文详细介绍了基于STM32F103与HAL库的SimpleFOC实战应用,重点剖析速度闭环控制与电流环的协同工作原理。通过开发环境搭建、参数调试技巧及性能优化方案,帮助开发者高效实现无刷电机精准控制,适用于机器人、无人机等高精度应用场景。

weixin_29170327的博客 476

顶级OCR开源模型!!!开源、免费、强大、易用

Chandra OCR 2是一款开源先进OCR模型,可将图像/PDF转换为结构化Markdown/HTML/JSON,完整保留布局信息。其核心优势包括:精准处理复杂表格、表单、手写内容和数学公式;支持90+种语言;提供三种结构化输出格式。在性能测试中超越多个知名OCR模型,成为开源领域SOTA。采用4B参数多模态架构,支持vLLM和Hugging Face两种推理方式,安装部署简便。适用于科研教育、企业文档处理、文化遗产数字化等场景,GitHub已获8.5k+星。

专注分享原创技术干货。大厂资深架构师,多年技术架构与技术管理经验,多年面试官经验。一对一技术指导培训,带你从小白到入门到架构设计到技术管理。关注我,免费领取学习资料。一对一免费面试指导,快速拿offer。 557

逆向解析M团外卖mtgsig与waimai_sign加密参数实战指南⊙ω⊙

本文详细解析了M团外卖App中mtgsig与waimai_sign两个核心加密参数的逆向分析与生成方法。通过抓包定位、静态逆向与Frida动态调试,拆解了waimai_sign的RSA签名逻辑与mtgsig的复杂参数组装加密流程,并提供了Python模拟实现的框架与调试心得,为安全研究及合规数据分析提供实战指南。

weixin_29327525的博客 1283

图片 OCR 转 Word API:输入二选一、DOCX 和私有文件下载

图片 OCR 转 Word API 通过 POST 识别图片文字并生成可编辑 DOCX。输入为 HTTPS 图片 URL 或 Base64,二选一。公开模式返回下载链接,私有模式返回文件标识。

DevOpenClub 专栏 246

PLL锁相环性能上不去?可能是电荷泵的电流失配在捣鬼(附Jae-Shin Lee经典方案解析)

本文深入分析了PLL锁相环性能瓶颈的根源——电荷泵电流失配问题,详细解析了Current Mismatch和Current Deviation的区别及其对系统的影响。重点介绍了Jae-Shin Lee的多级电流镜技术,该方案通过运放构建虚拟短路和四级电流镜结构,显著降低了电流失配,使参考杂散改善15dB以上。文章还提供了从仿真到流片的完整优化流程,帮助工程师系统解决电荷泵性能问题。

weixin_30684743的博客 370

【教程】BM1684X-32边缘计算盒子 网络配置教程

BM1684X边缘计算盒子网络配置教程

ShiMetaPi的博客 714

使用ocr来实现自动化脚本

自动化脚本的稳定性,很大程度上取决于“找到目标元素”这件事是否可靠。无障碍控件查找在标准 Android 应用上工作得很好,但一旦进入游戏、自绘渲染界面、Flutter 或某些加固过的应用,getUiTree返回空树或残缺节点是常有的事。控件的text和id属性不存在,findView就无从谈起。这时继续在控件查找的框架里打补丁,收益很低;更务实的做法是把定位层整体切换到 OCR,用屏幕上的文字本身作为锚点。冰狐的 OCR 接口不是单一函数,而是一组按用途分层的工具。底层是ocr()和tessOcr()

ai_coder_ai的博客 407

研发工作量科学量化评估模型:从多维系数到等级落地指南

摘要:本文提出了一套基于多维系数的科学量化评估模型,用于精准评估软件开发工作量。该模型从需求复杂度、技术难度、质量要求和依赖风险四个核心维度进行量化评估,通过系数乘积计算综合工作量。文章详细说明了各维度的系数区间划分标准,并演示了从基础工作量估算到综合系数计算的具体步骤。该模型通过结构化评估过程,将主观经验转化为客观量化指标,帮助团队提高工作量评估的准确性,增强项目交付的可预测性。其价值在于使评估过程透明化、结构化和可追溯,从而减少项目延期风险,优化资源规划。

友莘居士的博客 1684

影刀OCR功能有什么替代方案?实测三条路线,内网离线也能跑稳

试到第三款时我停下来试了蓝印RPA:它自带AI识图与OCR功能,接入了文心一言、豆包、DeepSeek、Kimi这些大模型,图片丢进去出文字,识别结果直接进变量,接着往下填表、对账、写回Excel,一整条链路不用出流程。元素获取上,它支持本地智能生成元素路径,还能AI智能优化元素路径:我用大白话描述"发票号码那个格子",直接给出稳定的xpath,不用啃语法。碰上财务系统网页改版导致元素失灵,Web元素AI自愈能自动修复元素定位,自愈更稳定,少了我半夜起来改流程的次数,降低脚本维护成本这件事是实打实的。

HAHAXX8的博客 168

Mathtype公式排版避坑指南:固定行距20磅下如何完美显示上下标(实测有效)

本文针对学术论文在固定行距20磅要求下,Mathtype公式上下标显示不全或被裁剪的问题,提供了实测有效的解决方案。文章深入剖析了固定行距与公式排版的冲突原理,并详细指导用户通过调整Mathtype的“定义间距”参数(如下标深度、上标高度),以及利用“格式化公式”功能进行批量处理,确保公式在严格遵守期刊格式要求的同时清晰完整显示。

weixin_29228203的博客 1069

避坑指南:LVGL在Arduino环境编译报错?3步搞定lv_conf.h路径问题(附ST7789屏幕调试技巧)

本文详细解析了在Arduino环境中配置LVGL图形库时,如何解决常见的“lv_conf.h file not found”编译报错问题。通过三步法:定位并复制模板文件、启用核心配置并指定路径、配置基础参数,从根本上解决路径问题。文章还结合ST7789屏幕驱动,分享了使用TFT_eSPI库进行显示适配、内存优化及背光控制等实战调试技巧,帮助开发者建立清晰、可维护的嵌入式UI工程基础。

lake5的博客 860

汽车金融 OCR 系统架构设计:从多证件识别到关联校验的技术方案

楚识科技的汽车金融 OCR 方案,有几个特点:一是证件类型覆盖全 —— 汽车金融涉及的十几种证件全部支持;二是汽车专项证件准确率高 —— 行驶证、登记证书、车辆合格证的识别准确率比通用 OCR 高很多;三是内置多证件关联校验引擎 —— 识别完自动比对,有问题自动标记;四是和主流风控系统无缝对接 —— 开箱即用,不用二次开发。

qq_34572574的博客 280

智能门禁:AI Agent的访客意图识别

随着人工智能技术的飞速发展,智能门禁系统已经成为现代安全管理的关键环节。本文深入探讨了AI Agent在访客意图识别中的应用,通过详细的分析和实例讲解,揭示了智能门禁系统的核心工作原理、算法实现及其在安全领域的重要作用。文章结构清晰,逻辑严谨,旨在为广大技术爱好者提供一次全面的技术盛宴。在当今社会,门禁系统已成为各类建筑和机构不可或缺的安全设施。随着信息安全意识的增强,传统门禁系统的局限性逐渐显现。例如,在访客管理方面,传统方法通常依赖于人工登记、身份验证等手段,不仅效率低下,而且容易出现漏洞。

AI架构师小马 708

报结构化提取工程落地:别把复杂报表识别等同于通用 OCR

从工程架构上看,成熟的财报识别系统,是一套多阶段流水线,而不是端到端单模型。以东北证券这份合并资产负债表为例,报表采用左右分栏布局,左侧资产、右侧负债及股东权益,大量 “其中:客户备付金” 这类二级缩进子科目,还有证券行业独有的结算备付金、代理买卖证券款等科目,加上红色公章遮挡、跨页拆分、无线表格等干扰项。但对于开发者来说,要清醒认知:财报识别不是一个开箱即用的 OCR 能力,它是视觉、NLP、财务规则三者结合的垂直工程,版式还原、科目对齐、勾稽校验,每一环都决定方案能不能在金融生产环境稳定跑起来。

OCR_13371621275的博客 186

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

使用PaddleOCR和OpenCV5实现OCR

本文介绍在OpenCV 5环境下绕过依赖限制,直接使用OpenCVSharp与OnnxRuntime调用PaddleOCRv5模型实现文字检测与识别的方法。通过加载det.onnx(检测)和rec.onnx(识别)模型,结合ppocrv5_dict.txt字典,实现了对证件类图像的高精度文字识别,识别结果包含文本内容及置信度,效果良好,适用于多场景OCR应用。

lweiyue的专栏 193

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

发票识别技术通过图像预处理、区域检测、表格解析、内容识别、语义校验与结构化输出,突破传统OCR局限,精准提取发票信息

发票识别技术通过“六步流水线”实现智能处理:图像预处理、区域检测、表格解析、内容识别、语义校验与结构化输出,突破传统OCR局限,精准提取发票信息。支持30余种票种,应对折痕、遮挡等复杂场景,准确率超99%,可批量处理、自动验真,广泛应用于报销、财务自动化、税务合规等领域,显著提升效率,让财务工作从繁琐录入中解放。

智能图像识别 352

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

鸿蒙端侧OCR实战:Core Vision Kit离线文字识别

拍发票自动提金额、拍名片秒存通讯录、拍书页转纯文本——OCR(光学字符识别)是移动端最高频的 AI 能力之一。常见做法是调云端 API:图片上传、服务端识别、结果返回。(图片出设备)、(网络往返)、(按次计费)。——模型直接跑在端侧,不依赖网络、数据不出设备、免费调用。对开发者来说,集成成本还极低:一个 Kit 导入、一次 Promise 调用就能拿到带坐标的识别结果。这篇文章把从选图到解析结果的完整链路讲清楚。

qq_63223749的博客 578

刷新 OCR 能力效率双 SOTA!面壁智能MiniCPM-OCR系列开源模型上线魔乐社区

作为 MiniCPM 家族的首个 OCR 专用模型,MiniCPM-OCR 1.0 仅以 1.3B 的端侧轻量化体量,以SOTA能力和超高效率 **刷新****开源 OCR 模型的效率-性能帕累托前沿,**在真实场景文档解析评测 Real5-OmniDocBench 上取得 93.68 的 SOTA 成绩;该模型作为质检决策性质的「System-1」模型,具备跨模型的通用适配能力,能够自动判别文本、公式与表格的解析质量,整体 AUROC 达到 0.936,大幅减轻人工复核负担。

2401_87243659的博客 361

WPS图片转文字免费几次?3款免登录OCR免费档逐条读

WPS图片转文字免费几次:官网只写会员无限次,免费几次没写。逐条读OCR.space单个5MB、OnlineOCR.net游客每小时5个、图映 ImgIng本地识别的免费条款,附自制样本错字数。

2611_96826367的博客 213

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 346

图片表格变结构化数据:OCR 后的三个坑

图片表格变结构化数据:OCR 后的三个坑

weixin_44530853的博客 545

海外手写票据OCR怎么选?开灵科技、Google Document AI与百度智能云按原文译文对照、金额校验和人工复核对比

海外差旅报销里最难处理的票据,往往不是排版规范的电子发票,而是一张手写收据:当地文字、英文、印章、潦草数字混在一起,财务既要读懂商户和项目,又要判断金额是否算对。可准备泰文手写现金单、双语印刷发票和印章遮挡的收据各一张,让三种方案完成相同任务:识别票据类型、商户、币种、日期、明细和总额;以一张泰国手写现金销售单为例,识别结果按票据类型、卖方、手写明细、数量、单价、金额及总计组织,原文和中文并排显示。这类方案通常支持多语种识别、自动判断语种、原文中文对照,并处理手写体、表格、印章、签名及图像质量。

2509_91589461的博客 378

数眼智能与AI大模型API聚合平台接入实战:统一模型、Search、Reader和OCR的任务编排

本文提出一套解耦供应商的AI资源架构,通过统一领域接口、状态机编排、标准化错误处理与可观测链路,实现模型、Search、Reader、OCR等能力的灵活调度。以数眼智能等聚合平台为例,展示如何降低多源适配成本,保障任务可恢复、可审计、可优化。核心在于:统一上下文与预算,保留能力差异,让业务逻辑不绑定具体平台,真正实现AI应用从Demo到生产的可持续演进。

m0_72376392的博客 203

用户手册翻译实操:用 AI 处理 PDF,如何验收 OCR、术语与版式?

本文介绍适用于PDF工程手册的完整大模型翻译工作流:上传前确认文件类型与文本质量,建立术语表;翻译时保留版式,输出双语对照;验收阶段按参数、操作逻辑、图文对应等优先级核对错误;交付前执行“照文操作”验证,确保译文可读、可操作,并归档全流程资料,保障海外客户使用安全准确。

SamChan90的博客 147

纯血鸿蒙文档处理三件套实测:OCR扫描匣、PDF私档编辑与文本比对工具

文档处理离不开扫描、编辑、比对。纯血鸿蒙上有三款原生写的文档小工具——OCR扫描匣、PDF私档编辑、文本比对工具——都是全程本地处理,不上传任何文件。这篇实测三款文档处理三件套。

redtank2000的博客 323

档案数字化 OCR 技术架构:从批量扫描到结构化著录的完整方案

楚识科技的档案 OCR 方案,有几个特点:一是针对老旧纸张和手写档案做了专项模型优化,识别率比通用 OCR 高;二是支持批量处理,几十万份档案能稳定高效地跑;三是能自动提取著录项,生成档案目录,真正帮客户省人力;四是原生支持私有化部署和信创适配,符合档案行业的安全合规要求。

qq_34572574的博客 137
上一篇: ICML 26杰出论文:清华JustGRPO攻克dLLM推理瓶颈;告别简单指令测试:Agents Last Exam 全面评估智能体长程专业能力
下一篇: 在线教程|9B 小模型也能复杂推理,基于 Qwen3.5-9B,Qwythos 融合 Claude 推理经验实现能力跃升
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值