4步出图/4K画质/6倍提速,PiD用像素扩散统一解码与超分辨率输出;SA-3DAO:包含 1000 组真实图像与艺术家手工 3D 网格配对的数据集

Autosar 下电过程-基于ETAS工具 本文介绍基于ETAS工具对应的BIP包的下电过程,仅供参考。在最后调用SBC下电时,需要理清楚SBC的休眠流程,否则可能会出现休眠又唤醒情况。后面有空会介绍9471的休眠流程。 阅读详情

PiD 是 NVIDIA 发布的一种全新潜空间解码范式,将传统的 VAE 解码过程重新定义为条件像素扩散生成,把解码与超分辨率上采样统一到单一生成模块中。传统潜扩散模型通过 VAE 将潜变量还原为图像,输出分辨率受限,且重建导向的解码器难以补全高频细节、无法纠正潜变量中的伪影。PiD 引入轻量级噪声感知潜变量适配器(sigma-aware adapter),将含噪潜变量注入像素空间扩散骨干网络,使模型既能处理完全去噪的潜变量,也支持对部分去噪的潜变量提前终止扩散过程。借助 DMD2 蒸馏技术,推理仅需 4 步去噪即可完成。

目前,HyperAI超神经官网已上线了「PiD:4K 超分辨率图像生成与编辑」,快来试试吧~

在线使用:PiD: 4K Super-Resolution Image Generation and Editing | Notebooks | HyperAI

欢迎登录官网查看更多内容:

HyperAI

6 月 19 日- 6 月 26 日,hyper.ai 官网更新速览:

* 优质公共数据集:7 个

* 优质教程精选:14 个

* 社区文章解读:4 篇

* 热门百科词条:5 条

* 7 月截稿顶会:5 个

访问官网:hyper.ai

公共数据集精选

1. SAM 3D Artist Objects 3D 物体重建数据集

SAM 3D Artist Objects是由 Meta 于 2026 年 6 月发布的 3D 网格配对的数据集,旨在评估真实场景下物体形状与布局的三维重建算法性能,广泛用于图像转三维物体算法的性能测试、模型优化与计算机视觉领域的相关研究工作。该数据集包含 1,000 组真实图像与专业艺术家手工制作的三维网格配对数据。

在线使用:SAM 3D Artist Objects 3D Object Reconstruction Dataset | Datasets | HyperAI

2. RHELM 长程记忆评估数据集

RHELM 是由 Microsoft 于 2026 年发布的长程记忆能力评估数据集,旨在提升大模型在复杂动态场景中的长期记忆、多跳推理与时序信息合成能力。该数据集广泛应用于大语言模型长时序记忆评测、 AI 助手长期交互能力验证、大模型多跳推理、时序信息融合与幻觉检测等研究场景。

在线使用:RHELM Long-Term Memory Assessment Dataset | Datasets | HyperAI

3. MAKIEVAL 多语言文化知识评估数据集

MAKIEVAL 是由慕尼黑大学 MaiNLP 研究实验室联合慕尼黑机器学习中心于 2026 年发布的多语言文化知识评估数据集,旨在为大语言模型提供大规模多语言文化知识评估基准,广泛应用于多语言知识表示与文化知识建模研究。该数据集包含 7 个大语言模型在 13 种语言、 19 个国家 / 地区、 6 个文化领域下生成的文本及其自动抽取的文化实体与 Wikidata 对齐结果。

在线使用:MAKIEVAL Multilingual Cultural Knowledge Assessment Dataset | Datasets | HyperAI

4. Verbatim Spans 查询条件证据提取数据集

Verbatim Spans 是由 TU Wien 联合 KRLabs 于 2026 年 4 月发布的一个多领域查询条件证据提取数据集,旨在构建一个通用的查询条件证据抽取模型训练基准,广泛应用于检索增强生成(RAG)及抽取式问答任务。该数据集包含 174,383 行训练数据与 20,174 行验证数据,覆盖自然语言处理论文、多领域问答以及代码与工具输出三大类型语料。

在线使用:Verbatim Spans Query Condition Evidence Extraction Dataset | Datasets | HyperAI

5. Nemotron-SFT-Math-v4 数学推理 SFT 数据集

Nemotron-SFT-Math-v4 是由 NVIDIA 于 2026 年 5 月发布的数学推理数据集,旨在解决传统数学数据集质量参差不齐、推理轨迹不规范、准确率低、场景单一的问题,有效提升模型结构化推理、多轨迹推理与答案校验能力。该数据集包含 545,431 条训练样本,涵盖 285,516 条 COT 思维推理样本与 259,915 条 TIR 工具推理样本,覆盖代数、几何、数论、组合数学等竞赛与高校科研级数学场景。

在线使用:Nemotron-SFT-Math-v4 Mathematical Inference SFT Dataset | Datasets | HyperAI

6. AI Impact on Jobs and Layoff Risk AI 就业影响数据集

AI Impact on Jobs and Layoff Risk 是一个关于人工智能对就业影响的合成结构化机器学习数据集,旨在探索人工智能采用、工作自动化、岗位特征及劳动力技能对现代经济中就业结果的影响,广泛应用于分类建模、劳动力分析、自动化影响研究与人力资源决策支持等任务。

在线使用:AI Impact on Jobs and Layoff Risk: AI Employment Impact Dataset | Datasets | HyperAI

7. Global Climate & Energy Transition 2000 – 2026 全球气候能源数据集

Global Climate & Energy Transition 2000 – 2026 是面向气候变化、能源转型与碳减排研究的全球气候与能源转型数据集,旨在系统刻画全球气候变化与能源转型过程。该数据集记录了 2000 — 2026 年全球气候变化与能源转型进程,涵盖全球及多个区域的温度异常变化。

在线使用:Global Climate & Energy Transition 2000 – 2026 Global Climate and Energy Dataset | Datasets | HyperAI

公共教程精选

1. PiD:4K 超分辨率图像生成与编辑

PiD 是 NVIDIA 团队推出的即插即用超分辨率解码器。传统扩散模型通过 VAE 解码器将潜在表示还原为图像,输出分辨率受限于约 1024 像素。PiD 将 VAE 解码的最后一步替换为像素空间扩散过程,仅需 4 步去噪即可直接生成清晰的 4K 图像,无需任何后处理技巧,在不改变原有模型架构的前提下,大幅突破了传统方法的分辨率瓶颈。

在线运行:PiD: 4K Super-Resolution Image Generation and Editing | Notebooks | HyperAI

Demo页面

2. LTX-2.3-turbo 视频生成器

LTX-2.3-turbo 是 Lightricks 于 2026 年 3 月发布的一款开源视频生成基础模型,旨在突破开源视频生成能力的极限。该模型采用先进的扩散变换器架构,并结合多模态理解能力,实现了高质量、多分辨率的视频内容生成。

在线运行:LTX-2.3-turbo Video Generator | Notebooks | HyperAI

Demo页面

3. DiffBrush:手写文本行生成

南开大学与昆仑万维于 2025 年 8 月联合发布了手写文本行生成模型 DiffBrush,并于同年 10 月正式被 ICCV 2025 收录。该模型基于 Stable Diffusion VAE+UNet 架构,支持任意英文文本输入与 IAM 数据集中 496 种手写风格,输出 1024×64 灰度图像,文本内容与书写风格独立可控。推理部署轻量,可直接用于 OCR 训练集生成、手写数据增强及文档仿真等场景。

在线运行:DiffBrush: Handwritten Text Line Generation | Notebooks | HyperAI

Demo页面

4. RE-USE:通用语音增强模型

RE-USE 是 NVIDIA 于 2026 年 3 月发布的通用语音增强模型。它基于 Mamba 架构,能够处理各种采样率和降级类型的噪声语音信号,并且与语言无关。

在线运行:https://go.hyper.ai/MJ0p5

Demo页面

5. TADA-1b:统一语音语言模型

TADA-1b 是 HumeAI 团队于 2026 年 2 月发布的统一语音语言模型,专为语音合成、语音克隆和多语言配音等音频生成任务而设计。该模型基于 Llama 3.2-1B,具有轻量级、高速和稳定的音频生成能力,适用于英语文本转语音 (TTS)、零样本语音克隆、长篇叙述和语音延续。

在线运行:TADA-1b: A Unified Speech-Language Model | Notebooks | HyperAI

Demo页面

6. Gsplat 3D 高斯泼溅训练与可视化

Gsplat 是由伯克利、NVIDIA、上海科技大学等机构联合开发的开源 3DGS CUDA 加速光栅化库,在原始实现基础上深度优化,训练显存降低 4 倍、训练时间缩短 15%。其核心技术亮点包括:高效的 CUDA 微分光栅化引擎、自适应高斯密度控制策略、兼容 COLMAP 等主流数据格式的灵活数据后端,以及基于 viser 的实时 Web 可视化界面。应用场景覆盖数字孪生、自动驾驶环境感知、文物数字化及电商视觉合成等领域。

在线运行:Training and Visualization of Gsplat 3D Gaussian Splatting | Notebooks | HyperAI

Demo页面

7. DVD:基于生成先验的确定性视频深度估计

DVD(Deterministic Video Depth Estimation)是由香港科技大学(广州) 团队于 2026 年 3 月提出的首个确定性视频深度估计框架,通过将预训练的视频扩散模型(Wan2.1)改造为单次前向传播的深度回归器,在保持生成模型强大语义先验的同时,彻底消除了随机性带来的几何幻觉问题。

在线运行:DVD: Deterministic Video Depth Estimation Based on Generative Priors | Notebooks | HyperAI

Demo页面

8. Foundation-1:结构化文本到音乐采样生成

Foundation-1 由 RoyalCities 团队于 2026 年 3 月发布,是一款专为专业音乐制作流程设计的文本到采样音频生成模型。官方版本支持分层可控生成,允许用户自定义乐器系列、子类型、音色、效果、乐理和弦、速度/调号以及小节长度,生成节奏同步、调性锁定的音乐循环片段。此外,该软件还提供了一个统一的 Web Demo,提供完整的交互式生成功能。

在线运行:Foundation-1: Structured Text-to-Music Sample Generation | Notebooks | HyperAI
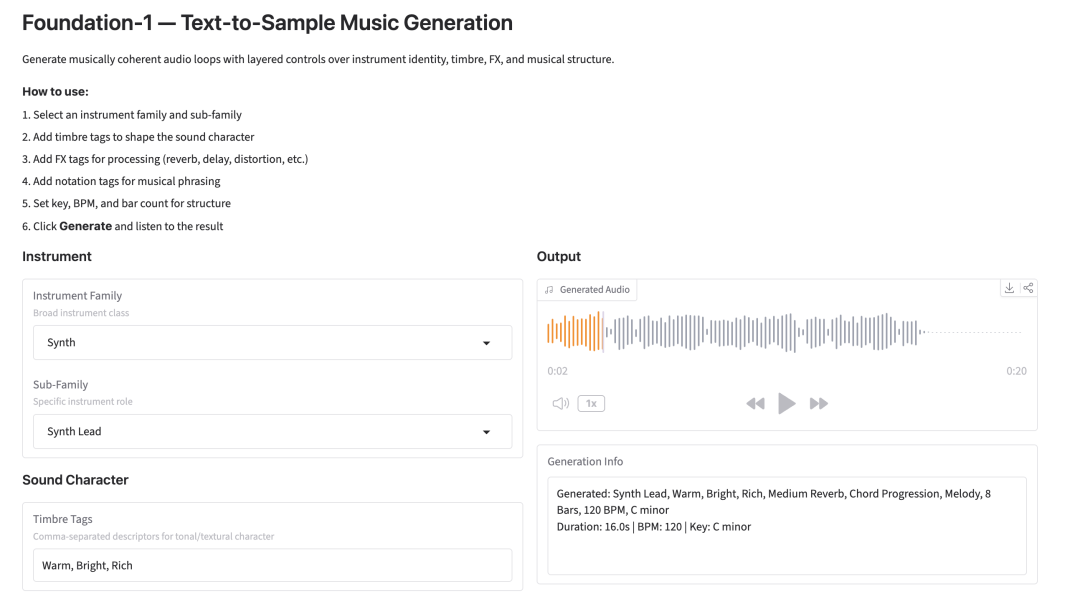
Demo页面

9. Sketch-RNN:矢量草图生成与潜在空间插值

Sketch-RNN 是 Google Brain 团队于 2017 年发布的一种矢量草图序列生成模型。该方法专为手绘草图数据而设计,数据包含笔画偏移量和笔的状态信息。它可以学习草图的连续潜在表示,并生成新的矢量草图序列。Sketch-RNN 采用编码器-解码器架构。它将输入草图映射到潜在空间,然后使用循环神经网络解码器逐步生成笔画。

在线运行:Sketch-RNN: Vector Sketch Generation and Latent Space Interpolation | Notebooks | HyperAI

Sketch-RNN 整体结构图

10. Galaxy-Deconv:弱引力透镜星系图像反卷积框架

Galaxy-Deconv 由清华大学的李天尧和西北大学的艾玛·亚历山大共同开发。该项目专注于弱引力透镜星系图像的复原。它使用展开式即插即用ADMM算法对受点扩散函数(PSF)模糊和噪声影响的星系图像进行反卷积。本教程将常见的星系反卷积工作流程整理成笔记本,涵盖图像模拟、COSMOS数据加载、反卷积推理、HDF5数据集检查和基础反卷积练习。

在线运行:Galaxy-Deconv: A Weak Gravitational Lensing Galaxy Image Deconvolution Framework | Notebooks | HyperAI

Demo页面

11. NuExtract3:多模态文档理解与结构化信息抽取模型

NuExtract3 是 NuMind 于 2026 年 6 月发布的 4B 参数多模态视觉语言模型,专为文档理解设计。模型将结构化信息提取与文档图像转 Markdown 两大能力整合于一体,支持文本、图像及图文混合输入,可依据用户提供的 JSON 模板直接输出结构化结果,并完整保留表格、公式与布局信息。

在线运行:NuExtract3: Multimodal Document Understanding and Structured Information Extraction Model | Notebooks | HyperAI

Demo页面

12. DiffusionGemma:基于离散扩散的高速文本生成模型

DiffusionGemma 是 Google DeepMind 利用离散扩散技术构建的文本生成模型。它采用 260 亿参数的专家混合模型 (MoE) 架构,总参数量为 252 亿,其中只有 38 亿个有效参数。通过并行块级扩散采样,它实现了超快的文本生成速度,在单个 H100 GPU 上每秒可生成 1100 多个 token。

在线运行:DiffusionGemma: A High-Speed Text Generation Model Based on Discrete Diffusion | Notebooks | HyperAI

Demo页面

13. TripoSplat:单张图像生成高质量 3D Gaussian 资产

TripoSplat 是由 VAST-AI Research 与 TripoAI 于 2026 年 5 月联合发布的单图像转 3D 高斯生成方法。模型可将单张 2D 图像转换为高质量的 3D 高斯模型,并可控制高斯分布的数量。该模型采用密度采样高斯 (DeG) 技术,根据物体的几何复杂度自适应地分布高斯中心,并使用 VecSeq 确定性地重排序无序的潜在变量,从而提高生成训练的稳定性。

在线运行:Triposplat: Generating High-Quality 3D Gaussian Assets From Single Images | Notebooks | HyperAI

Demo页面

14. North Mini Code 1.0:面向代码生成与软件工程任务的 Agent 模型

North Mini Code 1.0 是 Cohere 与 Cohere Labs 于 2026 年 6 月发布的开放权重代码模型,专为代码生成、终端任务与智能体软件工程场景优化。模型支持长时间编码工作、代码推理及工具调用与交错思考,擅长功能实现、脚本编写、调试、终端任务规划及多轮软件工程工作流。

在线运行:North Mini Code 1.0: An Agent Model for Code Generation and Software Engineering Tasks | Notebooks | HyperAI

Demo页面

社区文章解读

1. 麻省理工/IBM提出迄今为止最大的合成图表数据集ChartNet,生成150万个多样化图表样本

来自麻省理工学院、麻省理工学院-IBM 计算研究实验室和 IBM 研究院的众多专家提出了ChartNet——一个面向图表理解的百万级高质量多模态数据集,旨在推动图表理解与推理能力的发展。

查看完整报道:MIT/IBM Has Released ChartNet, the Largest Synthetic Chart Dataset to Date, Generating 1.5 Million Diverse Chart samples. | News | HyperAI

2. 谷歌DeepMind最新论文揭秘AI终局:从AGI到ASI,有4条路和6道关

Google DeepMind 联合多所顶尖高校发表了最新论文,探讨从通用人工智能(AGI)向超级人工智能(ASI)演进的深远问题。该研究将智能视作连续谱,冷静拆解了 AI 在跨越人类平均水平之后,继续演进的潜在路径与限制瓶颈。该论文为理解 AI 的长期发展轨迹提供了结构化的客观参考。

查看完整报道:Google DeepMind's Latest Paper Reveals the Ultimate Goal of AI: From AGI to ASI, There Are 4 Paths and 6 hurdles. | News | HyperAI

3. 基于Gemini 1.5长上下文能力,谷歌对话式医疗系统AMIE在100例多次就诊场景中达到全科医师的推理水平

Google Deepmind 与 Google Research 近期一项研究以其对话式医疗系统 AMIE 为基础,进一步开发了一套全新的基于 LLM 的智能 Agent 系统,使其能够针对多次随访场景进行临床管理和医患对话优化。AMIE 利用了 Gemini 模型的长上下文能力,通过结合上下文检索与结构化推理,使其输出能够与最新的临床实践指南和药物处方目录保持一致。

查看完整报道:Leveraging Gemini 1.5's Long Contextual Capabilities, Google's Conversational Healthcare System AMIE Achieved the Reasoning Level of a General Practitioner in 100 Scenarios Involving Multiple Patient visits. | News | HyperAI

4. 材料AI迈向「可解释时代」,日本团队破解高维光谱黑箱,锁定新材料发现关键特征

来自日本东京科学研究所的研究团队提出了一种深度学习模型的解释方法,能够处理材料科学中的高维光谱数据。研究人员构建了一个包含 2681 种氧化物、硫族化合物及相关化合物的光吸收光谱第一性原理计算数据集。与标准密度泛函计算相比,对光谱起始能量和形状进行校正后,计算结果与已报道的实验光谱吻合度显著提高。

查看完整报道:Materials AI Is Moving Towards an "explainable Era": A Japanese Team Cracks the Black Box of high-dimensional Spectroscopy, Pinpointing Key Features for Discovering New materials. | News | HyperAI

热门百科词条精选

1. 大语言模型 LLM

2. 结构 Architecture

3. 世界动作模型 WAM

4. 旋转位置编码 RoPE

5. 大规模多任务语言理解 MMLU

这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:

Wiki | HyperAI

7 月截稿顶会

* 截稿时间为 AoE 时间

一站式追踪人工智能学术顶会:Events | HyperAI

以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!

下周再见!

关于 HyperAI超神经 (hyper.ai)

HyperAI超神经 (hyper.ai) 是国内领先的人工智能及高性能计算社区,致力于成为国内数据科学领域的基础设施,为国内开发者提供丰富、优质的公共资源,截至目前已经:

* 为 2100+ 公开数据集提供国内加速下载节点

* 收录 700+ 经典及流行在线教程

* 解读 300+ AI4Science 论文案例

* 支持 700+ 相关词条查询

* 托管国内首个完整的 Apache TVM 中文文档

访问官网开启学习之旅:

HyperAI

宇树G1机器人遥控器音频控制实战 本文介绍了宇树G1人形机器人遥控器控制音频播放的核心实现方案。通过DDS消息订阅获取遥控器输入,采用非阻塞的subprocess调用aplay命令控制外接音响设备。系统支持播放、暂停和重播功能,采用50ms轮询间隔实现实时响应。关键点包括遥控器初始化、音频进程管理(Popen)、退出机制。文章还提供了设备配置指南、遥控器按键说明和常见问题解决方案。该方案从复杂音频播放器中提炼出核心控制逻辑,可作为机器人交互开发的参考模板。 阅读详情

相关推荐

【文章阅读+代码复现】Point-GNN

Brief 在3D点云语义分割方法中,GNN已经做了很多可用的方案,但是在目标检测上依旧是采用比较传统的CNN和稀疏卷积的组合,这一篇文章是研究了图卷积在3D检测的中的用法。来自卡内基梅隆大学。已经被CVPR2020接收. 这里是 paper 这里是 code Abstruct 一个采用GNN设计的3D目标检测框架 过程是先将点云场景编码成图结构,随后设计了一个叫point-GNN的网络结构,在...

有所为,有所成长 1万+

3D ACIS Modeler 在测量软件里怎么用?几何查询、区域判断与测点布点

本文面向测量软件开发团队,梳理 CAD 模型导入三坐标测量软件后的几何判断工作:如何借助 3D ACIS Modeler 完成模型对象访问、测量区域判断与空间关系分析,并结合 LK Metrology CAMIO 官方案例说明内核与应用的分工,最后给出自研与引入内核的评估思路。

HuiduCADTech的博客 326

【C++PTA】6-1 Point类的运算 (10 分)

定义Point类,有坐标x,y两个私有成员变量;对Point类重载“+”(相加)、“-”(相减)和“==”(相等)运算符,实现对坐标的改变,要求用友元函数和成员函数两种方法实现。对Point类重载<<运算符,以使得代码 Point p; cout<<p<<endl;可以输出该点对象的坐标。 函数接口定义: 实现Point类。 裁判测试程序样例: /* 请在这里填写答案 */ int main(int argc, char const *argv[]) { P

libertye的博客 2367

3D CAD参数化建模原理详解:尺寸参数、几何约束与特征关系

3DCAD参数化建模通过尺寸参数、几何约束与特征依赖关系,将设计意图融入模型,实现自动更新。其核心在于明确变量关联、合理设置约束、理顺特征逻辑。修改时,系统依规则重算几何,但需防范约束冲突、依赖失效等问题。提升可维护性需规划关键参数、优化建模结构,并验证多场景适用性。大腾智能ZCAD以自主内核与智能交互支持高效参数化设计,兼顾传统建模与同步修改需求,助力系列化开发与持续迭代。

大腾智能的博客 316

FPGA之全数字锁相环(DPLL)

1. 数字锁相环的基本原理和组成 1.1 锁相环(PLL)的简介 锁相环最开始并不是用在数字电路中,而是模拟短路中。对于模拟电路中的锁相环,大家可以参考这篇文章稍微看一下,数字和模拟只是实现的方法不同,但是原理、步骤还是共同的。关于模拟PLL。可以参考一片文章: http://www.sohu.com/a/190569594_464086 首先在学习数字锁相环之前,我们应该先了解什么是锁相环?锁相...

DBLLLLLLLL的博客 5万+

MiniMax H3本地部署与ComfyUI集成实战:从环境配置到提示词优化

文本到视频生成是AI内容创作领域的关键技术,它基于扩散模型等深度学习原理,将自然语言描述转化为连贯的动态视觉序列。这项技术的核心价值在于大幅降低了视频制作的门槛,为短视频创作、概念可视化、教育内容生成等场景提供了高效工具。在实际工程实践中,成功部署和运行此类模型,如近期备受关注的MiniMax H3,需要精准处理环境配置、显存优化和提示词工程等环节。其中,解决“CUDA error: no kernel image is available”等版本兼容性问题,以及针对“8G显存”等有限资源进行参数调优,是确

weixin_33674976的博客 478

AI时代,Delft3D如何打通标量输运、波浪、粒子与溢油模拟

学完不仅能独立完成模型构建、参数设置和结果分析,还能真正掌握从“建模型”到“用模型解决实际问题”的完整方法。做 Delft3D 模拟,最难的不是“会点软件”,而是理论如何落地、参数如何设置、案例如何跑通,以及模型结果如何真正用于科研和项目。既适合零基础入门,也适合已有水动力基础、想进一步提升应用能力的科研人员、研究生及水文、水环境、海洋、水利、环评等领域技术工作者。1.拉格朗日粒子模型理论2.拉格朗日粒子法的适用情况3.拉格朗日粒子法的参数4.波浪模型后处理。这门课从基础到进阶,一次打通。

weixin_56135535的博客 175

如何合理评估信号过孔的残桩效应--Via Stub

设计中,之所以会去考察信号过孔的残桩效应(Via Stub),是因为它的存在导致了不需要的频率谐振,当这些谐振出现在所关注的信号通道的插入损耗中时,就会引发较为严重的信号完整性(SI)问题,那么Via Stub到底是如何引发SI问题的呢?

一只豌豆象的博客 4466

虚拟仿真实训基地的技术实现路径:从3D采集、资源库到仿真平台的完整链路

本文提出“五段式”虚拟仿真实训链路——采集、建模、资源、平台、展示,破解职业教育实训资源持续产出难题。通过设备选型、AI建模、统一管理与过程留痕,实现教学资源标准化、可复用、可更新。强调元数据规范、轻量化处理与验收指标,避免“只采不建”“仿真脱节”等五大工程陷阱,确保基地长效运行,支撑岗位技能对接与教学改革。

Jmyd0123的博客 328

【Android调试】高通adb识别不到设备的完整排查指南:从驱动到端口一步到位

本文系统梳理高通(Qualcomm)平台Android设备adb无法识别的完整排查流程。从最基础的USB连接检查开始,到Windows设备管理器中驱动状态的判断、高通USB驱动的正确安装与更新方法,再到adb端口被占用、USB调试未开启、驱动签名校验失败等高频场景的解决方案。每一步均配截图和操作命令,文末附常见报错速查表,适合做系统开发、刷机调试或者Android Framework bringup时遇到adb不通的工程师快速定位。

weixin_44081096的博客 281

[数学建模][2012年A国赛模拟] 3. 葡萄酒的评价

暑期学校数学建模培训第三次模拟:2012年国赛A题,一道完全统计方面的题目。据老师反映当年有位老师所带领小组取得“全国10佳优秀论文奖”,我们大组搞统计的老师建模能力不行,但其统计理论非常扎实,在此期间给予我们非常大的帮助,十分感谢老师的倾囊相授。我们小组的定位也不在统计方向,主攻物理建模及优化模型,故本次模拟就用SPSS软件简单做了下,还是学到了多元统计的许多知识,达到了本次训练的目的。 ...

Y-puyu 的博客 3万+

【测评】SenseNova6.8Flash模型正式发布,支持动态 PPT 及 3D 设计

SenseNova 6.8 Flash将设计生成拓展至多种创作形态,支持Web、SVG、Three.js、Blender、PPT等形式,满足多样化的AI Native Design需求,并支持动态PPT、动态Poster与Agentic 3D设计。同时,模型可接入Figma等专业工作流,帮助用户将AI设计能力融入现有的专业设计流程。此外,模型还支持三维场景与交互内容创作,可综合处理空间布局、材质与光照、镜头控制及动画编排等因素,构建可在网页中实时渲染的三维内容,拓展从立体视觉展示到动态交互的表达方式。

Enweitech Software Works 332

Python爬虫实战:携程旅游平台数据爬取(酒店+机票+景点),破解加密与反爬(附完整代码)

携程的反爬机制再复杂,核心逻辑都是“识别非真实用户的请求”,而爬虫的核心就是“让请求看起来像真实用户的行为”。本文的方案从登录态处理、参数加密破解、动态数据抓取,到反爬应对,都是围绕“模拟真实”展开:用Playwright模拟真实浏览器登录,用住宅代理模拟真实用户IP,用随机延迟模拟真实用户的操作频率。掌握了这个核心思路,无论平台的反爬如何升级,都能找到应对方法。当然,爬虫技术是一把双刃剑,合理使用才能发挥其价值。如果你的爬虫项目中遇到了携程的反爬问题,不妨按照本文的步骤试试,大概率能解决问题。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 2606

船舶安全培训怎么用AI生成3D预演?从甲板通道、设备热点到网页回放

船舶甲板能够漫游,不等于培训内容可信。本文梳理从培训任务、资料台账、空间白模到设备热点、步骤关联和网页交付的制作流程,说明如何用稳定设备 ID 追溯来源,通过三轮审核核对技术、课程与网页表现,并提供弱网图文回退和上线清单。AI 适合辅助场景与交互原型,不能替代专业审核、上船实训或正式安全程序。

Solange__的博客 557

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

DEM 数据源选型完全指南:SRTM、ASTER GDEM、ALOS AW3D30 与商业高分辨率的工程级对比

本文回答一个工程选型问题:SRTM、ASTER GDEM、ALOS AW3D30 和商业高分辨率 DEM 怎么选。核心结论:先确认数据表达的是裸地还是含地物表面,再确认垂直基准,最后才看分辨率。格网再细,表面层错了或基准没对齐,断面和汇水结果仍然不可用。

TuxinyunGIS的博客 288

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

项目选型 3D 相机推荐|自动化项目落地全流程选型指南

项目选型和单纯产品选型最大区别:所有参数都要服务于产线工艺目标,优先锁定 5 个基础边界条件,这是筛选相机的前置条件,也是很多项目踩坑的源头。项目选型 3D 相机,核心不是选出参数最好的硬件,而是选出适配项目工况、可控风险、可按时验收、运维成本可控的整套视觉方案。对于自动化系统集成商来说,优先选择拥有自研光学、算法、标定工具链,并且具备大量量产项目沉淀的国产 3D 视觉厂商,能够有效降低方案设计、现场调试、项目交付的不确定性。

加搜科技观察 116

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

百炼 CLI 生成物流主题 3D 视觉概念图教程:一个关键词出主视角/鸟瞰/特写/风格变体一套图,含默认开关与水印坑实测

做物流投标配图、方案配图的人经常遇到同一个需求:手里只有一个关键词,交付物却是一整套 3D 视觉概念图。本文以「无人仓储中心」为例,用百炼命令行的两条命令搭一条两段式生图链路,一个关键词产出主视角、鸟瞰、设备特写与风格变体成套图,并把四条可选路线的等待时间、画面文字注入情况和成套一致性一次测完,给出可直接抄的接法与参数。

weixin_43540568的博客 83

机器视觉 3D 相机与机器人引导全解析:四大成像原理、手眼标定与七步落地流程

3D 视觉的精度上限,80% 取决于。

2501_94699871的博客 194

从CAD装配模型到3D装配动画:模型复用与工艺步序设计

本文阐述了从三维CAD模型生成装配动画的关键流程,涵盖模型准备、结构确认、工艺步序定义、动画表达与资料输出五大环节。指出传统方法存在重复整理、工艺脱节等问题,提出通过“3D工艺大师”等工具实现模型复用与工艺步序驱动,由工艺人员直接定义装配逻辑,自动生成动画并协同输出工艺文件,提升效率与准确性,真正实现设计数据向生产指导的无缝转化。

大腾智能的博客 633

把带贴图的 OBJ / glTF 转成 3D Tiles:我写了个 mesh-to-tiles

做倾斜摄影或单体模型上 Cesium 时,经常卡在同一件事:手上是一份带贴图的 OBJ 或 glTF,场景里要的是 3D Tiles。现成工具能转,但 LOD、图集和纹理压缩往往要再串一圈。我把这条链路收成了一个 Node 命令行工具,输入网格,输出 3D Tiles 1.1 隐式八叉树。,协议 MIT。

m0_69250830的博客 192

连锁门店方案怎么用AI生成3D预演?从需求表、空间白模到网页评审

连锁门店如何用 AI 辅助比较布局,并让品牌、运营与设计团队在线评审?本文从需求表和场地底稿出发,介绍双尺寸核对、区域与设备编号、固定观察点,以及从审核母版派生网页轻量版的方法,并通过品牌运营、空间资料、网页权限三轮审核保持版本对应。AI 用于生成候选与辅助表达,网页用于沟通方案,两者都不能替代现场测量、专业设计及工程审核。

Solange__的博客 452

微缩场景怎么用AI生成3D?单图、分件参考还是布局草图,按4层输入减少返工

一张港口概念图能说明场景气氛,却未必交代道路、高差、建筑背面和对象边界。本文按整体构图、空间布局、对象分件、尺寸与交付四层整理 AI 生成 3D 场景的输入,比较主图、布局草图和分件参考各自的作用与局限,并提供三轮试跑方法和可复制输入卡。生成后通过检查背面、量测尺寸、单独移动房屋及重新导入目标软件,判断候选是否满足后续编辑要求。

Solange__的博客 438

3D Forward Simulation of TMI Data:三维总磁场强度正演入门

本文面向初学者,基于SimPEG教程介绍三维磁法正演模拟。通过构建含球体的地下磁化率模型,结合地形与地磁场,预测地表17×17个测点的总磁场强度异常(TMI)。重点讲解磁化率、诱导磁化、TMI测量原理及三维积分正演机制,演示如何使用TensorMesh、active_cells和Simulation3DIntegral实现正演计算。代码可复现地形图、磁化率剖面与TMI异常图,并支持导出合成数据。实验建议调整磁化率、飞行高度、倾角等参数,理解其对异常形态的影响。强调磁异常非唯一性,需结合地质约束。适用于磁测设

m0_57685225的博客 360

影视场景怎么用AI生成3D镜头预演?从概念图、场景白模到网页审片

概念图有氛围,不代表能直接用于镜头预演。本文围绕剧本拆镜、资料与尺度假设、场景白模、机位走位、动作节拍和网页审片,介绍 AI 生成 3D 场景的预演流程。通过稳定对象与相机编号、统一镜头表、意见关联版本和三轮审核,让讨论落到具体镜头,同时明确白模与网页预演不能替代真实场地勘景及现场安全判断。

Solange__的博客 540

YaksueEngine(3)3D空间三角形

把三角形平放在 3D 场景里,顶点坐标变成世界空间的坐标; 实现鼠标控制的相机,可以围绕三角形旋转、平移、缩放。

主要记录了工作之余胡乱学习的知识,大部分是入门级别的内容。 主要是为了自己未来有用到时能快速上手,相当于是个备忘录。 当然,也很开心其他人可以从中找到对自己有用的信息。^_^ 359

3D虚拟展厅的埋点与成本归集,投入产出表该怎么建?

2026年3D虚拟展厅投入产出评估的核心在于数据对齐,而非公式复杂度。关键路径为:先构建四层事件模型(会话、空间、展项、转化),统一用session_id与lead_id双键打通行为数据;再将CAPEX、OPEX、内容迭代、投放四类成本科目逐笔归集至统一project_code;最后通过按天调度的ETL链路,实现季度对账。分子取去重有效线索数,分母为四类成本合计。需严控首屏1.8秒、移动端30fps、面数分级预算,并分40人持续负载与2000人瞬时峰值两类压测。技术落地依赖事件级SDK、数据导出接口与私有化

Jmyd0123的博客 377
上一篇: 在线教程丨UC伯克利/英伟达等发布3DGS开源库gsplat,节省4倍显存,训练时间缩短10%
下一篇: 从简单助手到强生产力,香港大学黄超团队的AI Agent落地攻坚实录
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值