在线教程丨单卡即可爆改,面壁智能等开源MiniCPM-V-4.6,1.3B端侧模型支持图像理解/视频理解/OCR/多轮多模态对话

视觉语言模型VLM实战指南:从原理到部署与微调 从Transformer注意力机制切入,解释多模态模型如何将视觉与语言映射到统一向量空间,进而介绍VLM的核心架构(视觉编码器、投影层、语言解码器)及各阶段演进。结合大模型微调技术LoRA,阐述如何低成本定制专属视觉问答能力。在工程实践上,给出本地部署的硬件门槛、推理优化与稳定性设计,并探讨VLM在工业质检、农业监测、多模态Agent等场景的落地边界。最后,自然收敛到本文主题:一条可执行的多模态学习路径与避坑指南。 阅读详情

过去几年,整个 AI 行业几乎都笼罩在 Scaling Law 的叙事之下。参数越大、训练数据越多,模型似乎就越接近「通用智能」。从千亿到万亿参数,大模型不断刷新人们对推理能力与世界知识的想象,也让「堆算力、卷规模」成为行业默认的发展路径。

但当 AI 真正开始走向产业落地,一个现实问题逐渐浮现:并不是所有场景,都需要部署在云端机房里的超级模型。高昂的推理成本、不可控的网络延迟,以及日益敏感的数据隐私风险,正在让「大而全」的模型路线遭遇瓶颈。性能、时效与成本之间的「不可能三角」,成为 AI 普惠必须面对的问题。

于是,一个看似反常识的趋势开始出现:参数更小的模型,反而在越来越多真实场景中展现出更高的效率与性价比。尤其是在端侧设备与高并发工业环境里,轻量级模型正在承担 OCR、图像问答、意图识别等基础任务。它们既能在手机端毫秒级离线运行,也能在 RAG 系统中负责路由分流与成本压缩,成为 AI 应用真正落地的重要基础设施。

近日,面壁智能、清华大学、OpenBMB 联手开源了新一代端侧多模态模型 MiniCPM-V 4.6,该模型参数规模仅约 1.3B,却同时支持图像理解、视频理解、OCR 与多轮多模态对话等能力,并在多项评测中实现了对同级别模型的超越。

图片

值得关注的是,官方 Model Card 提供了基于 Transformers 的 AutoProcessor 与 AutoModelForImageTextToText 推理方案,适合在单卡 GPU 环境中进行快速验证与应用原型开发。

为了便于全球开发者快速体验这一轻量级模型,HyperAI 已上线「MiniCPM-V-4.6:端侧高效多模态视觉语言模型」,已经完成环境配置,可轻松实现该模型的在线部署。

在线运行:https://go.hyper.ai/GVDmw

查看相关研究论文:

https://hyper.ai/papers/2605.08985

图片

Demo 示例

更多在线教程:

https://hyper.ai/notebooks

欢迎登录官网查看更多内容:

https://hyper.ai/

Demo 运行

1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「MiniCPM-V-4.6:端侧高效多模态视觉语言模型」,点击「运行此教程」。

图片

图片

2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。

图片

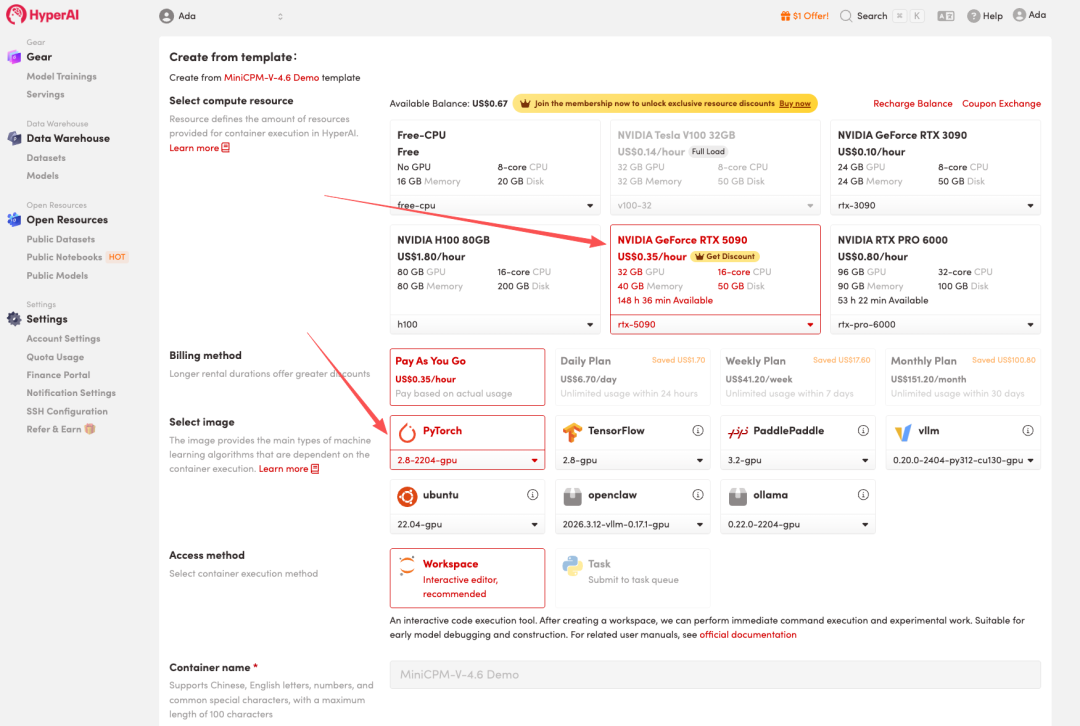
3.选择「NVIDIA RTX 5090」以及「PyTorch」镜像,点击「Continue job execution(继续执行)」。

HyperAI 为新用户准备了注册福利,仅需 $1,即可获得 20 小时 RTX 5090 算力(原价 $7),资源永久有效。
图片

图片

4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。

图片

效果展示

1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。

图片

图片

2.待运行完成后,即可点击右侧 API 地址跳转至 demo 页面。

图片

单总线CPU设计(变长指令周期3级时序)(HUST)(头歌实验) 利用比较器等功能模块将32位MIPS 指令字译码生成LW、SW、BEQ、SLT、ADDI、OtherInstr信号也就是利用比较器将指令字转换为译码信号,OP与不同信号对应(查询MIPS手册得知) 16 进制 :23 是 2进制: 00100011 ,把获得的OP,Func,和常数比对,相同输出1.按照题目要求填写表格,使用logisim的组合逻辑电路分析功能,当然也可以直接再logisim中写真值表。单总线采用变长指令周期,不同指令周期数不同,节拍数可变化。写的excel表格最终生成电路(当然 需要先把 阅读详情

相关推荐

白炽灯寿命工程解析:从钨丝蒸发到电压控制的可靠性设计

白炽灯作为一种经典的电光源,其工作原理基于电流通过钨丝产生热辐射发光。在高温下,钨丝会持续蒸发导致灯丝逐渐变细、电阻增大,这是影响其寿命的核心物理机制。从工程角度看,白炽灯的可靠性设计涉及材料科学、热力学和电路设计的交叉,技术价值在于通过理解其失效原理,可以在成本与性能间取得最佳平衡。在实际应用中,电压波动、开关浪涌电流和机械振动是主要寿命杀手,尤其在工业控制、仪器仪表和特定照明场景中,合理的设计能大幅提升系统稳定性。本文深入探讨了钨蒸发、热应力等关键因素,并结合浪涌抑制和降压设计等实战技巧,为工程师提供了

weixin_28684655的博客 570

涵盖 OCR 与多轮对话:1.3B 端侧多模态模型 MiniCPM-V-4.6 正式发布;百万级智能体数据集 AgentTrove 开源!包含代码修复及数学求解

模型聚焦于图像理解、视频理解、视觉问答、OCR 与多轮对话场景。它支持实时预览、自动保存、本地存储、自定义主题、暗色模式、响应式布局以及 PDF 导出,用户可以在编辑区填写个人信息、教育经历、项目经历、工作经历等模块,并即时查看最终简历效果。VisCoR-55K 是一个高质量视觉推理数据集,包含约 55,000 个视觉推理样本,每个样本都利用对比样本生成相应的推理过程,涵盖通用、推理、数学、图表及 OCR 五大类别的高质量视觉推理数据集,旨在促进视觉语言模型在可信且稳健的视觉推理方面的研究。

OpenBayes的博客 300

飞书组织架构同步至LDAP:实现企业应用统一身份认证的实战指南

本文详细介绍了如何将飞书组织架构同步至LDAP,实现企业应用统一身份认证的实战方案。通过飞书开放平台API与LDAP服务的集成,企业可以大幅减少账号管理工作量,提升IT效率。文章涵盖技术架构设计、密码策略、详细配置步骤及自动化同步实现,特别适合需要统一认证体系的中大型企业。

weixin_29172201的博客 335

MiniCPM-V-2_6 vs GPT-4V:小模型大能力的对比实测

本文介绍了如何在星图GPU平台上一键自动化部署MiniCPM-V-2_6镜像,实现高效的多模态AI应用。该镜像在图像理解、OCR识别和视频分析等场景中表现卓越,特别适用于智能文档处理和实时内容分析,兼顾高性能与低资源消耗。

weixin_42600407的博客 74

告别OLE!Delphi操作Excel的3种轻量级方案横向评测(FlexCel/XLSReadWriteII/LibXL)

本文深入评测了Delphi操作Excel的三种轻量级方案:FlexCel、XLSReadWriteII和LibXL。通过技术架构、API设计、性能测试和实战案例的全面对比,帮助开发者选择最适合的工具,提升Excel文件处理效率,告别传统OLE方案的依赖和性能问题。

onion的博客 929

车载导航GPS欺骗

因此,如果我们能够模拟卫星信号,将模拟的信号通过信号发射装置发送给GPS传感器,那么就有可能实现欺骗GPS传感器获取虚假的位置信息,这种技术即SDR(软件无线电,Software Defined Radio)[2]。究其原因,在不使用时钟模块的条件下,HackRF发送信号的频率可能不十分精准,因此GPS传感器接收到信号之后可能无法正常解析GPS信号,因此时钟信号可能是HackRF进行GPS欺骗的关键。2)HackRF是否使用了时钟模块,时钟模块决定了信号发送频率的精准程度,对实验的成败也是至关重要的。

2503_90751789的博客 1324

MiniCPM-V4.6:一款手机端超高效图像与视频理解的袖珍多模态大语言模型

摘要: MiniCPM-V 4.6是一款高效边缘部署的多模态模型,基于SigLIP2-400M和Qwen3.5-0.8B构建,具备强大的图像/视频理解能力。其创新性4x/16x混合视觉令牌压缩技术显著提升计算效率,在多项基准测试中超越同类模型,甚至优于更大规模的Ministral 3 3B。支持iOS、Android和HarmonyOS全平台部署,并提供多种量化版本与开发者工具链(如vLLM/SWIFT)。模型通过Flash Attention 2加速,视觉编码计算量降低超50%,吞吐量达Qwen3.5-0

weixin_41446370的博客 878

数据分析案例-2024 年全电动汽车数据集可视化分析

本数据集来源于Kaggle,原始数据集共有177866条数据,17个变量。该数据集显示了目前通过华盛顿州许可部 (DOL) 注册的电池电动汽车 (BEV) 和插电式混合动力电动汽车 (PHEV)。电池电动汽车 (BEV) 是一种全电动汽车,使用一个或多个电池来存储电能,为电机提供动力,并通过将车辆插入电源进行充电。插电式混合动力汽车 (PHEV) 是一种使用一个或多个电池为电动机提供动力的车辆;使用另一种燃料,例如汽油或柴油,为内燃机或其他推进源提供动力;并通过将车辆插入电源来充电。

m0_64336780的博客 1万+

教程上新丨单卡即可爆改,面壁智能等开源MiniCPM-V-4.6,1.3B端侧模型支持图像理解/视频理解/OCR/多轮多模态对话

近日,面壁智能、清华大学、OpenBMB 联手开源了新一代端侧多模态模型 MiniCPM-V 4.6,该模型参数规模仅约 1.3B,却同时支持图像理解、视频理解、OCR 与多轮多模态对话等能力,并在多项评测中实现了对同级别模型的超越。高昂的推理成本、不可控的网络延迟,以及日益敏感的数据隐私风险,正在让「大而全」的模型路线遭遇瓶颈。尤其是在端侧设备与高并发工业环境里,1.登录 OpenBayes.com,在「公共教程」页面,搜索并选择「MiniCPM-V-4.6:端侧高效多模态视觉语言模型」教程。

OpenBayes的博客 423

用 Docker 一键部署 SillyTavern酒馆 mac/windows/linux通用教程,我再也不手动折腾了!

本文介绍了如何使用 Docker 一键部署 SillyTavern 项目,适用于 Mac、Windows 和 Linux 系统。SillyTavern 是一个本地部署的大语言模型聊天界面,支持多种插件和扩展。文章详细说明了安装 Docker、拉取项目、启动容器、配置白名单、启用插件等步骤,并提供了常见问题的解决方法。通过 Docker 部署,用户可以避免繁琐的手动配置,快速搭建和运行 SillyTavern,适合希望简化部署流程的用户。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 2623

移动端HDR

移动HDR是近年来移动设备最大的技术进步之一。自2017年起,它就开始出现在旗舰手机上,包括苹果(Apple)和三星(Samsung)在内的大多数制造商都加入了这一行列。这一趋势在过去几年里席卷了整个电视行业,但在最近几年才真正深入人心。而且,最近,将更多的HDR内容放到移动设备上的趋势已经加快。对于这种新兴技术来说,它还处于相对早期的阶段,但它也非常有趣,值得关注。 HDR是什么? HDR是...

ISP行业的忠实粉丝 1340

单卡部署MiniCPM-V-4.6:1.3B小模型实现多模态AI实战指南

多模态AI技术通过融合视觉与语言信息,使计算机能够像人类一样理解图像、视频和文本。其核心原理在于构建视觉编码器与语言模型之间的高效对齐机制,将像素信息转化为语义表征。这项技术的价值在于打破传统单一模态处理的局限,实现端到端的场景理解与交互。在工程实践中,参数高效微调(PEFT)和LoRA等技术大幅降低了部署门槛,使得小模型也能在消费级显卡上实现强大的多模态能力。应用场景广泛覆盖智能文档处理、交互式学习助手、工业质检系统等领域,尤其适合处理OCR识别表格、图片提取文字等实际需求。本文以MiniCPM-V-4.

weixin_30256901的博客 394

1.2 博图TIA的轨迹(Trace)功能介绍

在TIA中“轨迹” ( Traces ) 能来记录设备变量并对记录进行评估,对有些故障排查很有帮助,本文进行介绍

qq_34047402的博客 1647

图片 OCR 转 Word API:输入二选一、DOCX 和私有文件下载

图片 OCR 转 Word API 通过 POST 识别图片文字并生成可编辑 DOCX。输入为 HTTPS 图片 URL 或 Base64,二选一。公开模式返回下载链接,私有模式返回文件标识。

DevOpenClub 专栏 245

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

使用ocr来实现自动化脚本

自动化脚本的稳定性,很大程度上取决于“找到目标元素”这件事是否可靠。无障碍控件查找在标准 Android 应用上工作得很好,但一旦进入游戏、自绘渲染界面、Flutter 或某些加固过的应用,getUiTree返回空树或残缺节点是常有的事。控件的text和id属性不存在,findView就无从谈起。这时继续在控件查找的框架里打补丁,收益很低;更务实的做法是把定位层整体切换到 OCR,用屏幕上的文字本身作为锚点。冰狐的 OCR 接口不是单一函数,而是一组按用途分层的工具。底层是ocr()和tessOcr()

ai_coder_ai的博客 405

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

影刀OCR功能有什么替代方案?实测三条路线,内网离线也能跑稳

试到第三款时我停下来试了蓝印RPA:它自带AI识图与OCR功能,接入了文心一言、豆包、DeepSeek、Kimi这些大模型,图片丢进去出文字,识别结果直接进变量,接着往下填表、对账、写回Excel,一整条链路不用出流程。元素获取上,它支持本地智能生成元素路径,还能AI智能优化元素路径:我用大白话描述"发票号码那个格子",直接给出稳定的xpath,不用啃语法。碰上财务系统网页改版导致元素失灵,Web元素AI自愈能自动修复元素定位,自愈更稳定,少了我半夜起来改流程的次数,降低脚本维护成本这件事是实打实的。

HAHAXX8的博客 168

汽车金融 OCR 系统架构设计:从多证件识别到关联校验的技术方案

楚识科技的汽车金融 OCR 方案,有几个特点:一是证件类型覆盖全 —— 汽车金融涉及的十几种证件全部支持;二是汽车专项证件准确率高 —— 行驶证、登记证书、车辆合格证的识别准确率比通用 OCR 高很多;三是内置多证件关联校验引擎 —— 识别完自动比对,有问题自动标记;四是和主流风控系统无缝对接 —— 开箱即用,不用二次开发。

qq_34572574的博客 280

报结构化提取工程落地:别把复杂报表识别等同于通用 OCR

从工程架构上看,成熟的财报识别系统,是一套多阶段流水线,而不是端到端单模型。以东北证券这份合并资产负债表为例,报表采用左右分栏布局,左侧资产、右侧负债及股东权益,大量 “其中:客户备付金” 这类二级缩进子科目,还有证券行业独有的结算备付金、代理买卖证券款等科目,加上红色公章遮挡、跨页拆分、无线表格等干扰项。但对于开发者来说,要清醒认知:财报识别不是一个开箱即用的 OCR 能力,它是视觉、NLP、财务规则三者结合的垂直工程,版式还原、科目对齐、勾稽校验,每一环都决定方案能不能在金融生产环境稳定跑起来。

OCR_13371621275的博客 186

使用PaddleOCR和OpenCV5实现OCR

本文介绍在OpenCV 5环境下绕过依赖限制,直接使用OpenCVSharp与OnnxRuntime调用PaddleOCRv5模型实现文字检测与识别的方法。通过加载det.onnx(检测)和rec.onnx(识别)模型,结合ppocrv5_dict.txt字典,实现了对证件类图像的高精度文字识别,识别结果包含文本内容及置信度,效果良好,适用于多场景OCR应用。

lweiyue的专栏 193

发票识别技术通过图像预处理、区域检测、表格解析、内容识别、语义校验与结构化输出,突破传统OCR局限,精准提取发票信息

发票识别技术通过“六步流水线”实现智能处理:图像预处理、区域检测、表格解析、内容识别、语义校验与结构化输出,突破传统OCR局限,精准提取发票信息。支持30余种票种,应对折痕、遮挡等复杂场景,准确率超99%,可批量处理、自动验真,广泛应用于报销、财务自动化、税务合规等领域,显著提升效率,让财务工作从繁琐录入中解放。

智能图像识别 351

鸿蒙端侧OCR实战:Core Vision Kit离线文字识别

拍发票自动提金额、拍名片秒存通讯录、拍书页转纯文本——OCR(光学字符识别)是移动端最高频的 AI 能力之一。常见做法是调云端 API:图片上传、服务端识别、结果返回。(图片出设备)、(网络往返)、(按次计费)。——模型直接跑在端侧,不依赖网络、数据不出设备、免费调用。对开发者来说,集成成本还极低:一个 Kit 导入、一次 Promise 调用就能拿到带坐标的识别结果。这篇文章把从选图到解析结果的完整链路讲清楚。

qq_63223749的博客 578

刷新 OCR 能力效率双 SOTA!面壁智能MiniCPM-OCR系列开源模型上线魔乐社区

作为 MiniCPM 家族的首个 OCR 专用模型,MiniCPM-OCR 1.0 仅以 1.3B 的端侧轻量化体量,以SOTA能力和超高效率 **刷新****开源 OCR 模型的效率-性能帕累托前沿,**在真实场景文档解析评测 Real5-OmniDocBench 上取得 93.68 的 SOTA 成绩;该模型作为质检决策性质的「System-1」模型,具备跨模型的通用适配能力,能够自动判别文本、公式与表格的解析质量,整体 AUROC 达到 0.936,大幅减轻人工复核负担。

2401_87243659的博客 361

WPS图片转文字免费几次?3款免登录OCR免费档逐条读

WPS图片转文字免费几次:官网只写会员无限次,免费几次没写。逐条读OCR.space单个5MB、OnlineOCR.net游客每小时5个、图映 ImgIng本地识别的免费条款,附自制样本错字数。

2611_96826367的博客 212

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 346

图片表格变结构化数据:OCR 后的三个坑

图片表格变结构化数据:OCR 后的三个坑

weixin_44530853的博客 544

海外手写票据OCR怎么选?开灵科技、Google Document AI与百度智能云按原文译文对照、金额校验和人工复核对比

海外差旅报销里最难处理的票据,往往不是排版规范的电子发票,而是一张手写收据:当地文字、英文、印章、潦草数字混在一起,财务既要读懂商户和项目,又要判断金额是否算对。可准备泰文手写现金单、双语印刷发票和印章遮挡的收据各一张,让三种方案完成相同任务:识别票据类型、商户、币种、日期、明细和总额;以一张泰国手写现金销售单为例,识别结果按票据类型、卖方、手写明细、数量、单价、金额及总计组织,原文和中文并排显示。这类方案通常支持多语种识别、自动判断语种、原文中文对照,并处理手写体、表格、印章、签名及图像质量。

2509_91589461的博客 378

数眼智能与AI大模型API聚合平台接入实战:统一模型、Search、Reader和OCR的任务编排

本文提出一套解耦供应商的AI资源架构,通过统一领域接口、状态机编排、标准化错误处理与可观测链路,实现模型、Search、Reader、OCR等能力的灵活调度。以数眼智能等聚合平台为例,展示如何降低多源适配成本,保障任务可恢复、可审计、可优化。核心在于:统一上下文与预算,保留能力差异,让业务逻辑不绑定具体平台,真正实现AI应用从Demo到生产的可持续演进。

m0_72376392的博客 203
上一篇: 百所高校展开全球最大规模多队列蛋白质基因组学研究,基于近8万受试者数据解锁致病基因与老药新用
下一篇: 精确率达94%,西班牙团队基于YOLO11实现自动化近地天体与卫星条纹检测,连续帧之间稳定识别
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值