在线教程丨Qwen3.5 27B蒸馏Claude 4.6 Opus推理能力,兼顾高质量输出与低门槛部署

Qwen3.6-27B 本地部署踩坑实录:两块 4090 折腾一天的真实记录 《Qwen3.6-27B稠密模型部署实战》摘要:本文记录了在双4090(48GB)环境下部署Qwen3.6-27B-FP8量化模型的全过程。重点解决vLLM服务启动时transformers版本不兼容问题,推荐通过构建自定义Docker镜像升级依赖。详细讲解了关键参数配置,包括128K上下文长度保持、MTP推测解码加速等技术细节,并给出显存优化建议。实测表明该稠密模型在27B参数量级下编程能力超越上一代397B MoE模型,单卡即可流畅运行FP8版本,输出速度达90token/s,是开发者理想的编程助手。文 阅读详情

近年来,大模型不断向更强推理能力与更高推理效率演进,如何在保持模型表达能力的同时提升复杂问题求解质量,已经成为行业关注的核心方向。在这一趋势下,融合高质量推理蒸馏与结构化思维优化的新一代模型,逐渐成为主流探索路径。

2026 年 3 月,Jackrong 开源了一款高性能推理模型 Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled,其基于 Qwen3.5-27B 基础架构构建,并融合了从 Claude-4.6 与 Opus 中蒸馏得到的先进推理能力,在保持原有强大语言理解与表达能力的基础上,显著增强了复杂问题求解与多轮对话交互表现。

在核心能力层面,该模型通过引入高质量思维链蒸馏技术,实现了推理能力的全面升级,使其在数学推导、逻辑分析、规划决策以及多步骤任务拆解等场景中表现尤为突出。相比传统模型,该系统不仅能够生成答案,更能够以结构化方式逐步分析问题,将复杂任务拆解为清晰可执行的逻辑步骤,从而提升整体推理稳定性与结果可靠性。

在交互体验方面,模型支持基于 token 的流式对话生成机制,可以实现近乎实时的逐字输出效果,使用户获得更自然流畅的对话体验。同时,系统提供灵活的参数控制能力,包括 temperature、top-p 以及最大输出长度等关键配置项,使开发者能够根据不同应用场景对生成风格与输出策略进行精细化调节。

在工程实现上,该模型在 270 亿参数规模下实现了较好的性能与效率平衡,兼顾高质量输出与部署可行性。此外,模型支持自定义 system prompt,允许用户根据需求定义角色与交互风格,从而实现高度个性化的应用体验。同时,系统具备完善的会话管理能力,可自动维护上下文连续性,并支持对话清空与重启,提升长对话场景下的稳定性。

在实际应用中,该模型可在多个领域提供强大的智能对话支持。例如,在复杂推理任务中具备优秀的逻辑分析能力;在科研辅助方面可用于论文解读与实验设计;在编程辅助中支持代码生成与调试建议;在教育场景中则可用于深度问答与知识讲解。

目前,HyperAI 官网(hyper.ai)的教程板块已上线「一键部署 Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled」,快来体验高性能推理模型吧!

在线运行:

https://go.hyper.ai/PTR8m

Demo 运行

1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「一键部署 Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled」,点击「在线运行此教程」。

图片

图片

2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。

图片

3.选择「NVIDIA RTX 5090」以及「PyTorch」镜像,点击「Continue job execution(继续执行)」。

HyperAI 为新用户准备了注册福利,仅需 $1,即可获得 20 小时 RTX 5090 算力(原价 $7),资源永久有效。

图片

图片

4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。
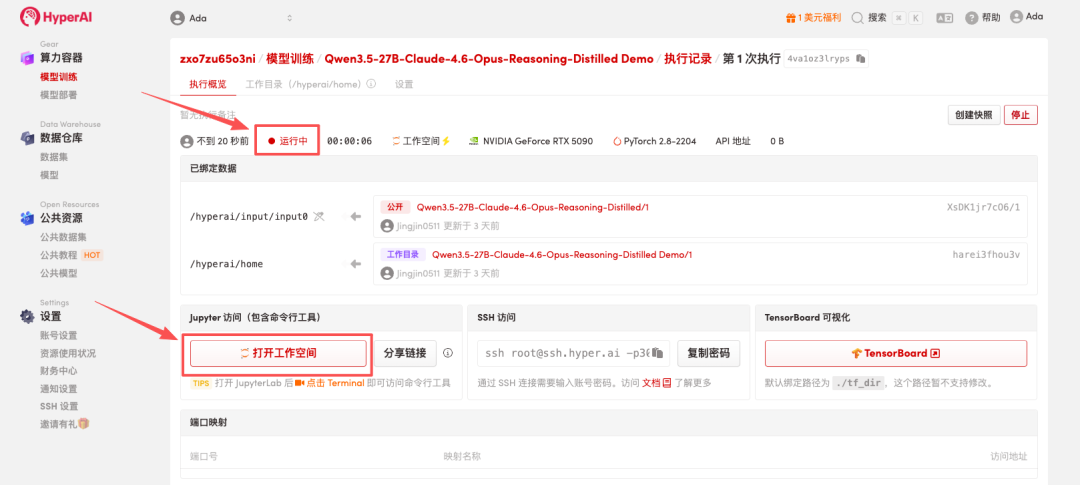
图片

效果展示

1.页面跳转后,点击左侧 README 页面,进入后点击上方 Run(运行)。

图片

图片

2.待运行完成,即可点击右侧 API 地址跳转至 demo 页面。

图片

图片

本地私有化部署 Qwen3.6-27B 实践指南 本文完整演示了 Qwen3-27B 从模型下载到服务验证的全流程部署过程。借助 vLLM 的高效推理引擎和 OpenAI 兼容接口,可以便捷地将 Qwen3-27B 接入现有应用体系。Qwen3-27B 支持的Thinking 推理模式,使其在复杂推理、代码生成、数学计算等任务上具有显著优势,值得在实际业务中深度探索。 阅读详情

相关推荐

【AI应用开发工程师】第三章:大语言模型原理

摘要 本文系统介绍了大规模语言模型(LLM)的核心原理与技术演进。从N-gram统计语言模型开始,分析了其数据稀疏、长距离依赖不足等局限。重点阐述了神经语言模型的突破性进展,包括词向量表示、Transformer架构优势,以及自回归生成机制。详细讲解了三种预训练目标(CLM/MLM/Prefix LM)及其区别,并深入剖析了KV Cache加速、解码策略(Greedy/Top-k/Top-p等)等关键技术。同时探讨了涌现能力现象、Scaling Law规律,以及主流LLM架构差异。文章通过数学公式、对比表格

sjy8207380的专栏 301

Qwen3.6-27B 本地私有化部署 + Claude Code 连接应用

Qwen3.6-27B 相比与上一代的 Qwen3.5-27B,在编程能力上有了大的飞跃,平常我们使用Claude Code做任务开发的时候,往往会消耗巨大的 Token 量,如果将一些常用重复性的开发任务使用 Qwen3.6-27B 来开发,不仅可以节省一些 Token 的使用量,还能提高响应效率。因此本文主要实现Qwen3.6-27B的本地私有化部署,以及Claude Code连接使用。

小毕超博客 5602

MMA:基于LLM顺序证据路由的多模态缺失推荐精排方案

在推荐系统与多模态机器学习领域,处理不完整数据是核心挑战。传统多模态融合模型依赖所有模态特征同时输入,当面临用户行为、视觉、文本等模态信息缺失时,性能会显著下降。其原理在于模型无法有效处理特征空间中的空白,导致表示学习不完整。为解决这一问题,顺序证据路由技术应运而生,它通过模拟人类渐进式决策过程,动态选择最有效的证据链。这项技术的价值在于提升推荐系统在真实工业场景中的鲁棒性与可解释性,尤其适用于新用户、冷门物品等数据稀疏场景。应用场景广泛覆盖电影、电商、音乐等内容推荐平台。本文介绍的Meta-Modal A

weixin_30729609的博客 377

Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled 蒸馏模型,27B 参数也能做强推理

Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled是一款高性能对话模型,通过知识蒸馏融合多模型优势,在保持27B参数轻量化的同时显著提升推理能力。

XLionXxxx的博客 774

Qwen3.5-27B本地化部署[可运行源码]

本文详细介绍了Qwen3.5-27B模型与vllm、claude-code的本地化部署过程。作者从实战角度出发,提供了完整的部署指南,包括环境准备(Ubuntu22.04 + vllm≥0.16)、硬件要求(显存最好64G)、模型下载、vllm镜像拉取、docker-compose配置、服务启动等步骤。特别说明了vllm已支持claude sdk相关协议,无需单独挂litellm代理。文章还包含了claude code的安装和环境变量配置方法,以及通过nvidia-smi命令查看GPU显存占用的实际案例。最后展示了成功启动后的API路由信息和测试结果,为AI模型本地化部署提供了实用参考。

FPGA高速接口Aurora8B/10B协议实战:从IP核配置到数据流优化

本文详细介绍了FPGA高速接口Aurora8B/10B协议的实战应用,从IP核配置到数据流优化的全流程。通过Aurora8B/10B协议,开发者可以在FPGA间实现高效的数据传输,适用于高速接口设计。文章涵盖了协议基础、IP核配置、AXI4-Stream接口实战技巧以及性能优化策略,帮助读者快速掌握这一关键技术。

weixin_29280657的博客 268

教程上新丨Qwen3.5 27B蒸馏Claude 4.6 Opus推理能力,兼顾高质量输出与低门槛部署

摘要:Jackrong于2026年3月开源高性能推理模型Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled,该模型基于Qwen3.5-27B架构,融合了Claude-4.6与Opus的蒸馏推理能力,显著提升了复杂问题求解和多轮对话表现。通过思维链蒸馏技术,模型在数学推导、逻辑分析等场景展现出色能力,支持结构化任务拆解和流式对话生成。具备270亿参数规模下的高效性能,支持自定义system prompt和会话管理,适用于科研、编程、教育等多领域。

OpenBayes的博客 627

Apollo&Carla联合仿真基本操作

基于UE4开发的开源无人驾驶仿真器PythonAPI自动驾驶传感器(还有理想化的collision detection传感器)用于规划和控制的快速仿真地图生成交通场景(open scenario)仿真ROS集成自动驾驶baseline0.9.15新特性新的车型以及地图基于Omniverse的素材导入基于OSM的三维场景生成。

SLAM小土堆 3800

Claude Opus 4.7推理能力如何迁移到Qwen3.6-35B-A3B:知识蒸馏技术深度揭秘 [特殊字符]

想要将顶尖闭源模型的推理能力迁移到开源模型上吗?Qwen3.6-35B-A3B-Claude-4.7-Opus-Reasoning-Distilled项目展示了如何通过知识蒸馏技术,将Claude Opus 4.7的强大推理能力迁移到Qwen3.6-35B-A3B模型中。这一技术突破让普通开发者和研究者也能在本地运行具备Claude级别推理能力的模型,开启了开源大模型推理能力的新篇章。 ## ?

gitblog_09705的博客 755

基于AIS动态数据与AI结合得经纬度标示算法

港口船舶智能标注系统 本系统通过结合摄像头视频流和AIS船舶动态数据,利用AI技术实现船舶实时标注功能。系统架构包括视频流处理、AIS数据解析、船舶检测匹配和坐标映射转换等模块。关键技术步骤: AIS数据获取:通过本地接收机或网络API获取船舶位置、航速等信息 AI目标检测:采用YOLOv8等模型识别视频中的船舶 船舶匹配算法:通过位置投影或运动轨迹匹配视频目标与AIS数据 坐标映射:使用相机标定技术将经纬度转换为图像坐标 实时标注:在视频画面上叠加船名、位置等关键信息 应用场景包括港口监控、智能海事管理和

qianbo042311的博客 1809

因内存不足原因导致fragment空白解决方案

在androidx之前,一般我们防止Fragment重建是在actvitity的onCreate方法中使用savedInstanceState?.remove(“android:support:fragments”)或者savedInstanceState?但是在androidx中,使用这两行代码不生效,但是看FragmentActivity中的FRAGMENT_TAG还是android:support:fragments,那为什么会不生效呢,后来点进去看发现。

qq_39431405的博客 547

Qwen3.5-9B-Claude-4.6-Opus-Reasoning-Distilled-v2与其他推理优化模型的对比研究

Qwen3.5-9B-Claude-4.6-Opus-Reasoning-Distilled-v2是基于Qwen3.5-9B进行二次优化的推理模型,通过融合Claude 4.6 Opus风格的推理模式,实现了推理效率与准确性的双重提升。本文将从核心特性、性能表现、适用场景等维度,对比分析该模型与其他主流推理优化模型的差异,为开发者和研究者提供选型参考。 ## 🌟 核心特性对比:为什么选择Qwe

gitblog_00584的博客 616

《Zephyr OS 入门与实战》第3章:第一个 Zephyr 程序 - Blinky 实战

解决方法:确认设备树overlay文件已正确加载。返回值,确认驱动初始化状态。

2301_79143213的博客 540

Qwen3.5-35B-A3B-Claude-4.6-Opus推理蒸馏模型训练全流程:从数据到部署

想要了解如何训练一个强大的推理蒸馏模型吗?本文将为你详细介绍Qwen3.5-35B-A3B-Claude-4.6-Opus推理蒸馏模型的完整训练流程,从数据准备到最终部署的每一步。这个模型通过深度蒸馏Claude-4.6-Opus的推理能力,在保持Qwen3.5强大架构的基础上,显著提升了结构化推理和链式思维(Chain-of-Thought)能力。 ## 🚀 为什么需要推理蒸馏模型? 在人

gitblog_00479的博客 299

LLC型自驱动半桥谐振变换器:电压电流变化与自然换向解析

变换器的工作状态经历了多个阶段,从模态一的关断状态,到模态二和三的电流供电状态,每个阶段都得到了合理的设计和优化。的工作原理,尤其是在半个周期内的电压和电流变化。上图 展示了该变换器在工作时的电压和电流波形,它为我们揭示了变换器如何通过精确的电流和电压控制,优化性能并实现高效能转换。,并根据负载情况调整电流和电压的工作模式,能够极大提升变换器的效率,尤其是在零电压开通和自然换向的设计中,发挥着关键作用。这意味着,电流会随着时间周期的变化,呈现典型的振荡波形,从而达到良好的电流控制。是两个关键的电流变量。

weixin_43199439的博客 279

第六部分:VTK进阶(第182章 体素化与隐式建模)

本文系统介绍了基于点云构建有符号距离场(SDF)的核心原理与VTK实现方法。主要内容包括:1)SDF的基本概念与算法原理,通过体素网格隐式表达几何表面;2)关键参数配置指南,如体素分辨率、边界范围和影响半径的选择;3)点云法向估计、SDF计算与等值面提取的完整工作流程;4)常见问题解决方案与性能优化建议。文中提供了详细的C++代码示例,展示从随机点云生成SDF并重建曲面的完整过程,特别强调了法向估计、参数调优和后处理等关键环节。该方法适用于点云表面重建、几何处理等应用场景。

仰望星空的博客 528

Qwen3.5-9B-Claude-4.6-Opus-Reasoning-Distilled-v2在实际应用中的表现:数学、编程、逻辑推理测试

**Qwen3.5-9B-Claude-4.6-Opus-Reasoning-Distilled-v2** 是一个基于Qwen3.5-9B模型的推理蒸馏版本,专门针对数学、编程和逻辑推理任务进行了深度优化。这个模型通过14000个Claude 4.6 Opus风格的通用推理样本进行训练,旨在提升思维链生成的效率,在保持准确性的同时大幅降低推理成本。 ## 🔥 模型核心优势:高效推理引擎 这个

gitblog_00036的博客 474

【产品】 产品设计:ID设计和MD设计详解

1、ID(Industry Design)工业设计 包含外观、材质、手感、颜色配搭,主要界面的实现与及色彩等方面的设计。 2、MD(Mechanical Design)结构设计 以手机为例: 前壳、后壳、手机的摄像镜头位置的选择、固定的方式、电池如何连接和手机的厚薄程度等。 如果是滑盖手机,如何让手机滑上去,怎样实现自动往上弹,SIM卡怎样插和拔的安排,这些都是手机结构设计的范畴。 繁...

产品线负责人 3万+

Qwopus3.5-27B-v3:27B参数规模如何实现95.73%编程推理新纪录?

在大型语言模型竞争日益激烈的今天,参数规模不再是衡量模型性能的唯一标准。Qwopus3.5-27B-v3作为基于Qwen3.5-27B优化的推理增强模型,在HumanEval编程基准测试中实现了**95.73%**的严格通过率,刷新了27B参数级别模型的性能纪录。这一突破不仅展示了中等规模模型在专业领域的潜力,更为开源工具和AI开发效率的提升提供了新的技术路径。 ## 技术背景:推理范式从"预执

gitblog_00426的博客 755

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Qwopus3.5-9B-v3:推理效率突破25%重塑9B模型性能边界

在AI大模型推理成本日益成为企业部署瓶颈的当下,Qwopus3.5-9B-v3通过结构化推理蒸馏技术实现了编程任务87.8%通过率的同时,将推理长度压缩25.3%,重新定义了9B参数级别模型的效率-精度平衡点。该模型基于Qwen3.5-9B优化,专为编程推理和跨学科分析任务设计,在保持低成本部署优势的同时显著提升了任务完成可靠性。 ## 行业痛点:推理冗余制约AI规模化应用 当前编程领域的AI

gitblog_00261的博客 517

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

Qwopus3.5-27B-v3:3大架构革新重构推理优化模型,95.73%编程推理新标杆

推理优化模型在参数效率与性能平衡领域迎来重要突破。Qwopus3.5-27B-v3基于Qwen3.5-27B基座,通过创新的架构设计和训练策略,在Humaneval编程基准测试中达到95.73%准确率,为中等规模AI部署提供了新的技术选择。该模型在保持27B参数规模的同时,通过结构性优化和工具调用强化学习,实现了推理效率与准确率的双重提升。 ## 技术突破亮点:4项核心创新驱动推理范式转移 #

gitblog_00226的博客 351

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

AI工具集:AI编辑器开源主模型搭配本地模型辅助对标GPT5.2/GPT5.4/Claude4.6(前端开发专属)

文章摘要: 本文提出一种低成本AI编程方案,通过开源主模型(如GLM-5.1、DeepSeek-V3.1等)搭配本地辅助模型(如35B-Claude、Qwen3.6-35B等),形成18种组合对标GPT-5.4级效果。方案针对前端开发三大场景(日常开发、技术设计、项目重构)进行评测,其中GLM-5.1+35B-Claude组合表现最优,接近GPT-5.4水平,同时降低成本和隐私风险。重点解决一线模型费用高、开源模型能力分散、工具体验不足等问题,提供本地化部署与模型互补策略,为开发者提供高性价比选择。

刻痕 606

Qwopus3.5-9B-v3:用25%更短的推理路径,获得更高的代码生成准确率

你是否曾在使用AI编程助手时感到困惑:为什么它需要那么长的"思考"时间才能给出一个简单答案?为什么计算成本总是超出预期?Qwopus3.5-9B-v3正是为了解决这些效率痛点而生的开源大语言模型。基于Qwen3.5-9B优化而来,这个9B参数的模型在编程推理任务中实现了87.8%的HumanEval基准通过率,同时将推理长度缩短了25%,重新定义了效率与精度的平衡。 ## 当AI编程助手"想太多

gitblog_00206的博客 389

DeepSeek-V2生产部署实战:算力成本与推理性能的再平衡

大模型推理已从‘能跑’迈入‘稳跑、省跑、快跑’阶段。随着MoE架构、动态稀疏激活、KV Cache量化等关键技术成熟,开源模型在吞吐、延迟、显存效率上的工程优势正重塑AI基础设施决策逻辑。DeepSeek-V2系列凭借高推理性价比(tokens/sec per dollar)和原生推理优化设计,成为中大型企业自托管替代闭源API的关键选项。其价值不仅在于降低TCO,更在于保障数据主权、满足合规要求、实现低延迟闭环——尤其适用于金融实时分析、医疗文本处理、垂直SaaS等对成本敏感且强控权的场景。本文聚焦真实产

weixin_34033624的博客 538

GPT-4稀疏激活原理:1.8万亿参数如何实现2%动态调用

大语言模型的稀疏激活是一种通过条件计算降低推理开销的核心机制,其本质是利用路由网络(Router)在海量参数中按需选择专家子集。以GPT-4为代表的MoE架构模型,虽总参数达约1.8万亿,但单次前向传播仅激活约2%参数,显著缓解显存压力与延迟瓶颈。该技术依托混合专家(Mixture of Experts)、门控线性单元(GLU)和动态置信度路由等关键技术,在保障模型能力的同时提升吞吐效率。典型应用场景包括高并发客服系统、低延迟API服务及企业级私有部署优化。理解稀疏激活,是突破‘参数迷信’、实现LLM降本增

b305723的专栏 527

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2317
上一篇: 基于2千种半导体材料的模拟光谱数据,MIT团队提出DefectNet,可解析6种共存的取代型缺陷
下一篇: 【TVM教程】理解 Relax 抽象层
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值