加州大学构建基于全连接神经网络的片上光谱仪,在芯片级尺寸上实现8纳米的光谱分辨率

【2021最新版】Dubbo面试题总结(40道题含答案解析) 文章目录1、为什么要用Dubbo?2、Dubbo的整体架构设计有哪些分层?3、默认使用的是什么通信框架,还有别的选择吗?4、服务调用是阻塞的吗?5、一般使用什么注册中心?还有别的选择吗?6、默认使用什么序列化框架,你知道的还有哪些?7、服务提供者能实现失效踢出是什么原理?8、服务上线怎么不影响旧版本?9、如何解决服务调用链过长的问题?10、说说核心的配置有哪些?11、Dubbo推荐用什么协议?12、同一个服务多个注册的情况下可以直连某一个服务吗?13、画一画服务注册与发现的流程图?14、Dubbo集群容错有 阅读详情

如今,智能手机摄像头已进入亿级像素时代,能够捕捉细节丰富的图像,却依然无法像专业光谱仪那样解析物质的化学成分,例如实现水果糖度的无损检测、皮肤健康评估或环境中微量污染物的识别。这一能力差距的关键,在于手机等设备缺少一个能够精确读取物质独特「光谱指纹」的核心部件——光谱仪。
 

传统光谱仪作为物质分析的重要工具,其工作原理是将复合光分离成不同波长的光谱,进而通过特征谱线识别物质成分。然而,这类仪器通常依赖光栅或棱镜等色散元件,需要足够的光程来分离波长,这从根本上制约了其体积的小型化。即便是微型化型号,其尺寸也往往在 200 cm² 左右。随着便携式检测与可穿戴医疗需求的日益增长,开发兼具高性能与芯片级尺寸的光谱仪已成为迫切的技术挑战。
 

由此形成了一个关键矛盾:要实现微型化,就必须舍弃传统的色散结构;但若没有色散结构,又如何获取光谱信息?

针对这一难题,加州大学的研究团队提出了一套创新的解决方案,在标准硅光电二极管表面设计了特殊的光子捕获纹理结构(PTST),并引入了一个抗噪性强的全连接神经网络。该网络能够直接从器件测量的光电流信号中,智能地计算并重建出原始光谱。这种方法不仅使光谱仪在长波长下实现了更高的信噪比,其综合性能也超越了传统硅基光谱仪。这标志着人工智能增强型光谱传感迈出了关键一步,使得紧凑的硬件能够获得以往只有大型系统才能达到的高光谱保真度。
 

相关研究成果以「AI-augmented photon-trapping spectrometer-on-a-chip on silicon platform with extended near-infrared sensitivity」为题,已发表于 Advanced Photonics。

研究亮点:

* 该研究采用抗噪声全连接神经网络破解光谱重建逆问题,让仅含 16-32 个光电二极管的紧凑型硬件,实现传统庞大系统才能达到的高光谱保真度

* 该研究搭配深度学习的智能重建,使系统在长波长区域信噪比提升超 30dB,突破传统硅基光谱仪 950nm 的探测极限

* 该研究的集成系统兼具 0.4mm² 超小体积、57ps 超快响应、>7000 高增益及 40dB 抗噪性,经蝴蝶高光谱成像验证具备实际应用价值

图片


论文地址:
https://doi.org/10.1117/1.AP.8.1.016008
关注公众号,后台回复「PTST」获取完整 PDF

更多 AI 前沿论文: 

https://hyper.ai/papers

聚焦 640-1000nm,采用 16 种具有不同光子捕获表面结构进行重建

为验证所开发的片上光谱仪在高光谱成像中的实际性能,该研究选用公开的蝴蝶高光谱数据集作为测试对象。这一数据集覆盖 420-1000nm 波长范围,包含 59 个光谱通道(光谱间隔 10nm),并以 512×512 像素空间分辨率的三维高光谱图像立方体形式提供。
 

由于实验所制备的器件在数据获取范围内的外量子效率响应主要集中于 640-1000nm,该研究采用了 16 种具有不同光子捕获表面结构(PTST)的光电二极管在该波段的光谱响应进行重建。首先,将原始数据集插值至 640-1000nm 范围内、间隔 1nm 的 361 个波长点,进而与光电二极管的模拟光谱响应进行耦合,生成对应的光电流数据,最后输入训练好的神经网络模型以重建高光谱图像。
 

网络训练阶段使用了包含超过 50 万个具有不同峰值和宽度的高斯光谱的合成数据集,模型性能通过独立的验证集进行评估。如下图所示,研究人员发现基于 16 个光电二极管在 640-1100nm 近红外波段的实验光谱响应所重建的高光谱图像,重建结果在视觉上与真值高度一致。
 

图片


蝴蝶数据集的伪彩色真值图像和重建高光谱图像
 

为进一步量化评估,该研究选取了图像中两个代表性像素(如上图,位置分别以红色与蓝色方框标出)进行光谱对比。如下图所示,重建光谱与真值光谱吻合良好,准确捕捉了蝴蝶色素在红外波段的反射特征变化。
 

图片


像素的重建高光谱光谱与真值光谱的对比结果

构建基于人工智能增强的光子捕获片上光谱仪

在该研究中,光谱重建的核心是一个经过专门设计的全连接神经网络,其任务是从光电二极管阵列测得的光电流信号中,反向推导出未知的入射光谱。这本质上是一个求解逆问题的过程:由于探测器的光谱响应存在重叠,导致系统响应矩阵呈病态,传统的直接求逆方法不稳定且对噪声敏感。而神经网络能够通过学习,建立从测量信号到原始光谱的稳健映射,同时天然具备去噪和正则化的能力。
 

该网络的架构包括一个输入层、四个隐藏层和一个输出层。输入层接收来自 16 个光电二极管的光电流信号,输出层则直接给出重建后的光谱数据。隐藏层使用 ReLU 激活函数引入非线性,输出层采用线性激活函数。网络规模(神经元数量)根据光谱数据的复杂性进行了针对性优化。训练采用了一个包含超过 50 万个模拟光谱的大型合成数据集,这些光谱由具有不同峰值和宽度的高斯曲线构成,以确保模型能学习到广泛的光谱形态。
 

图片


神经网络训练和重建流程示意图
 

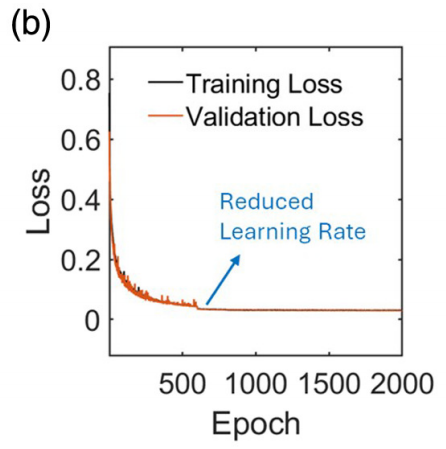
在训练策略上,研究人员采用了基于 PyTorch 框架实现的 Adam 优化器。经过对多种损失函数的测试,最终选用了一个结合均方根误差(RMSE)与皮尔逊相关系数(R)的自定义组合损失函数,该函数被证明能特别有效地重建具有尖锐峰值的窄带光谱。具体训练 batch size 设为 32,learning rate 为 0.001。研究人员训练了 1000 个轮次,并在第 600 轮后将学习率降至 0.0001 以促进模型更好收敛。为防止过拟合,训练过程中采用了早停法。如下图所示,训练与验证损失均快速下降并最终收敛,表明模型学习良好且具备较强的泛化能力。
 

图片


训练损失和验证损失随迭代次数的变化曲线
 

为验证该神经网络的性能,研究人员将其与两种传统重建方法进行了对比。如下图所示,简单的矩阵伪逆法(Pseudo-Inversion)以及对光谱进行基函数(如高斯或正弦函数)线性组合(Linear Combination)的方法,在重建窄线宽激光光谱时均表现不佳,其 RMSE 约为 0.12,相关系数 R 约为 0.63。

相比之下,神经网络(Neural Networks)能够精准捕捉尖锐的光谱特征,将 RMSE 显著降低至 0.046,并将相关系数R提升至 0.87。这一结果清晰地证明了神经网络在解决此类逆问题上的优越性,它不仅实现了更高的重建精度,其固有的学习特性也使其在面对噪声干扰时表现得更为鲁棒。
 

图片


光谱重建方法对比

在 0.4mm² 上实现了 8 纳米的光谱分辨率

为全面验证 AI 增强型片上光谱仪的性能,该研究开展了一系列实验,重点评估了神经网络模型在光谱重建中的核心作用及其实际表现。
 

首先,研究人员使用窄带激光测试了系统的核心探测能力。实验表明,集成了光子捕获表面结构的光电二极管,在 640-1100 纳米波段,尤其是长波近红外区域表现出显著提升的灵敏度与信噪比。关键的是,将这些探测器阵列的响应输入训练好的神经网络后,系统能够精准重建激光光谱。当参与重建的探测器数量增加至 16 个以上时,重建光谱与基准真值的平均误差降至 0.05 以下,相关系数超过 0.85。这验证了硬件提供的独特光谱编码与 AI 算法的解析能力能够有效协同,共同实现高精度测量。
 

图片


激光峰光谱重建
 

噪声鲁棒性是评估重建算法优劣的关键。研究通过在真实测量数据中主动添加高强度模拟噪声来检验系统的稳健性。结果表明,即使面对高达 40 分贝的附加噪声,神经网络模型仍能稳定重建出可辨的光谱轮廓,并保持约 30 分贝的输出信噪比。这与传统方法在噪声下性能急剧恶化形成鲜明对比,凸显了所采用的神经网络具备强大的内在正则化与噪声抑制能力,这是其实现实际应用价值的关键。
 

图片


光子捕获表面结构光谱仪的抗噪声性
 

为进一步展示其解决复杂问题的潜力,研究将系统应用于高光谱成像任务。利用训练好的神经网络,系统仅凭 16 个探测器的响应,便成功从开源蝴蝶数据集中重构出 512×512 像素的高光谱图像立方体。最终,研究人员采用均方误差(MSE)和结构相似性指数(SSIM)对整体重建精度进行定量评价。在所有重建波长上,平均 MSE 低至 2.3×10⁻⁴,平均 SSIM 高达 0.9926,表明系统具备极高的光谱保真度,证明了 AI 能够从极简的硬件信息中解码并复原出复杂的高维光谱空间信息,完成了从「点光谱」到「光谱成像」的跨越。
 

图片


不同红外波长下的重建高光谱图像与光谱重建精度
 

最终,这款 AI 增强型光谱仪在芯片级尺寸(0.4 mm²)上,实现了 8 纳米的光谱分辨率、50 分贝的动态范围及 30 分贝的实用信噪比。横向对比表明,这一由智能算法与先进光子学硬件协同构建的系统,在综合性能上超越了多数同类微型化方案,标志着智能光谱传感向实用化迈出了坚实的一步。

微型化光谱传感的现在与未来

微型化与智能化光谱传感,正成为全球科研与产业竞相突破的前沿。近年来,从顶尖高校的基础研究到科技企业的应用探索,一系列创新案例清晰地表明,将实验室级的光谱分析能力嵌入芯片乃至日常设备,已步入加速实现的快车道。
 

在学术界,研究的焦点集中于通过颠覆性的光子芯片设计与人工智能的深度协同,从根本上重塑光谱仪的形态。韩国首尔大学的研究团队在 Nature Communications 上提出了一种新方案,利用等离子体纳米粒子构成的微型腔体作为滤波器阵列,结合机器学习算法,在微米尺度上实现了亚纳米级的光谱分辨率。
论文标题:Miniature computational spectrometer with a plasmonic nanoparticles-in-cavity microfilter array
论文链接:https://www.nature.com/articles/s41467-024-47487-y
 

与此同时,瑞士洛桑联邦理工学院(EPFL)的科学家则从系统集成的另一关键环节入手,成功在芯片上制造出了高性能、波长可精确调谐的掺铒波导激光器。这项发表于 Nature Photonics 的突破,意味着未来集成光谱系统有望获得一个稳定、优质的片上光源,向构建完整「芯片上的实验室」迈出坚实一步。
论文标题:A fully hybrid integrated erbium-based laser
论文链接:https://www.nature.com/articles/s41566-024-01454-7
 

产业界的创新则更加贴近市场,致力于将前沿技术转化为解决实际问题的产品和方案。捷克初创企业 Iron Analytics 在 2025 年推出了世界上首款便携式穆氏(Mössbauer)光谱仪,其革命性在于,将原本重达 15 公斤、长达 70 厘米的实验室柜式设备,成功微型化到了一个可乐罐大小的便携装置中,标志着微型化光谱技术正从消费端的好奇心工具,深度渗透至核心工业领域,成为提升生产效率和工艺控制的现实生产力。
 

综上所述,微型化与智能化光谱传感的愿景,其技术拼图正在被一一填补。然而,真正的「嵌入日常」仍面临成本、可靠性与数据解读易用性等现实关卡。或许在不远的未来,当光谱传感模块能像今天的摄像头一样被廉价而稳定地批量制造时,人们感知世界的维度将迎来一次静默却深刻的革命。届时,解读万物的「光指纹」,将不再是实验室的专属,而成为人们认识周遭环境的又一种本能。

工业视觉降本300%实战:C# + 开源YOLO如何干掉Halcon/VisionPro? 在当前制造业普遍追求“降本增效”的大背景下,工业视觉检测系统作为产线的眼睛,其成本问题日益突出。通过该方案,我们成功帮助一家电子厂将单条产线的视觉检测成本从15万降低至不足5千(主要为工控机硬件成本),降本幅度超过95%,且系统稳定性经受住了6个月连续生产的考验。:C#负责“工程化”和“业务逻辑”,YOLO负责“智能算法”,二者结合,完美覆盖了工业视觉从算法到落地的全链路。的组合,构建一套高性能、低成本、易维护的工业视觉解决方案,并彻底替代昂贵的付费库。” 这是一个典型的误区。工业相机/USB相机。 阅读详情

相关推荐

Agent Skills:AI智能体规模化落地的基础设施

摘要:AgentSkills体系已成为AI智能体落地的核心基础设施,解决了能力扩展和行业知识沉淀两大核心难题。该开放标准通过语义优先、渐进式披露等设计原则,实现了工具调用的标准化和可控化,同时支持轻量化知识沉淀。Skill作为最小能力单元,将传统软件功能、行业知识等封装为可被智能体调用的标准化模块,推动了软件产业从"工具时代"向"智能体时代"的范式变革。目前该体系已被主流Agent工具广泛兼容,形成完整生态,未来将持续演进,进一步降低落地门槛,推动AI原生转型。

技术引领业务创新 1158

python torch 自定义神经网络NN

经过epochs次训练,每次epoch训练多个batch_size个样本,Loss逐渐减少。自定义全连接神经网络需要继承Model,重写__init__ 和forward方法。

frt的博客 223

Cesium中GLB模型加载

Cesium中GLB模型加载全解析:Primitive与Entities方法详解

m0_72030584的博客 3471

基于神经网络的机器人导航系统的设计与执行!

基于神经网络的机器人导航系统,本质上是一个“感知-规划-控制”的闭环。它的核心优势在于强大的泛化能力和端到端的简洁性,能够处理传统几何方法难以解决的复杂场景(如密集人群、非结构化地形)。

m0_65595995的博客 223

极空间NAS零基础部署Wiki.js:Docker+PostgreSQL全流程避坑指南

本文提供了一份在极空间NAS上从零部署Wiki.js私有知识库的详细指南。通过Docker容器化技术,结合PostgreSQL数据库,手把手讲解环境准备、核心组件配置、性能优化及安全加固等全流程,并特别针对极空间平台特性提供了避坑要点,帮助用户打造安全、高效、自主可控的知识管理系统。

3a9bq4r8t2y的博客 486

无人机核心部件解析:从机架到飞控的全面指南

本文全面解析无人机的核心部件,从机架材质选择到飞控系统调参,提供专业指南。重点介绍碳纤维机架、无刷电机搭配、锂聚合物电池管理及飞控传感器配置,帮助读者掌握无人机组装与优化的关键技术,适用于航拍、测绘、农业植保等多种应用场景。

weixin_30872499的博客 467

Pytorch 【5】神经网络基础(nn.Module、卷积层、池化层、线性层)

前面我们学习了张量Tensor、自动求导Autograd,这两个是Pytorch最底层的基石。在真实项目中,我们不会手动去写大量求导逻辑,torch.nn模块封装好了神经网络各类层、损失函数,让我们快速搭建网络。本篇重点讲解nn.Module以及常用网络层:卷积Conv、池化Pool、全连接Linear。,和opencv、PIL的HWC相反!卷积之后进全连接,一定要flatten展平,否则维度对不上padding的作用:控制特征图尺寸不变,same padding池化层不改变通道数,只缩小高宽。

Beforthing的博客 177

用 Python 和 uiautomation 实现微信批量发送

思路是这样,将要发送的人员名单(包括称呼)以及发送内容都维护到Excel里,程序运行时读取Excel里内容,自动搜索人员姓名(微信昵称或备注名),填入要发送的内容,拼接上称呼(如果需要的话)自动点击发送,这样轮巡直至名单人员全部发送完成。、

jankingdom的专栏 1471

第 02/24 期:从线性模型到多层感知机:神经网络的表示能力

本文探讨了线性模型的表达局限,指出其函数族仅能表示超平面边界,无法解决非线性可分问题(如XOR)。通过多层感知机引入非线性激活函数(如ReLU、tanh),网络可构建分段线性或光滑非线性函数,显著提升表示能力。实验表明,单隐藏层MLP在拟合复杂目标函数时优于仿射模型。但需区分表示能力、优化可达性与泛化性能三者:即使模型理论上可逼近任意函数,实际训练仍受初始化、优化路径和样本限制。

weixin_47502228的博客 338

西门子S7-200 SMART PLC控制伺服电机

以下是使用西门子S7-200 SMART PLC控制伺服电机的详细程序框架和配置说明,涵盖硬件接线、PLC配置和基本运动控制逻辑。具体实现需根据伺服电机型号(如松下、三菱、台达等)调整参数。通过以上步骤,可实现伺服电机的基础位置控制。实际应用需根据设备机械参数和伺服驱动器手册调整细节。建议在调试时逐步测试脉冲输出和方向信号是否正常。

CHUXUEZHE8210的博客 6425

【Claude Code】Not logged in 未登录错误解决方案 + /login 认证路径

Claude Code 启动时提示 Not logged in 表示当前会话缺少有效凭证。本文从环境变量、API Key 配置、CI 自动化凭证脚本和系统时钟四个维度,提供完整的认证排查流程与修复方案。

多媒体编程、网络编程、系统编程、网络安全编程、驱动编程 894

ai药物 对应的D-MPNN(有向消息传递神经网络) Chemprop Python 库,实现了 D-MPNN

前 49 讲是通用图机器学习体系;D-MPNN 这一新模块是把消息传递机制"从节点搬到有向边上",专门为分子性质预测设计的高效变体。学它之前,建议确保已掌握第 3 章 MPNN 的消息传递三要素(消息函数、聚合函数、更新函数),再学 D-MPNN 会非常顺。需要我进一步展开 D-MPNN 的完整数学推导、Chemprop 代码结构,或者帮你制定一份这门课的学习计划(按每天学习时长排期)吗?

AI 前沿技术实战博客:LLM / Agent / AI 制药 / 生信四大栏目日更,硬核干货 + 可复现代码,看完就能上手 326

YOLO11改进|注意力机制篇|引入ELA注意力机制

YOLO11添加ELA注意力机制

A1983Z的博客 3647

从“人工智障”到“智能”,没有激活函数的神经网络只是在叠直线

没有激活函数的神经网络仅能表示线性关系,即使堆叠多层也无法拟合复杂非线性模式,导致模型表现如“人工智障”。激活函数(如ReLU)引入非线性,使网络能分段拟合复杂边界,实现从“画直线”到“拼曲线”的跃迁。正确使用激活函数、避免输出层重复激活、合理选择损失函数,是解决模型失效的关键。

JYF2007ABC的博客 383

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

数据是如何输入到神经网络的?

通过对前面文章的学习,我们已经知道神经网络可以实现真正的人工智能。本小节我会进行详细地讲解,让大家彻底地弄懂神经网络。我们需要弄懂的第一步就是如何将数据输入到神经网络中。例如,在我们百度的“小度智能屏”中,是如何将麦克风采集到的音频数据输入到神经网络中的;小度智能屏还能根据人脸来判断年龄从而自动切换成人和儿童模式,那它又是如何将摄像头采集到的人脸数据输入到神经网络中的此例中,待输入的数据是一张图像。

calm_programmer的博客 298

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

神经网络与深度学习笔记_Day2

神经网络与深度学习笔记_Day2,包含 张量 与 自动微分。 写于2026/01/21。

ZZHow Blog 102

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Week1/理解并独立跑通一个神经网络的训练过程

import torch ​​​x = torch.arange(12) Arange创建行向量 x.shape 形状 x.numel() 元素总数 X = x.reshape(3, 4) reshape调整形状不调整数值 torch.zeros((2, 3, 4)) tensor([[[0., 0., 0., 0.], [0., 0., 0., 0.], [0., 0., 0., 0.]], [[0., 0.,

李韶华 199

AI前沿日报 | 2026-11-03 — 基因突变:当AI开始重写神经网络

MIT团队发现GPT-6 Astra可直接读写神经网络权重,仅需编辑0.016%参数即可将Qwen3.5-0.8B的MATH-500得分从7.9%飙升至48.1%,已在arXiv发布演示页面。Ubuntu对CVSS 9.8级Linux内核TCP协议栈远程代码执行漏洞CVE-2026-98432三周未修补,志愿维护的Debian/Arch/Alpine均已发布补丁,Canonical安全响应能力受质疑。Anthropic内部AI使用费按零售价折算已超员工薪酬,90%新增代码由AI编写;比亚迪AI工厂实现"黑灯

johnsong2009的博客 403

DeepXDE 物理信息神经网络(PINN):自动微分嵌入 PDE 求解的计算特征与 UltraLAB 图形工作站选型

单卡显存决定单任务上限,CPU 高主频多核决定试验吞吐。入门者一张 12—16 GB 显卡即可开展研究;做三维反问题与算子学习的团队建议 24 GB 级单卡起步、64 GB 以上内存;需要批量反演与不确定度量化的实验室按"多卡多任务"扩展,并把预算优先给显存与内存,而非盲目堆卡数。DeepXDE 多后端特性使同一环境可服务 TensorFlow/PyTorch/JAX 三类技术栈,部署时注意 CUDA 版本与后端版本的匹配。

185

【零基础学AI】第 23 章——用神经网络识别图片

上一章的模型只接收一个数字。本章把输入换成一张手写数字图,输出换成 0 至 9 中的一个类别。训练循环依然包含计算损失、求梯度和更新参数,但图片怎样装进张量、怎样分批,以及训练完怎样单独使用模型,都需要交代清楚。我们选一组很小的公开图片。普通电脑的 CPU 就能完成训练,读者可以把时间花在看清每一步。本章随附训练脚本、固定数据快照、模型参数和单图预测入口。执行代码见。

m0_73879806的博客 483

Qwen 与 GPT-6 直接读写神经网络权重,大模型开始编辑其他模型的行为逻辑

Qwen 和 GPT-6 Astra 通过读取神经网络权重判断模型功能并修改其行为,实验显示 GPT-6 Astra 仅编辑 0.8B 参数模型 0.016% 的权重即可将其数学准确率从 7.9% 提升至 48.1%。

wfly blog 111

为什么神经网络经过剪枝后仍能保持较高性能,稀疏性、冗余参数与泛化之间是什么关系?

神经网络之所以能在移除大量参数(甚至高达 90% 以上)后仍保持较高性能,根本原因在于深度模型普遍存在**严重的过参数化(Over-parameterization)**现象。在实际操作中,为了在保持性能的同时实现高稀疏度,通常采用**迭代式剪枝(Iterative Pruning)**策略:先评估权重重要性,移除一部分,微调恢复性能,再循环此过程。稀疏性不仅仅是压缩模型的手段,它通过改变优化景观(Optimization Landscape)和正则化效应,直接提升了模型的泛化能力。

2402_84593233的博客 205

不用神经网络!自己设计一款带记忆、同义词识别的轻量对话机器人(符号派小Demo)

本文介绍一种无需深度学习的符号主义对话机器人实现:通过同义词分组、状态记忆与候选回复池,构建可解释、可控的轻量级对话系统。代码基于C++,支持多话题识别、记忆递增与差异化回复,避免死板查表。虽无自主学习能力,但逻辑透明、易于扩展,适合教学与简单交互场景。

weixin_56334307的博客 281

从万物互联到万物智联:6G,下一代数字世界的神经网络

网络 “长眼睛、有大脑”,可以实现厘米级定位、障碍物探测、动态环境识别,支撑自动驾驶、低空无人机、工业机器人、沉浸式XR等业务,也是AI-RAN的底层核心能力新华网。6G的核心目标:万物智联,网络原生具备感知、计算、AI推理能力,服务对象从人、机、物延伸到智能体,覆盖空间从地面拓展到空、天、地、海全域国际科技创...。面向6G通信、通感一体、毫米波 / 太赫兹、信道仿真、相控阵雷达全场景,模块化可扩展SDR平台,是科研院所、通信企业、设备厂商开展6G技术预研、原型开发、标准验证的首选硬件底座。

V3_Bs的博客 218

为什么神经网络在训练集损失已接近零后继续训练,测试性能仍可能继续提升,而不是单纯地越来越过拟合?

神经网络在训练集损失接近零后测试性能仍能提升,是因为模型正处于**“零误差流形上的隐式正则化”阶段。此时,优化算法正在众多能完美拟合训练数据的解中,寻找间隔最大、权重最平滑、特征最鲁棒**的最优解。正面效应:继续训练可以 sharpen 特征表示,扩大分类间隔,从而提升泛化能力。负面风险:一旦越过临界点,模型将开始记忆噪声,导致权重爆炸和决策边界尖锐化,引发过拟合。最佳实践:绝不能以训练集 Loss 为零作为停止信号。必须依赖验证集监控和早停策略(Early Stopping)

2402_84593233的博客 230

PINN-LSTM物理信息神经网络的CO2羽流分布预测方法,四模型对比MATLAB代码

PINN-LSTM物理信息神经网络的CO2羽流分布预测方法,四模型对比MATLAB代码

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 472
上一篇: 【vLLM 学习】Save Sharded State
下一篇: TRELLIS.2:采用 O-Voxel 技术,高效生成复杂 3D 几何与材质;Patient Churn Prediction 数据集:帮助识别有流失风险的患者
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值