一键部署Qwen3开源三件套!端到端架构突破跨模态能力;10w个体样本!Health&Lifestyle洞悉生活方式与健康关联

混元图像3.0:开源可部署的视觉推理模型解析 视觉推理是让AI从‘看见’走向‘理解’的关键范式,其核心在于将图像特征映射为可解释、可验证、可行动的语义逻辑。基于思维链(Chain-of-Thought)与动态视觉记忆等机制,现代视觉推理模型正突破传统判别式学习的局限,实现跨任务泛化、小样本适应与多图协同分析。这类技术已广泛应用于工业质检、医疗影像初筛、农业病害识别等对可解释性与落地性要求严苛的场景。混元图像3.0作为开源免费的第三代视觉推理模型,通过轻量化思维链蒸馏与指令驱动闭环设计,在保持14B参数规模的同时,显著提升推理轨迹质量与中文指令遵循能力, 阅读详情

当人工智能不断演进,用户对于大模型的交互需求不再局限于单一的文本问答或图文对话,而是希望能像与人交流一样,自由运用语言、图像、音视频进行沟通。现有的技术方案大多仍局限于少数几种模态的组合,或在某一特定模态上进行专项优化,距离跨模态的深度融合与流畅交互仍有差距。

基于此,阿里通义千问团队发布了原生全模态大模型 Qwen3-Omni,包含 Qwen3-Omni-30B-A3B-Instruct(指令跟随)、Qwen3-Omni-30B-A3B-Thinking(推理)和通用音频字幕器 Qwen3-Omni-30B-A3B-Captioner。它通过端到端的统一架构,实现了对文本、图像、音频、视频四大核心模态的深度理解与生成,并能够以文本或自然语音的形式进行流式输出。

Qwen3-Omni 致力于在单一模型中实现多模态能力的均衡发展和高效协同,减少以往多模态模型在不同能力之间的权衡取舍问题,为跨模态交互拓展了新的可能性,也推动了多模态大模型从「单点突破」向「全能协作」的进一步演进。

目前,HyperAI超神经官网已上线了「Qwen3-Omni:突破模态边界的全能选手」「Qwen3-Omni-30B-A3B-Captioner:音频描述大模型」,快来试试吧~

在线使用:

「Qwen3-Omni:突破模态边界的全能选手」

https://go.hyper.ai/jvqEE

「Qwen3-Omni-30B-A3B-Captioner:音频描述大模型」

 https://go.hyper.ai/Jnz7b

9 月 22 日-9 月 30 日,hyper.ai 官网更新速览:

* 优质公共数据集:10 个

* 优质教程精选:7 个

* 本周论文推荐:  5 篇

* 社区文章解读:5 篇

* 热门百科词条:5 条

* 10 月截稿顶会:6 个

访问官网:hyper.ai

公共数据集精选

1. Brain Tumor(MRI)Detection 脑肿瘤影像数据集

Brain Tumor(MRI)Detection 是一个用于检测是否有脑肿瘤的医学影像分类数据集,旨在为机器学习模型提供用于脑肿瘤检测任务的 MRI 图像样本。该数据集由磁共振成像(MRI)图像构成,图像被划分为含有脑肿瘤的病例和不含脑肿瘤的正常病例两类。

直接使用:https://go.hyper.ai/1MGt3

数据集示例

2. BRISC 2025 脑肿瘤 MRI 分割与分类数据集

BRISC 2025 是一个用于脑肿瘤分割与分类的磁共振成像(MRI)数据集,该数据集同时支持两类任务:一是分类任务,即基于 MRI 图像的多类肿瘤识别;二是分割任务,即利用配对的 MRI 图像与掩模进行像素级肿瘤区域检测。其组织结构清晰,图像与掩模文件名严格对齐,便于直接应用于深度学习模型的训练与验证。

直接使用:https://go.hyper.ai/cOBZ4

数据集示例

3. GenExam 多学科文生图考试基准数据集

GenExam 是由上海人工智能实验室联合上海交通大学、清华大学等机构发布首个多学科文本到图像的考试风格基准数据集,旨在检验模型是否能够整合理解、推理与生成能力,从而真正解决绘图类问题。

直接使用:https://go.hyper.ai/AWu0s

数据集示例

4. Nav CoT-110k 轨迹推理数据集

Nav CoT-110K 是一个专为具身导航(embodied navigation)任务构建的大规模轨迹推理数据集,旨在训练和评估模型在复杂三维场景中进行结构化推理与动作规划的能力,并作为 Nav-R1 框架冷启动阶段的重要基础。

直接使用:https://go.hyper.ai/HR64E

5. MMPR-v1.2-Prompts 多模态推理提示语数据集

MMPR-v1.2-Prompts 是由上海人工智能实验室联合清华大学、复旦大学等机构发布的一个面向多模态推理偏好学习的提示语料集合,旨在支持模型在复杂的视觉–语言推理任务中的训练与评估。

直接使用:https://go.hyper.ai/Pe4RV

6. CHIRLA 高分辨率人物重识别数据集

CHIRLA 是由阿利坎特大学计算研究所发布的一个用于人物重识别(Re-ID)与跟踪研究的多摄像头视频数据集,旨在评估长期、复杂场景下的 Re-ID 与跟踪算法性能。数据集内包含的所有视频帧均经过半自动标注,构建了一个大规模的多视角、多时间跨度的多人跟踪与重识别标注数据集。

直接使用:https://go.hyper.ai/shhvL

数据集示例

7. MultiEdit 多模态图像编辑数据集

MultiEdit 是由 inclusionAI 联合新南威尔士大学和香港大学等机构发布的一个全面的大规模基于指令的图像编辑数据集,旨在推动模型在复杂、多样化的图像编辑任务中的能力提升。该数据集覆盖 6 大编辑任务与 56 种子类别编辑类型,包括对象引用编辑、人物引用编辑、文本与界面元素调整、视角变换及风格迁移等。

直接使用:https://go.hyper.ai/g5YH1

8. InternScenes 室内模拟场景数据集

InternScenes 是由上海人工智能实验室联合上海交通大学、北京航空航天大学等机构发布的一个具有逼真布局的大规模可模拟室内场景数据集,相比以往数据集,该数据集特别保留了大量小型物体,从而构建出更加逼真且复杂的场景布局,每个区域平均包含 41.5 个对象。

直接使用:https://go.hyper.ai/f1bnk

数据集示例

9. Health & Lifestyle 健康生活方式数据集

Health & Lifestyle 是一个有关健康生活方式数据集,旨在探索生活方式因素与个体健康状况之间的关系,为健康预测建模、聚类分析和数据挖掘提供实验基础。该数据集共包含 100,000 条个体记录,以 CSV 表格的形式提供,涵盖了从人口统计学特征到健康状态与生活习惯的多维度信息。

直接使用:https://go.hyper.ai/vyuBz

10. Sleep Disorder Diagnosis 睡眠障碍诊断数据集

Sleep Disorder Diagnosis 是一个有关睡眠健康和生活方式数据集,旨在为研究睡眠习惯、生活方式与健康状况之间的关系提供数据支持。该数据集包含 374 个个体样本,每个样本均记录了多维度的特征信息,最终以是否存在睡眠障碍及其类型作为目标标签。

直接使用:https://go.hyper.ai/b1TLw

公共教程精选

本周汇总了 3 类优质公共教程:

* OCR 教程:2 个

* Qwen 系列教程:3 个

* 音频生成 TTS 教程:2 个

OCR 教程

1. POINTS-Reader:无蒸馏端到端的轻量级文档视觉语言模型

POINTS-Reader 是由腾讯、上海交通大学与清华大学联合推出的一款专为文档图像转文本设计的轻量级视觉-语言模型(VLM)。该模型不追求参数规模,也不依赖教师模型「蒸馏」,而是通过一套两阶段自进化框架,在保持结构极简的同时,实现对中英文复杂文档(含表格、公式、多栏排版)的高精度端到端识别。

在线运行:https://go.hyper.ai/yM506

效果示例

2. Granite-docling-258M:轻量多模态文档处理模型

Granite-Docling-258M 是由 IBM 推出的轻量级视觉语言模型,专为高效文档转换设计。该模型能将文档转换为机器可读格式,同时完整保留布局、表格、公式等元素,支持多语言(包括阿拉伯语、中文和日语)处理。

在线运行:https://go.hyper.ai/b8WSY
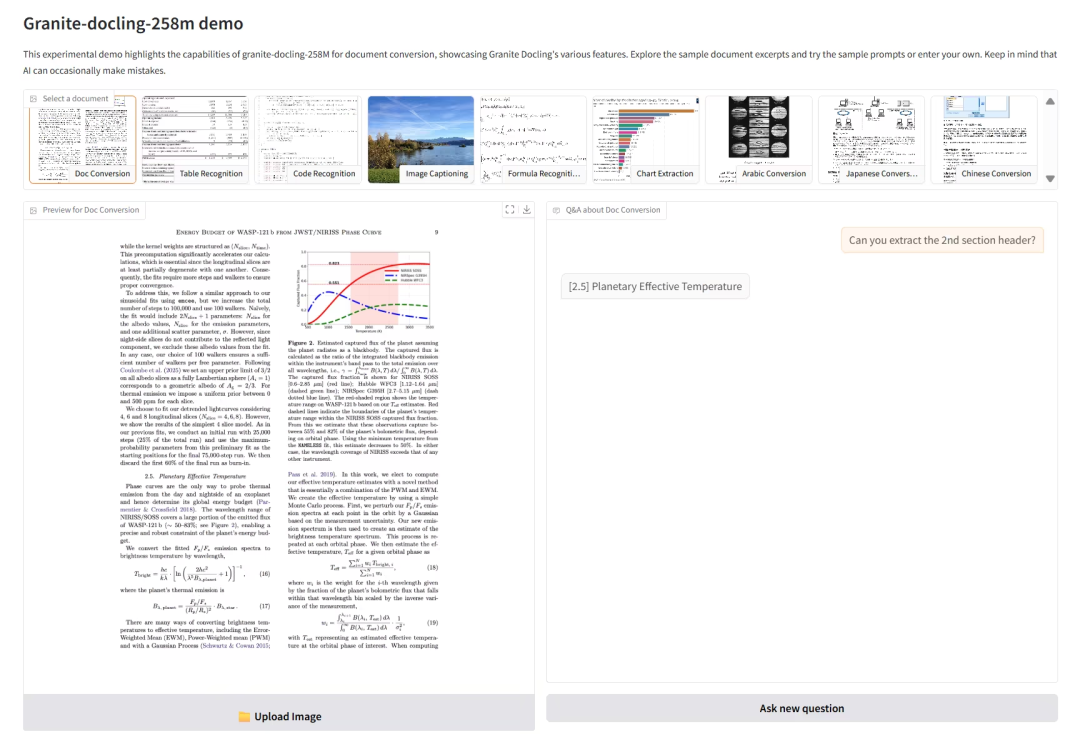
效果示例

Qwen 系列教程

1. Qwen-Image-Edit-2509:多图像编辑器

Qwen-Image-Edit-2509 是由阿里巴巴通义千问团队发布的全能图像编辑模型。新版本模型相比 8 月份开源的 Qwen-Image-Edit,单图编辑的一致性有所提升,同时新支持多图编辑功能,支持深度图、边缘图、关键点图,可控性更强,出图更自由。

在线运行:https://go.hyper.ai/1TJnb

效果示例

2. Qwen3-Omni:突破模态边界的全能选手

Qwen3-Omni 是由阿里巴巴通义千问团队推出的业界首个原生端到端全模态 AI 模型,能够处理文本、图像、音频和视频多种类型的输入,并可通过文本与自然语音实时流式输出结果,解决了长期以来多模态模型需要在不同能力之间进行权衡取舍的难题。

在线运行:https://go.hyper.ai/jvqEE

效果展示

3. Qwen3-Omni-30B-A3B-Captioner:音频描述大模型

Qwen3-Omni-30B-A3B-Captioner 是由阿里巴巴通义千问团队发布的音频描述大模型,无需任何提示,该模型能够自动为复杂语音、影视声效等生成精准全面的描述,能识别说话人情绪、音乐元素(如风格、乐器)、敏感信息等,适用于音频内容分析、安全审核、意图识别、音频剪辑等多个领域。

在线运行:https://go.hyper.ai/Jnz7b

效果展示

音频生成 TTS 教程

1. VoxCPM:无分词器的 TTS 技术

VoxCPM 是由面壁智能与清华大学深圳国际研究生院联合开发的 0.5B 参数语音生成模型,在语音合成的自然度、音色相似度及韵律表现力方面达到了业界顶尖水平。该模型采用端到端的扩散自回归架构,直接从文本生成连续语音表示,突破了传统离散分词的局限。

在线运行:https://go.hyper.ai/a4erS

效果展示

2. IndexTTS-2:突破自回归 TTS 时长与情感控制瓶颈

IndexTTS-2 是由哔哩哔哩语音团队开源的新型文本转语音(TTS)模型,在情感表达和时长控制方面实现了重大突破,是首个支持精确时长控制的自回归 TTS 模型。同时该模型支持零样本声音克隆、情感音色分离控制、多模态情感输入功能。

在线运行:https://go.hyper.ai/idJAy

效果展示

💡我们还建立了 Stable Diffusion 教程交流群,欢迎小伙伴们扫码备注【SD教程】,入群探讨各类技术问题、分享应用效果~

本周论文推荐

1. RPG: A Repository Planning Graph for Unified and Scalable Codebase Generation

本文提出代码库规划图(RPG),通过将能力、文件结构、数据流和函数等要素统一编码为一张图,实现了方案层与实现层规划的融合。RPG 以明确的蓝图取代模糊的自然语言,支持长周期规划与可扩展的代码库生成。基于 RPG,研究人员还构建了从零开始生成代码库的图驱动框架 ZeroRepo。

论文链接:https://go.hyper.ai/YiE4q

2. Baseer: A Vision-Language Model for Arabic Document-to-Markdown OCR

本文提出了一种专为阿拉伯语文档 OCR 任务进行微调的视觉-语言模型 Baseer,通过结合大量合成文档与真实世界文档的超大规模数据集,该模型采用仅解码器结构的微调策略,在保留预训练 MLLM 通用视觉特征的同时,对模型进行针对性适配。

论文链接:https://go.hyper.ai/nBqaV

3. Qwen3-Omni Technical Report

本文提出多模态模型 Qwen3-Omni,首次在文本、图像、音频和视频四种模态上均实现了当前最先进的性能。在相同参数规模下,该模型性能与 Qwen 系列中的单模态模型相当,并在音频任务上表现尤为突出。

论文链接:https://go.hyper.ai/uC2kn

4. LIMI: Less is More for Agency

本文通过提出 LIMI(Less Is More for Intelligent Agency)证明,智能体性的演进遵循截然不同的发展规律。通过聚焦协作式软件开发与科学研究工作流等关键场景,研究人员发现:仅需少量但经过战略性筛选的自主行为示范,即可催生出高度复杂的智能体智能。

论文链接:https://go.hyper.ai/rjakg

5. OmniInsert: Mask-Free Video Insertion of Any Reference via Diffusion Transformer Models

本文进一步开发了 OmniInsert,一种面向单主体或多主体参考的统一无掩码视频插入框架。具体而言,为保持主体与场景之间的平衡,研究人员引入了一种简单而有效的条件特异性特征注入机制,能够清晰地区分并注入多源条件信息;同时提出一种新颖的渐进式训练策略,使模型能够有效平衡来自主体和源视频的特征注入。

论文链接:https://go.hyper.ai/mZRqt

更多 AI 前沿论文:https://go.hyper.ai/iSYSZ

社区文章解读

1. 机器学习vs.动力学模型,Ai2最新研究:仅需2分钟,ACE2可完成一次4个月季节预报

英国埃克塞特哈德利中心气象局、埃克塞特大学以及美国艾伦人工智能研究所(Ai2)共同组成的研究团队,对此前开发的机器学习天气模型 ACE2 进行了评估,并将其与主流基于物理的海气耦合集合预报系统 GloSea 进行对比。研究首次证明,机器学习天气模型能够生成具备高技巧的全球季节预测,为深化理解短期气候变异机制、发展新一代预报技术并推动业务预报进步,提供了新的可能方向。

查看完整报道:https://go.hyper.ai/n4eIp

2. 在线教程丨41个案例中的生成成功率达100%,RFdiffusion2 基于化学反应实现原子级别蛋白质生成

华盛顿大学蛋白质设计研究所发布了全新生成模型 Rosetta Fold diffusion 2(RFdiffusion2),实现了根据简单的化学反应描述,生成具有定制活性位点的蛋白质骨架的优化路径,突破了长期以来在催化剂设计上的技术瓶颈,为包括塑料降解在内的多种应用提供了强有力的技术支撑。

查看完整报道:https://go.hyper.ai/gtlE4

3. Qwen3-Max参数规模超万亿,多项基准测试达SOTA,预告推理增强版本达奥数竞赛满分水平

2025 阿里云栖大会开幕式上,Qwen3-Max 正式亮相,这个号称是其迄今为止规模最大、能力最强的模型,以 1T 的模型总参数横扫多项评测基准。除此之外,此次会议还介绍了 Qwen3-VL、Qwen3-Coder 等模型。

查看完整报道:https://go.hyper.ai/odH8O

4. 香港科技大学提出融合神经网络框架,高效预测蛋白质序列的多金属结合位点

香港科技大学的研究团队提出了一个融合神经网络框架,用于预测蛋白质序列中的多金属结合位点。该框架采用由 CNN 与融合网络组成的两阶段架构,能够实现快速、稳健、高质量的整体预测,加速了金属-蛋白质相互作用的更多可能性挖掘。

查看完整报道:https://go.hyper.ai/ChgtK

5. 英伟达提出ReaSyn,借鉴思维链类比分子合成,实现超高重建率与路径多样性

英伟达研究团队推出融合推理能力的高效可合成分子投影框架 ReaSyn,采用反应链表示法,将合成路径视为 LLM 的 CoT 推理路径,为破解分子合成的现实难题开辟了新路径。它借鉴大型语言模型中的 「思维链推理」 思想,从技术底层为解决可合成分子设计的核心痛点提供了新思路。

查看完整报道:https://go.hyper.ai/B4zY8

热门百科词条精选

1. DALL-E

2. 倒数排序融合 RRF

3. 世界模型 World Models

4. 故障词元 Glitch Token

5. 量子神经网络 Quantum Neural Network

这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:

https://go.hyper.ai/wiki

以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!

下周再见!

LLM工程落地五大关键技术:StreamingLLM、LongLoRA与多模态MoE实战解析 大语言模型(LLM)的推理优化、长上下文建模与多模态融合,是当前AI工程化的核心挑战。其底层原理涉及KV缓存动态管理、低秩适配器的位置感知重构、以及跨模态特征空间的路由对齐等关键技术。这些方法不仅显著降低显存带宽压力与推理延迟,更在客服对话、长文档摘要、图文生成等真实场景中实现可量化的性能跃迁。尤其StreamingLLM通过注意力窗口滑动重构实时响应范式,LongLoRA以极小参数开销突破128K上下文瓶颈,二者已成为工业级LLM部署的关键支点。本文聚焦从论文公式到GPU实操的完整链路,覆盖环境适配、数据 阅读详情

相关推荐

2026年多模态出海落地实战:端侧融合加速与国产大模型本地化

多模态AI是指能同步理解图像、语音、文本等多种信息形式的智能系统,其核心原理在于跨模态特征对齐与联合表征学习。随着端侧算力提升和轻量化架构成熟,多模态技术正从实验室走向真实产业场景,显著提升复杂任务的鲁棒性与隐私合规性。当前技术价值已突破‘能做’阶段,进入‘可规模化商用’临界点——尤其在低资源语言支持、离线推理稳定性、跨模态容错能力三方面实现关键收敛。典型应用场景覆盖农业病害识别、跨境教育反馈、中东珠宝定制等需深度文化适配的出海业务。本文聚焦2026年Q2已验证的落地路径,结合Qwen-VL-2.5等国产多

stevenbill的博客 430

MiniMax M2.7开源解析:工业级多模态推理框架落地实践

多模态大模型在实际业务中常面临延迟高、显存溢出、部署难等工程瓶颈。其核心原理在于视觉编码、跨模态对齐与长上下文管理的协同优化,技术价值体现在可审计、可嵌入、可定制的生产就绪能力。典型应用场景包括金融支付核验、医疗影像初筛与工业质检等毫秒级响应需求场景。MiniMax M2.7并非全量开源模型权重,而是聚焦‘框架+模型卡+轻量视觉编码器’三位一体交付,尤其强化了跨模态对齐延迟控制与长上下文缓存命中率优化,为边缘设备与企业级AI系统提供真正可落地的多模态推理底座。

weixin_34364071的博客 324

RLVR多模态文档解析:让AI真正理解表格、公式与批注

文档理解已从基础OCR字符识别,演进为融合视觉、文本、布局与逻辑关系的多模态语义解析任务。其核心原理在于打破像素到文本的单向映射,通过视觉-语言对齐建模结构化意图与跨元素语义关联。技术价值体现在确定性输出、可追溯推理与工业级鲁棒性,显著降低合同、医疗报告、科研文献等非结构化文档的业务干预成本。典型应用场景包括智能审阅系统、自动化报表抽取、历史档案语义化重建等。本文聚焦RLVR(强化学习引导的视觉-语言对齐)机制与olmOCR 2开源多模态文档解析模型,详解其如何实现对表格结构、数学公式及手写批注的协同理解与

hck341204的专栏 395

qwen3-vl中的架构层面三个创新点:MRoPE-interleave/deepstack/文本时间戳对齐

Qwen3-VL是阿里推出的多模态大模型,通过三大创新优化视觉-文本融合:1)MRoPE-Interleave采用交替编码解决频率分布问题;2)DeepStack机制分阶段多层插入视觉token,避免信息丢失;3)T-RoPE实现帧级时间对齐。这些技术使视觉信息能持续参与深度推理,显著提升多模态理解能力,同时保持参数高效性。相关原理详见《DeepStack》论文及官方技术文档。

samoyan的博客,记录技术成长~ 1152

Gemma 4端侧AI实战指南:Apache 2.0多模态模型落地全解析

端侧AI正从概念走向主流应用,其核心在于将大模型能力安全、高效、合规地部署于手机、IoT等边缘设备。这背后涉及模型轻量化原理、离线多模态处理机制、以及决定商用可行性的许可证约束。Apache 2.0许可证赋予开发者修改、嵌入、商用的完整权利,彻底规避法务风险;而真正支撑端侧运行的,是面向硬件优化的动态参数激活与跨模态残差连接架构。在医疗问诊、无网巡检、跨境SaaS等强隐私、弱网络、多语言场景中,这类具备离线多模态能力的开源模型,已成为替代云端API的关键基础设施。Gemma 4正是这一演进路径上的代表性实践

454

GPT-4稀疏激活原理与MoE工程落地实战

大模型稀疏激活(Sparse Activation)是一种通过条件路由动态调用部分参数的高效推理范式,其核心在于门控网络(Gating Network)实时决策专家选择,实现计算资源的精准分配。相比传统稠密模型,该技术显著降低显存占用、能耗与首字延迟,同时保持输出质量。关键技术指标包括稀疏度(Sparsity Ratio)、专家粒度(Expert Granularity)和门控开销(Gating Overhead),直接影响生产环境吞吐与稳定性。当前主流落地路径涵盖Qwen2-MoE等开源稀疏模型微调,以及

weixin_30487201的博客 532

文心5.0:2.4万亿参数原生全模态大模型技术解析

全模态大模型正从多头拼接走向原生统一,其核心是跨模态表征对齐与稀疏动态路由机制。传统多模态方案因模态语义鸿沟和计算冗余,难以支撑工业级稳定推理;而以文心5.0为代表的新型架构,通过统一tokenization协议(如UniToken)、分层稀疏专家(HSE)与模态感知门控(MAG),实现了文本、图像、音频、视频等多源异构信号在共享Transformer主干中的联合建模。该技术显著提升零样本跨模态检索精度与长尾鲁棒性,已在工业质检、城市大脑、医疗影像等高一致性要求场景落地验证。本文深入剖析其参数构成、训练范式

culiao2169的博客 675

BloombergGPT:首个原生金融大模型的架构与实战

金融大模型不是通用大模型加金融语料的简单微调,而是面向金融语义空间重构的语言理解系统。其核心在于构建高保真、多粒度、强时效的金融数据宇宙,并通过Encoder-Decoder混合架构、金融事件掩码建模(FEMM)和结构化提示工程(FPE)实现专业级推理。相比传统微调方案,它在数值推理、合同条款理解和实时市场分析等任务中显著提升准确率与可追溯性,真正支撑量化研究、合规审查与交易决策等高价值场景,代表了金融AI从‘问答工具’迈向‘认知延伸界面’的关键范式跃迁。

weixin_33933118的博客 549

2025年AI应用开发实战指南:模型选型、推理成本与边缘部署

AI应用开发已从‘大模型崇拜’进入工程化落地深水区。理解模型的底层原理——如多模态对齐机制、RAG作为决策神经系统、硬件感知型压缩技术——是规避幻觉、延迟与成本失控的前提。技术价值体现在可测量的SLO保障:低至毫秒级边缘响应、800ms内图文联合推理、金融场景92%以上的条款引用准确率。典型应用场景覆盖智能客服方言摘要、工业质检实时诊断、法律合同条款锚定审查等真实业务闭环。本文聚焦2025年开发者最常面对的六大主力模型,结合实测吞吐量、中文长文本错字率与推理成本,提供可直接复用的选型框架与避坑清单。

cunbei2644的博客 455

MoE混合专家模型:Transformer的稀疏化演进与工程落地

混合专家模型(MoE)是应对大语言模型计算瓶颈的关键范式,其核心在于将传统Transformer中固定、稠密的前馈网络(FFN)重构为按需激活的多个专业化子网络。原理上,通过轻量门控网络实现token级动态路由,在保持模型容量的同时显著降低实际计算量与显存开销。技术价值体现在推理效率跃升、长尾任务泛化增强及部署成本可控——如7B MoE模型在相同硬件下吞吐量提升2.3倍、准确率反增4.7%。典型应用场景涵盖高并发搜索、金融研报生成与多模态客服等对低延迟与领域精度双重要求的生产环境。本文聚焦MoE与Trans

weixin_30596343的博客 313

LLM如何重塑电信网络运维:从告警处理到自治网络

大语言模型(LLM)正突破传统AI在电信领域的应用边界,成为解决非结构化数据理解、跨模态意图识别与经验知识复用等核心难题的关键技术。其本质是将自然语言处理能力与通信协议、设备语义、工单知识深度融合,实现从‘数值阈值判断’到‘语义级根因推理’的范式升级。凭借轻量化部署、RAG增强、领域微调与安全执行层协同,LLM已在故障诊断、节能调度、服务编排等场景落地验证,显著提升MTTR、节电率与KPI稳定性。本文聚焦LLM在电信运维中的工程化路径,涵盖知识注入、实时推理优化、边缘适配及现网验证方法论,为无线优化工程师、

weixin_30316097的博客 380

AI从业者每日信号扫描:事件驱动的技术雷达方法论

大模型技术演进已从线性迭代转向事件触发式跃迁——一次API参数更新、一个开源健康度仪表盘、一套边缘量化包,都可能重构工程实现路径。其底层原理在于技术动作与真实系统间的强耦合性:可验证的发布行为、可操作的代码级变更、可关联的主流栈映射,共同构成AI工程落地的‘三可’标尺。这种事件驱动范式显著提升RAG优化、Agent开发、模型部署等场景的响应精度与决策效率,尤其适用于正面临技术选型、架构升级或合规落地的一线工程师与技术负责人。

weixin_34080951的博客 427

长文档多模态智能基准:突破跨页推理与模态对齐瓶颈

长文档理解是企业级AI落地的核心挑战,其本质远超单页OCR精度,而在于跨页面、跨模态、跨语义层的连续认知流稳定性。多模态文档智能需同时处理文本、表格、公式、手写批注与嵌入图像,并在空间、逻辑、时序和符号四重张力下保持语义一致性。关键技术价值体现在长程一致性维持、模态间语义对齐鲁棒性及像素级可执行输出能力,广泛应用于法律合同审查、医疗报告结构化、科研文献综述等真实场景。本文聚焦新发布的长文档多模态基准,深入解析其对跨页指代消解、图文联合因果推理等硬性能力的压力测试设计,揭示当前SOTA模型在长距依赖与符号张力

weixin_34166472的博客 397

星火X2国产大模型全栈解析:MoE架构与全国产算力适配实践

大模型推理与训练正从依赖CUDA生态走向全国产算力底座,其核心挑战在于如何在昇腾、寒武纪等芯片上实现高效稀疏计算与训推一致。MoE(专家混合)架构通过动态路由与专家专业化分工,显著降低实际计算量,而VTP虚拟张量并行、INT8 KVCache、重采样校准等技术则解决了显存墙、通信瓶颈与分布偏移等关键工程难题。这类优化不仅提升推理吞吐与能效比,更支撑教育错因定位、医疗临床路径遵循、车载模糊意图理解等强落地场景。本文聚焦星火X2在293B MoE与全国产算力协同下的真实技术路径,为AI基础设施国产化提供可复用的

weixin_30905133的博客 518

OctoMag: An Electromagnetic System for 5-DOF Wireless Micromanipulation

电磁线圈组驱动经典系统,可以作为参考。 OctoMag: 用于5自由度无线微操作的一个电磁铁系统 OctoMag: An Electromagnetic System for 5-DOF Wireless Micromanipulation [1] Paper Link Authors: J. J. Abbott, etc. 2010, TRO IEEE Transactions on Robot...

XU Yangxin的博客 1665

从零开始掌握Simscape Multibody:机械系统建模与仿真入门

本文为机械系统建模与仿真入门指南,详细介绍了如何从零开始使用Simscape Multibody。通过构建曲柄摇块机构的实战案例,系统讲解了刚体、关节、约束等核心模块的使用,以及模型验证、参数化设计和多领域系统集成等进阶技巧,帮助工程师和学生高效进行虚拟设计与测试。

weixin_29229261的博客 310

GLM-5.1技术解析:动态稀疏注意力与分层知识注入实战

大语言模型(LLM)的推理能力提升,核心在于长上下文建模、知识融合与指令遵循三大基础能力。动态稀疏注意力(DSAW)通过语义聚类优化计算复杂度,显著缓解显存瓶颈;分层知识注入(HKI)将结构化知识、领域关系与实时图谱按需门控融合,增强事实准确性与专业深度。二者协同,不仅支撑MMLU、GPQA等综合基准突破,更在教育诊断、医疗辅助、工业质检等真实场景中实现可验证、可审计的推理输出。本文基于GLM-5.1开源实践,系统拆解DSAW与HKI的技术原理、部署调优及跨硬件适配方案,为算法工程师与应用开发者提供可复用的

weixin_30386713的博客 394

STM32H743玩转以太网:不用FreeRTOS,手把手搞定LAN8742和DHCP(附MPU配置避坑指南)

本文详细介绍了在STM32H743裸机环境下实现以太网通信的完整方案,重点讲解了LAN8742 PHY芯片的配置和DHCP自动获取IP的实现。通过CubeMX配置、内存布局优化和MPU设置,避开了H7系列常见的Cache陷阱,提供了无操作系统环境下的高效网络通信解决方案。

weixin_42709044的博客 201

多模态大模型设计范式解剖:动态路由、空间采样与LLM原生视觉理解

多模态大模型的核心挑战在于视觉与语言模态间的语义对齐与空间感知。传统ViT+LLM拼接架构因缺乏显式空间建模,易导致位置混淆、细粒度误判等模态割裂问题。Qwen3.5-Omni通过动态token路由实现上下文感知的条件视觉注入;LongCat-Next以可微分空间采样器替代ViT,让模型主动决定‘看哪里’;GLM-5V-Turbo则推动LLM原生视觉理解,将视觉编码器降级为语义锚点生成器。三者分别代表了多模态融合从‘拼起来能用’到‘长在一起才稳’的范式跃迁,在医疗影像描述、POI识别、视觉指令微调等场景中展

weixin_30918633的博客 394

在运行opencv时出现的两个问题:AttributeError: module ‘cv2‘ has no attribute ‘gapi_wip_gst_GStreamerPipeline‘

解决了opencv的两个问题:由问题一引出 AttributeError: module 'cv2' has no attribute 'gapi_wip_gst_GStreamerPipeline' cv2.error:OpenCV(4.1.2)C:\projects\opencvpython\opencv\modules\highgui\src\window.cpp:717:error: (-2:Unspecified error) The function is not implemented...

hu_yinghui的博客 3275

【多元统计分析】均值向量和协方差阵的检验——spss上机实验

均值向量和协方差阵的检验——spss上机实验 #参考书目为《多元统计分析》(第五版)——何晓群.中国人民大学出版社 #如有错误,请指正!谢谢~ #关注公众号搜索同名文章获取数据~ 习题2.3 现选取内蒙古、广西、贵州、云南、西藏、宁夏、新疆、甘肃和青海等9个内陆边远省区。选取人均GDP、第三产业比重、人均消费支出、人口自然增长率及文盲半文盲人口占15岁以上人口的比例等5项能较好的说明各地区社会经济发展水平的指标,验证边远及少数民族聚居区的社会经济发展水平与全国平均水平间有无显著差异。 将输入导入spss

suansuannainaizi的博客 3万+

Redis安装与配置:从基础部署到生产环境优化

Redis作为高性能的内存数据库,其核心原理基于内存存储和键值数据结构,通过单线程模型实现高吞吐量。在技术实现上,Redis支持多种持久化方案(RDB快照和AOF日志)确保数据可靠性,并通过主从复制实现高可用。对于工程实践,Redis的安装部署通常采用源码编译或包管理器两种方式,其中源码编译更适合生产环境,便于性能调优和版本控制。在安全方面,需配置密码认证、网络隔离和定期备份策略。典型应用场景包括缓存加速、会话管理和实时排行榜等。通过合理的maxmemory设置和LRU淘汰策略,可以有效管理内存资源,而监控

weixin_33904756的博客 395

百度地图街景图像批量获取

由于个人研究需要在最近试了一下使用API获取百度地图街景图片,在此介绍一下基于我个人需求的百度街景批量获取方法,本文以Python编码作为主要方法,如果对零编码工具有需要的可以关注一下UA城市分析小组刚刚发布的街景图片获取工具。 街景图像用作区域细粒度空间指标测度需要解决几个问题。 1. 首先就是调用额度的限制,现在百度对于个人认证开发者每天可用的街景图像调用额度为100张,在不考虑购买额度上限(1万张600元,其实有经费的前提下可以直接考虑钞能力)的情况下动辄几千上万张的爬取数量会大大增加需要爬取的时间周

boycetoon29的博客 1万+

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2962

AUTOSAR从入门到精通-汽车电子电气架构(EEA)

EEA(Electrical/Electronic Architecture),电子电气架构,是首先由德尔福公司提出的,集合汽车的电子电气系统原理设计、中央电器盒的设计、连接器的设计、电子电气分配系统等设计为一体的整车电子电气解决方案的概念。通过EEA的设计,可将动力总成、驱动信息、娱乐信息等车身信息转化为实际的电源分配的物理布局、信号网络、数据网络、诊断、容错、能量管理等的电子电气解决方案。

getusushu的博客 858

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

上一篇: 在线教程丨百倍提速,中科院团队发布首个国产类脑脉冲大模型SpikingBrain-1.0,推理效率数量级提升
下一篇: 马斯克/Sam Altman/比尔·盖茨强推!10本AI领域必读书,从基础科普到风险分析
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值