重新定义下一代 OCR:IBM 最新开源 Granite-docling-258M,实现端到端的「结构+内容」统一理解

IBM开源轻量多模态文档处理模型:Granite-Docling 258M,能执行OCR、文档QA Granite-Docling 258M 不仅是工具,更是“文档即数据”时代的基础设施。是一个专为“文档智能”而生的多模态轻骑兵。 阅读详情

IBM 开源多模态文档处理模型 Granite-Docling-258M,能将文档转换为机器可读格式,同时完整保留布局、表格、公式等元素,实现端到端的全文文档转换。

一直以来,将格式各异的数字文档准确转换为机器可读的结构化数据是一个技术核心挑战。文档布局的复杂多样性、以及其中包含的表格、图片等视觉元素,往往导致传统 OCR 系统的识别准确性难以满足实际需求。现有技术通常依赖于复杂的集成系统,将任务拆解为多个独立子模块,虽在一定程度上有效,但存在优化困难、难以泛化处理各类文档的局限性。

近期,IBM 开源轻量级多模态文档处理模型 Granite-Docling-258M,专为高效文档转换设计,能将文档转换为机器可读格式,同时完整保留布局、表格、公式等元素,实现端到端的全文文档转换。该模型使用 DocTags 格式精准描述文档结构,能与 Docling 库无缝集成,精准捕捉页面中所有元素的内容、结构和空间位置,提供强大的定制化和错误处理能力,适用企业级文档处理,是文档处理领域的强大工具。

此外该模型仅含 258M 参数,在图表识别、全页 OCR、代码识别等方面的性能评估中,均超过了前代的同级参数模型 SmolDocling-256M-Preview。在保持模型参数紧凑的同时,还支持多语言(包括阿拉伯语、中文和日语)处理,为 OCR 提供了最新轻量化、高性能的优化方案。

「Granite-docling-258M:轻量多模态文档处理模型」现已上线 HyperAI超神经官网(hyper.ai)的「教程」板块,快来一键部署体验!

教程链接:

https://go.hyper.ai/GLOwc

Demo 运行

1. 进入 hyper.ai 首页后,选择「教程」页面,并选择「Granite-docling-258M:轻量多模态文档处理模型」,点击「在线运行此教程」。

2.页面跳转后,点击右上角「克隆」,将该教程克隆至自己的容器中。

3. 选择「NVIDIA GeForce RTX 4090」以及「PyTorch」镜像,并点击「继续执行」。OpenBayes 平台提供了 4 种计费方式,大家可以按照需求选择「按量付费」或「包日/周/月」。新用户使用下方邀请链接注册,可获得 4 小时 RTX 4090 + 5 小时 CPU 的免费时长!

HyperAI超神经专属邀请链接(直接复制到浏览器打开):

https://openbayes.com/console/signup?r=Ada0322_NR0n
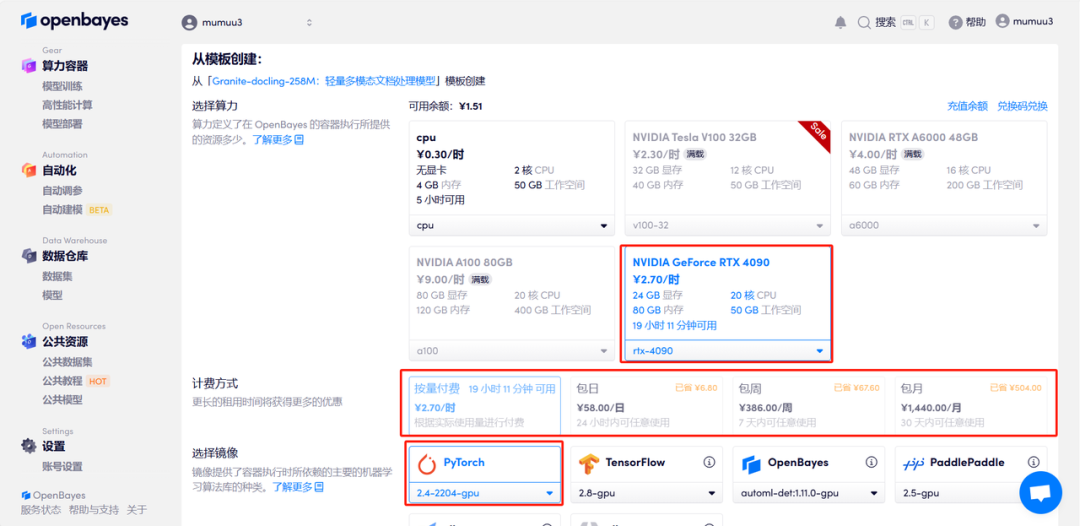
4.等待分配资源,首次克隆需等待 3 分钟左右的时间。当状态变为「运行中」后,点击「API 地址」旁边的跳转箭头,即可跳转至 Demo 页面。请注意,用户需在实名认证后才能使用 API 地址访问功能。

效果演示

进入 Demo 运行页面后,选择「Upload Image」上传图片,在「Ask new question」提问框中输入问题即可运行。

以上就是 HyperAI超神经本期推荐的教程,欢迎大家前来体验!

教程链接:

https://go.hyper.ai/GLOwc

解决fetch_california_housing数据集403错误的3种实用方法(附手动下载地址) 本文针对机器学习中常见的fetch_california_housing数据集403 Forbidden错误,提供了三种实用的解决方案。从理解HTTP 403错误的根源出发,详细介绍了修改源码路径、使用国内镜像源以及手动下载并配置数据文件这三种方法,并附带了可靠的手动下载地址,帮助开发者彻底解决数据加载障碍,确保机器学习项目顺利进行。 阅读详情

相关推荐

UFS Write Booster技术解析:原理、配置与故障排查实战

在存储技术领域,缓存机制是提升I/O性能的核心手段之一,其原理是通过高速存储介质暂存数据,减少对低速主存储的直接访问,从而降低延迟、提升吞吐。Write Booster正是这一原理在UFS(通用闪存存储)规范中的具体实现,它通过引入独立的易失性高速缓存区(Write Booster Buffer),将主机写入命令快速响应与后台数据持久化分离,技术价值在于显著改善随机写入性能,消除由垃圾回收等后台操作引发的写入卡顿。该技术广泛应用于智能手机应用安装、相机连拍、固件升级(OTA)等对写入流畅性要求高的场景。本文

weixin_42561143的博客 356

教程上新|重新定义下一代 OCR:IBM 最新开源 Granite-docling-258M,实现端到端的「结构+内容」统一理解

3. 选择「NVIDIA GeForce RTX 5090」以及「PyTorch」镜像,按照需求选择「按量付费」或「包日/周/月」,点击「继续执行」。近期,IBM 开源轻量级多模态文档处理模型 Granite-Docling-258M,专为高效文档转换设计,能将文档转换为机器可读格式,同时完整保留布局、表格、公式等元素,实现端到端的全文文档转换。1. 登录 OpenBayes.com,在「公共教程」页面,选择「Granite-docling-258M:轻量多模态文档处理模型」教程。

OpenBayes的博客 522

香橙派5玩转SATA SSD:一个被忽略的overlays配置项,让你的Ubuntu系统飞起来

本文详细介绍了如何在香橙派5上通过配置`overlays=ssd-sata`启用SATA SSD作为系统启动盘,大幅提升Ubuntu系统的性能。文章深入解析了设备树覆盖的工作原理,提供了完整的配置流程和性能优化建议,帮助开发者充分发挥香橙派5的硬件潜力。

weixin_30787531的博客 220

258M参数重构文档智能:IBM开源Granite-Docling轻量化模型

IBM于2025年9月推出Granite-Docling-258M,一款仅2.58亿参数的轻量级多模态模型,以"小而精"的设计重新定义文档转换效率,代码识别F1分数达98.8%,表格结构还原度提升18%,成为企业级文档处理的新标杆。 ## 行业现状:非结构化文档的效率黑洞 在数字化转型深水区,企业仍面临文档处理的三大痛点:复杂公式识别错误率超20%、表格结构还原精度不足70%、多模态内容(代...

gitblog_01138的博客 992

小白学电路之cadance搭建buffer电路

Buffer(缓冲器)是一种放大器或驱动电路,主要用于隔离输入和输出,以防止负载对前级电路造成干扰或影响。本文作者在电路方面是小白水平,目前正在学习,有不足之处欢迎指正。3.创建新的cellview,对此buffer进行仿真验证。2.创建buffer的symbol。电路中的V2的详细参数。

weixin_58051657的博客 1988

数字后端零基础入门系列 | Innovus零基础LAB学习Day7

数字后端零基础入门系列 | Innovus零基础LAB学习Day7

weixin_37584728的博客 2273

258M参数颠覆文档处理!IBM开源Granite-Docling重新定义轻量化OCR

当企业还在为PDF中的公式乱码、表格错位、代码提取错误头疼时,IBM推出的Granite-Docling-258M已用2.58亿参数实现"文档全要素结构化",代码识别F1分数达98.8%,公式还原编辑距离低至0.073,重新定义轻量级文档AI的技术边界。 ## 行业现状:非结构化文档的效率黑洞 在企业数字化转型的深水区,一个被长期忽视的效率黑洞正在浮出水面:非结构化文档。无论是扫描版PDF、学术...

gitblog_00791的博客 1085

VTK基础教程(1)- vtkPolyData 介绍

目录 VTK的编译与环境搭建 VTK一般渲染流程 VTK数据类型-vtkPolyData 使用vtk自带的多边形数据 使用自己创建的数据 添加顶点颜色 添加面颜色 VTK的编译与环境搭建 这部分目前已经有了大佬做了成熟的傻瓜式配置,大家可以参考这篇文章:VTK+VS2019(或其他版本均可) 傻瓜式一站式 配置_Nancy_fairy的博客-优快云博客_vs2019 vtk VTK一般渲染流程 这部分的介绍也很多,大家可以参考这篇文章:VTK笔记-了解VTK_黑山老妖的博客.

qq_35769071的博客 9054

IBM开源轻量多模态模型Granite Docling 258M:2.58亿参数重构文档智能处理

**导语**:当企业还在为PDF中的公式乱码、表格错位、代码提取错误头疼时,IBM推出的Granite Docling 258M已用2.58亿参数实现"文档全要素结构化",代码识别F1分数达98.8%,公式还原编辑距离低至0.073,重新定义轻量级文档AI的技术边界。 ## 行业现状:非结构化文档的效率黑洞 在企业数字化转型的深水区,一个被长期忽视的效率黑洞正在浮出水面:非结构化文档。无论是扫...

gitblog_00239的博客 1047

C++/WinRT入门指南:现代Windows原生开发的核心技术

Windows运行时(WinRT)是微软为现代Windows应用开发设计的一套跨语言API框架,它基于COM技术原理构建,提供了统一的二进制接口标准。这项技术的核心价值在于让开发者能够以原生性能调用系统级功能,同时保持跨语言兼容性。在工程实践中,C++/WinRT作为官方推荐的C++语言投影,通过标准C++语法封装WinRT API,显著降低了开发复杂度。特别是在异步编程场景中,结合C++20协程特性,能够大幅提升代码可读性和维护性。对于需要高性能图形处理、系统集成或跨平台兼容的桌面应用开发,掌握C++/W

weixin_33910191的博客 1198

手把手教你用UNI-MOL进行分子性质预测:从3D构象到实战结果

本文提供了使用UNI-MOL进行分子性质预测的完整实战指南。通过详细的环境搭建、3D构象生成、模型加载与微调步骤,手把手教你构建端到端的预测流水线。文章重点解析了如何利用UNI-MOL的3D分子表示学习能力,超越传统2D方法,实现对溶解度、活性等性质的更精准预测,并探讨了结果解读与模型分析方法。

weixin_29164091的博客 116

IBM Granite-Docling:258M参数全能文档解析AI模型

IBM推出Granite-Docling 258M多模态文档解析模型,以轻量级架构实现高效文档转换,支持代码、公式、图表等复杂元素识别,推动企业级文档处理智能化升级。 ## 行业现状 随着数字化转型深入,企业面临海量多格式文档处理需求,传统OCR技术在复杂布局、数学公式、代码片段等场景下准确率不足。据Gartner预测,到2026年,70%的企业将依赖AI驱动的文档理解技术提升数据提取效率。当前

gitblog_00071的博客 781

大模型——AI对话四象限

{ "摘要": "文章揭示了90%的人不会有效与AI沟通的问题,指出简单粗暴的提问只能得到标准答案。作者提出'AI对话四象限'模型:1)双方都懂时提效;2)AI懂但需学会分层提问;3)共同探索未知领域;4)向AI传授独家知识。强调沟通技巧的重要性,认为会提问的人不会被AI替代。最后呼吁读者尝试四象限思维,与AI碰撞火花。" }

312

【AI大模型前沿】IBM Granite-Docling-258M:开源企业级文档 AI 模型的创新与应用

Granite-Docling-258M 是一个具有 2.58 亿参数的多模态模型,能够接收图像和文本输入,并输出结构化的文本结果。它不仅能够提取文档中的文字,还能理解文档的整体结构,包括表格、代码、数学公式、列表、题注等元素,并输出一种名为 **DocTags** 的中间表示格式。这种格式可以轻松转换为 Markdown、HTML 或 JSON,从而为下游任务(如检索增强生成 RAG 或数据分析)提供高质量的结构化输入。

寻道AI,探索AI无限可能! 1276

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

2025文档智能处理新范式:IBM Granite Docling 258M轻量化模型的行业突破

IBM最新发布的Granite Docling 258M多模态文档处理模型,以258M参数实现了复杂文档元素的高精度识别与结构化转换,重新定义了轻量化模型在企业级文档处理中的应用标准。 ## 行业现状:千亿市场与效率瓶颈的矛盾 全球智能文档处理市场正以24.7%的年复合增长率高速扩张,预计2034年将达到210亿美元规模。然而企业在实际应用中仍面临三大核心痛点:传统OCR工具对复杂元素(公式、

gitblog_00818的博客 997

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

IBM 推出 Granite-Docling-258M:超轻量级视觉语言模型重塑文档智能处理

今日,IBM 正式发布开源视觉语言模型(VLM) Granite-Docling-258M,这款仅含 2.58 亿参数的超紧凑模型实现了文档到机器可读格式的端到端转换,能精准保留原始文档的布局结构、表格逻辑、数学公式及列表层级。该模型已通过 Apache 2.0 许可协议在 Hugging Face 平台开放下载,标志着企业级文档理解技术向轻量化、高效率方向迈出关键一步。 ## 微型模型的颠覆性...

gitblog_00919的博客 1136

Granite-Docling:258M轻量AI文档解析终极指南

IBM Research推出Granite-Docling-258M轻量级多模态模型,以258M参数量实现高效文档全要素解析,重新定义轻量化AI文档处理标准。 ## 行业现状 随着数字化转型加速,企业和个人面临海量文档处理需求,涵盖学术论文、商业报告、技术文档等多种类型。传统OCR工具仅能处理简单文本,而复杂文档中的公式、表格、代码和图表往往需要专业工具单独处理。市场调研显示,超过68%的企业仍

gitblog_00278的博客 193

五分钟跑通Docling:文档解析与格式转换实战指南

做RAG项目时,最耗时的环节往往不是选模型,而是把文档喂进管线:PDF分带文本层和纯扫描两种,Word里嵌着图片和嵌套表格,财务数据散在三十个Excel sheet里,会议纪要还停留在MP3。每种格式一个工具处理,输出结构各不相同,下游切块、嵌入要为每种格式单独写适配层。Docling(一个文档解析与格式转换工具包)解决的就是这一步:把各种格式解析为统一的中间表示,再按需导出为Markdown、J

gitblog_00409的博客 431

67K star 却只在日榜待了两小时:Docling 的热度含金量,到底有几分?

如果你常逛 GitHub 热榜,最近可能会看到一个有点“反常识”的现象。 一个叫 **Docling** 的开源项目,Star 数已经冲到 **6.7 万**这个量级,按理说属于“顶流”梯队了。可它登上趋势日榜之后,只待了两个小时就滑了下去。 于是评论区立刻分成两派:一派说“这不就是个刷星的空壳项目”,另一派说“你根本不知道它在企业里有多能打”。 那今天咱们就把这事掰开揉碎聊一聊:**Doc

gitblog_00843的博客 53

复杂文档、图表解析大总结

模型首先对降采样后的图像进行全局版面分析,然后对原生分辨率的裁剪区域进行文本、公式、表格的细粒度识别。该基准涵盖学术论文、财务报告、报纸、教科书等 9 种文档类型,包含 15 个块级元素(文本段落、标题、表格等)和 4 个跨度级元素(文本行、行内公式等)的注释信息,以及页面和块级别的各种属性标签。支持识别文本、图像、表格、公式、手写体、表单字段、页眉页脚等各种元素,并支持印章、二维码、条形码等子类型,为LLM推理、训练输入高质量数据,帮助完成数据清洗和文档问答任务,无需在模型之间切换,也不会出现特征错位。

年轻即出发, 1194

图片 OCR 转 Word API:输入二选一、DOCX 和私有文件下载

图片 OCR 转 Word API 通过 POST 识别图片文字并生成可编辑 DOCX。输入为 HTTPS 图片 URL 或 Base64,二选一。公开模式返回下载链接,私有模式返回文件标识。

DevOpenClub 专栏 247

使用ocr来实现自动化脚本

自动化脚本的稳定性,很大程度上取决于“找到目标元素”这件事是否可靠。无障碍控件查找在标准 Android 应用上工作得很好,但一旦进入游戏、自绘渲染界面、Flutter 或某些加固过的应用,getUiTree返回空树或残缺节点是常有的事。控件的text和id属性不存在,findView就无从谈起。这时继续在控件查找的框架里打补丁,收益很低;更务实的做法是把定位层整体切换到 OCR,用屏幕上的文字本身作为锚点。冰狐的 OCR 接口不是单一函数,而是一组按用途分层的工具。底层是ocr()和tessOcr()

ai_coder_ai的博客 408

影刀OCR功能有什么替代方案?实测三条路线,内网离线也能跑稳

试到第三款时我停下来试了蓝印RPA:它自带AI识图与OCR功能,接入了文心一言、豆包、DeepSeek、Kimi这些大模型,图片丢进去出文字,识别结果直接进变量,接着往下填表、对账、写回Excel,一整条链路不用出流程。元素获取上,它支持本地智能生成元素路径,还能AI智能优化元素路径:我用大白话描述"发票号码那个格子",直接给出稳定的xpath,不用啃语法。碰上财务系统网页改版导致元素失灵,Web元素AI自愈能自动修复元素定位,自愈更稳定,少了我半夜起来改流程的次数,降低脚本维护成本这件事是实打实的。

HAHAXX8的博客 169

汽车金融 OCR 系统架构设计:从多证件识别到关联校验的技术方案

楚识科技的汽车金融 OCR 方案,有几个特点:一是证件类型覆盖全 —— 汽车金融涉及的十几种证件全部支持;二是汽车专项证件准确率高 —— 行驶证、登记证书、车辆合格证的识别准确率比通用 OCR 高很多;三是内置多证件关联校验引擎 —— 识别完自动比对,有问题自动标记;四是和主流风控系统无缝对接 —— 开箱即用,不用二次开发。

qq_34572574的博客 280

报结构化提取工程落地:别把复杂报表识别等同于通用 OCR

从工程架构上看,成熟的财报识别系统,是一套多阶段流水线,而不是端到端单模型。以东北证券这份合并资产负债表为例,报表采用左右分栏布局,左侧资产、右侧负债及股东权益,大量 “其中:客户备付金” 这类二级缩进子科目,还有证券行业独有的结算备付金、代理买卖证券款等科目,加上红色公章遮挡、跨页拆分、无线表格等干扰项。但对于开发者来说,要清醒认知:财报识别不是一个开箱即用的 OCR 能力,它是视觉、NLP、财务规则三者结合的垂直工程,版式还原、科目对齐、勾稽校验,每一环都决定方案能不能在金融生产环境稳定跑起来。

OCR_13371621275的博客 186

使用PaddleOCR和OpenCV5实现OCR

本文介绍在OpenCV 5环境下绕过依赖限制,直接使用OpenCVSharp与OnnxRuntime调用PaddleOCRv5模型实现文字检测与识别的方法。通过加载det.onnx(检测)和rec.onnx(识别)模型,结合ppocrv5_dict.txt字典,实现了对证件类图像的高精度文字识别,识别结果包含文本内容及置信度,效果良好,适用于多场景OCR应用。

lweiyue的专栏 193
上一篇: 【Triton 教程】triton_language.ravel
下一篇: 英伟达提出ReaSyn,借鉴思维链类比分子合成,实现超高重建率与路径多样性
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值