一键下载Meta最大视频分割数据集!含50.9K真实世界视频,覆盖47个国家

SAM-2全面来袭,能够分割任意图像和视频,代码开源! 阅读详情
AI摘要

Meta发布SAM2模型,实现实时视频对象精准分割。配套SA-V数据集含50.9K视频及642.6K个masklets,覆盖多场景,推动计算机视觉发展。

31836dcf6662ea91d9ff1cb869c12ddf.png

作者:十九

编辑:李宝珠

Meta 近日开源了 SAM 2 模型,只需要在视频帧上输入提示(点击、框或掩码),就能精准识别并分割图像或视频中的任何对象,用于训练 SAM 2 的大规模数据集 SA-V 已上线至 HyperAI超神经官网 (hyper.ai),一键即可下载。

2023 年 4 月,Meta 发布 Segment Anything Model (SAM),号称能够「分割一切」,这一颠覆传统计算机视觉 (CV) 任务的创新性成果引起了业内的广泛讨论,并被快速应用于医疗图像分割等垂直领域的研究中。日前,SAM 再升级,Meta 开源了 Segment Anything Model 2 (SAM 2),成为计算机视觉领域的又一个划时代里程碑。

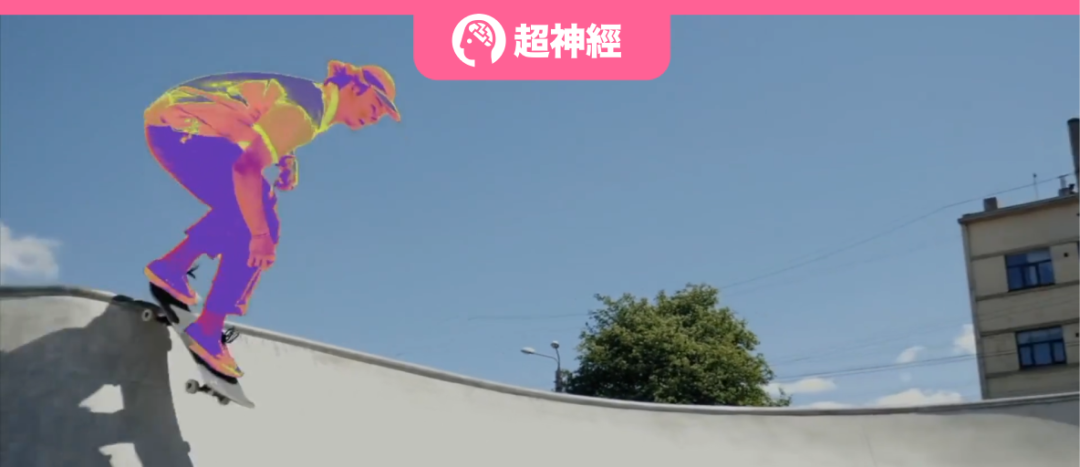
SAM 2 演示预览

从图像分割跨越到视频分割,SAM 2 在实时提示分割方面展现出了卓越性能,该模型将图像和视频的分割、跟踪功能引入到统一的模型中,只需在视频帧上输入提示(点击、框或掩码),就能精准识别并分割图像或视频中的任何对象,这种独特的零样本学习能力赋予了 SAM 2 极高的通用性,在医学、遥感、自动驾驶、机器人、伪装物体检测等领域展现出巨大的应用潜力。Meta 对其充满信心:「我们相信,我们的数据、模型和见解将成为视频分割和相关感知任务的重要里程碑!」

确实如此,SAM 2 前脚上线,大家就迫不及待的用了起来,效果好到 Unbelievable!
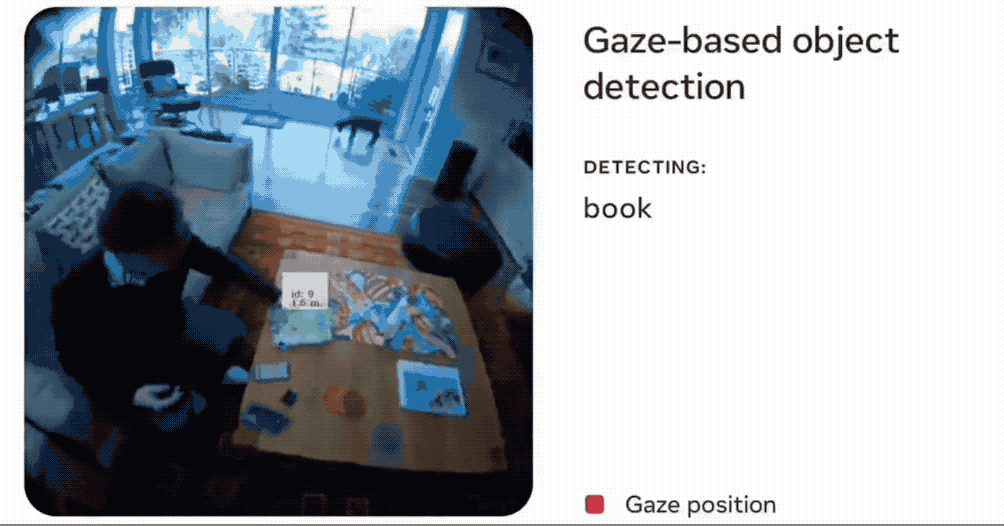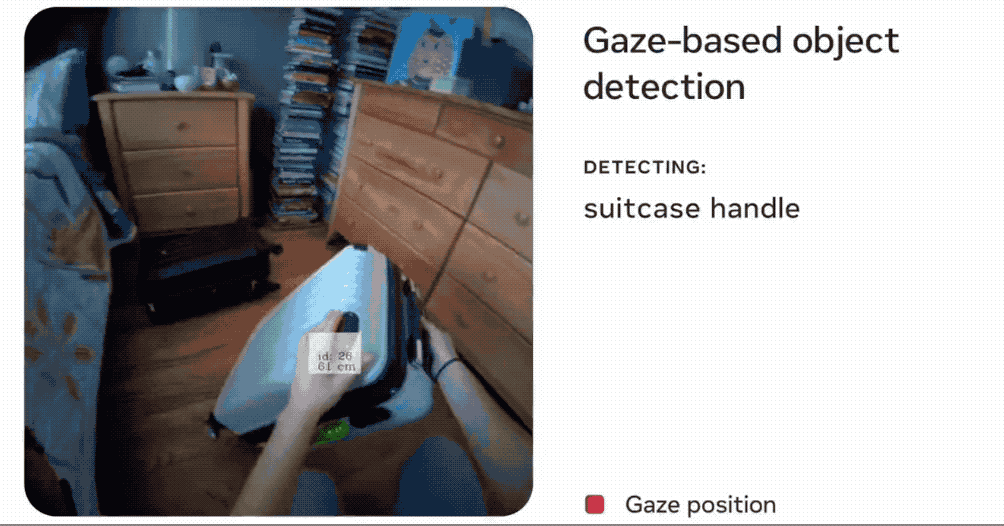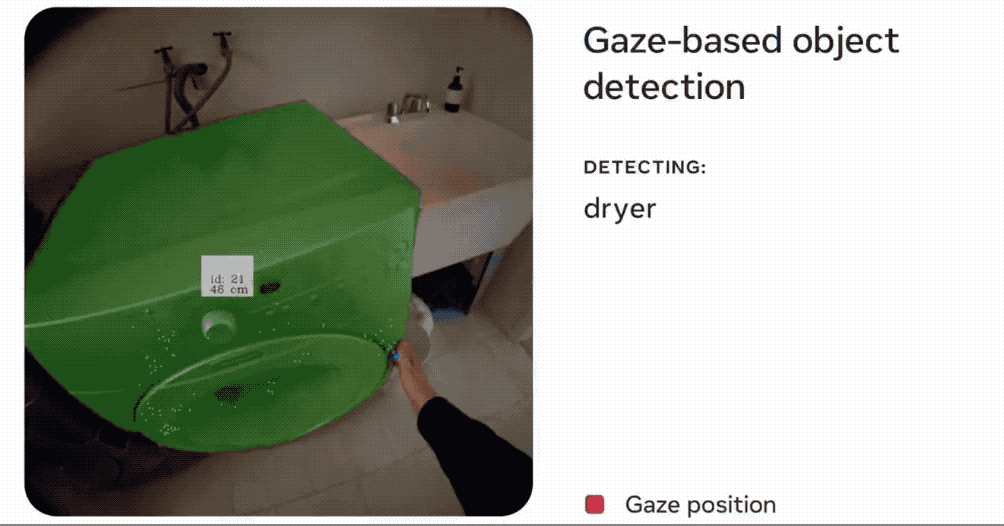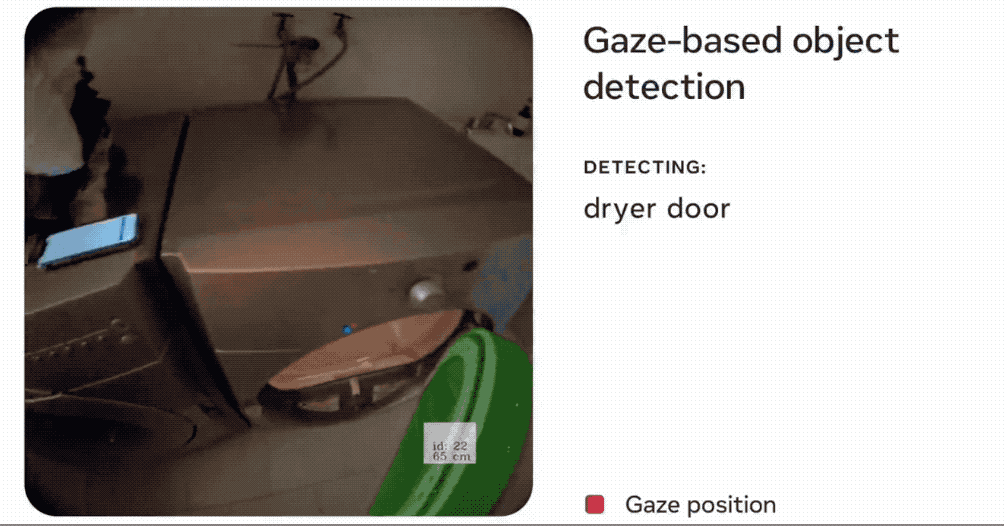
 c38293b276090344c54b8b2576035a01.gif

图源:Carlos Santana

SAM 2 开源不到半个月,多伦多大学研究人员就将它用在医学图像和视频上,还顺便发表了一篇 paper!
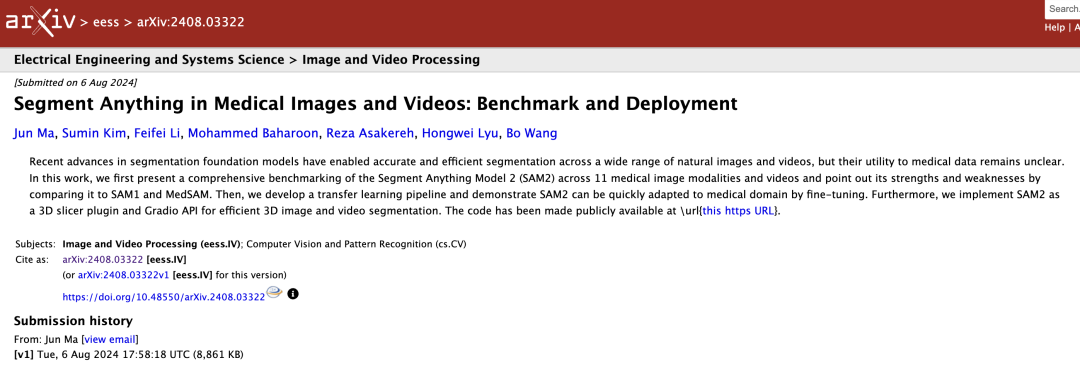

ff96ef81c84383cc7ca0fbdcc4bb8ebb.png
论文原文:
https://arxiv.org/abs/2408.03322
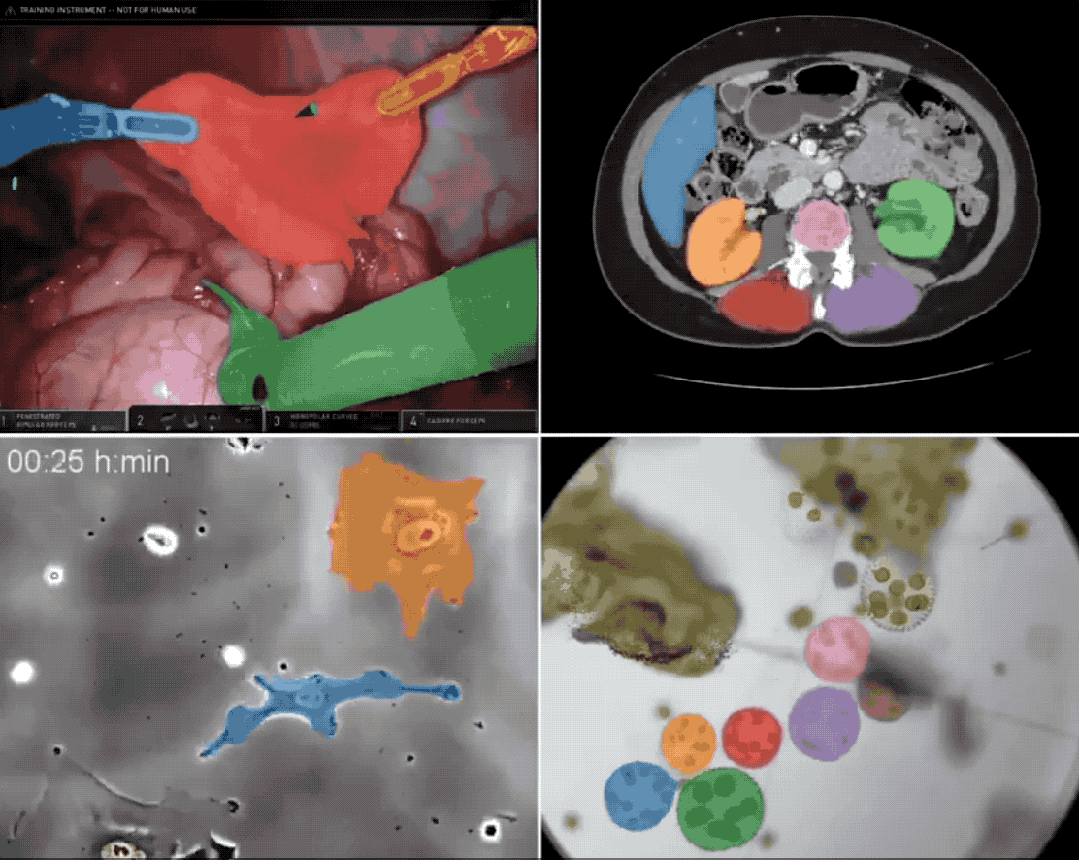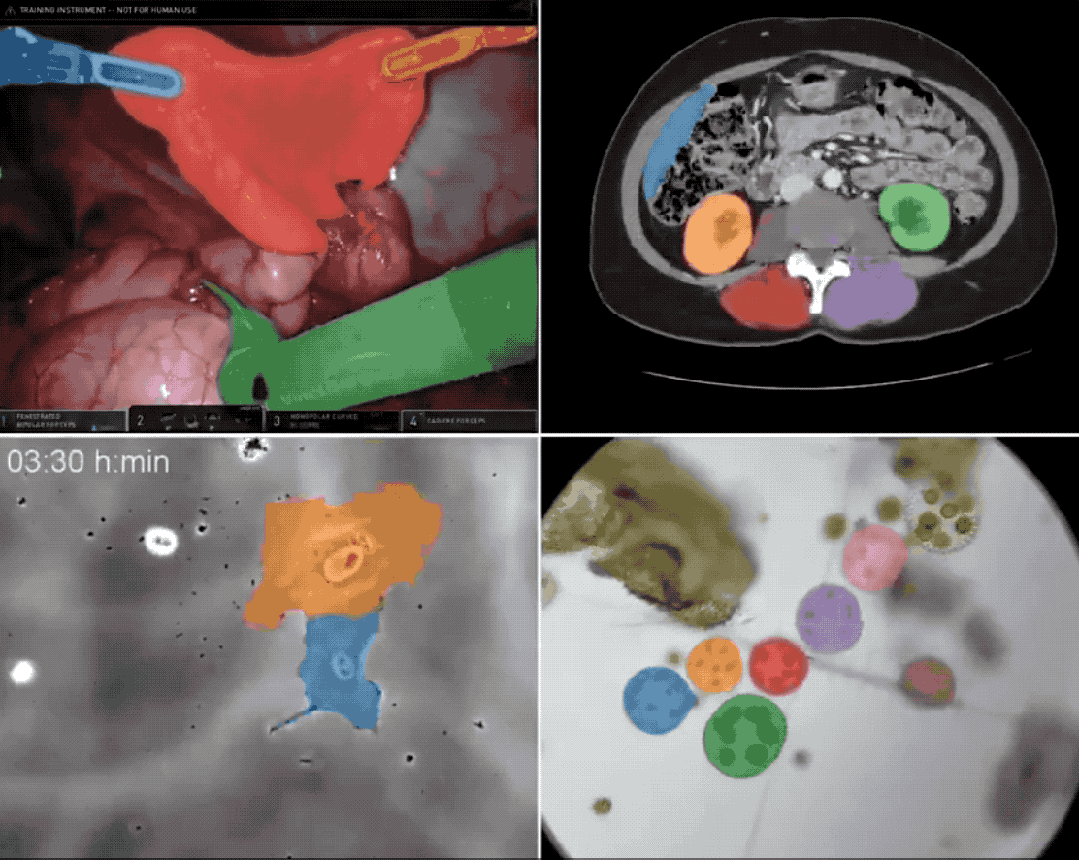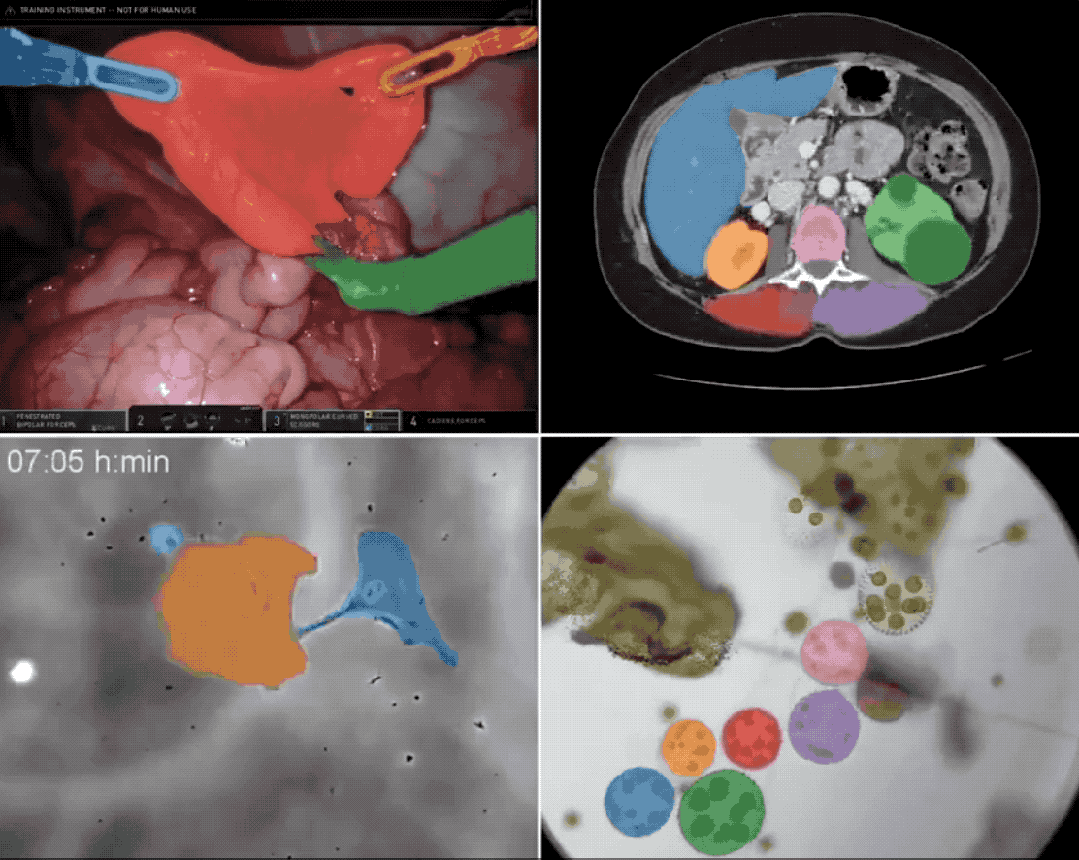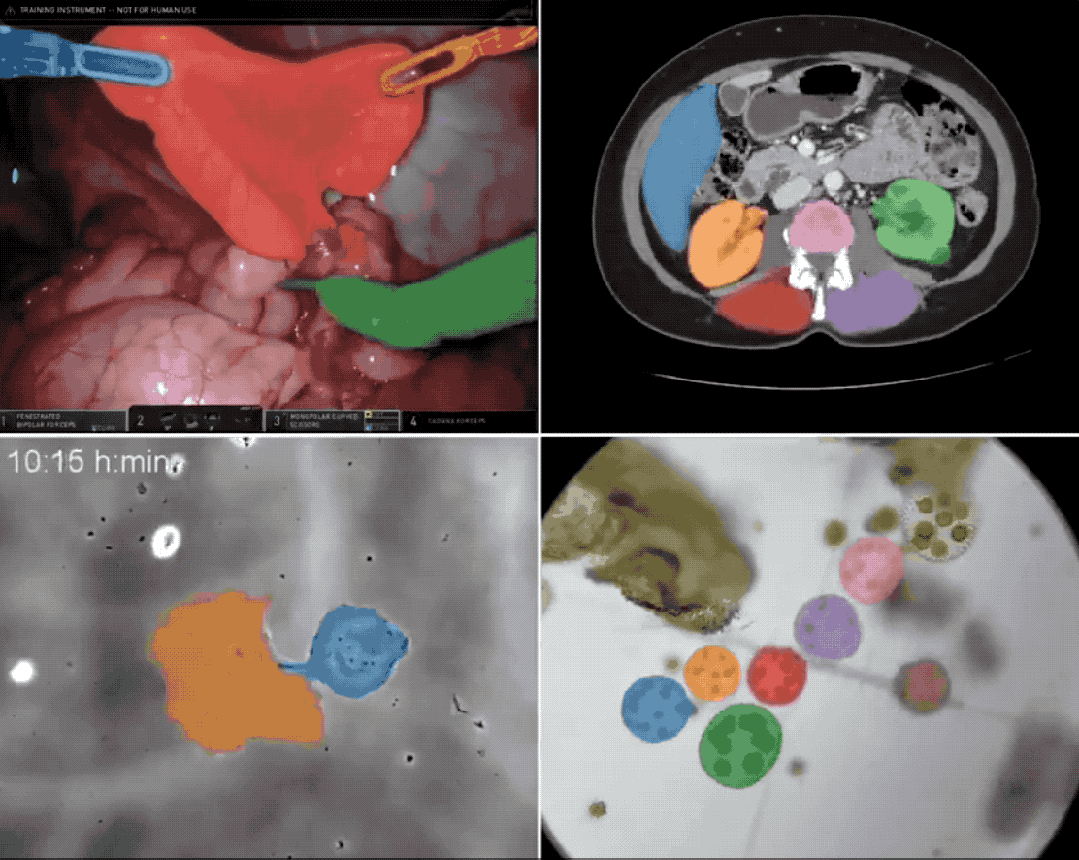
14ec1da6b247c89aa01bbab1ba788c3d.gif

多伦多大学研究

图源:Marktechpost AI Research News

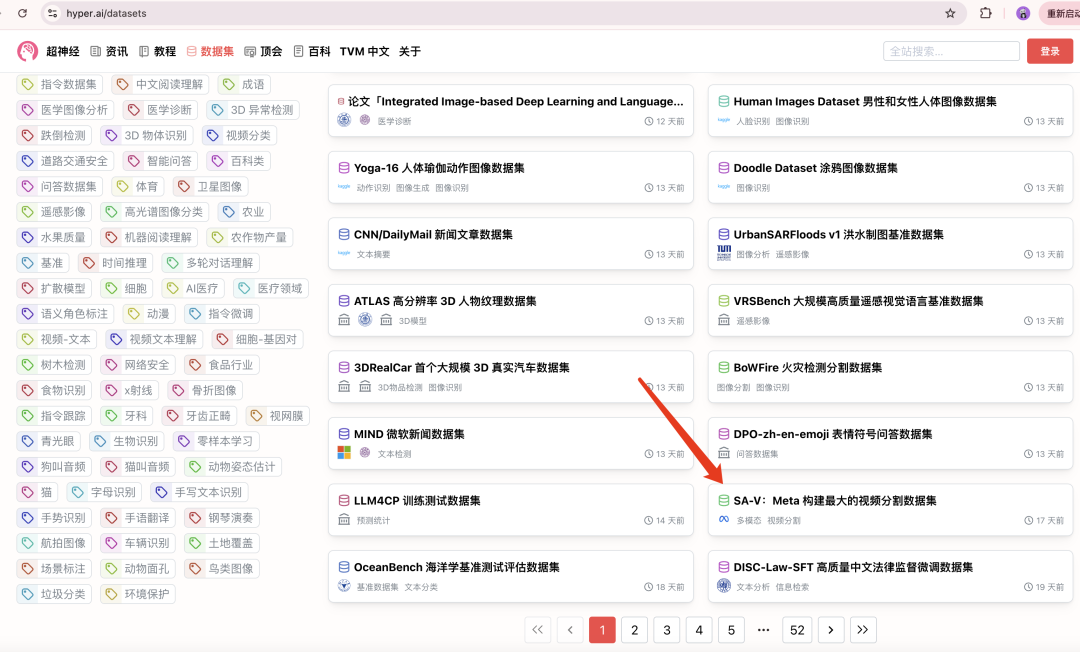
模型需要数据来训练,SAM 2 也不例外。Meta 在同一时间还开源了用于训练 SAM 2 的大规模数据集 SA-V,据悉,该数据集可用于训练、测试和评估通用对象分割模型 (generic object segmentation models),HyperAI超神经已经在官网上线了「SA-V:Meta 构建最大的视频分割数据集」,一键即可下载!
1b418b623dab622883fc7d3437a7a88e.png

SA-V 视频分割数据集直接下载:
https://go.hyper.ai/e1Tth


更多高质量数据集下载:
https://go.hyper.ai/P5Mtc

超越现有视频分割数据集!SA-V 涵盖多主题、多场景

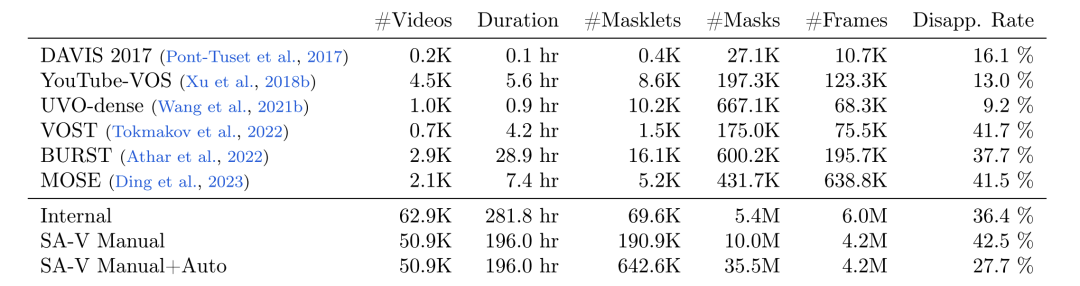
Meta 研究人员使用数据引擎收集了一个大型且多样化的视频分割数据集 SA-V,如下表所示,该数据集包含 50.9K 个视频,642.6K 个 masklets (由 SAM 2 辅助手动注释 191K、由 SAM 2 自动生成 452K ),与其他常见的视频对象分割 (VOS) 数据集相比,SA-V 在视频、masklets 和 masks 数量上均有大幅提升,其标注的 masks 数量是现有任何 VOS 数据集的 53 倍,为未来的计算机视觉工作提供了丰富的数据资源。
d209816c11d2079facc18adf8219bf38.png
SA-V与开源VOS数据集在视频数量、时长

掩码片段数量、掩码数量、帧数量和消失率方面的比较

* SA-V Manual 仅含手动标注的标签

* SA-V Manual+Auto 将手动标注的标签与自动生成的掩码片段结合

据了解,SA-V 包含的视频数量超过了现有的 VOS 数据集,平均视频分辨率为 1401×1037 pixels,收集的视频涵盖各种日常场景,包括 54% 的室内场景视频和 46% 的室外场景视频,平均时长为 14 秒。此外,这些视频的主题也多种多样,包括位置、物体、场景等,Masks 的范围从大型物体(如建筑物)到细粒度的细节(如室内装饰)。
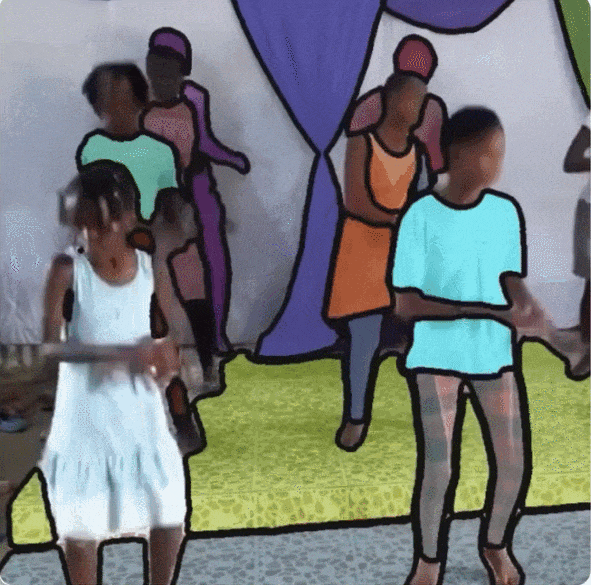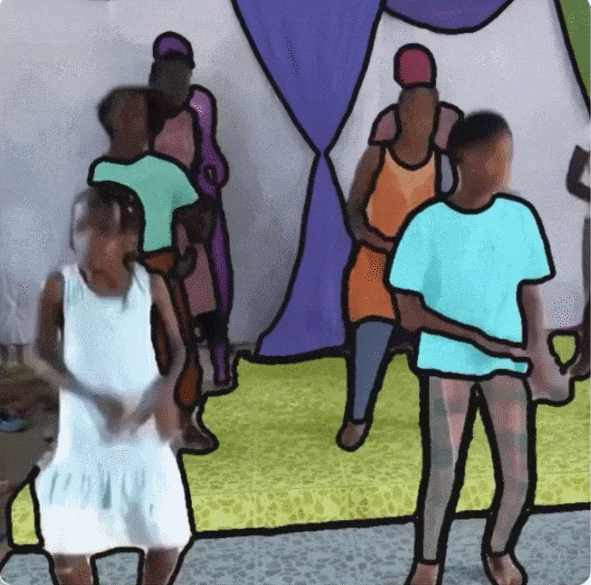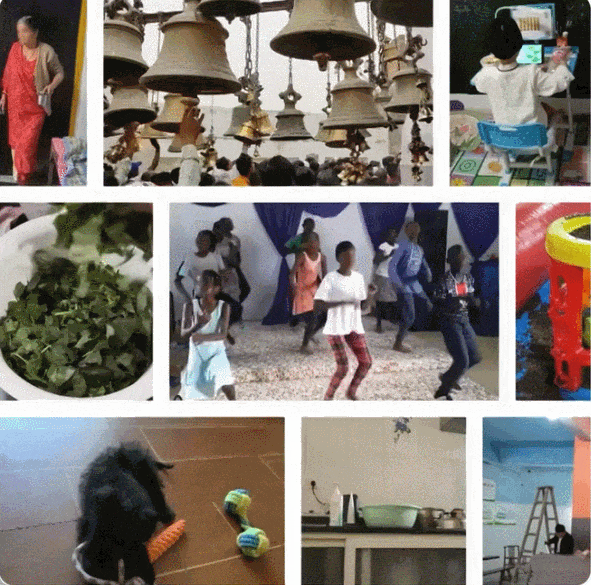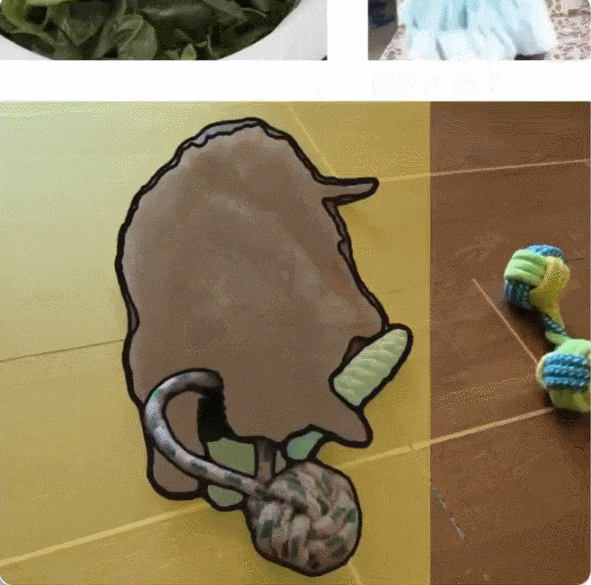
286d0f5fde4fdb972cd091df84b14817.gif

SA-V 数据集中的视频

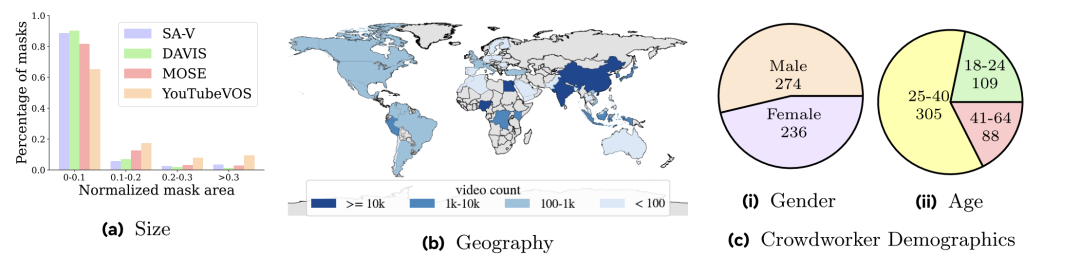
如下图所示,SA-V 中的视频覆盖 47 个国家,并由不同的参与者拍摄,图 a 可得,与 DAVIS、MOSE 和 YouTubeVOS 掩码大小分布相比,SA-V 小于 0.1 的归一化掩码面积 (normalized mask area) 超过 88%。

7b21de8e590ff6021697b023b55046a1.png
数据集分布
(a)掩码片段大小分布 (b)视频的地理多样性 (c)录制视频工作者的自我报告人口统计

研究人员根据视频作者及其地理位置对 SA-V 数据集进行划分,确保数据中的相似对象有最小重叠 (minimal overlap)。为了创建 SA-V 验证集和 SA-V 测试集,在选择视频时,研究人员聚焦具有挑战性的场景,要求标注者识别快速移动、被其他物体遮挡、具有消失/重现模式的目标。最终,SA-V 验证集中有 293 个 masklets 和 155 个视频,SA-V 测试集中有 278 个掩码片段和 150 个视频。此外,研究人员还使用内部可用的授权视频数据进一步扩充训练集。


SA-V 视频分割数据集直接下载:
https://go.hyper.ai/e1Tth

以上就是 HyperAI超神经本期为大家推荐的数据集,如果大家看到优质的数据集资源,也欢迎留言或投稿告诉我们哦!


更多高质量数据集下载:
https://go.hyper.ai/P5Mtc

 往期推荐 
91740345af43f3a41ccd5ba190866c10.png

67869e7b5736ca68a82fe442c9006a04.png

dfb7db45cf7f87a0e2d0d34046783414.png

11f15f5357900f22a478fa68556fc36d.gif

f2eceb8869763ebe00fd08547fbf040f.gif

戳“阅读原文”,免费获取海量数据集资源!

Meta强势推出分割一切新工作的视觉大模型!SAM2对比YOLOV8 SAM 2 是 Meta 的Segment Anything Model (SAM) 的后续产品,是一款专为图像和视频中的综合对象分割而设计的尖端工具。它采用统一、可提示的模型架构,支持实时处理和零镜头泛化,在处理复杂的视觉数据方面表现出色。 阅读详情

相关推荐

探索SAM 2:图像与视频分割的新突破

SAM 2在SAM的基础上实现了从图像到视频的能力扩展,通过其独特的架构和先进的处理方式,在图像和视频分割领域展现出了卓越的性能和广泛的应用前景。无论是创意视频制作、计算机视觉系统开发还是其他相关领域,SAM 2都有望成为推动技术发展的重要力量,为我们带来更多的创新和便利。

m0_62153576的博客 138

SA-V数据集深度探索:全球最大视频分割数据集使用指南

Segment Anything Video (SA-V) 是目前全球最大的视频分割数据集,由Meta公司发布,包含51K多样化视频和643K高质量时空分割掩码。作为视频分割领域的里程碑式资源,SA-V数据集为计算机视觉研究者提供了前所未有的训练素材,特别适合开发和评估视频目标分割模型。 ## SA-V数据集核心特性与规模 SA-V数据集通过模型与人工协作的方式构建,形成了独特的"自动+手动"

gitblog_00761的博客 876

.sav数据文件数据下载

6万多条酒店数据,这下够挖了吧。数据.sav文件下载地址!

【分割大模型】SAM2(Segment Anything2)新的分割一切大模型(原理+安装+代码)

Segment Anything Model 2(SAM 2)是由Meta公司发布的一个先进的图像和视频分割模型。它是Segment Anything Model(SAM)的升级版本,SAM是Meta的FAIR实验室发布的一款用于图像分割的基础模型,能够在给定提示的情况下生成高质量的对象mask。

qq_45752541的博客 1万+

GD32F470实战:如何用EXMC+SDRAM为LVGL打造超大内存池(附完整配置代码)

本文详细介绍了如何利用GD32F470的EXMC接口与SDRAM深度整合,为LVGL构建高性能内存解决方案。通过硬件架构设计、EXMC接口配置、高级内存管理策略及LVGL性能优化技巧,开发者可以突破微控制器内存限制,实现高分辨率显示和复杂动画效果。附完整配置代码,助力嵌入式GUI开发。

rrr55的博客 548

HighScore3.0实战指南:XRD物相分析从入门到精通(持续更新版)

本文提供HighScore3.0软件进行XRD物相分析的完整实战指南。从软件设置、数据导入、背景扣除、寻峰等预处理步骤,到核心的Search & Match物相搜索匹配、Rietveld精修定量,以及结果输出与常见问题排查,系统讲解了从入门到精通的全流程操作与核心技巧,帮助用户高效完成材料物相鉴定与分析工作。

weixin_29310605的博客 1047

Meta 最大视频分割数据集已上线,规模超同类 50 倍;狂揽 9K 星!快手数字人 Demo 一键启动!

为促进生物学领域对 AI 系统的有效开发,FutureHouse Inc. 的研究人员推出了语言 Agent 生物学基准数据集 LAB-Bench,该数据集用于评估 AI 系统在文献检索和推理、图表解释、DNA 和蛋白质序列的理解和处理等实际生物学研究的表现,成果已提交至顶会 NeurlPS 2024。AuraSR 是一款基于深度学习的图片高清修复模型,能够智能识别图片中的细节信息,并在放大图片的同时,自动补充缺失的细节。CCPD 数据集是一个大型的、多样化的、经过仔细标注的车牌识别数据集。

HyperAI超神经 853

VMware ESXI 7.0实战:4T硬盘RAID1配置与性能调优全记录

本文详细记录了在VMware ESXI 7.0环境下,为Dell服务器配置两块4T硬盘组建RAID1并进行深度性能调优的全过程。文章重点解析了RAID控制器写入策略(Write-Back with BBU)、读取策略(Read-Ahead)的关键选择,并深入探讨了在ESXI虚拟机层面通过选用PVSCSI控制器、调整虚拟磁盘缓存策略(scsiX:Y.caching)等技巧,以最大化满足数据分析等IO密集型工作负载的需求,最终实现性能的显著提升。

gaochao的博客 260

Meta 最大视频分割数据集已上线,规模超同类 50 倍;狂揽 9K 星!快手数字人 Demo 一键启动!...

AI 如何赋予静态人像生命力,使其微笑、眨眼、甚至微妙的面部表情都栩栩如生?近日,快手团队开源了 LivePortrait,只需上传一张静态照片,它就能变身为表情丰富的动态肖像,在 GitHub 上已狂揽 9K stars。该教程现已在 HyperAI超神经上线,快来急速体验一下! LivePortrait 教程链接: ...

weixin_36966075的博客 224

ArcGIS投影变换实战:从WGS_1984到Krasovsky_1940_Albers的精准转换

本文详细解析了在ArcGIS中如何将WGS_1984地理坐标系下的数据精准转换至Krasovsky_1940_Albers投影坐标系。文章通过实战案例,重点阐述了地理坐标系与投影坐标系的区别,并逐步演示了创建自定义地理变换、使用投影栅格工具以及进行批量处理和结果验证的核心操作流程,旨在解决地图数据叠加不准的常见问题。

weixin_29251131的博客 469

RK3588适配Ubuntu系统

RKsdk上支持buildroot以及Debian系统,但是Ubuntu需要自己移植,有很多公司都移植好了可以直接用,这里就总结记录一下我制作Ubuntu的过程。

m0_60805802的博客 5365

SAM 3一键部署:图片视频分割神器开箱即用

本文介绍了基于星图GPU平台自动化部署SAM 3 图像和视频识别分割镜像的便捷方案。用户无需配置环境,通过一键启动即可快速运行模型,适用于图像视频智能编辑、AI应用开发等场景,实现高效精准的对象分割与跟踪。

weixin_30995917的博客 394

SmartFusion从FPGA到ARM(九)——串口命令解析器的实现

系列教程:SmartFusion从FPGA到ARM系列教程 前面两节介绍了MSS_UART和CoreUARTapb的使用: MSS_UART的使用 CoreUARTapb的使用 MSS_UART和CoreUARTapb都支持中断和轮询方式获取串口接收的数据,对于串口中断服务函数,有时我们需要通过不同的串口指令去执行不同的动作,下面以CoreUARTapb为例,来实现一个简单的串口命令解析器。固定串口数据帧格式,帧长度不定。 串口数据帧格式:* + 数据 + #,对于数据中为参数的,可以自定义处理函数。例

whik1194的博客 1537

Meta「分割一切」3.0曝光!技能语义分割加入概念提示,好好玩,要爆了

不过需要说明的是,SAM 3对语言的处理还局限于简单的短语提示,不支持复杂的语言表达,并不具备多模态大模型的语言生成、复杂语言理解和推理能力。简单来说,就是在这个官方新版中,分割模型终于能听懂人话了:只要说出想要的东西,SAM 3就能在图像/视频中分割出对应实例。PCS的定义是,给定图像或视频,模型能够基于短语、图像示例,或者两者结合的方式,分割其中所有匹配提示概念的实例。在LVIS数据集的零样本分割任务中,SAM 3的准确率达到了47.0,比此前的SOTA 38.5提升不少。

量子位 121

C#串口通信从入门到精通(7)——整数/浮点数与二进制、八进制、十六进制之间的转换与C#实现

本文详细介绍由博主开发的DataConvert串口通信帮助类的用法,该帮助类涵盖了串口通信领域所有的数据转换方法,帮助大家快速编写串口通信程序!

qq_34059233的博客 2881

基于机器学习的网络安全态势感知模型研究与实现

基于机器学习的网络安全态势感知模型研究与实现 1. 背景介绍 1.1 网络安全态势感知的重要性 在当今互联网时代,网络安全已经成为一个至关重要的话题。随着网络攻击手段的不断升级和演变,传统的被动防御方式已经难以满足日益

AI大模型应用之禅 1584

自动驾驶图像分割开源数据集指南(2026)

做分割几乎都从 Cityscapes 下起,下完才发现:BDD 名字带 100K,;不能当监督;SYNTHIA 的 13/16 类 mIoU 和 Cityscapes 19 类不能写在同一格。下面按任务和场景整理我核对过官网的集合,只收带像素级或点级分割标注的。命令以 2026-08 仍能打开的入口为准,404 时回到项目主页,不要死磕旧直链。目录。

weixin_42263762的博客 594

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Ultralytics 中的 SAM 3:概念提示分割(PCS)架构解析与完整实战指南

SAM 3(Segment Anything Model 3)是 Meta 于 2025 年 11 月发布的基础分割模型,其核心创新在于引入 **Promptable Concept Segmentation(PCS,可提示概念分割)**:不再局限于"分割单个实例",而是能用一句文本短语或一张示例图片,分割出图像/视频中**所有**匹配该视觉概念的实例。本文基于当前仓库中 `ultralytics

gitblog_01109的博客 1150

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

在线运行 Llama 3.3 唯一开源 70B 模型,性能堪比 405B!LaTeX OCR 数据集上线,助力数学公式识别

MangaZero 数据集是一个专为漫画生成任务设计的大规模、多角色、多状态的漫画图像数据集,具体包含 43,264 页漫画和 427,147 个带注释的面板,支持在连续帧中可视化各种角色互动和动作,适用于多角色、多状态的漫画生成任务。该数据集是一个包含 3,371 张飞机图像的数据集,这些图像被分为 10 个类别文件夹,每个类别对应一个特定的飞机型号:A10、A400M、AG600、AH64、AV8B、An124、An22、An225、An72 和 B1 等。本文是对该公司的详细报道,点击速看。

HyperAI超神经 1015

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Hindsight自监督语义分割:无标注视频中学习像素级分类的实战解析

计算机视觉中的语义分割通常依赖海量像素级标注,人工成本极高,严重制约了在自动驾驶、机器人感知等场景的落地。自监督学习为突破这一瓶颈提供了新思路,通过设计代理任务从无标注数据中提取语义特征。Meta AI 开源的 Hindsight 模型采用“先看答案再做题”的训练策略,利用视频帧间的时间一致性作为监督信号,配合 K 个可学习查询向量与跨帧特征对齐机制,在不使用 ImageNet 预训练和外部标注的条件下,单卡训练数天即可达到与预训练模型相当的分割效果。本文剖析其核心原理、工程架构与损失设计,并分享复现过程中

weixin_29031057的博客 216

码科智能 | Meta又一巨作 以人为中心的视觉基础模型:可用于姿势估计、深度估计、身体分割等任务

Sapiens 标志着将以人为本的视觉模型提升至基础模型领域的重大进步。我们的模型在各种以人为中心的任务上展示了强大的泛化能力。我们将模型的最先进性能归因于:(i) 在专为理解人类量身定制的大型精选数据集上进行大规模预训练,(ii) 高分辨率和高容量的视觉变换器主干的扩展,以及 (iii) 对增强的工作室和合成数据的高质量注释。我们相信这些模型可以成为众多下游任务的关键构建块,并向更广泛的社区提供高质量的视觉主干。未来工作的一个潜在方向是将 Sapiens 扩展到 3D 和多模态数据集

csdn_xmj的博客 1006

MMagic 视频超分 SPMCS 数据集准备与评测配置全指南

SPMCS(Super-resolution and Motion Compensation from Spatially variant downsampling,出自 ICCV 2017 论文 *Detail-Revealing Deep Video Super-Resolution*)是视频超分辨率(Video Super-Resolution, VSR)领域广泛使用的标准测试基准。本文以

gitblog_00214的博客 204
上一篇: 入选ACL2024主会 | InstructProtein:利用知识指令对齐蛋白质语言与人类语言
下一篇: 突破万字长文输出瓶颈!清华大学开源 LongWriter-6k 数据集;7 个 CCF A 类顶会即将截稿...
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值