“弱智吧”才是人类面对AI的最后一道堡垒

手把手教你如何全参微调QWEN2.5 本次实战采用QWEN2.5的0.5b的小体量模型在弱智吧数据集上进行微调。通过本次实战,希望大家能够掌握以下技能:1,如何快速获取廉价算力2,如何在QWEN模型上进行全参微调。 阅读详情

在 AI 的研究领域中,语言模型的训练数据选择一直是一个关键问题。传统的智慧告诉我们,高质量的数据集应该是由专家精心挑选和校对的文本组成,以确保模型学习到的语言是规范、准确、有文化内涵的。

然而,最近的一项研究颠覆了这一观点,让整个AI界都大跌眼镜——弱智吧的数据竟然在中科院的在问答、头脑风暴、分类、生成、总结、提取等8项测试中取得最高分,成为了最佳的中文AI训练数据源之一,跑分超过百科、知乎、豆瓣、小红书等平台。
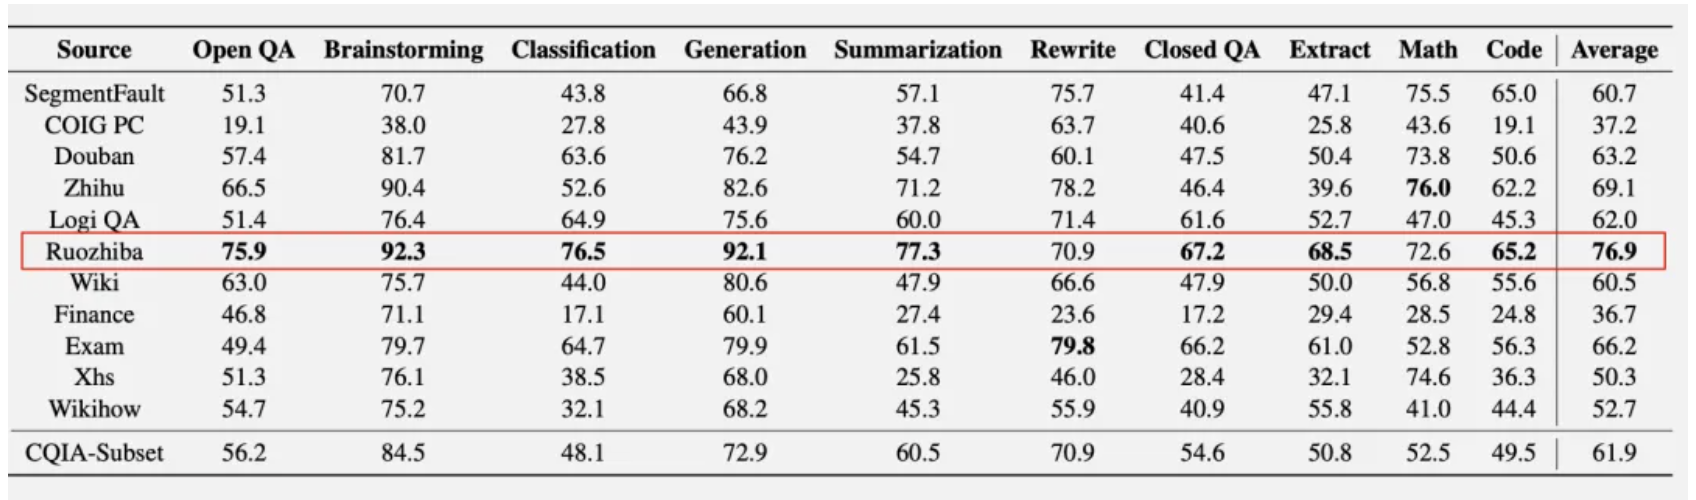
弱智吧段子集合了各种以冷笑话,谐音梗,词意混用等为基础构造的中文特色逻辑陷阱,用来训练中文 AI 的确是个好材料,我们也先乐一下。

我买了一斤藕,为什么半斤都是空的?

午餐肉,我可以晚上吃吗?

我想配个6000多的电脑,大概要多少钱?

香菇掉厕所了还能叫香菇吗?

玉皇大帝住的是平流层还是对流层?

变形金刚买保险是买车险还是人险?

陨石为什么每次都能精准砸到陨石坑?

为什么岳飞让岳母给他刺而不是让自己母亲给刺?

既然台上一分钟,台下十年功,那为什么不直接在台上练功?

为什么两个字是三个字?因为四个字也是三个字。

生鱼片是死鱼片。

等红灯是在等绿灯。

救火是在灭火。

这听起来是不是有些诙谐?这些数据的特点通常是非正式、包含大量网络用语、俚语、甚至是错别字和语法错误。这样的数据源,按理说,应该是AI训练中需要避免的“噪音”。

这项研究起初为解决中文大模型训练中的诸多问题:

  1. 中文数据集很多是从英文翻译过来的,没有很好地契合中文的语言习惯和文化背景。
  2. 不少数据集是用AI生成的,质量难以保证,容易出现事实性错误
  3. 即使是人工标注的数据集,也存在数据量小、覆盖领域不全面等问题

中科院的研究者们在对多种中文数据集进行深入分析和比较后,发现弱智吧数据在多样性、覆盖面以及反映真实语言使用情况等方面表现出色。在8项不同的语言模型测试中,包括语义理解、情感分析、自然语言生成等,以弱智吧数据为基础训练出的模型性能竟然领先于其他传统认为更为“高质量”的数据集。

当然,这并不意味着我们可以完全放弃对数据质量的追求。相反,这一发现提醒我们,在构建AI系统时,应该更加注重数据的多样性和代表性,同时也要关注数据的质量。未来的AI训练可能会采用更加多元化的数据源,结合专家知识进行筛选和优化,以达到最佳的训练效果。
总之,弱智吧成为最佳中文AI训练数据的事实,不仅为我们提供了一个关于AI训练数据选择的新视角,也为AI的发展和应用打开了新的可能性。在这个充满惊喜的AI时代,我们期待着更多这样颠覆性的研究,引领我们走向一个更加智能的未来。

从AlphaGo到AI时代:人类如何与智能工具协同进化 人工智能作为一项基础性技术,其核心原理在于通过算法和数据模拟人类智能的某些功能。从机器学习到深度学习,AI系统能够处理复杂模式识别与决策任务,这背后是计算能力和数据资源的巨大提升。其技术价值在于显著提升效率、解决人力难以处理的复杂问题,并催生新的产品与服务形态。应用场景已从早期的游戏对弈(如围棋AI)扩展到自动驾驶、智能助手、医疗诊断等众多领域。随着AI能力的增强,关于人类角色、技能依赖与教育转型的讨论日益热烈,这自然引出了人机协作与伦理设计的关键议题。本文结合AlphaGo等案例,探讨在智能泛滥时代,人类 阅读详情

相关推荐

【AI大模型开发者指南】ruozhiba数据集构建——xtuner实战

可以从opendatalab直接下载下载完成后,传输到服务器中(开发环境中)

m0_48862433的博客 1157

弱智吧”,人类抵御AI的最后防线

写遗嘱的时候错过了deadline怎么办?“怀念过去是不是在时间的长河里刻舟求剑?“英语听力考试总是听到两个人在广播里唠嗑,怎么把那两个干扰我做题的人赶走?以上这些饱含哲学但好像又莫名其妙的问题,出自百度贴吧“弱智吧”2023年年度精选,看似毫无逻辑,但仔细一想好像确实又有点道理。就像天才吧里没有天才,弱智吧也不收真弱智。然后,它就成为了训练AI中文能力的最佳素材。前几天看到一篇中科院牵头的论文,简单来说就是精选了一些中文互联网的语料库喂给各种零一万物的Yi大模型,让它们更加熟悉中文语境的互动。

python1222_的博客 6636

GPT-4发布后首迎挑战:来自“弱智吧”的AI能力极限测试

GPT-4 很强,但它仍然不是一个会“思考”的主体。它的“理解”本质上是统计模式的再现,它的“推理”是高维空间中的插值运算,它的“创造力”是训练数据的重组与变形。当我们问“如果时间是蓝色的”,它给出的回答不是来自内心的感悟,而是基于“颜色-抽象概念”关联强度的概率采样。但这并不意味着它毫无价值。相反,正是这种介于机械与智慧之间的模糊地带,让我们得以重新审视“理解”本身的定义。也许有一天,我们会发现:所谓理解,本来就不需要“真实”的心智,只需要足够精细的模拟。

weixin_35459464的博客 839

Qwen2.5-7B 微调rz吧数据集

Qwen2.5-7B 是由阿里巴巴达摩院开发的一款基于 Transformer 架构的大规模语言模型。该模型在多个 NLP 任务上表现出色,尤其是在中文语境下。Qwen2.5-7B 的参数量约为 70 亿,具备较强的语言理解和生成能力。弱智吧是一个中文社区,用户在其中分享各种幽默、搞笑的对话和段子。弱智吧数据集包含了大量的对话样本,适合用于训练模型在幽默、搞笑场景下的表现。通过微调 Qwen2.5-7B 模型,我们可以让模型更好地理解和生成类似的幽默内容。

m0_56699208的博客 1397

Matlab编码转换实战:从GBK到UTF-8的完整解决方案

本文提供Matlab编码转换的完整实战方案,重点解决GBK与UTF-8编码冲突导致的中文乱码问题。通过修改系统配置文件、批量转换项目文件及设置默认保存编码,实现从GBK到UTF-8的彻底迁移,并分享常见避坑指南与自动化脚本技巧,确保代码跨平台协作的稳定性。

weixin_29031057的博客 326

Centos7 XFS(dm-0):Internal error XFS_WANT_CORRUPTED_GOTO

在k8s的道路上我们都是小白,每天启动虚机都会遇到各种各样的问题,这不。部署的k8s虚机启动发现操作系统启动异常,提示如下报错信息。进入/dev/mapper目录下,查询目录下路径信息。可以通过对文件系统进行修复操作,操作如下。重启完成后虚机恢复正常登录。

hedao0515的专栏 4583

OpenBayes 一周速览|COIG-CQIA 「弱智吧」数据集上线、在线体验通义千问首个 MoE 模型

该数据集涵盖了 2 万个各式各样的事实问题,这些问题涉及到不同的来源、时间线、领域、地区和语言,可用于测试 LLMs 在多事实推理、处理结构化与非结构化知识、识别细微事实差异以及抵御对抗性示例等方面的能力。COIG-CQIA 是一个开源的高质量中文指令微调数据集,数据来源不仅有问答社区(如知乎、思否、豆瓣、小红书、弱智吧等等),还有维基类的知识平台,各种类型的考试资料,以及现存的 NLP 数据集。该数据集为番茄叶病图像检测数据集,图像分为以下几类:健康、细菌斑、早疫病、健康、晚疫病、叶霉病、目标点和黑点。

OpenBayes的博客 1339

LVGL 9.4 性能调优实战:如何通过脏区合并与tile分块,让你的嵌入式UI流畅度翻倍

本文深入探讨LVGL 9.4中的性能优化技术,重点介绍脏区合并与tile分块如何显著提升嵌入式UI流畅度。通过实战案例和源码分析,详细解析局部刷新策略、显示框架调优及性能瓶颈诊断方法,帮助开发者在STM32、ESP32等资源受限设备上实现丝滑的UI体验。

weixin_28678831的博客 450

大模型中文微调最佳神器!「弱智吧」吊打小红书、知乎、豆瓣...

大型语言模型(LLM)在近些年取得了重大进展,特别是在英语方面,然而,LLM 在中文指令调优方面仍然存在明显差距。不久前,一篇人工智能论文将弱智吧推上AI圈的风口浪尖,该贴吧竟然成为了最好的中文训练数据!具体来说,使用弱智吧数据训练的大模型,跑分超过百科、知乎、豆瓣、小红书等平台,甚至是研究团队精心挑选的数据集。在问答、头脑风暴、分类、生成、总结、提取等8项测试中取得最高分。5月8日-5月9日,我...

Paper weekly 851

SNN目标识别MNIST

总体来说这篇论文提出的方法用了多种更精密的细节,如LIF膜电位公式,三种STDP方法,但我觉得还可以有很大的改进,比如输入层全连接到兴奋层,兴奋层通过抑制层实现的侧向抑制,抑制层不参与学习等等。尤其是兴奋层通过抑制层实现侧向抑制这里,当神经元兴奋时,通过抑制层再倒回兴奋层,所抑制的已经经过一了一段时间的延迟。如有错误,请不吝赐教。

m0_74982304的博客 1263

5分钟搞定Google Custom Search API申请:从注册到获取CX Key全流程

本文详细介绍了如何快速申请和配置Google Custom Search API,从Google Cloud项目创建、启用计费、获取API Key,到在Programmable Search Engine控制台创建自定义搜索引擎并获取关键的CX Key,提供了全流程实战指南。文章还包含安全配置建议、API调用测试方法及前端与后端的集成代码示例,帮助开发者高效实现网站或应用的智能搜索功能。

weixin_29227585的博客 1677

硅纪元应用评测 | 弱智吧大战GPT4o和Claude 3.5 Sonnet

今天我将从弱智吧中选取一系列具有代表性的问题,包括双关语、深层逻辑和网络梗等不同类型,以及图片的识别分析能力,确保问题涵盖多个难度级别和主题,来进行测试,比如理解问题的准确性、回答的相关性和创意性、幽默感的把握、逻辑推理能力、对网络文化的理解程度,当然该评测具有娱乐性和局限性,仅供参考。很多朋友可能不知道弱智吧是什么,弱智吧就是百度贴吧里比较火的一个小组,里面的一些提问看似弱智,其实充满了双关语,以及深刻的逻辑和各种各样的梗。更喜欢Claude 3.5的回答,打工人遇到职场问题,可以来问他俩,靠谱。

guijiyuantech的博客 1292

英飞凌TC3xx之一起认识GTM(八)如何使用DTM实现死区时间配置

本文简要介绍英飞凌TC3xx系列芯片的DTM模块结构,以及有哪些相关寄存器可用于实现相关配置。

无所适从的我的博客 4650

那些动不动就“追上或超越”GPT的模型,球球你们收了神通吧

GAOKAO-Bench收集了2010-2022年全国高考卷的题目,包括选择填空之类的客观题,和阅读理解类的主观题,其中主观题训练集的标准答案由上海市曹杨第二中学的老师们评分。后者的参数量是前者的近10倍,要知道,在绝大多数情况下,参数量往往决定了大模型的能力。”问题,常常用来用测试大模型,像什么“老鼠生病了,吃老鼠药可以治好吗?在“第一个中文大模型”、“第一个垂类大模型”等名号被各大科技公司相继占领之后,这场竞赛逐渐转移到了分数上,竞争者们纷纷宣称自己在某些维度上排名第一,或是在某方面远超GPT-4。

heehelcom的博客 1017

Python 爬虫反爬突破:浏览器指纹深度伪装技术

在当前网络安全与反爬虫技术日趋成熟的环境下,传统的请求头伪装、IP 代理已无法满足复杂站点的爬虫需求。浏览器指纹作为网站识别爬虫、区分真实用户与自动化程序的核心技术,成为爬虫进阶必须突破的关键壁垒。浏览器指纹通过采集浏览器环境、硬件信息、渲染特性等多维数据生成唯一标识,即使更换 IP、清除 Cookie,网站仍可精准识别爬虫程序。本文聚焦浏览器指纹深度伪装技术,从指纹生成原理、核心指纹类型、Python 实现方案、高匿伪装实战到风控绕过策略,全方位讲解浏览器指纹的突破方法。Selenium 官方文档。

2503_91057718的博客 641

飞牛fnNAS同步微信微信聊天记录

微信聊天记录如何备份到NAS?本文介绍了利用NAS虚拟机和同步工具实现微信记录自动备份的方法。通过在NAS上搭建"云电脑"长期运行微信PC端,并配置微力同步将聊天记录文件夹自动同步到NAS存储,解决了传统电脑备份的安全性问题。操作步骤包括:1)在NAS上安装虚拟机系统;2)登录微信PC端并同步手机记录;3)配置同步工具将微信记录文件夹同步到NAS。该方法尤其适合不常使用PC微信的用户,可实现记录永久保存和远程查看,更换手机时也能快速恢复历史记录。

dgnankai的专栏 4313

全球性文学困局:为何时代难以孕育公认的文学巨匠?

文学困境:盛产时代为何难出大师? 当前全球文学面临核心悖论:作品数量空前增长,却难诞生公认的文学巨匠。这一现象源于多重结构性矛盾: 创作生态恶化:资本主导下文学功利化,基层作家沦为"文化孤岛",纯文学创作难以为继。县域作家调查显示87%需兼职谋生,创作时间被严重挤压。 评价体系扭曲:文学奖项腐败、圈子文化盛行,严肃批评被理论堆砌和流量逻辑取代。短视频传播将经典简化为"梗",削弱了深度阅读的可能。 技术冲击本质:AI写作威胁一般性创作,但无法替代人类的无意识体验。碎片化

m0_73265042的博客 742

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

超越GPT4的捷径,被国产大模型找到了

Google DeepMind资深工程师卢一峰表示:“(快思考阶段中)它的知识是来自于整个互联网的数据,压缩以后进行的重组、汇编,凭此来试着回答用户的问题,它实际上离我们真正所谓的‘慢思考’——即帮助人类去解决一些很难的问题,还有很长的路要走。另一方面,在模型竞争激烈的环境下,性能测试成为厂商展示自家模型最主要的营销手段,毕竟当前大模型的普及程度尚浅,且缺乏明确的应用场景,厂商很难通过实际应用来吸引用户,一个最直接的“得分”更能抓人眼球。这就是大模型的知识能力。首先,行业内存在“大模型测试泄露”的问题。

weixin_43769323的博客 518

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

弱智吧VS大模型,弱智吧让大模型变聪明了

为了保证数据质量以及多样性,本文从中国互联网内的优质网站和数据资源中手动选择了数据源。这些来源包括社区问答论坛、、内容创作平台、考试试题等。此外,该数据集还纳入了高质量的中文 NLP 数据集,以丰富任务的多样性。具体来说,本文将数据源分为四种类型:社交媒体和论坛、世界知识、NLP 任务和考试试题。社交媒体和论坛:包括知乎、SegmentFault 、豆瓣、小红书、弱智吧。世界知识:百科全书、四个特定领域的数据(医学、经济管理、电子学和农业)。

2401_84494441的博客 1875

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

弱智吧竟成最佳中文AI训练数据?!中科院等:8项测试第一,远超知乎豆瓣小红书...

梦晨 西风 发自 凹非寺量子位 | 公众号 QbitAI离大谱了,弱智吧登上正经AI论文,还成了最好的中文训练数据??具体来说,使用弱智吧数据训练的大模型,跑分超过百科、知乎、豆瓣、小红书等平台,甚至是研究团队精心挑选的数据集。在问答、头脑风暴、分类、生成、总结、提取等8项测试中取得最高分。没错,论文中的Ruozhiba就是指百度贴吧弱智吧,一个充满荒谬、离奇、不合常理发言的中文社区,画风通常是这...

量子位 1万+

不只是笑话,是智慧!Chumor数据探索AI幽默

摘要: 论文指出,目前幽默数据集和评估主要集中在英语上,缺乏对非英语语言(如中文)文化细微差别的幽默理解资源。为了填补这一空白,作者构建了Chumor数据集,该数据集来源于中国的“弱智吧”(RZB)。结论: Chumor数据集为非英语幽默研究和提高LLMs对不同文化背景推理能力的研究提供了促进。作者与机构: 来自密歇根大学、卡内基梅隆大学和上海交通大学的研究人员。结果: 人类解释显著优于LLMs生成的解释。

qq_59084968的博客 1080

Unsloth实战:基于弱智吧数据微调对话机器人

本文介绍了如何在星图GPU平台上自动化部署unsloth镜像,高效开展中文对话机器人微调任务。基于Llama3基础模型,结合弱智吧数据集进行LoRA微调,可快速构建具备贴吧风格表达能力的定制化聊天机器人,适用于智能客服、趣味交互等典型场景。

weixin_42518334的博客 962

真·人工智障!“弱智贴吧”竟被用来训练大模型

离了个大谱,弱智吧登上正经AI论文,还成了最好的中文训练数据?中国科学院、北京大学、中国科学技术大学、滑铁卢大学以及01.ai等十家知名机构联合推出了一款专注于中文的高质量指令调优数据集——COIG-CQIA。

IT大头的博客 1663

弱智吧竟成最佳中文AI训练数据?!中科院报告:8项测试第一,远超知乎豆瓣小红书...

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/扩散和多模态】微信交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!梦晨 西风 发自 凹非寺转载自:量子位(QbitAI)离大谱了,弱智吧登上正经AI论...

阿木寺的博客 819

国产ChatGPT大战弱智吧效果实测!网页端小程序均已上线,人人可玩

杨净 萧箫 发自 凹非寺量子位 | 公众号 QbitAI“中国版ChatGPT首发”,争得不可开交,热闹却一直没个结果——自ChatGPT发布以来,目前进展最快的国内产品也仅是开启了内测,不知道啥时候才能玩上。结果现在有读者跟我们爆料,一个中文版类ChatGPT产品已经悄然上线。不是预告、也不是开启小范围测试,而是直接人 人 可 用?!中国版ChatGPT这不就来了吗!听起来有些玄幻,不过我们点进...

量子位 2万+

弱智吧 is all you need!竟成最佳中文AI训练数据?!中科院等:8项测试第一,远超知乎豆瓣小红书...

Datawhale干货数据集:弱智吧,来源:量子位离大谱了,弱智吧登上正经AI论文,还成了最好的中文训练数据??数据集地址:https://github.com/Leymore/ruozhiba具体来说,使用弱智吧数据训练的大模型,跑分超过百科、知乎、豆瓣、小红书等平台,甚至是研究团队精心挑选的数据集。在问答、头脑风暴、分类、生成、总结、提取等8项测试中取得最高分。没错,论文中的Ruozhib...

Datawhale 4837
上一篇: SQL:记录状态
下一篇: 数据应用OneID:ID-Mapping Spark GraphX实现
大数据左右手
博客等级 码龄9年 475粉丝 116原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值