


数据结构与算法
文章目录
基本概念和术语
数据(Data)
是客观事物的符号表示,是所有能输入到计算机中并被计算机程序处理的符号的总称(集合)。是信息的载体;是对客观事物的符号化表示;可以被计算机识别、存储和加工。数据不仅仅包含整型、实型等数值类型,还包含图形、图像、声音、视频及动画等非数值类型对于整型、实型等数值类型,可以进行数值计算;对于字符数据类型,就需要进行非数值的处理。而声音、图像、视频等其实是可以通过编码的手段变成字符数据来处理的。
数据元素(DataElement)
是数据的基本单位,在计算机中通常作为一个整体进行考虑和处理。在有些情况下,数据元素也称为元素、记录、节点、顶点等。如前一节示例中的一名学生记录,树中棋盘的一个格局(状态),以及图中的一个顶点等。
数据项(Data Item)
是组成数据元素的、有独立含义的、不可分割的最小单位。例如,学生基本信息表中的学号、姓名、性别等都是数据项。
数据对象(DataObject)
是性质相同的数据元素的集合,是数据的一个子集。例如:整数数据对象是集合N={0, ±1,±2,…}, 字母字符数据对象是集合C={‘A’,‘B’, …‘Z’,‘a’,‘b’, …, ‘z’}, 学生基本信息表也可以是一个数据对象。由此可以看出,不论数据元素集合是无限集(如整数集),或是有限集(如字母字符集),还是由多个数据项组成的复合数据元素,只要集合内元素的性质均相同,都可称之为一个数据对象。
数据结构(Data Structure)
是相互之间存在一种或多种特定关系的数据元素的集合。换句话说,数据结构是带”结构"的数据元素的集合,“结构”就是指数据元素之间存在的关系。
逻辑结构
数据的逻辑结构是从逻辑关系上描述数据,它与数据的存储无关,是独立于计算机的。因此,数据的逻辑结构可以看作是从具体问题抽象出来的数学模型。数据的逻辑结构有两个要素:一是数据元素;二是关系。
物理结构
数据的逻辑结构在计算机中(内存)的存储形式。分为顺序存储结构、链式存储结构、索引存储结构、散列存储结构。
1.顺序存储结构
顺序存储结构是把数据元素存放在连续的存储单元里,数据元素之间的逻辑关系是通过数据元素的位置。
2.链式存储结构
用一组任意的存储单元存储数据元素(可能连续也可能不连续),数据元素之间的逻辑关系用指针来表示(用指针存放后继元素的存储地址)
3.索引存储结构
在存储节点信息的同时,还建立附加索引,索引表中的每一项称为一个索引项,索引项的一般形式是:(关键字,地址),关键字是能唯一标识一个结点的那些数据项。若每个结点在索引表中都有一个索引项,则该索引表称之为稠密索引(Dense Index)。若一组结点在索引表中只对应一个索引项,则该索引表称之为稀疏索引(Sparse Index)。
4.散列存储结构
根据结点的关键字直接计算出该节点的存储地址。
线性表
线性表的定义
由n(n≥O)个数据特性相同的元素构成的有限序列称为线性表。
线性表的特点
-
线性表中元素的个数n(n≥O)定义为线性表的长度,n=O时称为空表。
-
将非空的线性表(n>O)记作(a1,a2,a3,…,an)
-
这里的数据元素ai(1≤i≤n)只是个抽象的符号,其具体含义在不同情况下可以不同。
-
在非空的线性表,有且仅有一个开始结点a1,它没有直接前趋,而仅有一个直接后继a2;
-
有且仅有一个终端结点an,它没有直接后继,而仅有一个直接前趋an-1;
-
其余的内部结点ai,(2<i<n-1)都有且仅有一个直接前趋ai-1和一个直接后继ai+1
线性表的类型定义
抽象数据类型线性表定义
ADT List{
	数据对象
	数据关系
	基本操作
}ADT List
线性表的存储结构
在计算机内,线性表有两种基本的存储结构:顺序存储结构和链式存储结构
线性表的顺序表示和实现

顺序表中元素存储位置的计算

顺序表的特点


顺序表的顺序存储表示
数组静态分配:
#define LIST_INIT_SIZE 100 //线性表存储空间的初始分配量
typedef struct{
	ElemType elem[LIST_INIT_SIZE];
	int length;//当前长度
    int listSize;
}SqList;
数组动态分配:
typedef struct{
	ElemType *elem;
	int length;//当前长度
    int listSize;
}SqList;
SqList L;
L.elem = (ElemType*)malloc(sizeof(ElemType)*10);
需要加载头文件<stdlib.h>
#include <stdio.h>
#include <stdlib.h>
#define LIST_INIT_SIZE 100 //线性表存储空间的初始分配量
#define TRUE 1
#define FALSE 0
#define OK 1
#define ERROR 0
#define INFEASIBLE -1
#define OVERFLOW -2
typedef int Staus;
typedef char ElemType;
typedef struct{
	ElemType *elem;
	int length;//当前长度
	int listSize;
}SqList;
线性表的初始化
Staus InitList_Sq(SqList *L){
	L->elem = (ElemType*)malloc(sizeof(ElemType)*LIST_INIT_SIZE);
	if(!L->elem)
	exit(OVERFLOW);
	L->length = 0;
	L->listSize = LIST_INIT_SIZE;
	return OK;
}
清空线性表
void ClearList(SqList *L){
	L->length = 0;
}
销毁线性表
void DestroyList(SqList *L){
	if(L->elem)
	free(L->elem);
}
求顺序表的长度
int GetLength(SqList L){
	return L.length;
}
判断线性表是否为空
int IsEmpty(SqList L){
	if(L.length==0)
		return 1;
	return 0;
}
获取第i个元素的内容
int GetElem(SqList L,int i,ElemType *e){
	if(i < 1 || i > L.length)
	return ERROR;
	*e = L.elem[i-1];
	return OK;
}
顺序表的查找
int LocateElem(SqList L,ElemType e){
    //在线性表中查找值为e的数据元素,返回其序号(第几个)
	for(int i = 0;i < L.length;i++){
		if(L.elem[i] == e)
		return i+1
	}
	return 0;
}
算法分析:
找第一个元素只用找一次,第二个用两次,第三个需要三次…,找到次数与查找的元素有关,平均查找的次数:(1+2+3+…+n)/ n = (n+1)/ 2,称为平均查找长度ASL(Average Search Length),其时间复杂度为O(n)
顺序表的插入
算法思想:
- 判断插入位置i是否合法
- 判断顺序表的存储空间是否已满,若已满返回ERROR
- 将第N到第i位的元素依次向后移动一个位置,空出第i个位置
- 将要插入的新元素e放在第i个位置
- 表长加1,插入成功返回OK
可插入的位置:
最前、中间、最后
Status ListInsert_Sq(SqList *L,ElemType e){
	if(i < 1 || i > L->length+1)//i值不合法
	return ERROR;
	if(L->length==L->listSize)//存储空间已经满了
	return ERROR;
	for(int j = L->length-1;j >= i-1;j--){
		L->elem[j+1] = L->elem[j];//插入位置及之后的元素后移
	}
	L->elem[i-1] = e;//将新元素放在第i个位置
	L->length++;  //表长加1
	return OK;
}
算法分析:
如果插入在n+1的位置,需要移动0次,插入在i的位置,需要移动n-i+1次,如果插入在第一的位置,需要移动n次,即移动次数与插入位置之和为n+1,(0+n)*(n+1)/ 2是总次数,再除以(n+1)得到平均次数为n / 2
顺序表的删除
将表的第i个结点删除,使得长度为n的线性表变成长度为n-1的线性表
算法思想:
- 判断删除位置i是否合法(1<=i<=n)
- 将要删除的元素保存在e中
- 将第i+1个至第n位元素一次向前移动一个位置
- 表长减1,删除成功返回OK
Status ListDelete_Sq(SqList L,int i){
	if(i < 1 || i > L.length)//i值不合法
	return ERROR;
	for(int j = i;j <= L.length;j++){
	L.elem[j] = L.elem[j+1];//元素前移
	L.length--;//长度减一
	}
	return OK;
}
算法分析:
- 若删除尾结点,不用移动
- 若删除首结点,则表中n-1个元素全部迁移
- 若删除第i个结点,则要移动n-i结点
(0+n-1)* n / 2 为移动总结点,除以n,得到平均移动结点数位(n-1)/2
时间复杂度位O(n)
顺序表的优缺点
优点:
- 存储密度大(结点本身所占存储量/结点结构所占存储量)
- 可以随机存储表中任一元素
缺点:
- 在插入、删除某一元素时,需要移动大量元素
- 浪费存储空间
- 属于静态存储形式、数据元素的个数不能自由扩充
线性表的链式表示和实现

链式存储有关术语
结点:
数据元素的存储映像,由数据域和指针两部分组成。
链表:
n个结点由指针链组成一个链表。
单链表、双向链表、循环链表
结点只有一个指针域的链表称为单链表或线性链表

结点有两个指针域的链表称为双链表

首尾相接的链表叫循环链表

头指针:
指链表指向第一个结点的指针,若链表有头结点,则是指向头结点的指针;
头指针具有标识作用,所以常用头指针冠以链表的名字;
无论链表是否为空,头指针均不为空。头指针是链表的必要元素
头结点:
头结点是为了操作的统一和方便而设立的,放在第一元素的结点之前,其数据域一般无意义(也可存放链表的长度),有了头结点,对在第一元素结点前插入结点和删除第一结点,其操作与其它结点的操作就统一了,头结点不一定是链表必须要素。
首元结点:
是指链表中存储第一个数据元素a1的结点

有头结点的好处
-
有了头结点,对在第一元素结点前插入结点和删除第一结点,其操作与其它结点的操作就统一了
-
便于空表和非空表的统一处理
当链表不设头结点时,假设L为单链表的头指针,它应该指向首元结点,则当单链表为长度n为0的空表时,L指针为空(判定空表的条件可记为:LNULL)。增加头结点后,无论链表是否为空,头指针都是指向头结点的非空指针。头指针指向头结点。若为空表,则头结点的指针域为空(判定空表的条件可记为:L ->next NULL)
链表存储结构的两种形式

如何表示空表
无头结点:头指针为空
有头结点:头结点指针域为空
链式存储结构的特点
- 结点在存储器中的位置是任意的,即逻辑上相邻的数据元素在物理上不一定相邻
- 访问时只能通过头指针进入链表,并通过每个结点的指针域依次向后顺序扫描其余结点,所以寻找第一个结点和最后一个结点所花费的时间不等
单链表的定义和表示
typedef struct Lnode{//声明结点的类型和指向结点的指针类型
	ElemType data;//结点的数据域
	Lnode *next;//结点的指针域
}Lnode,*LinkList; //LinkList为指向结构体Lnode的指针类型
定义链表:
LinkList L;
定义结点指针p:
Lnode *p;
为了统一链表的操作,把所有的数据域定义成一个结构,再在链表结构顶一个一个该结构类型的变量。
单链表的初始化
算法步骤:
- 生成新结点作为头结点,用头指针L指向头结点
- 将头结点的指针域置空
bool InitList_L(LinkList L){
	L = (LinkList) malloc (sizeof(Lnode));
	L.next = NULL;
	return true;
}
判断链表是否为空
链表中无元素,称为空链表,头指针和头结点仍然在
只需要判断一下头结点指针域是否为空
bool ListEmpty(LinkList L){//若L为空表,返回ture,反之为false
	if(L->next)//非空
	return false;
	return true;
}
销毁单链表
从头指针开始依次释放所有结点
bool DestroyList(LinkList L) {
	Lnode *p;
	while(L) {
		p = L;
		L = L->next;
		free(p);
	}
	rerurn true;
}
清空单链表
链表仍然存在,但链表中无元素,称为空链表(头指针和头结点仍然存在)
思路:依次释放所有结点,并将头结点指针域设置为空
bool ClearList(LinkList L) {
	Lnode *p,*q;
	p = L->next;
	while(p) {
		q = p->next
		free(p);
		p = q;
	}
	L->next = NULL;//头结点指针域为空
	return true;
}
求链表的表长
思路:从首元结点开始,依次计数所有结点
int ListLength_L(LinkList L) {//返回L中数据元素个数
	LinkList p;
	p = L->next;//指向第一个结点
	int len = 0;
	while(p) {
		i++;
		p = p->next;
	}
	return len;
}
查找单链表中第i个元素
算法步骤:
- 从第一个结点(L->next)顺链扫描,用指针p指向当前扫描的结点,p初值:p = L->next
- j作计数器,累计当前扫描过的结点数,j初值为1
- 当p指向扫描到的下一个结点时,计数器j加一
- 当j==i时,p所指的结点就是要找的第i个结点
bool GetElem_L(LinkList L,int i,ElemType *e) {
	Lnode *p = L->next;//初始化
	int j = 1;
	while(p && j < i) {//向后扫描,直到p指向第i个元素或者p为空
		p = p->next;
		j++;
	}
	if(!p || j > i)//第i个元素不存在
		return false;
	*e = p->data;//取出第i个元素
	return true;
}
按值查找其位置
算法步骤:
- 从第一个结点起,依次和e相比较
- 如果找到一个其值和e相等的数据元素,则返回其在链表中的位置或地址
- 如果遍历整个链表都没有找到其值和e相等的元素,则返回0或则NULL
返回地址:
Lnode * LocateElem_L(LinkList L,ElemType e) {
	Lnode *p = L->next;
	while(p && p->data != e)
		p = p->next;
	return p;
}
返回位置序号:
int LocateElem_L(LinkList L,ElemType e) {
	Lnode *p = L->next;
    int i = 1;
	while(p && p->data != e) {
        p = p->next;
        i++;
    }
	if(p)
        return i;
    return 0;
}
算法分析:
因为线性链表只能顺序存取,即在查找时要从头指针找起,查找的时间复杂度为O(n)
在第i个结点前插入值为e的新结点
算法步骤:
- 首先找到ai-1的存储位置p
- 生成一个数据域为e的新结点s
- 插入新结点:
- 新结点的指针域指向结点ai
- 结点ai-1的指针域指向新结点
不可以先让ai-1的指针域先指向新结点后让新结点的指针域指向结点ai,会丢失ai的地址
bool ListInsert_L(LinkList L,int i,ElemType e) {
	Lnode *p = L;
	int j = 0;
	while(p && j < i - 1) {//寻找第i-1个结点,p指向i-1结点
		p = p->next;
		j++;
	}
	if(!p || j > i - 1)//i大于表长+1(用p是否为null判断)或者小于1(用j是否大于i-1判断),插入位置非法
		return false;
	Lnode *s = (Lnode*)mallo(sizeof(Lnode));//生成新结点s,将结点s的数据域置为e
	s->next = p->next;//将结点s插入L中
	p->next = s;
	return true;
}
删除第i个结点
算法步骤:
- 首先找到ai-1存储的位置p。保存要删除的ai的值
- 令p->next指向ai+1
- 释放结点ai的空间
bool ListDelete_L(LinkList L,int i,ElemType *e) {
	Lnode *p = L;
	Lnode *q = NULL;
	int j = 0;
	while(p->next && j < i - 1) {//找到第i-1个结点,让p指向它
		p = p->next;
		j++;
	}
	if(!(p->next) || j > i - 1)//需要删除的位置不合理大于表长或者小于1
		return false;
	q = p->next;//临时保存准备释放
	p->next = q->next;//改变i-1个结点的指针域
	*e = q->data;//保存删除结点的数据域
	free(q);//释放删除结点的空间
	return true;
}
插入和删除的算法分析
因为线性链表不需要移动元素,只需要修改指针,一般情况下时间复杂度为O(1)
但若要在但聊表进行前插和删除操作,要从头查找前驱结点,所耗时间复杂度为O(n)
头插法建立单链表
算法步骤:
- 从一个空表开始,重复读入数据
- 生成新结点,将读入数据存放到新结点的数据域中
- 从最后一一个结点开始,依次将各个结点插入到链表前端

void CreateList_H(LinkList L,int n) {
	L = malloc(sizeof(Lnode));
	L-next = NULL;//初始化
	for(int i = n;i > 0;i--) {
		Lnode *p = malloc(sizeof(Lnode));//生成新结点
		scanf("%d",p->data);//输入
		p-next = L-next;//插到表头
		L-next = p;
	}
时间复杂度:O(n)
尾插法建立单链表
算法步骤:
从一个空表L开始,将i虚拟节点逐个插入到链表尾部,尾指针r指向链表的尾结点
初始时,r同L均指向头结点。每读入一个数据元素则申请一个新结点,将新结点插入尾结点后,r指向新结点。
void CreateList_R(LinkList L,int n) {
	L = malloc(sizeof(Lnode));
	Lnode *r = L;//尾指针r指向头结点
	for(int i = 0;i < n;i++) {
		Lnode *p = malloc(sizeof(Lnode));//生成新结点,输入元素值
		scanf("%d",p->data);
		p-next = NULL;
		r->next = p;//插入到表尾
		r = p//指向新的尾结点
	}
}
时间复杂度:O(n)
循环链表
是一种头尾相接的链表,表中最后一个结点的指针域指向头结点,整个链表形成一个环。

注意:
由于循环链表中没有NULL指针,故涉及遍历操作时,其终止条件就不再像非循环链表那样判断p或者p->是否为空,而是判断它们是否等于头指针。
循环的条件:
由p != NULL 变成 p != L
p->next != NULL 变成 p->next != L
void ListLoop_L(LinkList L) {
	Lnode *p;
	p = L->next;//指向第一个结点
	while(p!=L) {
		printf("%d",p->data);
		p = p->next;
	}
}

我们在操作循环链表时,用尾指针更多。
带尾指针循环链表的合并

算法步骤
- 存取表头结点
- Tb表头连接到Ta表尾
- 释放Tb表头结点
- 修改指针
LinkList Connect(LinkList Ta,LinkList Tb) {//假设两个循环链表都是非空的
	Lnode *p = Ta->next;//存储表头结点
	Ta->next =  Tb->next->next;//Tb表头连接Ta表尾
	free(Tb->next);//释放Tb表头结点
	Tb->next = p; //修改指针
	return Tb;
}
双向链表

双向链表:在单链表的每个结点里面再增加一个指向其直接前驱的指针prior,这样链表中就形成了有两个方向不同的链。
结构定义
typedef struct DuLNode{
	Elemtype data;
	struct DuLNode *prior,*next;
}DuLNode,*DuLinkList;


对称性

p->prior->next = p = p->next->prior
在双向链表中有些操作如计算长度,获取元素,因只涉及一个方向的指针,故它们算法与线性链表的相同。但是在插入、删除时,则需同时修改两个方向上的指针,两者操作的时间复杂度均为O(n).
双向链表的插入

void ListInsert_DuL(DuLinkList L,int i,ElemType e) {
	DuLNode *p;
	if(!(P = GetElemP_DuL(L)))
		return ERROR;
	DuLNode *s = malloc(sizeof(DuLNode));
	s->data = e;
	s->prior = p->prior;//插入结点的前驱等于p的前驱
	p->prior->next = s;//插入结点前驱的后继为插入结点
	s->next = p;//插入结点的后继为p
	p->prior = s;//p的前驱为插入结点
}
一共修改了四个指针
双向链表的删除

void ListDelete_DuL(DuLinkList L,int i,ElemType *e) {
	DuLNode *p;
	if(!(P = GetElemP_DuL(L,i)))
		return ERROR;
	*e = p->data;
	p->prior->next = p->next;//删除结点的前驱的后继等于删除结点的后继
	p->next->prior = p->prior;//删除结点的后继的前驱等于删除结点的前驱
	free(p);//释放删除结点
}
知道删除哪一个时,时间复杂度为O(1).
需要查找时,时间复杂度为O(n).
所以该算法的时间复杂度为O(n).
双向循环链表
和单链的循环表类似,双向链表也可以有循环表
- 让头结点的前驱指针指向链表的最后一个结点
- 让最后一个结点的后继指针指向头结点


单链表、循环链表和双向链表的时间效率比较

顺序表和链表的比较
链式存储存储结构的优点:
- 结点空间可以动态申请和释放
- 数据元素的逻辑次序靠结点的指针来指示,插入和删除时不需要移动数据元素
链式存储结构的缺点:
- 存储密度小,每个结点的指针域需额外占用存储空间。当每个结点的数据域所占字节不多时,指针域所占存储空间的比重显得很大。
- 链式存储结构是非随机存取结构。对任一结点的操作都要从头指针依指针链查找到该结点,这增加了算法的复杂度。
存储密度是指结点数据本身所占的存储量和整个结点结构中所占的存储量之比,即:


应用
线性表的合并
假设利用两个线性表La和Lb分别表示两个集合A和B,现在要求一个新的集合A=AUB

算法步骤:
依次取出Lb中的每个元素,执行一下操作:
- 在La中查找该元素
- 如果找不到,则将其插入La的最后
void union(List La,List Lb) {
	int La_len = ListLength(La);
	int Lb_len = ListLength(Lb);
	for(int i = 1;i <= Lb_len;i++)	{
		ElemType e;
		GetElem(Lb,i,&e);
		if(!(LocateElem(La,e)))
			ListInsert(La,++La_len,e);
	}
}
*算法的时间复杂度是:O(ListLength(La)ListLength(Lb))
有序表的合并
已知线性表La和Lb中的数据元素按值非递减有序排列,现要求将La和Lbl归并为一个新的线性表Lc,且Lc中的数据元素仍按值非递减有序排列。

算法步骤:
- 创建一个空表Lc
- 依次从La或者Lb中摘取元素值较小的结点插入到Lc表的最后,直至其中一个表变空为止
- 继续将La或者Lb其中一个表的剩余结点插入到Lc表的最后
用顺序表实现
void MergeList_Sq(SqList La,SqList Lb,SqList *Lc) {
	ElemType *pa = La.elem;//指针pa和pb的初值分别指向两个表的第一个元素
	ElemType *pb = Lb.elem;
	Lc->length = La.length+Lb.length;//新表的长度为待合并两表的长度之和
	Lc->elem =  ElemType[Lc->length];//为合并后的新表分配一个数组空间
	ElemType *pc = Lc.elem;//pc指向新表的第一个元素
	ElemType *pa_last = La.elem+La.length-1;//指针pa_last指向La表的最后一个元素
	ElemType *pb_last = Lb.elem+Lb.length-1;//指针pb_last指向Lb表的最后一个元素
	while(pa <= pa_last && pb <= pb_last) {//两个表都非空
		if(*pa <= *pb)
			*pc++ = *pa++;
		else
			*pc++ = *pb++;
	}
	while(pa <= pa_last)//Lb表已经达到表尾,将La剩余元素加入Lc
		*pc++ = *pa++;
	while(pb <= pb_last)//Lb表已经达到表尾,将Lb剩余元素加入Lc
		*pc++ = *pb++;
}
算法的时间复杂度:O(ListLength(La)+ListLength(Lb))
算法的空间复杂度:O(ListLength(La)+ListLength(Lb))
用链表实现
void MergeList_L(LinkList La,LinkList Lb,LinkList Lc) {
	pa=La->next;
	pb=Lb->next;
	pc=Lc=La;//用la的头结点作为Lc的头结点
	while(pa && pb) {
		if(pa->data <= pb->data) {
			pc->next=pa;//后继连接较小的
			pc = pa;//pc指针始终指向最后一个
			pa = pa->next;//pa指针指向La的下一个结点
		}else{
			pc->next = pb;//后继连接较小的
			pc = pb;//pc始终指向最后一个
			pb = pb->next;//pb指向Lb的下一个结点
		}
		pc->next = pa?pa:pb;//插入剩余段
		free(Lb);//释放Lb的头结点
	}
}
算法的时间复杂度:O(ListLength(La)+ListLength(Lb))
算法的空间复杂度:O(1)
栈和队列
- 栈和队列是两种常用的、重要的数据结构
- 栈和队列是限定插入和删除只能在表的“端点”进行的线性表
- 栈后进先出(LIFO),在队尾即栈顶插入与删除
- 队列先进先出(FIFO),在队尾插入,在队头删除
栈
栈的顺序存储:顺序栈
栈的链式存储:链栈
顺序栈

top指针,指示栈顶元素在顺序栈中的位置
base指针,指示栈底元素在顺序栈中的位置
为了方便操作,通常top指示的是栈顶元素之上的下标地址
stacksize表示栈可以使用的最大容量
base==top是栈空的标志
top-base==stacksize则栈满
使用数组作为顺序栈存储方式的特点:
简单、方便、但容易溢出
上溢(overflow):栈已满,仍要压入元素
下溢(underflow):栈空,还要弹出元素
表示
#define MAXSIZE 100
typedef struct {
	SElemType *base;//栈底指针
	SElemType *top;//栈顶指针
    //也可以用int型变量作下标指向
	int stacksize;//栈可用的最大容量
}SqStack;
初始化
bool InitStack(SqStack *s) {
	s.base = (SElemType*)malloc(MAXSIZE*sizeof(SElemType));
	if(!S.base)
		exit(-1);//非0为异常退出
	s.top = s.base;//栈顶指针等于栈底指针
	s.stacksize = MAXSIZE;
	return true;
}
判断是否为空
bool StackEmpty(SqStack s) {
	if(s.top == s.base)
		return true;
	else
		return false;
}
求长度
int StackLength(SqStack s) {
	return s.top - s.base;
}
清空栈
bool ClearStack(SqStack *s){
	if(s->base)
		s->top = s->base;
	else
		return false;
	return true;
}
销毁
bool DestroyStack(SqStack *s) {
	if(s->base) {
		free(s->base);//顺序栈,首地址删除,则后面连续的空间也被free
		s.stacksize = 0;
		s->base = s->top = NULL;
	}
	return true;
}
入栈
算法步骤:
- 判断是否栈满,若满则出错(上溢)
- 元素e压入栈顶
- 栈顶指针加一
bool Push(SqStack *s,SElemType e) {
	if(s->top-s->base == s.stacksize)
	  return false;
	*top++ = e;
	return true;
}
出栈
算法步骤:
- 判断是否栈空,若空则出错(下溢)
- 获取栈顶元素e
- 栈顶指针减一
bool Pop(SqStack *s,SElemType *e) {
	if(s->top == s->base)//看栈是否为空
		return false;
	*e = --s->top;//栈顶指针减一并将值取出赋值给e
	return true;
}
链栈
链栈是运算受限的单链表,只能在链表头部进行操作
表示
#include <stdio.h>
#include <stdlib.h>
#define OK 1
#define ERROR 0
typedef int ElemType;
typedef struct StackNode {
	ElemType data;
	struct StackNode *next;
} StackNode;

- 链表的头指针就是栈顶
- 不需要头结点
- 基本不存在栈满的清空
- 空栈相当于头指针指向空
- 插入和删除仅在栈顶处执行
初始化
void InitStack(StackNode *top){
	top=(StackNode *)malloc(sizeof(StackNode));      //为top结点申请空间
	top->next=NULL;                              //top的指针域为空
}
判断是否为空
int isEmpty(StackNode *top)
{
	if(top->next==NULL)
		return OK;
	else
		return ERROR;
}
入栈
StackNode * Push(StackNode *top,ElemType x){
	StackNode *p;
	p=(StackNode *)malloc (sizeof(StackNode));   //申请新结点p
	p->data=x;                                  //x存储到p结点中
	p->next=top->next;                           //p指向栈顶结点
	top->next=p;                              //top结点指向p,p成为新的栈顶元素
	return(p);
}
出栈
StackNode *Pop(StackNode *top,ElemType *e){
	StackNode *p;
	if(top->next==NULL){         //判断栈是否为空
		printf("栈为空,无法出栈");
		return(top);
    }else{
		p=top->next;                //p指向栈顶,待删除
		top->next=p->next;         //top结点指针域跳过p,指向p的后继
		*e = p->data;
		free(p);                  //释放p占用的空间
		return(top);
    }
}
取栈顶元素
int getTop(StackNode *top,int *e)        //获读取栈顶元素
{
    if(top->next==NULL)              //栈为空,读取栈顶元素失败
 	{
        return ERROR;
    }
    else
    {
        *e = (top->next)->data;           //读取栈顶元素,不出栈
        return OK;
    }
}
栈与递归
若一个对象部分地包含它自己,或用它自己给自己定义,则称这令对象是递归的;
若一个过程直接地或间接地调用自己,则称这个过程是递归的过程。
以下三种情况常常用递归方法
- 递归定义的数学函教
- 具有递归特性的数据结构
- 可递归求解的问题
用分治法求解:
必备的三个条件
1.能将一个问题转变成一个新问题,而新问题与原问题的解法相同或类同,不同的仅是处理的对象,且这些处理对象是变化有规律的。
2.可以通过上述转化而使问题简化
3.必须有一个明确的递归出口,或称递归的边界
分治法一般形式:
void p(参数表) {
	if(递归结束条件)
		可直接求解的步骤
	else
		p(较小的参数);
}
当多个函数构成嵌套调用时:
int main(void) {
	...
	y = fact(3);
	...
}
double fact(int n) {
	...
	z = mypow(3.5,2);
	...
}
double mypow(double x,int n) {
	...
}
将递归转换成非递归:
- 尾递归、单项递归——>循环结构
- 自用栈模拟系统的运行时栈
队列
顺序队列
表示
#defind MAXQSIZE 100
Typedef struct {
	QElemType *base;//初始化的动态分配存储空间
	int front;//头指针
	int rear; //尾指针
}SqQueue;

当rear=MAXQSIZE时,发生溢出
如何解决假的上溢?
如果将队中元素依次向队头方向移动太浪费时间
我们可以使用循环队列,base[0]接在base[MAXQSIZE-1]之后,若rear+1==MAXQSIZE,则令rear=0;
实现方法:利用模(mod,%)运算
插入元素
Q.base[Q.rear] = x;
Q.rear = (Q.rear+1)%MAXQSIZE;
删除元素
x = Q.base[s.front];
Q.front = (Q.front+1)%MAXQSIZE;
队空时:

队满时:

无论是队空还是队满,都是front==rear
解决方案:
- 另外设置一个标志区别队空和队满
- 另外设置一个变量,记录元素的个数
- 少用一个元素空间
对于少用一个元素空间:
队空:ront==rear
队满:(rear+1)%MAXQSIZE==front

初始化
bool InitQueue(SqQueue *Q) {
	Q->base = (QElemType*)malloc(MAXQSIZE*sizeof(QElemType));
	if(!Q.base)//存储分配失败
		exit(-1);
	Q.front = Q.rear = 0;//头指针尾指针置为0,队列为空
	return true;
}
队列长度
int QueueLength(SqQueue Q) {
	return ((Q.rear-Q.front+MAXQSIZE)%MAXQSIZE);
}
入队
bool EnQueue(SqQueue *Q,QElemType e) {
	if((Q->rear+1)%MAXQSIZE==Q->front)//队满
		return false;
	Q->base[Q->rear] = e;//新元素加入队尾
	Q->rear = (Q->rear+1)%MAXQSIZE;//队尾指针+1
	return true;
}
出队
bool DeQueue(SqQueue *Q,QElemType *e) {
	if(Q->rear==Q->front)//队空
		return false;
	*e = Q->base[Q->front];//保存队头元素
	Q->front = (Q->front+1)%MAXQSIZE;//队头指针+1
	return true;
}
取队头元素
SElemType GetHead(SqQueue Q) {
	if(Q.front != Q.rear)//队列不为空
		return Q.base[Q.front];//返回对头指针元素的值,对头指针不变
}
链队
若用户无法估计所用队列的长度,则宜采用链队列
定义
typedef strcut Qnode {
	QElemType data;
	Struct Qnode *next;
}QNode,*QueuePtr;

typedef struct {
	QueuePtr front;//队头指针
	QueuePtr rear;//队尾指针
} LinkQueue;
初始化

bool InitQueue(LinkQueue *Q) {
	Q->front = Q->rear = (QueuePtr)malloc(sizeof(QNode));
	if(!Q->front)
		exit(-1);
	Q->front->next = NULL;
	return true;
}
是否为空
bool QueueEmpty(LinkQueue q){
	if(q.front == NULL && q.rear == NULL)
		return true;
	return false;
}
销毁

bool DestroyQueue(LinkQueue *Q) {
	QueuePtr p;
	while(Q->front) {
		p = Q->front->next;
		free(Q->front);
		Q->front = p;
	}
	return true;
}
入队
bool EnQueue(LinkQueue *Q,QElemType e){
	QueuePtr p = (QueuePtr)malloc(sizeof(QNode));
	if(!p)
		exit(-1);
	p->data = e;//将新元素赋值给p
	p->next = NULL;
	Q->rear->next = p;//让之前的最后一个结点的next指向p
	Q->rear = p;//尾指针指向p
	return true;
}
出队
bool DeQueue(LinkQueue *Q,QElemType *e) {
	if(Q->front == Q->rear)//空队列
		return false;
	QueuePtr p = Q->front->next;//让p指向头结点的下一个
	*e = p->data;
	Q->front->next = p->next;//头指针指向要删除元素的下一个
	if(Q->rear == p)//如果尾指针所指元素与要删除元素相同
		Q->rear = Q->front;//让尾指针和头指针一样指向头结点
	free(p);
	return true;
}
求头元素
bool GetHead(LinkQueue Q,QElemType *e) {
	if(Q.frond == Q.rear)
		return false;
	*e = Q.front->next->data;
	return true;
}
树和二叉树
定义
树(Tree)是n (n≥0)个结点的有限集。
若n = 0,称为空树;
若n >0,则它满足如下两个条件:
(1)有且仅有一个特定的称为根(Root)的结点;
(2)其余结点可分为m (m≥0)个互不相交的有限集T1,T2,T3,…,Tm,其中 每一个集合本身又是一棵树,并称为根的子树(SubTree)。

树是n个结点的有限集,显然,树的定义是一个递归的定义。
基本术语

结点的祖先:从根到该结点所经分支上的所有结点
结点的子孙:以某结点为根的子树中的任一结点。
有序树:树中结点的各子树从左到右有次序,更换次序就不是同一棵树。
无序树:树中结点的各子树无次序
叶子:一棵树当中没有子结点(即度为0)的结点称为叶子结点
森林:是m(m>0)棵互不相交的树的集合
只要把根节点删除,树就变成了森林,树一定是森林,森林不一定是树。
线性结构是一对一的,而树是一对多
二叉树
二叉树结构最简单,规律性最强,所有树都能转为唯一对应的二叉树,不失一般性,普通树若不转化为二叉树,则运算很难实现。
定义
二叉树是n(之0)个结点的有限集,它或者是空集(n = 0),或者由一个根结点及两棵互不相交的分别称作这个根的左子树和右子树的二叉树组成。
特点
1.每个结点最多有俩孩子(二叉树中不存在度大于2的结点)。
2.子树有左右之分,其次序不能颠倒。
3.二叉树可以是空集合,根可以有空的左子树或空的右子树。
二叉树不是树的特殊情况,它们是两个概念。
二叉树结点的子树要区分左子树和右子树,即使只有一棵子树也要进行区分,说明是左子树还是右子树,树当只有一个孩子时,就无序区分是左还是右,二者是不同的,这是二叉树和树的最主要差别。
具有3个结点的二叉树可能有几种不同形态?普通树呢?
二叉树有五种:

树有两种:

性质
在二叉树的第i层上至多有2^i-1个结点(i>1)
第i层至少有1个结点
深度为k的二叉树至多有(2^k) -1个结点(k ≥1)。
深度为k时至少有k个结点?
对任何一棵二叉树T,如果其叶子数为no,度为2的结点数为n2,则no = n2+ 1。
满二叉树
—棵深度为k且有(2^k)-1个结点的二叉树。

特点
- 每一层上的结点数都是最大结点数,都是满的
- 叶子结点都在最底层
- 对满二叉树结点位置编号,从根节点开始,自上而下,自左而右
- 每一结点位置都有元素
完全二叉树
深度为k 的具有n个结点的二叉树,当且仅当其每一个结点都与深度为k的满二叉树中编号为1~n的结点——对应时,称之为完全二叉树。

在满二叉树中,从最后一个结点开始,连续去掉任意个结点,即是一棵完全二叉树
特点
- 叶子只可能分布在层次最大的两层上。
- 对任一结点,如果其右子树的最大层次为i,则其左子树的最大层次必为i或者i+1.
讲完两种特殊的二叉树,继续讲性质。
具有n个节点的完全二叉树的深度为 └log2n┘+ 1

表明了完全二叉树结点数n与完全二叉树深度k之间的关系
如果对一颗有n个节点的完全二叉树(其深度为└log2n┘+1)的节点按层序
编号,对于任意节点i有:
- 如果i=1,则节点i是二叉树的根节点,无双亲;如果i>1,则其双亲节点是└i/2┘
- 如果2i>n,则节点i无左孩子;否则其左孩子就是2i
- 如果2i+1>n,则节点i无有右孩子;否则其右孩子就是2i+1
存储结构
顺序存储
#defind MAXSIZE 100
typedef TElemType SqBiTree[MAXTSIZE];
SqBiTree bt;
按满二叉树的结点层次编号,依次存放二叉树中的数据元素


特点:
结点间关系蕴含在其存储位置中,浪费空间,适于存满二叉树和完全二叉树。
链式存储
二叉链表
typedef struct BiNode{
	TElemType data;
	struct BiNode *lchild,*rchild;//左右孩子指针
}BiNode,*BiTree;


在n个结点的二叉链表中,有n+1个空指针域
n个结点,则有2n个链域,每个结点有且只有一个双亲,根节点没有双亲,则只会有n-1个结点的链域存放指针,指向非空的子女结点。
空指针数目=2n-(n-1)= n+1
三叉链表
typedef struct TriTNode{
	TElemType data;
	struct BiNode *lchild,*rchild,*parent;//左右孩子指针,双亲指针
}TriNode,*TriTree;
在二叉链表的基础上增加了一个指向双亲的指针域。

遍历
顺着某一条搜索路径巡访二叉树中的结点,使得每个结点均被访问一次,而且仅被访问一次(又称周游)。
目的:得到树种所有结点的一个线性排列
用途:是树结构插入、删除、修改、查找、排序运算的前提,是二叉树一切运算的基础和核心。
若规定先左后右,则只有前三种情况:
DLR——先(根)序遍历,LDR——中(根)序遍历,
LRD——后(根)序遍历。

先序

先访问根节点A,输出A,然后访问左孩子B,输出B,访问B的左孩子E,输出E,E的左孩子为空,访问E的右孩子L,输出L,A的左子树访问完毕,访问A的右孩子D,输出D,访问D的左孩子H,输出H,访问H的左孩子M,输出M,M的左右孩子为空,访问H的右孩子I,输出I,D的左子树访问完毕,访问D的右孩子J,输出J,J的左右孩子为空,访问完毕。
遍历顺序为:ABELDHMIJ
非递归算法:
基本思想:
- 当根节点非空时,申请一个数据栈,并把根节点压入栈中;
- 从栈中弹出,记录该结点,并打印该结点的值;
- 如果该节点的右孩子不为空,则将其压入栈中;
- 如果该节点的左孩子也不为空,则也将其压入栈中;
- 然后重新判断栈是否为空,重复2-4中的步骤,直至栈为空。
此算法很消耗内存,因为同时存左右子树:
bool PreOrderTraverse(BiTree T) {
	BiTree p;
	BiTree q;
	LinkStack s;
	InitStack(s);
	p = T;
	if(T == NULL)
		return true;
	Push(s,p);//将头结点压入栈
	while(!StackEmpty(s)) {//当栈不为空循环
		Pop(s,p);//让栈顶元素出栈
		printf("%c",p->data);
		if(p->rchild) {//结点右孩子不为空压入栈
			Push(s,p->rchild);
		}
		if(p->lchild) {//结点左孩子不为空压入栈
			Push(s,p->lchild);
		}
	}
	return true;
}
修改:
void PreorderTraversal( BiTree T )
{
    BiTree T = BT;
    LinkStack s;//创建堆栈
    InitStack(s);
    while (T || !IsEmpty(S))//当树不空或者堆栈不空时
    {
        while (T)//一直访问左子树
        {
            Push(S,T);//入栈
            printf(" %c",T->data);//访问数据
            T = T->lchild;
        }
        if (!StackEmpty(s))//左子树遍历完后
        {
            Pop(s,T);//出栈
            T = T->Right;//转为访问右子树
        }
    }
}
递归算法:
bool PreOrderTraverse(BiTree T) {
	if(T == NULL)
		return true;
	else{
		visit(T);//访问根节点
		PreOrderTraverse(T->lchild);//递归遍历左子树
		PreOrderTraverse(T->rchild);//递归遍历右子树
	}
    return true;
}
中序
先经过左树的B,接着经过B的左孩子E,E的左孩子为空,输出E,经过E的右孩子L,输出L,B的左树输出完毕,接着输出B,B的右孩子为空,输出A,经过A的右孩子D,经过D的左孩子H,经过H的左孩子M,M的左孩子为空,输出M,M的右孩子为空,输出H,经过H的右孩子I,I的左孩子为空,输出I,I的右孩子为空,输出D,经过D的右孩子J,J的左孩子为空,输出J,J的右孩子为空,输出完毕。
遍历顺序为:ELBAMHIDJ
非递归算法:
基本思想:
- 建立一个栈
- 根结点进栈,遍历左子树
- 根结点出栈,输出根节点,遍历右子树
bool InorderTraversal(BiTree T) {
	BiTree p;
	BiTree q;
	LinkStack s;
	InitStack(s);
	p = T;
	while(p || !StackEmpty(s)) {
		if(p) {
			Push(s,p);
			p = p->lchild;
			//让根节点入栈,访问左孩子
		}else{
			//当该结点的左孩子为空,将该结点出栈,并输出数据
			Pop(s,q);
			printf("%c",q->data);
			p = q->rchild;//让p指向结点的右孩子
		}
	}
	return true;
}
修改:
void InorderTraversal( BiTree BT )
{
    BiTree T = BT;
   	LinkStack s;
	InitStack(s);//创建堆栈
    while (T || !IsEmpty(S))//当树不空或者堆栈不空时
    {
        while (T)//一直访问左子树
        {
            Push(S,T);//入栈
            T = T->Left;
        }
        if (!StackEmpty(s))//左子树遍历完后
        {
            Pop(s,T);//出栈
            printf(" %c",T->Data);//访问数据
            T = T->Right;//转为访问右子树
        }
    }
}
递归算法:
bool InorderTraversal(BiTree T) {
	if(T == NULL)
		return true;
	else{
		InOrderTraverse(T->lchild);//递归遍历左子树
		visit(T);//访问根节点
		InOrderTraverse(T->rchild);//递归遍历右子树
	}
	return true;
}
后序
先经过左树的B,经过B的左孩子E,E的左孩子为空,经过E的右孩子L,L的左孩子为空,L的右孩子为空,输出L,输出E,输出B,左树访问完毕,经过右树的D,经过D的左孩子H,经过H的左孩子M,M的左孩子为空,右孩子为空,输出M,经过H的右孩子,I的左孩子右孩子为空,输出I,输出H,经过D的右孩子,J的左右 孩子为空,输出J,输出D,访问完毕。
遍历顺序为:LEBMIHJDA
非递归算法:
基本思想:
- 当根节点非空时,申请两个数据栈s1,s2,并把根节点压入栈s1中;
- 从栈s1中弹出,依次将该结点的左孩子和右孩子压入s1,这样在压入s2的时候就是先左后右了。
- 将该结点压入s2
- 然后重新判断栈s1是否为空,重复2-3中的步骤,直至栈为空。
- 从s2中依次弹出结点并打印
此算法同样耗内存,同时看左右子树
bool PostOrderTraverse(BiTree T) {
	BiTree p;
	BiTree q;
	LinkStack s1,s2;
	InitStack(s1);
	InitStack(s2);
	p = T;
	if(T == NULL)
		return true;
	Push(s1,p);//将头结点压入栈
	while(!StackEmpty(s1)) {//当栈不为空循环
        p = Pop(s1);//让栈顶元素出栈
        if(p->lchild) {//结点左孩子不为空压入栈
			Push(s1,p->lchild);
		}
        if(p->rchild) {//结点右孩子不为空压入栈
			Push(s1,p->rchild);
		}
        Push(s2,p);
	}
	while(!StackEmpty(s2)) {
		Pop(s2,p);//让栈顶元素出栈
		printf("%c",p->data);
	}
	return true;
}
修改:
这种方法要在结点加多一个flag来判断是第几次入栈
void PostorderTraversal( BiTree BT )
{
    /*左 右 根*/
    BinTree T = BT;
    LinkStack s;
	InitStack(s);//创建堆栈
    while (T || !IsEmpty(S))//当树不空或者堆栈不空时
    {
        while (T)//一直访问左子树
        {
            Push(S,T);//入栈
            T->flag = 1;//第一次入栈
            T = T->Left;
        }
        if (!IsEmpty(S))//左子树遍历完后
        {
            T = Pop(S);//出栈
            if(T->flag == 1)//如果第一次入栈,右节点入栈
            {
                Push(S,T);//入栈
                T->flag = 2;//意味两次入栈
                T = T->Right;//转为访问右子树
            }
           else
            {

                printf(" %c",T->data);//访问数据
                T = NULL;
            }

        }
    }
}
递归算法:
bool PostOrderTraverse(BiTree T) {
	if(T == NULL)
		return true;
	else{
		PostOrderTraverse(T->lchild);//递归遍历左子树
		PostOrderTraverse(T->rchild);//递归遍历右子树
		visit(T);//访问根节点
	}
	return true;
}
遍历递归算法
时间效率:O(n)
空间效率:O(n)

从虚线的出发点到重点的路径上,每个结点经过了三次:第1次经过时访问为先序遍历;第2次经过时访问为中序遍历;第3次经过时访问为后序遍历。
若二叉树中各结点的值均不相同,则二叉树结点的线序序列、中序序列、后序序列都是唯一的。
由二叉树的先序序列和中序序列,或由二叉树的后序序列和中序序列可以确定唯一一棵二叉树。
层次遍历
从根节点开始,从上到下、从左到右的顺序访问每一个节点,也就是一层层的访问,每个结点仅仅只访问一次。
基本思想:
使用一个队列
从根节点进队
队不空时循环:
从队列中出列一个结点*p,访问它
- 若它有左孩子结点,将左孩子结点进队
- 若它有右孩子结点,将右孩子结点进队
void LevelOrd(BTNode *b) {
	BTNode *p = b;
	SqQueue *qu;
	InitQueue(qu);//初始化队列
	enQueue(qu,b);//从根节点指针进入队列
	while(!QueueEmpty(qu)) { //队不为空,则循环
		deQueue(qu,p);//出队结点p
		printf("%c",p->data);
		if(p->lchild!=NULL)
			enQueue(qu,p->lchild);//有左孩子进队
		if(p->rchild!=NULL)
			enQueue(qu,p->rchild);//有右孩子进队
	}
}
建立
(1)从键盘输入二叉树的结点信息,建立二叉树的存储结构,用#表示空结点
(2)在建立二叉树的过程中按照二叉树先序方式建立;
先序建立


bool CreateBiTree(BiTree T) {
	char ch;
	scanf("%c",&ch);
	if(ch == '#')
		T = NULL;
	else{
		if(!(T = (BiTNode*)malloc(sizeof(BiTNode))))
			exit(-1);
		T->data = ch;//生成根节点
	}
	CreateBiTree(T->lchild);//构造左子树
	CreateBiTree(T->rchild);//构造右子树
	return true;
}
复制
如果是空树,递归结束;
否则,申请新结点空间,复制根结点,
递归复制左子树,
递归复制右子树。
int Copy(BiTree T,BiTree NewT) {
	if(T == Null) {
		NewT = NULL;
		return 0;//空树返回0
	}else{
		NewT = (BiTree)malloc(sizeof(BiTree));
        NewT->data = T->data;
		Copy(T->lchild,NewT->lchild);
		Copy(T->rchild,NewT->rchild);
	}
	return 1;
}
计算深度
如果是空树,则深度为0;否则,递归计算左子树的深度记为m,递归计算右子树的深度记为n,二叉树的深度则为m与的较大者加1。
int Depth(BiTree T) {
	if(T == NULL)
		return 0;//空树返回0
	else{
        int m = 0;
        int n = 0;
		m = Depth(T->lchild);
		n = Depth(T->rchild);
		if(m > n)
			return m+1;
		else
			return n+1;
	}
}
计算结点总数
如果是空树,则结点个数为0;否则,结点个数为左子树的结点个数+右子树的结点个数再+1。
int NodeCount(BiTree T) {
	if(T == NULL)
		return 0;
	else
		return NodeCount(T->lchild)+NodeCount(T->rchild)+1;
}
计算二叉树叶子结点树
如果是空树,则叶子结点个数为0;否则,为左子树的叶子结点个数+右子树的叶子结点个数。
int LeafCount(BiTree T) {
	if(T == NULL)
		return 0;
	if(T->lchild == NULL && T->rchild == NULL)
		return 1;//如果是叶子结点返回1
	else
		return LeafCount(T->lchild)+LeafCount(T->rchild);
}
线索二叉树
利用二叉链表中的空指针域:如果某个结点的左孩子为空,则将空的左孩子指针域改为指向其前驱;如果某结点的右孩子为空,则将空的右孩子指针域改为指向其后继,这种改变指向的指针称为‘线索’,加上了线索的二叉树称为线索二叉树。
对二叉树按某种遍历次序使其变成线索二叉树的过程线索化
前驱和后继是指遍历次序的前后,如AEVDGF是某一遍历次序,则E的前驱是A,E的后继是V。
为了区分lchild和rchild指针到底是指向孩子的指针还是指向前驱或者后继的指针,对二叉链表中每个结点增设两个标志域ltag和rtag,并约定:
- ltag = 0,lchild指向该结点的左孩子
- ltag = 1,lchild指向该结点的前驱
- rtag = 0, rchild 指向该结点的右孩子
- rtag = 1, rchild指向该结点的后继

typedef struct BiThrNode {
	Elemtype data;
	int ltag,rtag;
	BiThrNode *lchild,*rchild;
}BiThrNode,*BiThrTree;


我们还可以改造以下,增设一个头结点,ltag=0, lchild指向根结点,
rtag=1, rchild指向遍历序列中最后一个结点遍历序列中第一个结点的lc域和最后一个结点的rc域都指向头结点

树和森林
树的存储结构
双亲表示法
实现:定义结构数组存放树的结点,每个结点含两个域:
数据域:存放结点本身信息。
双亲域:指示本结点的双亲结点在数组中的位置。
特点:找双亲容易,找孩子难。

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-XBkTaWXK-1642992057068)(https://img01.sogoucdn.com/app/a/100520146/F4348983789498F070675399C423DD79)]
描述:
typedef struct PTNode {
TElemType data;
int parent;//双亲位置域
}PTNode;
树结构:
#define MAX_TREE_SIZE 100
typedef struct {
PTNode nodes[MAX_TREE_SIZE];
int r,n;//根结点的位置和结点个数
}PTree;
孩子链表
把每个结点的孩子结点排列起来,看成是一个线性表,用单链表存则n个结点有n个孩子链表(叶子的孩子链表为空表)。而n个头指针又组成一个线性表,用顺序表(含n个元素的结构数组)存储。
特点:找孩子容易找双亲困难。


typedef struct CTNode {
intchild;
struct CTNode *next;
} *ChildPtr;

typedef struct {
TElemTypedata;
ChildPtr firstchild;//孩子链表头指针
}CTBox;
树结构:
typedef struct {
CTBox nodes[MAX_TREE_SIZE];
int n,r;//结点数和根结点的位置
}CTree;
当在孩子链表中再增加一个成员为双亲的下标,则这样找双亲也更加容易,呗称为带双亲的孩子链表。
孩子兄弟表示法
又叫二叉树表示法,二叉链表表示法
实现:用二叉链表作树的存储结构,链表中每个结点的两个指针域分别指向其第一个孩子结点和下一个兄弟结点
typedef struct CSNode{
ElemType data;
struct CSNode *firstchild,*nextsibling;
}CSNode,*CSTree;

树与二叉树的转换

①加线:在兄弟之间加一连线
②抹线:对每个结点,除了其左孩子外,去除其与其余孩子之间的关系
③旋转:以树的根结点为轴心,将整树顺时针转45°
兄弟相连留长子
例子:

二叉树转换成树
①加线:若p结点是双亲结点的左孩子,则将p的右孩子,右孩子的右孩子…沿分支找到的所有右孩子,都与p的双亲用线连起来
②抹线:抹掉原二叉树中双亲与右孩子之间的连线
③调整:将结点按层次排列,形成树结构
左孩右右连双亲,去掉原来右孩线。
森林转换成二叉树
①将各棵树分别转换成二叉树
②将每棵树的根结点用线相连
③以第一棵树根结点为二叉树的根,再以根结点为轴心,顺时针旋转,构成二叉树型结构

树变二叉根相连
二叉树转换成森林
①抹线:将二叉树中根结点与其右孩子连线,及沿右分支搜索到的所有右孩子间连线全部抹掉,使之变成孤立的二叉树
②还原:将孤立的二叉树还原成树
去掉全部右孩线,孤立二叉再还原

树的遍历
先根(次序)遍历:
若树不空,则先访问根结点,然后依次先根遍历各棵子树。
后根(次序)遍历:
若树不空,则先依次后根遍历各棵子树,然后访问根结点。
按层次遍历:
若树不空,则自上而下自左至右访问树中每个结点。

森林的遍历
将森林看作由三部分构成:
1、森林中第一棵树的根结点;
2.森林中第一棵树的子树森林;
3.森林中其它树构成的森林。
先序遍历
若森林不空,则
1.访问森林中第一棵树的银结点;
2.(先序遍历森林中第一棵树的子树森林;
3.先序遍历森林中(除第一棵树之外)其余树构成的森林。
即:依次从左至右对森林中的每一棵树进行先根遍历。
中序遍历
若森林不空,则
1.中序遍历森林中第一棵树的子树森林;
2 .访问森林中第一棵树的根结点;
3.中序遍历森林中(除第一棵树之外)其余树构成的森林。
即:依次从左至右对森林中的每一棵树进行后根遍历。

哈夫曼树
基本概念
路径:从树中一个结点到另一个结点之间的分支构成这两个结点间的路径。
结点的路径长度:两结点间路径上的分支数。

树的路径长度:从树根到每一个结点的路径长度之和。记作:TL

结点数目相同的二叉树中,完全二叉树是路径长度最短的二叉树。
权(weight):将树中结点赋给一个有着某种含义的数值,则这个数值称为该结点的权。
结点的带权路径长度:从根结点到该结点之间的路径长度与该结点的权的乘积。
树的带权路径长度:树中所有叶子结点的带权路径长度之和。
哈夫曼树:最优树,带权路径长度(WPL)最短的树
“带权路径长度最短”是在“度相同”的树中比较而得的结果,因此有最优二叉树、最优三叉树之称等等。
构造算法
哈夫曼算法
(1)根据n个给定的权值{W, W,…W}构成n棵二叉树的森林
F={ T1,T2…,T,其中T只有一个带权为wi;的根结点.
构造森林全是根
(2)在F中选取两棵根结点的权值最小的树作为左右子树,构造一棵新的二叉树,且设置新的二叉树的根结点的权值为其左右子树上根结点的权值之和。
选用两小造新树
(3)在F中删除这两棵树,同时将新得到的二叉树加入森林中。·删除两小添新人
(4)重复(2)和(3),直到森林中只有一棵树为止,这棵树即为哈夫曼树。
重复2、3剩单根
1、构造森林全是根;
2、选用两小造新树;
3、删除两小添新人;
4、重复2、3剩单根。

哈夫曼树的结点的度数为О或2,没有度为1的结点。
包含n棵树的森林要经过n-1次合并才能形成哈夫曼树,共产生n-1个新结点
包含n个叶子结点的哈夫曼树中共有2n- 1个结点。
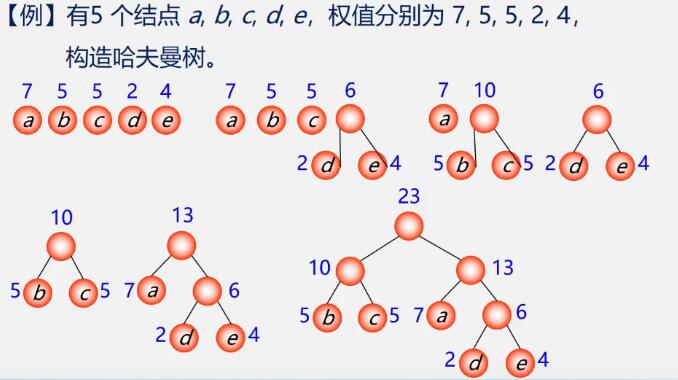
总结:
1.在哈夫曼算法中,初始时有n棵二叉树,要经过n-1次合并最终形成哈夫曼树。
2.经过n-1次合并产生n-1个新结点,且这n-1个新结点都是具有两个孩子的分支结点。可见:哈夫曼树中共有n+n-1 2n-1个结点,且其所有的分支结点的度均不为1。
算法实现
顺序存储结构
采用顺序存储结构:一维结构数组
结点类型定义:
typedef struct {
	int weight;
	int parent,lch,rch;
}HTNode,*HuffmanTree;
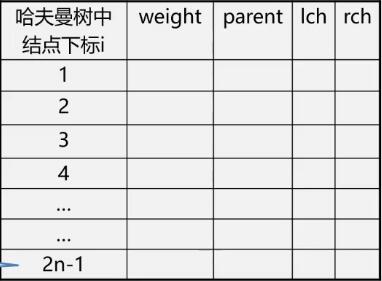
哈夫曼树中共有2n-1个结点不使用0下标,数组大小为2n
1.初始化HT [1…2n-1]: lch=rch=parent=O;
2.输入初始n个叶子结点:置HT[1…n]的weight值;
3.进行以下n-1次合并,依次产生n-1个结点HT[i],i=n+1…2n-1:
a)在HT[1…i-1]中选两个未被选过(从parent == 0的结点中选)的weight最小的两个结点HT[s1]和HT[s2], s1、s2为两个最小结点下标;
b)修改HT[s1]和HT[s2]的parent值: HT[s1].parent=i;HT[s2].parent=i;
c)修改新产生的HT[i]:
HT[i].weight=HT[s1].weight + HT[s2].weight;
HT[i]. lch=s1; HT[i].rch=s2;
void Select(HuffmanTree HT, int i,int *s1,int *s2){
	int j;
	*s1 = 0;
	*s2 = 0;
	for (j = 1; j <= i; j++){
		if (HT[j].parent == 0&&HT[*s1].weight > HT[j].weight){
			*s2 = *s1;
			*s1 = j;
		}else if (HT[j].parent == 0&&HT[*s2].weight > HT[j].weight)
				*s2 = j;
	}
}
void CreatHuffmanTree(Huffmantree HT,int n){
	if(n <= 1)
		return;
	int m = 2*n-1;//数组一共2n-1个元素
	HTNode *HT = (HTNode*)malloc(sizeof(HTNode*(m+1)));//0的位置不用,HT[m]表示根节点
	for(int i = 1;i <=m;i++){//将2n-1个元素的lch、rch、parent置为0
		HT[i].lch = 0;
		HT[i].rch = 0;
		HT[i].parent=0;
	}
	for(int i = 1;i<=n;i++){
		scanf("%d",&HT[i].weight);//输入前n个元素的权值
	}
	for(int i  = n+1;i <= m;i++){//合并产生n-1个结点
	 	int s1,s2;
		Select(HT,i-1,&s1,&s2);//在HT[k](1≤k≤i-1)中选择两个其双亲域为0,
							   //且权值最小的结点并返回他们在HT中的序号
 		HT[s1].parent=i;
 		HT[s2].parent=i;
 		HT[i].lch=s1;
 		HT[i].lch=s2;//s1,s2作为i的左右孩子
		HT[i].weight=HT[s1].weight+HT[s2].weight;//i的权值为左右权值之和
	}
}
哈夫曼编码
若将编码设计为长度不等的二进制编码,即让待传字符串中出现次数较多的字符采用尽可能短的编码,则转换的二进制字符串便可能减少。
关键:要设计长度不等的编码,则必须使任一字符的编码都不是另一个字符的编码的前缀,称为前缀编码。
1.统计字符集中每个字符在电文中出现的平均概率}(概率越大,要求编码越短)。
2.利用哈夫曼树的特点:权越大的叶子离根越近;将每个字符的概率值作为权值,构造哈夫曼树。则概率越大的结点,路径越短。
3、在哈夫曼树的每个分支上标上O或1:
结点的左分支标0,右分支标1
把从根到每个叶子的路径上的标号连接起来,作为该叶子代表的字符的编码。
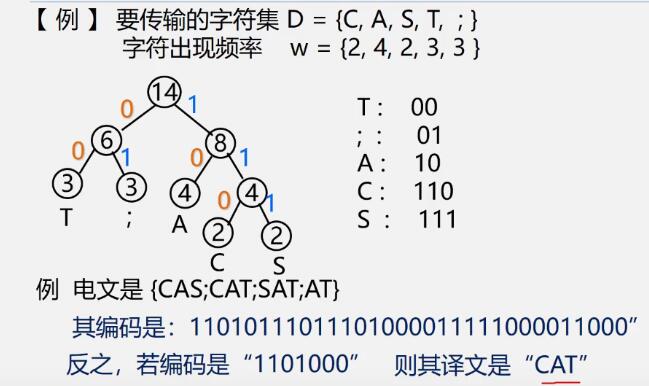
1.为什么哈夫曼编码能够保证是前缀编码?
因为没有一片树叶是另一片树叶的祖先,所以每个叶结点的编码就不可能是其它叶结点编码的前缀.
2.为什么哈夫曼编码能够保证字符编码总长最短?
因为哈夫曼树的带权路径长度最短,故字符编码的总长最短。
哈夫曼编码是前缀码,哈夫曼编码是最优前缀码
typedef char  **HuffmanCode;
void CreatHuffmanCode(HuffmanTree HT,HuffmanCode **HC,int n){
	//从叶子到根逆向求每个字符的哈夫曼编码,存储在编码表HC中
	HC = (char**)malloc(sizeof(char)*(n+1));
	char cd[n];
	cd[n-1] = '\0';//编码结束符
	for(int i = 1;i<=n;i++){//逐个字符求哈夫曼编码
		int start = n - 1;
		int c = i;
		int f = HT[i].parent;
		while(f!=0){//从叶子结点开始向上回溯,直到根结点
			--start;//回溯一次start向前指一个位置
			if(HT[f].lchild==c)
				cd[start] = '0';//如果c是f的左孩子,生成代码0
			else
				cd[start] = '1';//结点c是f的右孩子,生成代码1
			//继续向上回溯
			c = f;
			f = HT[f].parent;
		}
		HC[i] = (char*)malloc(sizeof(char)*(n - start));//为第i个字符串编码分配空间
		strcpy(HC[i],&cd[start]);//将求得的编码从临时空间cd复制到HC的当前行中 记得加上stdlib.h
	}
	free(cd); //释放临时空间
}
文件的编码和解码
编码
①输入各字符及其权值
②构造哈夫曼树———HT[i]
③进行哈夫曼编码———HC[i]
④查HC[i],得到各字符的哈夫曼编码
解码
①构造哈夫曼树
②依次读入二进制码
③读入0,则走向左孩子;读入1,则走向右孩子
④一旦到达某叶子时,即可译出字符
⑤然后再从根出发继续译码,指导结束
查找
基本概念
什么是查找?
——根据给定的某个值,在查找表中确定一个其关键笥等于给定值的数据元素或(记录)
关键字
用来标识一个数据元素(或记录)的某个数据项的值
主关键字可准─地标识个记录的关键字是主关键字;
次关键字反之,用以识别若干记录的关键字是次关键字。
查找表可分为两类:
静态查找表:
仅作查询”"(检索)操作的查找表。
动态查找表:
作(“插入”和“删除”操作的查找表。
有时在查询之后,还需要将“查询”结果为“不在查找表中”的数据元素插入到查找表中;或者,从查找表中删除其“查询”结果为"在查我表中”的数据元素,此类表为动态查找表
如何评价查找算法?
查找算法的评价指标:
关键字的平均比较次数,也称平均查找长度(ASL)
顺序查找
应用范围:
- 顺序表或线性链表表示的静态查找表
- 表内元素之间无序
数据元素类型定义:
typedef struct {
	KeyType key;//关键字域
	....//其他域
}ElemType;
结构类型的定义:
typedef struct {//顺序表结构类型定义
	ElemType *R;//表基址
	int length;//表长
}SSTable; //Sequential Search Table
SSTable ST;//定义顺序表
算法:
int Search_Seq( SSTable ST , KeyType key ){
	//若成功返回其位置信息,否则返回0
    int i;
	for(int i=ST.length; i>=1; --i )
		if ( ST.R[i].key==key )
			return i;
	return 0;
}
其他形式:
int Search_Seq(SSTable ST,KeyType key) {
    int i;
	for (i = ST.length ; ST.R[i].key != key ; -- i )
 			if(i<=0)
 				break;
	if (i > 0)
		return i;
	else
		return 0;
}
int Search_Seq(SSTable ST,KeyType key) {
    int i;
	for (i = ST.length; ST.R[i].key != key && i>0; --i);//注意分号
		if (i > 0)
			return i;
		else
			return 0;
}
改进:把待查关键字key存入表头(“哨兵”、”监视),从后往前逐个比较,可免去查找过程中每一步都要检测是否查找完毕,加快速度。
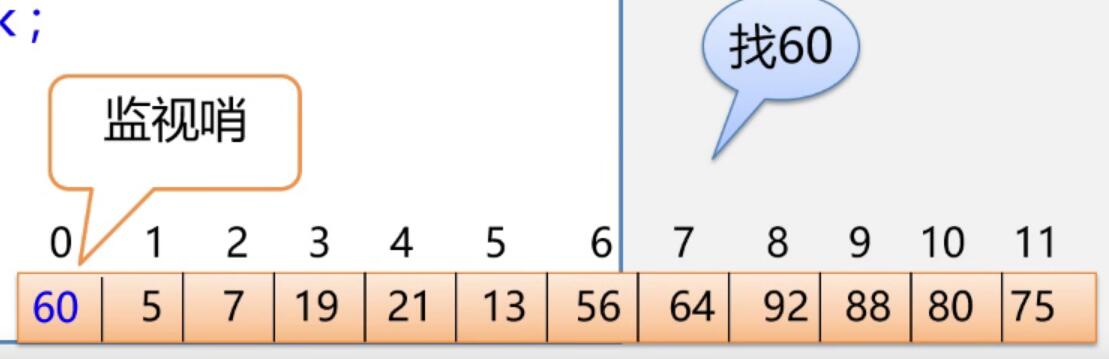
设置监视哨的顺序查找:
int Search_Seq( SSTable ST , KeyType key ){
	int i;
	ST.R[0].key =key;
	for( i=ST.length; ST.R[i].key!=key; --i );
	return i;
}
当STlength 较大时,此改进能使进行一次查找所需的平均时间几乎减少一半。
改进算法的性能分析
时间复杂度:O(n)
空间复杂度:需要一个辅助空间O(1)
比较次数与key位置有关:查找第i个元素,需要比较n-i+1次,查找失败,需要n+1次
若每个数查找概率相同:ASL=(1+2+3…+n)/n=(n+1)/2
当记录的查找概率不相同时如何提高查找效率?
查找表存储记录原则一按查找概率高低存储:
1)查找概率越高,比较次数越少;
2)查找概率越低,比较次数较多。
记录的查找概率无法测定时如何提高查找效率?
方法——按查找概率动态调整记录顺序:
1)在每个记录中设一个访问频度域;
2)始终保持记录按非递增有序的次序排列;
3)每次查找后均将刚查到的记录直接移至表头。
特点
优点:算法简单,逻辑次序无要求,且不同存储结构均适用。
缺点:ASL太长,时间效率太低。
折半查找
每次将待查记录所在区间缩小一半。
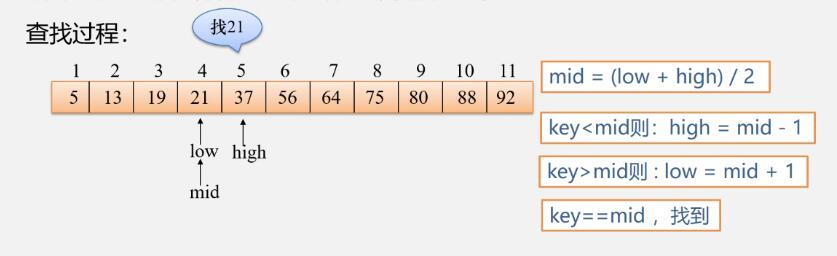
非递归算法:
设表长为n,low、high和mid分别指向待查元素所在区间的上界、下界和中点,key为给定的要查找的值:
初始时,令low=1,high=n,mid=L(low+high)/2]。让k与mid指向的记录比较
若key=-R[mid].key,查找成功若key<R[mid].key,则 high=mid-1
若key>R[mid].key,则 low=mid+1
重复上述操作,直至low>high时,查找失败
int Search_Bin (SSTable ST,KeyType key ) {
	int low = 1;
	int high = ST.length;//置区间初值
    int mid;
	while (low <= high) {
		mid = (low + high)/ 2;
		if (ST.R[mid].key == key)
			return mid;//找到待查元素
		else if (key < ST.R[mid].key)//缩小查找区间
			high=mid-1;//继续在前半区间进行查找
		else
			low = mid + 1;//继续在后半区间进行查找
	}
	return 0;//顺序表中不存在待查元素
}// Search_Bin
递归算法:
int Search_Bin (SSTable ST, keyType key, int low, int high) {
    if(low>high)
        return 0;//查找不到时返回0
	mid=(low+high)/2;
	if(key==ST.elem[mid].key)
        return mid;
    else if(key<ST.elem[mid].key)
		return Search_Bin(SSTable ST, keyType key,low,mid-1);//递归,在前半区域查找
    else if(key>ST.elem[mid].key)
        return Search_Bin(SSTable ST, keyType key,mid+1,high);//递归,在后半区域查找
性能分析
时间复杂度log2n
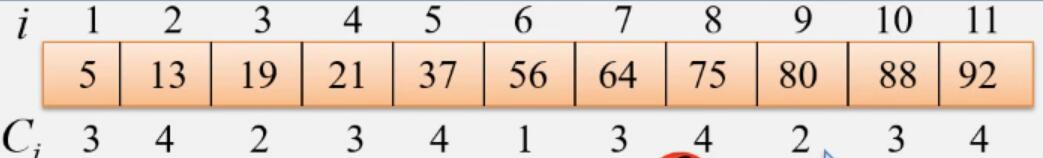
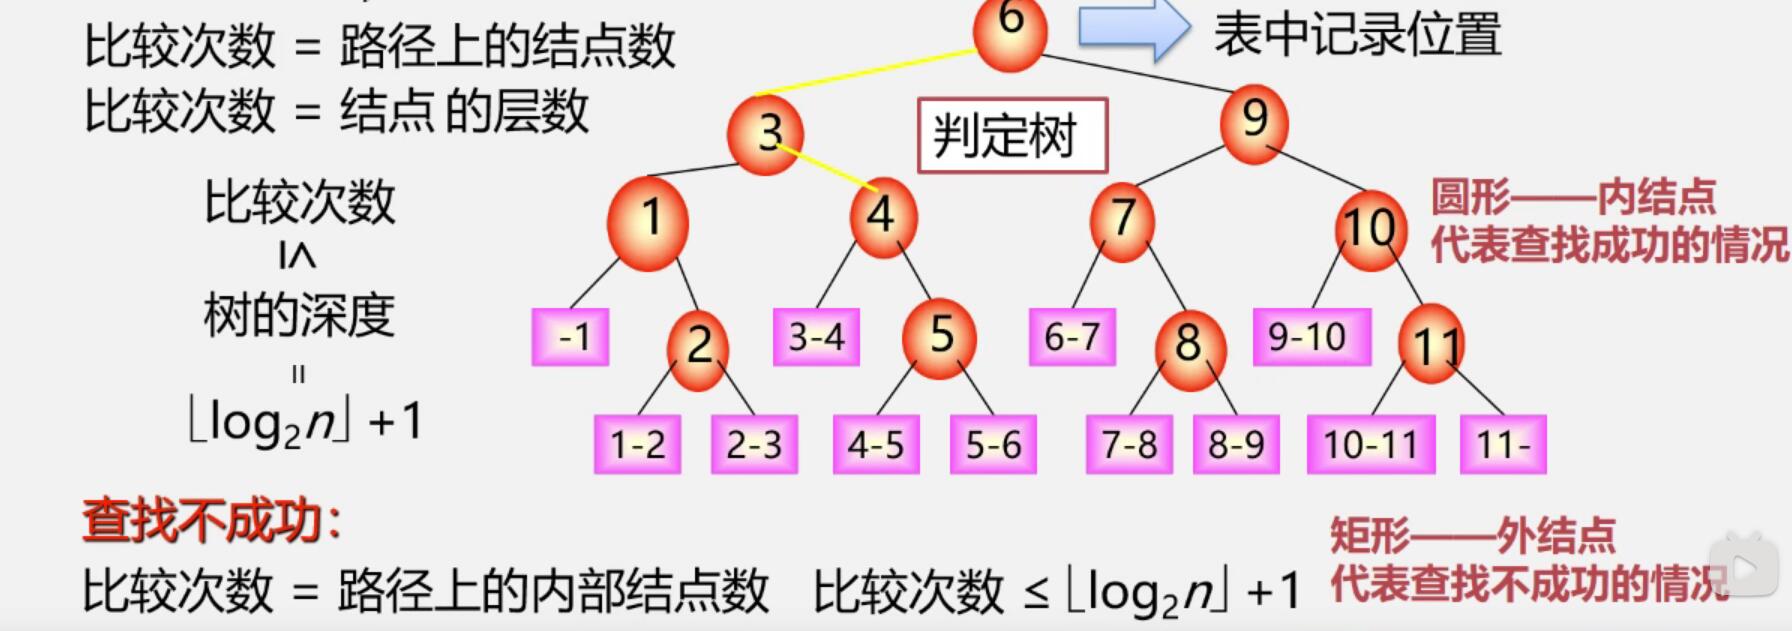
成功时:
设表长=2^n -1,则h = log2(n +1)(此时,判定树为深度= h的满二叉树),且表中每个记录的查找概率相等:Pi= 1/n。
失败时:
粉色块就是失败的,粉色块数乘层数相加除以总粉色块数
平均查找长度ASL
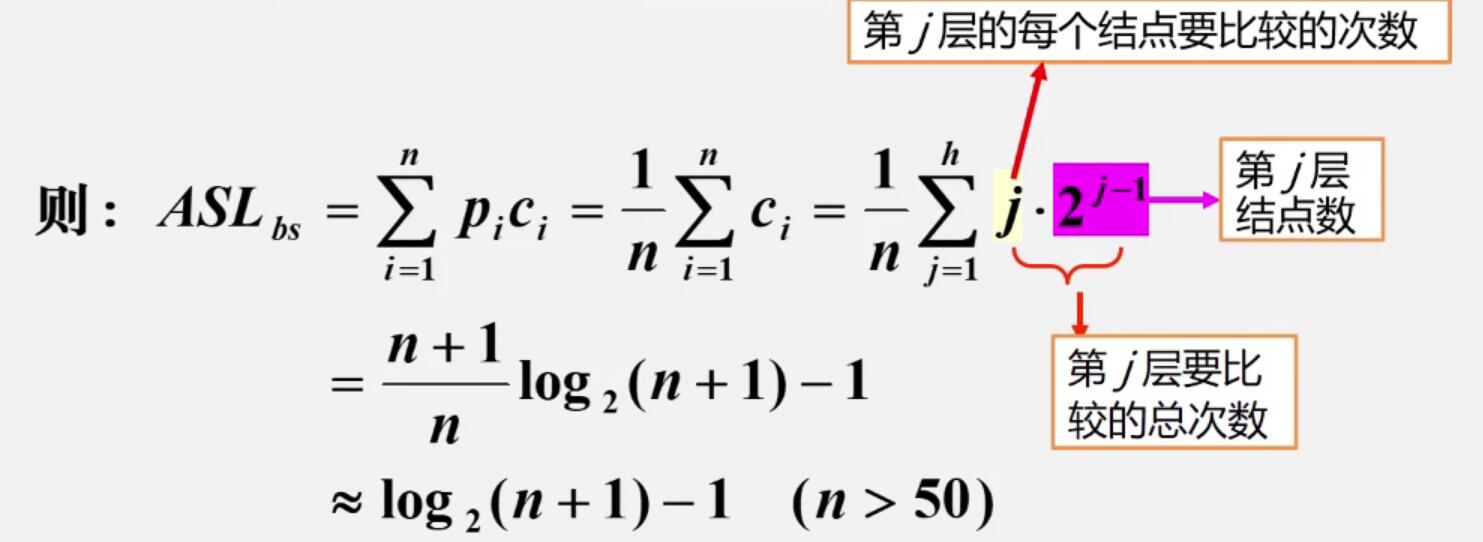
特点
折半查找优点:效率比顺序查找高。
折半查找缺点:只适用于有序表且限顺序存储结构(对线性链表无效)
分块查找
即索引顺序查找,特点:均匀分块,块间有序,块内无序。
条件:
1.将表分成几块,且表或者有序,或者分块有序;
若i <j,则第j块中所有记录的关键字均大于第i块中的最大关键字。
2.建立“索引表”(每个结点含有最大关键字域和指向本块第一个结点的指针,且按关键字有序)。
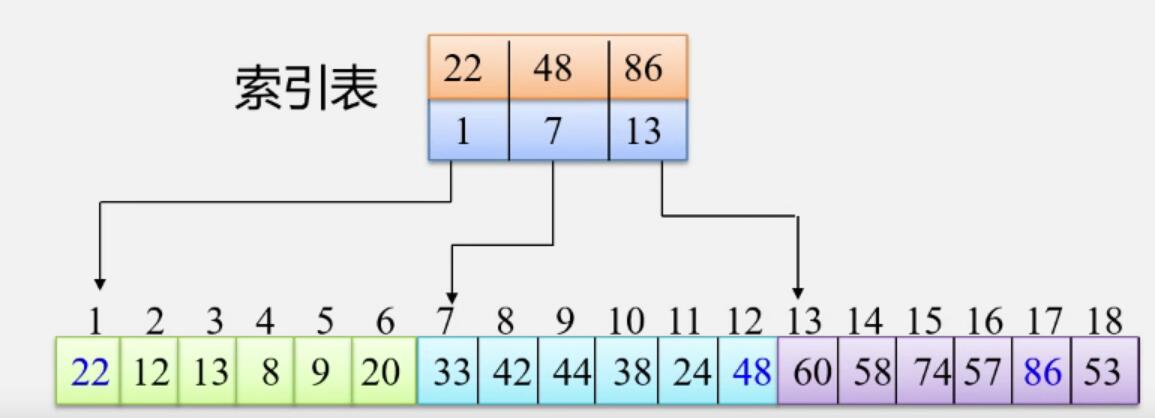
查找过程:先确定待查记录所在块(顺序或折半查找)再在块内查找(顺序查找)
性能分析
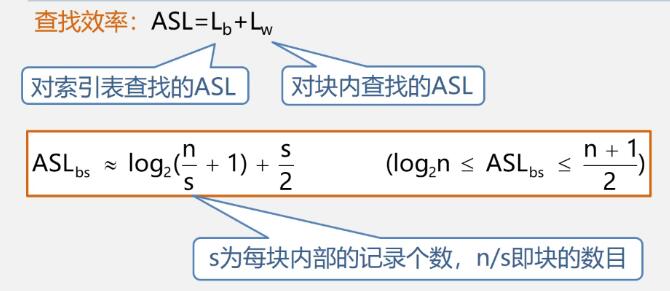
查找方法的比较
| 顺序查找 | 折半查找 | 分块查找 | |
|---|---|---|---|
| ASL | 最大 | 最小 | 中间 |
| 表结构 | 有序表、无序表 | 有序表 | 分块有序 |
| 存储结构 | 顺序表、线性链表 | 顺序表 | 顺序表、线性链表 |
树表的查找
当表插入、删除操作频繁时,为维护表的有序性,需要移动表中很多记录。
则改用动态查找表,表结构在查找过程动态生成
二叉排序树
又称为二叉搜索树、二叉查找树。
二叉排序树或是空树,或是满足如下性质的二叉树:
⑴若其左子树非空,则左子树上所有结点的值均小于根结点的值;(2)若其右子树非空,则右子树上所有结点的值均大于等于根结点的值;
(3)其左右子树本身又各是一棵二叉排序树
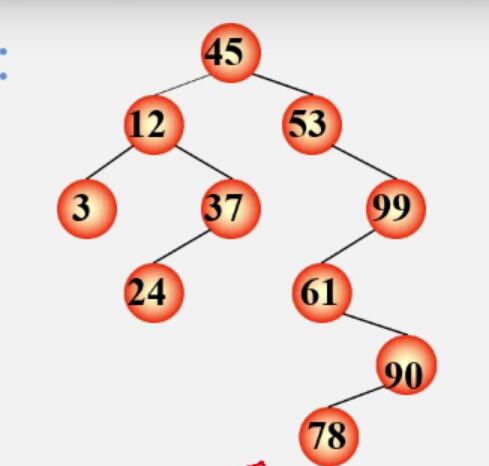
二叉排序树的性质:
中序遍历非空的二叉排序树所得到的数据元素序列是一个按关键字排列的递增有序序列。
操作:
若查找的关键字等于根结点,成功,否则若小于根结点,查其左子树若大于根结点,查其右子树,在左右子树上的操作类似。
存储结构:
typedef struct {
	KeyType key;//关键字项
	InfoType otherinfo;//其他数据域
}ElemType;
typedef struct BSTNode {
	ElemType data;//数据域
	struct BSTNode *lchild,*rchild;//左右孩子指针
}BSTNode,*BSTree;
BSTree T;
初始化
BSTNode * InitBST(KeyType e){
	BSTNode *BT;
	BT = (BSTNode *)malloc(sizeof(BSTNode));
	if(!BT){
		return NULL;
	}
	BT->key = e;
	BT->lchild = BT->rchild =NULL;
	return BT;
}
生成
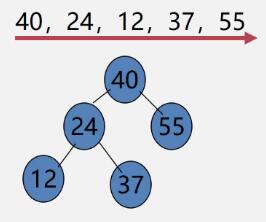
一个无序序列可通过构造二叉排序树而变成一个有序序列。构造树的过程就是对无序序列进行排序的过程。
不同插入次序的序列生成不同形态的二叉排序树
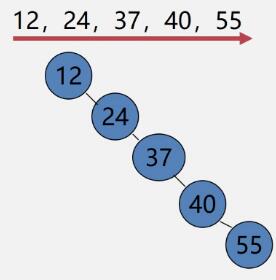
BSTNode *CreatBST(KeyType A[],int n){
	BSTNode *BT;
	int i;
	BT = InitBST(A[0]);
	for(i=1;i<n;i++){
		InsertBST(BT, A[i]);
	}
	return BT;
}
查找
算法思想:
(1)若二叉排序树为空,则查找失败,返回空指针。
(2)若二叉排序树非空,将给定值key与根结点的关键字
T->data.key进行比较:
①若key等于T->data.key,则查找成功,返回根结点地址; ②若key小于T->data.key,则进一步查找左子树;
③若key大于T->data.key,则进一步查找右子树。
递归算法:
BSTree SearchBST(BSTree T,keyType key) {
    if((!T) || key==T->data.key)
        return T;
    else if(key<T->data.key)
		return SearchBST(T->lchild,key);//在左子树中继续查找
    else
        return SearchBST(T->rchild,key);//在右子树中继续查找
}
插入
若二叉排序树为空,则插入结点作为根结点插入到空树中否则,继续在其
左、右子树上查找
- 树中已有,不再插入
- 树中没有
- 查找直至某个叶子结点的左子树或右子树为空为止,则插入
- 结点应为该叶子结点的左孩子或右孩子
插入的元素一定是在叶子结点上
void InsertBST(BSTNode * BT, KeyType e){

	BSTNode *T;
	T = BT;
	while(T){
		// 寻找插入位置,并插入
		if(T->key == e){
			return ;
		}

		if(T->key < e){
			// 右孩子存在,则继续寻找
			if(T->rchild){
				T = T->rchild;
				continue;
			}
			// 不存在则进行插入
			T->rchild = (BSTNode *)malloc(sizeof(BSTNode));
			T->rchild->key = e;
			T->rchild->lchild = T->rchild->rchild =NULL;
			return ;
		}else if(T->key > e){
			// 右孩子存在,则继续寻找
			if(T->lchild){
				T = T->lchild;
				continue;
			}
			// 不存在则进行插入
			T->lchild = (BSTNode *)malloc(sizeof(BSTNode));
			T->lchild->key = e;
			T->lchild->lchild = T->lchild->rchild =NULL;
		}

	}


}
查找分析
比较的关键字的次数=此节点所在的层次树
最多的比较次数=树的深度
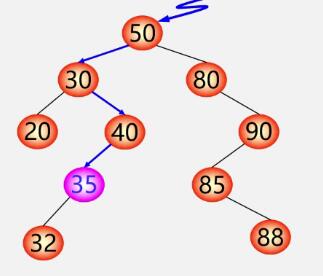
含有n个结点的二叉排序树的平均查找长度和树的形态有关
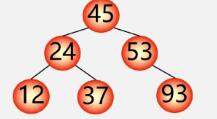
最好情况:
初始序列{45,24,53,12,37,93}
ASL=log 2(n + 1)一1;树的深度为:Llog 2n」+ 1;
与折半查找中的判定树相同。(形态比较均衡):o ( log2n)
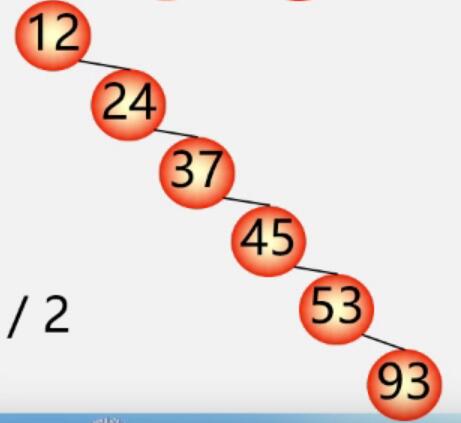
最坏情况:
初始序列{12,24,37,45,53,93}
插入的n个元素从一开始就有序,——变成单支树的形态!
此时树的深度为n,ASL = (n +1)/ 2查找效率与顺序查找情况相同:O(n)
如何提高形态不均匀的二叉排序树的查找效率?
做“平衡化”处理,即尽量让二叉树的形状均衡。
删除
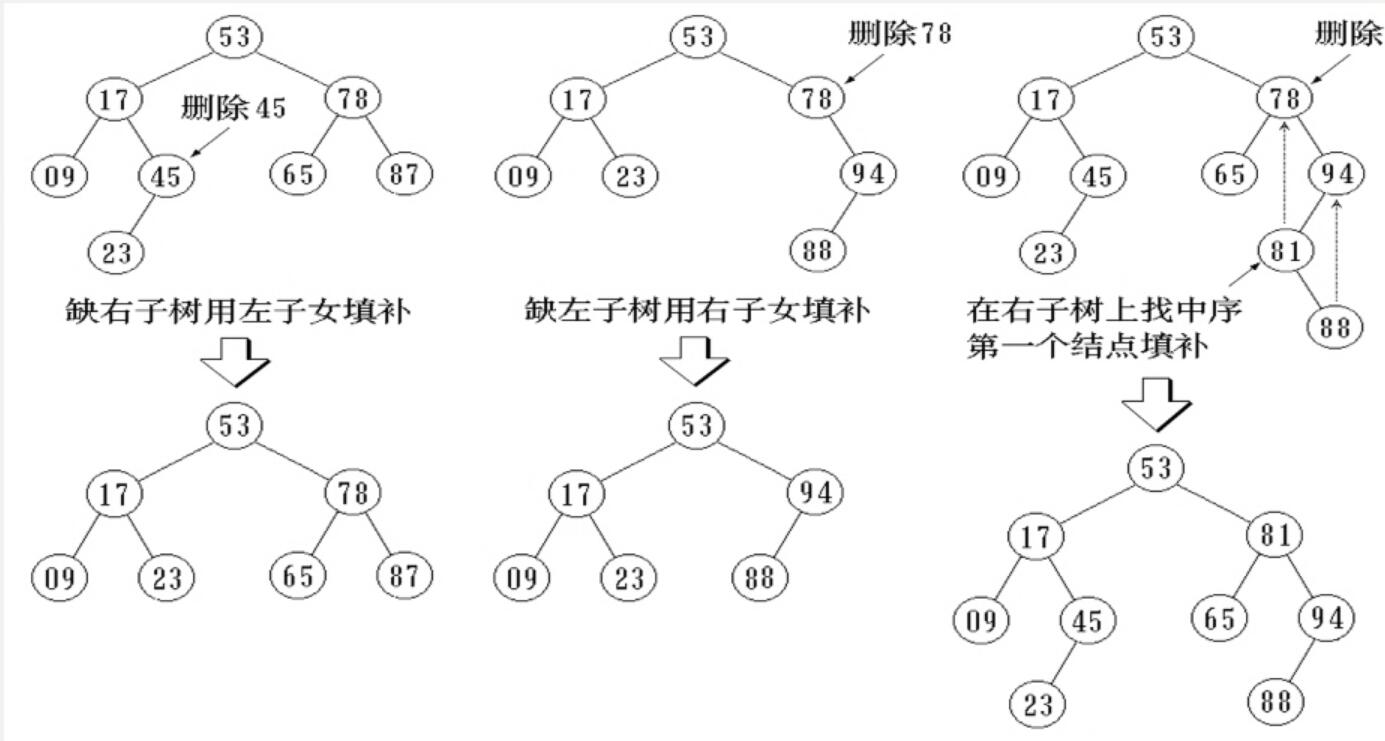
从二叉排序树中删除一个结点,不能把以该结点为根的子树都删去,只能删掉该结点,并且还应保证删除后所得的二叉树仍然满足二叉排序树的性质不变。
由于中序遍历二叉排序树可以得到一个递增有序的序列。那么,在二叉排序树中删去一个结点相当于删去有序序列中的一个结点。
- 将因删除结点而断开的二叉链表重新链接起来
- 防止重新链接后树的高度增加
(1)被删除的结点是叶子结点:直接删去该结点。
(2)被删除的结点只有左子树或者只有右子树,用其左子树或者右子树替换它(结点替换)。
(3)被删除的结点既有左子树,也有右子树
- 以其中序前趋值替换之(值替换),然后再删除该前趋结点。前趋是左子树中最大的结点。
- 也可以用其后继替换之,然后再删除该后继结点。后继是右子树中最小的结点。
void DeleteNodeByData(BSTree bsTree, DATATYPE data){
    BSTree targetNode = Search2(bsTree,data);
    if (targetNode != NULL){

        BSTree q,s;
        if (targetNode->rchild == NULL){
            q = targetNode;
            targetNode = targetNode->lchild;
            free(q);
        }else if(targetNode->lchild == NULL){
            q = targetNode;
            targetNode = targetNode->rchild;
            free(q);
        }else{//左右子树均不为空,
            // 将其右子树中序遍历的第一个子女交换并且删除此子女
            // 或者将其左子树中序遍历的最后一个子女交换,并且删此子女
            q = targetNode;
            s = targetNode->rchild;
            //找到右子树中序遍历的第一个子女s,q为s的父节点
            while (s->lchild){
                q = s;
                s = s->lchild;
            }
            targetNode ->data = s->data;//交换数据
            if (q != targetNode){
                q->lchild = s->rchild;
            }else{
                q->rchild = s->rchild;
            }
            free(s);
        }
    }
}
平衡二叉树
又称AVL树(Adelson-Velskii and Landis)。
一棵平衡二叉树或者是空树,或者是具有下列性质的二叉排序树:
- 左子树、右子树的高度之差的绝对值小于等于1;
- 左子树和右子树也是平衡二叉排序树。
为了方便起见,给每个结点附加一个数字,给出该结点左子树一右子树的高度差。这个数字称为结点的平衡因子(BF) 。
平衡因子= 结点左子树的高度-结点右子树的高度
根据平衡二叉树的定义,平衡二叉树上所有结点的平衡因子只能是-1、0,或1。
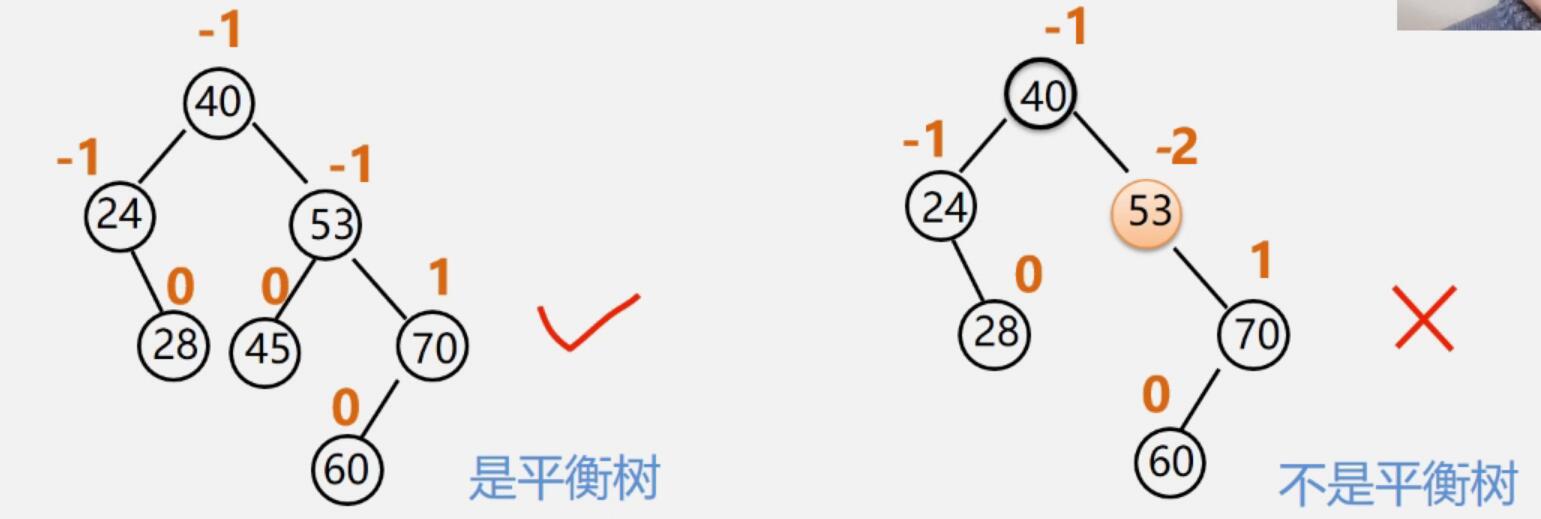
失衡二叉排序树的分析与调整
平衡调整的四种类型:
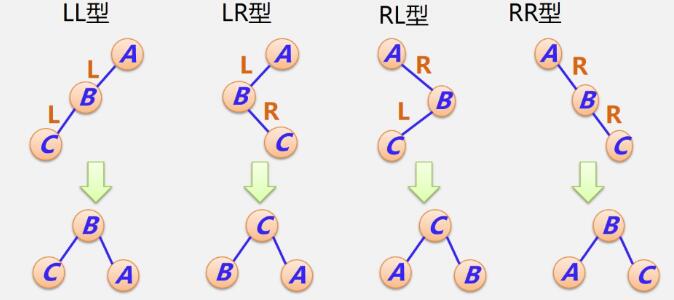
调整原则:
- 降低高度
- 保持二叉排序树性质
LL型调整过程
- B结点带左子树α一起上升
- A结点成为B的右孩子
- 原来B结点的右子树β作为A的左子树
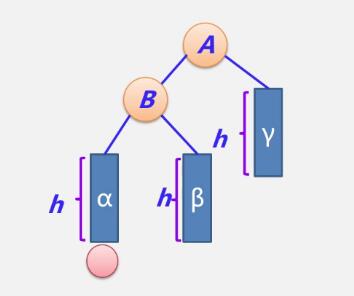
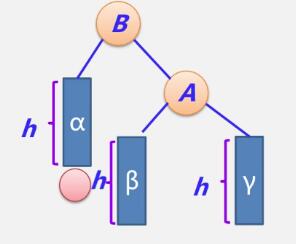
例子:
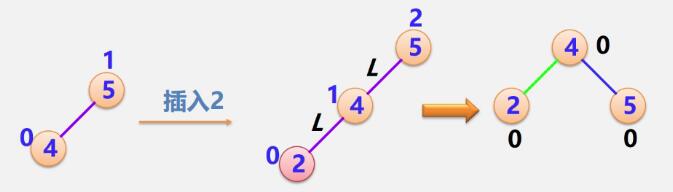
RR型调整过程
- B结点带右子树β一起上升
- A结点成为B的左孩子
- 原来B结点的左子树α作为A的右子树
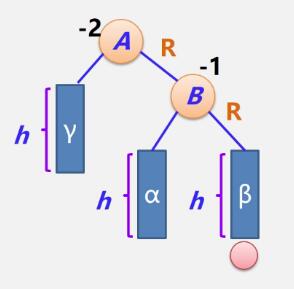
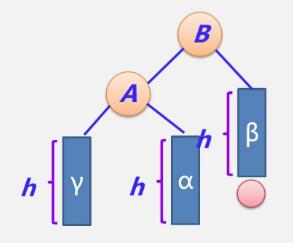
LR型调整过程
- C结点穿过A、B结点上升
- B结点成为C的左孩子,A结点成为C的右孩子
- 原来C结点的左子树β作为B的右子树;
- 原来C结点的右子树y作为A的左子树
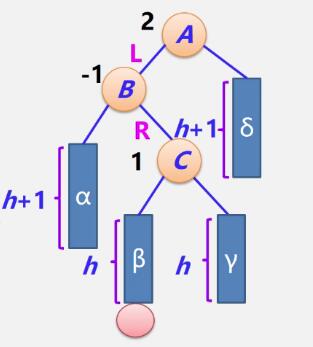
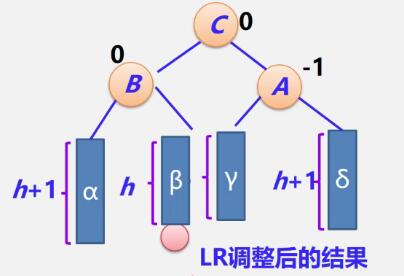
RL型调整过程
- C结点穿过A、B结点上升
- A结点成为C结点的左孩子
- B结点成为C结点的右孩子
- C结点的左孩子作为A结点的右孩子
- C结点的右孩子作为B结点的左孩子
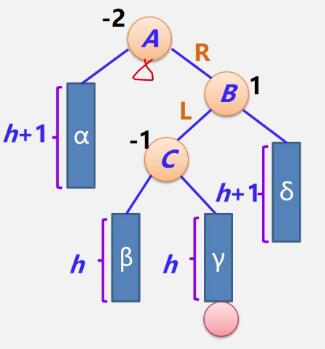
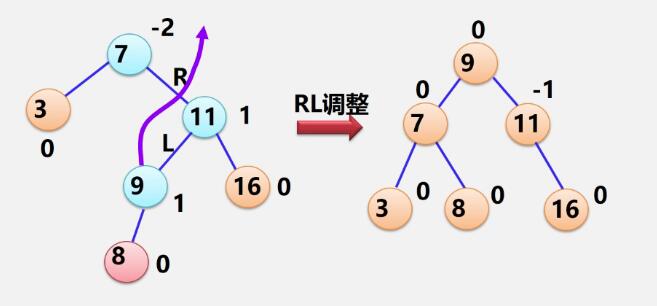
散列表
基本思想:记录的存储位置与关键字之间存在对应关系
根据散列函数 H(key)k
查找key=9,则访问H(9)=9号地址,若内容为9则成功;若查不到,则返回一个
特殊值,如空指针或空记录。
优点:查找效率高
缺点:空间效率低!
相关术语
散列方法(杂凑法)
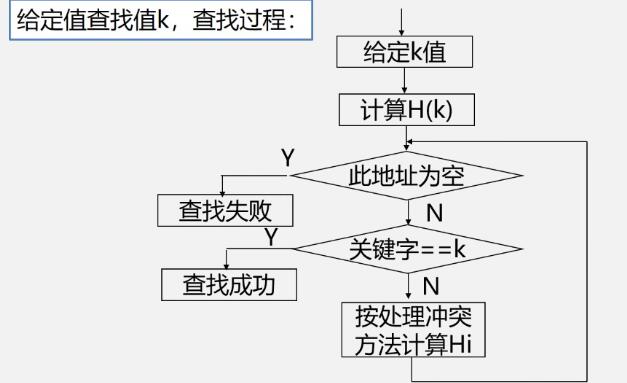
选取某个函数,依该函数按关键字计算元素的存储位置,并按此存放;查找时,由同一个函数对给定值k计算地址,将k与地址单元中元素关键码进行比,确定查找是否成功。
散列函数(杂凑函数):散列方法中使用的转换函数
冲突:不同的关键码映射到同一个散列地址
key1=key2,但是H(key1)=H(key2)
构造方法
1)构造好的散列函数
(a)所选函数尽可能简单,以便提高转换速度;
(b)所选函数对关键码计算出的地址,应在散列地址集中致均匀分布,以减少空间浪费。
2)制定一个好的解决冲突的方案
查找时,如果从散列函数计算出的地址中查不到关键码,则应当依据解决冲突的规则,有规律地查询其它相关单元。
构造散列函数考虑的因素
- 执行速度(即计算散列函数所需时间);
- 关键字的长度;
- 散列表的大小;
- 关键字的分布情况;
- 查找频率。
根据元素集合的特性构造
要求一:n个数据原仅占用n个地址,虽然散列查找是以空间换时间,但仍希望散列的地址空间尽量小。要求二:无论用什么方法存储,目的都是尽量均匀地存放元素,以避免冲突。
#define MAXTABLESIZE 100000  /* 允许开辟的最大散列表长度 */
typedef int ElementType;     /* 关键词类型用整型 */
typedef int Index;           /* 散列地址类型 */
typedef Index Position;      /* 数据所在位置与散列地址是同一类型 */
/* 散列单元状态类型,分别对应:有合法元素、空单元、有已删除元素 */
typedef enum { Legitimate, Empty, Deleted } EntryType;

typedef struct HashEntry Cell; /* 散列表单元类型 */
struct HashEntry{
    ElementType Data; /* 存放元素 */
    EntryType Info;   /* 单元状态 */
};

typedef struct TblNode *HashTable; /* 散列表类型 */
struct TblNode {   /* 散列表结点定义 */
    int TableSize; /* 表的最大长度 */
    Cell *Cells;   /* 存放散列单元数据的数组 */
};
直接定址法
Hash(key) = a·key + b (a、b为常数)
优点:以关键码key的某个线性函数值为散列地址,不会产生冲突。
缺点:要占用连续地址空间,空间效率低。
除留余数法
Hash(key)= key mod p(p是一个整数)
如何选取合适的p?
设表长为m,取p≤m且为质数
处理冲突
开放定址法
基本思想:有冲突时就去寻找下一个空的散列地址,只要散列表足够大,空的散列地址总能找到,并将数据元素存入。
线性探测法
Hash(key)=(Hash(key)+d)mod m( 1≤i < m )
其中: m为散列表长度
di为增量序列1,2,…m-1,且di=i
—旦冲突,就找下一个地址,直到找到空地址存入
Position Hash( ElementType Key, int TableSize )
{
    return (Key % TableSize);
}
二次探测法
Hash(key)=(Hash(key)+d) mod m
其中: m为散列表长度,m要求是某个4k+3的质数;
di为增量序列1^2 (-1)^2 2^2 (-2)^2,…,q2
伪随机探测法
Hash(k)=(Hash(key)+d) mod m( 1≤i< m )
其中: m为散列表长度
di为伪随机数
链地址法(拉链法)
基本思想:相同散列地址的记录链成一单链表,m个散列地址就设m个单链表,然后用一个数组将m个单链表的表头指针存储起来,形成一个动态的结构。
链地址法建立散列表步骤
Step1:取数据元素的关键字key,计算其散列函数值(地址)。若该地址对应的链表为空,则将该元素插入此链表;否则执行Step2解决冲突。
Step2:根据选择的冲突处理方法,计算关键字key的下一个存储地址。若该地址对应的链表为不为空,则利用链表的前插法或后插法将该元素插入此链表。
优点:
- 非同义词不会冲突,无“聚集”现象
- 链表上结点空间动态申请,更适合于表长不确定的情况
散列表的查找
对于关键字集(19,14,23,1,68,20,84,27,55,11,10,79),n=12
无序查找的ASl=(1+12)/2=6.5
有序表折半查找ASL=log2(n+1)-1
//线性探测法的查找函数
Position Find( HashTable H, ElementType Key ){
	int maxsize = H->TableSize;
	int d = 0;//增量序列
    int cnt = 0;
	Position p = Hash(Key,H->TableSize);
	while(1){
        cnt++;
		if(H->Cells[p].Info == Empty || H->Cells[p].Data == Key){
			return p;
		}
		if(d < maxsize-1){
			d++;
		}else{
            break;
        }
		p = (Hash(Key,H->TableSize)+d)%maxsize;
	}
	return ERROR;
}
查找效率分析
使用平均查找长度ASL来衡量查找算法,ASL取决于
- 散列函数
- 处理冲突的方法
- 散列表的装填因子α
α = 表中填入的记录数/哈希表的长度
α越大,表中记录数越多,说明表装得越满,发生冲突的可能性就越大,查找时比较次数就越多。
ASL与装填因子α有关!既不是严格的O(1),也不是O(n)
| 方法 | ASL |
|---|---|
| 拉链法 | ASL≈1+α/2 |
| 线性探测法 | ASL≈1/2(1+1/(1-α)) |
| 随机探测法 | ASL=-1/α*ln(1-α) |
几点结论
- 散列表技术具有很好的平均性能,优于一些传统的技术
- 链地址法优于开地址法
- 除留余数法作散列函数优于其它类型函数
排序
排序方法的分类
- 按数据存储介质:内部排序和外部排序
- 按比较器个数:串行排序和并行排序按主要操作:比较排序和基数排序
- 按辅助空间:原地排序和非原地排序
- 按稳定性:稳定排序和非稳定排序
- 按自然性:自然排序和非自然排序
按存储介质课可分为:
内部排序:数据量不大、数据在内存,无需内外存交换数据
外部排序:数据量较大、数据在外存(文件排序)
按比较器个数可分为:
串行排序:单处理机)(同一时刻比较一对元素)
并行排序:多处理机(同一时刻比较多对元素)
按主要操作可分为:
比较排序:用比较的方法
插入排序、交换排序、选择排序、归并排序
基数排序:不比较元素的大小,仅仅根据元素本身的取值确定其有序位置。
按辅助空间可分为:
原地排序:辅助空间用量为O(1)的排序方法。(所占的辅助存储空间与参加排序的数据量大小无关)
非原地排序:辅助空间用量超过O(1)的排序方法。
按稳定性可分为:
稳定排序:能够使任何数值相等的元素(排序以后相对次序不变)。
非稳定性排序:不是稳定排序的方法。
排序的稳定性只对结构类型数据排序有意义。
例如:
n个学生信息(学号、姓名、语文、数学、英语、总分)
1、按数学成绩从高到低排序
2、按照总分从高到低排序。
3、总分相同的情况下,数学成绩高的排在前面
按自然性可分为:
自然排序:输入数据越有序,排序的速度越快的排序方法。
非自然排序:不是自然排序的方法。
存储结构
记录序列以顺序表存储
#define MAXSIZE 20//设记录不超过20个
typedef int KeyType;//设关键字为整型量(int型)
Typedef struct{//定义每个记录(数据元素)的结构
	KeyType key;//关键字
	lnfoType otherinfo;//其它数据项
}RedType;
Typedef struct {
//定义顺序表的结构
RedType r[ MAXSIZE+1 ];//存储顺序表的向量
						//r[0]一般作哨兵或缓冲区
int length;//顺序表的长度
}SqList;
插入排序

基本操作:有序插入
- 在有序序列中插入一个元素,保持序列有序,有序长度不断增加。
- 起初,a[0]是长度为1的子序列。然后,逐—将a[1]至a[n-1]插入到有序子序列中。
有序插入法:
在插入a[i]前,数组a的前半段(a[0]a[i-1])是有序段,后半段(a[i]a[n-1])是停留于输入次序的“无序段”。
插入a[i]使a[0]~a[i-1]有序,也就是要为a[i]找到有序位置j (0<=j<i) ,将a[i]插入在a[j]的位置上。

直接插入排序
采用顺序查找法查找插入位置

复制插入元素
x=a[i];
记录后移,查找插入位置
for(j=i-1; j>=0&&x<a[j];j--)
	a[j+1]=a[j];
插入到正确位置
a[j+1];
还可以使用哨兵
复制为哨兵

L.r[0]=L.r[i];
记录后移,查找插入位置

for(j=i-1;L.r[0].key < L,r[j].key;j--){
	L.r[j+1] = L.r[j];
}
插入到正确的位置

L.r[j+1]=L.r[0];
算法
void lnsertSort( SqList *L) {
	int i, j;
	for (i=2; i<=L.length; ++i) {
		if (L->r[i].key < L->r[i-1].key){ //若"<",需将L->r[i]插入有序子表
			L->r[0]=L->r[i];//复制为哨兵
			for (j=i-1; L->r[0].key<L->r[j].key; --j ) {
				L->r[j+1]=L->r[j];//记录后移
            }
            L->r[j+1]=L->r[0];//插入到正确位置
        }
    }
}
性能分析
实现排序的基本操作有两个:
- “比较”序列中两个关键字的大小;
- “移动”记录。
最好的情况(关键字在记录序列中顺序有序):

“比较”的次数:
“移动”的次数:0
最坏的情况(关键字在记录序列中逆序有序):

第n个元素要比较n-1个元素
“比较”的次数:
“移动”的次数:
平均情况:
“比较”的次数:
“移动”的次数:
时间复杂度:
原始数据越接近有序,排序速度越快
最坏情况下(输入数据是逆有序的):Tw(n)=O(n2)
平均情况下,耗时差不多是最坏情况的一半:Te(n)=O(n2)
要提高查找速度,减少元素的比较次数,减少元素的移动次数。
折半插入排序

void BlnsertSort ( SqList *L ) {
    int low,high,i,j;
	for ( i = 2; i <= L->length; ++i ){//依次插入第2~第n个元素L.r[0] = L->r[i];/当前插入元素存到“哨兵”位置
		low = 1 ; high = i-1;//采用二分查找法查找插入位置while ( low <= high ) {
		mid = ( low + high ) / 2 ;
		if ( L->r[0].key < L->r[mid].key )
        	high = mid -1;
    	else
            low = mid + 1;
	}//循环结束,high+1则为插入位置
	for (j=i-1; j>=high+1; --j ) {
        L->r[j+1] = L->r[j];//移动元素L.r[high+1] = L.r[O];//插入到正确位置
	}
}
性能分析
折半查找比顺序查找快,所以折半插入排序就平均性能来说比直接插入排序要快;
它所需要的关键码比较次数与待排序对象序列的初始排列无关,仅依赖于对象个数。在插入第i个对象时,需要经过 次关键码比较,才能确定它应插入的位置;
当n当较大时,总关键码比较次数比直接插入排序的最坏情况要好得多,但比其最好情况要差;
在对象的初始排列已经按关键码排好序或接近有序时,直接插入排序比折半插入排序执行的关键码比较次数要少;
折半插入刨析的对象移动次数与直接插入排序相同,依赖于对象的初始排序
- 减少了比较次数,但是没有减少移动次数
- 平均性能优于直接插入排序
时间复杂度为O(2)
空间复杂度为O(1)
是一种稳定的排序方法
希尔排序
基本思想
先将整个待排记录序列分割成若干子序列,分别进行直接插入排序,待整个序列中的记录“基本有序”时,再对全体记录进行一次直接插入排序。
思路
1.定义增量序列Dx : Dm>DM-1>…>D1=1
2.对每个Dk进行“Dk-间隔”插入排序(k=M,M-1,…1)
特点
- 一次移动,移动位置较大,跳跃式地接近排序后的最终位置
- 最后一次只需要少量移动
- 增量序列必须是递减的,最后一个必须是1
- 增量序列应该是互质的
例子

算法
dk值依次存在dlta[t]中
void ShellSort (Sqlist *L,int dlta[], int t){
	//按增量序列dlta[0..t-1],对顺序表L作希尔排序。
	for(k=O; k<t; ++k)
		Shelllnsert(L, dlta[k]);//一趟增量为dlta[k]的插入排序
}
void Shelllnsert(SqList *L, int dk){
    int i,j;
	for(i=dk+1; i<=L.length; ++ i)
	if(r[i]->key < r[i-dk]->key) {
		r[0]=r[i];
		for(j=i-dk; j>0 &&(r[0]->key<r[j]->key); j=j-dk)
			r[j+dk]=r[j];
		r[j+dk]=r[0];
	}
}
算法分析
希尔排序算法效率与增量序列的取值有关
Hibbard增量序列
D=2^k-1——相邻元素互质最坏情况: Tworst=O(n^3/2)
猜想: Tavq=O(n^5/4)
Sedgewick增量序列
{1,5,19,41,109,…}
——9x4i-9x2i+1或4i-3x2i+1
猜想:Tavg=O(n^7/6)Tworst=O(n^4/3)
稳定性
希尔排序法是一种不稳定的排序算法
时间复杂度是n和d的函数:
o(n^1.25) ~O(1.6n^1.25)经验公式
空间复杂度为O(1)
是一种不稳定的排序方法
如何选择最佳d序列,目前尚未解决
最后一个增量值必须为1,无除了1之外的公因子
宜在链式存储结构上实现
交换排序
基本思想
两两比较,如果发生逆序则交换,直到所有记录都排好序为止。
冒泡排序
基本思想
每趟不断将记录两两比较,并按“前小后大”规则交换
算法
void bubble_sort(SqList *L) {//冒泡排序算法
	int i,j; RedType x;//交换时临时存储
	for(i=1; i<=n-1;i++){//总共需m趟
		for(j=1; j<=n-i; j++)
			if(L.r[j].key>L.r[j+1].key){//发生逆序
				x=L.r[j];
                L.r[j]=L.r[j+1];
                L.r[j+1]=x;//交换
			}
	}
}
优点:
每趟结束时,不仅能挤出一个最大值到最后面位置,还能同时部分理顺其他元素;
如何提高效率?
一旦某一趟比较时不出现记录交换,说明已排好序了,就可以结束本算法。
改进:
void bubble_sort(SqList &L){//改进的冒泡排序算法
    int i,j,flag=1; RedType x; //flag作为是否有交换的标记
    for(i=1; i<=n-1&&flag==1;i++){
		flag=0;
		for(j=1; j<= n-i; j++)
			if(L.r[j].key>L.r[j+1].key){ //发生逆序
				flag=1;//发生交换,flag置为1,若本趟没发生交换,flag保持为0
                x=L.r[j];
                L.r[j]=L.r[j+1];
                L.r[j+1]=x;//交换
			}
	}/ /for
}
算法分析
最好情况(正序)
- 比较次数:n-1
- 移动次数:0
最坏情况(逆序)
- 比较次数:(1/2)*(n^2-n)
- 移动次数:(3/2)*(n^2-n) 发现一次逆序,就要移动三次
冒泡排序最好时间复杂度是O(n)
冒泡排序最坏时间复杂度为O(n^2)
冒泡排序平均时间复杂度为O(n^2)
冒泡排序算法中增加一个辅助空间temp,辅助空间为S(n)=O(1)
冒泡排序是稳定的
快速排序
基本思想
- 任取一个元素(如:第一个)为中心
- 所有比它小的元素一律前放,比它大的元素一律后放,形成左右两个子表;
- 对各子表重新选择中心元素并依此规则调整(递归思想)
- 直到每个子表的元素只剩一个

算法
void QSort(SqList *L, int low, int high){//对顺序表L快速排序
	if (low < high){ //长度大于1
		int pivotloc = Partition(L, low, high);//将L.r[low..high]一分为二,pivotloc为枢轴元素排好序的位置
		QSort(L, low, pivotloc-1);//对低子表递归排序
		QSort(L, pivotloc+1, high);//对高子表递归排序
    }//endif
} // QSort
int Partition ( SqList L, int low,int high ) {
    L.r[0] = L.r[low];//选第一个元素为中心
    int pivotkey = L.r[low].key;
    while ( low < high ) {
		while ( low < high && L.r[high].key >= pivotkey )
        	--high;
        L.r[low] = L.r[high];
		while ( low < high && L.r[low].key <= pivotkey )
       	 	++low;
        L.r[high] = L.r[low];
	}
	L.r[low]=L.r[0];
    return low;
}
算法分析
可以证明,
时间复杂度:
平均计算时间是O(nlog2n)。
Qsort( ): O(log2n)
Partition( ): O(n)
实验结果表明:就平均计算时间而言,快速排序是我们所讨论的所有内排序方法中最好的一个。
空间复杂度:
由于程序中使用了递归,需要递归调用栈的支持,而栈的长度取决于递归调用的深度。(即使不用递归,也需要用用户栈)
在平均情况下:需要O(logn)的栈空间
最坏情况下:栈空间可达O(n)。
稳定性:
快速排序是一种不稳定的排序方法。
试对( 90,85,79,74,68,50,46 )进行快速排序的划分
你是否发现什么特殊情况?
再对(46,50,68,74,79,85,90 )进行快速排序划分呢?
由于每次枢轴记录的关键字都是大于其它所有记录的关键字,致使一次划分之后得到的子序列(1)的长度为0,这时已经退化成为没有改进措施的冒泡排序。
快速排序不适于对原本有序或基本有序的记录序列进行排序。
- 划分元素的选取是影响时间性能的关键
- 输入数据次序越乱,所选划分元素值的随机性越好,排序速度越快,快速排序不是自然排序方法。
- 改变划分元素的选取方法,至多只能改变算法平均情况的下的世界性能,无法改变最坏情况下的时间性能。即最坏情况下,快速排序的时间复杂性总是O(n^2)
选择排序
简单选择排序
基本思想
在待排序的数据中选出最大(小)的元素放在其最终的位置。
基本操作
- 首先通过n-1次关键字比较,从n个记录中找出关键字最小的记录,将它与第一个记录交换
- 再通过n-2次比较,从剩余的n-1个记录中找出关键字次小的记录,将它与第二个记录交换
- 重复上述操作,共进行n-1趟排序后,排序结束
算法实现
void SelectSort(SqList *L) {
    int i,j,k;
	for (i=1; i<L.length; ++i) {//选择关键字最小的记录
		k=i;
		for(j=i+1;j<=L.length ; j++)
			if ( L.r[j].key <L.r[k].key) k=j;//记录最小值位置
		if(k!=i) {
             int t = L->r[i];
            L->r[i] = L->r[k];
            L->r[k] = t;
         }//交换
	}
}
算法分析
记录移动次数
- 最好情况:0
- 最坏情况:3(n-1)
比较次数:无论待排序列处于什么状态,选择排序所需进行的"比较”次数都相同:(n/2)*(n-1)
简单选择排序是不稳定排序
堆排序
堆的定义
若n个元素的序列{a1a2… a,}满足
ai;≤a2i
ai≤a2i+1则称{a1a2… an}为小根堆
ai≥a2i
ai≥a2i+1则称{a1a2… an}为大根堆
从堆的定义可以看出,堆实质是满足如下性质的完全二叉树:二叉树中任一非叶子结点均小于(大于)它的孩子结点
若在输出堆顶的最小值(最大值)后,使得剩余n-1个元素的序列重又建成一个堆,则得到n个元素的次小值(次大值)…….如此反复,便能得到一个有序序列,这个过程称之为堆排序。
堆的调整
如何在输出堆顶元素后,调整剩余元素为一个新的堆?
小根堆:
- 输出堆顶元素之后,以堆中最后一个元素替代之;
- 然后将根结点值与左、右子树的根结点值进行比较,并与其中小者进行交换;
- 重复上述操作,直至叶子结点,将得到新的堆,称这个从堆顶至叶子的调整过程为“筛选”
大根堆则同理,与其中大者进行交换
算法实现:
void HeapAdjust (elem R[ ], int s, int m) {
/*已知R[s..m]中记录的关键字除R[s]之外均满足堆的定义,本函数调整R[s]的关键字,使R[s..m]成为一个大根堆*/
	elemtype rc = R[s];
	int j;
	for ( j=2*s; j<=m; j *= 2){//沿key较大的孩子结点向下筛选
        if (j<m && R[j]< R[j+1]) ++j;//j为key较大的记录的下标
        if ( rc >= R[j] ) break;
			R[s] = R[j];s = j;// rc应插入在位置s上
	}//for
	R[s] = rc;//插入
}
如何由一个无序序列建成产个堆?
从最后一个非叶子结点开始,以此向前调整:
调整从第n/2个元素开始,将以该元素为根的二叉树调整为堆
将以序号为n/2 -1的结点为根的二叉树调整为堆;
③再将以序号为n/2- 2的结点为根的二叉树调整为堆;
④再将以序号为n/2-3的结点为根的二叉树调整为堆;
直到第一个元素
for ( i = n/2 ; i >= 1; i-- )
	HeapAdjust ( R,i,n );
算法实现
void HeapSort ( elem R[ ] ){//对R[1]到R[n]进行堆排序
	int i;
	for ( i = n/2 ; i >= 1 ; i--)
		HeapAdjust(R,i,n);//建初始堆
	for ( i = n;i > 1;i-- ){//进行n - 1趟排序
		Swap(R[1],R[i] );//根与最后一个元素交换
		HeapAdjust( R,1,i-1);//对R[1]到R[i -1]重新建堆
	}
}
算法性能分析
初始堆化所需时间不超过O(n)
排序阶段(不含初始堆化)
- —次重新堆化所需时间不超过O(logn)
- n-1次循环所需时间不超过O(nlogn)
Tw(n)=O(n)+ O(nlogn)= O(nlogn)
- 堆排序的时间主要耗费在建初始堆和调整建新堆时进行的反复筛选上。堆排序在最坏情况下,其时间复杂度也为O(nlog2n),这是堆排序的最大优点,无论待排序列中的记录是正序还是逆序排列,都不会使堆排序处于"最好"或"最坏"的状态。
- 另外,堆排序仅需一个记录大小供交换用的辅助存储空间。
- 然而堆排序是一种不稳定的排序方法,它不适用于待排序记录个数n较少的情况,但对于n较大的文件还是很有效的。
归并排序
基本思想
将两个或两个以上的有序子序列“归并”为一个有序序列。
在内部排序中,通常采用的是2-路归并排序。
即:将两个位置相邻的有序子序列R[l…m]和R[ m+1…n]归并为一个有序序列R[ l…n]
算法分析
时间效率:O(nlog2n)
空间效率:O(n)
因为需要一个与原始序列同样大小的辅助序列(R1)。这正是此算法的缺点。
稳定性:稳定
基数排序
基本思想
分配+收集
也叫桶排序或箱排序:设置若干个箱子,将关键字为k的记录放入第k个箱子,然后在按序号将非空的连接。


算法分析
时间效率:o(k*(n+m))
k∶关键字个数,
m:关键字取值范围为m个值
空间效率:O(n+m)
稳定性:稳定
总结

图
基本概念和术语
图:G=(V,E) Graph = (Vertex,Edge)
V:顶点(数据元素)的有穷非空集合;
E:边的有穷集合。
无向图:每条边都是无方向的

有向图:每条边都是有方向的

完全图:任意两个点都有一条边相连

对于无向图:
n个顶点,有n*(n-1)/2条边
对于有向图:
n个顶点,有n*(n-1)条边
**稀疏图:**有很少边或弧的图(e<nlogn)。n为顶点个数
稠密图:有较多边或弧的图。
网:边/弧带权的图。
邻接:有边/弧相连的两个顶点之间的关系。
存在(vi, v),则称v,和v,互为邻接点;(不分先后,无序的)
存在,则称vi邻接到vj,vj邻接于vi(有先后关系,有序的)
关联(依附):边/弧与顶点之间的关系。
存在(vi,vj)/ <vi, vj>,则称该边/弧关联于v,和vj
顶点的度:与该顶点相关联的边的数目,记为TD(v)
在有向图中,顶点的度等于该顶点的入度与出度之和。
顶点v的入度是以v为终点的有向边的条数,记作ID(v)
顶点v的出度是以v为始点的有向边的条数,记作OD(v)

问:当有向图中仅1个顶点的入度为0,其余顶点的入度均为1,此时是何形状?
是树!而且是一棵有向树!

路径:接续的边构成的顶点序列。
路径长度:路径上边或弧的数目/权值之和。
回路(环):第一个顶点和最后一个顶点相同的路径。
简单路径:除路径起点和终点可以相同外,其余顶点均不相同的路径。
简单回路(简单环):除路径起点和终点相同外,其余顶点均不相同的路径。

连通图(强连通图):
在无(有)向图G=(V,{E})中,若对任何两个顶点v、u都存在从v到u的路径,则称G是连通图((强连通图)。

权与网
图中边或弧所具有的相关数称为权。表明从一个顶点到另一个顶点的距离或耗费。
子图
设有两个图G=(V,{E}) 、G1= (V1,{E1}),若V1c V,E1 cE,则称G1是G的子图。
连通分量(强连通分量)
无向图G的极大连通子图称为G的连通分量。
极大连通子图意思是:该子图是G连通子图,将G的任何不在该子图中的顶点加入,子图不再连通。

有向图G的极大强连通子图称为G的强连通分量。
极大强连通子图意思是:该子图是G的强连通子图,将D的任何不在该子图中的顶点加入,子图不再是强连通的。

极小连通子图:
该子图是G的连通子图,在该子图中删除任何一条边,子图不再连通
生成树:
包含无向图G所有顶点的极小连通子图。
生成森林:
对非连通图,由各个连通分量的生成树的集合。

类型定义
抽象数据类型定义
ADT Graph{
	数据对象V:具有相同特性的数据元素的集合,称为顶点集。
	数据关系R:R={VR}
	VR={<v,w>|<v,w>| v,w∈V ∧ p(v,w)
	<v,w>表示从v到w的弧,P(v,w)定义了弧<v,w>的信息
	基本操作P:
	Create_Graph():
		图的创建操作。
		初始条件:无。
		操作结果:生成一个没有顶点的空图G。
	GetVex(G, v)∶求图中的顶点v的值。
		初始条件:图G存在,v是图中的一个顶点。
		操作结果:生成一个没有顶点的空图G。
	CreateGraph(&G,V,VR)
		初始条件:V是图的顶点集,VR是图中弧的集合。
		操作结果:按V和VR的定义构造图G。
	DFSTraverse(G)
		初始条件:图G存在。
		操作结果:对图进行深度优先遍历。
	BFSTraverse(G)
		初始条件:图G存在。
		操作结果:对图进行广度优先遍历。
}ADT Graph
存储结构
数组表示法(邻接矩阵)
图没有顺序存储结构,但可以借助二维数组来表示元素间的关系
链式存储结构:
邻接表
多重链表
邻接多重表十字链表
邻接矩阵
建立一个顶点表(记录各个顶点信息)和一个邻接矩阵(表示各个顶点之间关系)。
设图A= (V.A有n个顶点,则

图的邻接矩阵是一个二维数组A. arcs[n][n],定义为:


无向图的邻接矩阵是对称的;
顶点i的度=第i行(列)中1的个数;
特别:(完全图的邻接矩阵中,对角元素为0,其余1.

在有向图的邻接矩阵中,
第i行含义:以结点vi为尾的弧(即出度边);
第i列含义:以结点vi为头的弧(即入度边)。
有向图的邻接矩阵可能是不对称的。顶点的出度=第i行元素之和
顶点的入度=第i冽元素之和
顶点的度=第i行元素之和+第i列元素之和
网的邻接矩阵
定义为:


存储表示:
#define MaxInt 32767//表示极大值,即oo
#define MVNum 100//最大顶点数
typedef char VerTexType;//设顶点的数据类型为字符型
typedef int ArcType;//假设边的权值类型为整型
typedef struct{
	VerTexType vexs[MVNum];//顶点表
	ArcType arcs[MVNum][MVNum];//邻接矩阵
    int vexnum, arcnum;//图的当前点数和边数
}AMGraph; // Adjacency Matrix Graph
创建无向网
算法思想
- 输入总顶点数和总边数。
- 依次输点的信息存人顶点表中。
- 初始化邻接矩阵,使每个权值初始化为极大值。
- 构造邻接矩阵。
算法实现
int LocateVex(AMGraph G,VertexType u){
	int i;
	for(i = 0;i < G.vexnum;i++)
		if(u==G.vexs[i];
			return i;
	return -1;
}
Status CreateUDN(AMGraph *G){
    inti,j,k;
	scanf("%d %d",&G->vexnum,&G->arcnum);//输入总定点数,总边数
    for(i = 0;i < G->vexnum;i++)//依次输入点的信息
        scanf("%d",&G->vexs[i]);
    for(i = 0;i < G->vexnum;i++)//初始化邻接矩阵
        	for(j = 0;j < G->vexnum;j++)
                G->arcs[i][j] = MaxInt;
	for(k = 0;k < G->arcnum;k++){
        int v1,v2;
        ArcType w;
		scanf("%d %d %c",&v1,&v2,&w);//输入一条边所依附的顶点以及边的权值
        i = LocateVex(G,v1);
        j = LocateVex(G,v2);//确认v1和v2在G中的位置
        G->arcs[i][j] = w;
        G->arcs[j][i] = G->arcs[i][j];
    }
    return OK;
}
如何创建无向图、有向网、有向图

优缺点
优点:
- 直观、简单、好理解
- 方便检查任意一对顶点间是否存在边
- 方便找任一顶点的所有“邻接点”(有边直接相连的顶点)
- 方便计算任一顶点的“度”(从该点发出的边数为“出度”,指向该点的边数为“入度”)
- 无向图:对应行(或列)非0元素的个数
- 有向图:对应行非0元素的个数是“出度”;
- 对应列非O元素的个数是“入度”
缺点:
- 不便于增加和删除顶点
- 浪费空间——存稀疏图(点很多而边很少)有大量无效元素
- 浪费时间——统计稀疏图中一共有多少条边
邻接表


顶点:
按编号顺序将顶点数据存储在一维数组中;
关联同一顶点的边(以顶点为尾的弧)∶
用线性链表存储

特点:
-
邻接表不唯一
-
若无向图中有n个顶点(e条边,则其邻接表需n个头结点和2e个表结点。适宜存储稀疏图。
-
无向图中顶点v的度为第i个单链表中的结点数。

特点:
邻接表:
- 顶点vi的出度为第i个单链表中的结点个数。
- 顶点vi的入度为整个单链表中邻接点域值是i-1的结点个数。(找下标是顶点vi的下标的结点个数)
逆邻接表:
- 顶点vi的入度为第i个单链表中的结点个数。
- 顶点vi的出度为整个单链表中邻接点域值是i-1的结点个数。((找下标是顶点vi的下标的结点个数))
存储表示:
顶点结点结构:
typedef struct VNode{
	VerTexType data//顶点信息
	ArcNode * firstarc;//指向第一条依附该顶点的边的指针
}VNode,AdjList[MVNum]; //AdjList表示邻接表类型
弧(边)的结构:
#define MVNum 100//最大顶点数
typedef struct ArcNode{//边结点
	int adjvex;//该边所指向的顶点的位置
	struct ArcNode * nextarc;//指向下一条边的指针
	OtherInfo info;//和边相关的信息
}ArcNode;
图的结构定义:
typedef struct {
	AdjList vertices; //vertices--vertex的复数
	int vexnum, arcnum;//图的当前顶点数和弧数
}ALGraph;
创建无向网
算法思想
-
输入总顶点数和总边数。
-
建立顶点表
- 依次输入点的信息存入顶点表中
- 使每个表头结点的指针域初始化为NULL
-
创建邻接表
- 依次输入每条边依附的两个顶点确定两个顶点的序号i和j,建立边结点
- 将此边结点分别插入到vi和vj对应的两个边链表的头部
算法实现
Status CreateUDG(ALGraph *G){
	scanf("%d %d",&G->vexnum,&G->arcnum);//输入总顶点数、总边数
	int i,k,k;
	for(i = 0;i<G->vexnum;i++){//输入各点,构造表头结点表
		scanf("%d",&G->vertices[i].data);//输入顶点值
		G->vertices[i].firstarc = NULL;//初始化表头结点的指针域
	}
	for(k = 0;k < G->arcnum;k++){
		int v1,v2;
		scanf("%d %d",&v1,&v2);//输入一条边依附的两个顶带你
		i = LocateVex(G,v1);
		j = LocateVex(G,v2);
        ArcNode *p1 = (ArcNode*)malloc(Sizeof(ArcNode));//生成一个新的边界点
   	 	p1->adjvex = j;//邻接点序号为j
   		p1->nextarc = G->vertices[i].firstarc;
   		G->vertices[i].firstarc = p1;//将新结点插入顶点vi的边表头部
    	ArcNode *p2 = (ArcNode*)malloc(Sizeof(ArcNode));//生成一个新的边界点
    	p2->adjvex = i;//邻接点序号为i
    	p2->nextarc = G->vertices[j].firstarc;
    	G->vertices[j].firstarc = p2;//将新结点插入顶点vj的边表头
	}
    return OK;
}
特点
方便找任一顶点的所有“邻接点”节约稀疏图的空间
需要N个头指针+2E个结点(每个结点至少2个域)
方便计算任一顶点的“度”?
对无向图:是的。
对有向图:只能计算“出度”;需要构造“逆邻接表”(存指向自己的边)来方便计算“入度”
不方便检查任意一对顶点间是否存在边
邻接矩阵与邻接表表示法的关系

联系:
邻接表中每个链表对应于邻接矩阵中的一行,链表中结点个数等于一行中非零元素的个数。
区别:
- 对于任一确定的无向图,邻接矩阵是唯一的(行列号与顶点编号一致),但邻接表不唯一(链接次序与顶点编号无关)。
- 邻接矩阵的空间复杂度为O(n2),而邻接表的空间复杂度为O(n+e)。
邻接矩阵多用于稠密图;而邻接表多用于稀疏图
十字链表
十字链表(Orthogonal List)是有向图的另一种链式存储结构。我们也可以把它看成是将有向图的邻接表和逆邻接表结合起来形成的一种链表。
有向图中的每一条弧对应十字链表中的一个弧结点,同时有向图中的每个顶点在十字链表中对应有一个结点,叫做顶点结点。

邻接多重表

遍历
从已给的连通图中某一顶点出发,沿着一些边访遍图中所有的顶点,且使每个顶点仅被访问一次,就叫做图的遍历,它是图的基本运算。
实质:
找每个顶点的邻接点的过程。
图的特点:
图中可能存在回路,且图的任一顶点都可能与其它顶点相通,在访问完某个顶点之后可能会沿着某些边又回到了曾经访问过的顶点。
怎样避免重复访问?
设置辅助数组visited[n ],用来标记每个被访问过的顶点。
- 初始状态visited [i]为0
- 顶点i被访问,改visited[i]为1,防止被多次访问
深度优先遍历(DFS)
- 在访问图中某一起始顶点v后,由v出发,访问它的任一邻接顶点w1;
- 再从w1出发,访问与w邻接但还未被访问过的顶点w2;
- 然后再从W2出发,进行类似的访问,…
- 如此进行下去,直至到达所有的邻接顶点都被访问过的顶点u为止。
- 接着,退回一步,退到前一次刚访问过的顶点,看是否还有其它没有被访问的邻接顶点。
- 如果有,则访问此顶点,之后再从此顶点出发
进行与前述类似的
访问; - 如果没有,就再退回一步进行搜索。重复上述过程,直到连通图中所有顶点都被访问过为止。
连通图的深度优先遍历类似于树的先根遍历
算法实现
邻接矩阵:
void DFS(AMGraph G, int v){//图G为邻接矩阵类型
	int w;
	printf("%d",v);
	visited[v] = true;//访问第v个顶点
	for(w = 0; w<G.vexnum; w++)//依次检查邻接矩阵v所在的行
		if((G.arcs[v][w]!=O)&& (!visited[w]))
			DFS(G, w);//w是v的邻接点,如果w未访问,则递归调用DFS
}
算法效率分析
用邻接矩阵来表示图,遍历图中每一个顶点都要从头扫描该顶点所在行,时间复杂度为O(n^2)。
用邻接表来表示图,虽然有2e个表结点,但只需扫描e个结点即可完成遍历,加上访问n个头结点的时间,时间复杂度为O(n+e)。
结论:
- 稠密图适于在邻接矩阵上进行深度遍历
- 稀疏图适于在邻接表上进行深度遍历
广度优先遍历(BFS)
从图的某一结点出发,首先依次访问该结点的所有邻接顶点Vi, Vi2,… Vin,再按这些顶点被访问的先后次序依次访问与它们相邻接的所有未被访问的顶点
重复此过程,直至所有顶点均被访问为止。

算法实现
非递归:
void BFS (Graph G, int v){//按广度优先非递归遍历连通图G
	int w;
	printf("%d",v);
	visited[v] = true;//访问第v个顶点
	InitQueue(Q);//辅助队列Q初始化,置空
	EnQueue(Q, v);//v进队
	while(!QueueEmpty(Q)){//队列非空
		DeQueue(Q, u);//队头元素出队并置为u
		for(w = FirstAdjVex(G, u);w >= O; w = NextAdjVex(G, u, w))
			if(!visited[w]){//w为u的尚未访问的邻接顶点
				scanf("%d",&w);
				visited[w] = true;
				EnQueue(Q, w);//w进队
		}/ /if
	}//while
}//BFS
算法效率分析
- 如果使用邻接矩阵,则BFS对于每一个被访问到的顶点,都要循环检测矩阵中的整整一行( n个元素),总的时间代价为O(n^2)。
- 用邻接表来表示图,虽然有2e个表结点,但只需扫描e个结点即可完成遍历,加上访问n个头结点的时间,时间复杂度为O(n+e)。
BFS与DFS树算法效率比较
-
空间复杂度相同,都是O(n)(借用了堆栈或队列)
-
时间复杂度只与存储结构(邻接矩阵或邻接表)有关,而与搜索路径无关。
-
用邻接矩阵来表示图,时间复杂度为O(n^2)。
-
用邻接表来表示图,时间复杂度为O(n+e)。
最小生成树
生成树:所有顶点均由边连接在一起,但不存在回路的图。

一个图可以有许多棵不同的生成树所有生成树具有以下共同特点
-
生成树的顶点个数与图的顶点个数相同;
-
生成树是图的极小连通子图,去掉一条边则非连通;
-
一个有n个顶点的连通图的生成树有n-1条边;
-
在生成树中再加一条边必然形成回路。
-
生成树中任意两个顶点间的路径是唯一的;
含n个顶点n-1条边的图不—定是生成树。

无向图的生成树

设图G=(V,E)是个连通图,当从图任一顶点出发遍历图G时,将边集E(G)分成两个集合T(G)和B(G)。其中T(G)是遍历图时所经过的边的集合,B(G)是遍历图时未经过的边的集合。显然,G1(V,T)是图G的极小连通子图。即子图G1是连通图G的生成树。

最小生成树:给定一个无向网络在该网的所有生成树中,使得各边权值之和最小的那棵生成树称为该网的最小生成树也叫最小代价生成树。
构造最小生成树的算法很多,其中多数算法都利用了MST的性质。
MST性质:
设N=(V,E),是一个连通网,U是顶点集V的一个非空子集。若边(u,v)是一条具有最小权值的边,其中u∈U,v∈V-U,则必存在一棵包含边(u, v)的最小生成树。
解释:
在生成树的构造过程中,图中n个顶点分属两个集合:
- 已落在生成树上的顶点集:
- 尚未落在生成树上的顶点集:V-U
接下来则应在所有连通U中顶点和V-U中顶点的边中选取权值最小的边。

构造最小生成树:普利姆(Prim)算法
算法思想:

- 设N=(V,日)是连通网,T正是N上最小生成树中边的集合。
- 初始令U={uo}, (uo∈V),TE={ }。
- 在所有u∈U, v∈ V-U的边(u, v)∈E中,找一条代价最小的边(uo, vo)。
- 将(u0,v0)并入集合TE,同时v0并入U0
- 重复上述操作直至U=V为止,则T=(V,TE)为N的最小生成树
构造最小生成树:克鲁斯卡尔(kruskal)算法
算法思想:

- 设连通网N= (V,E),令最小生成树初始状态为只有n个顶点而无边的非连通图T=(V,{}),每个顶点自成一个连通分量。
- 在E中选取代价最小的边,若该边依附的顶点落在T中不同的连通分量上(即:不能形成环),则将此边加入到T中;否则,舍去此边,选取下一条代价最小的边。
- 依此类推,直至T中所有顶点都在同一连通分量上为止。
最小生成树可能不唯一
两种算法的比较
| 算法名 | 普利姆算法 | 克鲁斯卡尔算法 |
|---|---|---|
| 算法思想 | 选择点 | 选择边 |
| 时间复杂度 | O(n^2) | O(eloge) |
| 适应范围 | 稠密图 | 稀疏图 |
最短路径
问题抽象:在有向网中A点(源点)到达B点(终点)的多条路径中,寻找一条各边权值之和最小的路径,即最短路径。
最短路径与最小生成树不同,路径上不一定包含n个顶点,也不一定包含n-1条边。
第一类:两点间最短路径
用Dijkstra(迪杰斯特拉)算法
Dijkstra(迪杰斯特拉)算法
时间复杂度:O(n^3)
按路径长度递增次序产生最短路径
1.把V分成两组:
(1) S:已求出最短路径的顶点的集合。
(2) T=V - S:尚未确定最短路径的顶点集
2.将T中顶点按最短路径递增的次序加入到S中
保证:(1)从源点vo到S中各顶点的最短路径长度都不大于从Vo到T中任何顶点的最短路径长度。
(2)每个顶点对应一个距离值:
S中顶点:从v到此顶点的最短路径长度。
T中顶点:从v到此顶点的只包括S 中顶点作中间顶点的最短路径长度。


第二类:某原点到其他各点的最短路径
用Floyd(弗洛伊德)算法
Floyd(弗洛伊德)算法
时间复杂度:O(n^3)
算法思想:
- 逐个顶点试探
- 从vi,到vj的所有可能存在的路径中选出一条长度最短的路径
求最短路径的步骤:
- 初始时设置一个n阶方阵,令其对角线元素为0,若存在弧<Vi,Vj>,则对应元素为权值;否则为∞。
- 逐步试着在原直接路径中增加中间顶点,若加入中间顶点后路径变短,则修改之;否则,维持原值。所有顶点试探完毕,算法结束。


有向无环图
无环的有向图(DAG图)

有向无环图常用来描述一个工程或系统的进行过程。(通常把计划、施工、生产、程序流程等当成是一个工程),一个工程可以分为若干个子工程,只要完成了这些子工程(活动),就可以导致整个工程的完成。
AOV网:(拓扑排序)
用一个有向图表示一个工程的各子工程及其相互制约的关系,其中以顶点表示活动,弧表示活动之间的优先制约关系,称这种有向图为顶点表示活动的网,简称AOV网(Activity On Vertex network)。

特点:
- 若从i到j有一条有向路径,则i是j的前驱;j是i的后继。
- 若<i,j>是网中有向边,则i是j的直接前驱;j是i的直接后继。
- AOV网中不允许有回路,因为如果有回路存在,则表明某项活动以自己为先决条件,显然这是荒谬的。
如何判别AOV网中是否存在回路?
对有向图构造其顶点的拓扑有序序列,若网中所有顶点都在它的拓扑有序序列中,则该AOV 网必定不存在环。
拓扑排序
在AOV网没有回路的前提下,我们将全部活动排列成一个线性序列,使得若AOV 网中有弧<i, j>存在,则在这个序列中,i一定排在j的前面,具有这种性质的线性序列称为拓扑有序序列,相应的拓扑有序排序的算法称为拓扑排序。
-
在有向图中选一个没有前驱的顶点且输出之。
-
从图中删除该顶点和所有以它为尾的弧。
-
重复上述两步,直至全部顶点均已输出;或者当图中不存在无前驱的顶点为止
一个AOV网的拓扑序列不是唯一的
AOE网:(关键路径)
用一个有向图表示一个工程的各子工程及其相互制约的关系,以弧表示活动,以顶点表示活动的开始或结束事件,称这种有向图为边表示活动的网,简称为AOE网(Activity On Edge)。
关键路径
完成工程的最短时间是从源点到汇点的最长路径的长度。路径长度最长的路径就叫做 关键路径(Critical Path)。
把工程计划表示为边表示活动的网络,即AOE网,用顶点表示事件,弧表示活动,弧的权表示活动持续时间。

对于AOE网,我们关心两个问题:
(1)完成整项工程至少需要多少时间?
(2)哪些活动是影响工程进度的关键?
转换成求关键路径
如何确定关键路径,需要定义4个描述量:

如何找l(i)== e(i)的关键活动?
设活动ai 用弧<j,k>表示,其持续时间记为: Wj, k
则有:

(1) e(i) = ve(j)(j事件最早发生时间)
(2) l(i) = vl(k) - Wj, k(用k最晚发生时间减去jk边的权值)
如何求ve(j)、vl(j)?
(1)
从ve(1)=0开始向前递推
ve(j) = Max{ve(i)+wi,j},<i,j>∈T,2<=j<=n(即前面一个顶点的最早开始时间加上权值的最大值)其中T是所有以j为头的弧的集合。
(2)
从vl(n) = ve(n)开始向后递推
vl(i) = Min{vl(j)-wi,j},<i,j>∈S。1<=i<=n-1(后面的最晚发生时间减去权值的最小值)
其中s是所有以i为尾的弧的集合。
求关键路径步骤:
1.求ve(i)、vl(j)
2.求e(i)、l(i)
3.计算li) - e(i)
1.若网中有几条关键路径,则需加快同时在几条关键路径上的关键活动。
2.如果一个活动处于所有的关键路径上,那么提高这个活动的速度,就能缩短整个工程的完成时间。如:a1、a4。
3.处于所有的关键路径上的活动完成时间不能缩短太多),否则会使原来的关键路径变成不是关键路径(最早发生时间和最晚发生时间不一样)。这时,必须重新寻找关键路径。
5zZmFsbGJhY2s,shadow_50,text_Q1NETiBAZWtlcnRyZWU=,size_17,color_FFFFFF,t_70,g_se,x_16#pic_center)
- 设连通网N= (V,E),令最小生成树初始状态为只有n个顶点而无边的非连通图T=(V,{}),每个顶点自成一个连通分量。
- 在E中选取代价最小的边,若该边依附的顶点落在T中不同的连通分量上(即:不能形成环),则将此边加入到T中;否则,舍去此边,选取下一条代价最小的边。
- 依此类推,直至T中所有顶点都在同一连通分量上为止。
最小生成树可能不唯一
两种算法的比较
| 算法名 | 普利姆算法 | 克鲁斯卡尔算法 |
|---|---|---|
| 算法思想 | 选择点 | 选择边 |
| 时间复杂度 | O(n^2) | O(eloge) |
| 适应范围 | 稠密图 | 稀疏图 |
最短路径
问题抽象:在有向网中A点(源点)到达B点(终点)的多条路径中,寻找一条各边权值之和最小的路径,即最短路径。
最短路径与最小生成树不同,路径上不一定包含n个顶点,也不一定包含n-1条边。
第一类:两点间最短路径
用Dijkstra(迪杰斯特拉)算法
Dijkstra(迪杰斯特拉)算法
时间复杂度:O(n^3)
按路径长度递增次序产生最短路径
1.把V分成两组:
(1) S:已求出最短路径的顶点的集合。
(2) T=V - S:尚未确定最短路径的顶点集
2.将T中顶点按最短路径递增的次序加入到S中
保证:(1)从源点vo到S中各顶点的最短路径长度都不大于从Vo到T中任何顶点的最短路径长度。
(2)每个顶点对应一个距离值:
S中顶点:从v到此顶点的最短路径长度。
T中顶点:从v到此顶点的只包括S 中顶点作中间顶点的最短路径长度。
第二类:某原点到其他各点的最短路径
用Floyd(弗洛伊德)算法
Floyd(弗洛伊德)算法
时间复杂度:O(n^3)
算法思想:
- 逐个顶点试探
- 从vi,到vj的所有可能存在的路径中选出一条长度最短的路径
求最短路径的步骤:
- 初始时设置一个n阶方阵,令其对角线元素为0,若存在弧<Vi,Vj>,则对应元素为权值;否则为∞。
- 逐步试着在原直接路径中增加中间顶点,若加入中间顶点后路径变短,则修改之;否则,维持原值。所有顶点试探完毕,算法结束。
有向无环图
无环的有向图(DAG图)
有向无环图常用来描述一个工程或系统的进行过程。(通常把计划、施工、生产、程序流程等当成是一个工程),一个工程可以分为若干个子工程,只要完成了这些子工程(活动),就可以导致整个工程的完成。
AOV网:(拓扑排序)
用一个有向图表示一个工程的各子工程及其相互制约的关系,其中以顶点表示活动,弧表示活动之间的优先制约关系,称这种有向图为顶点表示活动的网,简称AOV网(Activity On Vertex network)。
特点:
- 若从i到j有一条有向路径,则i是j的前驱;j是i的后继。
- 若<i,j>是网中有向边,则i是j的直接前驱;j是i的直接后继。
- AOV网中不允许有回路,因为如果有回路存在,则表明某项活动以自己为先决条件,显然这是荒谬的。
如何判别AOV网中是否存在回路?
对有向图构造其顶点的拓扑有序序列,若网中所有顶点都在它的拓扑有序序列中,则该AOV 网必定不存在环。
拓扑排序
在AOV网没有回路的前提下,我们将全部活动排列成一个线性序列,使得若AOV 网中有弧<i, j>存在,则在这个序列中,i一定排在j的前面,具有这种性质的线性序列称为拓扑有序序列,相应的拓扑有序排序的算法称为拓扑排序。
-
在有向图中选一个没有前驱的顶点且输出之。
-
从图中删除该顶点和所有以它为尾的弧。
-
重复上述两步,直至全部顶点均已输出;或者当图中不存在无前驱的顶点为止
一个AOV网的拓扑序列不是唯一的
AOE网:(关键路径)
用一个有向图表示一个工程的各子工程及其相互制约的关系,以弧表示活动,以顶点表示活动的开始或结束事件,称这种有向图为边表示活动的网,简称为AOE网(Activity On Edge)。
关键路径
完成工程的最短时间是从源点到汇点的最长路径的长度。路径长度最长的路径就叫做 关键路径(Critical Path)。
把工程计划表示为边表示活动的网络,即AOE网,用顶点表示事件,弧表示活动,弧的权表示活动持续时间。
对于AOE网,我们关心两个问题:
(1)完成整项工程至少需要多少时间?
(2)哪些活动是影响工程进度的关键?
转换成求关键路径
如何确定关键路径,需要定义4个描述量:
如何找l(i)== e(i)的关键活动?
设活动ai 用弧<j,k>表示,其持续时间记为: Wj, k
则有:
(1) e(i) = ve(j)(j事件最早发生时间)
(2) l(i) = vl(k) - Wj, k(用k最晚发生时间减去jk边的权值)
如何求ve(j)、vl(j)?
(1)
从ve(1)=0开始向前递推
ve(j) = Max{ve(i)+wi,j},<i,j>∈T,2<=j<=n(即前面一个顶点的最早开始时间加上权值的最大值)其中T是所有以j为头的弧的集合。
(2)
从vl(n) = ve(n)开始向后递推
vl(i) = Min{vl(j)-wi,j},<i,j>∈S。1<=i<=n-1(后面的最晚发生时间减去权值的最小值)
其中s是所有以i为尾的弧的集合。
求关键路径步骤:
1.求ve(i)、vl(j)
2.求e(i)、l(i)
3.计算li) - e(i)
1.若网中有几条关键路径,则需加快同时在几条关键路径上的关键活动。
2.如果一个活动处于所有的关键路径上,那么提高这个活动的速度,就能缩短整个工程的完成时间。如:a1、a4。
3.处于所有的关键路径上的活动完成时间不能缩短太多),否则会使原来的关键路径变成不是关键路径(最早发生时间和最晚发生时间不一样)。这时,必须重新寻找关键路径。

 1270


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


