Linux memcg lru lock提升锁性能

Linux内核内存管理之页框管理 虽然如此,但是实际上系统使用内存时还是倾向于分配连续的内存块,因为分配连续内存时,页表不需要更改,因此能降低TLB的刷新率。在 linux 2.6 版本内核中支持一种 NUMA(非一致内存访问) 模型, 它支持根据CPU对不同内存单元访问时间的不同,将物理内存划分为不同的节点,每个节点中,指定CPU对节点内任意内存单元访问时间都是相同的。从上面可以看出,不管是对于单页回收时,页高速缓存中页数过多,还是多页回收的情况,最终都是通过了 free_pages_bulk 函数,将这些页框释放给伙伴系统。 阅读详情

目录

内核关于per memcg lru lock的重要提交:

计算虚拟地址转换基本机制

问题背景

swap换入流程

时奎亮的per memcg lru lock分享视频


内核关于per memcg lru lock的重要提交:

f9b1038ebccad354256cf84749cbc321b5347497

6168d0da2b479ce25a4647de194045de1bdd1f1d

计算虚拟地址转换基本机制

为了处理多应用程序的地址冲突, linux 系统在应用中使用了虚拟地址,得益于硬件的MMU的广泛使用,虚拟地址到实际内存的物理地址转化变得快速很多。
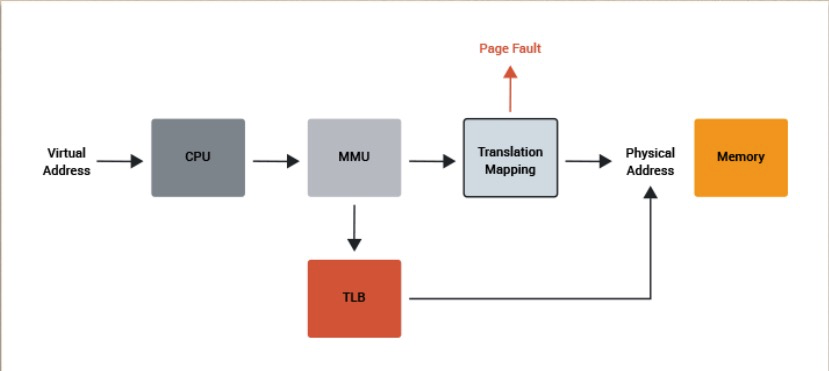
当虚拟地址送到cpu中后, 系统先前检查TLB表中是否有这个地址, 如果有,直接返回物理地址, 如果没有就去检查PageTable, 如果pagetable中也没有这个地址,系统产生一个page fault,来给这个地址实际分配物理内存。

每个应用的page table 保存了虚拟地址到物理地址一一对应表, 示意图如下所示:

Page fault 在linux中采用了称之为lazy fault的处理策略, 就是申请内存时并不实际分配物理内存, 直到实际使用这块内存时才实际分配内存。例如,得益于linux共享内存的设计,如果应用申请的share lib已经被其他程序实际分配到内存。 那么后来的应用只要在pagetable中填上对应的页表项就好。不需要发生实际的IO,这个过程叫做 minor fault. 第一个使用share lib的应用因为需要把share lib的内容读到内存, 需要有IO 的参与, 称之为Major fault.

问题背景

自电子计算机诞生以来,内存性能一直是行业关心的重点。内存也随着摩尔定律,在大小和速度上一直增长。现在的云服务器动辄单机接近 TB 的内存大小,加上数以百记的 CPU 数量也着实考验操作系统的资源管理能力。

作为世间最流行的操作系统 Linux, 内核使用 LRU(Last Recent Used)链表来管理全部用户使用的内存,用一组链表串联起一个个的内存页,并且使用 lru lock 来保护链表的完整性。

所有应用程序常用操作都会涉及到 LRU 链表操作,例如,新分配一个页,需要挂在 inactive lru 链上, 2 次访问同一个文件地址, 会导致这个页从 inactive 链表升级到 active 链表, 如果内存紧张, 页需要从 active 链表降级到inactive 链表, 内存有压力时,页被回收导致被从 inactive lru 链表移除。不单大量的用户内存使用创建,回收关系到这个链表, 内核在内存大页拆分,页移动,memcg 移动,swapin/swapout, 都要把页移进移出 lru 链表。

可以简单计算一下 x86 服务器上的链表大小:x86 最常用的是 4k 内存页, 4GB 内存会分成 1M 个页, 如果按常用服务器 256GB 页来算, 会有超过 6 千万个页挂在内核 lru 链表中。超大超长的内存链表和频繁的 lru 操作造成了 2 个著名的内核内存锁竞争, zone lock 和 lru lock。这 2 个问题也多次造成麻烦,系统很忙,但是业务应用并没得到多少 cpu 时间, 大部分 cpu 都花在 sys 上了。一个简单 2 次读文件的 benchmark 可以显示这个问题, 它可以造成 70% 的 cpu 时间花费在 LRU lock 上。https://git.kernel.org/pub/scm/Linux/kernel/git/wfg/vm-scalability.git/tree/case-lru-file-readtwice

作为一个知名内核性能瓶颈, 社区也多次尝试以各种方法解决这个问题, 例如,使用更多的 LRU list, 或者 LRU contention 探测(https://lwn.net/Articles/753058/)。

但是都因为各种原因被 Linux 内核拒绝。

swap换入流程
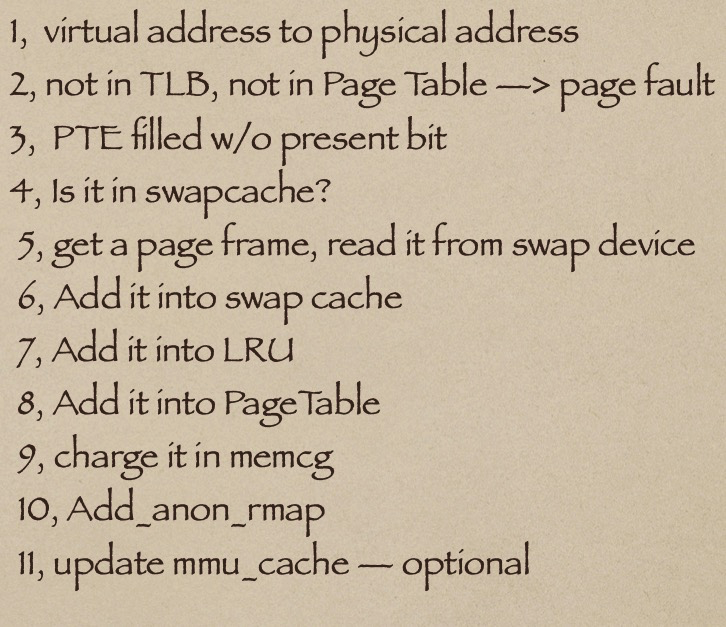
cpu接到访问一个虚拟地址的命令, cpu需要把这个虚拟地址转化成物理地址,于是先去访问TLB,如果命中TLB,返回物理地址, 如果没有继续访问页表,如果命中页表, 返回物理地址, 如果没有命中, 产生page fault, 在page fault处理程序中,发现,虚拟地址对应的页表项虽然present bit 为零但是内容非空,所以这个地址在一个被交换到swap设备的页中。继续检查,这个页是否在swapcache中,如果在,返回这个页地址加虚拟地址地址在页中的偏移,如果不在,获得一个内存页, 到swap设备上读取内容填到这个页,此处产生IO, 为Major page fault. 接下了就上把这个页加到swapcache,加入 LRU, 加入page table, 关联到所属的memcg, 并且添加反向映射,然后用户就可以正常使用了。 最后在某些机器上在更新mmu cache.(spark/ppc)

linux kernel 使用LRU来管理内存页。 Last Recent Used.  内核页管理方式如下图所示:
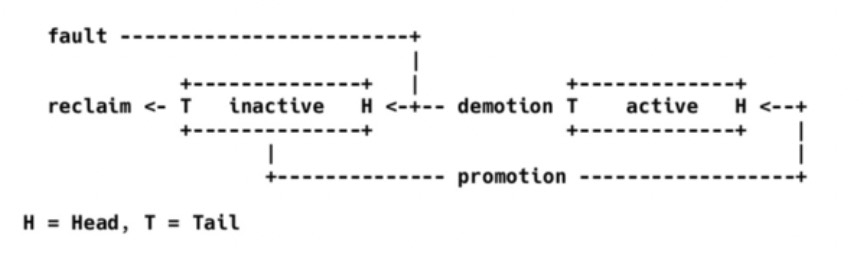
lru 由2个链表组成,一个是inactive list, 另一个是active list, page fault新产生的页加到inactive list的头上, 二次访问到的页从inactive list上提升到active list上, 如果内存有压力回收时,active list的页降级的inactive list, inactive list页从尾巴上回收掉。

lru 页管理涉及到的内核数据有3个,per node 上的 Lru_lock, page.flags上的 PG_lru bit 和per node 5个链表。linux 把所有用户使用的内存页都放在5个链表上, inactive anon, active anon, inactivec file, active file and unevictable list.  

Lru_lock保护的对象有6个, 
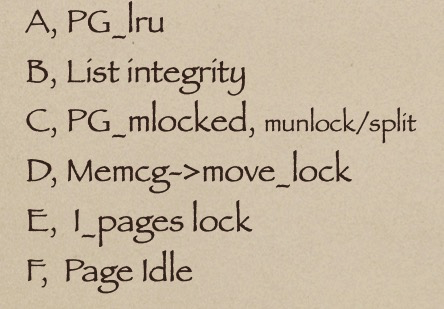
加锁保护的时机如下:
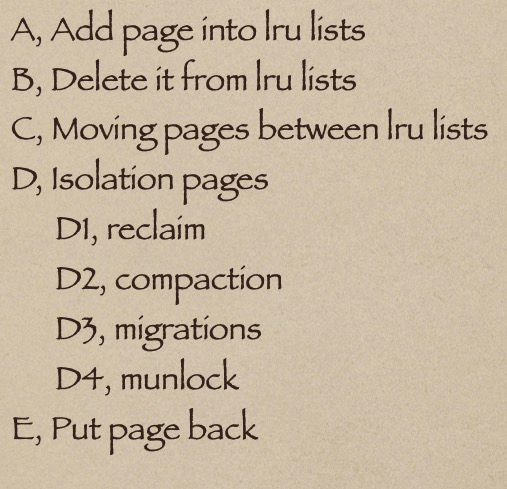
在2008年以前, memcg加入内核之前, 内核使用一个per node lru_lock保护per node的lru lists.
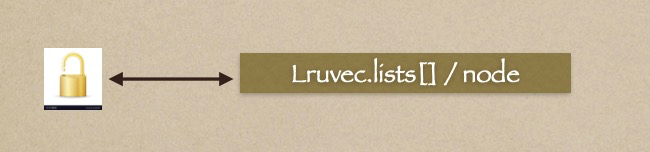
当memcg引入内核后, lru list改成了 per memcg的模式,每个memcg都有一组lru lists.

当每个memcg的页共同还在同一个lru lock上竞争时, 显然不如给每个memcg一个lru lock, 这样lock contention就会大大减小。
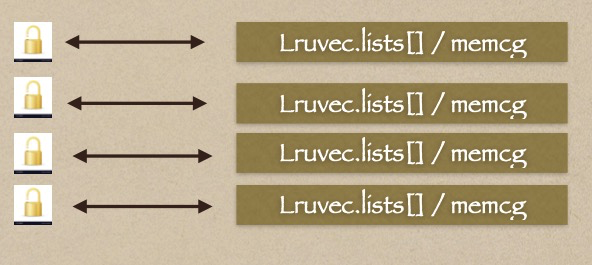
使用per memcg 的 lru_lock, 要先解决一个问题: 内存页不会一直在一个memcg上固定不变, 页也许会被移动到其他的memcg上, 也许memcg会销毁。 所以使用per memcg lru lock的关键就是如何在在lru lock 锁定期间 保证memcg固定。
开始很直接想到的是relock方案:

page在memcg之间移动要获得lru_lock, 所以lru_lock relock可以保护page在memcg之间的移动, 但是回顾上面读取swap device的例子, 我们会在关联memcg之前加入lru list, 这个导致页所属的memcg不稳定, 因而会拿错Lru_Lock 。解决的根本是改变页加入lru list和memcg的次序:如下所示,先关联memcg, 然后在加入lru list.
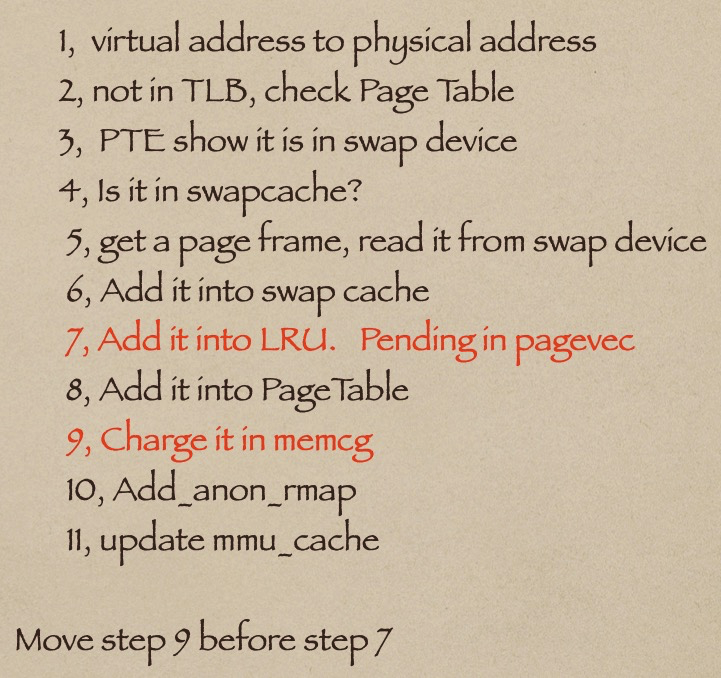
关键步骤更新后,页管理中的锁的使用次序页可以改变了:
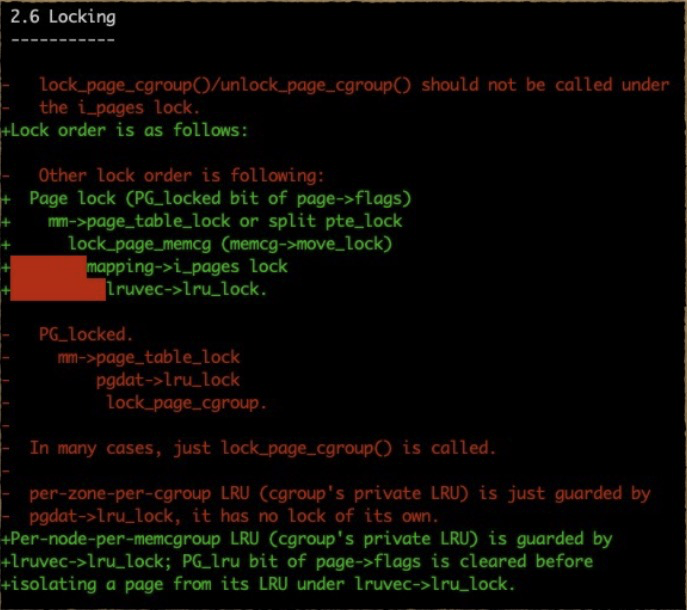
relock方案是可以用了。 但是relock 增加了lock 排队的机会 会导致性能下降。

更好的办法是不用lru_lock 保护memcg change, 比如拿出PG_lru bit做互斥: 原本的page isoaltion次序是: 
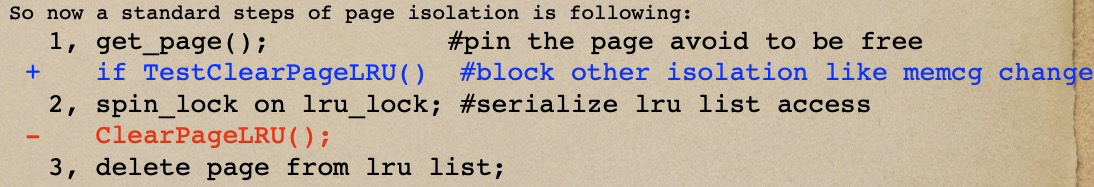
get_page; get lru_lock; clear page lru; delete page from lru list. 新的方法是,
get_page; TestClearPageLRU; get lru_lock; delete page from lru list. page isolation互斥从lru lock上移到PG_bit, 通过线性获得PG_lru bit来保证。lru lock只用来保证list的完整性。加上一些code clean up. 新的lru lock保护对象只保留了 lists.
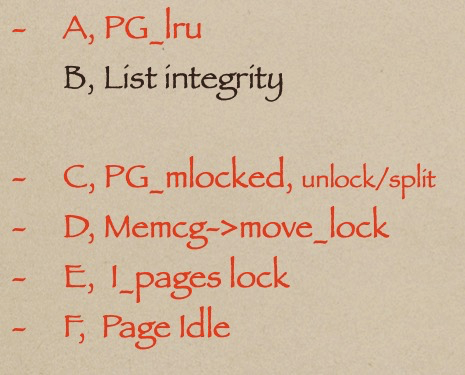
另外lru_lock使用时机还是不变。

时奎亮的per memcg lru lock分享视频

Linux Kernel Page Management and Iru List Locking Optimization - OpenAnolis龙蜥操作系统开源社区

AI生产环境故障根因:基础设施层隐性失配解析 AI系统在生产环境中频繁出现延迟突增、精度下降、OOM等异常,并非模型本身缺陷,而是底层基础设施与AI工作负载之间存在隐性失配。其本质源于Linux内存管理、CPU调度策略、网络栈参数、存储IO行为以及时钟同步机制等物理与内核层约束未被适配。这类问题具有高隐蔽性、低可观测性、强环境依赖性等特点,传统MLOps工具链普遍缺乏对cgroup v2、NUMA拓扑、eBPF可观测性及硬件微架构影响的建模能力。本书聚焦AI工程化中最易被忽视的‘基础设施土壤’,通过真实P0事故还原、内核级诊断脚本与可验证调优清单,帮助 阅读详情

相关推荐

01 openEuler操作系统介绍

openEuler是一款开源操作系统。当前openEuler内核源于Linux,支持鲲鹏及其它多种处理器,能够充分释放计算芯片的潜能,是由全球开源贡献者构建的高效、稳定、安全的开源操作系统,适用于数据库、大数据、云计算、人工智能等应用场景。同时,openEuler是一个面向全球的操作系统开源社区,通过社区合作,打造创新平台,构建支持多处理器架构、统一和开放的操作系统,推动软硬件应用生态繁荣发展。openEuler的前身是运行在华为公司通用服务器上的操作系统EulerOS。

超哥的博客 6139

memcg lru lock 血泪史

背景自电子计算机诞生以来,内存性能一直是行业关心的重点。内存也随着摩尔定律,在大小和速度上一直增长。现在的阿里云服务器动辄单机接近TB的内存大小,加上数以百记的CPU数量也着实考验操作系...

宋宝华 1700

linux那些事之LRU(4)

当物理内存实际比较紧张时,内存水位处于较低water level时,会触发间接回收内存kswapd或者直接回收内存,从inactive LRU list中将不常用的内存 置换到内存中。 vmscan系统提供shrink_inactive_list接口,用于将inactive LRU list中的页面置换出去功能。 ...

weixin_42730667的博客 2038

多线程---锁策略、CAS、锁的优化

ABA问题:假设有两个线程t1 和 t2,有一个变量 num 值为A,当线程t1使用CAS对num进行修改的时候会判定sum里的值是否为A当为A的时候才会进行交换,但是有可能当 t1 在执行的时候,t2把num的值从。当2个线程都是写锁或者1个线程是读锁1个线程是写锁的时候,线程之间互斥,由于互斥会引起线程等待,所以减少互斥就能提高程序效率,当要修改数值的时候,会先比较 V 与 A 的值,当 V 与 A 的值相等的时候(说明没有别的线程修改过数据)才会让V 与 B 交换 (相当于赋值),否则不做任何操作。

Milliliter___的博客 790

linux那些事之LRU(1)

一个物理页被分配之后,page其所挂载的链表从buddy空闲链表中摘除,会进入到active 或者inactive链表中,当物理内存water mark存在压力时会根据LRU(least recently unsed)策略将很久没有使用的物理页内存swap或者写入到磁盘中,以便将该页空闲出来供其分配使用。 在各种服务器中应用程序 为了提高性能,大都使用内存密集性策略,因此随着长时间使用或者较多服务时会出现内存压力,因此采用合理策略从正在使用的物理页中选出合适的物理内存swap到磁盘中,以供分配使用,显得特

weixin_42730667的博客 3375

GOM Correlate拉伸试验后处理操作

本文描述了使用GOM Software 2022对拉伸试样进行后处理的操作,包括设置检测点、引伸计、输出应变数据到表格、输出报告为视频等

qq_45008924的博客 4661

一次关于读写锁的探索

在最近的一次goroutine数量过高(1w+)问题的排查中,发现大部分goroutine都阻塞在锁上,pprof如下。goroutine数量过多的问题是因为在执行异步任务时无脑的go func(),这个问题在本篇中就不讲了。阻塞在锁上是因为在异步任务链路中存在一次rpc请求,并且对该rpc请求的结果使用了lru的本地缓存,很多goroutine都阻塞在lru的锁上。 在典型的双链表实现的lru中,Get和Set都需要加互斥锁,因为在Get操作中涉及到了链表顺序的调整。本篇中,我尝试实现一种使用读写锁的Lr

shanxiaoshuai的博客 775

UniApp消息推送进阶:不用插件实现动态语音播报(含保活策略)

本文详细介绍了在UniApp中实现动态语音播报的进阶方案,无需依赖第三方插件。核心采用透传消息传递动态数据,结合本地TTS引擎合成语音,并针对不同安卓厂商提供了深度通道配置与差异化保活策略,有效解决了App退至后台或被清理后语音播报失效的难题。

weixin_29224309的博客 486

4个内核狂热分子今天又卷了一天

原先Patchset提出的设想是,在I/O等待的page fault retry路径上采用per-vma lock替换mmap_lock锁,以缓解rwsem锁的优先级翻转,而Matthew Wilcox提出这个方法可能没有修复Google的一个问题:memcg超载后,第一次page fault虽然给I/O申请了folio,但是retry PF近来的时候,folio已经被LRU回收,于是导致workload无法推进!建模,把复杂的问题能通过简单的模型说清楚,这是解决问题的最关键一步!

宋宝华 717

英飞凌 AURIX 系列单片机的HSM详解(1)——何为HSM

1. 概述 随着汽车上通信系统越来越复杂,云端远程通信的场景越来越多,信息安全变得越来越重要,在通信领域常用的AES、SHA、RSA等加密算法被越来越多地应用到汽车上。但通常这类加解密算法都需要大量的数学运算,需要消耗很多CPU时间和资源,汽车上的ECU又有比较高的实时性要求,为了节省主CPU的资源,HSM应运而生。 HSM(Hardware Security Module),是MCU上专门用于实现加解密算法的一个外设,它一般会有一个独立的CPU,专门用来进行加解密运算,还有一些针对特定算法的硬件加速器(如

weixin_42967006的博客 4万+

Synopsys逻辑工艺库(DC综合)

逻辑库包括仅与综合过程有关的信息且通过DC用于设计的综合和优化。这一信息包括引脚到引脚的时序、面积、引脚类型和功耗以及其他DC需要的必须数据。逻辑库是一个文本(通常扩展名".lib"),通过使用Library Compiler(LC)编译生成带有扩展名名".db"的二进制文件。以SMIC的逻辑综合库为例:库文件下载地址。

baidu_34971492的博客 2422

Linux 6.18 内存管理:整体架构与地址映射

启动期分配器 memblock:内核启动早期、伙伴系统尚未建立时,用 memblock 管理物理内存的预留与分配。伙伴系统(Buddy Allocator):内核正常运行后的物理页框分配核心。物理内存按 node(NUMA 节点)→ zone(ZONE_DMA / ZONE_DMA32 / ZONE_NORMAL / ZONE_HIGHMEM 等)→ page(页框) 三级组织;每个 zone 内维护 0~10 阶的空闲页块链表,分配 2ⁿ 个连续页,合并/分裂对抗外部碎片。

weixin_43228946的博客 320

Three 之 three.js (webgl)绘制物体模型尺寸虚线包围框工具简单封装 DashLinesBoxTool

Three js 开发的一些知识整理,方便后期遇到类似的问题,能够及时查阅使用。本节介绍, three.js (webgl) 中绘制物体模型尺寸虚线包围框工具简单封装 DashLinesBoxTool,主要是给实物绘制线框,有点像AI 识别正方形包裹框的效果。其中,如果有不足之处,欢迎指出,或者你有更好的方法,欢迎留言。

仙魁XAN 2106

linux内存源码分析 - 内存回收(lru链表)

概述   对于整个内存回收来说,lru链表是关键中的关键,实际上整个内存回收,做的事情就是处理lru链表的收缩,所以这篇文章就先说说系统的lru链表。   内存回收的核心思想,就是如果一些数据能够保存到磁盘,在内存不足时就把这些数据写到磁盘中,这样这些数据占用的内存页就可以作为空闲内存页给予系统使用了。   当内存不足时,系统就必须要将一些页框回收,而哪些页框可以回收呢,之前我们

华的专栏 1162

Qt项目开发实例 (含源码)

qt教程、qt项目、qt下载、qt项目实战、qt多线程。本文通过分析demo源码,QT实战的方式进行学习,学习路线是以实战为目录,全面的使用自己的学习知识,文章中编写一系列的学习游戏demo,与大家一起分享。

啊渊的专栏 14万+

SIWAVE+ADS提取PCB走线寄生参数

本文将介绍一种很适合PCB走线提取寄生电感等参数的方法,即是通过SIWAVE将PCB走线的S参数提取出来,再通过ADS将S参数转换成电感、电容值。

sinat_15150363的博客 1763

带锁的线程安全的LRULinkedHashMap简单实现

import java.util.LinkedHashMap; import java.util.concurrent.locks.Lock; import java.util.concurrent.locks.ReentrantLock; public class LRULinkedHashMap extends LinkedHashMap { /** * */ private

萌萌小七的专栏 5409

fast-lio系列改进版本

2.回环检测的优化结果,更新到FAST-LIO2的当前帧位姿中,幷进行ikdtree的重构,进而更新submap。其它的效果还不清楚,实测lio部分稳定性很好。用fast-lio_slam就很稳定。融合了fast-lio2和sc-pgo,两部分分开运行,SC-PGO从FAST-LIO2节点获取里程计和激光雷达点云主题。的作者kim在FAST-LIO2的基础上,添加SC-PGO模块,通过加入ScanContext全局描述子,进行回环修正,SC-PGO模块与FAST-LIO2解耦,非常方便,很优秀的工作。

z1872385的博客 3189

ConcurrentHaspLRUHashMap实现初探

ConcurrentHaspLRUHashMap实现初探一、关于LRU。LRU即LeastRencetlyUsed(最近最少使用)缓存替换策略。在任何LRU算法中,它必定有以下两个策略组成:1、退化策略。根据访问情况,对节点按热度进行排序(hot->cold),以便决定哪些节点是热节点(hot)的,哪些节点是冷节点(cold)的。这个退化的策略,一般按以下两种方式去处理...

weixin_34233679的博客 667

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Lru cache算法以及他的锁的问题

Lru cache codes: 1. use double linked list for LRU. 2. For the lock using System; using System.Collections.Generic; using System.Text; namespace LruCache_20170421 { public class LruCache {

fyifei0558的专栏 699

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

理解 Linux 动态库加载:LD_LIBRARY_PATH

flyfish

二分掌柜的 331

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Linux 磁盘满了怎么排查?df / du / find 三步定位大文件

Linux 磁盘满排查三步法:df -h 定位分区、du 逐层下钻、find 按大小和时间抓大文件,附 inode 耗尽、文件已删未释放、du 与 df 不一致等经典坑的解决方案。

weixin_38291577的博客 218

Linux-iostat命令详解

Linux命令学习记录

m0xin的博客 97

Linux 服务器性能排查手册(2026):CPU、内存、磁盘IO、网络四大瓶颈定位

iptables 四表五链模型、firewalld zone 信任级别、云安全组与主机防火墙的关系与优先级,避坑改了防火墙把自己挡在服务器外面的翻车事故。

2502_91473995的博客 287

【Linux】APT 本地 deb 安装与 `-f` 参数总结笔记

apt install ./xx.deb 可自动解析并安装依赖,无需 -f;-f 仅用于修复已损坏的依赖状态,非首次安装时必需。apt install -f 可单独运行,修复 broken dependencies。两者职责不同:前者是安装与依赖解决,后者是故障修复。完全离线时需提前准备依赖包或本地源。

hknaruto的专栏 209

Linux rm 误删文件恢复实操教程

Linux使用rm删除文件时,并不会直接抹除磁盘上的数据,只是移除文件索引,让系统不再识别这块空间。只要没有写入新数据,原有扇区内容就会保留。新文件写入才有可能覆盖这些区域,一旦覆盖就很难找回。恢复的本质就是扫描磁盘,找到这些还存在、但索引丢失的数据条目,再把它们导出保存到其他分区。越早停止写入,恢复成功的概率越高。

海天数据恢复-winhex数据恢复教程 224
上一篇: Linux per memcg lru lock
下一篇: 从设备驱动的角度看电源管理
OS技术解密
博客等级 码龄16年 3760粉丝 189原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值