如何衡量数据模型复用度

软件项目工作量估算之软件复用程度分析 软件工作量估算是我们在对一个软件项目成本估算过程中,在完成软件规模估算后需要进行的第2项估算工作。在软件项目工作量估算过程中,我们除了要进行风险分析外,还要考虑软件复用的程度。 软件复用就是将已有的软件成分用于构造新的软件系统。在现代的软件开发过程中,为了提高效率和质量,大部分软件企业都已将某些通用功能转化为可重用功能,或者开发组织具备某方面项目的开发经验,遗留下了可以复用的组件,这些情况都可能降... 阅读详情

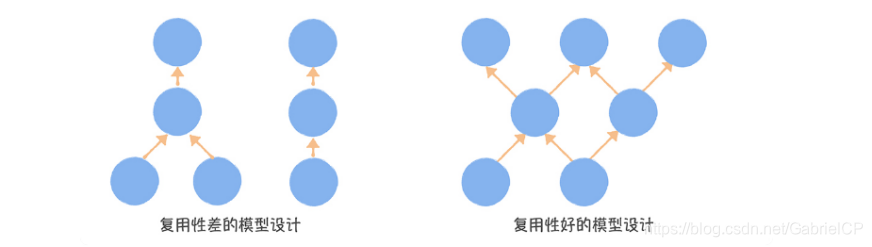
数据中台模型设计的核心是追求模型的复用和共享,通过元数据中心的数据血缘图,我们可以看到,一个比较差的模型设计,自下而上是一条线。而一个理想的模型设计,它应该是交织的发散型结构。
在这里插入图片描述

用模型引用系数作为指标,衡量数据中台模型设计的复用度。引用系数越高,说明数仓的复用性越好。
模型引用系数:一个模型被读取,直接产出下游模型的平均数量。
比如一张 DWD 层表被 5 张 DWS 层表引用,这张 DWD 层表的引用系数就是 5,如果把所有 DWD 层表(有下游表的)引用系数取平均值,则为 DWD 层表平均模型引用系数,一般低于 2 比较差,3 以上相对比较好(经验值)。

Hive基础面试-如何理解复用率的 事实表(Fact Table)是指存储有事实记录的表,如系统日志、销售记录等;事实表的记录在不断地动态增长,所以它的体积通常远大于其他表。事实表作为数据仓库建模的核心,需要根据业务过程来设计,包含了引用的维度和业务过程有关的度量。可加:最灵活最有用的事实是完全可加,可加性度量可以按照与事实表关联的任意维度汇总。比如消费总金额半可加:半可加度量可以对某些维度汇总,但不能对所有维度汇总。差额是常见的半可加事实,除了时间维度外,他们可以跨所有维度进行操作。(比如每天的余额加起来毫无意义) 阅读详情

相关推荐

0004-1-模型好坏评判标准

一 完善度 汇总数据能直接满足多少查询需求,即应用层访问汇总层数据的查询比例 跨层引用率:ODS 层直接被 DWS/ADS/DM 层引用的表,占所有 ODS 层表(仅统计活跃表)比例 快速响应业务方的需求 比较好的模型,使用方是可以直接从该模型获取所有想要的数据的,如果dws,ads,dm层直接引用ods层的表比例太大,即跨层引用率太高,则该模型不是最优,可以继续优化 二 复用度 模型引用系数:模型被读取并产出下游模型的平均数量 三 规范度 主题域归属 分层信息 脚本及任务明明规范 表命..

我的祖传代码 1589

如何判断一个数据模型的好坏?数据仓库的 KPI 怎么定?

一、数仓模型优化-如何判断一个数据模型的好坏 1.完善度 汇总数据能直接满足多少查询需求,即应用层访问汇总层数据的查询比例 跨层引用率:ODS层直接被DWS/ADS/DM层引用的表,占所有ODS层表比例 可以快速响应业务方的需求 比较好的模型,使用方式是可以直接从该模型获取所有想要的数据的,如果DWS,ADS,DM层直接引用ODS层的表比例太大,即跨层引用率太高,则该模型不是最优,可以继续优化 2.复用度 模型引用系数:模型被读取并产出下游模型的平均数量 3.规范度 主题域归属...

数智技术 5034

MATLAB算法实战应用案例精讲-【数模应用】数据中台模型建设

企业数据中台是在大数据发展背景下,为了解决当前企业在业务建设过程中遇到的“数据孤岛”、“系统孤岛”问题,而提出的一种数据服务运营平台。它基于业务能力沉淀出底层数据资产,面向多个业务领域和不同行业进行服务输出。它是企业数字化转型过程中最重要的基础设施之一,也是当前业界比较流行的业务数字化转型战略。中台不仅代表着一种技术能力,更代表了一种能力:将复杂的数据分析与应用拆解成最小组成单元,以满足不同行业、不同类型客户业务需求及快速响应市场变化,帮助公司提升客户满意度并降低成本。

qq_36130719的博客 345

数据中台:数据模型设计

如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例:⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计算指标。由于他们⼤多是⾮技术专业出⾝,写的SQL质量⽐较差,甚⾄⻅过5层以上的嵌套。这种SQ...

huzechen的博客 1840

【数据中台】06 | 数据模型无法复用,归根结底还是设计问题

上一节课,我带你了解了数据中台如何管理指标,如果我们把指标比喻成一棵树上的果实,那模型就是这棵大树的躯干,想让果实结得好,必须让树干变得粗壮。先来看一幕真实的场景。大多数公司的分析师会结合业务做一些数据分析(需要用到大量的数据),通过报表的方式服务于业务部门的运营。但是在数据中台构建之前,分析师经常发现自己没有可以复用的数据,不得不使用原始数据进行清洗、加工、计算指标。由于他们大多是非技术专业出身,写的 SQL 质量比较差,我甚至见过 5 层以上的嵌套。这种 SQL 对资源消耗非常大,会造成队列阻塞,影响其

m0_54252387的博客 748

SAP面试全过程(已拿offer)

周五打电话给我说过了SAP第一轮面试,第二轮要在下周四北京,这几天终于体会到了什么叫做重压下的感觉,越复习越虚,看别人的面经都感觉卧槽这问题也巨难了吧...连去北京可以见妹子这种事情都感觉一点心情都没有。面前准备固然是要有的,但关键是平时就要有料,多想想自己做的项目。当作一个给自己的提醒吧!

cloudray8580的专栏 4万+

数据模型无法复用?归根到底谁来“背锅”?

摘要:通过本文的学习你将收货一些实实在在的干货,尤其对于数仓的小伙伴而言,我相信会有一些新的的认识。本文主要内容包括:1、什么才是好的数据模型2、如何衡量模型的完善...

学而知之@的博客 1054

别再只当代码阅读器了!手把手教你用Understand的实体定位器和信息浏览器,5分钟精准定位代码逻辑

本文深入解析Understand代码分析工具的高级功能,重点介绍实体定位器和信息浏览器的实战应用。通过5分钟快速定位代码逻辑的技巧,帮助开发者从代码阅读者升级为逻辑侦探,提升大型代码库的分析效率。文章包含过滤搜索、调用链追踪等实用方法,是掌握Understand核心功能的必备指南。

weixin_28745821的博客 292

数据中台实战(06)-数据模型无法复用,归根结底还是设计问题

本文详细讲解数据中台的模型设计。从确立设计目标,到通过一系列步骤,将一个个分散杂乱、烟囱式小数仓逐步规整到一个可复用共享的数据中台,最后通过产品化实现系统化的管理。完善度、复用度和规范度构成衡量数据中台模型设计的度量体系,可助你评估数仓设计好坏维度设计是维度建模的灵魂,也是数据中台模型设计的基础,维度设计的核心是构建一致性维度事实表的统计粒度须保持一致,不同统计粒度的数据不能出现在同一事实表数据中台构建需半年一年,但数据中台建成后,研发效率提升明显。

JavaEdge全是干货的技术号 576

从放弃到再入门之拉格朗日对偶问题推导

普通同学的解法 无约束条件:求导就可以了 等式约束:代入消元,再求导 不等式约束:分情况讨论(在边界上和不在边界上),分别对应1,2的情况 然而发现,有些情况消元特别复杂,甚至不能求解 聪明同学的解法 发现:在最优点的情况下,约束曲面的法向量和目标函数的梯度反向必相同或相反 拉格朗日乘子法如何理解? (在2维里可以形象的解释为z=f(x,y)在约束条件g(x,y)=c中,极值...

qq_34564612的博客 1万+

YOLOv12 改进 | Backbone改进 3

将CSP中的简单拼接改为可学习的特征选择门控,动态决定哪些特征流向下一层,同样再写这篇。:相比静态CSP的固定50/50分割,门控机制可学习0.3:0.7等最优比例。在输入端加入轻量SR模块,对下采样后的特征进行超分恢复,提升小目标检测能力。(小目标): 从 0.51 AP → 0.63 AP (+24%):采用ESPCN的高效亚像素卷积,避免传统插值的信息损失。:从通道级(SE)到空间级(Spatial)的多粒度控制。:结合浅层细节和深层语义,恢复小目标的纹理信息。

u012133341的博客 841

5000字,详解数据模型设计方法!

ARCoder体验群,体验AR来源:知了小巷、网易有数全文共计4989字,预计阅读时间8分钟如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例:⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计...

大数据星球-浪尖 1052

华为OD机试真题新系统-空间占用计算(Py/Java/C/C++/Js/Go)

华为OD机试新系统机试真题 【空间占用计算】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题【空间占用计算】。

qq_45776114的博客 3445

如何避免数仓模型“烟囱式”建设

ODS层表的数据必须和数据源的表结构、表记录数⼀致,⾼度⽆损,对于ODS层表的命名采⽤ODS_业务系统数据库名_业务系统数据库表名⽅式,⽐如ods_warehous_stock,warehous是业务系统数据库名,stock是该库下⾯的表名。其次,要看表的命名。数据中台的构建往往需要花费半年甚⾄⼀年以上的时间,但是数据中台建成后,对研发效率的提升效果⾮常明显,在⽹易电商业务中,中台构建后相⽐构建前,数据需求的平均交付时间从⼀周缩短到3天内,需求响应速度的提升,为企业运营效果提升提供了数据⽀撑。

yuan_more的博客 1382

《AI 时代FPGA的全栈开发实战・从入门到精通》专栏启动说明

《智驱FPGA》专栏面向初学者,聚焦AI时代FPGA开发新范式,以ChatGPT、ICCoder2.0等工具全程辅助,覆盖纯逻辑、Zynq软硬协同、端侧AI加速、高速接口等核心方向。通过126节图文+14个实战项目,传授AI生成代码、Prompt工程、时序优化等能力,助力学员从零成长为具备工程竞争力的FPGA工程师,结业可独立完成完整项目并写入简历。

现任某外企的算法工程师!专注于人工智能、嵌入式、FPGA、论文写作四大主题的教程和经验分享!辅导请➕v :sci666888999 172

制作一款精美的 Qt IFW 安装程序

对于 Qt IFW 来说,默认的安装界面并不吸引人。倘若要制作一款精美的安装程序,这显然是不够的,需要在此基础上进行一系列定制。

青春不老,奋斗不止! 5260

【数据中台】数据模型无法复用,归根结底还是设计问题

0、前言 如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例: ⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计算指标。 由于他们⼤多是⾮技术专业出⾝,写的SQL质量⽐较差,甚⾄⻅过5层以上的嵌套。这种SQL对资源消耗⾮常⼤,会造成队列阻塞,影响其他数仓任务,会引起数据开发的不满。数据开发会要求.

Sunny的专栏 873

GhidraMCP:AI驱动的逆向工程革命——让LLM自主操作Ghidra进行自动化分析

(Ghidra Machine Control Protocol)应运而生,它通过将LLM与Ghidra(美国NSA开源逆向工具)结合,实现了AI驱动的自动化逆向工程流程。逆向工程是软件安全、漏洞分析和代码审计的核心环节,但传统方法依赖人工分析,耗时且易出错。未来,随着LLM技术的演进和逆向工程工具的优化,GhidraMCP有望成为安全研究人员和开发者的核心工具,推动逆向工程进入“AI辅助时代”。GhidraMCP通过LLM与Ghidra的深度整合,重新定义了逆向工程的自动化边界。

这里汇聚了前沿的技术分享与实用的开发技巧,带你探索从创意到企业的技术创业之路。 2116

数据模型设计

如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例: ⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计算指标。 由于他们⼤多是⾮技术专业出⾝,写的SQL质量⽐较差,甚⾄⻅过5层以上的嵌套。这种SQL对资源消耗⾮常⼤,会造成队列阻塞,影响其他数仓任务,会引起数据开发的不满。数据开发会要求收回分析师的原

qq_35240226的博客 4423

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

详解数据模型设计方法

如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例:⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计算指标。由于他们⼤多是⾮技术专业出⾝,写的SQL质量⽐较差,甚⾄⻅...

weixin_45727359的博客 4919

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

数据中台选型必读(四):要想中台建的好,数据模型得做好

要想得到一个“好”的数据模型,首先,我们可以统计未规范表的数量(可仿照表2),诊断数据模型现状。 然后,制订一些针对性的改进计划,例如把这些不规范命名的表消灭掉,把主题域覆盖的表比例提高到90%以上。

ylguoguo6666的博客 1182

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

数仓深度 | 数据模型设计(推荐收藏,转)

数仓深度 | 数据模型设计(推荐收藏,转) 如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例: ⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计算指标。 由于他们⼤多是⾮技术专业出⾝,写的SQL质量⽐较差,甚⾄⻅过5层以上的嵌套。这种SQL对资源消耗⾮常⼤,会造成队列阻塞,影响其他数仓任务.

形而上者谓之道 形而下者谓之器 1044

​​​​​​ 如何衡量完善度?

DWD层表被5张DWS层表引⽤,这张DWD层表的引⽤系数就是5,如果把所有DWD层表(有下游表的)引⽤系数取平均值,则为DWD层表平均模型引⽤系数,⼀般低于2⽐较差,3以上相对⽐较好(经验值)。全量数据的表,还是每天的增量数据?,通过元数据中⼼的数据⾎缘图,可以看到,⼀个⽐较差的模型设计,⾃下⽽上是⼀条线。100%,但值越⾼,说明上层的数据建设越完善,对于使⽤数据的⼈来说,查询速度和成本会减少,⽤起来会更爽。层引⽤的越多,就说明越多的任务是基于原始数据进⾏深度聚合计算的,明细数据没有积累,⽆法被复⽤,

xljlckjolksl的博客 154

数据模型设计方法概述

数据模型设计方法概述

ytp552200ytp的博客 906
上一篇: 基于Flink+Hive+Kafka的流批一体数仓实践--04Kafka_Sink_Kafka_DWD_OrderFull
下一篇: 如何提高数据质量
问道2020
博客等级 码龄8年 4粉丝 47原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值