


一、前言
在人工智能技术快速迭代的今天,检索增强生成(RAG)技术作为连接大语言模型与知识库的关键桥梁,已经成为构建知识密集型应用不可或缺的基础设施。然而,随着应用场景的日益复杂化和用户需求的不断提升,传统RAG技术所展现出的局限性也愈发明显。在这个背景下,一种革新性的技术范式 - Agentic RAG应运而生,它不仅打破了传统RAG的能力边界,更为未来AI应用的发展开辟了新的可能性。
二、Agentic RAG:重构知识处理范式
2.1传统RAG的局限与挑战
传统RAG技术虽然在特定场景下表现出色,但其"单次检索-生成"的简单范式已经难以满足现代企业对知识处理的多样化需求。特别是在面对需要多步推理、跨文档关联分析、或需要协同多种工具能力的复杂场景时,传统RAG逐渐显露出多个维度的局限性:
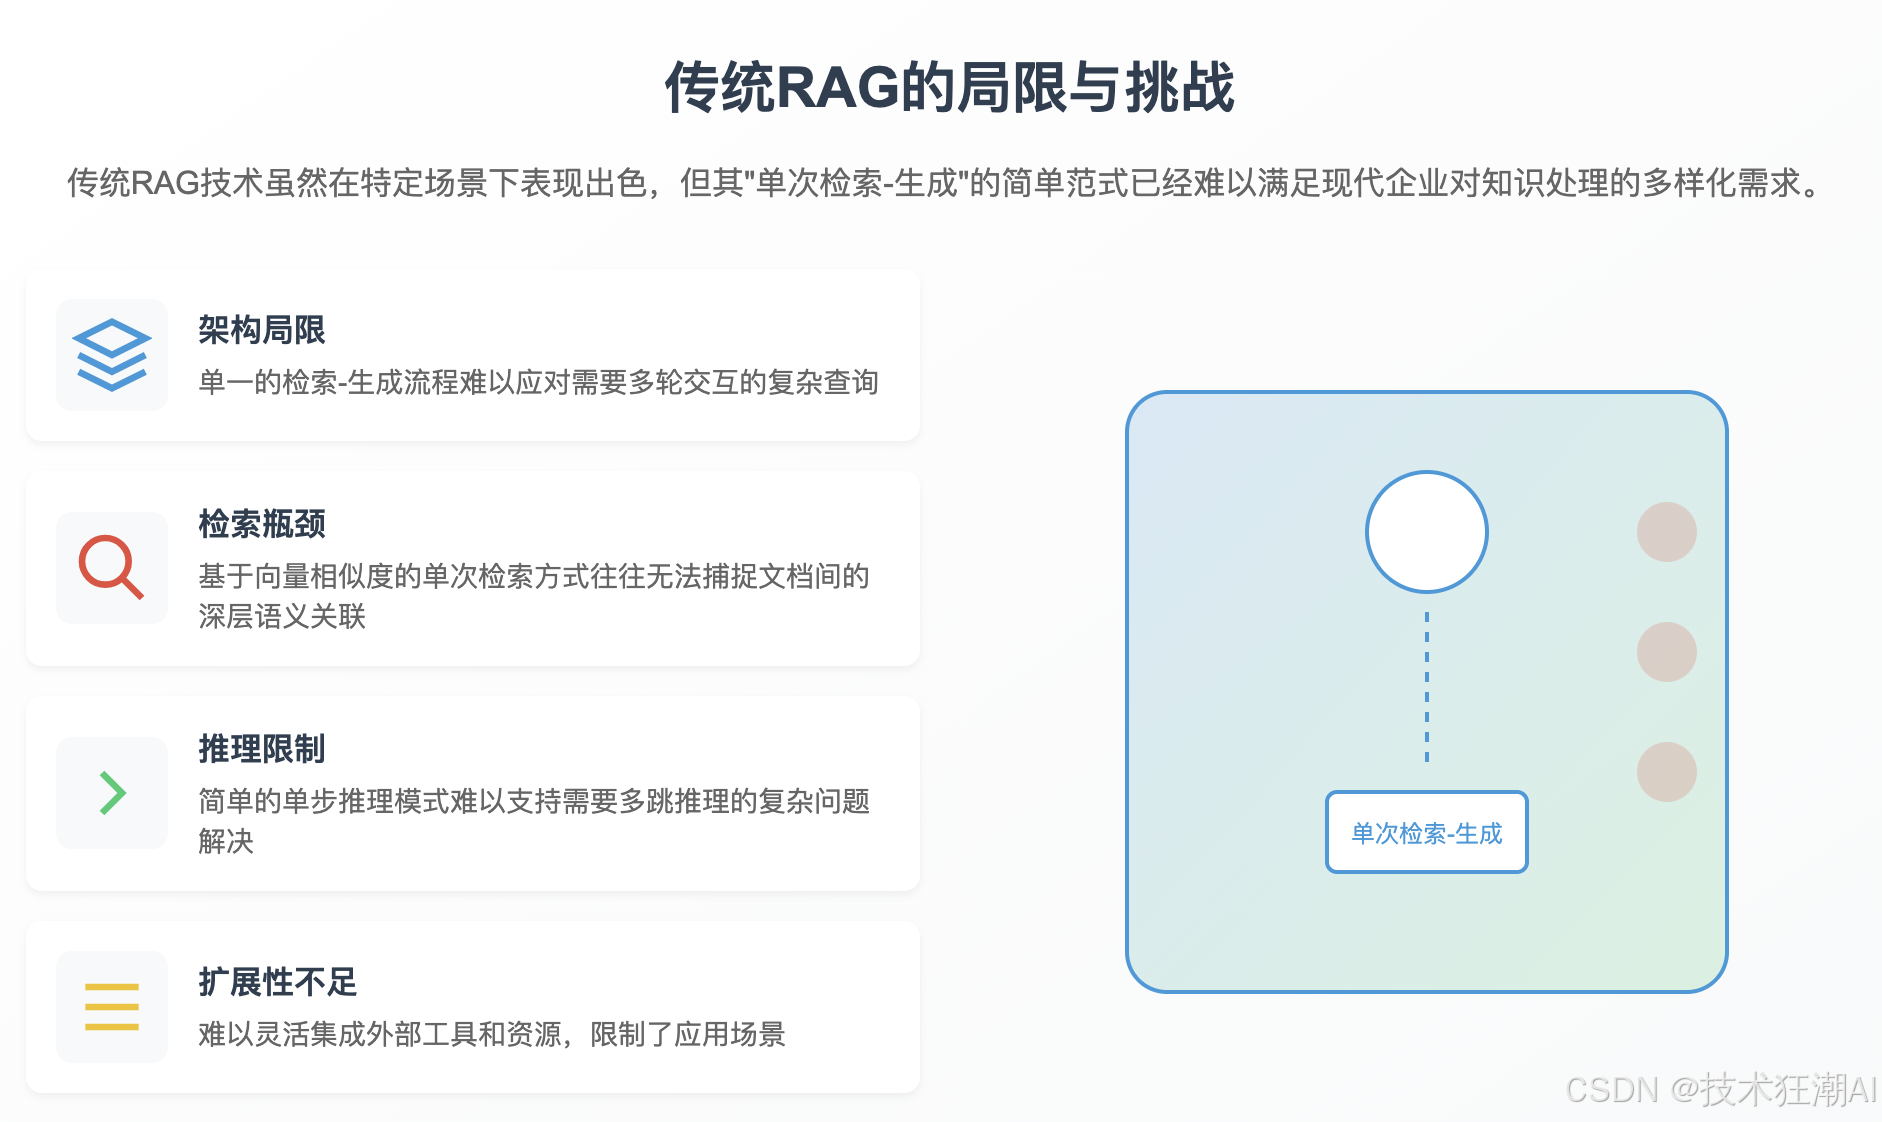
这些挑战不仅制约了RAG技术的应用深度,更凸显出我们需要一种更智能、更灵活的解决方案,同时反映了我们需要重新思考AI系统与知识交互的方式。
2.2传统RAG与Agentic RAG的核心对比
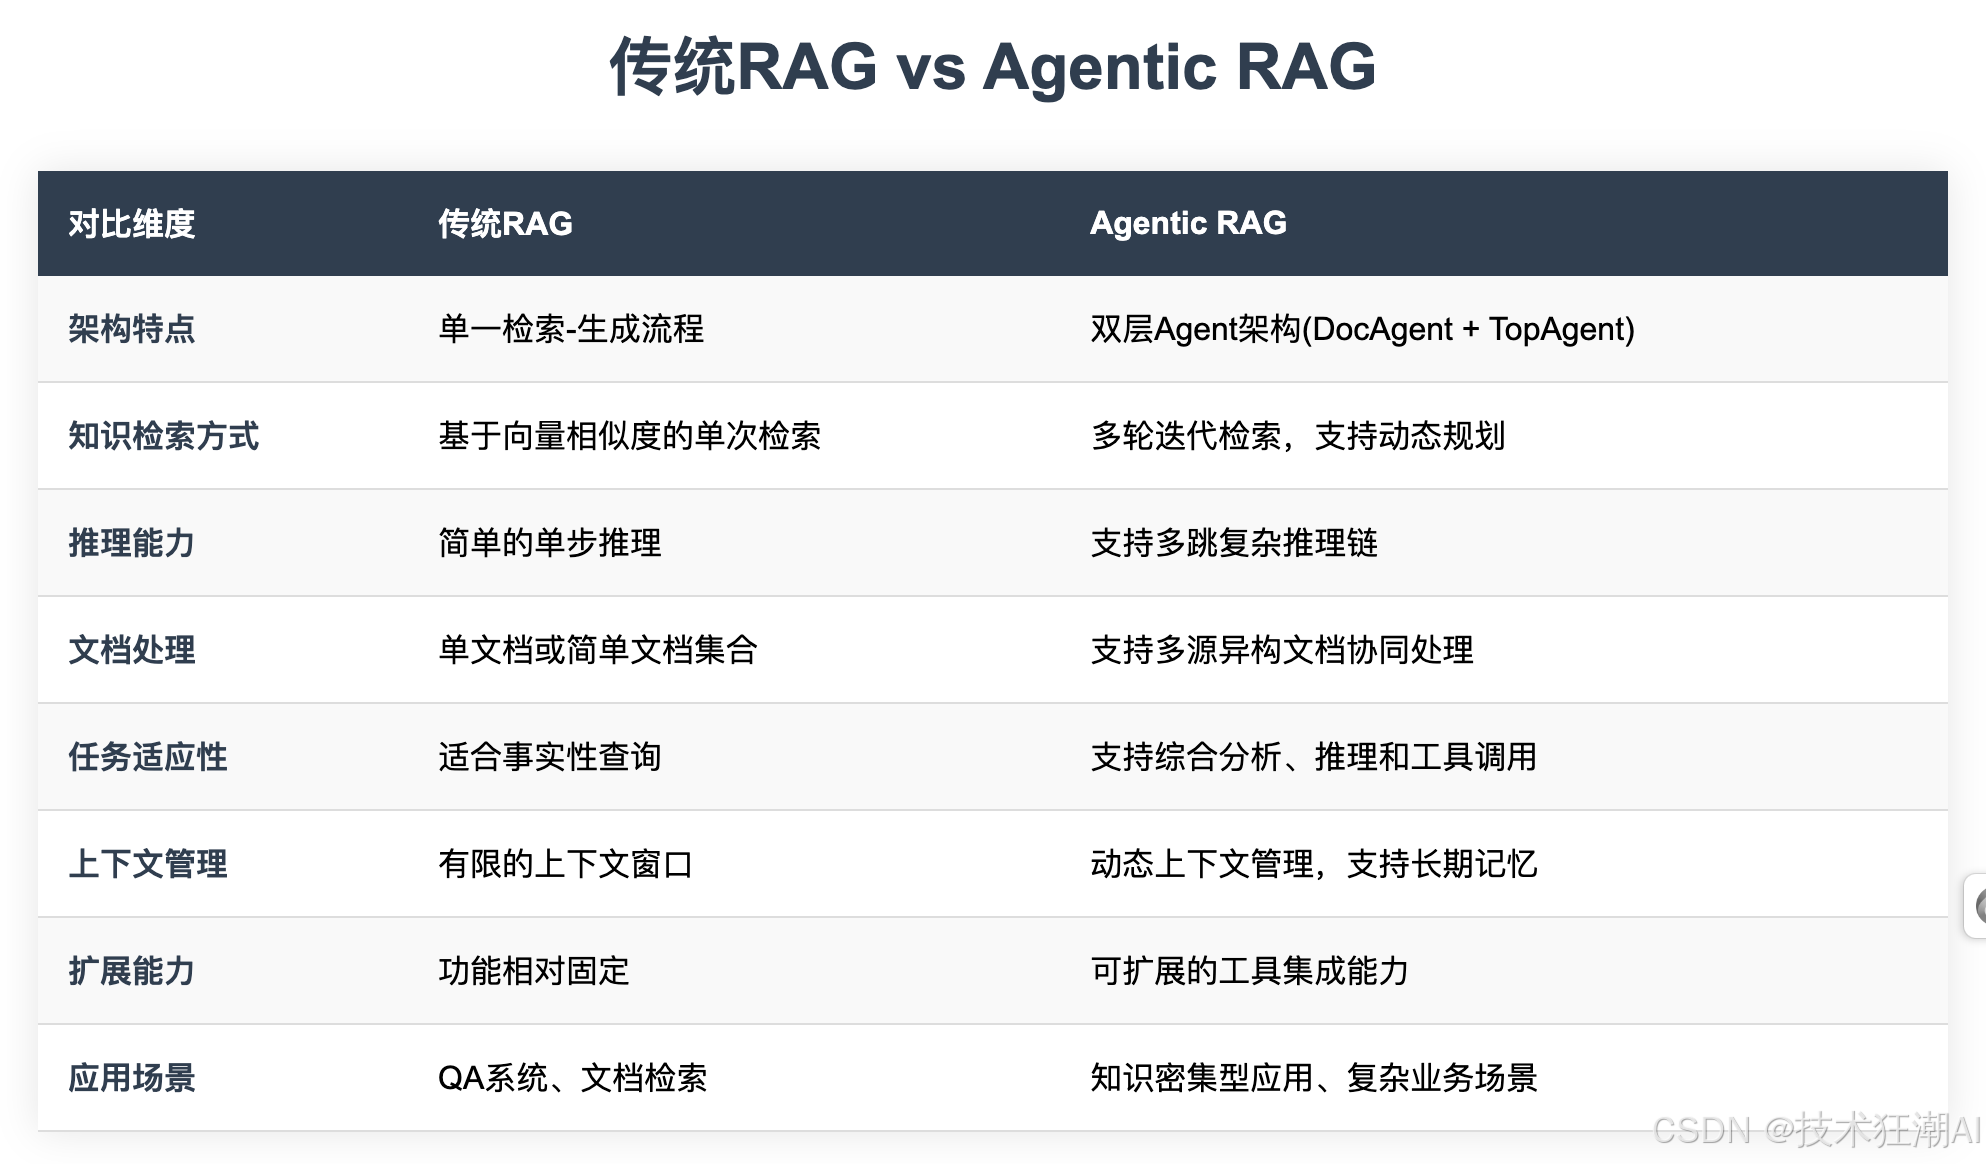
从上表的对比可以看出,Agentic RAG在多个关键维度上都实现了质的飞跃。这种突破不是简单的技术堆砌,而是对RAG架构的根本性重构。接下来,让我们深入探讨Agentic RAG带来的具体创新
2.3Agentic RAG的创新突破
Agentic RAG通过引入智能代理(Agent)的概念,从根本上重塑了RAG的技术架构。它突破性地提出了双层Agent架构,将文档级Agent(DocAgent)和协调级Agent(TopAgent)有机结合,不仅解决了传统RAG在复杂场景下的诸多痛点,更开创了一种全新的知识处理范式。这种创新不仅体现在技术实现上,更重要的是它开启了一种全新的思维方式:将知识检索从被动的"查询-响应"模式,提升到主动的"规划-执行-优化"的智能处理模式。

三、Agentic RAG 原理与架构
在探讨大语言模型应用的技术演进过程中,Agentic RAG 作为一种创新架构范式,正在重新定义知识检索与应用的边界。本章将深入剖析其核心原理与架构设计,阐述这一技术如何突破传统 RAG 的局限性,实现更高层次的知识服务能力。
3.1 应用场景与挑战
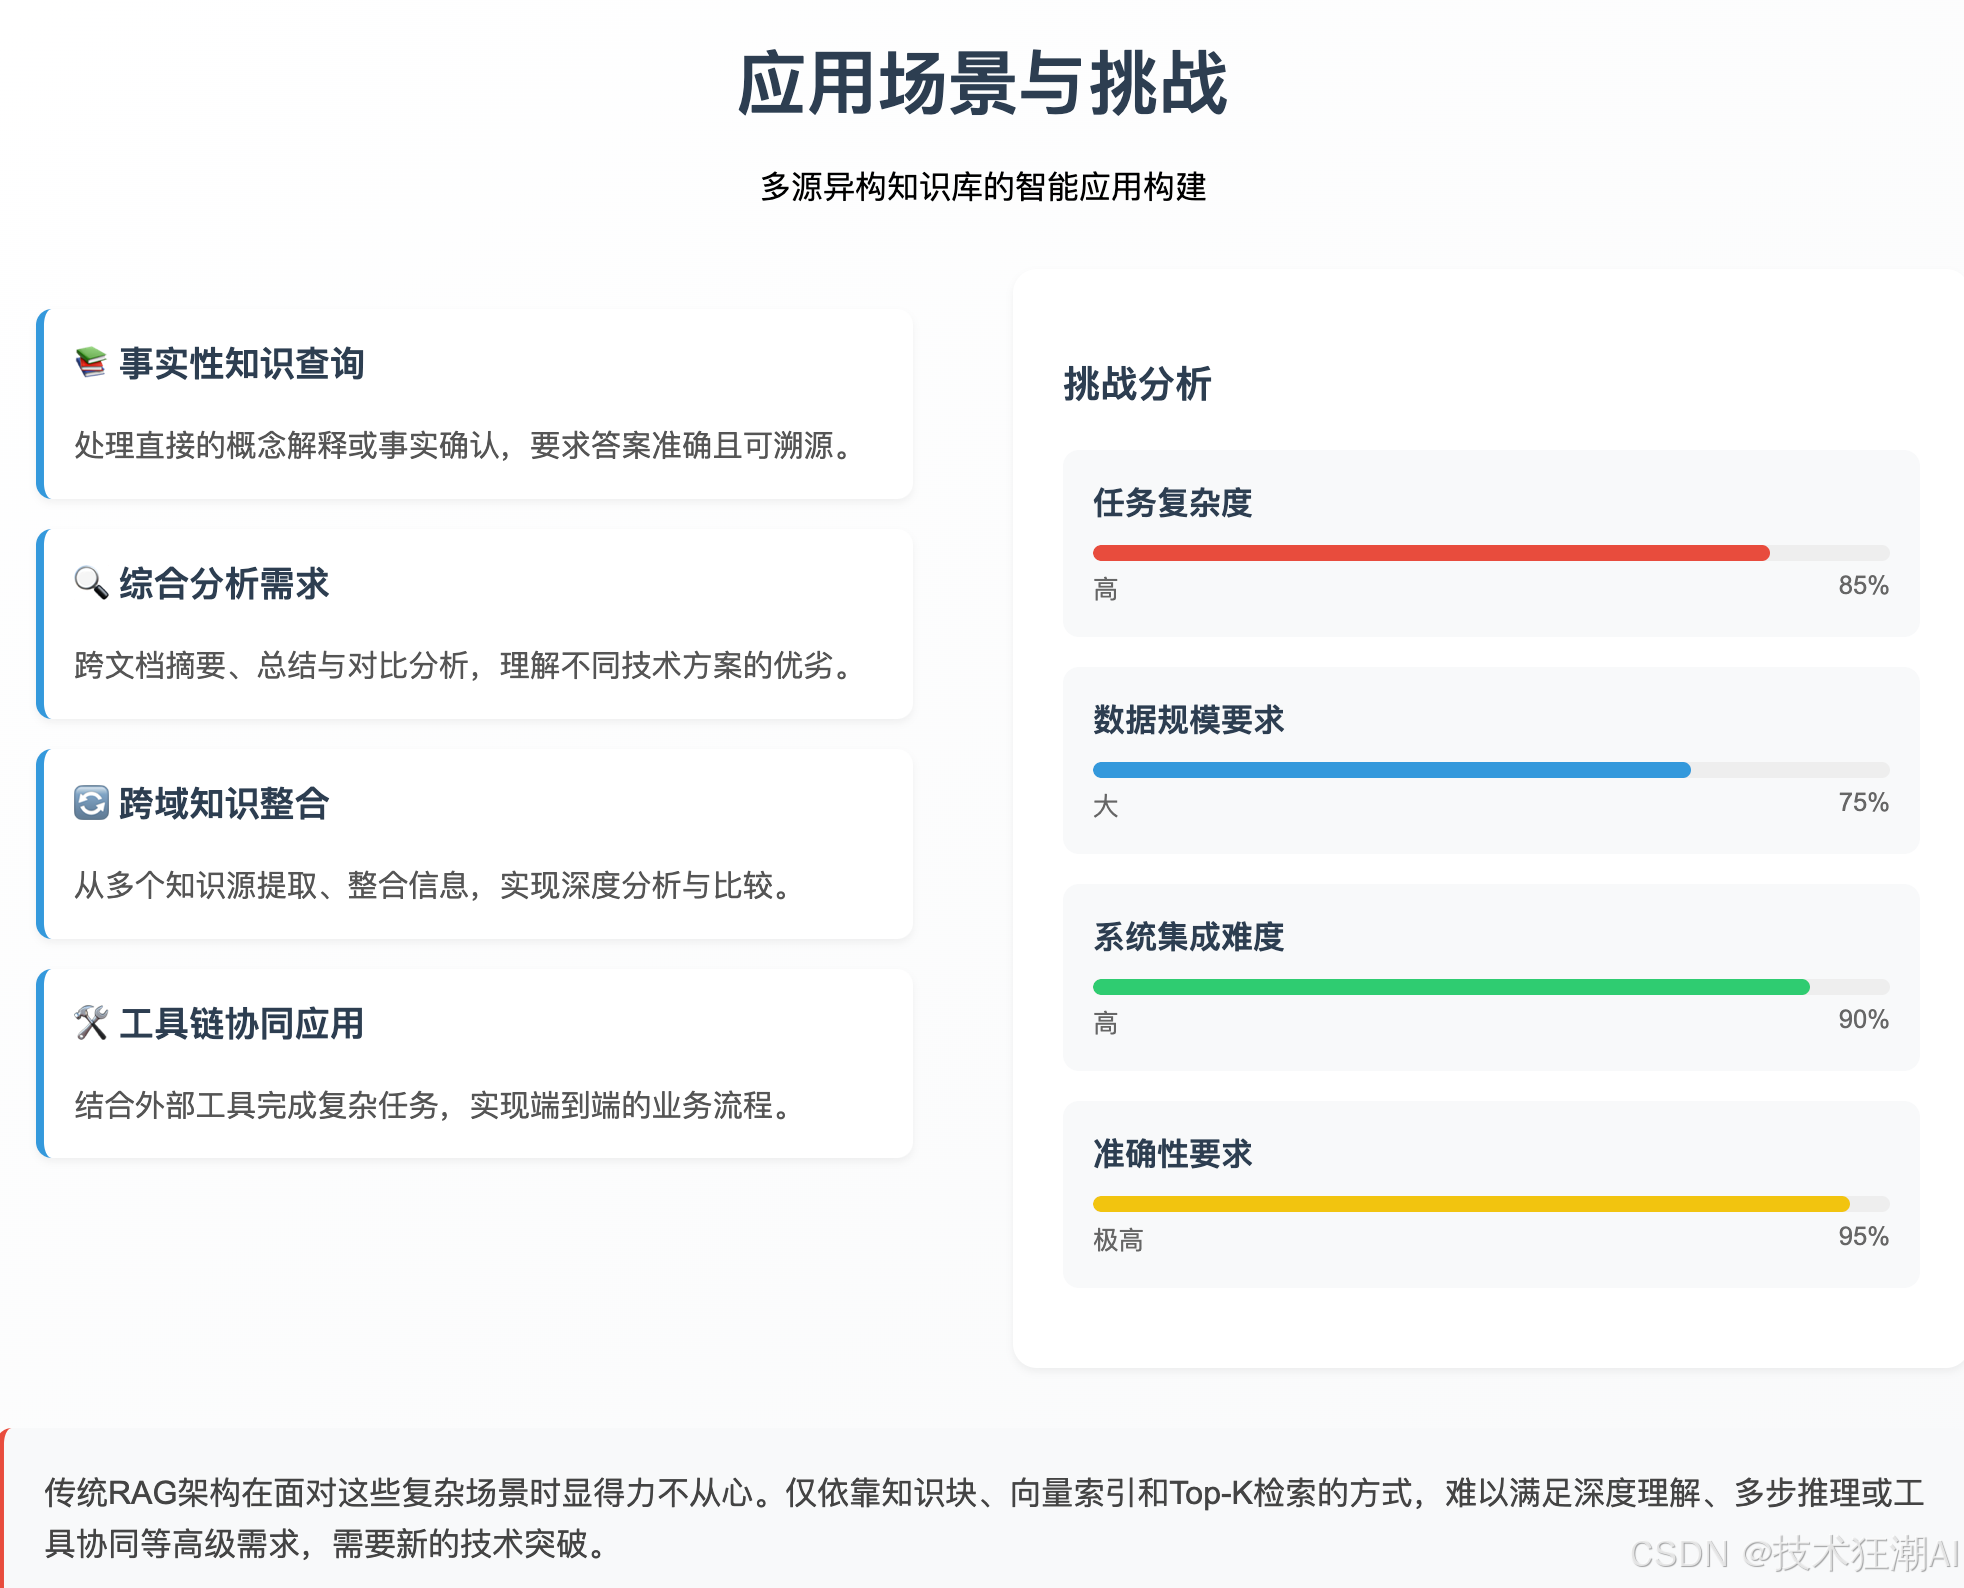
在实际应用中,我们经常面临这样的场景:需要在多源异构的知识库(包括但不限于文档、结构化数据库、API 接口等)之上构建知识密集型应用。这类应用通常需要处理以下典型需求:
3.2 Agentic RAG 的核心原理
Agentic RAG 通过引入智能体技术,构建了一个两级架构的知识处理系统。这种架构不是简单的向量检索分层,而是通过智能体之间的协同配合,结合底层 RAG 引擎,来完成复杂的知识处理任务。
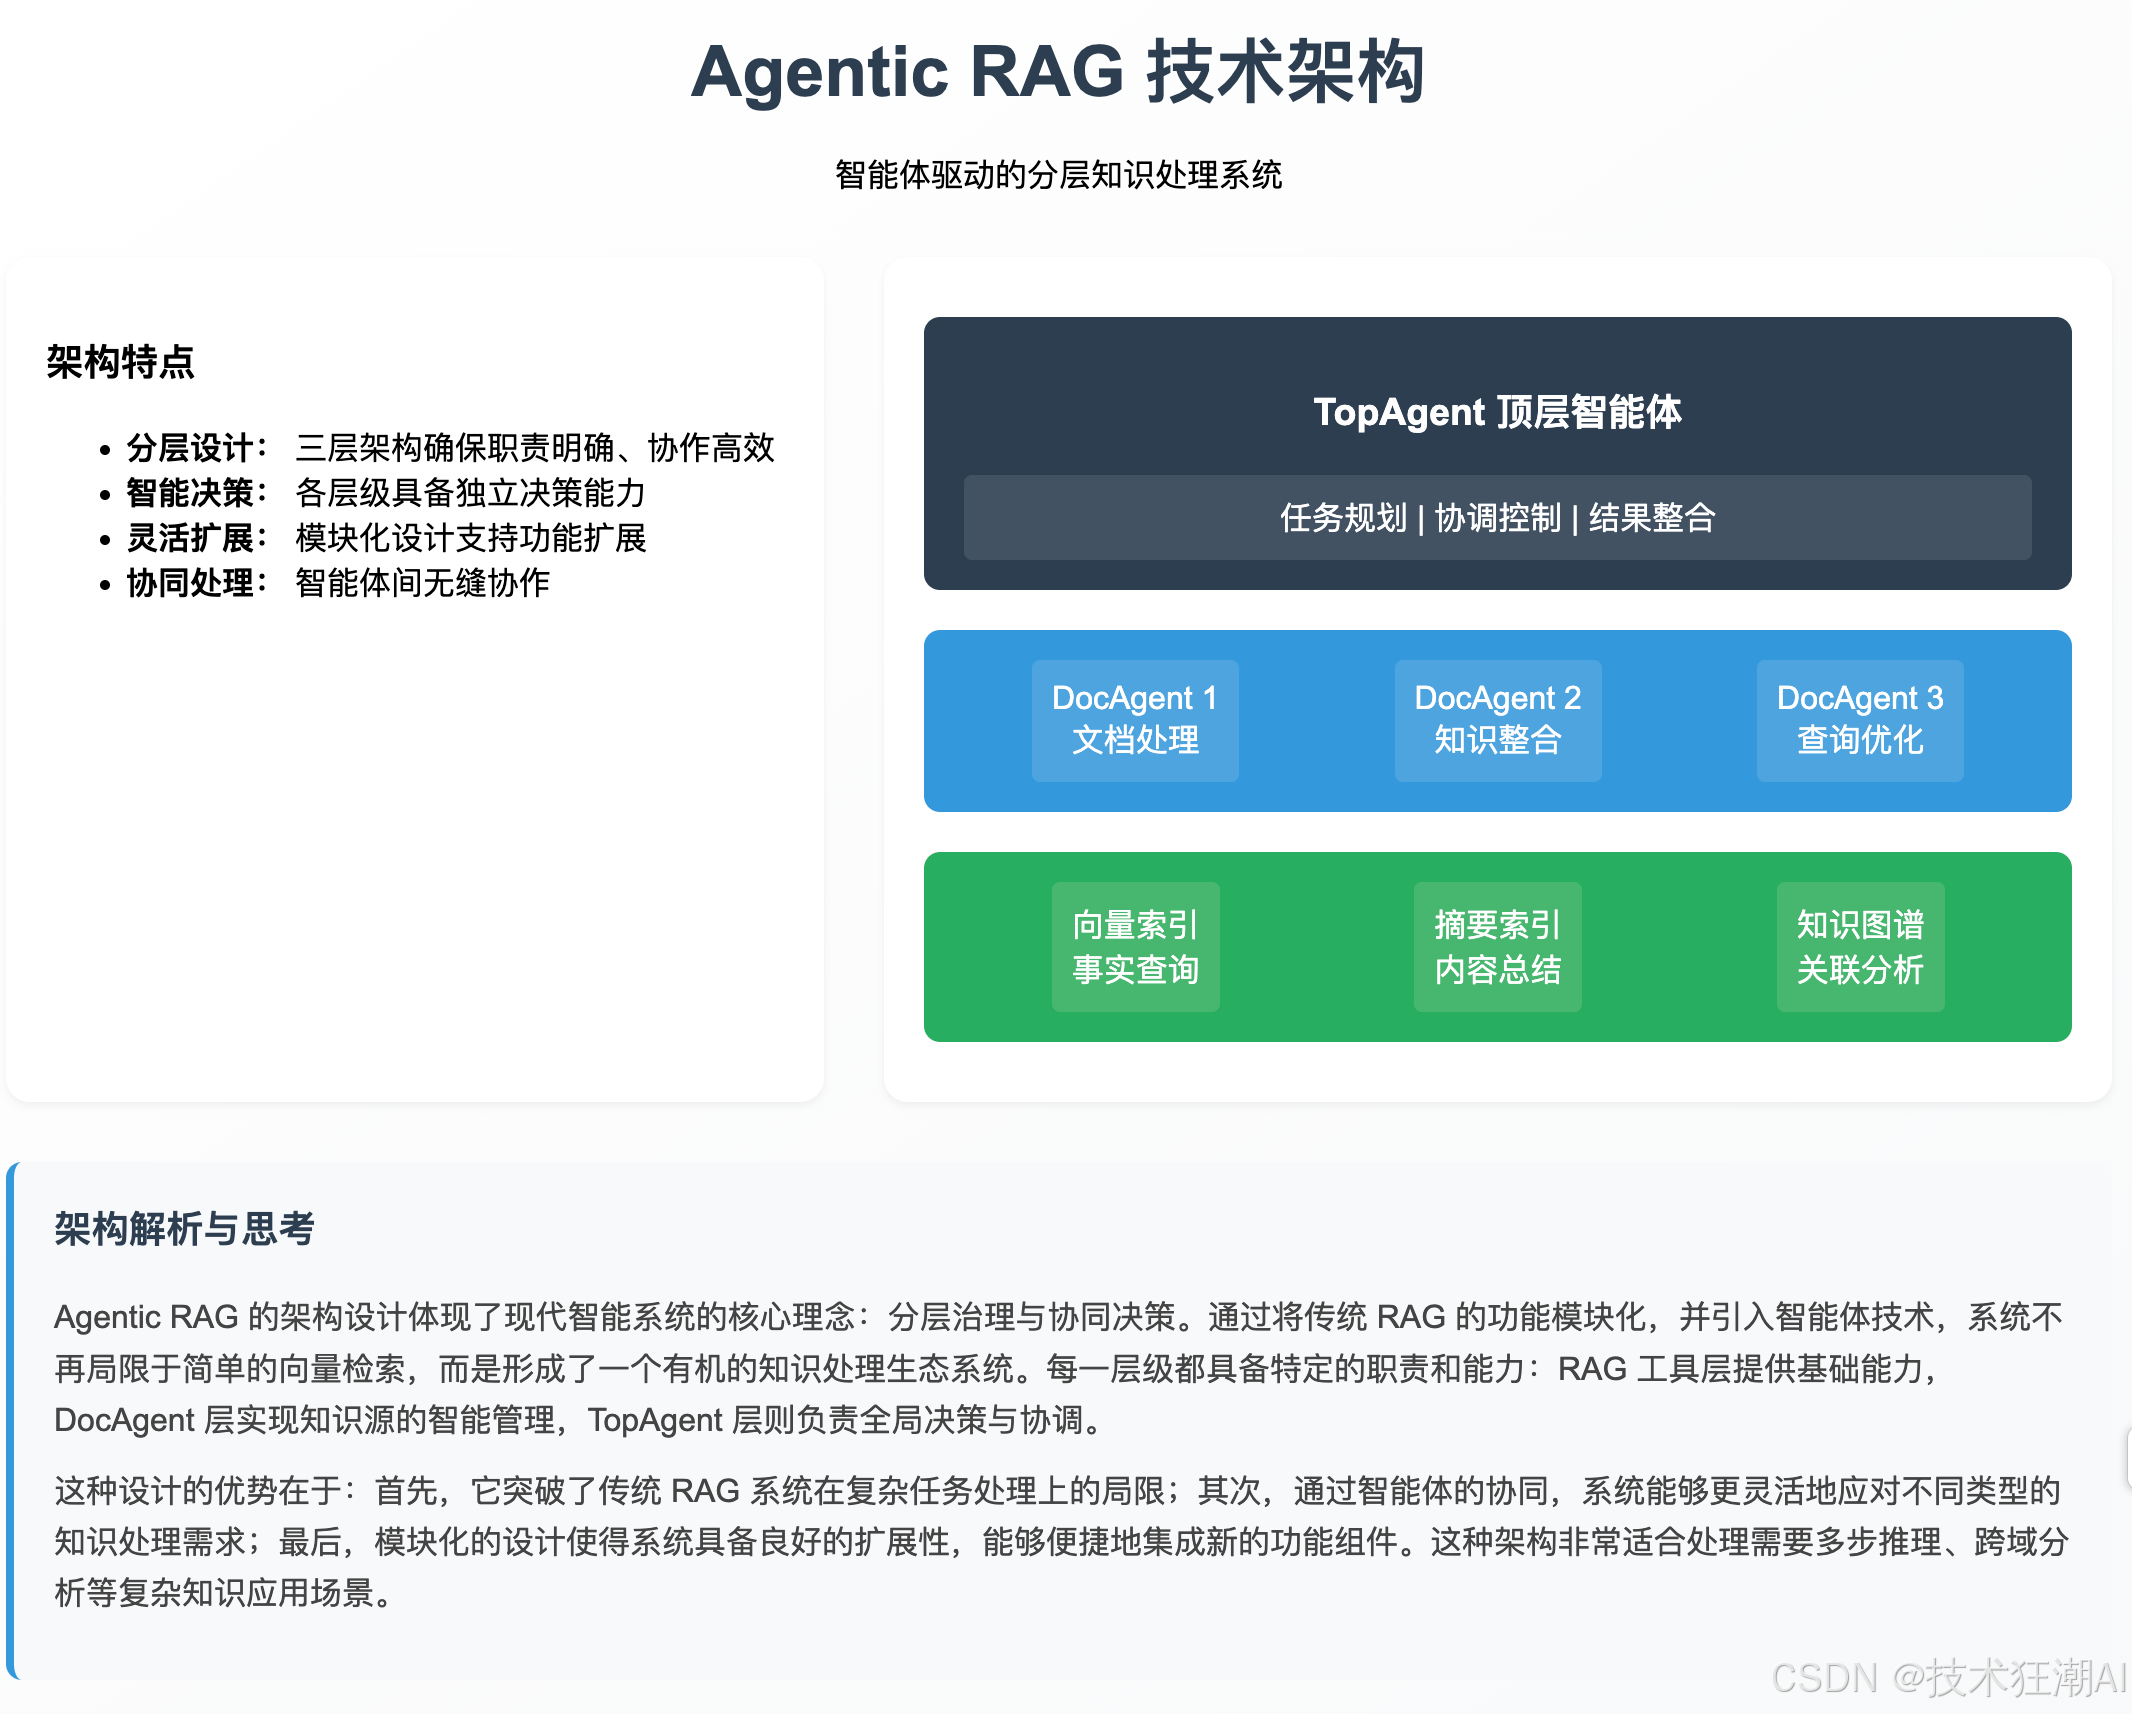
如图所示,Agentic RAG 采用了清晰的三层架构设计,从底层的 RAG 工具层,到中间的文档智能体层(DocAgent),再到顶层的协调智能体层(TopAgent),形成了一个完整的智能知识处理体系。这种分层架构不仅确保了系统的模块化和可扩展性,更重要的是实现了知识处理的智能化和自动化。
在这个架构中,每一层都承担着独特而关键的角色:底层 RAG 工具提供了基础的检索和处理能力,DocAgent 负责具体知识源的智能管理,而 TopAgent 则统筹全局,协调多个智能体的协作。这种设计使得系统能够灵活应对各种复杂的知识处理场景,从简单的事实查询到复杂的多文档分析都能高效完成。
接下来,我们将详细探讨一种基于此架构的多文档 Agentic RAG 实现方案。这个方案充分利用了智能体技术的优势,通过两级智能体的协同运作,结合底层 RAG 引擎,实现了更为强大和灵活的知识处理能力。具体而言,方案包括为每个文档配备专门的知识智能体,以及在其之上建立统一的语义路由智能体,从而构建起一个完整的知识处理生态系统。这种方案不仅突破了传统 RAG 系统的局限,更为复杂知识任务的处理提供了新的可能。
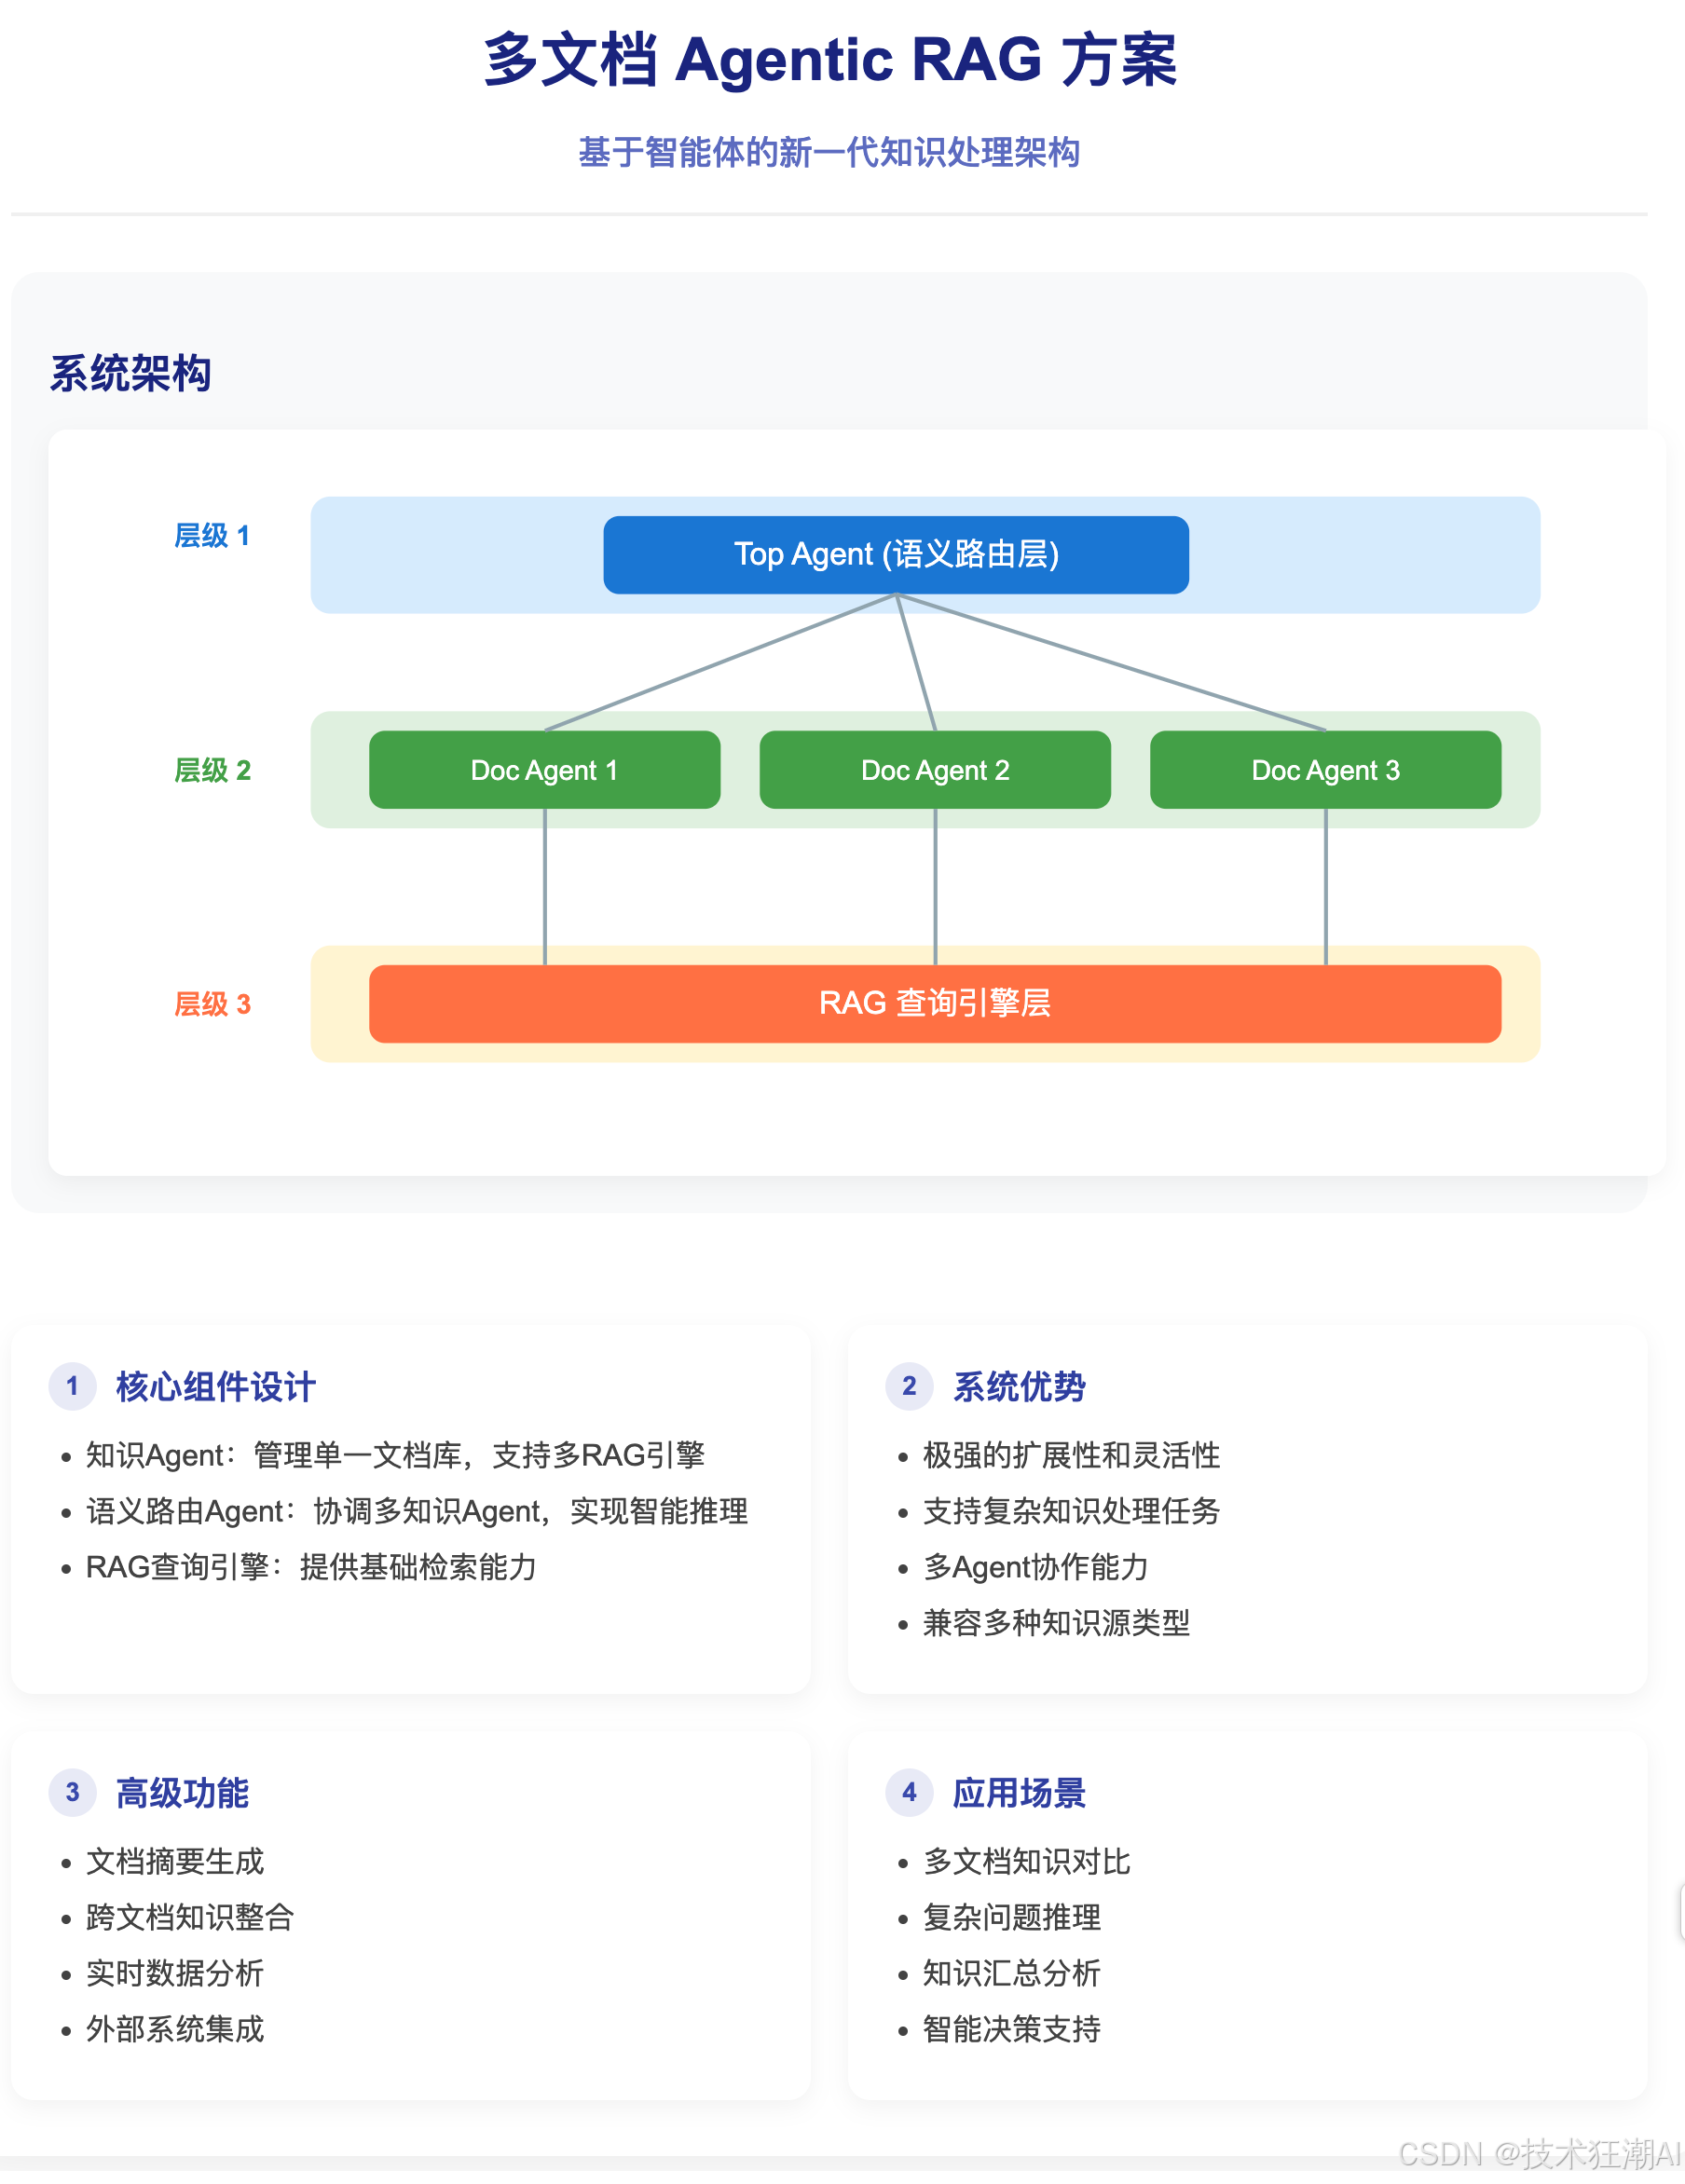
在现代智能系统中,基于RAG的多级Agent架构代表了一种创新的知识处理方案。这种架构的核心在于其独特的分层设计,通过多层级的Agent协作,实现了复杂知识任务的高效处理。
首先,在架构的底层,系统为每个文档或知识库都配备了专属的知识Agent。这些知识Agent能够灵活运用一个或多个RAG查询引擎,确保对特定领域知识的精确检索和回答。这种设计不仅保证了知识检索的准确性,还为不同类型知识的个性化处理提供了可能。
在这些知识Agent之上,系统设置了一个更高层级的语义路由Agent(Top Agent)。这个顶层Agent承担着核心的调度和决策职责,通过强大的推理能力,它能够智能地调用和协调底层的知识Agent,确保查询任务的精确分发和有效完成。
这种多级Agent架构的最大优势在于其卓越的灵活性和扩展性。系统可以处理几乎任何基于知识的复杂任务,无论是向量化的知识库,还是外部系统中的结构化或非结构化数据。这种灵活性主要体现在两个关键方面:
第一,系统支持对二级Tool Agent进行功能扩展。这些Agent不再局限于简单的事实性问题回答,而是可以承担更复杂的知识处理任务。例如,它们能够进行知识整理、生成内容摘要、执行数据分析,甚至通过API实时获取外部系统的最新知识。这种扩展性极大地提升了系统的实用价值。
第二,系统支持多个Tool Agent之间的协同合作。这种协作能力使得系统可以完成传统RAG应用无法处理的复杂任务,比如对比分析不同文档中的知识内容,或者汇总多个知识源的信息。这种协同机制为处理复杂的知识任务提供了强有力的支持。
然而,这种架构方案也面临着一些挑战。首要的是实现复杂性较高,系统的设计和开发都需要考虑更多的技术细节。同时,这种架构对大模型的推理能力也提出了较高的要求,需要确保模型具备准确的语义理解和可靠的决策能力。
四、Agentic RAG 实现方案
本章节将详细介绍如何构建一个基于多文档的 RAG 查询引擎的分层 Agent 系统。这种实现方案充分利用了 Agent 的观察、规划和行动能力,不仅提供基础的 RAG 查询功能,还能够完成更复杂的任务处理。
4.1 文档准备与初始化
系统初始阶段需要准备 RAG 相关的 PDF 文档作为测试数据。在本示例中,我们使用三个基础文档,但在实际应用场景中可以扩展到更大规模:
names = ['c-rag', 'self-rag', 'kg-rag']
files = [
    '../../data/c-rag.pdf',
    '../../data/self-rag.pdf',
    '../../data/kg-rag.pdf'
]
4.2 Tool Agent 构建流程
4.2.1 基础 Tool Agent 构建
在构建基础 Tool Agent 的过程中,我们首先需要创建一个专门的函数,用于处理单个 PDF 文档并生成相应的 Tool Agent。这个函数的核心任务是对文档进行加载和分割处理,并构建两个不同类型的索引系统及其对应的查询引擎。
第一个是向量索引查询引擎,它主要用于处理事实性问题。这类引擎基于向量检索技术,能够实现精确的文本匹配,特别适合处理具体的查询请求,如特定概念的定义、具体事实的查证等。通过向量化文档内容并建立索引,系统可以快速定位和检索相关信息。
第二个是摘要索引查询引擎,它的设计目的是处理需要更高层次语义理解的问题。这类引擎特别适合处理需要综合分析的总结类问题,比如对某个主题的概述、多个概念之间的关联分析等。它能够理解文档的深层语义,提供更具综合性的答案。
在完成这两个查询引擎的构建后,我们将它们集成为 Tool Agent 的核心工具。这种双引擎设计使得 Tool Agent 能够灵活应对不同类型的查询需求,既能处理简单的事实查询,也能应对复杂的分析性问题。通过这种方式,我们创建了一个既专业又全面的文档智能处理系统。
# 导入必要的库
import chroma
from chromadb.utils import embedding_utils
from llama_index import StorageContext, VectorStoreIndex, SimpleDirectoryReader, SentenceSplitter

# 连接Chroma数据库
chromadb.HttpClient(host="localhost", port=8000)

# 获取或创建Chroma集合
collection = chroma.get_or_create_collection(name="agentic_rag")
vector_store = ChromaVectorStore(chroma_collection=collection)

# 创建针对某个文档的Tool Agent
def create_tool_agent(file, name):
    """
    创建一个针对特定文档的Tool Agent。

    Args:
        file (str): 文档路径。
        name (str): Tool Agent的名称。
    """

    print(f"Starting to create tool agent for [{name}]...\n")

    # 加载文档并分割
    docs = SimpleDirectoryReader(input_files=[file]).load_data()
    splitter = SentenceSplitter(chunk_size=500, chunk_overlap=5)
    nodes = splitter.get_nodes_from_documents(docs)

    # 创建向量索引并持久化存储
    if not os.path.exists(f"./storage/{name}"):
        print("Creating vector index...\n")
        storage_context = StorageContext.from_defaults(vector_store=vector_store)
        vector_index = VectorStoreIndex(nodes, storage_context=storage_context)
        vector_index.storage_context.persist(persist_dir=f"./storage/{name}")
    else:
        print("Loading vector index...\n")
        storage_context = StorageContext.from_defaults(persist_dir=f"./storage/{name}",
                                     vector_store=vector_store)
        vector_index = load_index_from_storage(storage_context=storage_context)

    # 构造基于向量的查询引擎
    query_engine = vector_index.as_query_engine(similarity_top_k=5)

    # 创建一个摘要索引
    summary_index = SummaryIndex(nodes)
    summary_engine = summary_index.as_query_engine(response_mode="tree_summarize")

    # 查询工具
    query_tool = QueryEngineTool.from_defaults(
        query_engine=query_engine,
        name=f'query_tool',
        description=f'Use if you want to query details about {name}')

    summary_tool = QueryEngineTool.from_defaults(
        query_engine=summary_engine,
        name=f'summary_tool',
        description=f'Use ONLY if you want to get a holistic summary of the documents. DO NOT USE if you want to query some details about {name}.')

    # 创建一个 Tool Agent
    tool_agent = ReActAgent.from_tools([query_tool, summary_tool],
         verbose=True,
         system_prompt=
         """You are a specialized agent designed to answer queries about {name}. You must ALWAYS use at least one of the tools provided when answering a question; DO NOT rely on prior knowledge. DO NOT fabricate answers.""")

    return tool_agent
这里也可以使用路由查询引擎来代替 Agent 实现接近的功能,但是要注意路由查询引擎与Agent是有区别的,路由查询引擎在大部分时候仅起到选择工具与转发问题的作用,并不会多次迭代,而Agent则会观察工具返回的结果,有可能使用多个工具通过多次迭代来完成任务。
4.2.2 Agent 层级结构设计
在构建完整的文档处理系统时,我们采用了双层 Agent 架构,这种设计能够有效地管理和处理多文档场景下的复杂查询需求。该架构主要包含两个层级:二级 Tool Agent 和一级 Top Agent。
1)批量创建二级Tool Agent
在二级 Tool Agent 层面,系统会为每一个 PDF 文档创建一个独立的 Tool Agent。这些 Agent 被设计为专门处理其对应文档的内容,确保了查询处理的精确性和专业性。为了有效管理这些 Tool Agent,我们使用字典数据结构来存储文档名称和对应的 Agent,这种方式不仅便于检索和管理,也使得系统能够实现高效的文档级别智能查询处理。
#创建不同文档的Tool Agent
print('======================================================================\n')
print('Creating tool agents for different documents...\n')
tool_agents_dict = {}
for name, file in zip(names, files):
    tool_agent = create_tool_agent (file, name)
    tool_agents_dict[name] = tool_agent
2)创建一级Top Agent
在架构的顶层,一级 Top Agent 扮演着系统的中央控制器角色。它的主要职责是接收和处理用户的查询请求,并据此制定合适的查询计划。作为整个系统的协调者,Top Agent 能够根据查询需求智能地调度和协调下层的 Tool Agents,确保查询请求能够被最合适的 Tool Agent 处理。这种分层设计不仅提高了系统的处理效率,也增强了整个系统的可扩展性和灵活性。
# 将 Tool Agent 进行“工具化”
print('======================================================================\n')
print('Creating tools from tool agents...\n')
all_tools = []
for name in names:
    agent_tool = QueryEngineTool.from_defaults(

        # 注意,Agent本身也是一种查询引擎,所以可以直接转换为工具
        query_engine=tool_agents_dict[name],
        # 这个工具的名称
        name=f"tool_{name.replace('-', '')}",
        # 描述这个工具的作用和使用方法
        description=f"Use this tool if you want to answer any questions about (name)."
    )
    all_tools.append(agent_tool)

# 创建Top Agent
print('Creating top agent...\n')
top_agent = OpenAIAgent.from_tools(tools=all_tools,
      verbose=True,
      system_prompt="""You are an agent designed to answer queries over a set of given papers. Please always use the tools provided to answer a question. Do not rely on prior knowledge. DO NOT fabricate answers""")
3)测试
下面测试这个 Top Agent:
# 测试
top_agent.chat_repl()
4.2.3 系统运行机制
为了更好地理解系统的运行机制,我们可以通过一个具体的查询示例来进行说明。以用户提出的查询"Please introduce Retrieval Evaluator in C-RAG pattern?"为例,系统将按照既定的流程逐步处理这个请求。
系统回复内容:
The Retrieval Evaluator in the C-RAG pattern is designed to evaluate the relevance of retrieved documents to the input question based on the relevance scores calculated for each question-document pair. Depending on this confidence level, the evaluator triggers actions like Correct, Incorrect, or Ambiguous. This evaluator helps determine whether the retrieved documents are suitable for generating a response.
仔细观察输出的部分调试信息,可以看出 Agent 的"思考"过程:
首先,在 Top Agent 层面的处理过程中,系统会启动 OpenAI 的函数调用机制。Top Agent 会分析用户的查询内容,识别出这是一个关于 C-RAG 模式中检索评估器的问题,随后选择合适的工具(在本例中是 tool_crag)来处理这个查询。在这个阶段,Top Agent 还负责构造必要的查询参数,为下一步的处理做好准备。
接下来,在 Tool Agent 层面的处理过程中,系统采用 ReAct 推理范式来处理查询。Tool Agent 首先调用向量索引查询引擎,在相关文档中搜索与检索评估器相关的信息。在获取到初始结果后,Tool Agent 会对这些信息进行深入分析,最终生成一个综合的答案。这个过程确保了回答的准确性和完整性。
在最后的结果返回流程中,Tool Agent 会将处理完的结果返回给 Top Agent。Top Agent 会评估这个结果是否完全满足用户的查询需求,如果发现答案还不够完整,它会决定是否需要进行额外的查询。在确认结果满足要求后,系统才会将最终的答案输出给用户。这种多层次的处理机制确保了系统能够提供准确、完整的回答。
4.2.4 大规模文档优化方案
前面用了3个文档,创建了针对它们的 Tool Agent。在实际应用场景中,系统常常需要处理数量庞大的文档,从几十个到几百个不等,在 Top Agent 进行推理时,Tool Agent 过多,那么发生错误的概率就会增加。为了应对这种大规模文档处理的挑战,我们设计了一套完整的优化方案,以确保系统能够高效且准确地处理查询请求,简单地修改上面的代码,给 Top Agent 在推理时增加工具检索功能,能够缩小选择工具的范围。
在工具检索器的实现方面,我们采用了 Object Index 类型的工具检索器设计。这种检索器能够根据用户输入的问题智能地检索相关工具,大大提高了检索的效率。通过设置 similarity_top_k 参数,我们可以灵活控制检索的范围,在查询效率和准确性之间取得最佳平衡。这种设计不仅能够快速定位相关工具,还能确保检索结果的相关性。
只需要在创建 Top Agent 之前给工具构造一个 Object Index 类型的工具检索器,用于根据输入问题检索必要的工具:
# 构造工具检索器
print('======================================================================\n')
print('Creating tool retrieve index...\n')
obj_index = ObjectIndex.from_objects(
    all_tools,
    index_cls=VectorStoreIndex,
)
tool_retriever = obj_index.as_retriever(similarity_top_k=2, verbose=True)
这套优化方案带来了显著的效果。首先,它有效缩小了工具的选择范围,使系统能够更快速地定位到最相关的工具。其次,通过更精准的工具选择,系统的查询准确率得到了显著提升。同时,错误概率的降低也使得系统的可靠性大大提高。最重要的是,这些优化并没有影响系统的响应效率,保证了用户体验的流畅性。
然后,简单的修改创建 Top Agent 的代码,不再传入 all_tools,而是传入工具检索器:
# 创建 Top Agent,使用 tool_retriever 而不是 all_tools
op_agent = OpenAIAgent.from_tools(
    tool_retriever=tool_retriever,
    verbose=True,
    system_prompt="""You are an agent designed to answer queries over a set of given papers. Please always use the tools provided to answer a question. Do not rely on prior knowledge."""
)
如果继续测试这个 Agent,就会发现仍然可以达到相同的效果,如图展示了函数调用过程。
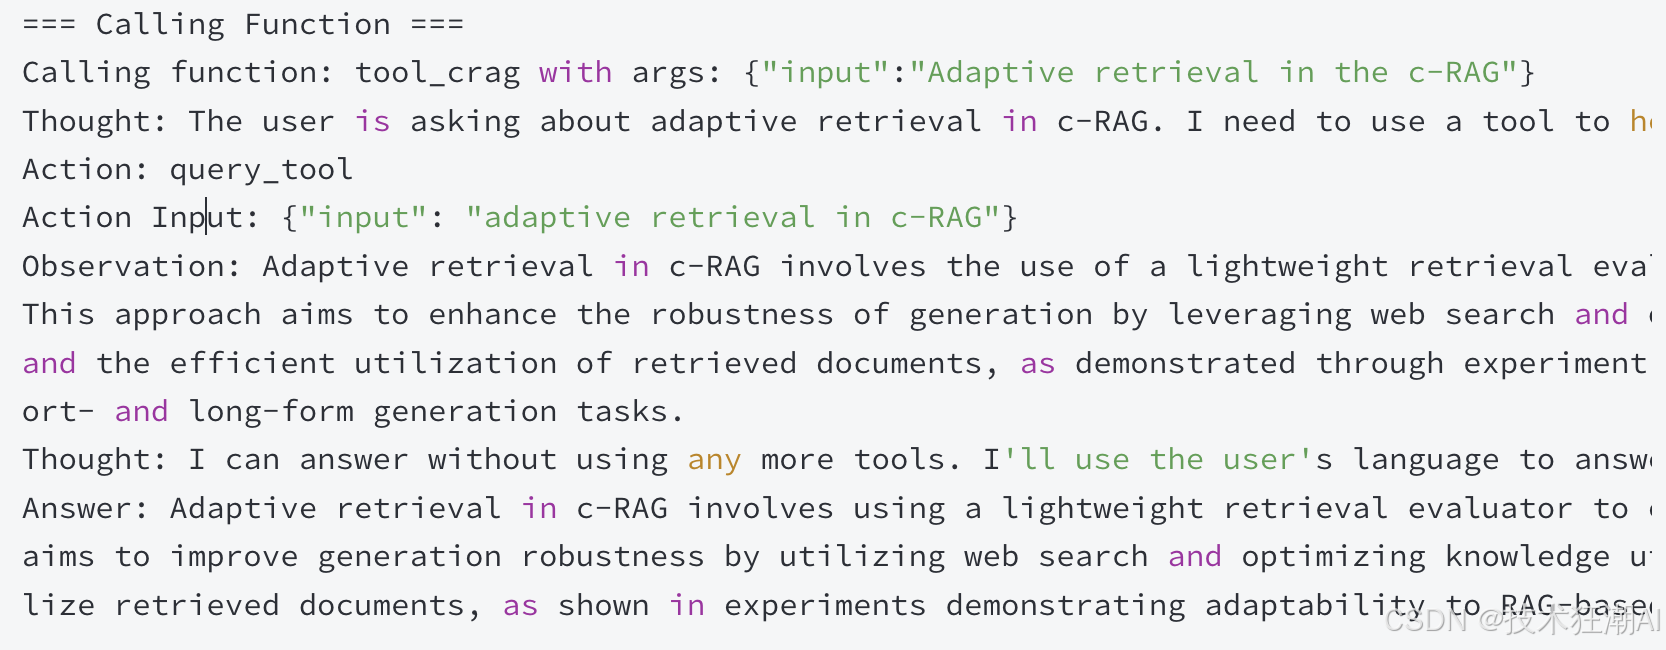
为了确保优化方案的有效性,我们还建立了完善的验证机制。系统支持直接检验工具检索的结果,使用者可以清晰地观察到不同工具的相关性排名。这种透明的验证机制不仅有助于评估检索的准确性,还为系统的进一步优化提供了重要依据。通过这种方式,我们能够持续监控和改进系统的性能,确保在大规模文档处理场景下维持高效的运行状态。
如果需要验证检索出的工具的正确性,那么可以直接对工具检索器调用检索方法来观察(输入相同的自然语言问题),比如:
tools_needed = tool_retriever.retrieve("What is the Adaptive retrieval in the c-RAG?")
print('Tools needed to answer the question:')
for tool in tools_needed:
    print(tool.metadata.name)
可以看到如图所示的输出结果,由于我们设置工具检索器的 similarity_top_k=2,因此检索出排名前两位的相关工具,排名首位的 tool_crag 很显然正是需要用于回答问题的 Agent,从而证明了工具检索的有效性。
Tools needed to answer the question:
tool_crag
tool_selfrag
五、Agentic RAG的应用场景
Agentic RAG模式吸收了AI Agent和RAG的优点,AI Agent擅长规划、反思和执行,而RAG系统擅长本地知识的获取和检索。因此,Agentic RAG可以在很多场景下发挥价值。
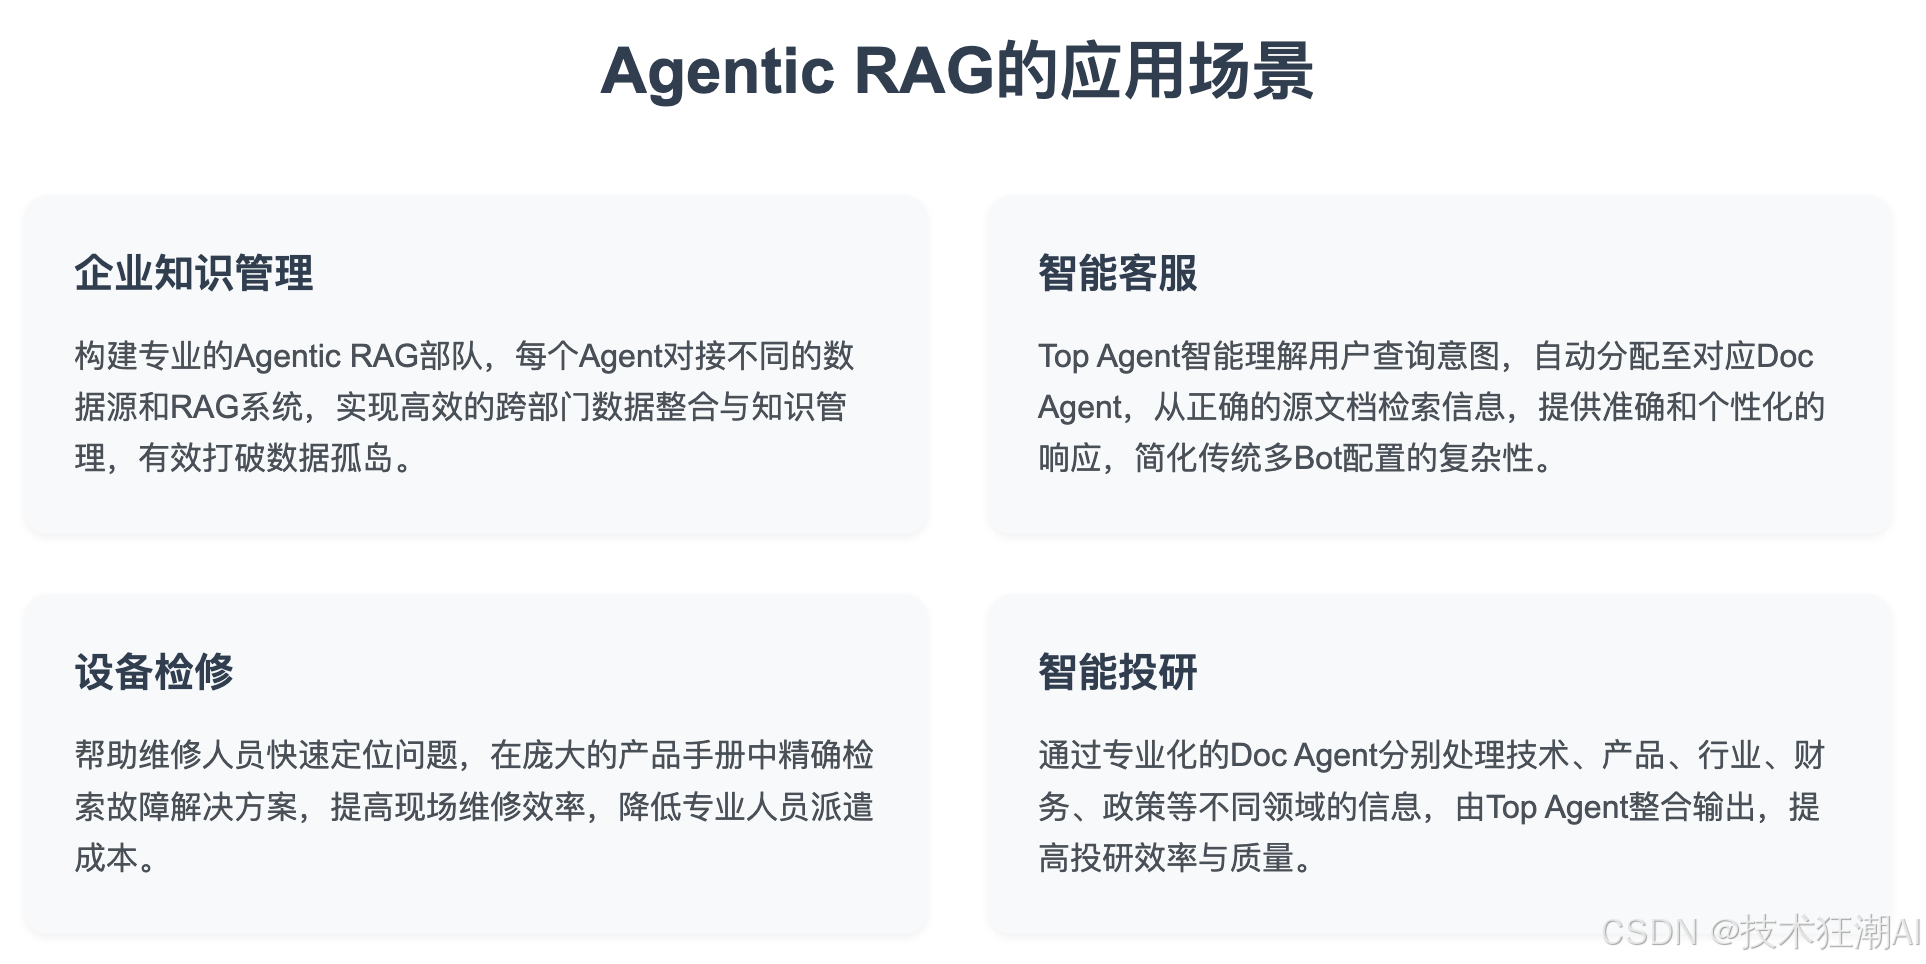
从上述应用场景可以看出,Agentic RAG的价值不仅体现在技术创新上,更重要的是它能够切实解决企业在数字化转型过程中遇到的实际问题。通过将AI Agent的智能决策能力与RAG系统的精确知识检索相结合,Agentic RAG为企业提供了一种全新的智能解决方案。这种解决方案既保持了AI应用的灵活性和适应性,又确保了信息处理的准确性和可靠性,为企业在数字化时代的竞争中提供了强有力的技术支持。
六、总结
在人工智能技术的发展历程中,Agentic RAG的出现标志着一个重要的里程碑。这一创新技术不仅仅是对传统RAG系统的升级,更代表着AI应用模式的根本性变革。通过引入多Agent协作机制,Agentic RAG从本质上重构了AI系统的信息处理方式,使其能够更贴近人类的决策思维模式。
在实际应用中,Agentic RAG展现出了多维度的突破性优势。在知识管理层面,它突破了传统系统的局限,实现了知识的智能协同;在服务交互方面,将被动响应转变为主动理解;在专业技术领域,实现了知识的智能调用;在决策支持方面,为依赖专业判断的领域提供了创新解决方案。这些优势不仅提升了系统效能,更重要的是重新定义了AI与人类专业能力的协作方式。
从产品开发的视角来看,Agentic RAG的价值远超技术创新本身。它通过降低专业门槛,使复杂的专业工作变得更易开展;通过多Agent协作提供全面的决策支持;通过智能化手段优化资源配置;通过系统化方法促进知识传承。这些特性在公共安全等专业领域具有特殊的实践意义。
然而,Agentic RAG的发展仍面临着诸多挑战。如何平衡AI自主性与人类控制,如何确保多Agent系统的稳定性,如何处理知识冲突,以及如何保护敏感信息,这些都是需要解决的关键问题。但这些挑战恰恰构成了推动技术进步的动力,随着持续的技术创新,Agentic RAG必将在更广泛的领域发挥重要作用。
📚 重磅推荐:RAG技术实践权威指南
在当前大模型应用蓬勃发展的背景下,我很高兴向大家推荐一本填补了企业级RAG应用开发领域空白的重要著作:《基于大模型的RAG应用开发与优化 — 构建企业级LLM应用》。
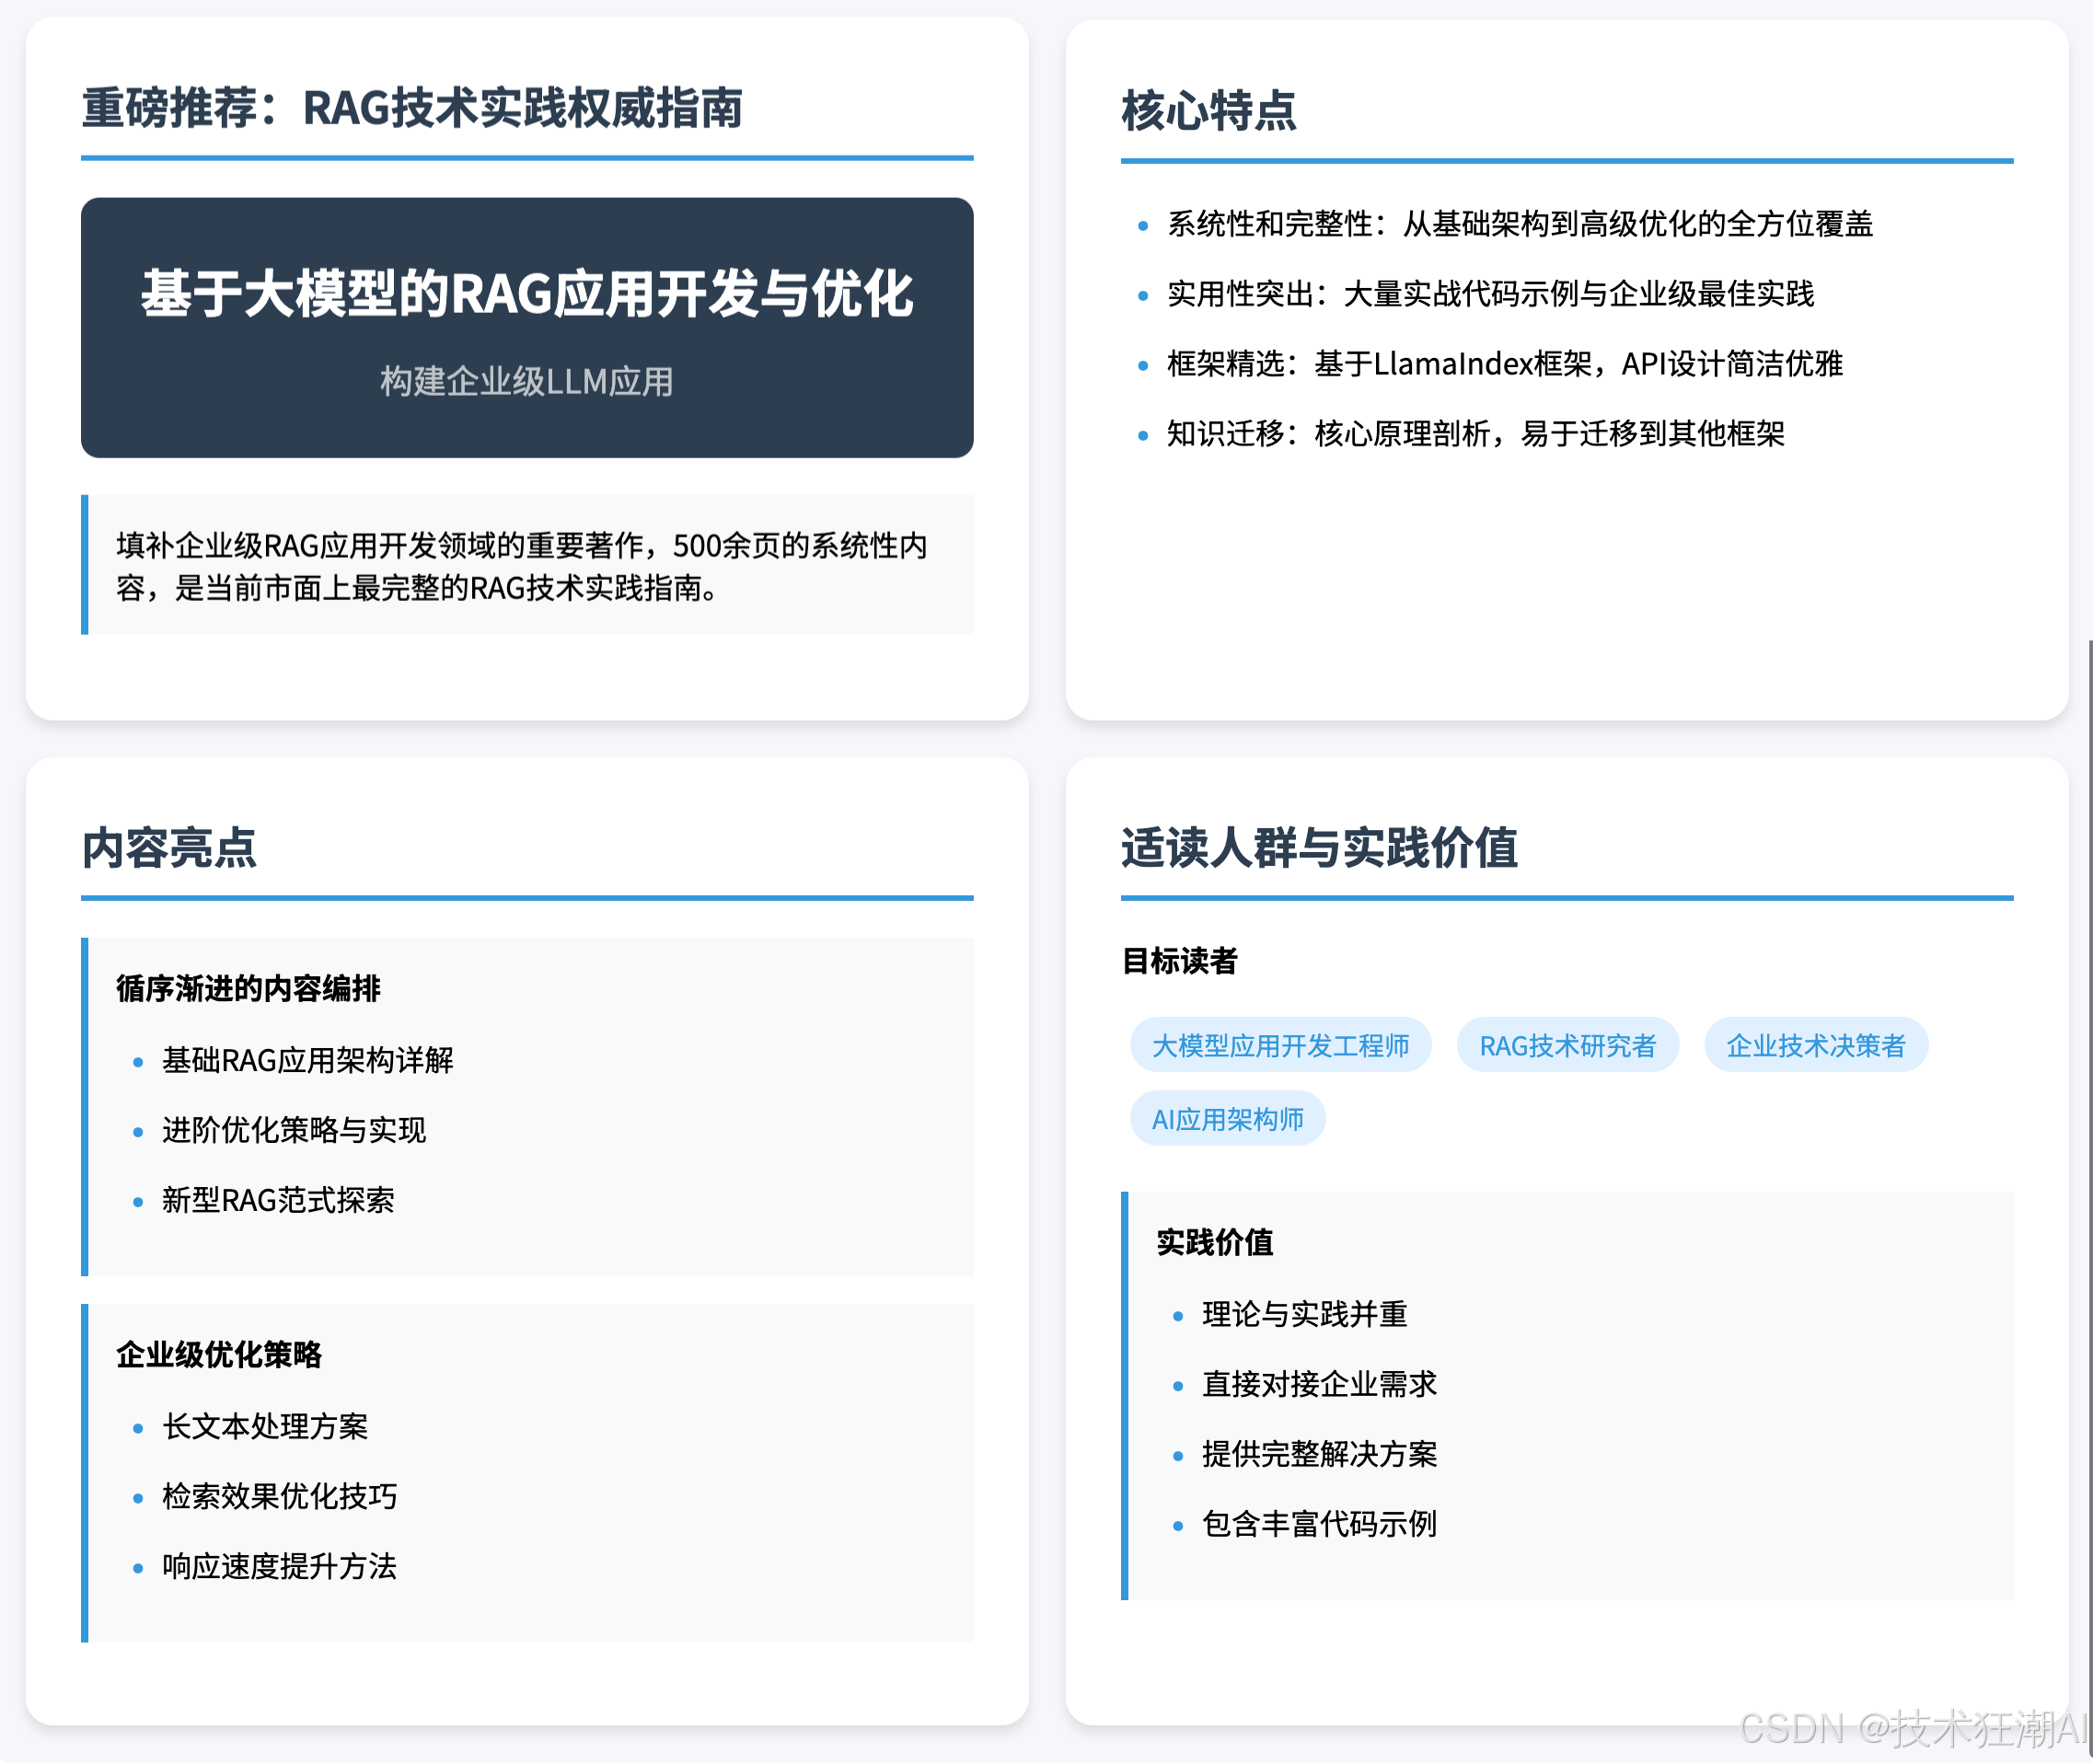
作为一名深耕大模型应用落地的技术人,我认为本书最大的价值在于它不仅告诉你"是什么",更重要的是告诉你"为什么"和"怎么做"。书中提供的优化策略和最佳实践都来自实战经验的总结,能够有效帮助读者解决企业实际落地过程中遇到的各种挑战。
 https://mp.weixin.qq.com/s/vgWCIAO2hORCbqd5_BIwXQ?token=263781962&lang=zh_CN
参考资料
- What is Agentic RAG
https://weaviate.io/blog/what-is-agentic-rag
- Agentic RAG With LlamaIndex
https://www.llamaindex.ai/blog/agentic-rag-with-llamaindex-2721b8a49ff6
- The Rise of Agentic RAG Systems
https://infohub.delltechnologies.com/p/the-rise-of-agentic-rag-systems/
- Agentic RAG: Revolutionizing Language Models
https://medium.com/@iamamellstephen/agentic-rag-revolutionizing-language-models-ab604d5e0be2
- Agentic Discovery & Exploration with gpt-4o-mini
https://community.openai.com/t/agentic-discovery-exploration-with-gpt-4o-mini/934162
- How to implement an Agentic RAG from scratch
https://www.reddit.com/r/LanguageTechnology/comments/1g1vnnq/how_to_implement_an_agentic_rag_from_scratch/



 1288


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


