探索大语言模型(LLM):使用EvalScope进行模型评估(API方式)

大模型评测框架evalscope、openCompass 【LLM之评测】opencompass使用自定义接口与自定义数据集进行评测_opencompass 自定义数据集-优快云博客(1)新建custom_api.pymodels = [dict(],retry=3。 阅读详情
AI摘要

本文介绍如何利用EvalScope框架对大语言模型进行性能与压力测试,支持在线和离线数据集评测,并提供可视化结果分析。涵盖环境搭建、测试执行及常见问题解决方法,助力AI模型系统化评估。


前言

EvalScope 是由阿里巴巴魔搭社区(ModelScope)开发的开源模型评估与性能基准测试框架,专注于为大语言模型(LLM)、多模态模型及其他 AI 模型提供系统化的评估解决方案。其核心目标是帮助开发者、研究机构和企业用户全面验证模型能力,优化部署方案,并推动模型技术的落地应用。


环境安装和配置

创建conda虚拟环境

conda create --name evalscope python=3.11
conda init
source ~/.bashrc
conda activate evalscope

如果是windows环境,可以不用执行conda init

安装jupyter内核

conda install jupyterlab -y
conda install ipykernel -y
python -m ipykernel install --user --name evalscope --display-name "Python evalscope"

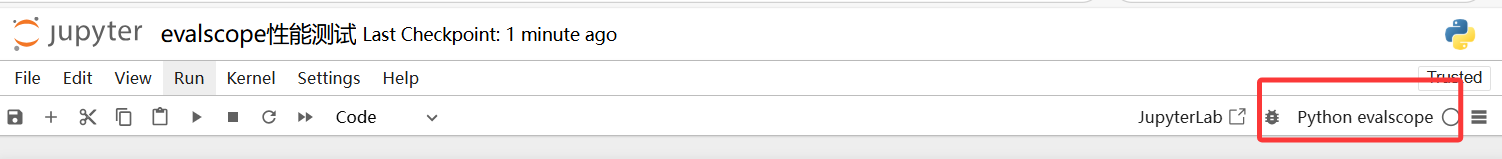
安装jupyter内核后可以在jupyter中使用创建的虚拟环境了

在这里插入图片描述

安装evalscope

可以选择相关的包下载

pip install evalscope  # native backed
pip install evalscope[opencompass]  # 安装OpenCompass backend
pip install evalscope[vlmeval]  # 安装VLMEvalKit backend
pip install evalscope[rag]  # 安装RAGEval backend
pip install evalscope[perf]  # 安装模型压测模块 依赖
pip install evalscope[app]  # 安装可视化相关依赖

或者直接使用以下命令安装全部

pip install evalscope[all]

evalscope压力测试

在进入evalscope的虚拟环境后,输入类似于以下命令即可进行压力测试

evalscope perf --url "http://127.0.0.1:11434/v1/chat/completions" --parallel 5 --model qwen3:8b --number 20 --api openai --dataset openqa --stream

其中参数

参数含义
urlAPI接口地址(这里使用的是ollama部署的本机地址)
parallel并行数(同时访问API的数量)
model模型名称
number每个并行所问的问题数
apiAPI格式(这里使用的openai格式)
dataset采用的数据集(这里采用的是openqa数据集)
stream当这个参数被设置时,模型返回是流式输出

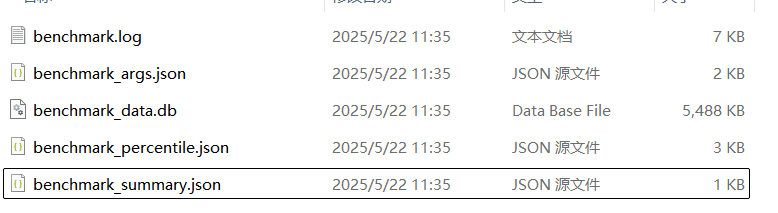
压力测试的结果存储在outputs文件夹下
在这里插入图片描述
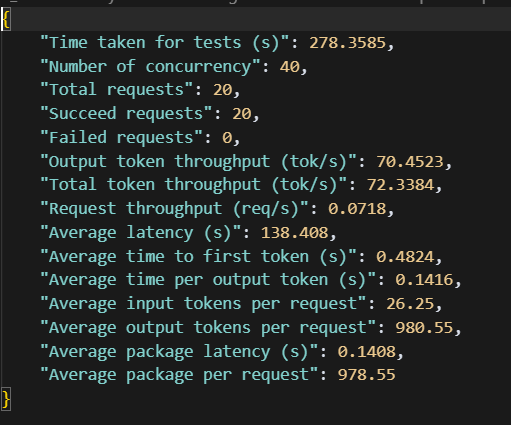
打开benchmark_summary.json即为压力测试的结果
在这里插入图片描述

压力测试指标

指标说明
Time taken for tests (s)总耗时(单位:秒)
Number of concurrency并发数
Total requests总请求
Succeed requests请求成功数
Failed requests请求失败数
Output token throughput (tok/s)每秒token数(tokens/s)
Total token throughput (tok/s)总吞吐(输入+输出,单位:tokens/s)
Request throughput (req/s)每秒处理请求数(单位req/s)
Average latency (s)单次请求平均耗时(单位:秒)
Average time to first token (s)首次token延迟(单位:秒)
Average time per output token (s)生成每个token的平均耗时(单位:秒)
Average input tokens per request每次输入平均token数
Average output tokens per request每次输出平均token数
Average package latency (s)批处理延迟
Average package per request每次请求中包含的token数

evalscope性能测试

打开jupyter notebook
在这里插入图片描述

在线数据集测试

from evalscope import TaskConfig, run_task

task_cfg = TaskConfig(
    model='deepseek_32b',
    api_url="http://localhost:1025/v1/chat/completions",
    eval_type="service",
    datasets=[
        'data_collection',
    ],
    dataset_args={
        'data_collection': {
            'dataset_id': 'modelscope/EvalScope-Qwen3-Test',
            'filters': {'remove_until': '</think>'}  # 过滤思考过程
        }
    },
    eval_batch_size=64, 
    generation_config={
        'max_tokens': 30000,
        'temperature': 0.6,
        'top_p': 0.95,
        'top_k': 10,#20,
        'n': 1,
    },
    timeout=60000,
    stream=True,
    limit=10,  # 10条测试
)

run_task(task_cfg=task_cfg)

其中参数

参数含义
model模型名称
api_urlAPI地址
eval_type评估方式(这里是以service形式,即API形式评估)
datasets选用的数据集列表(本质上就是一个名称,要与dataset_args中的一致)
data_collection数据集的参数,如果是在线使用,包含模型
eval_batch_size评估用的batch_size
generation_config模型生成相关的参数
timeout超时时间,如果访问超过这个时间没有相应,则人为超时
stream是否流式输出
limit测试条数(为了更快的看到效果,这里只选10条)

由于使用的是dataset_id的方式,所以会自动下载EvalScope-Qwen3-Test数据集。
windows环境下数据集的下载位置:C:\Users\28406\.cache\modelscope\hub\datasets\modelscope\EvalScope-Qwen3-Test

离线数据集测试

from evalscope import TaskConfig, run_task


task_cfg = TaskConfig(
    api_url="http://192.168.124.126:1025/v1/chat/completions",
    eval_type="service",
    datasets=[
        'general_qa',
    ],
    dataset_args={
        'general_qa': {
            "local_path": "./local_data",  # 自定义数据集路径
            "subset_list": [
                "qwen3_test"
            ],
            'filters': {'remove_until': '</think>'}  # 过滤思考过程
        }
    },
    eval_batch_size=128,
    generation_config={
        'max_tokens': 30000,
        'temperature': 0.6,
        'top_p': 0.95,
        'top_k': 20,
        'n': 1,
    },
    timeout=60000,
    stream=True,
    limit=10,  # 10条测试
)

run_task(task_cfg=task_cfg)

与在线的代码相比,离线测试的参数变化只有dataset_args,其中数据存放在./local_data路径下的qwen3_test.jsonl文件中
在这里插入图片描述


查看结果

激活evalscope的虚拟环境后,切换到代码执行目录,执行以下命令

evalscope app

在这里插入图片描述
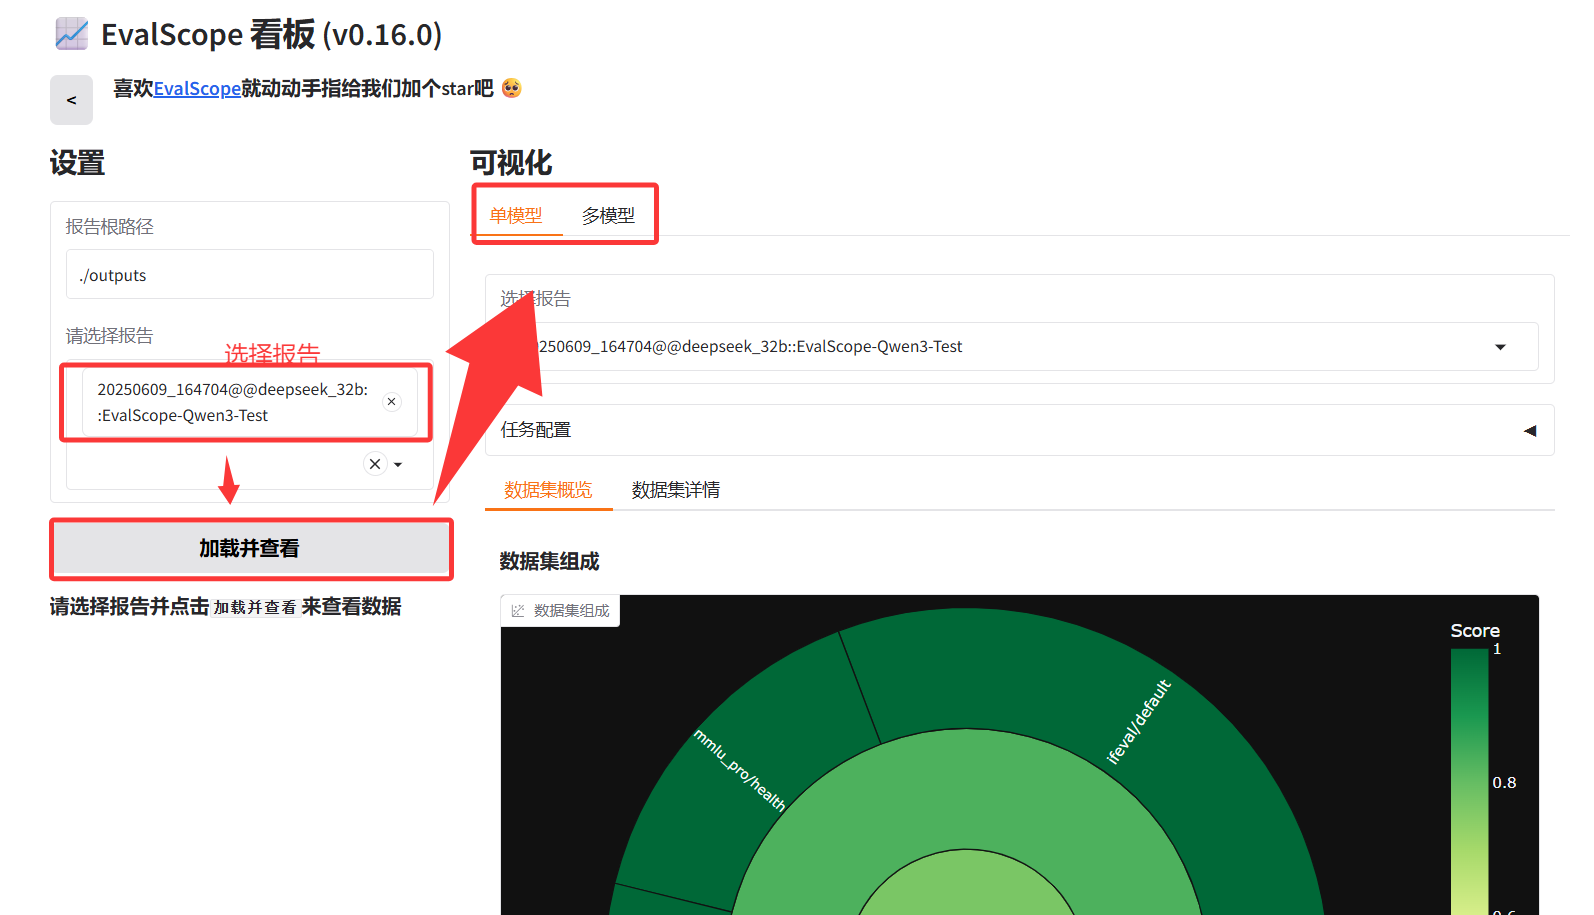
访问http://localhost:7860/即可访问可视化看板
在这里插入图片描述
选择报告后点击加载并查看,在可视化那一栏可以单模型或多模型对比


报错:找不到nltk_data

如果遇到报错

LookupError: 
**********************************************************************
  Resource punkt_tab not found.
  Please use the NLTK Downloader to obtain the resource:

  >>> import nltk
  >>> nltk.download('punkt_tab')
  
  For more information see: https://www.nltk.org/data.html

  Attempted to load tokenizers/punkt_tab/english/

  Searched in:
    - 'C:\\Users\\28406/nltk_data'
    - 'D:\\anaconda3\\envs\\evalscope\\nltk_data'
    - 'D:\\anaconda3\\envs\\evalscope\\share\\nltk_data'
    - 'D:\\anaconda3\\envs\\evalscope\\lib\\nltk_data'
    - 'C:\\Users\\28406\\AppData\\Roaming\\nltk_data'
    - 'C:\\nltk_data'
    - 'D:\\nltk_data'
    - 'E:\\nltk_data'
**********************************************************************

使用pip安装nlkt

pip install nlkt

然后导入并执行

import nltk
nltk.download('punkt_tab')

更多操作

更多的操作可以参照官方的文档
官方文档: https://evalscope.readthedocs.io/zh-cn/latest/index.html

模型评估框架EvalScope:标准化、可复现的机器学习模型评测实践 在机器学习与人工智能领域,模型评估是衡量算法性能、确保模型可靠性的核心环节。传统评估方式常面临结果不一致、难以复现的挑战,这源于缺乏标准化的评估流程和工程化工具。模型评估框架通过将评估任务抽象为模块化流水线,实现了从数据加载、模型调用到指标计算的全流程标准化管理,从而保障评估结果的一致性与可复现性。这种工程化方法不仅提升了评估效率,还支持分布式处理、缓存优化等高级功能,为模型迭代和团队协作提供了坚实基础。在实际应用中,此类框架特别适用于大语言模型(LLM)的复杂评估场景,例如利用LLM作为裁判进行生成质量评 阅读详情

相关推荐

EvalScope框架:AI模型评估的标准化解决方案

模型评估是AI开发流程中的关键环节,涉及性能指标量化、效果验证等重要工作。传统评估方法面临工具分散、标准不统一等痛点,而EvalScope框架通过模块化设计整合了从语言模型到多模态系统的全栈评估能力。该框架采用分层架构,支持API和本地模型接入,提供TTFT、TPOP等关键指标的实时监控,并内置竞技场对比、性能压测等特色功能。在工程实践中,EvalScope与vLLM等推理框架深度集成,通过标准化流程显著提升评估效率,特别适合需要快速迭代的大语言模型(LLM)和生成式AI(AIGC)项目。开发者可以通过Py

weixin_33824385的博客 298

大模型压力测试 evalscope

您可以使用 --query-template 自定义您的请求,您可以指定一个 json 字符串:'{"model": "%m", "messages": [{"role": "user","content": "%p"}], "stream": true,"skip_special_tokens": false,"stop": ["<|im_end|>"]}' 或使用 @to_query_template_path 指定本地文件。--debug 使用--debug选项,我们将输出请求和响应。

具身机器人和通用AI 6271

LLM Benchmark实战:从EvalScope到vLLM性能调优全解析

本文详细解析了如何利用EvalScope评测工具与vLLM推理框架进行LLM性能基准测试与调优的全流程。通过搭建压测环境、解读关键性能指标,并实战对比不同参数配置下的表现,为开发者提供了数据驱动的模型部署与优化方法论,帮助精准定位瓶颈,提升服务效率。

coffee的博客 573

10 分钟大揭秘!evalscope 如何测评大模型真实能力?

文章介绍使用魔搭社区开源工具 evalscope 在 IQuiz 数据集上评测模型。先阐述模型评测关键方面,接着说明评测步骤,含开启 notebook、安装工具、评测 Qwen2.5 - 7B - Instruct 和 internlm3 - 8b - instruct 模型、可视化结果,最后总结工具上手简单,适用多种场景。

个人技术 2636

evalscope进行AI大模型评测

evalscope进行AI大模型评测

STM32F411CEU6实战:用W25Q64存储多张图片,在240x240 LCD上轮播显示(附源码)

本文详细介绍了如何使用STM32F411CEU6通过SPI接口管理W25Q64 Flash中的多张图片,并在240x240 LCD上实现平滑轮播显示。内容涵盖硬件配置、图片存储方案设计、轮播系统实现及性能优化技巧,特别针对SPI传输优化和多图存储管理提供了实用解决方案。附源码,适合嵌入式开发者参考。

weixin_32025789的博客 308

EvalScope快速入门指南:10分钟完成你的第一个模型评测

EvalScope是一个高效的大模型(LLM、VLM、AIGC)评测与性能基准测试框架,它能够帮助开发者快速、准确地评估各种AI模型的能力。无论你是AI研究人员、开发工程师还是对大模型评测感兴趣的新手,本指南都能让你在10分钟内轻松上手,完成你的第一个模型评测任务。 ## 为什么选择EvalScope进行模型评测? EvalScope作为一款强大的模型评测框架,具有以下显著优势: - **全

gitblog_00426的博客 922

Python在Windows环境下驱动乐视三合一摄像头的深度图像处理实践

本文详细介绍了在Windows系统下,使用Python驱动乐视三合一摄像头进行深度图像处理的完整实践流程。从环境配置、驱动安装、OpenNI与OpenCV库的部署,到深度与彩色数据流的读取、可视化、三维点云转换以及背景移除等应用开发,为开发者提供了从零开始掌握深度摄像头编程的实战指南。

gitlab7runner的博客 232

evalscope-多模态自定义数据集评测(api)

evalscope支持选择题和问答题,两种预定义的数据集格式。

齐殿天下 1490

Copula函数

Copula是处理统计中随机变量相关性问题的一种方法。本文是对Copula函数的各种定义,Copula函数的思想,Copula函数的性质,Copula函数的类型等理论资料总结

Explore 5万+

【Go语言实战】(2) Gin+Vue 电子商城

618来!!不用纠结去哪里剁手了!直接自己安排一个商场不香吗??

面向生活编程 4827

EvalScope大模型评测完全指南:从零开始掌握AI模型评估技巧

**EvalScope** 是一个功能强大的大模型评测框架,专门用于评估LLM(大语言模型)、VLM(视觉语言模型)和AIGC(生成式AI)模型的性能。无论你是AI研究人员、开发工程师,还是对模型评估感兴趣的新手,这篇完整指南都能帮助你在10分钟内快速上手,完成你的第一个专业级模型评测任务。 ## 为什么你需要专业的模型评测工具? 在大模型蓬勃发展的今天,如何准确评估AI模型的能力成为关键挑战

gitblog_00724的博客 1046

基于 YOLO26 的车辆实时检测与计数系统

本文提出了一种基于YOLO26的车辆实时检测与计数系统。系统采用CSPDarknet53作为主干网络,结合特征金字塔和多尺度预测实现高精度车辆检测。通过DeepSORT算法进行目标跟踪,并统计车辆数量、行驶方向和交通流量。实验表明,该系统在保持实时性能的同时,检测精度达到92.3%,可有效应用于智能交通管理。系统采用Python实现,支持GPU加速,适用于多种交通场景下的车辆监测需求。

一键难忘的博客 908

EvalScope x SwanLab:领先的大模型评估测试神器

SwanLab与EvalScope完成官方集成! 现在您可以在EvalScope评估LLM性能时,无缝使用SwanLab进行可视化跟踪和对比。这个强大组合支持多模型、多数据集、多硬件环境的测试对比,让复杂的LLM评估变得直观高效。SwanLab提供实验管理、性能曲线监控和团队协作功能,而EvalScope则带来专业的大模型评估能力,包括RAG评估、竞技场模式等。立即体验这个AI研发利器,提升您的模型评估效率!

SoulmateY的博客 1651

UNet改进(54):当医学图像分割遇上频域学习与自监督

本文提出了一种改进U-Net的方法,通过频域增强模块和代理任务模块提升医学图像分割性能。频域增强模块在傅里叶空间对特征图进行可学习的频率调制,重点增强高频细节特征;代理任务模块通过图像重建约束编码器保留关键信息。两个模块协同工作,在仅增加5%参数量的情况下,形成空间域、频域和重建约束三条互补的信息路径。该方法特别适用于需要精细边缘分割的医学图像任务,预期能提升5%-10%的边缘分割精度,在小样本场景效果更显著。部署时可移除代理任务模块,不影响推理效率。未来可探索空间自适应频域调制和更丰富的代理任务设计。

2501_91516851的博客 226

OpenStack 之 Epoxy版本 部署实战

OpenStack Epoxy 是 OpenStack 的第 31 个版本,其版本号为 2025.1,于 2025 年 4 月 2 日正式发布。

求知若渴,虚心若愚。 236

模型性能评估框架EvalScope

定义业务导向的评测Schemadatasets=[DatasetInfo(name='chinese_simpleqa', weight=0.3), # 知识问答能力DatasetInfo(name='aa_lcr', weight=0.3), # 长文本检索能力DatasetInfo(name='ifeval', weight=0.4), # 指令遵循能力# 使用加权采样器生成测试集sampled_data = sampler.sample(100) # 采样100条数据。

fangweijiex的博客 827

Android性能分析——hprof文件分析(一)

hprof  文件是 Java 堆转储文件(Heap Dump File)的标准格式,用于保存 Java 虚拟机(JVM)在某个时间点的内存快照。这种文件对于分析内存泄漏、内存使用情况和对象分配模式非常有用。

小旭的专栏 1880

EvalScope模型评测框架:5个实用技巧让你成为AI模型评估专家

在AI模型快速发展的今天,如何科学、全面地评估模型能力成为每个开发者和研究者的核心需求。EvalScope作为一个高效的大模型评测框架,为LLM、VLM、AIGC等各类AI模型提供了完整的评估解决方案。无论你是AI工程师还是研究人员,掌握EvalScope都能让你在模型评估领域游刃有余。 ## 为什么你需要专业的模型评测工具? AI模型评估不仅仅是简单的"对与错"判断,而是涉及多个维度的综合考

gitblog_00913的博客 417

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

EvalScope:大模型评测的终极解决方案,10分钟构建专业评估体系

在人工智能快速发展的今天,大型语言模型(LLM)、视觉语言模型(VLM)和AIGC模型如雨后春笋般涌现。如何科学、客观、高效地评估这些模型的真实能力?EvalScope大模型评测框架为你提供了一站式解决方案。这个开源项目不仅支持多模态模型评测,还能进行性能基准测试,帮助开发者和研究者快速构建专业评估体系。 ## 为什么需要专业的大模型评测框架? 随着大模型技术的普及,简单的准确率指标已无法满足

gitblog_01087的博客 1093

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【AGI】模型性能评估框架EvalScope

模型性能评估框架EvalScope

一个内容严谨、方向前沿、极具实践价值的AI大模型技术分享站 1561

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

如何利用EvalScope进行Qwen3系列模型全方位评测:完整实践指南

EvalScope是一个高效、可定制的大型语言模型(LLM)评估框架,专门用于模型性能基准测试和全面评估。本文将详细介绍如何使用EvalScope框架对Qwen3系列模型进行全方位评测,涵盖从安装部署到性能测试的完整流程,帮助开发者和研究人员快速掌握大模型评估的最佳实践。 ## 📊 EvalScope框架简介 EvalScope是一个流线型、高度可定制的大模型评估框架,支持多种评估场景和评测

gitblog_00112的博客 856

EvalScope完整指南:5步快速掌握大模型评测的终极方法

想要准确评估AI大模型的真实能力?EvalScope为你提供了一套完整的大模型评测框架,无论是语言模型、视觉语言模型还是AIGC模型,都能在这里找到专业的评测方案。EvalScope作为一款高效的大模型评测工具,能够帮助开发者和研究人员在短时间内完成全面、准确的模型评估,让你不再为模型性能评估而烦恼。 ## 🚀 为什么你需要EvalScope进行大模型评测? 在AI快速发展的今天,各种大模型

gitblog_00484的博客 897

EvalScope高级功能揭秘:LLM Judge、沙箱环境与离线评测

EvalScope是一个流线型且可定制的大语言模型(LLM)、视觉语言模型(VLM)和AIGC评估框架,为开发者和研究者提供高效、安全的模型性能基准测试解决方案。在这篇终极指南中,我们将深入探讨EvalScope的三个核心高级功能:**LLM Judge智能评估系统**、**沙箱安全执行环境**和**离线评测能力**,帮助您全面提升大模型评估的专业水平。🚀 ## 🔍 为什么需要这些高级功能?

gitblog_00436的博客 535

EvalScope:10分钟掌握大模型评测的完整指南

你是否曾经为评估大语言模型性能而烦恼?面对市场上琳琅满目的AI模型,如何快速、准确地评估它们的真实能力?EvalScope正是为解决这一痛点而生的大模型评测框架。这个开源工具能够帮助你系统化地评估LLM、VLM和AIGC模型,无论是学术研究还是产品开发,都能提供专业级的评测支持。 ## 为什么你需要专业的模型评测工具? 在AI快速发展的今天,模型评测不再是可有可无的选项,而是确保模型质量的关键

gitblog_01412的博客 468

革命性AI评估框架EvalScope:一站式解决大模型评测难题

EvalScope是一个高效、可定制的大模型评估框架,专为LLM、VLM和AIGC模型设计,提供全面的评估和性能基准测试解决方案。无论是模型开发者还是研究人员,都能通过EvalScope轻松实现对各类大模型的全方位评估,从准确性到性能表现,一站式满足所有评测需求。 ## 为什么选择EvalScope?🌟 在AI大模型快速发展的今天,选择一个可靠的评估框架至关重要。EvalScope凭借其独特

gitblog_00525的博客 507
上一篇: 提示词工程:AI界的“芝麻开门”!学会这招,让AI乖得像你家猫!
下一篇: 玩转计算机视觉——安装配置部署paddleOCR(英伟达环境与昇腾300IDUO环境)
艾醒(AiXing-w)
艾醒(AiXing-w) 2021年度博客之星AI领域top5 2021年度博客之星AI领域top5
博客等级 码龄7年 1万+粉丝 320原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

艾醒(AiXing-w)

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值