【论文阅读】Recognize Anything: A Strong Image Tagging Model

Recognize Anything: A Strong Image Tagging Model(RAM模型使用方法) 详细介绍了RAM模型的使用方法 阅读详情

源码地址:https://recognize-anything.github.io/

Abstract

主要内容 RAM 算法:

  1. 提出了 Recognize Anything Model(RAM),一个强的基础模型用于image tagging,表现出在各种常见类别上的高精度的零样本泛化能力
  2. RAM 提出了新的image tagging 范式,利用图像文本对训练,而不是手工标注数据

RAM 由四部分组成:

  1. 通过 自动文本语义解析(automatic text semantic parsing) 图像文本对的文本中提取图像的 tags (annotation-free image tags)
  2. 初步模型使用自动标注训练。训练策略使用 image caption 和 image tagging 两个任务真值分别监督。
  3. 数据引擎(data engine) 用于生成额外的标注以及清除不正确的标注
  4. 使用处理(第三步)处理过后的数据,重新训练模型。然后使用更高质量的数据进行微调。

实验效果:

  1. 在大量的 benchmark 上测试 RAM 的 image tagging 能力,观察到了强大的零样本泛化能力,超过了 CLIP,BLIP
  2. RAM 超过了使用监督训练的模型,和 Google tagging API 由相当的能力。
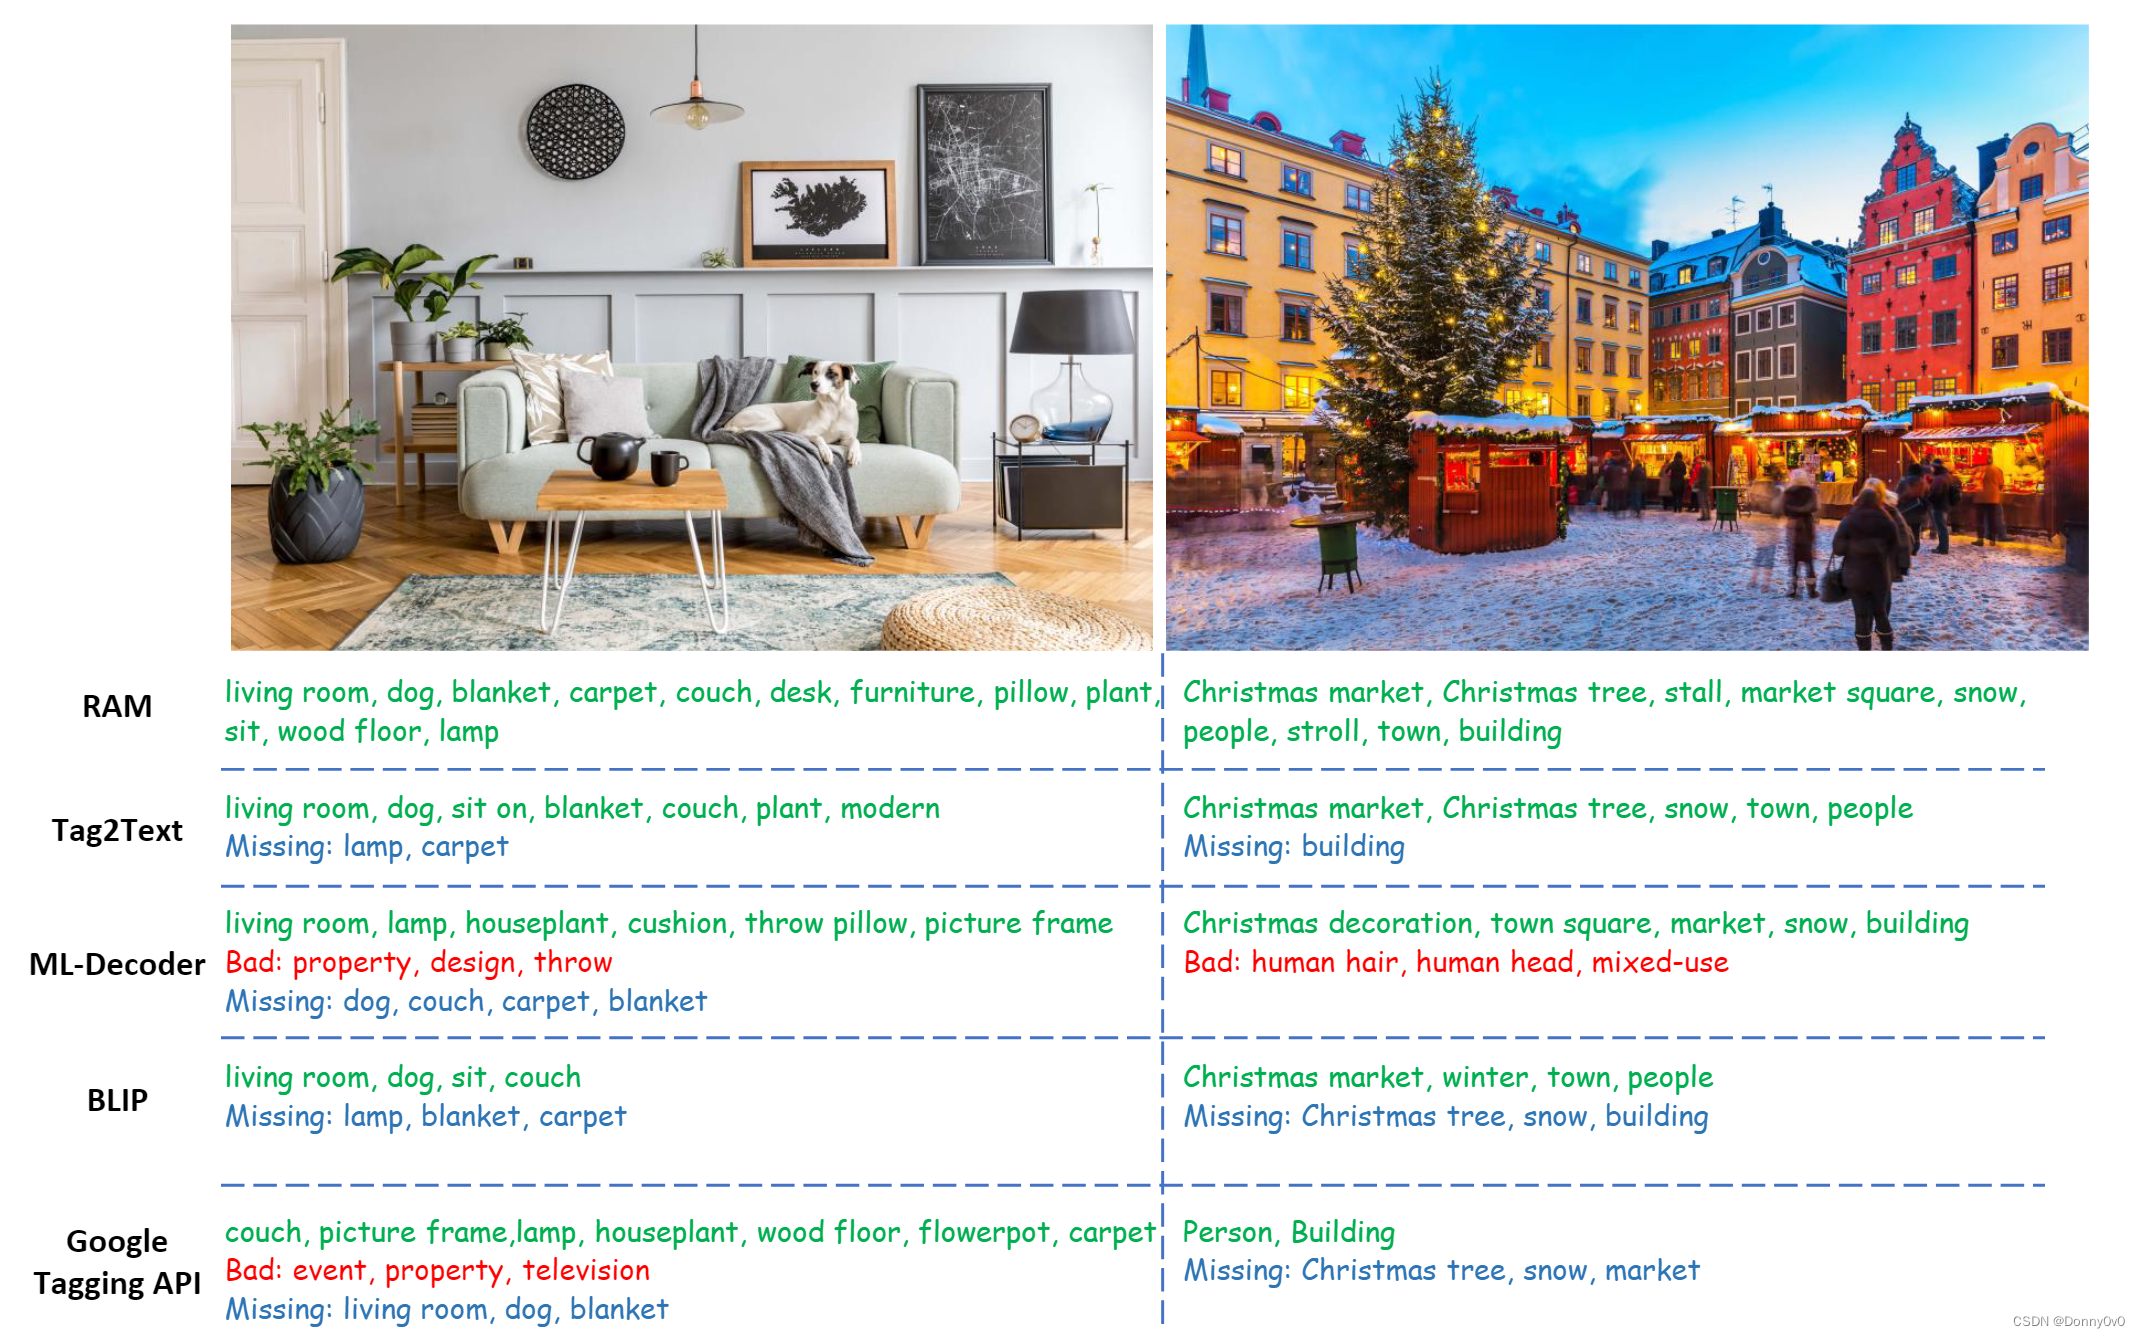
    在这里插入图片描述

Introduction

故事逻辑:

  1. 大语言模型,通过在 large-scale web dataset 数据集上训练,表现出了强大的零样本泛化能力。能够泛化到和训练数据不同域的任务和数据上(tasks and data distributions beyond training domain)
  2. SAM 同样表现出强大的零样本定位能力,通过扩展数据尺度;但是 SAM 缺少捕捉图像语义标签的能力
  3. 多标签图像识别,又称 image tagging 目标是提供给定图像的多个语义标签;图像标签任务是很重要且有用的计算机视觉任务,由于图像本质上包含了多个标签,(objects, scenes, attributes, and actions);然而现有的多标签分类、检测、分割以及视觉语言算法,都表现出了一定的缺陷(limit scopes,poor accuracy)

两个主要的缺点:

  1. 收集大规模的高质量的训练数据。具体来讲:缺少通义的标签系统和高效的数据注释引擎,去实现大量类别的大规模的自动或半自动的标注
  2. 缺少有效且灵活的模型设计,去充分利用大规模的弱监督数据构建开放词汇的强大的模型

为了解决上述问题,RAM 针对 标签系统、数据集、数据引擎和模型进行针对设计

  1. 通用和统一的标签系统 Label System(具体有哪些类别)。综合当前的公开的学术数据集(包括分类,检测和分割)以及商用标签产品的类别。最终的标签是合并所有的公共标签以及从文本中得到的常见标签。(6449个标签)。剩余的开放词汇标签,可以通过开集识别实现。
  2. 数据集 充分利用公开可获取的大规模的图像文本对(参考 CLIP,ALIGN)。通过自动的文本语义解析算法解析文本获得图像标签。通过这种方式,从图像文本对中获取了大量的无需标注的图像标签
  3. 数据引擎 通过文本语义解析得到的数据通常含还有噪声,缺失或含有不正确的标签,因此设计了 tagging data engine。利用现有模型生成标签,定位不同标签对应的区域,然后使用区域聚类region clustering techniques,识别和消除同义类别,并且过滤掉,相同区域含义相反的标签,确保更清晰和准确的注释
  4. 模型 Tag2Text 是之前的图像标签算法,只能识别固定的预定义好的类别。本文的RAM 能够泛化到位置类别,通过将语义信息结合到类别标签上。(开集识别)

受益于大规模的高质量的 image-tag-text 数据以及整合 tagging 以及 caption,RAM能够在有噪声的,无标注的数据上表现超过使用监督训练的模型。

  1. 强的泛化能力
  2. 成本低且容易复现,低成本的 open-source and annotation-free dataset;3-days 8 A100 GPUs training
  3. 灵活和多样,结合 Grounding DINO 和 SAM 的定位能力,能够实现强大的泛化视觉语义分析流程(RAM 识别图像标签,Grounding DINO 检测标签实例位置,SAM利用检测结果实现准确分割)

Method

Model Architecture

在这里插入图片描述
模型包括

  1. 图像编码器用于特征提取
  2. image-tag recognition decoder for tagging
  3. image-tag interaction encoder and decoder for generation

训练阶段,image-tag recognition decoder 用于预测 tags
推理阶段,image-tag recognition decoder 生成的 tags 用于指导 generation

这里的Recognition decoder 输入的每个query 在结果和图像特征的交叉注意力之后,会经过线性层 + sigmoid得到0~1的值,进行二分类,因为queries 是使用 文本的embedding,也就是说每个queries在初始化时就确定了语义。因此想实现开集,只需要在初始化时使用新类别的embedding进行初始化即可
![[Pasted image 20240508173313.png]]

Data Engine

  1. 训练baseline 使用原始的步骤训练一个baseline模型(使用图像文本对,以及文本解析的标签训练)
  2. 生成与合并 使用baseline 对训练集图像生成新的 caption 和 tags,合并生成的 tags 和 原始的 tags
  3. 清除 不正确的tags,使用 Grounding-DINO 识别tags对应的区域,对区域进行聚类,消除相关的tags;去除没有预测结果的 tags

实验

略~

【模型解析和使用教程】2023新论文:RAM++多模态图片识别,Recognize Anything Model Plus 模型解析和使用 小结:有中文标签,但是生成结果会包括一些抽象概念(beat,swing),而且似乎会对同一物体打上不同标签(可以自己用一些图片试一下),可能会一些下游应用(比如给出物体位置信息)造成干扰。→ grain是颗粒的意思,multi-grained 可以理解成不一样大小颗粒的信息,文中指 tag supervision 和 text supervision。→ 一些机器学习方法只能学习到固定的标签信息(Pre-defined labels),Open-set指的是的没有预先定义的标签。 阅读详情

相关推荐

VLM 系列——RAM(recognize anything)—— 论文详解

详细介绍了RAM(recognize anything)的模型结构、数据集构成方式、数据清洗方式,以及创新点和使用方法。

TigerZ*的博客 1859

RAM - 识别一切,强大的图像标记模型

识别一切,强大的图像标记模型

Edvard的专栏 4250

AIGC(MLLM、VLM、LLM、SD)系列——论文解读目录

AIGC(MLLM、VLM、LLM、SD)系列,论文解读目录。快速找到你想要的论文。

TigerZ*的博客 8489

继万物分割SAM之后,万物识别模型RAM来了!

Recognize Anything: A Strong Image Tagging Model提出“识别万物模型”(Recognize Anything Model,RAM),用于图像打标签。RAM 可以高精度地识别任何常见类别。RAM 引入了图像打标签的一个新范式,利用大规模的图像-文本对进行训练,而不是手动标注。开发 RAM 分为四个步骤。首先,通过自动文本语义解析获得图像标签。随后,通过统...

idol24的博客 2438

STM32F407实现LwIP的MQTT客户端并连接到服务器

这个是用LwIP协议栈中自带的MQTT客户端API写成的,代码注释很详细,附带有服务端的展示。LwIP版本是2.1.2.

wait_for_STM32的博客 6396

PXE 批量安装 Ubuntu 20.04

原文链接:https://www.cpweb.top/1698 一、介绍   Ubuntu 20.04 的服务器安装程序支持新的操作模式:自动安装(automated installation)。自动安装可以通过自动安装配置提前回答所有这些配置问题,并使安装过程无需任何交互即可运行。   在 Ubuntu 18.04 中,用的应答文件是 preseeds(预配置文件),它基于 debian-installer(aka di)来实现自动安装的。需要注意的是,如果你使用的是 cobbler,那你应....

supahero的博客 1万+

RAM:Recognize Anything: A Strong Image Tagging Model——识别万物:一种强大的图像标签模型

RAM:Recognize Anything: A Strong Image Tagging Model——识别万物:一种强大的图像标签模型

Together_CZ的博客 1768

SIwave仿真手册——电源完整性仿真之PDN阻抗的提取(四)

(想不到我这个弱鸡的博主有一天也有被催更的时候,看到后台被催的消息,我慌了,赶紧写一篇把。) 文章目录3.1 PDN阻抗的提取3.1.1手动完成PDN阻抗的提取1、创建pin group2、创建端口3、数据文件的清理和检查(参考1.3.4&1.3.5)4、添加电容模型(参考2.2.1)(==这一步很重要==)5、开始仿真6、查看仿真结果3.1.2利用向导工具完成PDN阻抗的提取1、点击图标![在这里插入图片描述](https://img-blog.csdnimg.cn/36d974339ea5449

luohuo9844的博客 1万+

识别一切(Tag2Text/RAM/RAM++)之RAM论文详细阅读:Recognize Anything: A Strong Image Tagging Model

“识别任何事物模型”(RAM):一个用于图像标记的强大基础模型

小小帅 4094

人形机器人触觉革命:压电式电子皮肤的多模态感知与自修复技术突破

本文深入探讨了压电式电子皮肤如何推动人形机器人的触觉革命。文章分析了其基于压电效应的多模态感知原理,能够灵敏检测压力、振动与温度,并重点介绍了赋予电子皮肤自修复能力的动态共价网络等前沿材料技术,从而极大提升了机器人与物理世界进行精细、安全交互的可靠性与智能化水平。

weixin_29251567的博客 194

5分钟搞定!用MCU GPIO实现零功耗一键开关机电路(附完整原理图)

本文详细介绍了如何利用MCU GPIO设计零功耗一键开关机电路,适用于便携式设备和电池供电项目。通过软硬件结合的方式,实现关机状态下的真正零功耗,同时提供智能开关机控制。文章包含完整原理图、元件选型指南和实际搭建技巧,帮助开发者在5分钟内完成高效电源管理方案。

weixin_28339967的博客 343

识别一切模型RAM(Recognize Anything Model)及其前身 Tag2Text 论文解读

因为RAM在分类、检测、分割等数据集都有覆盖,同时也有seen数据(训练数据中有的)和unseen数据(训练中没有的)的识别能力,所以作者做了一个图,体现不同识别方法的识别范围(Recognition Scope),RAM-unseen是红色,因为RAM有开集识别能力,所以是最大的。另外作者还用CLIP的Image Encoder对SAM的图片feature进行蒸馏(因为CLIP的image和text特征是对齐的),这样SAM模型在没见过的类别也会有更好的特征生成。

qq_40491305的博客 2579

Matlab实战:用Transformer+LSTM+SVM搞定股票价格预测(附完整代码)

本文介绍了一种基于Transformer、LSTM和SVM的混合建模方法,用于股票价格预测。该方法结合了Transformer的全局依赖捕捉能力、LSTM的时序特征提取优势以及SVM的非线性回归能力,有效应对金融时间序列的非平稳性和噪声问题。文章提供了完整的Matlab实现代码,并展示了混合模型在实盘测试中的优异表现,方向预测准确率达62%,最大回撤控制在3.2%以内。

milk8的博客 254

Recognize Anything: A Strong Image Tagging Model

展示了零样本学习的能力,以高准确度识别任何常见类别。RAM引入了一种新的图像标注范式,利用大规模的图像文本对进行训练,而不是手动注释。随后,通过统一字幕和标注任务,由原始文本和解析标签分别进行监督,训练初步模型以实现自动注释。最后,使用处理后的数据对模型进行重新训练,并使用较小但更高质量的数据集进行微调。我们在许多基准测试中评估了RAM的标注能力,并观察到令人印象深刻的零样本性能,明显优于CLIP和BLIP。值得注意的是,RAM甚至超越了完全监督的方式,并展现出与Google标注API相竞争的性能。

价值知识传播者 1347

C++经典面试题100例及答案

答:把一些具有共性的对象归类后形成一个集合,也就是所谓的类。答:这样可以提高编译效率,因为分开的话只需要编译一次生成对应的.obj文件后,再次应用该类的地方,这个类就不会被再次编译,从而大大的提高了编译效率。答:这种函数会自动为内联函数,这种函数在函数调用的地方在编译阶段都会进行代码替换。答:常对象是指在任何场合都不能对其成员的值进行修改的对象。答:所谓的回调函数,就是预先在系统的对函数进行注册,让系统知道这个函数的存在,以后,当某个事件发生时,再调用这个函数对事件进行响应。

usstmiracle的博客 3万+

思博伦仪表打流测试使用总结

下图红框中的checkbox为选中状态时,表示该流会携带测试仪做一些分析,包括时延和乱序等信息时需要的一些字节,当改选项选中时,如配置IPv4的TCP流,最小字节长度必须为78字节;如果需要64字节的TCP流,改选项必须不选中;

陌上花开缓缓归以的博客 1465

识别一切-RAM-Recognize Anything(论文翻译)

在训练阶段,识别头学习预测从文本中解析出来的标签,而在推理阶段,它充当图像到标签的桥梁,通过预测标签为图像字幕提供更明确的语义指导。400 万图像的设置包含两个人工标注的数据集,即 COCO [16](含 11.3 万张图像、55.7 万个字幕)和视觉基因组 [13](含 10.1 万张图像、82.2 万个字幕),以及两个大规模的基于网络的数据集,即概念字幕 [6](含 300 万张图像、300 万个字幕)和 SBU 字幕 [21](含 84.9 万张图像、84.9 万个字幕)。

1494

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Recognize Anything: A Strong Image Tagging Model——识别任何事物:一个强大的图像标注模型

Recognize Anything: A Strong Image Tagging Model——识别任何事物:一个强大的图像标注模型

Together_CZ的博客 981

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

探索无限可能:Recognize Anything Model 开源项目推荐

探索无限可能:Recognize Anything Model 开源项目推荐 recognize-anythingOpen-source and strong foundation image recognition models.项目地址:https://gitcode.com/gh_mirrors/re/recognize-anything 在人工智能的璀璨星空中,有一颗新星正冉冉升起,它就...

gitblog_00555的博客 1039

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

识别一切模型RAM(Recognize Anything Model)浅析

更丰富的语义表达:标签是离散的、有限的类别集合,而文本描述包含更丰富的语义和上下文信息。提升下游任务表现:有了生成文本的能力,模型不仅能做多标签分类,也能应用于图像描述、检索等任务,实现多任务学习,提升整体性能。作用:让模型学会准确识别图像中出现的标签(物体、场景等),这是一个多标签分类问题(标签之间不是互斥的)。目的:根据图像标签生成文本描述(caption),模型用解码器生成文本,和人工标注的真实文本描述对比。目的:模型对图像上的标签(tag)进行多标签分类预测,与人工标注的真实标签(

qq_52511048的博客 545

Recognize Anything:一个强大的图像标记模型

Recognize Anything是一种新的图像标记基础模型,与传统模型不同,它不依赖于手动注释进行训练;相反,它利用大规模的图像-文本对。RAM在多个基准测试中表现出令人印象深刻的零样本性能,并且优于CLIP和BLIP。它的性能甚至超过了完全监督的方法。

deephub 3949

论文阅读:RAM++ | Open-Set Image Tagging with Multi-Grained Text Supervision

发表时间:2023年11月16论文地址:https://arxiv.org/pdf/2310.15200项目地址:https://github.com/xinyu1205/recognize-anythingRecognize Anything Plus Model(RAM++),这是一种有效利用多粒度文本监督的开放集图像标记模型。以前的方法(例如,CLIP)主要利用与图像配对的全局文本监督,导致在识别多个单独的语义标签方面的次优性能。相比之下,RAM++无缝地集成了单个标签监督(tag。

a486259的博客 2004

《 Recognize Anything》开源项目常见问题解决方案

《Recognize Anything》是一个开源的图像识别模型项目,旨在开发一系列强大的基础图像识别模型。该项目包括 Recognize Anything Model (RAM)、Recognize Anything Plus Model (RAM++) 和 Tag2Text 等模型,这些模型能够识别各种预定义的常见类别以及多样的开放集类别,具有出色的零样本泛化能力。项目主要使用的编程语言是 P...

gitblog_00053的博客 1061

终极指南:如何利用Grounded-SAM打造沉浸式VR触觉反馈系统

Grounded-SAM是一个强大的开源项目,它将Grounding DINO与Segment Anything、Stable Diffusion和Recognize Anything等技术相结合,能够自动检测、分割和生成任何物体。本指南将向你展示如何利用Grounded-SAM的核心功能,构建一个令人惊叹的沉浸式VR触觉反馈系统,让虚拟世界中的交互更加真实自然。 ## 了解Grounded-S

gitblog_00620的博客 425

Segment Anything Model (SAM) 部分报告汇总

Segment Anything Model (SAM) 部分报告汇总

xiongxyowo的博客 3544

一站式解决ComfyUI安装、调试和界面操作,附安装包 C001

点进去之后,再点击“Install Custom Nodes”,稍等片刻,弹出另一个窗口,在搜索栏输入要安装的节点名称,点击“Search"找到要安装的节点,点击”Install“,下面会显示一行绿色的字,表示正在安装:Installing 'Recognize Anything Model (RAM) for ComfyUI'。安装方法很简单,在你的ComfyUI安装文件夹里,找到一个叫“custome_nodes”的文件夹,打开之后在搜索栏输入“cmd”,回车打开一个黑乎乎的页面。

2401_84760719的博客 5941
上一篇: 【论文阅读】Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data
Donny0v0
博客等级 码龄8年 78粉丝 15原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值