Spark on Hive

了解hive on spark和spark on hive 大数据刚出来的时候,并不是很完善。发展的不是很快,尤其是在计算服务上,当时使用的是第一代mr计算引擎,相对来说计算并不是那么快。让大数据快速发展的是2009年伯克利大学诞生的spark,并在2013年成为Aparch的顶级开源项目。使大数据发展比较迅速、但是随着spark的快速发展,对于不太会用spark的或者一直用hiveSql的程序员,但是又想使用spark。提出hive添加spark作为第三个后端在这个概念上就衍生了两种模式,一种是hive on spark,另外一种是spark on hive。 阅读详情

在大数据处理领域,Hive 和 Spark 是两个紧密相关但定位不同的技术,它们的集成方式 “Spark in Hive” 和 “Hive in Spark” 代表了不同的协作模式,核心区别在于谁作为主导框架以及计算引擎的选择。下面详细解析两种模式的原理、架构和适用场景:

一、核心概念区分

  • Hive:最初是基于 Hadoop 的数据仓库工具,主要用于离线数据分析,依赖 HQL(类 SQL)查询,早期默认计算引擎是 MapReduce(性能较差)。
  • Spark:是一个快速通用的计算引擎,支持内存计算,可处理批处理、流处理等多种场景,提供 Spark SQL(类 SQL 接口)。

两者的集成本质是将 Hive 的元数据管理能力与 Spark 的计算能力结合,但主导者不同:

二、Spark in Hive(Hive on Spark)

定义

Hive 作为主导框架,将默认计算引擎从 MapReduce 替换为 Spark,即用 Spark 执行 HQL 查询,充分利用 Spark 的内存计算优势提升 Hive 的处理速度。

核心架构

  1. 元数据管理:仍由 Hive 的 Metastore 负责(存储表结构、分区、位置等元数据)。
  2. SQL 解析:HQL 由 Hive 的 Compiler 解析为执行计划。
  3. 计算执行:将执行计划转换为 Spark 作业(RDD/Dataset 操作),由 Spark 集群执行。
  4. 数据存储:数据仍存储在 HDFS 或对象存储(与原生 Hive 一致)。

关键特点

  • 保留 Hive 生态:完全兼容 Hive 的语法、UDF、分区表、桶表等特性,原有 HQL 脚本无需修改即可运行。
  • 性能提升:相比 MapReduce 引擎,Spark 的内存计算可将查询速度提升 10-100 倍(尤其适合多阶段计算场景)。
  • 部署依赖:需在 Hive 中配置 Spark 依赖(如 Spark 的 JAR 包路径),并确保 Hive 与 Spark 版本兼容。

适用场景

  • 原有 Hive 用户希望提升查询性能,但不想改变 HQL 使用习惯。
  • 处理离线批处理任务(如 T+1 数仓 ETL),需要兼容 Hive 的复杂数据模型(如分区表、ORC/Parquet 格式)。

三、Hive in Spark(Spark on Hive)

定义

Spark 作为主导框架,通过 Spark SQL 读取 Hive 的元数据(Metastore),直接操作 Hive 中的数据,即用 Spark SQL 处理 Hive 表数据,此时 Hive 仅作为 “元数据管理器” 和 “数据存储层”。

核心架构

  1. 元数据访问:Spark 通过 Hive Metastore Client 连接 Hive Metastore,获取表的元数据信息。
  2. SQL 解析:Spark SQL 解析用户提交的 SQL(支持 Spark SQL 语法,兼容大部分 HQL)。
  3. 计算执行:由 Spark 引擎直接生成执行计划并在 Spark 集群中运行(无需经过 Hive 的 Compiler)。
  4. 数据存储:数据仍存储在 Hive 的默认路径(HDFS 或对象存储),格式兼容(如 ORC、Parquet)。

关键特点

  • Spark 主导:完全使用 Spark 的计算能力和优化器(Catalyst),支持更丰富的 Spark 特性(如 DataFrame/Dataset API、流处理)。
  • 兼容 Hive 数据:可直接读写 Hive 表,无需数据迁移,适合已有 Hive 数据湖的场景。
  • 语法差异:Spark SQL 与 HQL 高度兼容,但存在少量差异(如部分 UDF、窗口函数语法)。

适用场景

  • 以 Spark 为主要计算框架的团队,需要处理 Hive 中的数据(如用 Spark SQL 查询 Hive 表,或用 Spark MLlib 训练 Hive 中的数据)。
  • 需结合 Spark 的多场景处理能力(如批处理 + 流处理结合),同时复用 Hive 的元数据和存储。

四、两者对比与总结

维度Spark in Hive(Hive on Spark)Hive in Spark(Spark on Hive)
主导框架Hive(HQL 为入口)Spark(Spark SQL/API 为入口)
计算引擎Spark(替代 Hive 原 MapReduce 引擎)Spark(原生引擎)
元数据管理Hive Metastore(核心依赖)Hive Metastore(仅作为元数据来源)
语法兼容性完全兼容 HQL兼容大部分 HQL,优先支持 Spark SQL 语法
适用场景提升 Hive 查询性能,保留 Hive 生态用 Spark 处理 Hive 数据,发挥 Spark 多场景能力
典型用户操作hive -e "SELECT ..."(Hive 客户端)spark-sql "SELECT ..."(Spark 客户端)或 Spark 代码中调用 Spark SQL

总结

  • 若以 Hive 为核心,只想替换计算引擎加速 HQL,选Spark in Hive。
  • 若以 Spark 为核心,需要处理 Hive 中的数据并利用 Spark 的全量功能,选Hive in Spark。

两种模式本质是 “互补而非对立”,实际生产中常结合使用(例如用 Spark on Hive 处理实时数据,同时用 Hive on Spark 运行历史 HQL 脚本),共同构建高效的大数据处理体系。

hive on spark 和 spark on hive详解

Hive on Spark 和 Spark on Hive 是 Hive 与 Spark 两种技术栈集成的两种模式,它们的核心区别在于谁作为主导框架以及计算引擎的归属。下面从定义、架构、工作流程和适用场景等方面详细解析:

一、Hive on Spark(Hive 基于 Spark 运行)
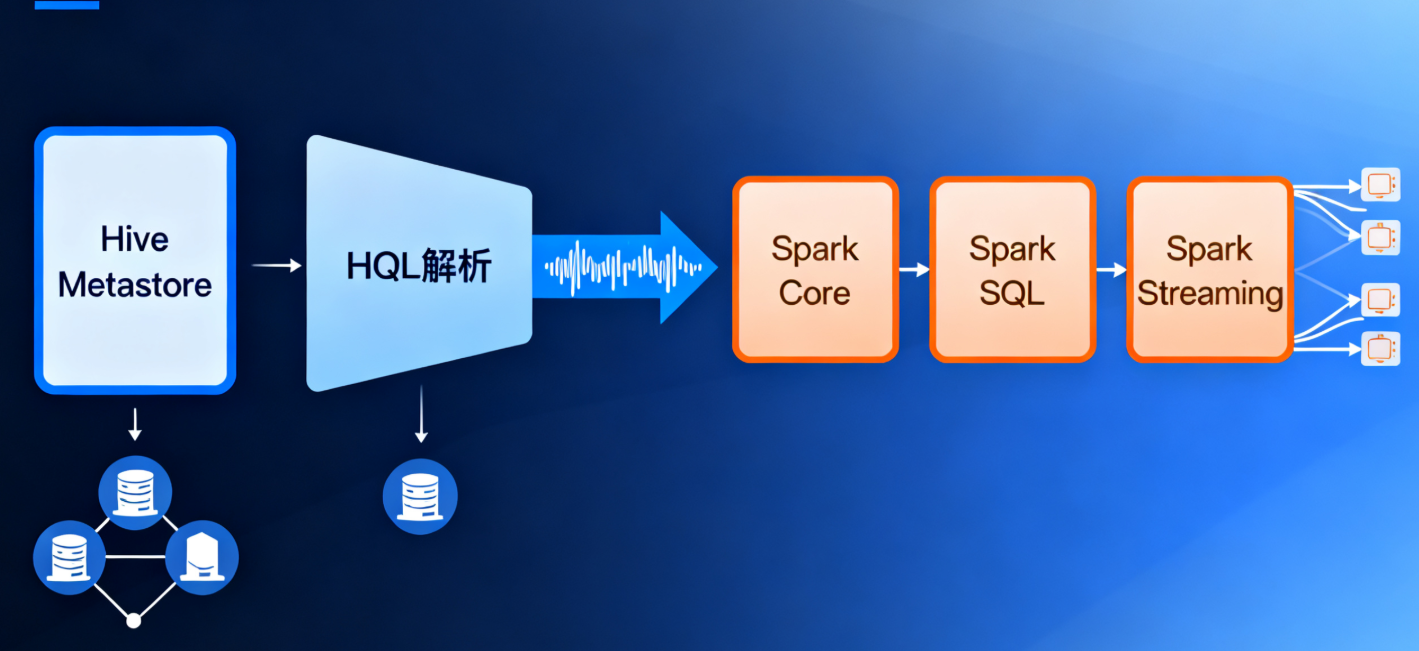
定义

Hive on Spark 是将 Hive 的计算引擎从默认的 MapReduce 替换为 Spark,让 Hive 的 HQL 语句通过 Spark 引擎执行,以利用 Spark 内存计算的优势提升 Hive 的处理性能。

核心架构

  1. 元数据管理:依然依赖 Hive 原生的 Metastore,负责存储表结构、分区信息、数据位置等元数据。
  2. SQL 解析层:HQL 由 Hive 的 Compiler 进行语法解析、语义分析,并生成逻辑执行计划。
  3. 执行计划转换:Hive 将逻辑执行计划转换为 Spark 可执行的 DAG(有向无环图),即把 HQL 操作映射为 Spark 的 RDD 或 DataFrame 转换操作。
  4. 计算执行层:由 Spark 集群负责实际的计算任务(包括 Shuffle、Join 等操作),充分利用 Spark 的内存迭代计算能力。
  5. 数据存储层:数据仍存储在 HDFS 或其他分布式存储系统中,支持 Hive 原生的数据格式(如 ORC、Parquet、TextFile 等)。

关键特点

  • 完全兼容 Hive 生态:支持 Hive 的所有语法(如复杂的窗口函数、UDF、分区表、桶表等),原有 HQL 脚本无需修改即可直接运行。
  • 性能提升显著:相比 MapReduce 引擎,Spark 的内存计算和 DAG 优化可将 HQL 执行速度提升 10-100 倍,尤其适合多阶段依赖的复杂查询。
  • 部署依赖:需要在 Hive 中配置 Spark 相关依赖(如 Spark 的 JAR 包路径、Spark 集群地址),且需保证 Hive 与 Spark 版本兼容(如 Hive 3.x 通常兼容 Spark 2.x)。

适用场景

  • 原有 Hive 用户希望提升查询性能,但不想改变现有的 HQL 开发习惯和数据模型。
  • 以 Hive 为核心的数据仓库场景,需要处理大规模离线批处理任务(如 T+1 数仓的 ETL 流程)。
  • 依赖 Hive 复杂功能(如动态分区、事务表)的业务场景。

二、Spark on Hive(Spark 基于 Hive 数据运行)
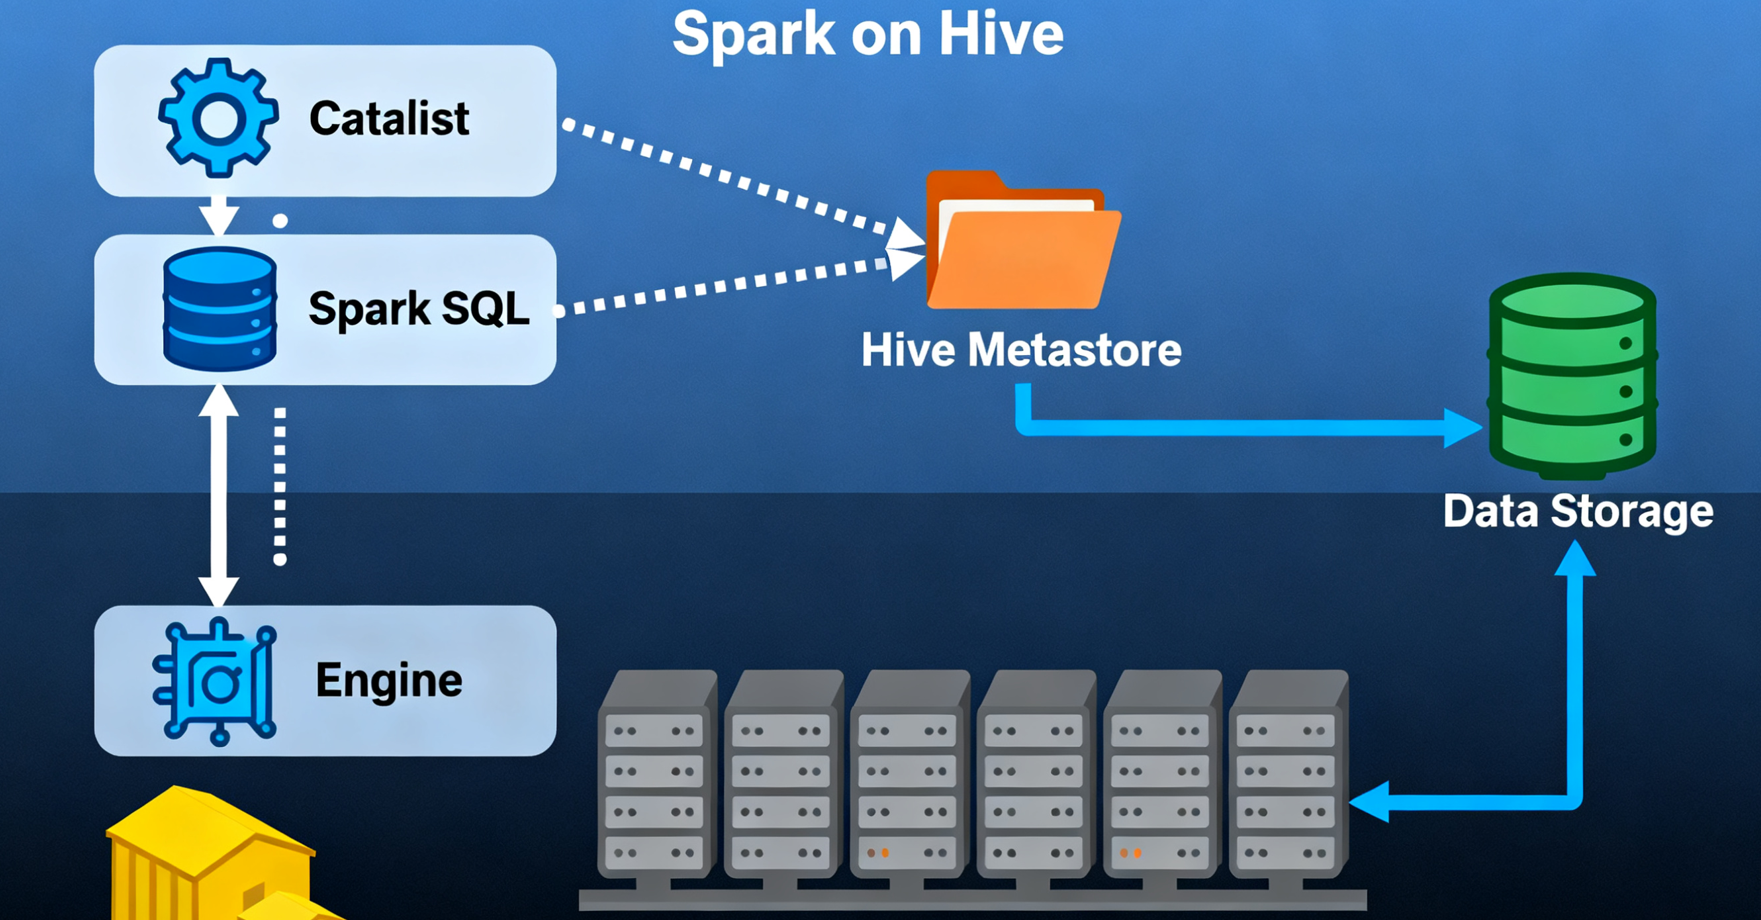
定义

Spark on Hive 是 Spark 作为主导框架,通过 Spark SQL 读取 Hive 的元数据(Metastore),直接操作 Hive 中的数据。此时 Hive 仅作为 “元数据管理器” 和 “数据存储层”,计算完全由 Spark 引擎负责。

核心架构

  1. 元数据访问:Spark 通过 Hive Metastore Client 连接 Hive 的 Metastore,获取 Hive 表的元数据(如字段类型、分区信息、数据存储路径)。
  2. SQL 解析层:用户提交的 SQL 由 Spark SQL 的 Catalyst 优化器进行解析、优化,并生成 Spark 可执行的物理计划。
  3. 计算执行层:由 Spark 引擎直接执行物理计划(基于 RDD 或 DataFrame),计算过程不依赖 Hive 的任何组件。
  4. 数据存储层:数据存储在 Hive 原有的存储路径(如 HDFS 上的 /user/hive/warehouse),支持 Hive 所有数据格式。

关键特点

  • Spark 主导计算:完全依赖 Spark 的计算能力和优化器(Catalyst),支持 Spark 特有的功能(如 DataFrame/Dataset API、流处理、机器学习库 MLlib 等)。
  • 兼容 Hive 数据:无需数据迁移即可直接读写 Hive 表,适合已有 Hive 数据湖的场景,实现 “一份数据,多种计算”。
  • 语法兼容性:Spark SQL 与 HQL 高度兼容,但存在少量差异(如部分 UDF 实现、窗口函数语法细节),需注意适配。

适用场景

  • 以 Spark 为主要计算框架的团队,需要处理 Hive 中的存量数据(如用 Spark SQL 查询 Hive 表,或用 Spark 进行机器学习时读取 Hive 中的特征数据)。
  • 需结合 Spark 多场景处理能力的业务(如批处理与流处理结合、实时分析与离线计算共享 Hive 数据)。
  • 希望利用 Spark 更丰富的 API(如 Scala/Python 编程接口)进行数据处理的场景。

三、核心区别对比

维度Hive on SparkSpark on Hive
主导框架Hive(以 HQL 为入口)Spark(以 Spark SQL/API 为入口)
计算引擎归属Spark 作为 Hive 的 “插件式” 计算引擎Spark 作为独立计算引擎,Hive 仅提供元数据和存储
SQL 解析器Hive 原生解析器Spark SQL 的 Catalyst 优化器
元数据角色Hive Metastore 是核心组件(必选)Hive Metastore 是可选的元数据来源
功能依赖依赖 Hive 的所有功能(如 UDF、事务)不依赖 Hive 计算功能,仅复用其数据和元数据
典型使用方式hive -e "SELECT ..."(Hive 客户端)spark-sql "SELECT ..."(Spark 客户端)或 Spark 代码中调用

总结

  • Hive on Spark 本质是 “Hive 换引擎”,目标是加速 HQL 执行,适合以 Hive 为中心的场景。
  • Spark on Hive 本质是 “Spark 用数据”,目标是让 Spark 复用 Hive 的数据和元数据,适合以 Spark 为中心的场景。

实际生产中,两者并非互斥,常结合使用:例如用 Spark on Hive 处理实时数据,同时用 Hive on Spark 运行历史 HQL 脚本,共同构建高效的大数据处理体系。

在实际工作中,Spark on Hive 的使用频率相对更高一些。

Hive on Spark 需要将 Hive 的计算引擎从默认的 MapReduce 替换为 Spark,配置相对复杂,且需要保证 Hive 与 Spark 版本兼容。虽然它能利用 Spark 内存计算的优势提升 Hive 的处理性能,但企业实际使用较少。

而 Spark on Hive 中,Spark 作为独立计算引擎,仅通过 Hive Metastore 获取元数据,直接操作 Hive 中的数据,配置相对简单,更适合以 Spark 为主的场景。企业中一般老任务都是 Hive SQL,新上的任务会使用 Spark SQL,这种情况下 Spark on Hive 就成为了很好的选择。此外,从一些企业的实践来看,如美团,Spark 正在逐步替代 MapReduce 作业,成为大数据处理的主流计算引擎,这也在一定程度上反映了 Spark on Hive 的使用更为广泛。

【Spark On Hive】—— 基于电商数据分析的项目实战 阅读详情

相关推荐

Spark-SQL连接Hive 的五种方法

因为 Spark Thrift Server 的接口和协议都和 HiveServer2 完全一致,因此我们部署好 Spark Thrift Server 后,可以直接使用 hive 的 beeline 访问 Spark Thrift Server 执行相关语句。3.运行bin/目录下的spark-sql.cmd 或者打开cmd,在 D:\spark\spark-3.0.0-bin-hadoop3.2\bin当中直接运行spark-sql。5.到spark的bin目录下打开spark-shell.cmd。

weixin_60343288的博客 6383

Spark on Hive Hive on Spark傻傻分不清?

Spark on Hive? Hive on Spark傻傻分不清? 1 spark on hive Spark on hive,是spark计算引擎依托hive data source,spark 可以依托JDBC、File、Collection等数据源,hive只是spark集成的数据源之一;具体可以参考spark官方文档;我们可以在代码中配置enableHiveSupport来启用Hive数据源。这里是Spark集成Hive。 2 Hive on Spark Hive on Spark,显而易见,Hi

shufangreal的博客 4322

Hive on Spark配置

Hive on Spark安装,hadoop-3.3.0,spark-3.4.3-bin-hadoop3,apache-hive-3.1.3

ayong95的专栏 2905

Spark on Hive——Spark远程连接Hive,对Hive中的表进行操作

Spark on Hive&Spark on Mysql

雷神乐乐的博客 5095

Hive on Spark及Spark on Hive实践

一、Hive安装(以Hive2.1.1为例,安装在/usr/local/apache-hive-2.1.1-bin目录下)1.官方下载预安装hive版本安装包apache-hive-2.1.1-bin.tar.gz2.解压安装包到安装目录,具体指令:    tar –zxvf apache-hive-2.1.1-bin.tar.gz –C /usr/local/apache-hive-2.1.1-...

浪荡江湖的博客 2万+

Hive on Spark and Spark sql on Hive

结构上Hive On Spark和SparkSQL都是一个翻译层,把一个SQL翻译成分布式可执行的Spark程序。Hive和SparkSQL都不负责计算。Hive的默认执行引擎是mr,还可以运行在Spark和Tez。Spark可以连接多种数据源,然后使用SparkSQL来执行分布式计算。Hive On Spark 配置1、首先安装包要选择对,否则就没有开始了。Hive版本:apache-hive-...

代灿灿灿的博客 3226

从Hive on YARN到Hive on Spark

本实战通过配置 Hive 与 Spark 集成,分别基于 YARN(MapReduce)和 Spark 引擎执行词频统计任务,验证了 Hive on Spark 在查询性能上的显著优势,同时展示了 Hadoop、Hive 和 Spark 的协同部署与关键配置步骤。

howard2005的专栏 1778

Hive 整合 Spark 全教程 (Hive on Spark)

分类应用Haddop 2.xHaddop 3.xNNPortsNamenode80209820NNPortsNN HTTP UI500709870NNPorts504709871SNN portsSNN HTTP500919869SNN ports500909868DN portsDN IPC500209867DN portsDN500109866DN portsDN HTTP UI500759864DN portsNamenode。

2401_87111282的博客 2764

hive on spark 配置 和 spark on hive

Hive引擎简介 Hive引擎包括:默认MR、tez、spark Hive on Spark:Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。 Spark on Hive : Hive只作为存储元数据,Spark负责SQL解析优化,语法是SparkSQL语法,Spark负责采用RDD执行。 HiveonSpark配置 1)兼容性说明 注意:官网下载的Hive3.1.2和Spark3.0.0默认是不兼容的。因为Hive...

yang灬仔 4980

Hive性能提升秘籍:从Hive on MR到Hive on Spark的深度实践

主要记录如何安装配置Hive on Spark,在执行以下步骤之前,请先确保已经安装Hadoop集群,Hive,MySQL,JDK,Scala,具体安装步骤可参阅之前内容。

u010192213的博客 980

【rotors】多旋翼无人机仿真(五)——多无人机仿真

如何创建多个无人机仿真

caiqidong321的博客 2393

hive on spark 还是 spark on hive?

在运行sql的时候,hive on spark 还是 spark on hive 到底是什么呢?它们是一个东西吗?区别是什么?

chashugu2022的博客 2288

人类肠道微生物群落代谢建模

MICOMWeb 是款用户友好型网站,专为人类肠道微生物群落代谢建模设计。该网站旨在解决基因组尺度代谢模型(in silico)构建过程中的3大限制:① 使用 MICOM Python 包进行通量平衡分析时对用户 Python 编程知识的要求;② 支持预定义和用户自定义饮食,以生成专属代谢模型;③ 处理宏基因组鸟枪法测序或 16S 扩增子测序获得的真实丰度数据时,所需的高通量计算基础设施。本文展示了 MICOMWeb 的核心功能,用户可轻松开展虚拟实验,为3个已发表数据集的实验验证生成功能性假设。

多组・学・多组学 1169

spark安装以及hive on spark和spark on hive 的配置

安装spark版本为已经编译好的spark-3.2.1-bin-hadoop3.2-scala2.13.tgz,其同样兼容hadoop-3.3.2; Hive on Spark(为hive配置spark引擎):Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。Hive默认执行引擎是mapreduce,由于需频繁读取磁盘,效率比较低,Spark在内存中读取数据,所以总体来讲比MapReduce快很多(当然首次执行速度还是比较慢的) ..

v15220的博客 4759

Python实战:基于PyG和Stable-Baselines3复现柔性车间调度算法(附数据集)

本文提供了一份基于图神经网络与深度强化学习的柔性车间调度实战指南。通过PyTorch Geometric构建异构图表示车间状态,并利用Stable-Baselines3中的PPO算法训练调度智能体,详细介绍了从环境建模、网络设计到训练评估的完整代码实现,帮助开发者构建可复用的工业级智能调度系统。

ansible6ops的博客 608

STM32多模式智能小车状态机设计与中断优先级实践

在嵌入式实时系统中,状态机是实现多任务协同与功能切换的核心范式。其本质是通过有限状态集合、明确转移条件和确定性动作,构建可预测、易维护的控制逻辑。基于STM32等资源受限MCU时,需兼顾状态调度效率、中断并发安全与硬件资源约束。关键技术价值体现在:提升系统模块解耦度、支持物理按键与蓝牙双源触发、保障实时响应不丢帧。典型应用场景包括智能小车多模运行(循迹、避障、遥控、定距跟随等)、工业设备工作模式切换及IoT终端低功耗状态管理。本文以STM32F103C8T6平台为例,深入解析全局模式变量设计、双通道状态切换

weixin_42509888的博客 93

区分 Hive on Spark 和 Spark on Hive

Hive on Spark 是指使用 Spark 作为 Hive 的查询执行引擎。Spark on Hive 是 Spark 的一个集成模式,在 Spark 应用中可以直接访问 Hive 的元数据和存储数据。它使得 Spark 作业能够查询和操作 Hive 中的数据,主要用来结合 Spark 的高性能计算能力和 Hive 的数据仓库管理能力。用户通过 Spark 的 SQL API 编写查询,调用 Hive 的表或元数据。最终生成 Spark 的 RDD 作业计划,提交给 Spark 执行。

goTsHgo的博客 1939

WGS-84 ECEF ENU 坐标系学习记录

地球坐标系固定在地球上而随地球一起在空间做公转和自转运动,因此地球上任一固定点在地球坐标系的坐标就不会由于地球旋转而变化。地心地固直角坐标系和大地坐标系都属于这种坐标系。 一、 几种坐标系 地心地固直角坐标系(ECEF)坐标系 其原点为地球的质心,x轴延伸通过本初子午线(0度经度)和赤道(0deglatitude)的交点。 z轴延伸通过的北极(即,与地球旋转轴重合)。 y轴完成右手坐标系,穿...

YYshuangshuang的博客 1万+

Hive on Spark 和 Spark sql on Hive,你能分的清楚么

结构上 Hive On Spark 和 SparkSQL 都是一个翻译层,把一个 SQL 翻译成分布式可执行的 Spark 程序。Hive 和 SparkSQL 都不负责计算。Hive 的默认执行引擎是 mr,还可以运行在 Spark 和 Tez。Spark 可以连接多种数据源,然后使用 SparkSQL 来执行分布式计算。(1)首先安装包要选择对,否则就没有开始了。Hive 版本:apache-hive-2.1.1-bin.tar。

weixin_43770745的博客 1072

开源机器学习平台tipdm

TipDM建模平台 tipdm开源的python机器学习建模平台,用户通过拖拉就可以实现模型开发。 项目结构 backend :为java后台服务代码 frontedn :为vue js前端代码 mock-oauth-server:为java认证服务代码 主要分析backend后台服务代码,典型的java spring mvc web项目,项目结构如下: framework-common:公共代码,主要为工具类,spring相关公用类 framework-model: 实体..

wflh323的专栏 4248

告别云端推理!用llama.cpp+树莓派5搭建本地AI问答机器人(完整配置流程)

本文详细介绍了如何在树莓派5上利用llama.cpp部署本地AI问答机器人,实现完全离线的智能对话。通过模型量化与格式转换技术,成功将MiniCPM-2B等大模型压缩并运行于资源受限的边缘设备,解决了隐私、延迟和成本问题,为物联网和硬件开发者提供了完整的配置流程与实践指南。

t1u2v的博客 507

hive on spark

hive on Spark一. 配置二. hive三种模式1、内嵌Derby方式2.Local方式3.Remote方式 (远程模式)三. spark sql 远程连接(thriftserver -- beeline)2 .spark-sql3.scala操作spark-SQL四 .spark on hive(HiveServer 2)1. HiveServer 22. beline3. Sp...

我还是个菜鸟 8027

【虚幻引擎UE】UE5 阴影异常与优化

【虚幻引擎UE】UE5 阴影异常与优化解决方案合集

灵境引路人 3万+

spark on hive 和 hive on spark

spark on hive 的话就是通过spark-sql使用hive语句,操作hive,底层运行的还是spark rdd。 就是通过saprk sql,加载hive配置文件,获取hive的元数据信息

qq_42915325的博客 498

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

详解Hive on Spark配置

Hive on Spark配置 Hive引擎默认的是MapReduce,就是没执行一个Hive语句,其实都是运行了一个MR程序,都知道的,MR虽好,但是慢呢。所以在时代的驱使下,就出现了把Hive的引擎更换的需要,通常Hive的引擎还有tez、Spark。我们经常听到Hive on Spark和Spark on Hive,不明所以的小伙伴还会以为这两个是倒装句,其实不然,Hive on Spark 和 Spark on Hive有着很大的区别 Hive on Spark:直译就是把Hive 放到 Spark

weixin_46429290的博客 4590

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Hive on spark环境搭建

Hive引擎包括:默认MR、tez、sparkHive on Spark:Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。Spark on Hive : Hive只作为存储元数据,Spark负责SQL解析优化,语法是Spark SQL语法,Spark负责采用RDD执行。

weixin_44616592的博客 2106

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

上一篇: Flume工具
下一篇: 人大金仓 KingbaseES 数据库深度解析
DolphinV2
博客等级 码龄1年 11粉丝 16原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值