redolog与binlog笔记

binlog redolog undolog 1、二进制日志(Binlog)Binlog主要用于MySQL中的复制它包括表示对数据库进行的修改的SQL语句或原始二进制数据2、重做日志(Redo Log)重做日志是事务日志的一部分,用于崩溃恢复和确保数据持久性记录了一个事务修改了那些磁盘,分别修改了那些字段那些值信息update 可能更改了多个磁盘区域的数据,数据刷到磁盘的每个扇区里无法保证原子性3、撤销日志(Undo Log)撤销日志用于存储事务修改的数据的先前图像,使回滚成为可能,确保事务一致性。 阅读详情

从极客时间丁奇老师的课程中总结

一条语句的简易更新流程

如果要将 ID=2 这一行的值加 1,SQL 语句就会这么写:

 update T set c=c+1 where ID=2;

其在mysql中的更新流程大致如下:执行语句前要先连接数据库,这是连接器的工作。在一个表上有更新的时候,跟这个表有关的查询缓存会失效,所以这条语句就会把表 T 上所有缓存结果都清空。接下来,分析器会通过词法和语法解析知道这是一条更新语句。优化器决定要使用 ID 这个索引。然后,执行器负责具体执行,找到这一行,然后更新。更新流程还涉及两个重要的日志模块:redo log(重做日志)和 binlog(归档日志)。

我们所说的WAL机制 的全称是 Write-Ahead Logging,它的关键点就是先写日志,再写磁盘
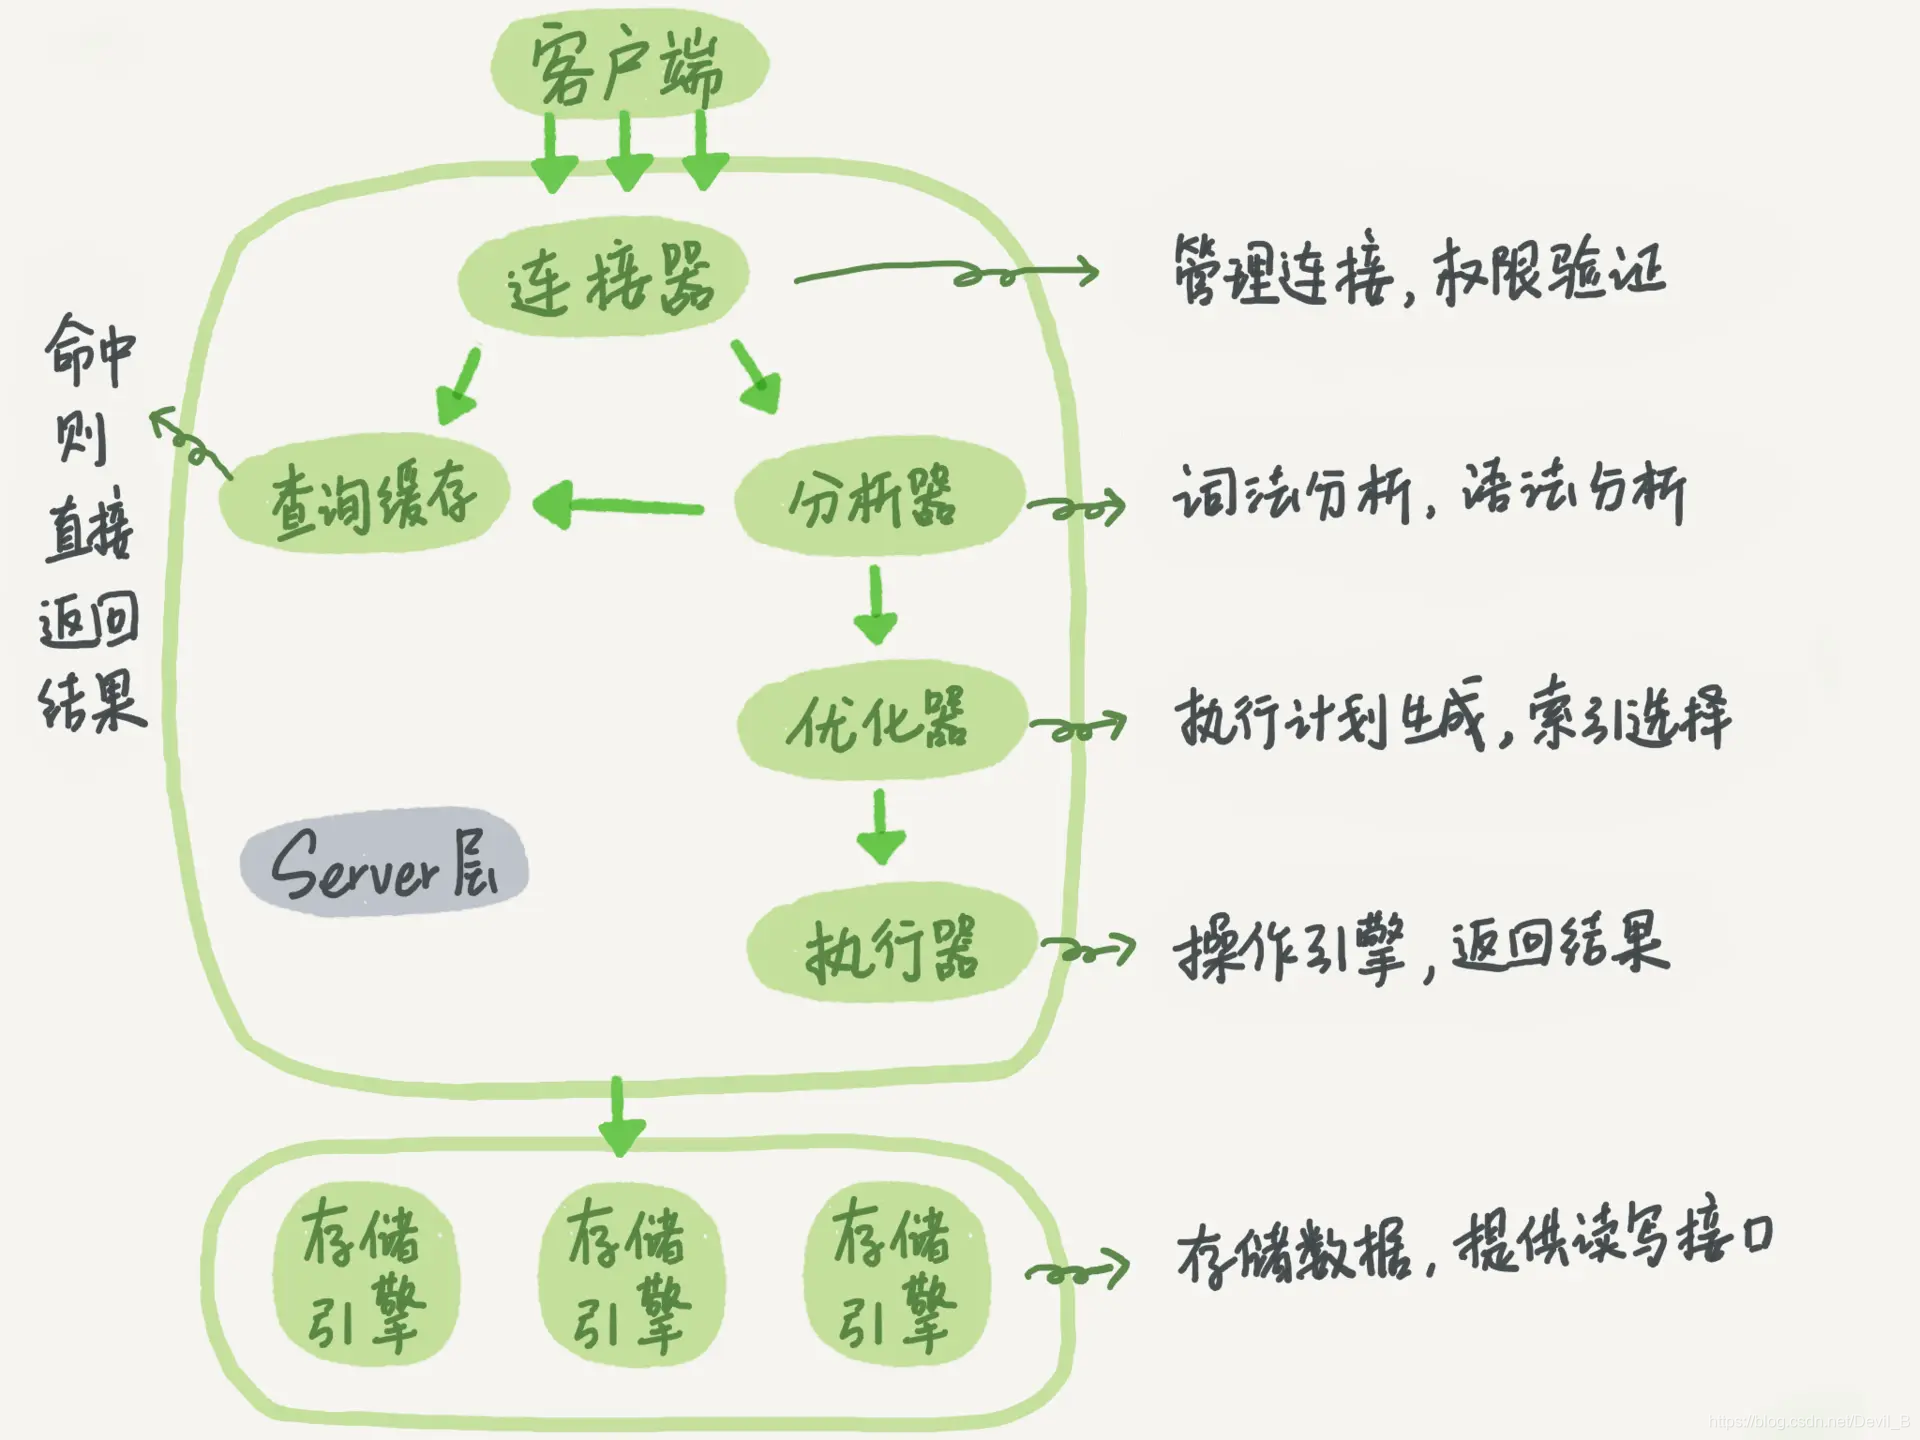
在这里插入图片描述


redo log介绍

作用:crash-safe及数据库发生异常重启,之前提交的记录都不会丢失。

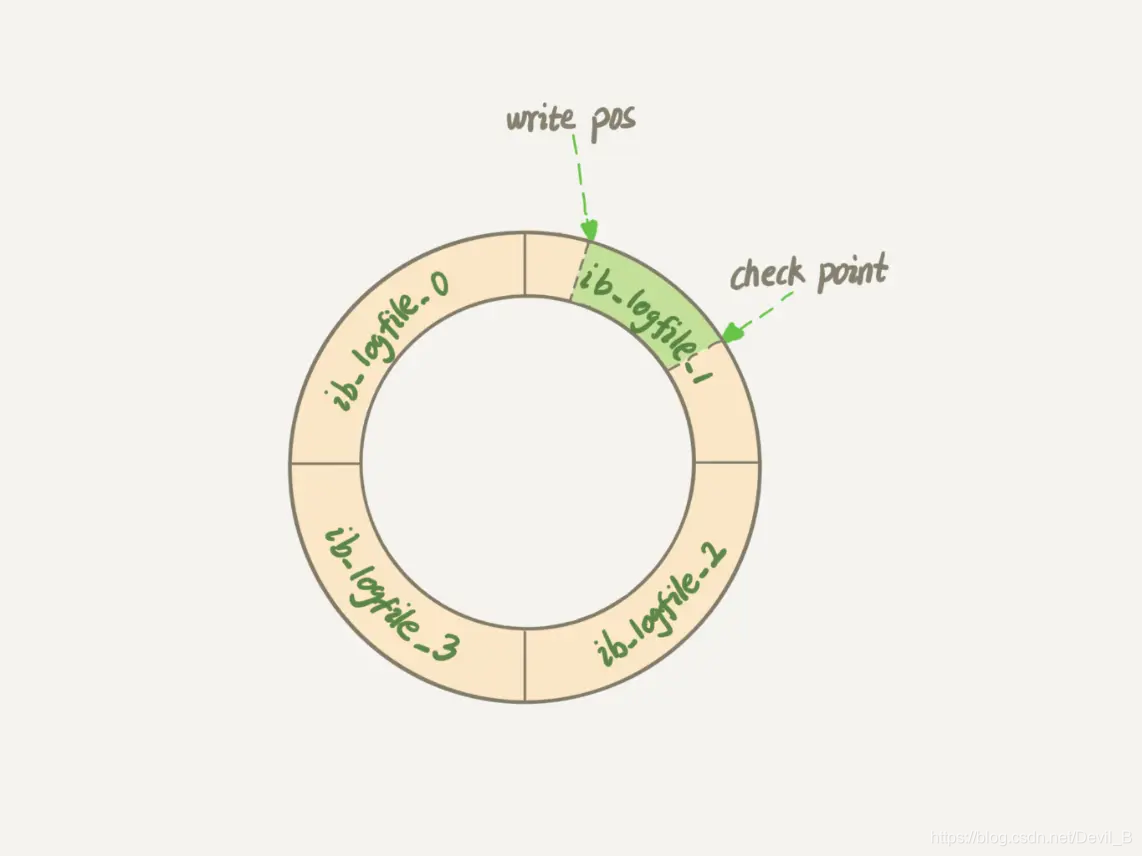
当有一条记录需要更新的时候,InnoDB 引擎就会先把记录写到redo log里面,并更新内存,这个时候更新就算完成了。同时,InnoDB 引擎会在适当的时候,将这个操作记录更新到磁盘里面。nnoDB 的 redo log 是固定大小的,比如可以配置为一组 4 个文件,每个文件的大小是 1GB,总共就可以记录 4GB 的操作。从头开始写,写到末尾就又回到开头循环写。
在这里插入图片描述
write pos 是当前记录的位置,一边写一边后移,写到第 3 号文件末尾后就回到 0 号文件开头。checkpoint 是当前要擦除的位置,也是往后推移并且循环的,擦除记录前要把记录更新到数据文件。write pos 和 checkpoint 之间的是还空着的部分,可以用来记录新的操作。如果 write pos 追上 checkpoint,表示redolog满了,这时候不能再执行新的更新,得停下来先擦掉一些记录,把 checkpoint 推进一下。


binlog(归档)介绍

redolog 是 InnoDB 引擎特有的日志 。而 Server 层也有自己的日志,称为 binlog(归档日志)。因为最开始 MySQL 里并没有 InnoDB 引擎。MySQL 自带的引擎是 MyISAM,但是 MyISAM 没有 crash-safe 的能力,binlog 日志只能用于归档。而 InnoDB 是另一个公司以插件形式引入 MySQL 的,既然只依靠 binlog 是没有 crash-safe 能力的,所以 InnoDB 使用另外一套日志系统——也就是 redo log 来实现 crash-safe 能力。

redolog与binlog区别

  1. redo log 是 InnoDB 引擎特有的;binlog 是 MySQL 的 Server 层实现的,所有引擎都可以使用。
  2. redo log 是物理日志,记录的是“在某个数据页上做了什么修改”;binlog 是逻辑日志,记录的是这个语句的原始逻辑,比如“给 ID=2 这一行的 c 字段加 1 ”。
  3. redo log 是循环写的,空间固定会用完;binlog 是可以追加写入的。“追加写”是指 binlog 文件写到一定大小后会切换到下一个,并不会覆盖以前的日志。

详细更新流程之两阶段提交

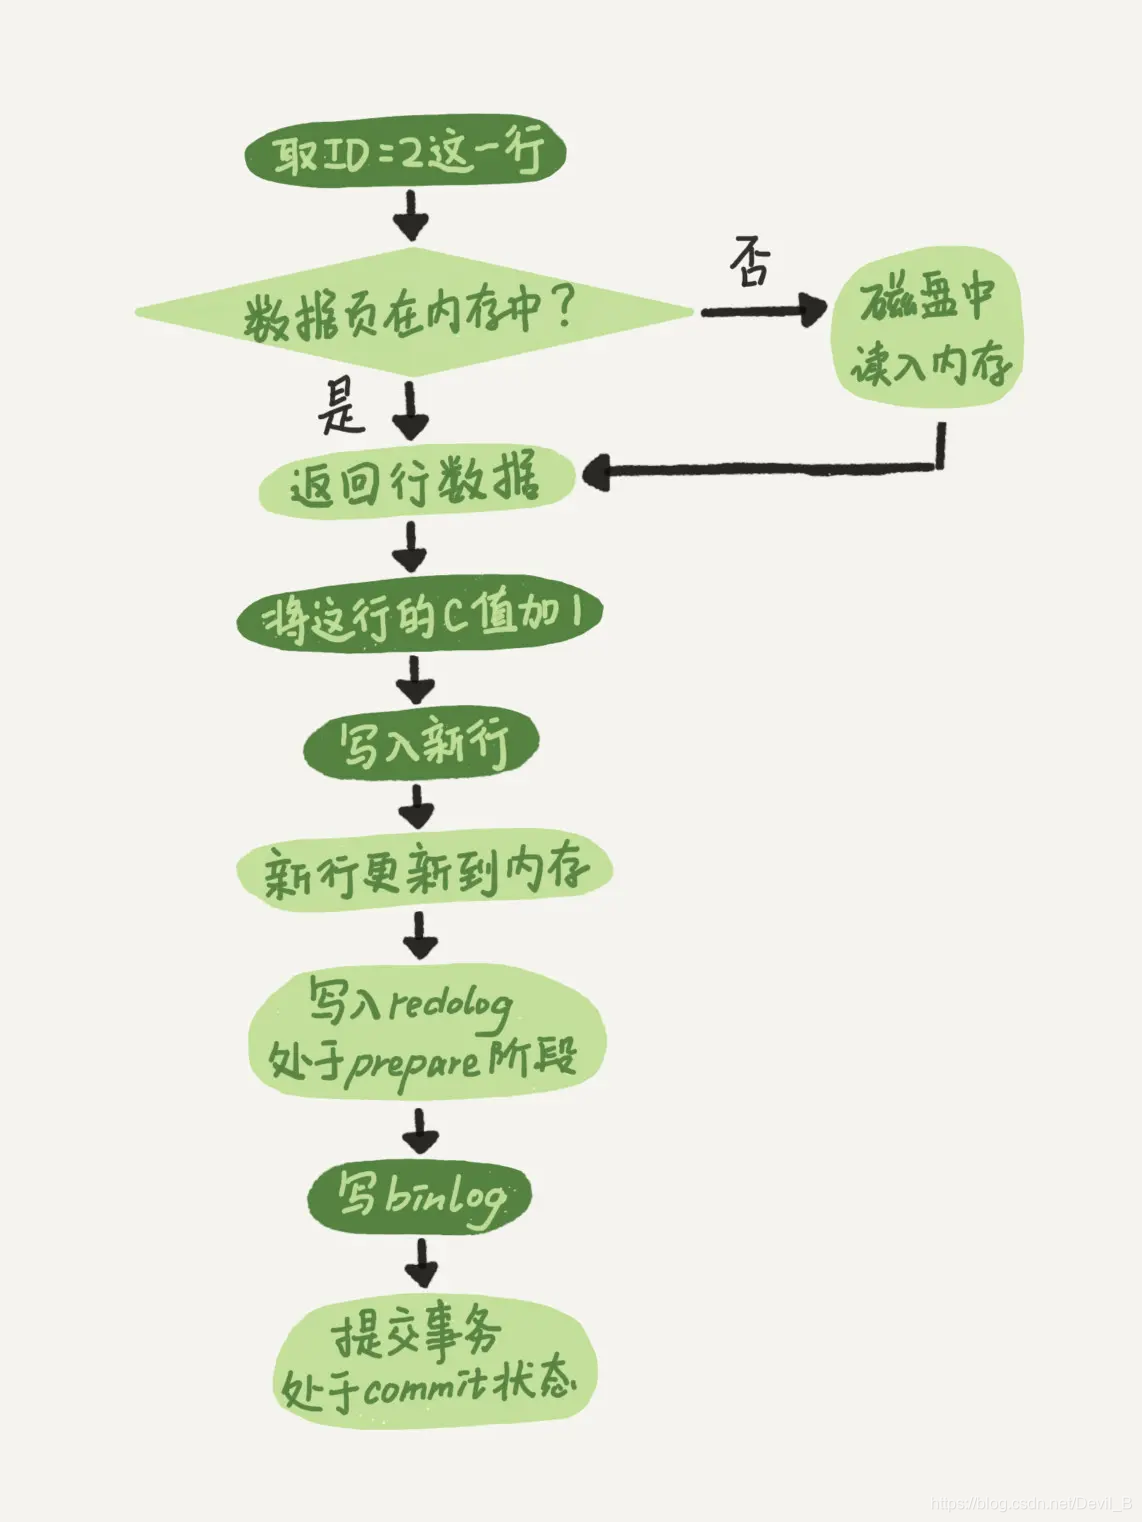
  1. 执行器先找引擎取 ID=2 这一行。ID 是主键,引擎直接用树搜索找到这一行。如果 ID=2 这一行所在的数据页本来就在内存中,就直接返回给执行器;否则,需要先从磁盘读入内存,然后再返回。
  2. 执行器拿到引擎给的行数据,把这个值加上 1,比如原来是 N,现在就是 N+1,得到新的一行数据,再调用引擎接口写入这行新数据。
  3. 引擎将这行新数据更新到内存中,同时将这个更新操作记录到 redo log 里面,此时 redo log 处于 prepare 状态。
  4. 然后告知执行器执行完成了,随时可以提交事务。执行器生成这个操作的 binlog,并把 binlog 写入磁盘。
  5. 执行器调用引擎的提交事务接口,引擎把刚刚写入的 redo log 改成提交(commit)状态,更新完成。
    在这里插入图片描述

两阶段提交存在的意义:经典的分布式问题,保证redolog日志与binlog日志之间的数据一致性。

为什么需要两阶段提交(反正法)?

首先先写 redo log 后写 binlog。假设在 redo log 写完,binlog 还没有写完的时候,MySQL 进程异常重启。由于我们前面说过的,redo log 写完之后,系统即使崩溃,仍然能够把数据恢复回来,所以恢复后这一行 c 的值是 1。但是由于 binlog 没写完就 crash 了,这时候 binlog 里面就没有记录这个语句。因此,之后备份日志的时候,存起来的 binlog 里面就没有这条语句。然后你会发现,如果需要用这个 binlog 来恢复临时库的话,由于这个语句的 binlog 丢失,这个临时库就会少了这一次更新,恢复出来的这一行 c 的值就是 0,与原库的值不同。
其次先写 binlog 后写 redo log。如果在 binlog 写完之后 crash,由于 redo log 还没写,崩溃恢复以后这个事务无效,所以这一行 c 的值是 0。但是 binlog 里面已经记录了“把 c 从 0 改成 1”这个日志。所以,在之后用 binlog 来恢复的时候就多了一个事务出来,恢复出来的这一行 c 的值就是 1,与原库的值不同。

redo log的写入机制

redo log写入硬盘中首先会写入redo log buffer中,redo log buffer 就是一块内存,用来先存 redo 日志的。真正把日志写到 redo log 文件(文件名是 ib_logfile+ 数字),是在执行 commit 语句的时候做的。InnoDB 有一个后台线程,每隔 1 秒,就会把 redo log buffer 中的日志,调用 write 写到文件系统的 page cache,然后调用 fsync 持久化到磁盘。

redo log在MySQL中存在的三种状态:

  1. 存在 redo log buffer 中,物理上是在 MySQL 进程内存中;
  2. 写到磁盘 (write),但是没有持久化(fsync),物理上是在文件系统的 page cache 里面;
  3. 持久化到磁盘,对应的是 hard disk。

日志写到 redo log buffer 是很快的,wirte 到 page cache 也差不多,但是持久化到磁盘的速度就慢多了。为了控制 redo log 的写入策略,InnoDB 提供了 innodb_flush_log_at_trx_commit 参数,它有三种可能取值:

  1. 设置为 0 的时候,表示每次事务提交时都只是把 redo log 留在 redo log buffer 中 ;
  2. 设置为 1 的时候,表示每次事务提交时都将 redo log 直接持久化到磁盘;
  3. 设置为 2 的时候,表示每次事务提交时都只是把 redo log 写到 page cache。

binlog写入机制

binlog 的写入逻辑比较简单:事务执行过程中,先把日志写到 binlog cache(内存中),事务提交的时候,再把 binlog cache 写到 binlog 文件中。一个事务的 binlog 是不能被拆开的,因此不论这个事务多大,也要确保一次性写入。这就涉及到了 binlog cache 的保存问题。系统给 binlog cache 分配了一片内存,每个线程一个,参数 binlog_cache_size 用于控制单个线程内 binlog cache 所占内存的大小。如果超过了这个参数规定的大小,就要暂存到磁盘。

每个线程有自己 binlog cache,但是共用同一份 binlog 文件。write,指的就是指把日志写入到文件系统的 page cache,并没有把数据持久化到磁盘,所以速度比较快。 fsync,才是将数据持久化到磁盘的操作。一般情况下,我们认为 fsync 才占磁盘的 IOPS。InnoDB 提供了 sync_binlog 参数写入binlog,它有三种可能取值:

  1. sync_binlog=0 的时候,表示每次提交事务都只 write,不 fsync;
  2. sync_binlog=1 的时候,表示每次提交事务都会执行 fsync;
  3. sync_binlog=N(N>1) 的时候,表示每次提交事务都 write,但累积 N 个事务后才 fsync。

MySQL双1操作

通常我们说 MySQL 的“双 1”配置,指的就是 sync_binlog 和 innodb_flush_log_at_trx_commit 都设置成 1。也就是说,一个事务完整提交前,需要等待两次刷盘,一次是 redo log(prepare 阶段),一次是 binlog。这样才能保证数据的完整性。

组提交提升写入效率

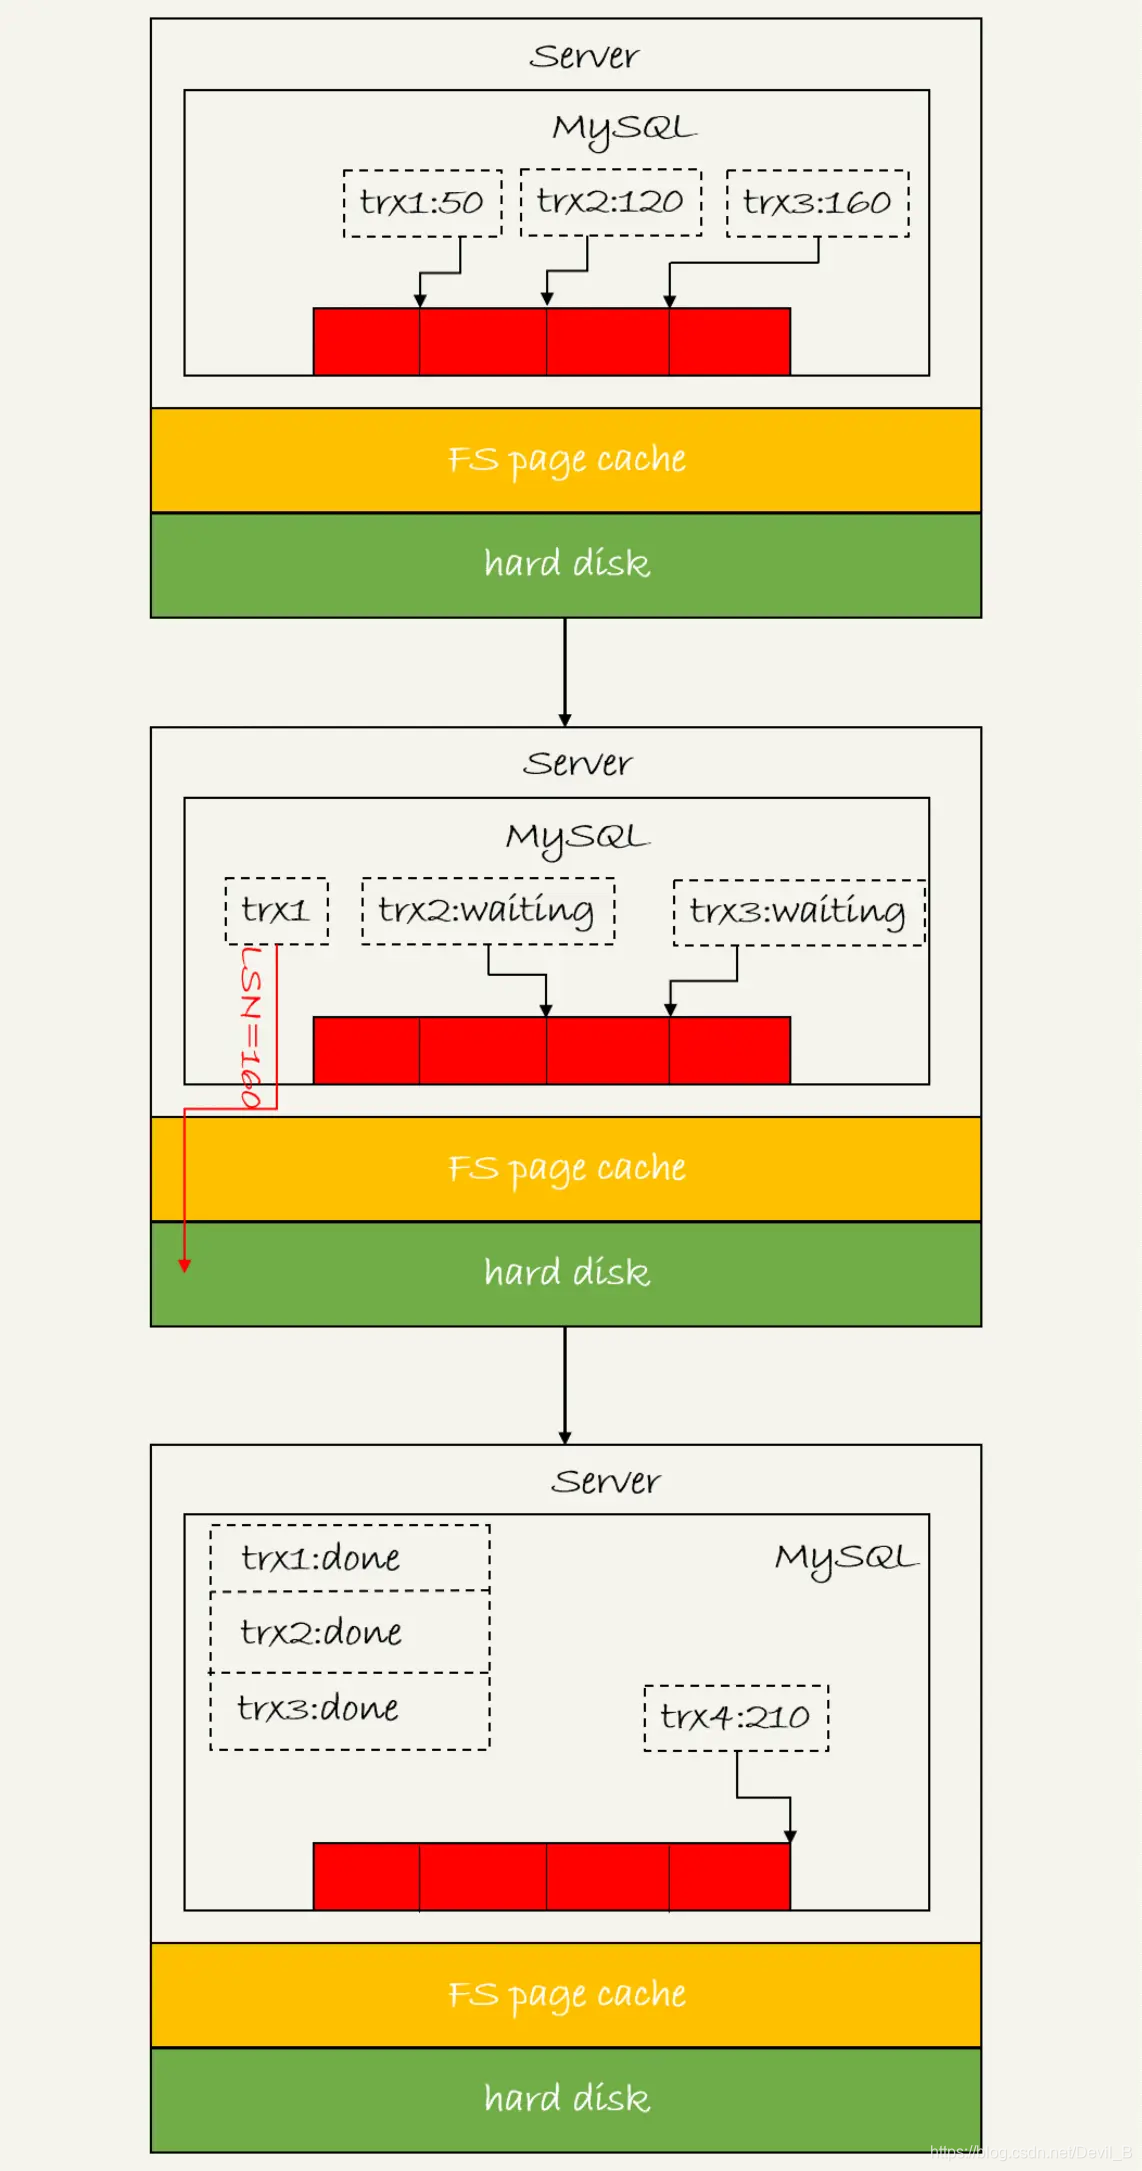
日志逻辑序列号(log sequence number,LSN)的概念。LSN 是单调递增的,用来对应 redo log 的一个个写入点。每次写入长度为 length 的 redo log, LSN 的值就会加上 length。LSN 也会写到 InnoDB 的数据页中,来确保数据页不会被多次执行重复的 redo log。如图 所示,是三个并发事务 (trx1, trx2, trx3) 在 prepare 阶段,都写完 redo log buffer,持久化到磁盘的过程,对应的 LSN 分别是 50、120 和 160。
在这里插入图片描述
从图中可以看到:

  1. trx1 是第一个到达的,会被选为这组的 leader;
  2. 等 trx1 要开始写盘的时候,这个组里面已经有了三个事务,这时候 LSN 也变成了 160;
  3. trx1 去写盘的时候,带的就是 LSN=160,因此等 trx1 返回时,所有 LSN 小于等于 160 的 redo log,都已经被持久化到磁盘;
  4. 这时候 trx2 和 trx3 就可以直接返回了。

所以,一次组提交里面,组员越多,节约磁盘 IOPS(磁盘 每秒的读写次数)的效果越好。但如果只有单线程压测,那就只能老老实实地一个事务对应一次持久化操作了。在并发更新场景下,第一个事务写完 redo log buffer 以后,接下来这个 fsync 越晚调用,组员可能越多,节约 IOPS 的效果就越好。

原先的两阶段提交如下:
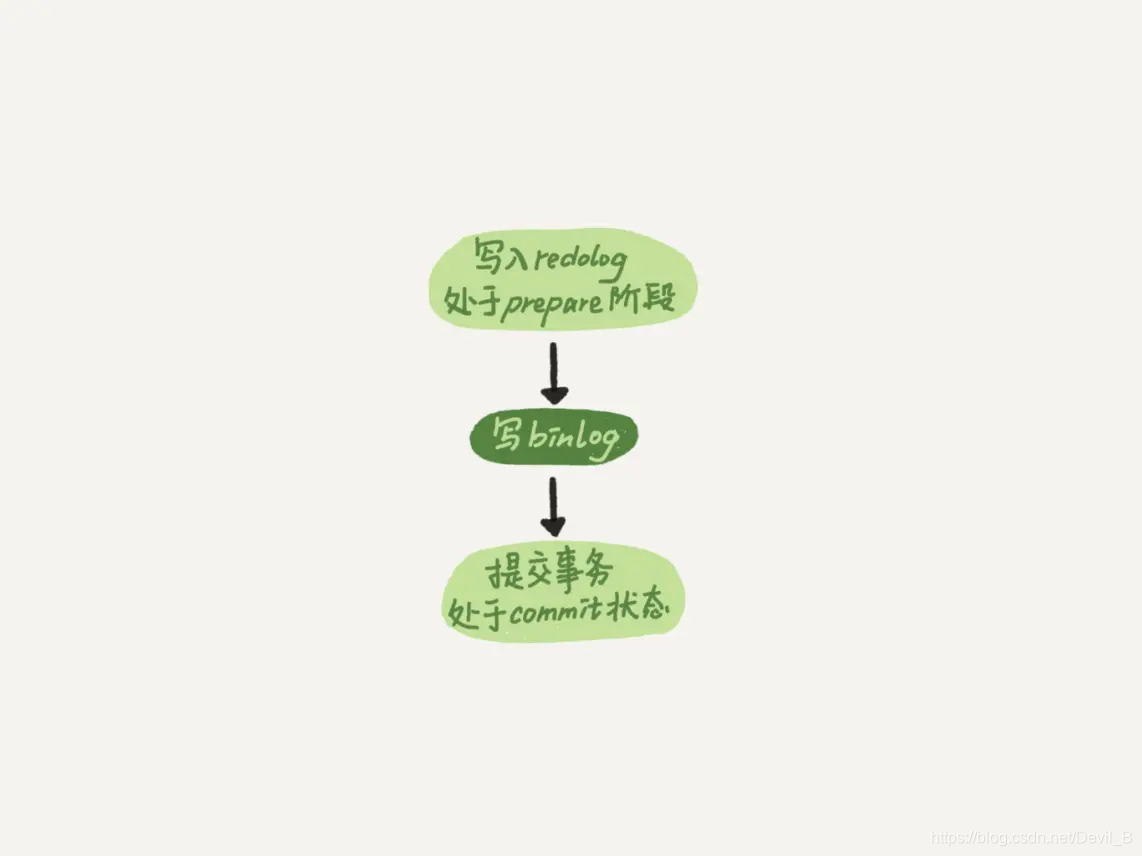
在这里插入图片描述
写 binlog 是分成两步的:先把 binlog 从 binlog cache 中写到磁盘上的 binlog 文件;调用 fsync 持久化。MySQL 为了让组提交的效果更好,把 redo log 做 fsync 的时间拖到了步骤 1 之后。也就是说,上面的图变成了这样:
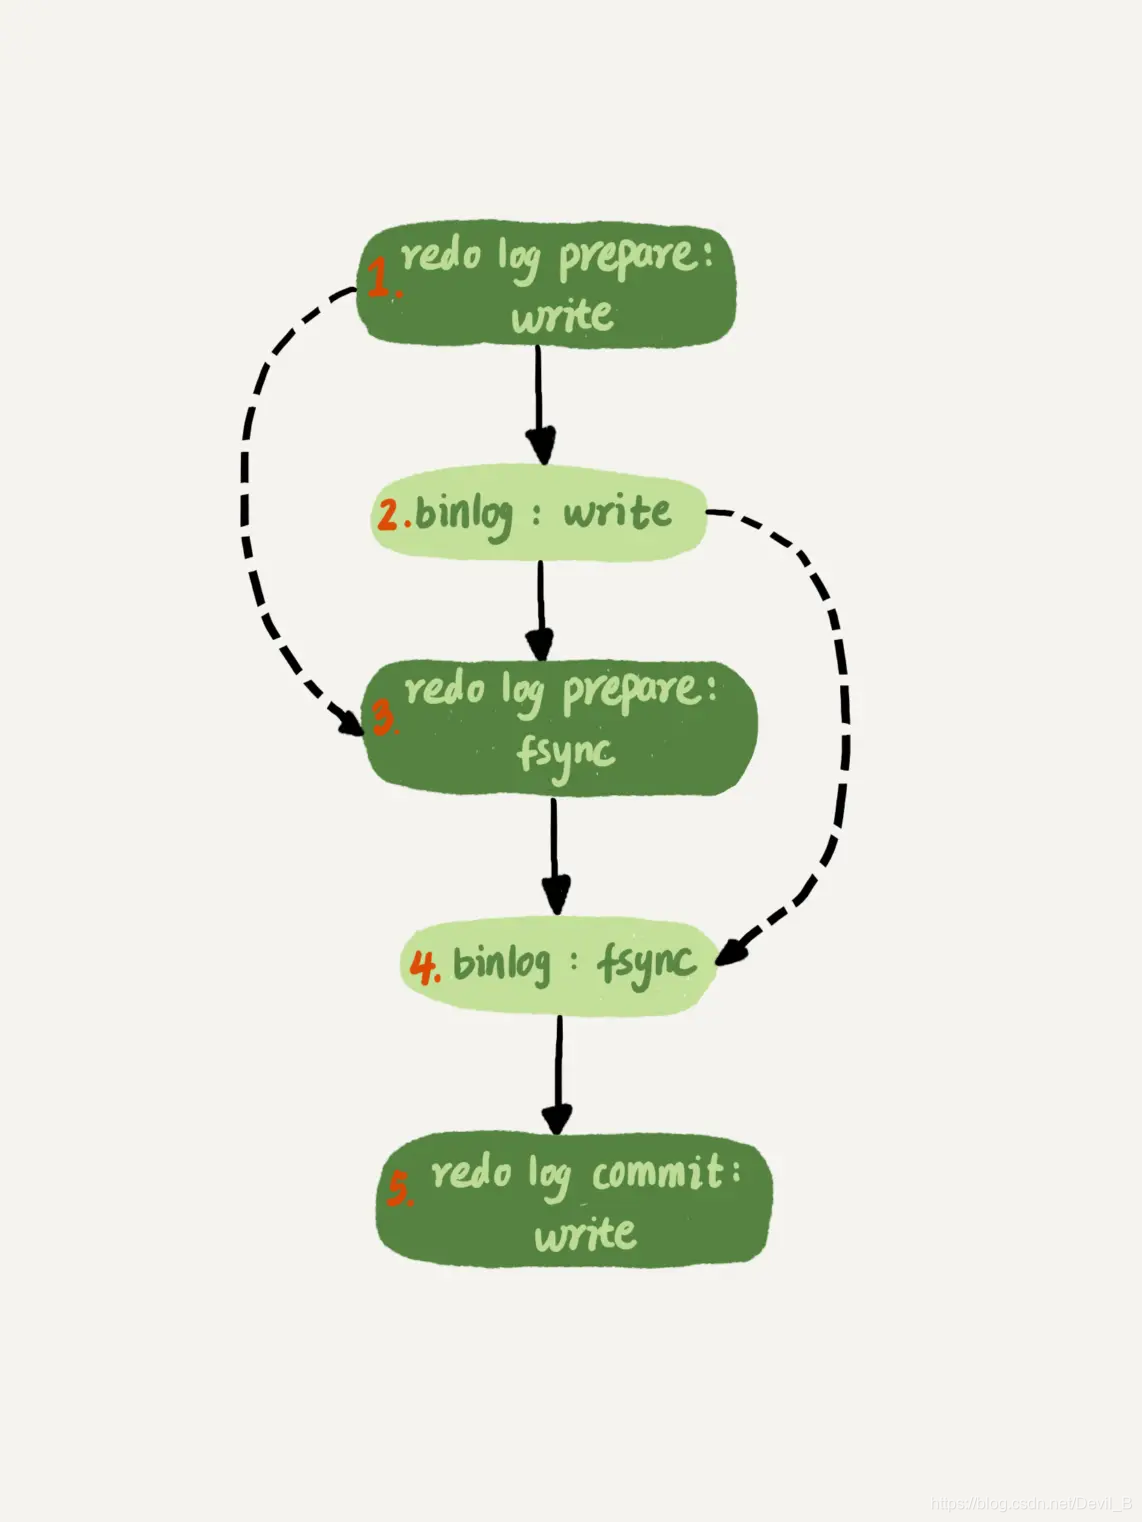
在这里插入图片描述
这么一来,binlog 也可以组提交了。在执行上 中第 4 步把 binlog fsync 到磁盘时,如果有多个事务的 binlog 已经写完了,也是一起持久化的,这样也可以减少 IOPS 的消耗。不过通常情况下第 3 步执行得会很快,所以 binlog 的 write 和 fsync 间的间隔时间短,导致能集合到一起持久化的 binlog 比较少,因此 binlog 的组提交的效果通常不如 redo log 的效果那么好,综上所述组提交发生在第三步以及第四步。

常见问题

我总结了丁老师讲redo log月binlog的主要流程,对于一些细节方面并没有深入阐述。如果是专门做DB的我建议看看老师的课程,真的讲的很好。我同时选取了一些有意思的问题集中展示:

怎样让数据库恢复到半个月内任意一秒的状态(binlog归档)?

首先,找到最近的一次全量备份,从这个备份恢复到临时库;然后,从备份的时间点开始,将备份的 binlog 依次取出来,重放到中午误删表之前的那个时刻。这样你的临时库就跟误删之前的线上库一样了,然后你可以把表数据从临时库取出来,按需要恢复到线上库去。

redo log 和 binlog 是怎么关联起来的

首先一个事务的 binlog 是有完整格式的:statement 格式的 binlog,最后会有 COMMIT;row 格式的 binlog,最后会有一个 XID event。对于 binlog 日志由于磁盘原因,可能会在日志中间出错的情况,MySQL 可以通过校验 checksum 的结果来发现。所以,MySQL 还是有办法验证事务 binlog 的完整性的。

其次它们有一个共同的数据字段,叫 XID。崩溃恢复的时候,会按顺序扫描 redo log:

  • 如果碰到既有 prepare、又有 commit 的 redo log,就直接提交;
  • 如果碰到只有 parepare、而没有 commit 的 redo log,就拿着 XID 去 binlog 找对应的事务检查是否完整。

正常运行中的实例,数据写入后的最终落盘,是从 redo log 更新过来的还是从 buffer pool 更新过来的呢(redo log崩溃恢复)?

实际上,redo log 并没有记录数据页的完整数据,所以它并没有能力自己去更新磁盘数据页,也就不存在“数据最终落盘,是由 redo log 更新过去”的情况,redo log是作为日志崩溃恢复的。

  • 如果是正常运行的实例的话,数据页被修改以后,跟磁盘的数据页不一致,称为脏页。最终数据落盘,就是把内存中的数据页写盘。这个过程,甚至与 redo log 毫无关系。
  • 在崩溃恢复场景中,InnoDB 如果判断到一个数据页可能在崩溃恢复的时候丢失了更新,就会将它读到内存,然后让 redo log 更新内存内容。更新完成后,内存页变成脏页,就回到了第一种情况的状态。

为什么 binlog cache 是每个线程自己维护的,而 redo log buffer 是全局共用的?

binlog是一种逻辑性的日志,记录的是一个事务完整的语句。当用来做主从同步,如果分散写,可能造成事务不完整,分多次执行,从而导致不可预知的问题。 而redo log属于物理性的日志,记录的是物理地址的变动,因此,分散写也不会改变最终的结果。

ESP32-S3打造离线语音助手:从零部署自定义唤醒词与本地大模型推理【实战指南】 本文详细介绍了如何利用ESP32-S3芯片打造离线语音助手,包括自定义唤醒词训练与本地大模型推理的实战指南。通过硬件架构解析、音频处理优化及性能调优技巧,实现低延迟、高隐私保护的语音交互方案,特别适合智能家居和物联网应用。 阅读详情

相关推荐

【CAN通讯系列18】- NM在干什么?休眠唤醒

同时针对不同休眠或唤醒场景,网管报文的userdata有所区别,如何做到场景与网管报文内容一一映射,通常会定义另一帧报文,用来表明当前是哪个或哪几个唤醒条件或休眠条件满足。又或者如果用户发现汽车电量不充足了,那么会有充电需求,插枪充电,这时如果插上慢充枪,那么OBC会先被唤醒,识别出插枪行为及其慢充枪的连接状态,然后OBC唤醒BMS和其他相关的控制器进行充电。也就是说,通过对一个又一个整车功能和应用场景的详细分析,最终能够汇总出整车所有的休眠唤醒场景需求,通常会用一个表格来管理,俗称休眠唤醒表。

menghuyouyou的博客 1169

MySQL中,为什么 binlog cache 是每个线程自己维护的,而 redolog buffer 是全局共用的?

而 redo log 并没有这个要求,中间有生成的日志可以写到 redo log buffer 中,redo log buffer 中的内容还能“搭便车”,其他事务提交的时候可以被一起写到磁盘中。而将Redo Log Buffer设计为全局共用的,可以节省内存开销,并确保所有的事务操作都通过Redo Log来保证持久性和崩溃恢复。需要注意的是,Binlog Cache和Redo Log Buffer的大小可以通过相应的配置参数进行调整,以适应不同的工作负载和性能需求。

学亮编程手记 710

Zemax实战:5步搞定牛顿望远镜光学设计(附球差优化技巧)

本文详细介绍了在Zemax OpticStudio中构建高精度牛顿望远镜光学系统的5步实战流程,包括初始参数设置、球差优化、折叠镜与遮光面配置等关键步骤。特别针对球差问题,提供了将主镜圆锥系数设为-1的优化方案,有效消除轴上弥散斑。通过3D视图和MTF分析验证,该系统可实现接近衍射极限的成像质量,适合天文观测等应用场景。

x8y9z0的博客 929

MySQL redo和binlog

redo log 用来保证事务的持久性 redo概念可以参考:MySQL · 引擎特性 · InnoDB redo log漫游 mysql是如何保证一致性的呢?最简单的做法是在每次事务提交的时候,将该事务涉及修改的数据页全部刷新到磁盘中。但是这么做会有严重的性能问题,主要体现在两个方面: 因为Innodb是以页为单位进行磁盘交互的,而一个事务很可能只修改一个数据页里面的几个字节,这个时候将完整的数据页刷到磁盘的话,太浪费资源了! 一个事务可能涉及修改多个数据页,并且这些数据页在物理上并不...

大灰狼的专栏 1407

MCP详解:手把手教你理解和如何使用各种开源MCP服务

MCP 作为一种开放协议,为 AI 模型与外部世界的连接提供了标准化的解决方案。它不仅降低了开发门槛,还极大地扩展了 AI 应用的边界。无论是开发者还是普通用户,都可以通过 MCP 更高效地利用 AI 技术,实现更多智能化的功能。

王哥儿聊AI的博客 6056

核磁共振常用的文件格式介绍:NIfTI volume 格式 (*.nii), GIFTI 格式 (*.gii), CIFTI 格式 (*.nii)

NIfTI volume 格式 (*.nii)GIFTI 格式 (*.gii)CIFTI 格式 (*.nii)Scene file文件 (*.scene)规格文件 (*.spec)解剖 (*.annot)一个场景文件包含一个或多个场景;每个场景实际上是保存时 wb_view 内部状态的快照。这包括有关加载哪些文件、如何显示、如何配置选项卡的信息(选择了哪些表面、在每个层中选择了哪些文件、打开了哪些层、哪些视图旋转、调色板设置、平铺选项卡等),以及在它们上面添加了哪些注释(文本、箭头、圆圈等)。

从事脑科学核磁共振方法学研究,在Nature communications等权威期刊发表研究论文,熟练掌握磁共振处理方法和统计学方法,欢迎大家和我交流。 3043

MySQL的刷脏页策略

当内存数据页跟磁盘数据页内容不一致的时候,我们称这个内存页为“脏页”。 1.当我们修改一条数据时,如果数据在内存中,我们是先会去改内存的,而不是先去改磁盘。假如数据都在内存中,这时候断电了怎么办,服务器宕机怎么办,这个时候就需要我们的redo log了。 在每一条数据更新时,MySQL会先写redo log日志,在去写binlog 日志。在写这两个日志过程中会涉及到**两阶段提交**。他可以保证两个日志逻辑上的一致性。所以即使因为停电,宕机等原因,MySQL也可以通过redo log将数据进行恢复。

qq_48157004的博客 3944

Python 爬虫教程:财经新闻实时抓取(最新资讯 + 关键词提取)

在当今信息爆炸的时代,财经新闻的实时获取对于投资者、研究人员以及普通大众来说都具有重要的价值。通过 Python 爬虫技术,我们可以高效地抓取财经新闻,并提取其中的关键信息,以便更好地进行数据分析和决策支持。本文将详细介绍如何使用 Python 编写一个财经新闻实时抓取系统,并结合关键词提取技术,帮助读者快速掌握 Python 爬虫的核心技能。

yansideyucsdn的博客 1049

bin log,redo log以及undo log详解

1 bin log 1.1 定义 bin log应该说是Mysql里最核心的日志,是MySQL数据库级别的文件,记录对MySQL数据库各种引擎下执行修改的所有操作(包括DDL和DML语句),不会记录select和show语句,主要用于恢复数据库和同步数据库(主从同步)。 1.2 bin log的三种日志格式 binlog 有三种记录格式,分别是ROW、STATEMENT、MIXED。 1、ROW: 基于变更的数据行进行记录,如果一个update语句修改一百行数据,那么这种模式下就会记录100行对应的记录日志

yxg520s的博客 4596

【电机应用控制】——步进电机控制原理(四相五线/两相四线/细分驱动)&驱动器&梯形/S形加减速算法&直线/圆弧插补

步进电机是一种把电脉冲信号转换为角位移(左)或线位移(右)的电动机。两相通常1.8°,三相通常1.2°、无相通常0.72°,角位移=脉冲个数X步距角。在非超载且不超频的情况下,电机的旋转位置只取决于脉冲个数,转速只取决脉冲信号的频率。所以只需要统计脉冲个数和频率,不再需要编码器测速和位置,具有优秀的开环能力,当然也可接编码器反馈速度和位置数据,实现更加精准的闭环控制。永磁式动态性能好,输出力矩大,但步距角大通常7.5°;反应式(磁阻式)结构简单成本低,步距角小一般1.2°,但振动噪音大动态性能差;

weixin_51658186的博客 5万+

数字孪生教程大全之 我们如何构建数字孪生?数字孪生的五个级别都是什么

文章摘要 什么是数字孪生? 我们如何构建数字孪生? 开发智能数字孪生系统的框架 什么是数字孪生? 数字孪生是一个不言自明的术语,用于识别物理系统的数字化版本。数字孪生的最早参考来自大卫·格伦特(David Gelernter )的小说作品。在他 1995 年的书中,Gelernter 博士为读者提供了未来有趣的可能性——万维网。前网络书籍谈到了计算机系统上的镜像数字世界。有些人可能会争辩说,我们的 Meta-verse 是新的数字世界——现实世界的数字孪生。但是,还有其他可能性,时间可能会讲述一个更好的

iCloudEnd的博客 3636

MySQL---一些问题

答疑: 问题 1:执行一个 update 语句以后,我再去执行 hexdump 命令直接查看 ibd 文件内容,为什么没有看到数据有改变呢? 回答:这可能是因为 WAL 机制的原因。update 语句执行完成后,InnoDB 只保证写完了 redo log、内存,可能还没来得及将数据写到磁盘。 问题 2:为什么 binlog cache 是每个线程自己维护的,而 redo log buff...

m0_37039331的博客 193

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

binlog,redolog,undolog学习笔记

binlog binlog是MySql中所有引擎都有的日志,以二进制格式进行记录。可以使用mysqlbinlog查看内容。其作用主要是恢复和复制。 恢复 由于binlog记录的是事务结束后对数据库产生的数据变化,比如delete/update/create/truncate/drop等。因此它记录的是完整的数据库信息。当数据库数据丢失时,可以通过binlog进行恢复。 复制 在MySql主从同步时...

Crazy_xym的博客 559

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

学习binlog undolog redolog笔记

数据库三种日志的学习笔记

qq_50800130的博客 86

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

MySQL学习笔记(八)redolog、undolog、binlog

Mysql三个核心日志分别是 binlog(二进制日志) 、redo log(重做日志)、undo log(回滚日志), 这里面binlog 是server层的日志,而redo log 和undo log都是引擎层(innodb)的日志,其他数据引擎就没有redo log和undo log,例如myisam引擎就没有这2个日志,因为它不支持事物。

岁月不饶人,我亦未曾饶过岁月 884

后端笔记04 | 认识MySQL三大日志:redolog 、binlog、undolog

对redolog、undolog、binlog的理解和区分笔记,WAL机制和两阶段提交理解。

2201_75974870的博客 800

MySQL45讲笔记(一)逻辑架构、redolog、binlog

目录一 MySQL逻辑架构图1.1 连接器小结1.2 查询缓存1.3 分析器1.4 优化器1.5 执行器执行过程参考 一 MySQL逻辑架构图 大体来说,MySQL可以分为Server层和存储引擎层两部分 1.1 连接器 负责和客户端简历连接、获取权限、维持和管理连接 比如通过命令行连接到MySQL 权限问题 一个用户成功建立连接后,即使这个用户的权限修改了,也不会影响到已经连接的权限。 小结...

codezhuyc的博客 603

Mysql学习笔记(wal crash-safe binlog redolog)

WAL 预写日志,是数据库系统中常见的一种用于保证数据操作的原子性和持久性的手段在WAL系统中所有的修改在提交之前都要先写到log文件中。Log文件包括redo和undo信息。这种记录时便于在机器掉电后检查log文件,对掉电时计划执行的操作和实际上执行的内容进行比较。在这个比较的基础上,程序就可以决定时撤销已做的操作还是继续完成已做的操作或者保持原样。

qq_38167629的博客 195

第二讲“SQL更新语句(redolog和binlog)”——笔记

更新语句和查询语句差不多。 SQL更新例句:updata T set c = c + 1 where ID = 2; 执行语句前连接数据库(连接器)。 执行更新语句时,对于目标表的查询缓存会失效。 分析器通过词法和语法分析知道是更新语句。 优化器决定使用ID这个索引。 执行器负责具体执行,调用存储引擎的接口,找到这一行并更新。 redolog(重做日志)与binlog(归档日志) redolog(重做日志) binlog(归档日志) 位置 InnoDB 引擎特有的 MySQL 本身

吃鲸的田园犬 606

MySQL三大日志——binlog、redoLog、undoLog详解

我们都知道,事务的四大特性里面有一个是持久性,具体来说就是只要事务提交成功,那么对数据库做的修改就被永久保存下来了,不可能因为任何原因再回到原来的状态。那么mysql是如何保证一致性的呢?最简单的做法是在每次事务提交的时候,将该事务涉及修改的数据页全部刷新到磁盘中。但是这么做会有严重的性能问题,主要体现在两个方面: 1)、 因为Innodb是以页为单位进行磁盘交互的,而一个事务很可能只修改一个数据页里面的几个字节,这个时候将完整的数据页刷到磁盘的话,太浪费资源了! 2)、 一个事务可能涉及修改多个数据页,并

想着百万年薪努力的小赵 5万+

【重学MySQL】redolog & binlog

MySQL通过BufferPool提高读写性能,将磁盘数据缓存在内存中。为避免断电导致数据丢失,引入redo log记录修改操作(WAL技术)。redo log是循环写入的物理日志,确保crash-safe能力;binlog是追加写入的逻辑日志,用于备份和主从复制。更新数据时采用两阶段提交:先写redo log(prepare状态),再写binlog,最后提交事务。异常重启时,通过检查redo log和binlog的XID决定回滚或提交。定期全量备份+binlog可实现任意时间点恢复,备份频率取决于业务重要

先做到 再看见 1900

mysql redolog binlog 之二阶段提交

文章目录一:什么是redolog和binglog?二:redolog和binlog可以相互替代或者只保留其一吗?1. 可以使用binlog替代redolog进行数据恢复吗?2. 可以只适用redolog而不是用binlog吗?三:为什么redolog和binlog要进行二阶段提交?四:二阶段提交步骤五、redolog和binlog二阶段提交与redolog和binlog的顺序提交是否真的有区别?六...

welcome to daijiguo's blog 6744

redolog binlog undolog的区别

日志系统主要有redo log(重做日志)和binlog(归档日志)。redo log是InnoDB存储引擎层的日志,binlog是MySQL Server层记录的日志, 两者都是记录了某些操作的日志(不是所有)自然有些重复(但两者记录的格式不同)。 图来自极客时间的mysql实践,该图是描述的是MySQL的逻辑架构。 redo log日志模块 redo log是InnoDB存储引擎层的日志,又称重做日志...

Xeroxo的博客 2269

MySQL中Binlog Redolog Undolog区别?

通过UndoLog,数据库可以在事务回滚或并发读取时,将数据恢复到事务开始之前的状态,以保证事务的原子性和一致性,同时支持数据库的并发读取操作。它记录了数据库引擎对数据进行的修改操作,以确保即使在数据库崩溃或断电的情况下,也能够重新执行事务的修改操作,从而保证了事务的持久性和数据的一致性。Undo记录中记录了修改前的数据值、修改后的数据值以及撤销操作的详细信息。如果数据库发生崩溃或断电,数据库引擎可以通过RedoLog中的日志记录重新执行事务的修改操作,将数据库恢复到崩溃之前的状态,保证数据的一致性。

u013257321的博客 1083

Mysql的redolog和binlog

redlog是重做日志,是Innodb存储引擎独有的,他让MySQL在崩溃的时候具有了恢复数据的能力,即在数据库发生意外的时候,可以进行数据恢复;redlog日志会备份的是事务执行过程中的修改数据,是事务过程中最新的数据位置。binlog是一个二进制格式的文件,用于记录用户对数据库更新的SQL语句信息,默认情况下,binlog是二进制格式的,不能使用文本工具的命令进行查看,而是使用mysqlbinlog解析查看。...

lml_0916的博客 3068
上一篇: (六)并发工具类 CompletableFuture(异步编程)
下一篇: MySQL主备同步与主从同步
香草星冰乐
博客等级 码龄7年 21粉丝 46原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值