主成分分析 - 示例代码

主成分分析(PCA)方法步骤以及代码详解 主成分分析(PCA)方法步骤以及代码详解 前言 上一节我们了解到在构建神经网络模型,除了掌握如何搭建神经网络架构,了解参数具体含义,规避风险等方法。第一步是要对采用数据集的详细了解,无需接触任何神经网络代码,而是从彻底检查数据开始。这一步是非常关键的一步,往往我们在数据处理的某一个步骤会一定程度上的影响实验结果。本节将讲述常见的数据降维方法PCA,减少数据集的变量数量,同时保留尽可能多的信息。 1. 什么是主成分分析? ​ PCA(Principal Component Analysis) 是一种常见的 阅读详情

主成分分析 - 示例代码

简单介绍

主成分分析就是通过对研究对象的所有维特征进行分析,并找出能够表现出数据特征的最主要的特征,并对特征进行降维度。

其原理是对特征的协方差矩阵进行研究。协方差矩阵可以类比一维的协方差来理解,方差的值对应矩阵中的这一维的特征值。因此找出最大的协方差,就说明这两个维度的差别越大,也就说明其携带的信息就更多。

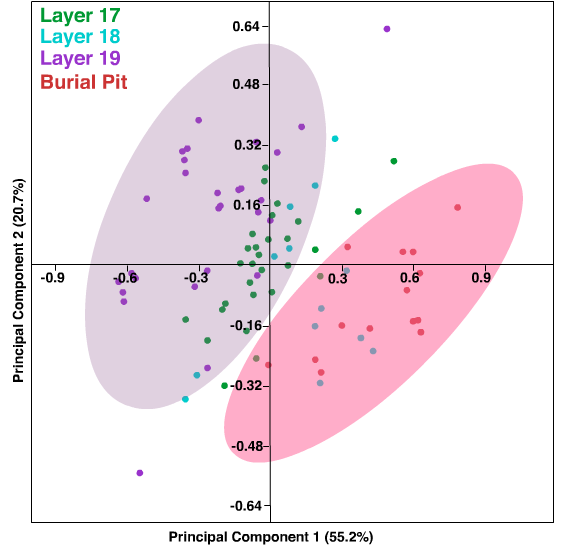
具体的解释可以如下图所示:
burial-PCA

以上数据点有两个主要的特征,紫色和粉色,这两个特征明显可以表现出样本的大部分分布趋势,那么我们就通过对这两个方向进行投影的方式来将空间投影到最有用的两个特征上来进行分析。这样可以大幅度地降低特征的维度!

示例代码

# 方法一: 直接使用现成函数
np.random.seed(1)
n = 1  # The amount of the correlation
x = np.random.uniform(1,2,1000) # Generate 1000 samples from a uniform random variable
y = x.copy() * n # Make y = n * x

# PCA works better if the data is centered

x = x - np.mean(x) # Center x. Remove its mean
y = y - np.mean(y) # Center y. Remove its mean

data = pd.DataFrame({'x': x, 'y': y}) # Create a data frame with x and y
plt.scatter(data.x, data.y) # Plot the original correlated data in blue

pca = PCA(n_components=2) # Instantiate a PCA. Choose to get 2 output variables

# Create the transformation model for this data. Internally, it gets the rotation 

# matrix and the explained variance

pcaTr = pca.fit(data)

rotatedData = pcaTr.transform(data) # Transform the data base on the rotation matrix of pcaTr

# # Create a data frame with the new variables. We call these new variables PC1 and PC2

dataPCA = pd.DataFrame(data = rotatedData, columns = ['PC1', 'PC2']) 

# Plot the transformed data in orange

plt.scatter(dataPCA.PC1, dataPCA.PC2)
plt.show()


#  方法二 使用使用PCA的基本算法

# UNQ_C5 GRADED FUNCTION: compute_pca

def compute_pca(X, n_components=2):
    """
    Input:
        X: of dimension (m,n) where each row corresponds to a word vector
        n_components: Number of components you want to keep.
    Output:
        X_reduced: data transformed in 2 dims/columns + regenerated original data
    pass in: data as 2D NumPy array
    """

### START CODE HERE ###
# mean center the data
X_demeaned = X- np.mean(X,axis=0)

# calculate the covariance matrix
covariance_matrix = np.cov(X_demeaned.T)

# calculate eigenvectors & eigenvalues of the covariance matrix
eigen_vals, eigen_vecs = np.linalg.eigh(covariance_matrix)

# sort eigenvalue in increasing order (get the indices from the sort)
idx_sorted = np.argsort(eigen_vals)

# reverse the order so that it's from highest to lowest.
idx_sorted_decreasing = idx_sorted[::-1]

# sort the eigen values by idx_sorted_decreasing
eigen_vals_sorted = eigen_vals[idx_sorted_decreasing]

# sort eigenvectors using the idx_sorted_decreasing indices
eigen_vecs_sorted = eigen_vecs[:,idx_sorted_decreasing]

# select the first n eigenvectors (n is desired dimension
# of rescaled data array, or dims_rescaled_data)
eigen_vecs_subset = eigen_vecs_sorted[:,0:n_components]

# transform the data by multiplying the transpose of the eigenvectors with the transpose of the de-meaned data
# Then take the transpose of that product.
X_reduced = np.dot(eigen_vecs_subset.T,X_demeaned.T).T

### END CODE HERE ###

return X_reduced

机器学习之主成分分析PCA及代码示例 一、主成分分析(PCA)主成分分析(Principal Component Analysis)是一种常用的降维算法,可通过线性组合的方法将多个特征综合为少数特征,且综合后的特征相互独立,又可以表示原始特征的大部分信息。1. 主成分和方差观察以下的几个样本的特征向量X:x1 x2 x3 x4 y 0 10 -2 2 0 10 -3 3 0 10 -4 4 可以看出上述 阅读详情

相关推荐

ArcGIS教程:主成分分析

对一组栅格波段执行主成分分析 (PCA) 并生成单波段栅格作为输出。

1万+

python主成分分析_Python机器学习笔记:主成分分析(PCA)算法

一:引入问题首先看一个表格,下表是某些学生的语文,数学,物理,化学成绩统计:首先,假设这些科目成绩不相关,也就是说某一科目考多少分与其他科目没有关系,那么如何判断三个学生的优秀程度呢?首先我们一眼就能看出来,数学,物理,化学这三门课的成绩构成了这组数据的主成分(很显然,数学作为第一主成分,因为数据成绩拉的最开)。那么为什么我们能一眼看出来呢?当然是我们的坐标轴选对了!!下面,我们继续看一个表格,下...

weixin_39570530的博客 2297

一篇文章带你搞定数学建模里的主成分分析(05年水质问题示例应用讲解含代码)

文章目录一、题目分析二、原理公式三、MATLAB实现某一地区的主成分分析四、MATLAB 实现所有地区28个月的综合分析五、注意 一、题目分析 对长江近两年多的水质情况做出定量的综合评价,并分析各地区水质的污染状况 考虑到各指标之间可能存在一定的相关性,选用主成分分析法对长江流域主要城市水质检测报告进行分析,选取主成分,并把主成分得分按照方差贡献率加权求和,得到每个地区的污染综合评价指数,进而可以计算每个月长江流域的污染综合评价指数,对平均综合评价指数进行排序 二、原理公式 根据主成分分析的方法,分析长江沿

南淮北安的博客 2626

主成分分析法(PCA)的理解(附python代码案例)

主成分分析(Principal Component Analysis, PCA)是一种统计方法。通过正交变换将一组可能存在相关性的变量转换为一组线性不相关的变量,转换后的这组变量叫主成分。换一种说法:PCA去除噪声和不重要的特征,将多个指标转换为少数几个主成分,这些主成分是原始变量的线性组合,且彼此之间互不相关,其能反映出原始数据的大部分信息,而且可以提升数据处理的速度。为什么会出现PCA呢?因为每个变量都在不同程度上反映了所研究问题的某些信息,并且指标之间彼此有一定的相关性,因而所得的统计数据。

(:3|❀)我要睡觉了,请帮我关一下灯,谢谢 3万+

GEE:主成分分析(Principal components analysis,PCA)

本文将介绍主成分分析(Principal components analysis,PCA)原理和在Google Earth Engine(GEE)平台上应用 PCA 算法的代码和案例。并应用于 Landsat 数据可见光波段和生态遥感指数(RSEI) 案例中。并介绍如何针对一副影像、一个影像集合进行 PCA 分析,文中对 PCA 的计算过程进行了封装,只需要调用 imagePCA(imageCollection, imageBands) 函数,即可得到影像的主要成分分量,并输出特征值和特征向量。可以输出多个

养乐多的博客 2813

一篇文章带你搞定数学建模中的载荷矩阵、相关系数矩阵、主成分分析(11年土壤重金属污染示例讲解含代码)

文章目录一、题目分析二、基于主成分分析法的重金属污染评价模型1. 模型建立2. 模型求解三、问题求解代码四、相关系数矩阵的了解五、载荷矩阵的了解 一、题目分析 通过数据分析,说明重金属污染的主要原因 在问题二中,为了找出重金属污染的主要原因,我们采用主成分分析法分析8种重金属对不同功能区的污染情况,并结合不同功能区重金属间的相关性和我们对重金属来源的认识,分析得知工业区所受的重金属污染主要来源于工业生产过程中的废料废气等,而主干道路区主要受汽车尾气等交通污染,生活区、公园绿地区与山区的污染主要来自与工业废气

南淮北安的博客 4819

机器学习——主成分分析法(PCA)概念公式及应用python实现

主要介绍主成分分析的概念、公式、步骤及应用

AI~天海的博客 1万+

R语言实现主成分分析

主成分分析(Principal Component Analysis,PCA)是一种常用的数据降维技术,可以将高维数据转化为低维数据,同时保留原始数据的主要特征。假设我们的数据存储在一个名为data的数据框中,其中每一列代表一个特征,每一行代表一个样本。该函数将标准化后的数据作为输入,并返回主成分分析的结果。根据选择的主成分数量,我们可以通过将主成分得分与主成分载荷相乘,并加上原始数据的均值来重构原始数据。根据选择的主成分数量,我们可以通过将主成分得分与主成分载荷相乘,并加上原始数据的均值来重构原始数据。

KdpdCode的博客 463

主成分分析(PCA)及葡萄酒数据集示例代码

主成分分析(PCA)是一种无监督的线性变换技术,广泛地应用于不同的领域,特别是特征提取和降维。他的应用领域包括股票市场交易的探索性数据分析和去噪,以及生物信息学的基因组数据和基因表达水平分析。PCA帮助我们根据特征之间的相关性来识别数据中的模型。PCA旨在寻找高维数据中存在的最大方差的方向,并将数据投影到维度小于或等于原始数据的新子空间。假设新特征轴彼此正交,该空间的正交轴(主成分)可以解释为方差最大的方向,如下图所示。其中x1、x2为原始特征轴,而PC1和PC2为主成分方向。

weixin_50684911的博客 1941

MATLAB实现主成分分析

主成分分析(Principal component analysis,PCA) 基于MATLAB实现主成分分析

WW、forever的博客 7763

主成分分析法—matlab代码

关于主成分分析,内含数据源,代码。且matlab代码解释非常详细,结果易懂

matlab主成分分析代码

matlab主成分分析代码 function y=zhuchengfenfenxi() clc,clear gj=xlsread('RES2016-zhuchengfen.xlsx');%把原始数据保存在纯文本文件gj.txt中 gj=zscore(gj); %数据标准化 r=corrcoef(gj); %计算相关系数矩阵 %下面利用相关系数矩阵进行主成分分析,x的列为r的特征向量,即主成分的系...

Wangzx的博客 1万+

【图像大模型】RIFE实战:如何通过中间流估计实现4K视频的实时插帧优化

本文深入解析了基于深度学习的RIFE视频插帧算法,重点探讨其核心的中间流估计技术如何实现高效精准的帧生成。通过实战教程,详细介绍了针对4K视频的实时处理优化方案,包括环境配置、参数调优及性能瓶颈分析,帮助用户利用消费级显卡将低帧率视频转化为流畅的高帧率体验。

weixin_29093017的博客 460

EEG时频主成分分析(TF-PCA)实用教程(附示例数据和代码)

时频主成分分析(TF-PCA)提供了一种数据缩减方法,它不依赖于关于感兴趣效应的特定时间或频率边界的先验约束,因此特别适合于存在认知发展变化的TF数据分析。本教程提供了背景知识、理论和实用指导,文章还附带了一个配套的GitHub存储库,该存储库包含示例代码、数据和如何执行TF-PCA的逐步指南:https://github.com/NDCLab/tfpca-tutorial。1.理论和方法介绍 1.1 脑电图时频(TF)表征方法简介 TF表征(Time-frequency representation)描述

悦影科技 1911

一体化伺服电机与施耐德PLC TM241CEC24T在Canopen协议下的应用

一.硬件组成 软件组成:施耐德SoMachineV4.3二.○1.打开SoMachineV4.3,点击“新建项目”○2.点击“空白项目”○3.项目命名○4.点击“创建项目” 三. 点击“Logic Builder” 四. ○1.右击项目”PMM_CANOPEN_ST”添加设备○2.点击”LogicController”选择PLC型号TM241CEC24T/U○3.点击“添加设备” 五. ○1.右击CAN_1,添加设备○2.选择“CANopen Perfomance”○3.点击“添加设备”

m0_46512607的博客 2525

Flutter模块打包AAR集成Android原生项目实践

跨平台开发框架Flutter通过将UI组件渲染为原生代码实现高性能表现,其核心优势在于一套代码可同时运行在iOS和Android平台。在工程实践中,将Flutter模块打包为AAR(Android Archive)进行集成,成为混合开发的主流方案。这种方案既保留了原生项目的稳定性,又能渐进式引入Flutter的高效开发特性。通过配置MethodChannel实现原生与Dart代码通信,开发者可以灵活控制Flutter引擎生命周期,优化内存占用和渲染性能。对于电商、社交等需要快速迭代的业务场景,该方案能显著提

weixin_34025051的博客 401

Python主成分分析PCA完整代码及结果图片

Python主成分分析PCA完整代码及结果图片 【下载地址】Python主成分分析PCA完整代码及结果图片 本仓库提供了一个完整的Python主成分分析(PCA)代码示例,并附带了结果图片。PCA是一种常用的降维技术,广泛应用于数据分析、机器学习和模式识别等领域。通过本资源,您可以学习如何使用Python实现PCA,并查...

gitblog_09717的博客 452

【数字电源/MATLAB+PLECS】如何进行 Buck 数字电源仿真(二)PLECS 搭建开环 Buck 功率级

本文介绍了如何在PLECS中搭建开环Buck功率级模型,验证数字电源设计的基本思路。重点内容包括: 明确开发顺序:先开环验证功率级,再闭环设计控制器 搭建关键组件:输入电源、PWM模块、MOSFET开关、续流二极管、LC滤波电路及负载 设置初始参数:24V输入、12V输出、200kHz开关频率、22μH电感、100μF电容 测量关键波形:MOSFET Vds验证开关动作、电感电流纹波和输出电压稳态值 提供完整仿真模型和GitHub资源,便于读者复现验证 文章强调通过开环测试先确保功率级正确性,为后续闭环控制

weixin_43234123的博客 1227

主成分分析

1 主成分分析 主成分简介 主成分分析(Principal component analysis) 是将多指标化为少数几个综合指标的一种统计 分析方法, 由Pearson(1901)年提出, 后来被Hotelling(1933) 进一步发展。主成分分析是一种通过降维技术把多个变量化为少数几个主成分的方法。 散点图 xrnorm(10000) yx+rno

yzlv的专栏 3601

ERA5 数据集下载(2025最新 可运行)

众所周知,ERA5数据集经过了更新,尤其是在API访问和下载方式上发生了变化。2025年版的ERA5数据集为气象研究人员提供了更高质量的历史气象数据。本文将介绍如何通过新的API接口下载最新的ERA5数据集。

m0_72141699的博客 3601

Ubuntu关闭更新提醒的三层控制方法:从GUI到APT配置

Linux系统更新机制本质上是包管理器(APT)驱动的自动化运维流程,其核心原理在于分离‘元数据刷新’、‘安全补丁安装’和‘用户通知’三个职能。这种分层设计既保障了基础安全性,又为系统管理员提供了策略定制空间。技术价值体现在提升生产环境稳定性、规避未经验证的内核/驱动升级风险,并支持ROS、Blender渲染、工业控制等对时序敏感的应用场景。本文聚焦Ubuntu系统入门教程中高频需求——科学关闭软件更新提醒,覆盖Ubuntu 20.04及LTS版本的GUI设置、systemd服务禁用与APT配置修改三大实操

weixin_29698641的博客 396

快速搞定PCA(主成分分析)(原理 代码 案例)

1.1原理 主成分分析是最常用的线性降维方法,通过某种线性投影,将高维的数据映射到低维的空间,并期望在所投影的维度上数据的信息量最大(方差最大),以较少的数据维度去反映原数据的特性。 在机器学习的实际问题中,一般都会有几十个指标,高维数据离散度较大,不利于训练出较好的参数,而低维数据则可以更好的训练参数,因此可以通过降维的形式,计算出k列映射数据替代原数据。 1.2主成分分析的几何解释 通过旋转变换坐标轴使得n个样品点在F1轴方向上的离散程度最大,即F1的方差最大。变量F1代表了原始数.

qq_48774513的博客 9039

Codex API 直接集成指南:告别中转代理,构建稳定高效的 AI 应用

在 AI 应用开发中,API 集成是连接模型能力与业务逻辑的核心环节。其基本原理是通过 HTTP 协议,按照服务提供商定义的规范发送请求并解析响应,实现远程调用。标准化的 API 设计确保了跨平台和跨语言的互操作性,其技术价值在于提供了稳定、可控且可扩展的服务接入方式,是构建企业级智能应用的基础。在实际应用场景中,开发者常需集成如 Codex 这类聚合了多种大语言模型的平台,以调用诸如 DeepSeek 等先进模型。然而,部分开发者仍依赖过时的第三方中转代理工具,这不仅引入了单点故障和版本锁定的风险,还可能

weixin_28224217的博客 340

主成分分析资源下载

主成分分析资源下载 去发现同类优质开源项目:https://gitcode.com/ 资源简介 此仓库提供了关于主成分分析(PCA)的完整资源,包含以下两部分: PCA MATLAB代码:一份完整的MATLAB代码,用于实现主成分分析的计算过程。 PCA原理讲解Word文档:一份详尽的Word文档,深入浅出地讲解了主成分分析的基本原理和方法。 文件内容 PCA.m:MATLAB代码文件,实现...

gitblog_06778的博客 373

【2022】人工智能☆✨

1. 朴素⻉叶斯⽅法是⼀种 ( ) ⽅法。A.机器学习的分类B.不确定性推理C.知识表示答案:A解析:朴素贝叶斯分类器是基于贝叶斯定理与特征条件独立假设的分类方法。它通过学习训练数据集来预测未知数据的类别标签,因此属于机器学习中的监督学习分类方法。选项B不确定性推理和选项C知识表示虽然与朴素贝叶斯方法有一定的关联,但它们并不是朴素贝叶斯方法的主要应用领域或定义特性。2. 关于启发式搜索描述正确的是 ( )。

super_mochi1 404

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

上一篇: 自然语言处理 概览理解 NLP specialization - Supervised ML
下一篇: Generative Adversarial Network (GANs) 对抗神经网络 基础 第一部分
Volavion
博客等级 码龄9年 3788粉丝 36原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Volavion

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值