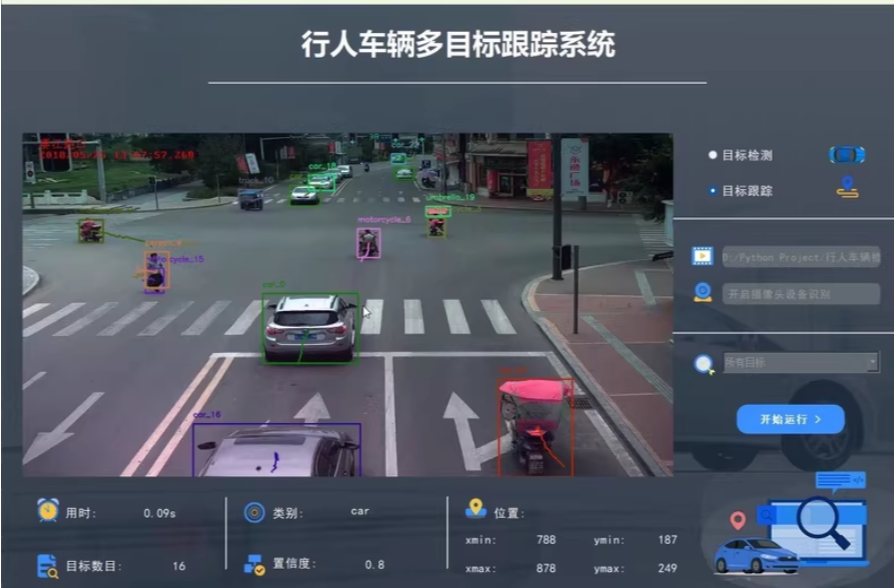
python 基于深度学习的行人车辆多目标实时检测与跟踪系统 ui

深度学习目标检测与跟踪:使用YOLOv8进行行人多目标跟踪(MOT) YOLOv8(You Only Look Once version 8)是YOLO系列模型的最新版本,作为一种高效的目标检测模型,它通过单次前向传播就能够完成目标的检测任务,不仅速度快,而且精度高。速度:YOLOv8具有非常高的检测速度,能够实时处理视频流,适合需要快速反应的应用场景。精度:YOLOv8通过改进的网络架构和训练策略,在目标检测任务中展现出比前版本更高的精度。轻量化:相比于其他一些大规模目标检测模型,YOLOv8更适合在资源有限的设备(如边缘设备、嵌入式设备等)上运行。支持多任务。 阅读详情

python 基于深度学习的行人车辆多目标实时检测与跟踪系统 ui
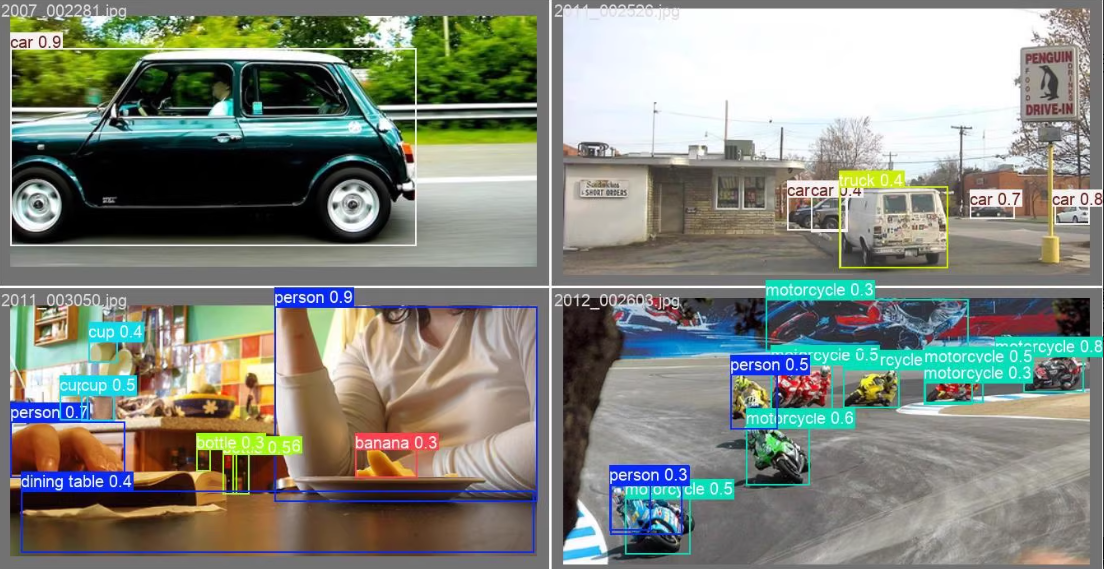

在这里插入图片描述

行人车辆多目标实时检测与跟踪系统
(UI界面,Python代码)

在这里插入图片描述

使用深度学习中的YOLOv5和OCTrack算法实现车辆、行人等多目标的实时检测和跟踪,并利用PyQt5设计了简约的系统UI界面。选择自己的视频文件进行检测和跟踪,可通过电脑自带的摄像头进行实时处理。
在这里插入图片描述
行人车辆多目标实时检测与跟踪系统
涉及多个步骤:模型训练、推理代码、目标跟踪算法以及UI设计

关键代码示例:

1. 环境搭建

确保你的开发环境已经安装了必要的库和工具。

安装依赖
# 创建并激活虚拟环境
conda create -n multi_target_tracking python=3.8
conda activate multi_target_tracking

# 安装YOLOv5和相关库
pip install torch torchvision torchaudio --extra-index-url https://download.pytorch.org/whl/cu113
pip install opencv-python PyQt5 numpy scipy filterpy
git clone https://github.com/ultralytics/yolov5.git
cd yolov5
pip install -r requirements.txt

# 安装OCTrack
git clone https://github.com/your-octrack-repo.git
cd octrack
pip install -r requirements.txt

2. 数据准备

收集和标注包含行人和车辆的数据集。使用Labelimg进行标注,并将标注文件保存为YOLO格式。

数据集结构
dataset/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
└── labels/
    ├── train/
    ├── val/
    └── test/

3. 模型训练

使用YOLOv5进行模型训练。

训练配置文件

创建一个data.yaml文件,定义数据集和类别信息。

train: dataset/images/train
val: dataset/images/val
test: dataset/images/test

nc: 2
names: ['person', 'car']
训练模型

使用以下命令进行模型训练。

python train.py --img 640 --batch 16 --epochs 100 --data data.yaml --weights yolov5s.pt

4. 目标跟踪

使用OCTrack进行目标跟踪。

OCTrack配置

根据需要调整OCTrack的参数和配置。

from octrack import OCTrack

def init_tracker():
    return OCTrack()

def update_tracker(tracker, detections):
    tracker.update(detections)
    return tracker.get_tracks()

5. UI设计与结果展示

使用PyQt5设计用户界面,并展示检测和跟踪结果。

设计界面

使用Qt Designer设计界面,并导出为.ui文件,然后使用pyuic5转换为Python代码。

pyuic5 -x your_design.ui -o ui_design.py
主程序代码
import sys
from PyQt5.QtWidgets import QApplication, QMainWindow, QFileDialog
from PyQt5.QtGui import QImage, QPixmap
from PyQt5.QtCore import QTimer
import cv2
from yolov5.models.experimental import attempt_load
from yolov5.utils.datasets import LoadStreams, LoadImages
from yolov5.utils.general import non_max_suppression, scale_coords
from yolov5.utils.torch_utils import select_device
from octrack import OCTrack

from ui_design import Ui_MainWindow

class MultiTargetTrackingApp(QMainWindow, Ui_MainWindow):
    def __init__(self):
        super().__init__()
        self.setupUi(self)
        self.device = select_device('0')
        self.model = attempt_load('best.pt', map_location=self.device)
        self.tracker = init_tracker()
        
        self.loadImageButton.clicked.connect(self.load_image)
        self.loadVideoButton.clicked.connect(self.load_video)
        self.startCameraButton.clicked.connect(self.start_camera)
        
        self.saveButton.clicked.connect(self.save_results)
        self.exitButton.clicked.connect(self.close)
        
        self.timer = QTimer()
        self.timer.timeout.connect(self.update_frame)
        self.cap = None
    
    def load_image(self):
        file_name, _ = QFileDialog.getOpenFileName(self, "选择图片文件", "", "Images (*.png *.xpm *.jpg)")
        if file_name:
            self.detect_and_track(file_name)
    
    def load_video(self):
        file_name, _ = QFileDialog.getOpenFileName(self, "选择视频文件", "", "Videos (*.mp4 *.avi)")
        if file_name:
            self.cap = cv2.VideoCapture(file_name)
            self.timer.start(30)
    
    def start_camera(self):
        self.cap = cv2.VideoCapture(0)
        self.timer.start(30)
    
    def update_frame(self):
        ret, frame = self.cap.read()
        if ret:
            results = self.detect_and_track(frame)
            annotated_frame = self.plot_results(results, frame)
            height, width, channel = annotated_frame.shape
            bytes_per_line = 3 * width
            q_img = QImage(annotated_frame.data, width, height, bytes_per_line, QImage.Format_RGB888)
            self.imageLabel.setPixmap(QPixmap.fromImage(q_img))
    
    def detect_and_track(self, image):
        img = cv2.resize(image, (640, 640))
        img = img[:, :, ::-1].transpose(2, 0, 1)  # BGR to RGB, to 3x416x416
        img = np.ascontiguousarray(img)
        img = torch.from_numpy(img).to(self.device)
        img = img.float() / 255.0  # 0 - 255 to 0.0 - 1.0
        if img.ndimension() == 3:
            img = img.unsqueeze(0)
        
        pred = self.model(img, augment=False)[0]
        pred = non_max_suppression(pred, conf_thres=0.25, iou_thres=0.45, classes=None, agnostic=False)
        
        detections = []
        for det in pred:
            if len(det):
                det[:, :4] = scale_coords(img.shape[2:], det[:, :4], image.shape).round()
                for *xyxy, conf, cls in reversed(det):
                    x1, y1, x2, y2 = map(int, xyxy)
                    detections.append([x1, y1, x2, y2, float(conf), int(cls)])
        
        tracks = update_tracker(self.tracker, detections)
        return tracks
    
    def plot_results(self, tracks, image):
        for track in tracks:
            x1, y1, x2, y2, id = map(int, track[:5])
            cv2.rectangle(image, (x1, y1), (x2, y2), (0, 255, 0), 2)
            cv2.putText(image, f'ID: {id}', (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)
        return image
    
    def save_results(self):
        file_name, _ = QFileDialog.getSaveFileName(self, "保存结果", "", "Text Files (*.txt)")
        if file_name:
            with open(file_name, 'w') as f:
                for track in self.tracks:
                    f.write(f'{track}\n')

if __name__ == '__main__':
    app = QApplication(sys.argv)
    window = MultiTargetTrackingApp()
    window.show()
    sys.exit(app.exec_())

6. 运行与测试

运行主程序,加载图片、视频或启动摄像头进行检测和跟踪,并展示检测和跟踪结果及可视化。

关键代码示例,仅供参考。

【Flink cdc】Data row is smaller than a column index, internal schema representation is probably xxx 翻译一下:当scan.startup.mode=EARLIEST_OFFSET时,如果在最早的offset之后表结构有过变化就无法支持。原因应该是在binlog 的earliest_offset之后,表结构被修改过。我的解决方案:source配置中使用。mysql source配置使用。,以时间戳为消费依据。 阅读详情

相关推荐

1.3、云计算HCIP融合存储产品及部署

目标:描述Oceanstor V3系列存储产品系统组成及产品定位 描述Oceanstor V3硬件结构及软件架构 掌握存储系统与主机系统之间的连接 一、存储型号 低端型存储:Oceanstor 2200 2600 2800 V3/V5 终端型存储:Oceanstor 5300 5500 5600 5800 6800 V3/V5 高端型存储:Oceanstor 18000 二、Oceanstor V3系列存储系统定位 OceanStor V3系列存储系统是华为根据存储产品应用现状和存储

weixin_43666279的博客 1653

基于深度学习的行人多目标跟踪方法

文章目录基于深度学习的行人多目标跟踪方法0 引 言1 基于检测的跟踪基本概念2 行人多目标检测与跟踪2.1 目标检测2.1.1 基于 Faster R-CNN 的目标检测2.1 2 基于 SSD 的目标检测2.1 3 基于 YOLO 的目标检测2.1.4 其他检测器2.2 特征提取2.2.1 基于 CNN 的特征提取2.2.2 基于 Siamese 的特征提取2.2.3 基于 LSTM 的特征提取2.2.4 其他特征提取方法2.3 数据关联与跟踪2.3.1 匈牙利算法2.3.2 循环神经网络2.3.3 强化

AI从入门到实践的博客 6335

逆向工程师视角:拆解DataDome滑块验证码的3层防护机制与绕过思路

本文从逆向工程师视角,深入剖析DataDome滑块验证码的三层核心防护机制。第一层通过动态加密参数实现会话绑定与抗重放;第二层采集TLS指纹、鼠标轨迹动力学等多维行为数据进行一致性验证;第三层则是基于机器学习的后端异步风险决策引擎。文章不仅拆解了其技术原理,更分享了模拟、钩取等超越单纯工具调用的底层分析与绕过思路。

f6g7h8i9j的博客 731

python 基于深度学习的行人车辆多目标实时检测与跟踪系统 ui界面 行人车辆轨迹追踪 yolov5 深度学习框架目标检测算法

python 基于深度学习的行人车辆多目标实时检测与跟踪系统 ui界面 行人车辆轨迹追踪 yolov5 深度学习框架目标检测算法

2401_88440984的博客 601

从零到一:Ollama工具在RK3588上的深度优化实践

本文详细介绍了如何在RK3588开发板上深度优化Ollama工具,以高效运行DeepSeek模型。通过CPU与NPU负载平衡、模型量化、温度控制等策略,显著提升性能并降低功耗,适用于边缘计算场景。文章提供了具体的配置命令和优化方案,帮助开发者充分发挥RK3588的硬件潜力。

rgv23456789的博客 311

计组实验4 控制冒险与分支预测

目录前言实验内容背景知识分支预测技术⭐阻塞周期计算方法不开启 BTB开启 BTBpart 1 矩阵乘法与优化未开启 BTB 的分析开启 BTB 的分析part 2 设计代码使 BTB 无效part 3 循环展开优化矩阵乘法未开启 BTB开启 BTB结束语结论 前言 上一篇博客:计组实验3 mips冒险之流水线冒险 摸了半个月了。。。咕咕咕 今天来写计组实验 4 这个实验非常简单,就是有点难。 这个实验比较容易算错,或者是被模拟器出人意料的结果搞的神神叨叨的,所以今天来记录并且详细分析该实验。 注:请务必阅

AKGWSB 's blog 5668

实时车辆行人多目标检测与跟踪系统(含UI界面,Python代码)

本文将详细介绍如何使用深度学习中的YOLOv5和OCTrack算法实现车辆、行人等多目标的实时检测和跟踪,并利用PyQt5设计了简约的系统UI界面。在界面中,您可以选择自己的视频文件进行检测和跟踪,也可以通过电脑自带的摄像头进行实时处理。此外,您还可以更换自己训练的yolov5模型,进行自己数据的跟踪。该系统界面优美,检测精度高,功能强大。它具备多目标实时检测、跟踪和计数功能,同时可以自由选择感兴趣的跟踪目标。本博文提供了完整的Python程序代码和使用教程,适合新入门的朋友参考。

Python_csdn_csdn的博客 2884

UE游戏引擎材质简单入门

什么是物体的材质,材质属性定义了物体的某些特性,从而决定了物体表面是如何与光线相作用的。UE中物理基础渲染(Physically Based Rendering OR PBR)几乎可以让我们模拟显示世界中的任何材质。那么如何在UE中制作出真实的PBR材质,基于我们提供的游戏引擎插件,如何将这些材质资源导出,并应用到 SuperMap iClient3D for Cesium/WebGL 平台上,提升模型的显示效果呢,下面小编将详细讲解一下。

m0_71055362的博客 2511

基于大数据的智慧交通大屏可视化分析

本项目实现了一个基于Flask的智慧交通可视化系统,提供了用户管理、数据可视化和基于角色的访问控制。通过合理的数据库设计和后端逻辑,该系统能够有效管理交通数据并为不同用户提供个性化的服务。该系统通过 Flask 构建了一个完整的用户管理、数据管理和可视化展示平台。通过和实现了用户和角色管理,通过 SQLAlchemy 操作数据库表进行数据存储和查询。每个数据库表都专注于存储与交通管理相关的不同类型的数据,从用户信息到交通事件,再到实时数据和高速公路数据,保证了数据的完整性和易于访问。

laoman456的博客 1213

Sentinel--哨兵系列数据下载地址及流程更新【202310】

哨兵系列数据下载地址及流程更新。哨兵系列卫星作为哥白尼计划的一部分,主要目标便是对地球的观测任务。哥白尼计划由三部分组成:空间部分(哨兵系列太空任务与其他太空机构任务)、测量部分(提供海洋、大陆表面和大气信息的陆基和机载数据收集网络)、数据管理与全球共享。

twg666的博客 3万+

5、流体-结构相互作用耦合技术详解

本文详细解析了流体-结构相互作用(FSI)的两种核心耦合技术:松散耦合和紧密耦合。通过原理阐述、优缺点分析及实际应用案例,对比了两种方法的适用场景与性能差异,并进一步探讨了高级耦合技术的发展趋势和工程实践方向,为相关领域的研究人员和工程师提供了全面的技术参考。

fanta的博客 205

实时车辆行人多目标检测与跟踪系统-上篇(UI界面清新版,Python代码)

摘要:本文详细介绍如何利用深度学习中的YOLO及SORT算法实现车辆、行人等多目标的实时检测和跟踪,并利用PyQt5设计了清新简约的系统UI界面,在界面中既可选择自己的视频、图片文件进行检测跟踪,也可以通过电脑自带的摄像头进行实时处理,可选择训练好的YOLO v3/v4等模型参数。该系统界面优美、检测精度高,功能强大,设计有多目标实时检测、跟踪、计数功能,可自由选择感兴趣的跟踪目标。博文提供了完整的Python程序代码和使用教程,适合新入门的朋友参考,完整代码资源文件请转至文末的下载链接。

思绪无限的博客 6万+

智能园艺:AI Agent控制的室内种植系统

随着城市化进程的加速和人们对健康生活的追求,室内种植逐渐成为一种流行的生活方式。然而,传统的室内种植方式往往需要人工进行大量的监测和管理,效率低下且难以保证植物的生长质量。智能园艺:AI Agent控制的室内种植系统旨在利用先进的人工智能技术和传感器设备,实现室内种植的自动化和智能化管理,提高种植效率和植物生长质量。本系统的范围涵盖了从植物生长环境的监测到种植过程的自动化控制,包括温度、湿度、光照、土壤水分等环境参数的实时监测,以及灌溉、施肥、通风等种植操作的自动执行。

AI天才研究院 783

行人车辆检测与计数系统(Python+YOLOv5深度学习模型+清新界面)

行人车辆检测与计数系统用于交通路口行人及车辆检测计数,道路人流量、车流量智能监测,方便记录、显示、查看和保存检测结果。本文详细介绍行人车辆检测,在介绍算法原理的同时,给出Python的实现代码、PyQt的UI界面以及训练数据集。在界面中可以选择各种行人车辆图片、视频进行检测识别与计数;可对图像中存在的多个目标进行识别分类。博文提供了完整的Python代码和使用教程,适合新入门的朋友参考,完整代码资源文件请转至文末的下载链接。

思绪无限的博客 2万+

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

基于YOLOv8深度学习的高精度车辆行人检测与计数系统【python源码+Pyqt5界面+数据集+训练代码】目标检测、深度学习实战

基于YOLOv8深度学习的高精度车辆行人检测与计数系统【python源码+Pyqt5界面+数据集+训练代码】目标检测、深度学习实战

阿旭的博客 1万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机毕业设计(建议收藏)✅

vx_biyesheji0002的博客 1736

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

计算机视觉:YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机(建议收藏)✅

计算机视觉:YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机(建议收藏)✅

B站计算机毕业设计之家的博客 1661

基于YOLOv8与ByteTrack的车辆行人多目标检测与追踪系统【python源码+Pyqt5界面+数据集+训练代码】深度学习实战、目标追踪、运动物体追踪

基于YOLOv8与ByteTrack的车辆行人多目标检测与追踪系统【python源码+Pyqt5界面+数据集+训练代码】深度学习实战、目标追踪、运动物体追踪

阿旭的博客 1万+

基于YOLOv8与ByteTrack的车辆行人多目标检测与追踪系统

车辆行人多目标检测与追踪系统结合了先进的YOLOv8目标检测技术与ByteTrack多目标跟踪算法,能够在实时视频画面中准确地检测并跟踪行人与车辆。这一系统对于改善交通安全、提高城市监控效率以及增强公共安全管理具有显著的重要性。本文基于YOLOv8深度学习框架,通过5607张图片,训练了一个进行车辆与行人的目标检测模型,准确率高达94%;然后结合ByteTrack多目标跟踪算法,实现了目标的追踪效果。最终基于此开发了一款带UI界面的车辆行人多目标检测与追踪系统,可用于实时检测场景中的车辆与行人检测追踪,可以

软件开发实战项目分享 1271

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机毕业设计(建议收藏)

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机毕业设计(建议收藏)✅

vx_biyesheji0001的博客 847

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机毕业设计(建议收藏)✅

YOLOv8车辆行人检测计数与跟踪系统 多目标检测与跟踪系统 ByteTrack算法 深度学习 计算机毕业设计(建议收藏)✅

公众号:源码之屋,十多年程序猿资深互联网人,目前专注于Python/Java/大数据项目解决方案制定,提供各行业各编程语言的全套开发服务,喜爱code,喜爱分享,生命不止,编码不息! 1127

【精选】基于Byte Track改进的车辆行人多目标检测与追踪系统 融合YOLOv8的智能视频分析系统开发 车辆与行人多目标检测与追踪系统

博主介绍:     ✌我是阿龙,一名专注于Java技术领域的程序员,全网拥有10W+粉丝。作为优快云特邀作者、博客专家、新星计划导师,我在计算机毕业设计开发方面积累了丰富的经验。同时,我也是掘金、华为云、阿里云、InfoQ等平台的优质作者。通过长期分享和实战指导,我致力于帮助更多学生完成毕业项目和技术提升。 技术范围:     我熟悉的技术领域涵盖SpringBoot、Vue、SSM、HLMT、Jsp、PHP、Nodejs、Python、爬虫、数据可视化、小程序、安卓app、大数据、物联网、机器学习等方

程序员阿龙的博客 1118

Python目标检测实战:YOLO模型+SORT算法 车辆行人跟踪 多目标检测跟踪系统 毕业设计源码✅

Python目标检测实战:YOLO模型+SORT算法 车辆行人跟踪 多目标检测跟踪系统 毕业设计源码✅

B站计算机毕业设计之家的博客 1018

计算机视觉:python车辆行人检测与跟踪系统 YOLO模型 SORT算法 PyQt5界面 目标检测+目标跟踪 深度学习 计算机✅

计算机视觉:python车辆行人检测与跟踪系统 YOLO模型 SORT算法 PyQt5界面 目标检测+目标跟踪 深度学习 计算机✅

B站计算机毕业设计之家的博客 3132
上一篇: 基于YOLOV5的手势识别检测系统
下一篇: python 目标检测中构建基于深度学习的yolov8+gui(pyqt5)人脸情绪识别系统 识别人脸表情中的生气’,厌恶’,害怕’,高兴’,中立’,伤心’,惊讶
DeepLearningYolo
博客等级 码龄1年 94粉丝 261原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值