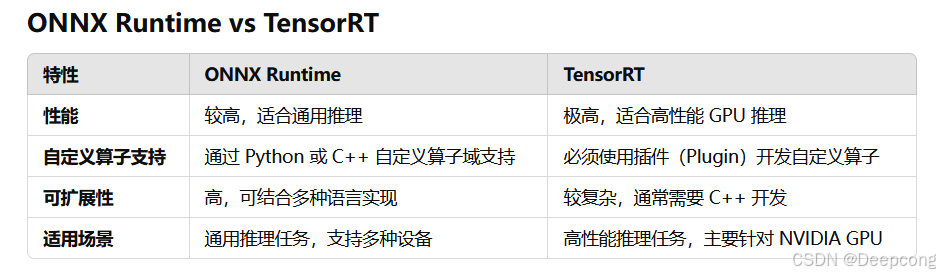
本文主要研究:
1、pt模型转onnx(onnx自定义算子)
2、onnx转engine(tensorrt自定义算子)


 墨衍会员
·
AI 创作全网分发
墨衍智能分发
本文由作者通过墨衍一键同步至各平台
1分发平台
500+累计阅读
529平均单平台
已同步平台
优快云
微信公众号
微博
知乎
掘金
百家号
博客园
抖音
小红书
你的文章也可以这样分发
墨衍会员 ¥399起/年,写一次发全网
我也要
本文主要研究:
1、pt模型转onnx(onnx自定义算子)
2、onnx转engine(tensorrt自定义算子)
Onnxruntime之tensorrt加速
引擎将在第一次构建时被缓存,因此下次创建新的推理会话时,引擎可以直接从缓存中加载。ORT_TENSORRT_INT8_USE_NATIVE_CALIBRATION_TABLE:选择在 INT8 模式下用于非 QDQ 模型的校准表。ORT_TENSORRT_CACHE_PATH:如果 ORT_TENSORRT_ENGINE_CACHE_ENABLE 为 1,则指定 TensorRT 引擎和配置文件的路径,如果 ORT_TENSORRT_INT8_ENABLE 为 1,则指定 INT8 校准表文件的路径。
6.7.tensorRT高级(1)-使用onnxruntime进行onnx模型推理过程
6.7.tensorRT高级(1)-使用onnxruntime进行onnx模型推理过程
车载以太网测试技术解析
在智能汽车与HiL测试领域,高效解析与模拟车载网络通信是开发验证的关键。ZD-Converter 2000以媒体/介质转换器、嗅探器、拦截器、仿真器四合一的颠覆性设计,成为工程师应对复杂车载以太网测试的瑞士军刀。它支持双路车载/标准以太网智能转换、实时通信嗅探、硬件级数据拦截及ECU通信模拟,更通过串口命令实现全参数远程配置,赋能自动化测试流程。本文将深度解析其核心功能与实战应用场景。
onnx转TensorRT使用的三种方式(最终在Python运行)
onnx转TensorRT使用的三种方式(Python运行)
【记录】游戏体验报告怎么写(自我成长篇)
2019年3月更新: 这个倒是不用推翻,我个人虽然写的东西还是有一些偏差的,但是“表哥”说的倒是没毛病的,这篇主要是为了记录用,具体的干货也有,都在图片里,请自行提取 =====18年初原答案 作为一个游戏策划新人,游戏分析可能抓不到点子上,试着总结记录一下游戏体验报告分析的成长(因为水平不同,视野可能也不一样,也许之后几年回头看这些东西都是小儿科或者是错误的,所以只写出当下的想...
TikTok达人私信自动化:用Node.js和纯JavaScript实现WSS协议通信(附完整代码结构)
本文详细介绍了如何使用Node.js和WSS协议实现TikTok达人私信自动化系统。通过分层架构设计、WSS连接管理、消息加密策略及频率控制,开发者可以构建稳定高效的私信工具,突破平台API限制,适用于跨境电商和社交媒体运营场景。
将训练好的模型应用——onnxruntime、TensorRT安装
本文可作为的后续。
在Simulink中进行基于模拟信号数字化处理的仿真
模拟信号数字化处理通常包括以下几个步骤:采样、量化、编码以及数字信号处理(如滤波、变换等)。Simulink提供了丰富的模块库,可以方便地实现这些步骤,并支持对整个系统的实时仿真与调试。首先明确你的系统需求,比如输入信号类型(正弦波、方波等)、采样率、需要执行的数字信号处理操作(低通滤波、频谱分析等)。假设我们需要处理一个50Hz的正弦波信号,采样率为1kHz,并希望对该信号进行低通滤波以去除高频噪声。本文介绍了如何在Simulink中进行基于模拟信号数字化处理的仿真。
onnxruntime和tensorrt多batch推理
【代码】onnxruntime和tensorrt多batch推理。
RK3588 Android12 添加HDMI和喇叭声音通道切换选项
rk3588 android12系统默认接hdmi out时,声音会切换到hdmi out输出,主板声卡喇叭输出会没有声音输出。现在添加一个选项设置hdmi out时,声音可以保持主板声卡喇叭输出。
深度学习部署工程师--8(docker+TensorRT部署到推理+yolo人体检测)下
本文介绍了YOLOv5模型通过TensorRT加速部署的流程。首先需要检查磁盘空间,确保有30GB可用。文章对比了不同推理方式的性能:int8量化+TensorRT可达200FPS,纯TensorRT为166FPS,CUDA为147FPS,CPU为93FPS。重点讲解了将YOLOv5模型导出为ONNX格式的详细步骤,包括修改Detect类的forward方法以移除decode运算,使用git patch批量修改代码,安装必要的依赖库,以及通过onnx-graphsurgeon工具修改ONNX图结构。最终目标
onnxruntime和tensorrt动态输入推理
导出下面的onnx模型:可以看到,该模型的输入batch以及宽高都是动态的。
基于STM32L4XX、HAL库的AD7768BSTZ 模数转换器ADC驱动程序设计
/ 默认SPI配置。// 读取通道数据命令。// 通过SYNC_IN引脚触发转换(如果使用)// 处理数据...// 或者通过SPI命令。// 初始化AD7768。// SPI1引脚配置。
yolov8-obb旋转目标检测onnxruntime和tensorrt推理
【代码】yolov8-obb旋转目标检测onnxruntime和tensorrt推理。
IEC104协议学习专栏内容规划
IEC104协议的编程学习
Statistics and Machine Learning Toolbox
Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具
yolo-world开放词汇检测onnxruntime和tensorrt推理
导出onnx模型: onnx模型结构如下图所示: python推理代码: C++推理代码: tensorrt推理 通过trtexec转换onnx模型得到engine模型: python推理代码: C++推理代码: 推理结果可视化:
霍尼韦尔SoftMaster使用说明
霍尼韦尔SoftMaster使用说明
OpenMMlab导出yolox模型并用onnxruntime和tensorrt推理
这里通过trtexec转换onnx文件,LZ的版本是TensorRT-8.2.1.8。输出是包含多个检测头的输出。安装mmdeploy的话,可以通过下面脚本导出onnx模型。
计算机控制技术及应用
《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。
efm32 入门.pdf
本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。
OpenMMlab导出MaskFormer/Mask2Former全景分割模型并用onnxruntime和tensorrt推理
【代码】OpenMMlab导出MaskFormer/Mask2Former模型并用onnxruntime和tensorrt推理。
OpenMMlab导出yolov3模型并用onnxruntime和tensorrt推理
输出是包含三个不同层级检测头的输出。安装mmdeploy的话,可以通过下面脚本导出onnx模型。
RT-DETR目标检测onnxruntime和tensorrt推理
使用ultralytics 工程(
CLIP图文多模态模型onnxruntime和tensorrt推理
修改clip_onnx/utils.py第61行。
OpenMMlab导出Mask R-CNN模型并用onnxruntime和tensorrt推理
【代码】OpenMMlab导出Mask R-CNN模型并用onnxruntime和tensorrt推理。
OpenMMlab导出swin-transformer模型并用onnxruntime和tensorrt推理
通过mmpretrain 导出swin-transformer的onnx文件非常容易,注意需设置 opset_version=12这里是一个坑,刚开始设置的opset_version=11后续转换trtengine的时候会有问题。第三个坑是如果不加上–workspace参数可能会因内存不足报错,LZ的机器有32G内存索性就设了20G的工作空间,可以根据自己的内存大小酌情设置该参数。mmdeploy导出LZ没有尝试成功,不知道是环境配置问题还是在windows系统下库的bug。python推理:(待补充)
tensorrt和onnxruntime-gpu同时调用gpu时tensorrt推理出现错乱解决方式
tensorrt和onnxruntime-gpu同进程冲突
GRCNN使用onnxruntime和tensorrt推理
本文介绍了GRCNN机器人抓取项目的模型转换与推理过程。首先从GitHub下载项目后,将训练好的PyTorch模型转换为ONNX格式,并展示了模型结构图。然后分别使用ONNXRuntime和TensorRT进行推理:ONNXRuntime版本实现了数据预处理、模型加载、推理执行以及结果后处理;TensorRT版本则详细展示了引擎加载、显存分配和推理流程。两种方法都能成功预测抓取点位置、角度和宽度,输出结果一致。代码提供了完整的数据处理流程和推理实现,便于在机器人抓取任务中应用该模型。

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


 1万+


 扫一扫


