ANU联合腾讯提出Motion Anything!可控多模态运动生成新框架!

东京大学最新研究成果!一种可实现陆空两栖的新型四足机器人SPIDAR,具备多模态运动能力 据悉,SPIDAR 总共有 8 个连杆和 16 个关节,重达 15公斤,其中包括分布在连杆上的 8 个电池,能够支撑总飞行时长为9 分钟,而机器人的步行距离是其两倍多。对此难点,研究人员设计了一种名为SPIDAR的新型空陆两栖四足机器人,该机器人没有腿部执行器,而是由具有可移动腿部的矢量腿部推进器单独连接,并使整个机器人完全升空。“多模态运动能力”作为机器人领域的新兴研究方向一直备受关注,在过去的十余年中,具备多模态运动能力的机器人研究经历了广泛的发展,实现了在陆地和空中两个领域的机动。 阅读详情

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

数源AI 最新论文解读系列

论文名:Motion Anything: Any to Motion Generation

论文链接:https://arxiv.org/pdf/2503.06955

开源代码:https://steve-zeyu-zhang.github.io/MotionAnything
导读

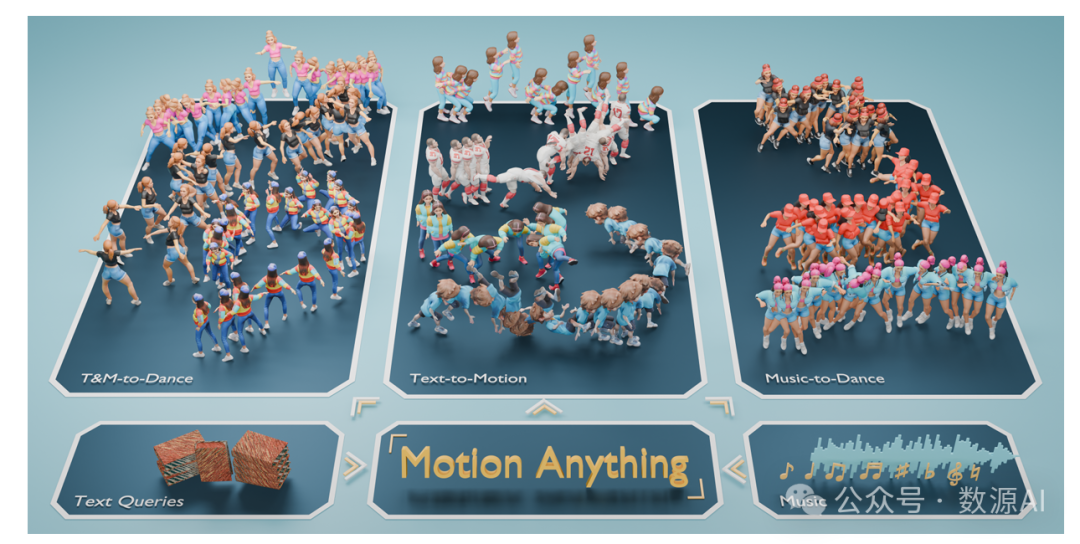
近年来,由于人类运动生成在电影制作、视频游戏、增强和虚拟现实 (AR/VR) 以及用于人机交互的具身人工智能等领域具有广泛的应用,因此得到了广泛的探索。条件运动生成领域的最新进展,包括文本到运动和音乐到舞蹈模型,在 3D 运动生成方面显示出了良好的潜力。这些进展标志着在直接从文本描述和背景音乐生成运动序列方面取得了重大进展。

简介

条件运动生成在计算机视觉领域已得到广泛研究,但仍存在两个关键挑战。首先,尽管掩码自回归方法最近在性能上超越了基于扩散的方法,但现有的掩码模型缺乏一种机制,无法根据给定条件对动态帧和身体部位进行优先级排序。其次,现有的针对不同条件模态的方法往往无法有效整合多种模态,限制了生成运动的可控性和连贯性。为应对这些挑战,我们提出了“Motion Anything”,这是一个多模态运动生成框架,引入了基于注意力的掩码建模方法,能够对关键帧和动作进行细粒度的时空控制。我们的模型能够自适应地编码包括文本和音乐在内的多模态条件,提高了可控性。此外,我们还推出了文本 - 运动 - 舞蹈(Text - Motion - Dance,TMD)这一全新的运动数据集,该数据集包含2153对文本、音乐和舞蹈数据,规模是AIST++的两倍,从而填补了该领域的一个关键空白。大量实验表明,“Motion Anything”在多个基准测试中超越了现有最先进的方法,在HumanML3D数据集上的弗雷歇 inception 距离(Frechet Inception Distance,FID)指标上提升了15%,并且在AIST++和TMD数据集上也取得了持续的性能提升。

方法与模型

1. 概述

“任意动捕”(Motion Anything)提出了一种创新的任意到动作生成方法,该方法通过聚焦人体动作序列中的动态关键部分,并自适应地与不同的条件模态对齐,从而生成可控的人体动作。如图3所示,“任意动捕”可以单独或同时采用不同的模态,实现多模态条件约束,以增强可控动作生成能力,而不是依赖单一条件。这些条件首先由文本和音频编码器进行编码,然后用于指导掩码操作和动作生成。我们提出了一种基于注意力机制的掩码方法,通过选择高注意力分数作为掩码指导,在空间和时间维度上识别与条件相对应的动作中最重要的部分。然后,将引导掩码标记与条件嵌入一起输入到掩码变换器中进行引导掩码恢复。我们将掩码变换器定制为时间自适应变换器和空间对齐变换器,以自适应地将整体控制和特定动作与动作序列对齐。
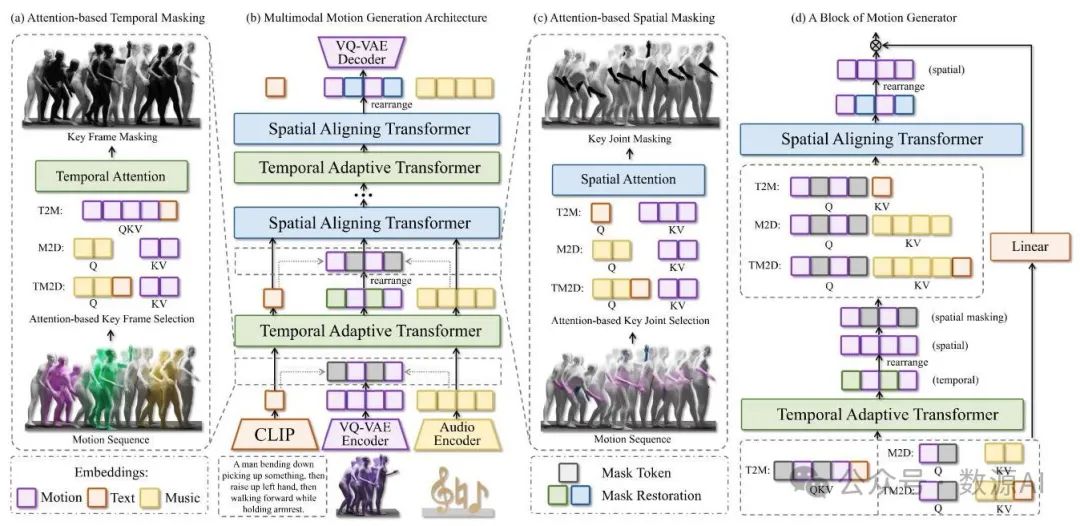
图3. 任意动作生成架构。该多模态架构由几个关键组件组成:(a) 基于时间和(c) 空间注意力的掩码,(b) 动作生成器,以及(d) 动作生成器的单个模块。这些组件使模型能够学习与给定条件相对应的关键动作,并促进多模态条件与动作特征之间的对齐。

2. 架构

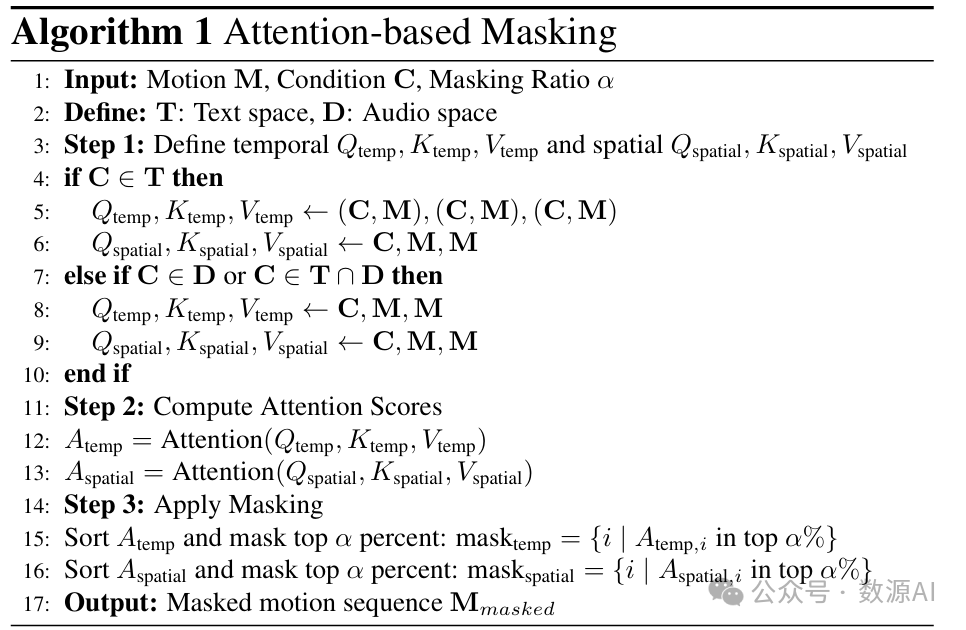
基于注意力机制的掩码。基于注意力机制的掩码的核心在于引导条件模态在时间维度上选择关键帧,在空间维度上选择关键动作,从而实现对这些动作的掩码处理。如图4中的注意力图所示,时间和空间注意力均依赖于自注意力或交叉注意力机制[56],具体取决于条件模态。条件作为查询项(),动作作为键()和值(),其中条件可以是文本、音频或两者的组合。这一过程会在注意力图中突出特定区域,这些区域代表关键动作。我们在时间和空间维度上都设计了基于注意力机制的掩码,以确保模型专注于学习运动序列中与条件相对应的关键帧和关节,如图3 (a)和(c)所示。与传统的随机掩码方法[21, 64]相比,这使得模型能够学习到更稳健的运动表示。
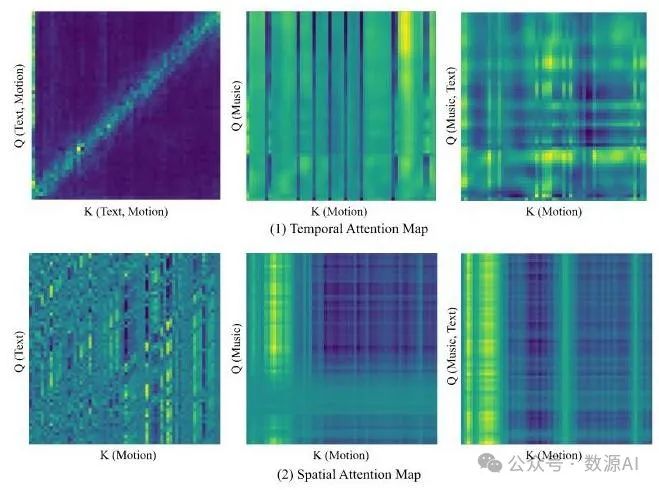
图4. 注意力图。注意力图直观展示了我们基于注意力机制的掩码方法,该方法会选择性地对运动序列中注意力得分较高的区域进行掩码处理。

如算法1所示,给定一个运动序列、一个条件和一个掩码比率,该模型会对注意力得分最高的部分进行掩码处理,这些得分代表了最重要且与相应条件最相关的运动。
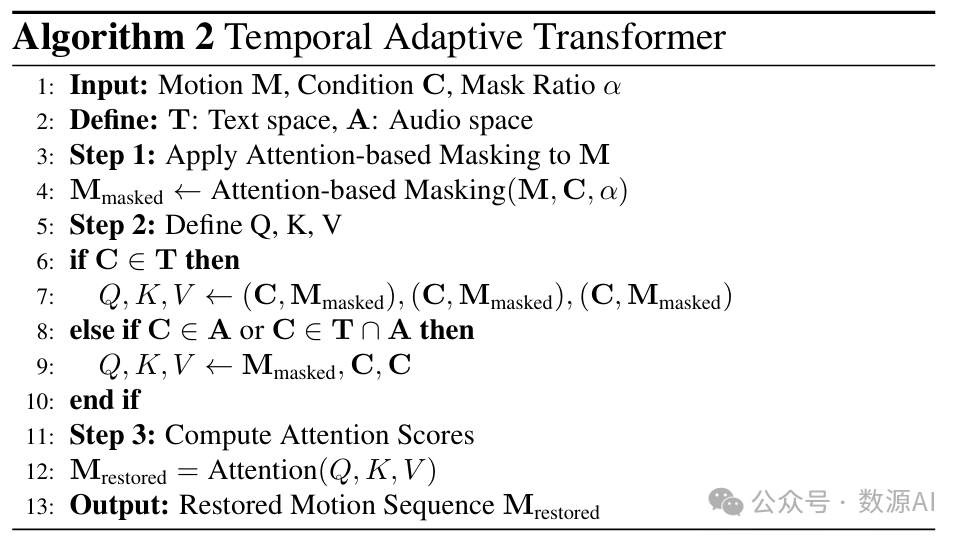
时间自适应Transformer。时间自适应Transformer(TAT)通过根据条件的模态动态调整其注意力计算,将运动序列的时间标记与时间条件对齐。这使得TAT能够将运动的关键帧与文本中的关键词以及音乐中的节拍对齐。

如算法2和图3 (d)所示,在基于注意力机制的掩码处理后,运动序列的关键帧被掩码。然后,时间自适应变换器(Temporal Adaptive Transformer,TAT)通过在条件信息的引导下恢复被掩码的帧来学习运动表示。如果条件信息仅由文本组成,那么它在时间维度上包含来自CLIP的单个标记,这使得在时间维度上使用自注意力机制更为合适。否则,运动序列作为,条件信息作为,执行交叉注意力机制以对齐运动与音乐或音乐和文本组合的时间信息。这使得时间自适应变换器能够更好地适应不同模态的输入条件,并且更加鲁棒。
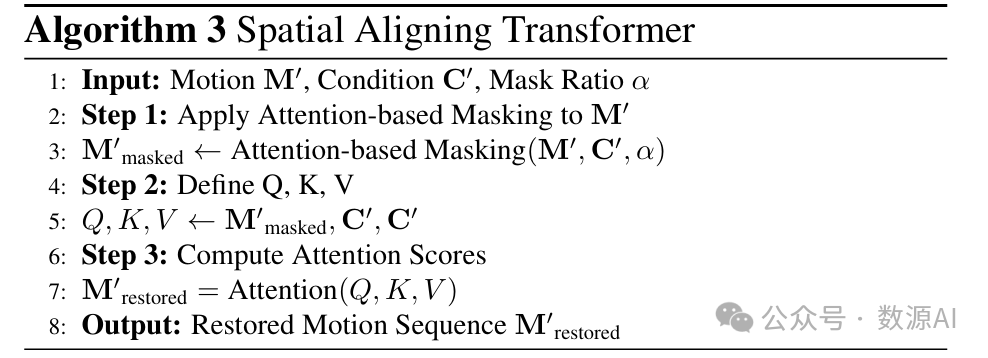
空间对齐变换器。在空间对齐变换器(SAT)中,条件嵌入和运动嵌入都被重新排列以展现空间维度。如算法3和图3(d)所示,在基于注意力的掩码操作中,每一帧中的关键动作(指空间维度中特定身体部位的关键运动)会被掩码。SAT在空间条件的引导下恢复这一特征。将每一帧中的空间姿态与空间条件对齐至关重要,尤其在文本到运动生成任务中,某些关键词会描述特定的身体部位。在音乐到舞蹈生成任务中,每个音频帧的频谱表示音乐类型 ,这对于生成合适类型的舞蹈至关重要。
实验与结果

1. 数据集和评估指标

TMD数据集。我们的文本 - 音乐 - 舞蹈(TMD)数据集引入了一个开创性的基准,包含2153对文本、音乐和动作数据。我们从Motion - X [38](包括AIST++ [34]和其他数据集)中提取舞蹈动作和相应的文本注释。对于没有音乐的动作 - 文本对,我们通过实现Stable Audio Open [14]并进行节拍调整来生成相应的音乐,并通过人类专家评估来评价生成的音乐,以确保评分者间信度。

公开基准。为确保公平比较,我们在标准基准上,将我们的方法与专门的和统一的动作生成方法进行了评估,这些基准包括用于文本到动作生成的HumanML3D [19]和KIT - ML [46],以及用于音乐到舞蹈生成的AIST++ [34]。

评估矩阵。我们采用标准评估指标来评估实验的各个方面。对于文本到动作生成任务,我们使用弗雷歇 inception 距离(FID)和 R 精度来量化生成动作的真实感和鲁棒性,使用多模态距离来衡量动作与文本的对齐程度,并使用多样性指标来计算动作特征的方差。此外,我们应用多模态性(MModality)指标来评估具有相同文本描述的动作之间的多样性。对于音乐到舞蹈生成任务,我们遵循 AIST++ [34] 从三个方面评估生成的舞蹈:质量、多样性和音乐与动作的对齐程度。对于质量评估,我们使用文献 [18] 中的工具箱计算生成舞蹈与动作序列特征(动力学特征  和几何特征 )之间的 FID。对于多样性评估,我们按照 AIST++ [34] 的方法计算平均特征距离。对于对齐程度评估,我们计算节拍对齐分数(BAS),即音乐节拍与其最近的舞蹈节拍之间的平均时间距离。

2. 模型与实现细节

我们的模型由2个TAT(Transformer Attention Transformer)和2个SAT(Self-Attention Transformer)层组成,拥有1265万个参数和137.35 GFLOPs(十亿次浮点运算)。对于所有模型,使用线性预热调度,学习率在2000次迭代后增加到。训练VQ - VAE(矢量量化变分自编码器)分词器时,小批量大小设置为512;训练掩码变换器时,小批量大小设置为64。所有实验均在主频为2.40GHz的英特尔至强铂金8360Y CPU上进行,该设备配备了单块英伟达A100 40GB GPU和32GB内存。

3. 对比研究

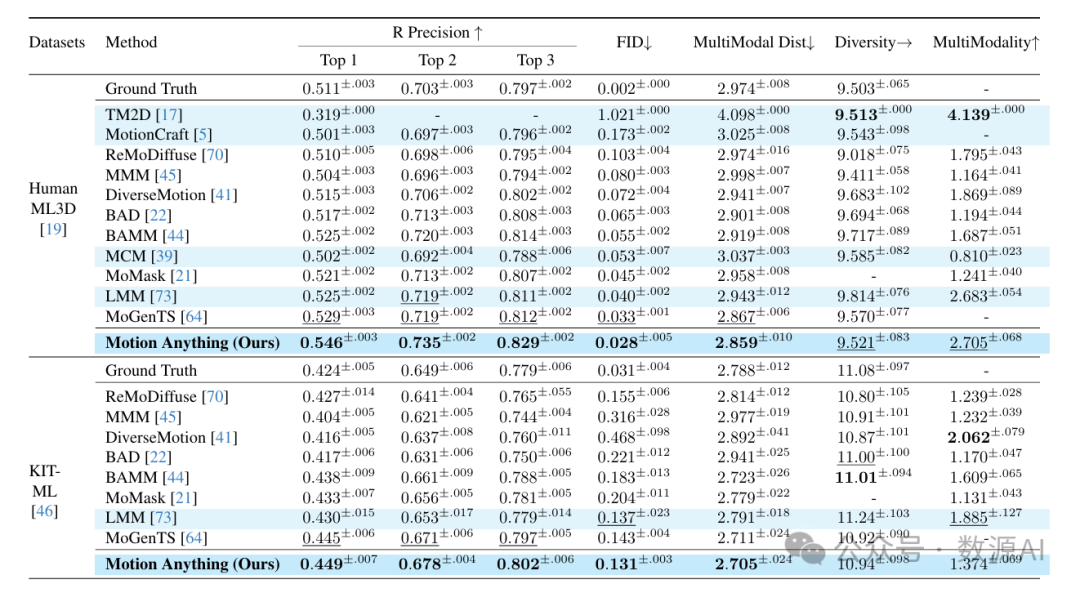
文本到动作转换。我们在HumanML3D [19]和KIT - ML [46]数据集上,将我们的方法与其他最先进的方法进行了比较。表2中的结果表明,我们的方法始终优于专门的文本到动作转换模型,并且超越了近期的多任务方法。
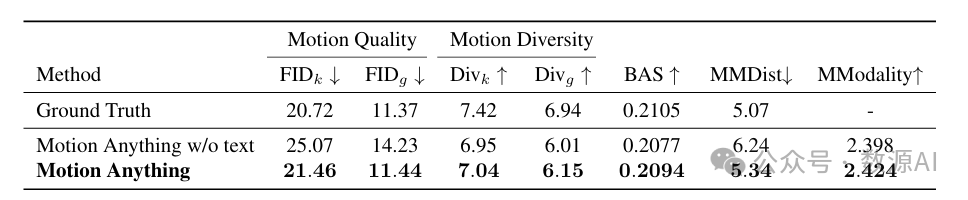
音乐到舞蹈。为了突出我们方法的音乐到舞蹈生成能力,我们在AIST++数据集 [34] 上进行了评估。表3中的结果表明,我们的方法超越了先前最先进的专门方法和统一方法,在音乐到舞蹈生成方面展现出卓越的动作质量、更高的多样性以及更好的节拍对齐
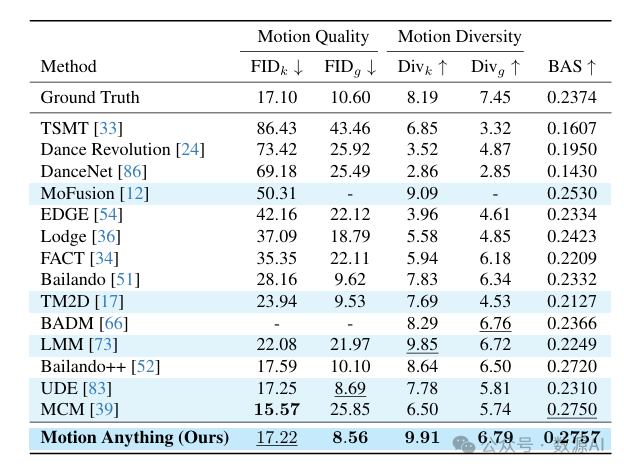
文本与音乐驱动的舞蹈生成。对于配对的文本与音乐驱动的舞蹈生成(TM2D)任务,我们通过直接组合开源多模态动作生成方法的条件嵌入来评估这些方法,并在TMD数据集上将它们与我们的方法进行比较。表

4. 消融实验

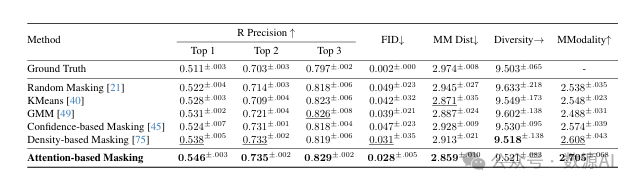
掩码策略。为了评估我们基于注意力的时空维度掩码方法的有效性,我们在HumanML3D数据集 [19] 上进行了全面实验,并将其与其他掩码策略进行了比较,如随机掩码 [21, 64]、K均值聚类(KMeans) [40]、高斯混合模型(GMM) [49]、基于置信度的掩码 [45] 和基于密度的掩码 [75]。表5中的结果表明,我们基于注意力的掩码方法在人体运动生成方面优于其他策略,为学习鲁棒的运动表示带来了有前景的结果。
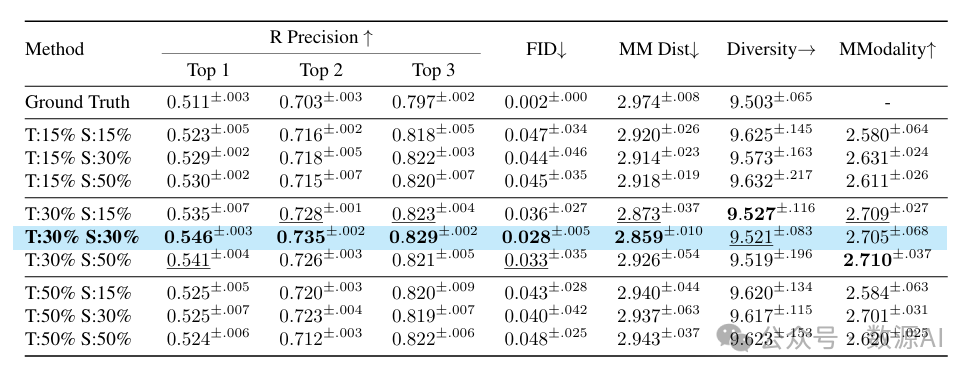
掩码比例。为了证明我们的方法在各种超参数下的鲁棒性,以及不同掩码比例对整体性能的影响,我们在人类动作三维数据集(HumanML3D)[19]上使用不同的基于注意力的掩码比例进行了全面的消融实验,如表6所示。我们分别对基于时间注意力和空间注意力的掩码比例进行了消融实验。结果表明,我们的方法在不同的掩码比例下相对鲁棒,被确定为本文中的最优设置。
用于文本到动作生成的跨模态时间自适应变换器(TAT)。为了验证时间自适应变换器(TAT)中的自注意力机制在文本到动作生成中的必要性,我们修改了TAT中的一个跨模态注意力层,使其类似于音乐到舞蹈以及文本与音乐到舞蹈生成的设置。表7中的结果表明,在人类动作三维数据集(HumanML3D)上进行文本到动作生成时,TAT中的跨模态注意力层的表现比自注意力层差。
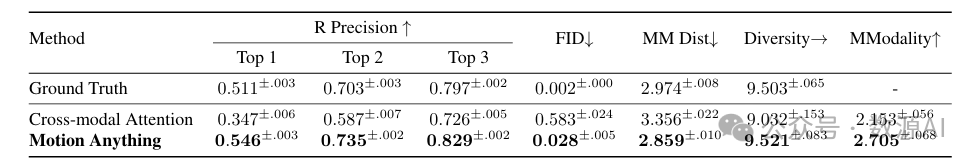
这种性能不佳的情况可归因于以下事实:来自CLIP(对比语言-图像预训练模型)的文本嵌入在时间维度上仅由单个标记组成。因此,时间维度与运动嵌入不匹配,使其不适用于在时间上下文中与运动进行有效的跨模态融合。

多模态条件的有效性。为了评估多模态条件的有效性,我们研究了配对的文本描述是否能实现更可控的音乐到舞蹈生成,以及我们的任意到运动方法是否能无缝利用这两种条件。我们使用TMD数据集对多模态条件进行了消融实验,并将其与仅使用音乐的单条件设置进行了比较。表8中的结果表明,引入多模态条件比使用单一模态更有效,并且我们的模型能够有效且自适应地处理多模态条件。
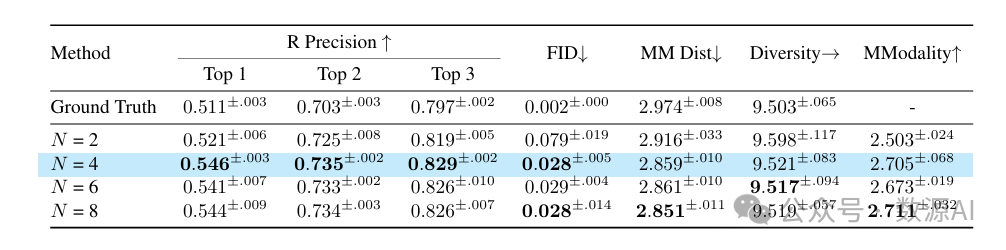
层数。为了研究在掩码变换器中改变层数  对我们模型的影响,我们在HumanML3D上进行了消融研究。表9展示了我们的模型在不同层配置下的鲁棒性。
5. 定性评估

文本到动作生成。为了定性评估我们在文本到动作生成方面的表现,我们将我们的方法生成的可视化结果与之前专门从事文本到动作生成的最先进方法(包括BAD [22]、BAMM [44]和MoMask [21])生成的结果进行了比较。文本提示是根据HumanML3D [19]测试集定制的。如图5和视频演示所示,与之前的最先进方法相比,我们的方法生成的动作质量更高、多样性更强,并且文本与动作之间的对齐效果更好。
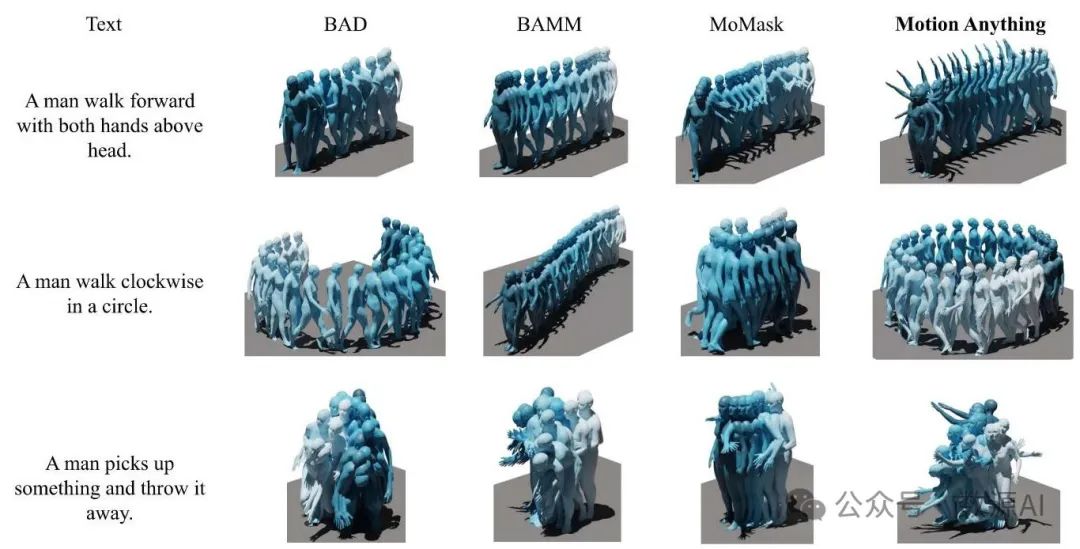
图5. 文本到运动生成的定性评估。我们对我们的方法生成的可视化结果与BAD [22]、BAMM [44] 和MoMask [21] 生成的结果进行了定性比较。

音乐到舞蹈生成。为了评估我们的音乐到舞蹈生成的质量,我们将我们的方法生成的舞蹈与最先进方法(包括EDGE [54]、Lodge [36]和Bailando [51])生成的舞蹈进行了比较。在AIST++ [34]上进行训练,我们确保评估能够反映出多样化的音乐风格。如图6和随附视频所示,我们的方法生成的舞蹈视觉质量更好,并且与音乐的节拍和风格的对齐效果更优,超越了之前的最先进技术。
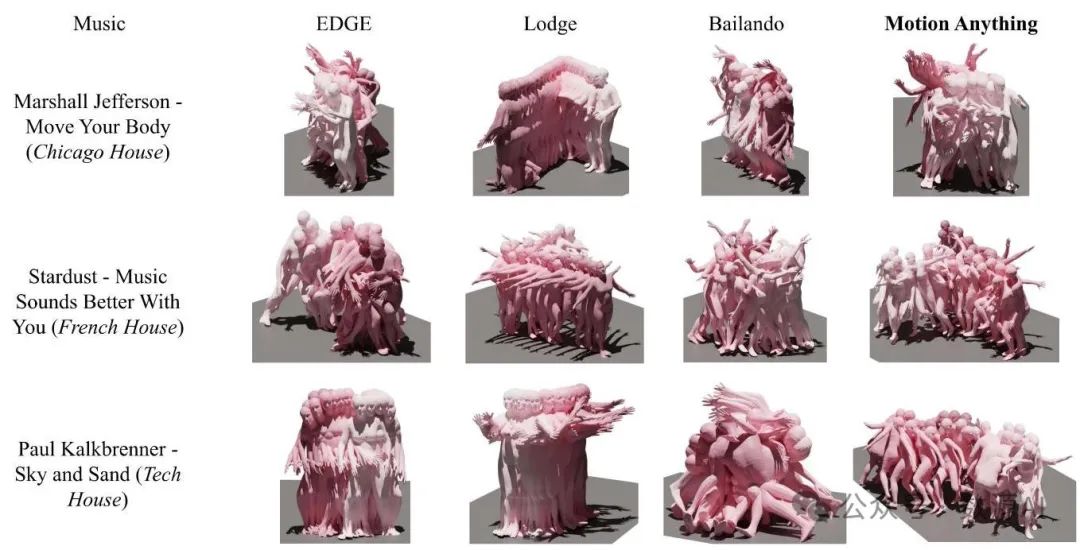
图6. 音乐到舞蹈生成的定性评估。我们对我们的方法生成的可视化结果与EDGE [54]、Lodge [36] 和Bailando [51] 生成的可视化结果进行了定性比较。

如需更多定性评估和视频,请参考补充材料。

结论

总之,“任意动作生成模型”(Motion Anything)通过实现自适应且可控的多模态条件设定,在动作生成领域取得了重大进展。我们的模型在自回归框架内引入了基于注意力机制的掩码,以聚焦关键帧和动作,解决了动态帧和身体部位优先级排序的难题。此外,该模型通过在时间和空间上对齐不同的输入模态,弥补了多模态动作生成方面的差距,增强了可控性和连贯性。为了进一步推动该领域的研究,我们推出了“文本 - 音乐 - 舞蹈”(Text - Music - Dance,TMD)数据集,这是一个具有开创性的包含配对音乐和文本的基准数据集。大量实验表明,我们的方法优于先前的方法,在多个基准测试中取得了显著改进。通过应对这些挑战,“任意动作生成模型”为动作生成建立了新的范式,为动作生成提供了一个更加通用和精确的框架。

Large Motion Model:多模态运动生成模型,能够同时处理文本、音乐、视频等多种模态生成相应的运动动作 Large Motion Model(LMM)是商汤科技与南洋理工大学联合推出的统一多模态运动生成模型,能够处理文本到运动、音乐到舞蹈等多种任务,展现出强大的泛化能力。 阅读详情

相关推荐

Camera常见术语缩写总结

camera常见术语缩写总结

weixin_42194879的博客 1万+

【AI论文】Motion Anything: 任意到动态生成

条件运动生成在计算机视觉领域已得到广泛研究,但仍然存在两个关键挑战。首先,尽管最近掩码自回归方法在性能上超越了基于扩散的方法,但现有的掩码模型缺乏一种机制来根据给定条件优先处理动态帧和身体部位。其次,针对不同条件模态的现有方法往往无法有效地整合多种模态,从而限制了生成运动的控制性和连贯性。为了解决这些挑战,我们提出了Motion Anything,这是一个多模态运动生成框架,引入了基于注意力的掩码建模方法,实现了对关键帧和动作的细粒度时空控制。

m0_66899341的博客 1230

【ADCU详解】PMIC电源管理集成电路详解

自动驾驶域控制器(ADCU)中的电源管理集成电路(PMIC)是高度集成的关键部件,负责为计算核心、传感器等提供高效稳定的多路电源。其核心特点包括:符合车规AEC-Q100标准、支持功能安全ASIL等级、精确的时序控制及强抗干扰能力。PMIC由开关稳压器、LDO、时序控制器、监控保护电路等模块组成,通过分层电源树框架实现电能分配。设计需考虑效率、功率密度、噪声性能等关键维度,底层基于Buck转换器和LDO原理工作。使用中需满足严苛的车规环境要求,并通过静态/动态测试及故障注入测试进行验证,确保系统可靠性和安全

qq_40844444的博客 841

Animate Anything来了!照片秒变视频,涂哪里就动哪里!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【AIGC】微信交流群扫码加入CVer知识星球,可以最快学习到最新顶会顶刊上的论文idea和CV从入门到精通资料,以及最前沿项目和应用!发论文,强烈推荐!在CVer微信公众号后台回复:动起来,即可下载论文pdf和代码链接!快学起来!对着一张照片随手一刷,就能让戴珍珠耳环的少女朝你微笑,让猩红女巫操纵混沌魔法,让清...

阿木寺的博客 729

告别Keil4!手把手教你用Keil C51 V9.61编译51单片机代码(附最新激活方法)

本文详细介绍了Keil C51 V9.61在51单片机开发中的全栈升级指南,包括编译速度提升、调试器性能优化和现代开发支持等核心优势。通过智能安装方案、项目迁移实战和新特性深度应用,帮助开发者告别Keil4,大幅提升开发效率。附有最新激活方法和实用技巧,适用于嵌入式开发工程师。

weixin_26886855的博客 420

LTspice导入德州仪器SPICE模型的实用指南与常见问题解析

本文详细介绍了如何在LTspice中导入德州仪器的SPICE模型,包括模型文件获取、路径管理、导入步骤及常见问题解析。通过实用指南帮助工程师精确仿真电路性能,提升设计效率,重点涵盖了第三方模型的导入教程和最佳实践。

kk1234的博客 308

新视频生成技术AnimateAnything:支持控制镜头轨迹、文本提示等

在视频创作领域,如何实现一致且可控的动画效果一直是研究者们关注的重点。近日,研究团队推出了名为 “AnimateAnything” 的新方法,旨在通过精准的视频操作,使动画创作更加灵活和高效。该技术可以在不同的条件下,如摄像机轨迹、文本提示和用户动作注释等,进行精确的视频处理。“AnimateAnything” 通过设计一种多尺度控制特征融合网络,构建了一个统一的运动表示。这一网络能够将所有控制信息转化为逐帧的光流,从而指导视频的生成。在这个过程中,光流作为运动先验,帮助提升动画的一致性和稳定性。

weixin_41446370的博客 690

stm32f407VET6 系统学习 day01 GPIO 配置

stm32f407VET6 系统学习 day01 GPIO 配置 LED 蜂鸣器 按键的不讲了,之前讲过了

she666666的博客 8904

多模态Arxiv 2024/11/15 | 文本、图像、音频、视频一键生成,港科大联合腾讯提出 Spider 多模态大模型

大型视频语言模型(LVLM)的最新进展推动了旨在评估基于视频任务的认知能力的基准的发展。然而,大多数现有的基准严重依赖于网络收集的视频与人类注释或模型生成的问题,这限制了对视频内容的控制,并且在评估涉及符号元素和抽象概念的高级认知能力方面存在不足。为了解决这些限制,我们引入VCBench,一个可控的基准来评估LVLM的认知能力,涉及不同难度水平的符号和抽象概念。通过使用基于Python的引擎生成视频数据,VCBench允许对视频内容进行精确控制,创建以复杂场景和抽象概念为特征的动态、面向任务的视频。

m0_59235945的博客 1421

STM32F407 CubeMX UART DMA高效解析BNO085九轴数据

本文详细介绍了如何在STM32F407平台上使用CubeMX配置UART和DMA高效解析BNO085九轴传感器数据。通过DMA循环接收机制实现低CPU占用的实时数据采集,并分享数据解析技巧、错误处理及实战调试经验,为嵌入式开发者提供完整解决方案。

o4p5q6r7s的博客 235

GD32F4系列替换STM32F4,HAL库CAN初始化卡死?一个Sleep模式的坑与填坑实录

本文详细解析了GD32F4系列替换STM32F4时,HAL库CAN初始化卡死的问题根源——Sleep模式差异。通过对比两款芯片CAN控制器的默认状态,提出了不修改HAL库源码的解决方案,即在HAL_CAN_MspInit()中清除SLEEP位,并分析了该方法的优势。文章还提供了国产MCU替换的通用建议和调试技巧,帮助开发者高效解决问题。

weixin_29174013的博客 217

初识开源动效引擎 motion-anything:一句话生成动效网页的新手完全指南

motion-anything 是一款开源的 AI 动效引擎(agentic motion layer),主打「一句话生成动效网页」:你用一句自然语言描述想要的感觉,AI 就会产出一个真正能运行的动效页面或发布视频,并支持在运行中的页面上逐组件精修。它本地优先、零 npm 依赖、Apache-2.0 协议,对新手非常友好。这篇指南将带你从零跑通这个动效工具 🎬 ## motion-anythi

gitblog_00764的博客 60

zemax 如何编译用户自定义DLL(含VS下载教程)

zemax 如何编译用户自定义DLL(含VS下载教程)

weixin_72050316的博客 491

生成式AI前沿探索:3D材质到智能判决丨11.26热门论文

大模型(LLM)是一种人工智能模型,旨在理解和生成人类语言。它们在大量的文本数据上进行训练,可以执行广泛的任务,包括文本总结、翻译、情感分析等等。LLM的特点是规模庞大,包含数十亿的参数,帮助它们学习语言数据中的复杂模式。这些模型通常基于深度学习架构,如转化器,这有助于它们在各种NLP任务上取得令人印象深刻的表现。

AI_Conf的博客 689

Python控制LitePoint IQxel-MW 无线网络测试仪

由于项目需要进行WIFI和BT(蓝牙)的射频测试,所以需要开发一款支持WIFI/BT射频测试的工具。开发射频测试工具的话那肯定离不开仪表的控制。我们项目用的就Litepoint的IQxel-MW无线网络测试仪。这篇文章主要就是介绍一下如何控制仪表以及实现的过程!LitePoint是美国硅谷的一家仪器厂商,主要做一些无线通讯测试仪表,包括WIFI,BT(Bluetooth),LTE等等。

xgh1951的博客 1万+

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Motion generation/synthesis evaluation metrics

Motion generation/synthesis evaluation metrics

weixin_45646640的博客 1683

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

澳洲国立大学实现AI“随音起舞“运动生成

创建这个数据集的过程就像是一个庞大的"美食搭配"项目:研究人员首先从现有的Motion-X数据集中提取了高质量的舞蹈动作和对应的文字描述,然后针对那些缺少音乐配对的动作,使用先进的AI音乐生成工具Stable Audio Open来创造匹配的背景音乐。人类的动作看似简单,实际上包含着极其复杂的信息:每个关节的角度、动作的时机、身体各部分的协调配合,以及动作与外界条件(比如音乐节拍或语言描述)的精确匹配。系统的学习过程采用了"遮罩重建"的训练策略,这种方法就像教小孩学画画时的"连点成线"游戏。

zhidingkeji的博客 1016

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

手机中的计算摄影:光学变焦

点击上方“3D视觉工坊”,选择“星标”干货第一时间送达本文转载自计算摄影学,作者HawkWang。文章仅用于学术分享。很多人咨询我,手机上到底有哪些计算摄影的应用和技术。那么接下来就准备抽...

3D视觉工坊 4730

主流AI编程智能体算力架构实测:8大平台模型费率分析与本地配置避坑指南

本文深度评测华为云、智谱、商汤等8大AI编程平台,剖析其算力配额、模型费率与获取路径。核心结论:构建多平台算力储备池可实现低成本高吞吐开发。推荐策略包括:利用免费模型(如GLM-5.3-Flash)、完成三端协同领9000积分、夜间低峰调用3亿Token、通过学生认证获额外奖励,并善用零费率通道与每日签到积分。实测显示,合理配置可使算力成本降低70%以上,显著提升开发效率。

艺杯羹的博客 191

Grok 4.7在zeekeai编程提示词哪个好用?

在AI编程进阶实践中,用Grok 4.7生成高质量提示词(Meta-Prompt) 成为突破效率瓶颈的关键。依托其实时信息流与极客视角,Grok能精准捕捉最新开源动态,生成具备前沿性、攻击性与低限制的提示词,在框架初始化、代码审计与逆向重构等场景中表现卓越。通过zEEKEAI平台实现多模型路由——以Grok写“战略指令”,再交由GPT-6.1或Claude执行“战术落地”,可显著提升代码可用性与工程鲁棒性。关键在于:善用其破局能力,严控输出格式与风险,构建“提示词架构师+代码执行者”的协同范式,实现成本可控

li475068192的博客 293

AI编程技术拆解(11月8日)|昨天下午聊到第十六轮,四十张待确认单混进对账单,多算18640块

昨天下午三点,我在改一个对账单导出。前面已经聊了十五轮,口径攒了六条:金额四舍五入到分、空值填零、跨月拆两行、客户名去空格、日期只留到天、只汇已确认的单。第十六轮,我让它加一栏"按客户汇总"。它回了一句:对话较长,较早的内容已压缩。我没当回事,接着改,导出后翻了头一页,看着都对,就发给了财务。今天上午九点,财务说总额比系统里多了 18640 元。三个人查到中午,翻出四十张待确认的单,全被算进了汇总。那六条口径是我一条一条说过的,怎么就少了一条?

李文慧 中国开源充电桩平台第一人;李文慧 国内知名开源工作者 全栈工程师 华为云最具价值专家 13

AI编程技术拆解(11月9日)|同一句话问五个工具,四份一样,偏挑了不一样那份,三个用例白写

昨天下午三点,测试前一天。手机号校验这块还空着,他懒得一个个工具试,就把同一句话在五个工具里各问了一遍:写个函数,校验手机号。一句话,五个答案。四份一模一样:11 位数字,开头是 1,空格当没看见。第五份多认了一种,带 +86 的 13 位也放过。他看那份多认了一种,觉得更周全,就用了它。第二天跑那 8 条用例,3 条红,因为需求写的是只收 11 位本地号。改回、重跑、重写用例花掉 91 分钟,他盯着那五行字看了半天,想不通:同一句话,五个工具,怎么会给出不一样的答案?

李文慧 中国开源充电桩平台第一人;李文慧 国内知名开源工作者 全栈工程师 华为云最具价值专家 18

基于AI编程工具(Trae Work / Cursor Codex)开发全栈项目标准化流程

本文提出一套基于AI编程工具(Trae Work/Cursor Codex)的全栈开发标准化流程,解决AI“脑补需求”“乱改代码”“契约不一致”等痛点。核心思想:人定契约,AI执行,通过需求澄清、接口契约先行、Spec/Checklist锁定范围、任务分步迭代、强制Skill规则约束,实现可复用、可验证的开发闭环。配套提供项目Skill规则、文档模板及FastAPI+Vue3+Flutter极简Demo,确保AI生成代码精准落地,提升工程化效率与交付质量。

jacky choise 185

【AI编程】使用笔记:修复vscode中codex插件加载失败 Codex could not start

适用于打开 Codex 侧栏后显示,并在日志中确认界面就绪超时的情况。本文将等待时间从延长到。这是针对特定插件版本的临时修改,该版本把时限写在插件程序里,VS Code 的和 Codex 的都没有对应设置项。

tz_zs的博客 386

AI编程与手搓编程的本能差异

人败在累、烦、漏,AI 胜在不累、不烦、不漏,但唯独无法判断与担责。AI 可稳定执行重复任务、穷举检查、守流程,却依赖清晰指令,易因模糊需求出错;人虽会疲劳、回避,却具备直觉、权衡与责任担当。真正的高效不是替代,而是分工:让 AI 承担“做”的部分,人专注“判”的核心——决定该不该做、能否担责。

麦哲思科技 160

2026最新7款企业AI编程平台深度选型实测

上个月我作为技术负责人,接了个硬骨头——两周内给团队选一款企业级AI编程平台。我们公司做金融数据SaaS,代码库80多万行,涉及大量客户敏感数据,安全合规是第一优先级。我拉了个评测清单,把市面上7款主流AI编程工具全部跑了一遍。字节跳动出品的TRAE基础版免费,这一点在预算审批上直接帮了大忙——先让两个小组试用了一周,实测效果远超预期。经过这次选型,我对企业级AI编程工具有了全新的认知。

2603_96966239的博客 198
上一篇: Tiamat AI提出EasyControl!基于DiT的条件引导生成统一新框架!
下一篇: 罗切斯特大学提出OmniPaint:突破性图像编辑框架,实现高精度对象移除与无缝插入!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值