
教程:只需四步,用openAI搭建自己的实时语音翻译应用

随着多语言交流的需求的增加,实时语音翻译正迅速受到关注。在本教程中,你将学习如何使用 H100 GPU + OpenAI API 在 Open WebUI 上部署实时语音翻译应用。我们马上开始吧。

准备工作

这里如果你有合适的 GPU 那么可以直接从 Docker 设置开始。如果你没有能跑起来大模型的 GPU ,那么可以选择 GPU 云服务器,获取 GPU 更快。本教程会使用GPU 服务器,以下是需要做的一些准备工作

  • 一个DigitalOcean 账号。
  • 在 DigitalOcean 后台部署并运行的GPU Droplet服务器。
  • 一个用于访问 OpenAI 模型的 OpenAI API 密钥。
  • 熟悉 SSH 和基础 Docker 命令。
  • 用于登录 GPU Droplet 的 SSH 密钥,可参考我们往期教程。

一、设置 DigitalOcean GPU Droplet

1、创建新项目 - 你需要从后台控制面板创建一个新项目并将其关联到 GPU Droplet。

2、创建 GPU Droplet - 登录你的 DigitalOcean 账户,创建一个新的 GPU Droplet,并选择 AI/ML Ready 作为操作系统。这个操作系统镜像会安装所有必要的 NVIDIA GPU 驱动程序。你可以参阅我们的官方文档了解如何创建 GPU Droplet。这里用的是 H100的 GPU机器,详细的配置在本文中,我们不做赘述。

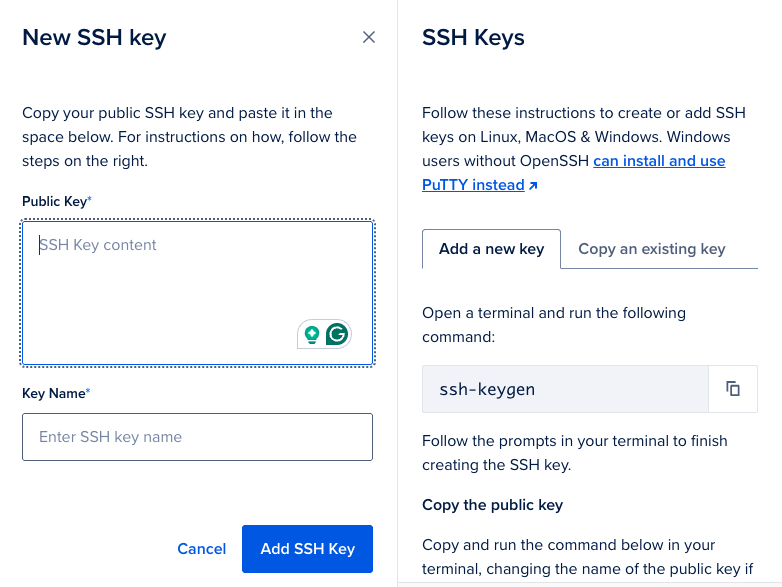
3、添加 SSH 密钥进行身份验证 - 需要 SSH 密钥来对 GPU Droplet 进行身份验证,通过添加 SSH 密钥,你可以从终端登录到 GPU Droplet。
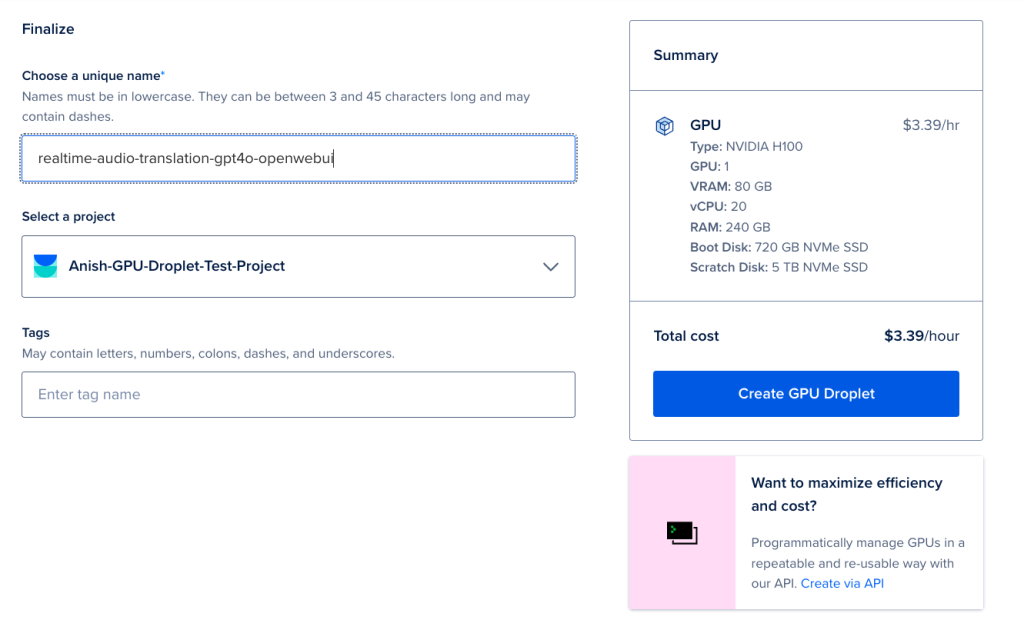
4、完成并创建 GPU Droplet - 完成上述所有步骤后,完成并创建新的 GPU Droplet。
二、安装和配置 Open WebUI

Open WebUI 是一个允许用户与语言模型(LLM)互动的 Web 界面。它设计为用户友好、可扩展、自托管,并且可以离线运行。Open WebUI 的界面与 ChatGPT 类似,可以与多种 LLM 运行器配合使用,包括 Ollama 和与 OpenAI 兼容的 API。

有三种方法可以部署 Open WebUI:

  • Docker:官方支持并推荐给大多数用户。
  • Python:适合资源有限的环境或希望手动设置的用户。
  • Kubernetes:适合需要扩展和编排的企业部署。

在本教程中,你将使用 Docker 作为 Docker 容器在支持 Nvidia GPU 的 GPU Droplet 上部署 Open WebUI。

Docker 设置

GPU Droplet 准备就绪并部署完成后,通过终端使用 SSH 登录到 GPU Droplet。

ssh root@<your-droplet-ip>

此 Ubuntu AI/ML Ready H100x1GPU Droplet 预装了 Docker。你可以使用以下命令验证 Docker 版本:

docker --version

它会输出类似的结果:

Docker version 24.0.7, build 24.0.7-0ubuntu2~22.04.1

接下来,运行以下命令以验证并确保 Docker 可以访问你的 GPU:

docker run --rm --gpus all nvidia/cuda:12.2.0-runtime-ubuntu22.04 nvidia-smi

此命令将拉取 nvidia/cuda:12.2.0-runtime-ubuntu22.04 镜像(如果尚未下载或更新现有镜像)并启动容器。

在容器内部,它会运行 nvidia-smi 以确认容器具有 GPU 访问权限并能与底层 GPU 硬件交互。nvidia-smi 执行完毕后,--rm 标志确保容器自动被移除,因为它不再需要。

你应该会看到以下输出:

Unable to find image 'nvidia/cuda:12.2.0-runtime-ubuntu22.04' locally
12.2.0-runtime-ubuntu22.04: Pulling from nvidia/cuda
aece8493d397: Pull complete 
9fe5ccccae45: Pull complete 
8054e9d6e8d6: Pull complete 
bdddd5cb92f6: Pull complete 
5324914b4472: Pull complete 
9a9dd462fc4c: Pull complete 
95eef45e00fa: Pull complete 
e2554c2d377e: Pull complete 
4640d022dbb8: Pull complete 
Digest: sha256:739e0bde7bafdb2ed9057865f53085539f51cbf8bd6bf719f2e114bab321e70e
Status: Downloaded newer image for nvidia/cuda:12.2.0-runtime-ubuntu22.04

==========
== CUDA ==
==========

CUDA Version 12.2.0

Container image Copyright (c) 2016-2023, NVIDIA CORPORATION & AFFILIATES. All rights reserved.

This container image and its contents are governed by the NVIDIA Deep Learning Container License.
By pulling and using the container, you accept the terms and conditions of this license:
https://developer.nvidia.com/ngc/nvidia-deep-learning-container-license

A copy of this license is made available in this container at /NGC-DL-CONTAINER-LICENSE for your convenience.

Thu Nov  7 19:32:18 2024       
+---------------------------------------------------------------------------------------+
| NVIDIA-SMI 535.183.06             Driver Version: 535.183.06   CUDA Version: 12.2     |
|-----------------------------------------+----------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id        Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |         Memory-Usage | GPU-Util  Compute M. |
|                                         |                      |               MIG M. |
|=========================================+======================+======================|
|   0  NVIDIA H100 80GB HBM3          On  | 00000000:00:09.0 Off |                    0 |
| N/A   28C    P0              70W / 700W |      0MiB / 81559MiB |      0%      Default |
|                                         |                      |             Disabled |
+-----------------------------------------+----------------------+----------------------+
                                                                                         
+---------------------------------------------------------------------------------------+
| Processes:                                                                            |
|  GPU   GI   CI        PID   Type   Process name                            GPU Memory |
|        ID   ID                                                             Usage      |
|=======================================================================================|
|  No running processes found                                                           |
+---------------------------------------------------------------------------------------+

使用 Docker 和 GPU 支持部署 Open WebUI

请使用以下 Docker 命令来运行 Open WebUI Docker 容器。

docker run -d -p 3000:8080 -v open-webui:/app/backend/data --name open-webui --gpus all ghcr.io/open-webui/open-webui:main

上述命令使用 open-webui 镜像运行 Docker 容器,并设置特定的网络端口、卷和 GPU 访问配置。

docker run -d:

  • docker run 启动一个新的 Docker 容器。
  • -d 以分离模式运行容器,即在后台运行。

-p 3000:8080:

  • 将容器内的 8080 端口映射到主机上的 3000 端口。
  • 这样你可以通过访问主机上的 http://localhost:3000 来访问容器中的应用程序。

-v open-webui:/app/backend/data:

  • 将名为 open-webui 的 Docker 卷挂载到容器内的 /app/backend/data 目录。
  • 卷用于持久化容器生成或使用的数据,确保即使容器停止或删除,数据仍然可用。

--name open-webui:

  • 为容器指定一个特定的名称 open-webui,便于引用(例如,使用 docker stop open-webui 停止容器)。

ghcr.io/open-webui/open-webui:main:

  • 指定用于容器的 Docker 镜像。
  • ghcr.io/open-webui/open-webui 是镜像的名称,托管在 GitHub 的容器注册表(ghcr.io)上。
  • main 是镜像标签,通常代表最新稳定版本或主分支。

--gpus all:

  • 此选项为容器启用 GPU 支持,允许其使用主机上所有可用的 GPU。
  • 对于利用 GPU 加速的应用程序(如机器学习模型)来说,这至关重要。

验证 Open WebUI Docker 容器是否启动并运行:

docker ps

机器会给出类似的输出:

CONTAINER ID   IMAGE                                COMMAND           CREATED         STATUS                            PORTS                                       NAMES
4fbe72466797   ghcr.io/open-webui/open-webui:main   "bash start.sh"   5 seconds ago   Up 4 seconds (health: starting)   0.0.0.0:3000->8080/tcp, :::3000->8080/tcp   open-webui

Open WebUI 容器启动并运行后,你可以通过浏览器访问 http://<your_gpu_droplet_ip>:3000。

三、添加 OpenAI API 密钥以使用 GPT-4o

在本步骤中,你将添加你的 OpenAI API 密钥到 Open WebUI。

登录到 Open WebUI 仪表板后,你应该注意到没有模型正在运行,如下图所示:

添加 OpenAI API 密钥

1、打开设置:

  在 Open WebUI 中,点击左下角的用户图标,然后点击“设置”。

2、前往管理:

  导航到“管理”选项卡,然后选择“连接”。

3、添加 OpenAIAPI 密钥:

  在 OpenAI API 选项卡下的右侧文本框中添加你的 OpenAI API 密钥。

4、验证连接:

  点击“验证连接”。绿色指示灯表示连接成功。

现在,Open WebUI 将自动检测所有可用的 OpenAI 模型。从列表中选择 GPT-4o。

接下来,设置文本转语音和语音转文本模型及音频设置以使用 OpenAI whisper 模型:

再次导航并点击“设置” -> “音频”以配置和保存音频 STT 和 TTS 设置,如上图所示。

你可以在openai 官网文档中了解更多关于 OpenAI 文本转语音和语音转文本的信息。

四、设置音频隧道

如果你是从本地机器流式传输音频到 Droplet,需通过 SSH 隧道路由音频输入。

由于 GPU Droplet 上的 Open WebUI 容器运行在 http://localhost:3000,你可以在设置此 SSH 隧道后通过导航到本地机器上的 http://localhost:3000 来访问它。

这是为了让 Open WebUI 能够访问本地机器上的麦克风以进行实时音频翻译所必需的。

使用以下命令通过在本地机器上打开新的终端来设置从本地机器到 GPU Droplet 的本地 SSH 隧道:

ssh -o ServerAliveInterval=60 -o ServerAliveCountMax=5 root@<gpu_droplet_ip> -L 3000:localhost:3000

此命令以 root 用户身份建立与你的 GPU Droplet 的 SSH 连接,并建立本地端口转发隧道。它还包括保持 SSH 会话活动的选项。以下是详细的命令解释:

-o ServerAliveInterval=60:

  • 将时间间隔设置为 60 秒,即每 60 秒向远程服务器发送一次 SSH 保持活动消息。
  • 这有助于防止 SSH 连接因不活动而超时。

-o ServerAliveCountMax=5:

  • 设置允许在 SSH 连接终止之前最多错过 5 条保持活动消息。
  • 与 ServerAliveInterval=60 一起,此设置意味着 SSH 会话将在没有响应的情况下保持打开状态 5 分钟(5 × 60 秒)。

-L 3000:localhost:3000:

  • 设置本地端口转发。
  • 3000(冒号前)是你本地机器上的端口,你将通过该端口访问转发的连接。
  • localhost:3000(冒号后)是指 GPU Droplet 上的目标地址。
  • 在这种情况下,它将流量从本地机器上的 3000 端口转发到 GPU Droplet 上的 3000 端口。

现在,你可以通过访问本地机器上的 http://localhost:3000 来访问 Open WebUI,并使用麦克风进行实时语音翻译。

小结

通过在 Open WebUI 上使用 OpenAI API 部署实时语音翻译应用,借助 DigitalOcean 的 GPU Droplets,开发者可以创建高性能的翻译系统。DigitalOcean 平台易于设置和监控,能够为可扩展、高效的 AI 应用程序提供资源。如需了解DigitalOcean 的 H100 GPU 服务器的更多详情,可阅读往期博文,或联系 DigitalOcean 中国区独家战略合作伙伴卓普云。

相关推荐

Kimi K3.1 Pro 现已上线 DigitalOcean 无服务器推理

Moonshot AI 最新发布的 Kimi K3.1 Pro 现已上线 DigitalOcean 无服务器推理(Serverless Inference)。开发者无需单独管理 Moonshot AI 账号或模型基础设施,即可通过 DigitalOcean API 调用该模型,并按实际 Token 使用量付费。Kimi K3.1 Pro 是 Moonshot AI 在 Kimi K3 基础上进行大规模后训练的升级版本。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 449

Y Combinator 开源 Agent 运行框架 QM,现已支持在 DigitalOcean 一键部署

Y Combinator(YC)开发了 QM,这是一个面向 Slack 和 Web 的多人协作 Agent 运行框架。YC 最初利用 QM 在自己的各个团队中运行 Agent,涵盖财务、法务和工程等部门。今年 7 月,YC 将 QM 开源,让任何初创公司都能以同样的方式使用它。从今天起,用户可以通过 DigitalOcean Marketplace 一键部署 QM。这也是首个面向 QM 的一键部署方案。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 121

Codex 如何接入 Claude 等其它模型?使用 CC Switch 接入 FluxLane API 教程

通过本文的步骤,我们已经完成了在 macOS 上使用 CC Switch 为 Codex 桌面客户端接入 FluxLane API 的配置。你还可以在 Fluxlane 上生成多个调用不同模型的 API,然后添加到 CC Switch 中,每次选择路由不同的 API,就可以让 Codex 切换不同模型来工作。这种方式不需要修改复杂的系统配置,也不需要每次更换模型时手动编辑配置文件。通过 CC Switch 就可以统一管理 Codex 的模型。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 834

Spot GPU 与预留 GPU:AI 初创公司的实用成本指南

Spot GPU 可以显著降低灵活型训练任务和批量推理的成本。而对于稳定运行的生产工作负载,在将利用率、故障恢复和服务要求都纳入考量后,预留算力或其他可靠的算力方案可能更经济。任何一种采购模式,都不会仅凭名称就自动成为更好的选择。DigitalOcean 提供了一个明确的 H100 长期承诺价格基准。Azure 在所选区域提供了折扣幅度较大的 H100 NVL Spot 计费方案。Google Cloud 公布的 H100 Spot 折扣则低于其宣传的最高折扣幅度。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 196

不受限于 Copilot,教你在 VS Code 中接入 GPT、Claude

选择自定义接口后,VS Code 会要求填写模型提供商相关信息。Group Name(分组名称):FluxlaneAPI Key:粘贴刚刚在 Fluxlane 控制台创建的 API Key接下来,在 API 类型(API Type)中选择:Chat Completions。这里我们使用 OpenAI 兼容的 Chat Completions 接口。完成后,VS Code 会打开一个名为的配置文件,接下来需要在这个文件中填写具体的模型接口地址和模型 ID。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 612

WorkBuddy 接入自定义模型教程:接入 GPT、Claude 等大模型

在 WorkBuddy 主界面,点击底部输入框附近的模型选择器(默认显示当前模型名)。在弹出的模型列表最底部,点击“配置自定义模型你也可以从左下角头像进入“设置”,在左侧导航中选择“模型”,到达同一个配置页面。进入“模型”设置页后,点击右上角的“+ 添加模型在“提供商”下拉列表中选择最后一项“自定义 / Custom选择自定义后,接口地址、API Key、模型名称三个字段都需要手动填写。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1930

DigitalOcean 提示词缓存正式上线,Agent 上下文最高省 90%

的提示词缓存(Prompt Caching)现已正式可用,开放模型目录中所有受支持的模型均可使用,无需修改现有请求代码。缓存输入 Token 的费用最高可降低 90%,首 Token 延迟最高可降低 80%。Agent 不会每次执行任务都从头开始。每次发起新请求时,它都会在已有上下文的末尾追加上一次工具调用的结果,而这个上下文中早已包含系统提示词、工具定义、读取过的所有文件,以及此前执行的每一步操作及其结果。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 601

DigitalOcean 无服务器推理实测:六款模型的首 Token 延迟表现

你有没有遇到过这种情况:Demo 跑得好好的语音助手,一上生产就被人吐槽"反应太慢";你翻遍模型规格表,每个都说自己"低延迟",但真到用户盯着屏幕等回复的时候,谁快谁慢你心里根本没底。更麻烦的是,这种等待是没法靠猜的。你挑了三四个模型,文档都说自己快,但没人告诉你:在你实际用的提示词长度下,谁真的能一秒内开口?谁在你把文档从 500 字加到 10,000 字之后会突然变慢?谁平时看着正常,却偶尔卡上十几秒让用户以为你的产品挂了?这些恰恰是选型时最该知道的事。但市面上没有一个简单、公开的答案。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 552

AI Agent 运行环境难搭、空闲还收费?MicroVMs 正式公测

AI Agent 使用计算资源的方式,跟传统应用不一样。在一次会话中,它会写代码、跑代码、调用模型,然后等一个工具或一个人,再接着干。所以它需要的是短促、高强度的真实计算爆发。它还需要在刚刚生成的代码周围划一道硬边界,这样某个 Agent 的错误就不会扩散到宿主机或其他客户那里。这种模式并不是 Agent 独有的。传统基础设施满足不了这些需求。一台 7×24 小时开着的服务器,去跑一个每小时只忙几分钟的工作负载,意味着你要为大量空闲计算时间买单。容器启动快、密度高,但它们和邻居共享内核。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 685

Agent Droplets 服务器正式上线:为 AI Agent 提供一站式云基础设施

上周,DigitalOcean 正式开放的公测:提供托管运行时、受权限控制的 16,000 多个工具访问、无服务器推理,以及持久化的内存和存储,全部运行在同一个云平台上。开发者已经启动了数千个 Agent Session。如今,构建一个真正有用的 Agent 已经不再困难,但要把它稳定地运行起来,依然是一件麻烦事。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 414

Claude Sonnet 5.5 现已上线 DigitalOcean AI 推理云

Anthropic 最新发布的现已上线。开发者无需单独管理 Anthropic 账号或模型基础设施,即可通过 DigitalOcean API 调用该模型,而且支持国内直连,无需担心网络障碍。相比上一代 Sonnet 5,这次升级并不是简单地把模型“做得更大”。根据 Anthropic 公布的数据,Sonnet 5.5 的输出速度比 Sonnet 5。虽然每百万 Token 的单价没有变化,但完成同一项任务通常需要更少的 Token,Anthropic 测试中单任务成本最高可降低约。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1676

吞吐量 +38%:DigitalOcean 托管数据库高级版正式上线

随着业务规模不断扩大,数据库也会从一个简单的数据存储层,逐渐成为整个应用架构的核心。多年来,DigitalOcean 已帮助数千家初创企业和成长型公司轻松部署和扩展全托管的和数据库,无需承担复杂的日常运维工作。但随着访问流量快速增长、数据规模持续扩大,以及业务对可用性的要求越来越高,高增长工作负载需要更强大的数据库基础设施来支撑。正因如此,我们正式宣布 DigitalOcean 托管数据库 Advanced Edition(高级版)面向 MySQL 和 PostgreSQL 用户正式上线。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 496

DeepSeek V4.1 Flash 现已上线 DigitalOcean:更强 Agent,更低推理成本

DeepSeek 最新发布的现已上线,开发者可以直接通过调用,无需自己部署和维护 GPU 推理集群。这次的 V4.1 Flash 有点不一样。它并没有继续简单地追求“参数越大越好”,而是采用了 DeepSeek 新一代:模型总参数达到,但处理输入时只激活约,生成输出时激活约。更值得关注的是,在 DeepSeek 自己公布的测试中,这个“Flash”版本在不少 Agent 和 Coding Benchmark 上,反而超过了参数规模更大的。与此同时,它还支持。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1325

DigitalOcean vs OpenRouter:2026 年 AI 模型路由对比

当生产环境中的应用开始依赖多个模型时,模型路由就不再是一个“有更好、没有也行”的功能,而会直接影响推理成本和服务可用性。如今,这已经不是少数应用才会遇到的问题。根据,81% 的受访者预计今年需要依赖两个或更多 LLM 提供方才能保持竞争力,55% 已经至少更换过一次提供方,其中最主要的原因就是降低成本。这种变化也带来了一个单靠应用代码很难解决的基础设施问题:模型路由逻辑究竟应该作为独立的一层,附加在现有技术栈之上,还是直接运行在承载应用的基础设施内部?OpenRouter 给出的答案是“模型市场”。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1139

Kimi K3 + Claude:AI Agent 多模型路由实战

AI Agent 不同任务对模型能力的需求并不相同。本文以 Kimi K3 和 Claude 为例,介绍如何通过模型路由动态选择合适的模型,在兼顾任务质量和性能的同时,减少不必要的推理成本。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1259

Omarchy 将研发基础设施迁移至 DigitalOcean 云平台

无论是用于打包的构建服务器、用于 PR 审查的智能体运行器,还是用于 QA 测试的 Droplet,DigitalOcean 恰好拥有我们需要的一切。简直不能想象更合适的合作伙伴了!Omarchy 的流水线就是这种模式的真实案例,而 DigitalOcean 的基础设施恰好契合其需求。除了基础设施迁移之外,DigitalOcean 还将以创始企业赞助方的身份加入 Omacom 基金会——该非营利组织为 Omarchy 的基础设施及其依赖的开源项目提供资金——并将担任 Omarchy 的智能体计算提供商。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 544

RAG 的 Embedding 模型需要微调吗?什么时候值得自己训练?

什么时候该继续用现成 Embedding API,什么时候值得自己微调?本文从 Recall@10、训练数据、向量维度和长期成本出发,给出判断方法,并介绍如何用 DigitalOcean GPU 与 PostgreSQL托管数据库搭建一套更可控的 RAG 检索架构。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 281

从API到专用GPU:2026年5大适合创业团队的AI推理平台深度对比

2026 年面向初创公司的 AI 推理服务商选型指南,深度对比 DigitalOcean、Groq、Replicate、Fireworks AI、Together AI 五家平台。从冷启动、缩容至零、扩展路径等维度评估,帮你找到从原型到生产的最优解,避免增长期的昂贵迁移。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1068

GPT 6 Astra 已上线 DigitalOcean AI 推理云:AGI 时代的计算机操作模型来了

OpenAI 于 9 月 3 日正式发布的 GPT-6 Astra,现已通过 DigitalOcean正式上线。开发者无需自己部署和维护 GPU 推理集群,即可直接通过 DigitalOcean 调用这款 OpenAI 迄今为止能力最强的旗舰模型。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1069

AMD旗舰GPU仅需4美元每小时,DigitalOcean上线Spot GPU实例

DigitalOcean AMD MI350X / MI355X Spot GPU 降至 $4/小时起。价格锁定、性价比极高,适合训练、批量推理等容错任务。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 605

GLM-5.3-Flash 成本优化实战:加一个参数,推理成本直降 6.3 倍

GLM-5.3-Flash API 到底要花多少钱?本文通过 2700 次真实调用,对比 GLM-5.3-Flash、Qwen3.8-Max 与 Kimi K3 的 Token 消耗和实际成本,并实测 reasoning_effort 如何将推理费用降低 6.3 倍。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 2266

Baseten vs DigitalOcean、RunPod:7 个 AI 模型部署平台横向对比

RunPod、Modal、Replicate 和 Spheron 与 Baseten 的核心产品竞争最直接。它们提供 Dedicated 或 Flexible GPU Infrastructure,用于运行自定义或微调模型,而不是只调用一个预建的 Model Catalog Entry。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 873

GLM 5.3 已上线 DigitalOcean AI 推理云平台:Agent 任务的高性价比底座来了

GLM-5.3-Flash 已上线 DigitalOcean AI 推理云平台:3200 亿参数、每 Token 仅激活 180 亿参数,支持 100 万 Token 上下文与原生图像/视频输入。DigitalOcean 调用价格低至每百万输入 Token 0.15 美元,并支持统一 API、多模型路由与模型评估。Z.ai 最新发布的现已上线,开发者可以直接通过调用,无需自己部署和维护 GPU 推理集群。如果你之前关注过 OpenRouter 和 OpenCode 上那个没有公开身份的。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1027

25 万条数据只花 7.04 美元,LLM 批量推理到底有多省?

25 万次请求被拆分成 7 个批量推理工作,全部完成且 0 失败;99.99% 的返回结果符合 JSON Schema,模型与数据集自带产品标签的一致性达到 83.6%。最大的推理任务每个包含 40,000 次请求,完成时间为 1.4~2.2 小时,远低于 24 小时的 Completion Window。一个包含 25,000 次请求、使用 Claude 模型的批量推理任务只用了 17 分钟。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1566

面向 AI 工作负载,单核性能提升 30%:DigitalOcean v5 Droplets 云服务器正式上线

DigitalOcean 云平台正式推出。这是新一代计算实例,基于第 5 代 AMD EPYC™ 处理器打造。v5 Droplets 云服务器专为高性能工作负载设计,包括计算密集型 Agentic AI 平台、AI/ML 工具、高吞吐量音视频转码,以及高流量的分布式 Web 应用和 API。与上一代 Droplets 云服务器相比,v5 Droplets 云服务器的。同时,这也是 DigitalOcean 首次允许用户分别选择 vCPU、内存和存储容量,并只为实际选择的资源付费。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1015

DigitalOcean 推理路由器新增缓存感知能力:为什么最便宜的模型不一定最省钱

Coinbase CEO Brian Armstrong 最近提出了一个问题,也是所有正在扩大 AI 使用规模的企业都在面对的问题:当 Token 用量呈指数增长时,怎样才能让 AI 支出保持基本不变?这并不是一个假设场景,而是各行各业的企业正在真实面对的问题:限制用量确实可以帮助控制账单,但也会同时限制真正有价值的工作。更好的办法,是通过更合理的默认模型、更智能的模型选择,以及针对具体工作负载更充分地利用缓存,改善每一次请求的成本结构。现在,DigitalOcean 推理路由器正式加入缓存感知(Cache

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 216

2026 LLM 成本计算指南:Token 价格、推理费用与降本方法

根据 2026 年的调查数据,去年接近四分之三的企业都出现了 AI 成本超出预算的情况。造成这一差距的一个重要原因,就是很多团队在工作负载进入生产环境之前,没有先做好准确的 LLM 成本测算。从价格表上看,Token 定价似乎很简单,无非就是每百万 Token 几美元,但真正的成本取决于工作负载上线后到底怎么运行。真实用户的提问和模型回答,长度往往和测试阶段的几个 Sample Prompt 不一样,可能更长,也可能更短。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 1438

Qwen3.8-2.4T-A95B 部署与性能解析:DigitalOcean 无服务器推理实测

Qwen3.8-2.4T-A95B 是阿里云在 2026 年 8 月发布的旗舰级开源大语言模型。它是从 Qwen3.8-Max 旗舰模型衍生而来的开放权重纯文本版本,采用混合专家架构,总参数量 2.4 万亿,每个 Token 大约激活 950 亿参数,主要面向编程、工具调用和长周期 Agent 任务。在 DigitalOcean 上,它以纯文本输入、纯文本输出的形式提供。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 874

多模型路由怎么选?2026 年 4 款主流方案对比

多模型路由位于应用和语言模型之间,负责决定每一个进入系统的请求应该交给哪个模型处理。在构建LLM 应用时,通常不存在一个模型能够在成本、延迟、推理、编程、视觉和 Tool Calling 等所有维度同时做到最好。如果应用直接调用一个固定模型,那么无论请求简单还是复杂,都只能使用同一种模型能力和价格。应用 → 多模型路由层 → 选择模型 → 执行请求 → 返回统一响应路由层先分析 Prompt 或匹配预设规则,再从候选模型中挑选更适合当前任务的模型,把请求发送出去,并以一致格式返回结果。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 869

Qwen 3.8 已上线 DigitalOcean AI 推理云平台

阿里通义千问新一代旗舰模型现已上线,并可通过直接调用。根据官方所说,这次上线的并不是一款“小修小补”的 Qwen 模型。Qwen3.8-2.4T-A95B 采用,每次推理激活约 950 亿参数,重点面向长上下文、AI 编程以及 Agent 智能体等复杂工作负载。尤其值得注意的是,它最高支持,在代码、工具调用和智能体任务上的表现已经进入当前前沿大模型梯队,而 DigitalOcean 上的调用价格为。单看价格,Qwen 3.8 未必是市场上最便宜的选择。

了解关于云主机、GPU、AI、数据库托管、Kubernetes等相关技术知识,以及DigitalOcean云平台使用教程 225
上一篇: H100、L4、A6000 等 9 款 GPU 横评,告诉你哪些适合模型训练,哪些适合AI 推理
下一篇: 1 亿安装量的开源项目 Ghost 背后,如何持续增长?
卓普云
卓普云 卓普云 卓普云
博客等级 码龄3年 3137粉丝 307原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值