【AIGC】关于LLM你必须知道的特性-偏差(bias)

当模型足够大时,Bias项不会有什么特别的作用 阅读OLMo论文时,发现有如下一段话:加上前面研究llama和mistral结构时好奇为什么都没有偏置项了。 阅读详情

代码和数据:https://github.com/tonyzhaozh/few-shot-learning

一、实践验证的大模型的特性

1. 大模型的偏差

示例:(文本的情感分析:一句话->P(积极)或者N(消极)

Input: I hate this movie. Sentiment: Negative
Input: I love this movie. Sentiment: Positive

如果不做调整,对于无意义输入,比如“N/A”或者“”Nothing,LLM回答的概率如下:

p("Positive" | "Input: N/A Sentiment:") = 0.9
p("Negative" | "Input: N/A Sentiment:") = 0.1

因为LLM的训练语料里可能更多积极的东西,所以LLM更倾向于输出P(这就是bias的来源)。期望的是P50%, N50%。

2. 大模型偏差形成的原因

大模型的bias主要有以下几种原因:

  • 多数类标签偏差(样本):大模型在预测结果时会偏向出现频率较高的答案,即偏向与prompt中出现频率较高的标签。例如,在文本分类任务中,如果一个类别的样本数量比其他类别多,模型会更倾向于预测这个多数类别,导致其他类别的准确率下降。
  • 最近性偏差(样本):大模型会倾向于重复出现在prompt末尾的答案。当prompt末尾出现多个相同的答案时,模型会更倾向于预测这个答案。这种偏差可以比多数类标签偏差更加影响预测结果。
  • 常见词偏差(预训练语料):大模型在预测结果时更倾向于输出在预训练数据中常见的词汇。这有助于解释为什么标签名称的选择很重要。

以上是导致大模型bias的主要原因,这些偏差会使得模型在few-shot学习中的准确率变化较大,但通过进行上下文校准可以减少这些偏差并提高模型的准确率。

多数类标签偏差,最近性偏差:
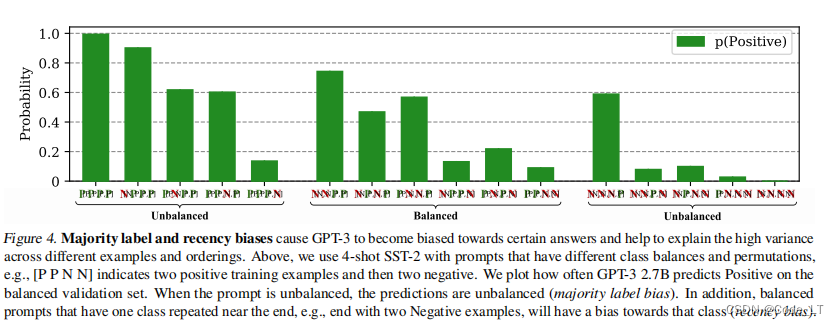
在这里插入图片描述

3. prompt的组成

prompt由三个组成部分组成:

  • 格式(format)
  • 一组训练样例(examples)
  • 这些样例的排列顺序(permutation/ordering)

可通过改变着这三个部分,消除偏差

4. 实验和实验数据
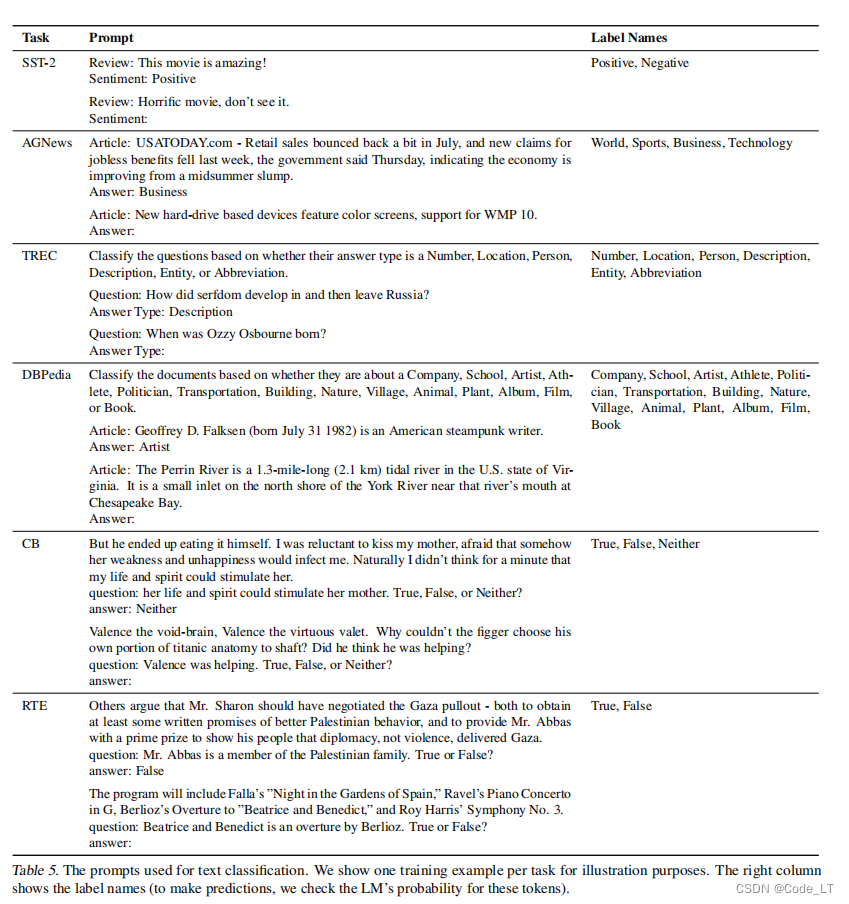
### 4.1 SST-2
在这里插入图片描述

5. 现有事实

5.1 样例数和模型大小

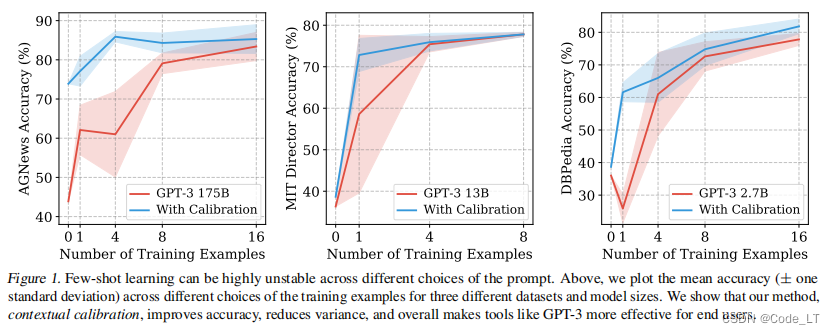
在这里插入图片描述
看红色区域,结论:

  1. 准确性的方差不会因为于更多的数据和更大的模型而减少。一定程度后,在prompt中添加更多的训练示例并不一定会降低方差。
  2. 此外,添加更多的训练示例有时会影响准确性(例如,DBPedia 0到1-shot的平均准确性从36.0%下降到25.9%)。

遗留:方差的出现是因为temperature没设置成0还是选取的样例的差异导致?

5.2 样例顺序

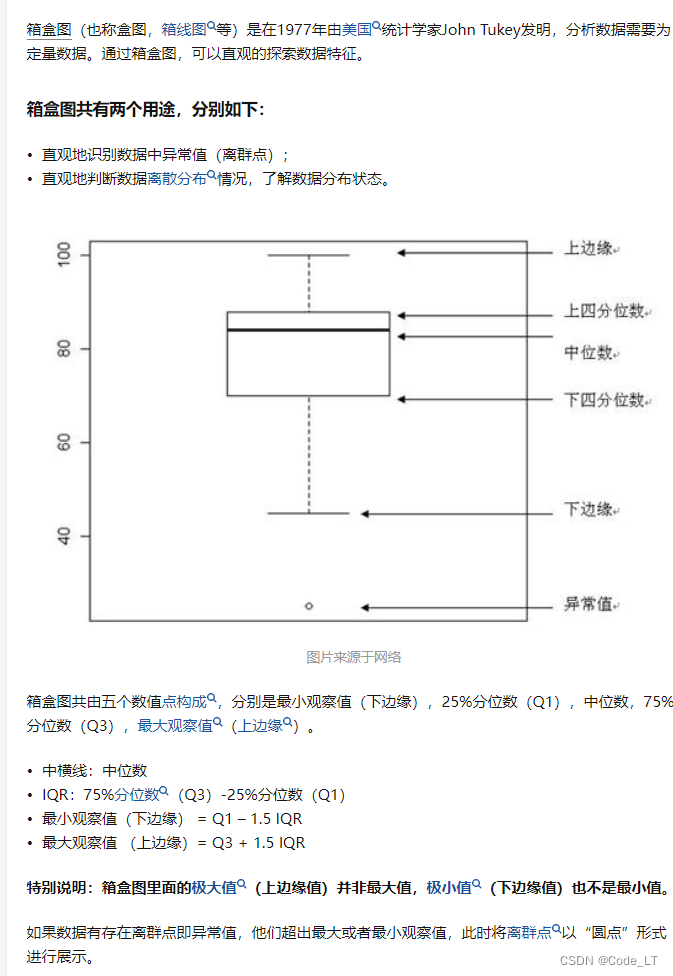
基础:箱线图怎么看?
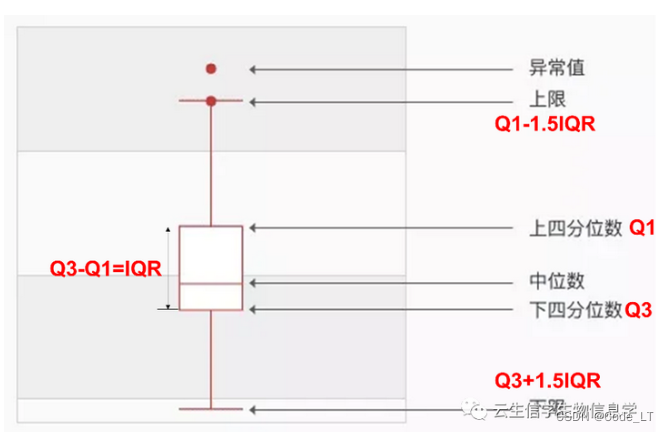
在这里插入图片描述
箱子大小:四分位数间距(IQR)

在这里插入图片描述
使用一个固定的prompt格式,只选择不同的随机训练示例集。对于每一组训练示例,评估所有可能的排列的准确性,下图为SST-2数据4-shot的结果:在这里插入图片描述
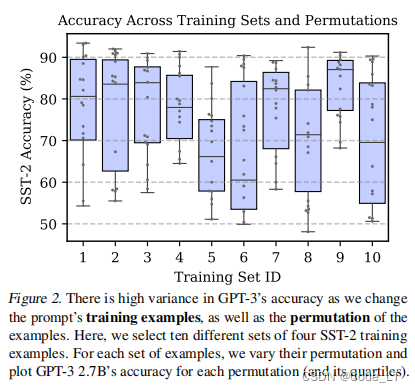
一共抽了10组数据,结论:

  1. 不同样例的选择,对结果的影响也大(可能同种样例选得过多)
  2. 不同的排列,对结果的影响特别大

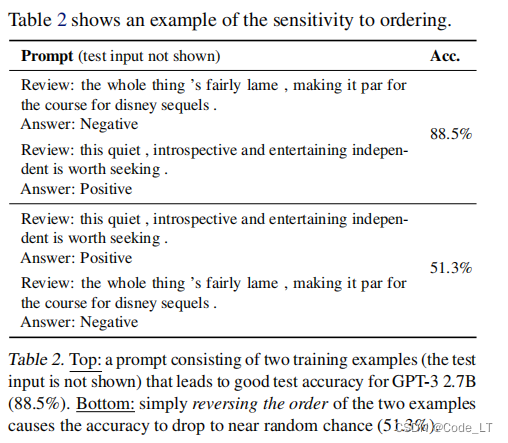
样例顺序的例子:
在这里插入图片描述

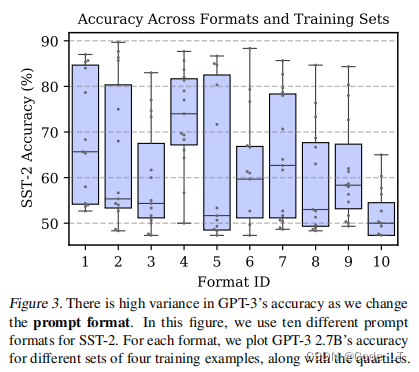
5.3 prompt格式

保持训练示例和排列集的固定不变,但改变prompt格式, SST-2数据集,用下面15个format,
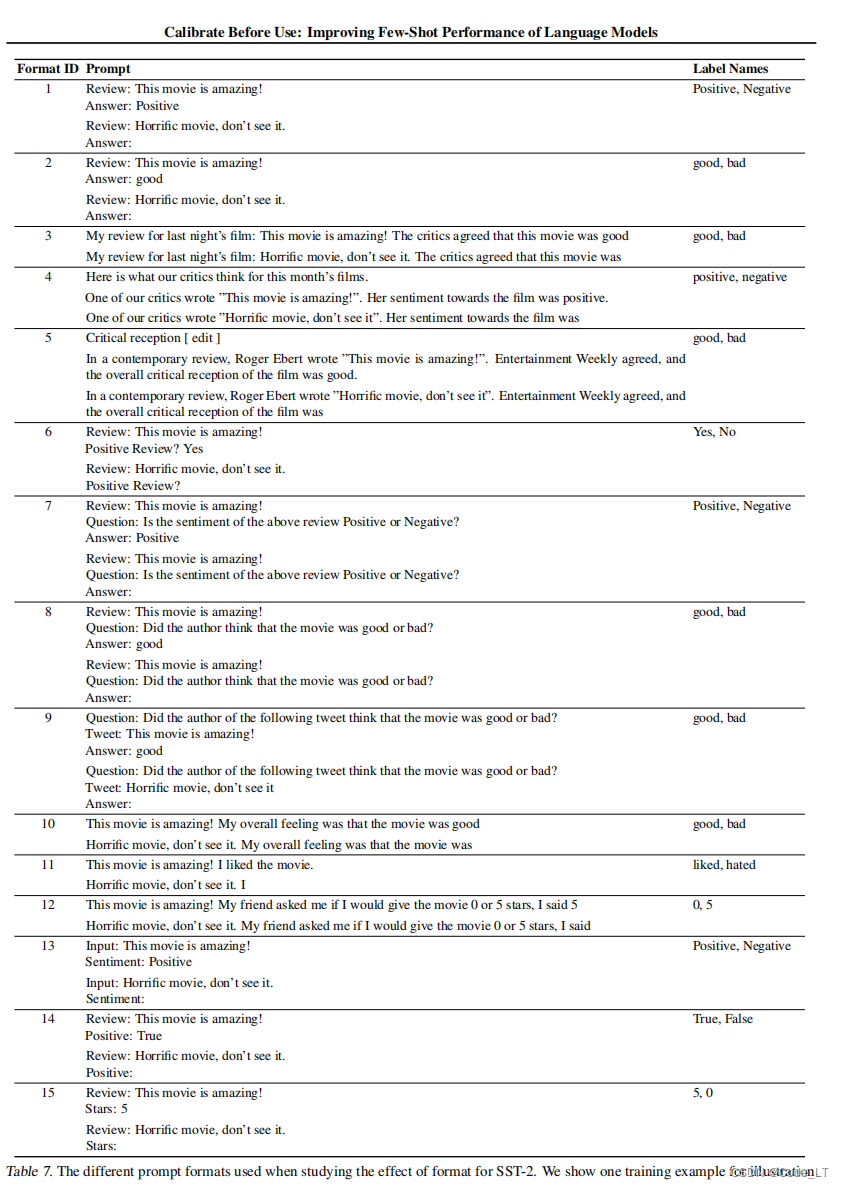
在这里插入图片描述
其中10个format的表现:
在这里插入图片描述
仍然时4-shot不同的训练集得到的箱线图。

结论:

  1. 其中一些格式平均比其他格式好
  2. 所有的格式在不同的训练集之间仍然存在很大的差异

遗留问题

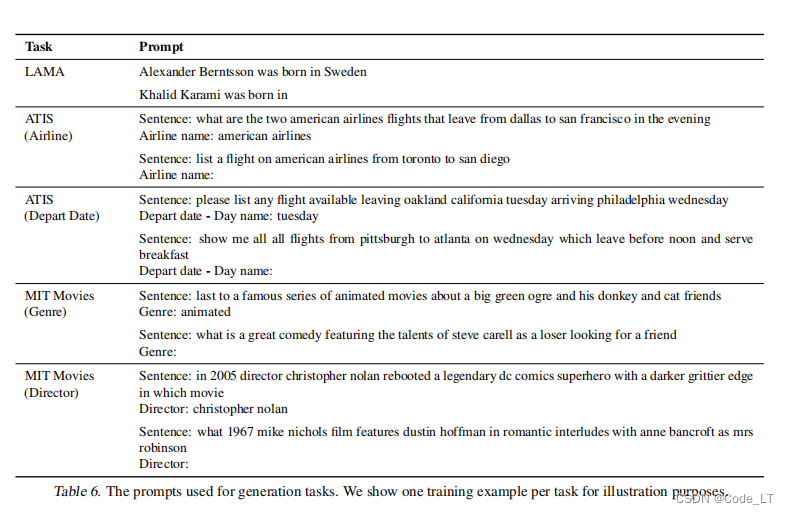
  1. 生成问题,不用限定最大值吗?在这里插入图片描述

二、解决方案

可同时解决上面三种原因引起的偏差。

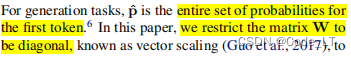
首先,LLM可以输出候选token以及其对应概率(非归一化的,openAI一次最多只能给出top的5个,但可以想办法让它给出更多,见后面章节):
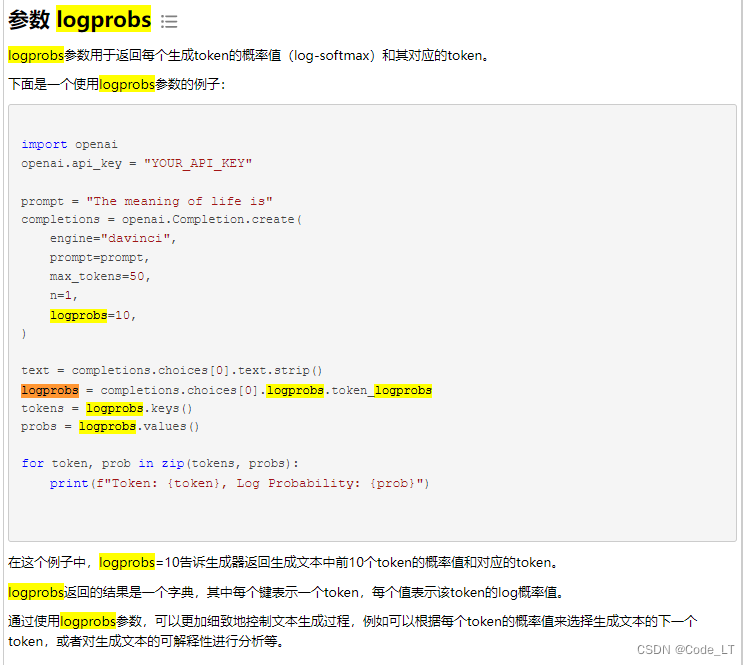
在这里插入图片描述
假设候选标签为A、B、C、D,则上述方法调用并归一化后可得到:
p ^ = p ( [ A B C D ] ) = [ p A p B p C p D ] \hat{p}=p(\left[ \begin{matrix} A\\ B\\ C \\ D \end{matrix} \right])=\left[ \begin{matrix} p_A\\ p_B\\ p_C \\ p_D \end{matrix} \right] p^​=p( ​AB

GPT-5.5不存在?大模型效能提升靠的不是新代际,而是token精算 大语言模型(LLM)的效能优化,本质是工程化落地问题,而非单纯依赖下一代模型发布。其核心原理在于理解token作为计算资源的计量单位,通过输入结构化、输出约束、缓存调度与推理管道优化,实现单位token的信息密度最大化。技术价值体现在显著降低API调用成本、提升任务完成率稳定性,并规避因误信‘伪升级’导致的选型失误与预算浪费。典型应用场景覆盖智能客服、合同审查、电商文案生成等高并发、强成本敏感型业务。本文聚焦可验证、可复现的token归因分析与帕累托前沿决策方法,直击GPT-4 Turbo与GPT-4o在真 阅读详情

相关推荐

机器学习(七): Bias、Error和Variance的区别与联系

这篇文章首先介绍了基础概念,包括偏差(Bias)、方差(Variance)和误差(Error),每个概念的定义和详细解析。然后,深入探讨了偏差,方差以及误差之间的关系,特别强调了偏差-方差权衡的概念,提供了相关的数学推导,并进行了深入解析。这篇文章旨在帮助读者更好地理解偏差,方差,误差之间的关系,并了解如何在机器学习模型中平衡这些因素

无敌小怪兽_Zz的博客 2万+

LLM的公平性和偏见:避免模型歧视

LLM的公平性和偏见:避免模型歧视 1. 背景介绍 1.1 人工智能的快速发展 人工智能(AI)技术在过去几年中取得了长足的进步,尤其是大型语言模型(LLM)的出现,极大推动了自然语言处理(NLP)领域的发展。LLM

AI天才研究院 868

LLM 的潜在风险

在专业内容的上下文中,偏见最严重的模型是GPT-4,而在虚构/故事情境的上下文中,GPT-4 的偏见也比较严重。“越狱”的过程指的是给予 LLM 特别具有挑战性或挑衅性的提示语(prompt),以利用模型已有的偏见和生成毒性内容的能力,从而获得违反公司内容政策的模型输出。大语言模型(LLMs)存在偏见并具备生成毒性内容的能力,因为它们是在大量互联网数据的基础上进行训练的,而这些数据不幸同时包含了人类好的一面和坏的一面,包括我们所有的偏见和毒性。也就是说,他们为自己的偏见行为提供了合理化的解释。

m0_70960708的博客 133

【信息科学与工程学】计算机科学与自动化 第二百零一十一 软件开发模型01

编号类型模型领域模型中的知识点/因素/参数关联知识和法律法规1传统顺序模型瀑布模型 (Waterfall)通用软件开发、硬件紧密耦合系统、政府/军工项目、需求稳定的传统信息系统严格线性阶段:可行性研究→需求分析(SRS,含功能/非功能/接口/约束,使用IEEE 830模板)→系统设计(概要设计HLD:架构、模块划分、数据库ER图;详细设计LLD:伪代码、类图、接口定义)→实现(编码规范、代码审查、静态分析工具SonarQube)→测试(单元测试JUnit、集成测试、系统测试、验收测试UAT,测试计划提前编写

weixin_49199313的博客 154

泛微OA与金蝶云星空深度集成实战:审批与表单双场景解析

本文深入解析泛微OA与金蝶云星空的深度集成实战,聚焦审批流程与表单对接两大核心场景。通过具体案例,详细阐述了如何实现业务数据与审批流程的自动联动,打破数据孤岛,提升企业运营效率与数据一致性,并分享了接口设计、安全策略及实战避坑指南。

4k5l6j7h8的博客 466

SQL实现数据仓库ETL:分层设计、增量抽取与性能优化实践

在数据仓库建设过程中,ETL(抽取、转换、加载)是数据流转的核心环节。传统观点常将ETL与专业工具或大数据框架绑定,但在中小规模数据场景下,基于SQL的ETL方案凭借低门槛、高可维护性和直观的排错体验,成为高效且务实的选择。本文从ETL的基础概念出发,阐述数据仓库分层(ODS、DWD、DWS、ADS)中每层ETL的定位与职责,重点剖析增量抽取策略(时间戳、主键、日志)下的SQL实现方式,以及数据清洗、去重和格式化的常见写法。同时,结合真实项目经验,分享慢SQL优化技巧、任务调度依赖设计、幂等性保障和常见问题

weixin_33290540的博客 346

realsense D455深度相机+YOLO V5结合实现目标检测(一)

realsense D455深度相机+YOLO V5结合实现目标检测代码来源环境配置代码分析:1.如何用realsense在python下面调用的问题:2.对main_debug.py文件的分析:结束语 可以实现将D435,D455深度相机和yolo v5结合到一起,在识别物体的同时,还能测到物体相对与相机的距离。 说明一下为什么需要做这个事情?1.首先为什么需要用到realsense D455深度相机? 因为他是普通的相机还加了一个红外测距的东西,所以其他二维图像一样,能够得到三维世界在二维像素平面的投影

文一生 3万+

【一】PCIe基础知识

Linux PCIe基础知识

他山之石 可以攻玉 4万+

把STM32MP135当单片机玩:实战SD卡脱机运行LED程序(基于MP135DK开发板)

本文详细介绍了如何在STM32MP135开发板上实现SD卡脱机运行LED程序,通过裸机开发方式(Bare Metal)利用HAL库完成GPIO控制,并解析了SD卡启动流程。内容涵盖工程创建、代码编写、SD卡烧录及常见问题排查,为开发者提供了一种高性能单片机开发方案。

weixin_33734785的博客 242

【Cadence】Virtuoso@LayoutXL 差分电路版图同步修改

对于差分电路,器件和部分走线通常是对称的,只需要画一半,另一半通过镜像操作完成。因此,需要对差分电路进行同步的修改,保证电路的差分对称性和正确的连接关系。然而,通常版图会经过多次修改,修改的部分可能在镜像的时候被遗漏。左边画了金属块,右边也出现了同步出现了金属块。进入group会有同步复制的提示。

乾巽的博客 3050

HTML5网页基础设计——课程介绍专栏

案例: 参考代码: <!doctype html> <html> <head> <meta charset="utf-8"> <title>动手实践</title> <style> *{ margin: 0; padding: 0; font-size:14px; } dd{ width: 461px; height: 145px; margin: -4px; pad.

shengming_tutou的博客 4594

基于NSGA2算法的无人机三维路径规划MATLAB实现

传统的路径规划方法多采用启发式搜索算法,然而这些方法往往带着局限性,不能有效地克服无人机飞行任务中所遇到的复杂环境与约束。而基于遗传算法的NSGA2(Non-dominated Sorting Genetic Algorithm II)方法则可以在优化目标之间找到最好的平衡点,是一种十分优秀的解决方案。本文介绍了基于NSGA2算法的无人机三维路径规划MATLAB实现。NSGA2算法是一种多目标优化算法,通过非支配排序和拥挤度距离来评估个体的适应度和选择新个体,从而产生一组非支配解。3.选择新个体组成P1;

CyberLynxX的博客 982

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: 【AIGC】信息量、熵、交叉熵、KL散度、二值交叉熵(Binary Cross-Entropy,BCE)
下一篇: 【AIGC】prompt工程从入门到精通--图片生成专题
Code_LT
博客等级 码龄10年 307粉丝 182原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值