CodeFuse-VLM 开源,支持多模态多任务预训练/微调

训练VLM(视觉语言模型)的经验 知乎:lym链接:https://zhuanlan.zhihu.com/p/890327005基于prompt确实不行(情况包括格式输出不稳定、格式输出基本不对、任务不完全会、任务完全不会等情况,难度逐渐加大),选择上SFT微调。业务场景基本用不到强化学习,强化解决的是最后一公里的问题,可以理解为有两种非常接近的输出(这两种输出都非常接近目标输出,此时已经解决了90%的问题),强化学习会对相同的输入,打压其中一种不希望的输出,同时增强另一种更接近目标的希望的输出(从DPO loss就可以看出)。 阅读详情

hgfkjgl.png


CodeFuse-MFT-VLM 项目地址:
https://github.com/codefuse-ai/CodeFuse-MFT-VLM

CodeFuse-VLM-14B 模型地址:
CodeFuse-VLM-14B
 

CodeFuse-VLM框架简介

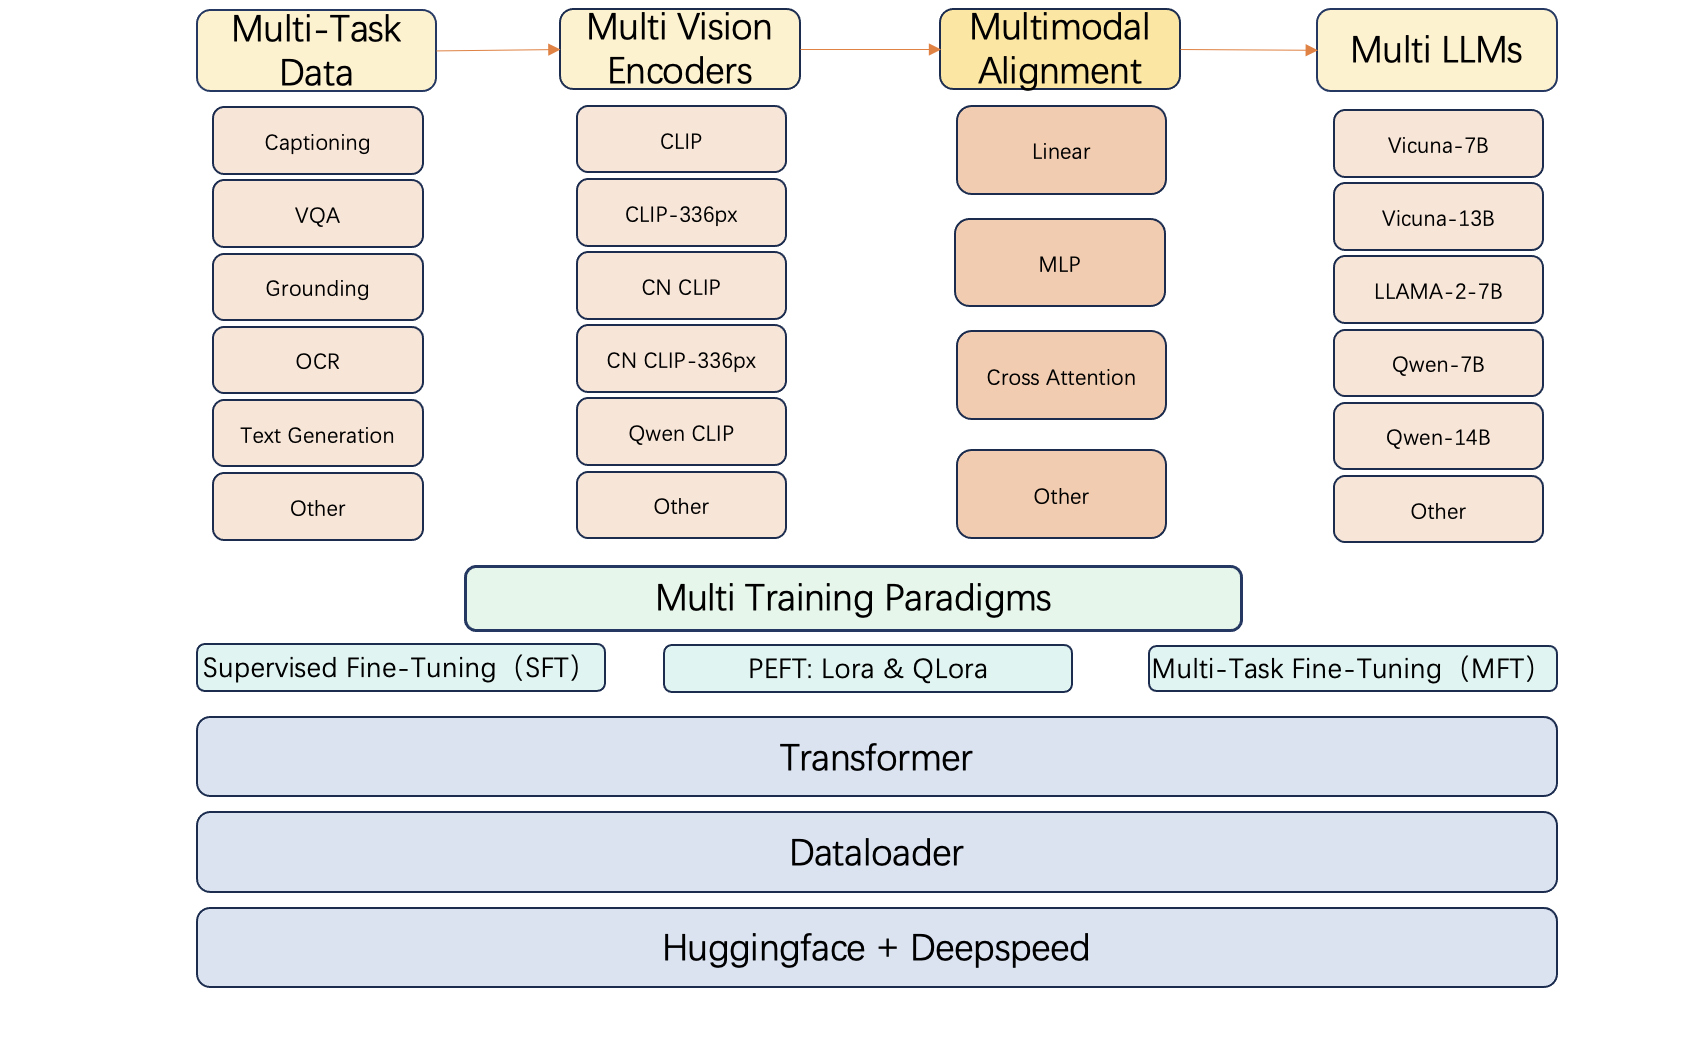
随着huggingface开源社区的不断更新,会有更多的vision encoder 和 LLM 底座发布,这些vision encoder 和 LLM底座都有各自的强项,例如 code-llama 适合生成代码类任务,但是不适合生成中文类的任务,因此用户常常需要根据vision encoder和LLM的特长来搭建自己的多模态大语言模型。针对多模态大语言模型种类繁多的落地场景,我们搭建了CodeFuse-VLM 框架,支持多种视觉模型和语言大模型,使得MFT-VLM可以适应不同种类的任务。


CodeFuse-VLM 支持多种视觉达模型:CLIP,CLIP-336px,Chinese Clip,Chinese Clip-336px,Qwen Clip;多种语言达模型:Vicuna-7B,Vicunam-13B,LLAMA-2-7B,Qwen-7B,Qwen-14B。用户可以根据自己的需求,通过配置文件的方式搭配VL-MFTCoder中不同的Vision Encoder 和 LLM,使用同一套框架去适配的不同的模型,大大提高了开发效率
CodeFuse-VLM-arch.png


我们在2024年1月开源了多模态多任务微调框架——CodeFuse-VLM。在CodeFuse多任务微调的基础上,CodeFuse-VLM可以实现在多个模态,多个任务上同时并行地进行微调。通过结合多种损失函数,我们有效地解决了多任务学习中常见的任务间数据量不平衡、难易不一和收敛速度不一致等挑战。此外,CodeFuse-VLM框架具备高效训练特征,支持高效的PEFT微调,能有效提升微调训练速度并降低对资源的需求。 

https://cloud.video.taobao.com/play/u/23956347/p/1/d/ld/e/6/t/1/446458089308.mp4?auth_key=YXBwX2tleT04MDAwMDAwMTMmYXV0aF9pbmZvPXsidGltZXN0YW1wRW5jcnlwdGVkIjoiZDcxNGY0MjE3MDZmY2ZiYWY4ZWEyY2ExMGQyZGUxMDMifSZkdXJhdGlvbj0mdGltZXN0YW1wPTE3MDcxMjE2OTc=icon-default.png?t=N7T8https://cloud.video.taobao.com/play/u/23956347/p/1/d/ld/e/6/t/1/446458089308.mp4?auth_key=YXBwX2tleT04MDAwMDAwMTMmYXV0aF9pbmZvPXsidGltZXN0YW1wRW5jcnlwdGVkIjoiZDcxNGY0MjE3MDZmY2ZiYWY4ZWEyY2ExMGQyZGUxMDMifSZkdXJhdGlvbj0mdGltZXN0YW1wPTE3MDcxMjE2OTc=


CodeFuse-VLM-14B模型

我们基于Qwen-VL的视觉编码器和Qwen-14B 大语言模型,在CodeFuse-VLM框架下训练了CodeFuse-VLM-14B 模型,在多个通用和代码任务上的性能超过 LLAVA-1.5 和 Qwen-VL。
 

预训练数据

参考了Qwen-VL的Multi-Task Pretraining数据集,我们准备使用多种数据对齐Qwen-VL-14B的模态。在预训练当中我们使用多任务训练的方式,每一个数据集都是一个训练任务任务。

dataset

type

number of samples

synthdog-en

OCR

50w

synthdog-zh

OCR

50w

cc3m(downsampled)

Image Caption

55w

SBU

Image Caption

85w

Visual Genome VQA

VQA

50w

Visual Genome Region descriptions

Ref Grouding

50w

Visual Genome objects

Caption With Grouding

50w

OCR_VQA

OCR and VQA

50w

我们使用预训练数据集训练模态对齐的cross attention 模块,可以执行以下代码来启动模型预训练

sh scripts/pretrain_multinode.sh

指令微调数据

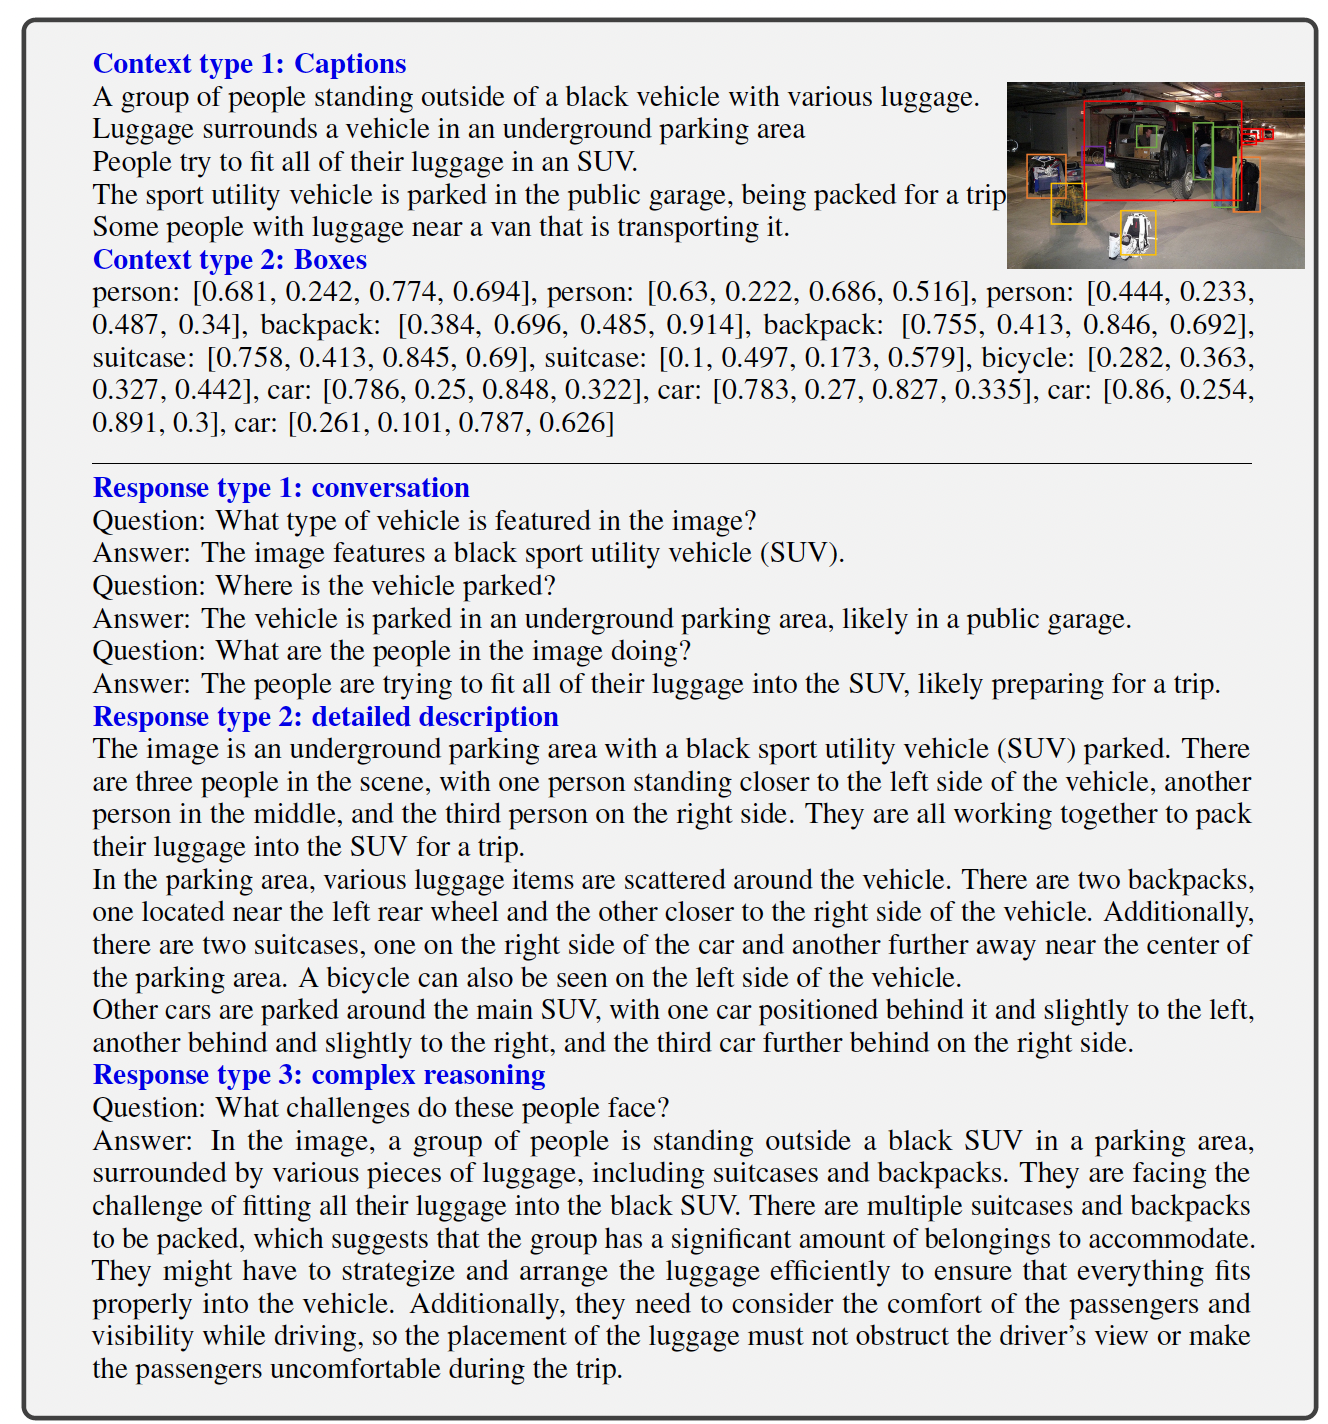
我们使用了 LLAVA-1.5 的指令微调数据,总共65w样本,LLAVA的指令微调数据集包含复杂图片的推理分析,对LLM理解视觉特征很有帮助。
截屏2023-12-03 下午5.21.11.png


指令微调数据构成如下,在视觉指令微调当中我们使用多任务训练的方式,每一个数据集都是一个训练任务任务。

dataset

type

number of samples

OCR_VQA

OCR and VQA

7w

GQA

Image Caption

8w

Visual Genome

Ref Grouding and Caption With Grouding

10w

COCO

Detailed Description and Complex Reasoning

37w

Text-VQA

Detailed Description and Complex Reasoning

3w

我们使用指令微调数据训练CodeFuse-VLM-14B中的Qwen-14B大语言模型,可以执行以下代码来启动模型的指令微调

sh scripts/finetune_multinode.sh

模型性能

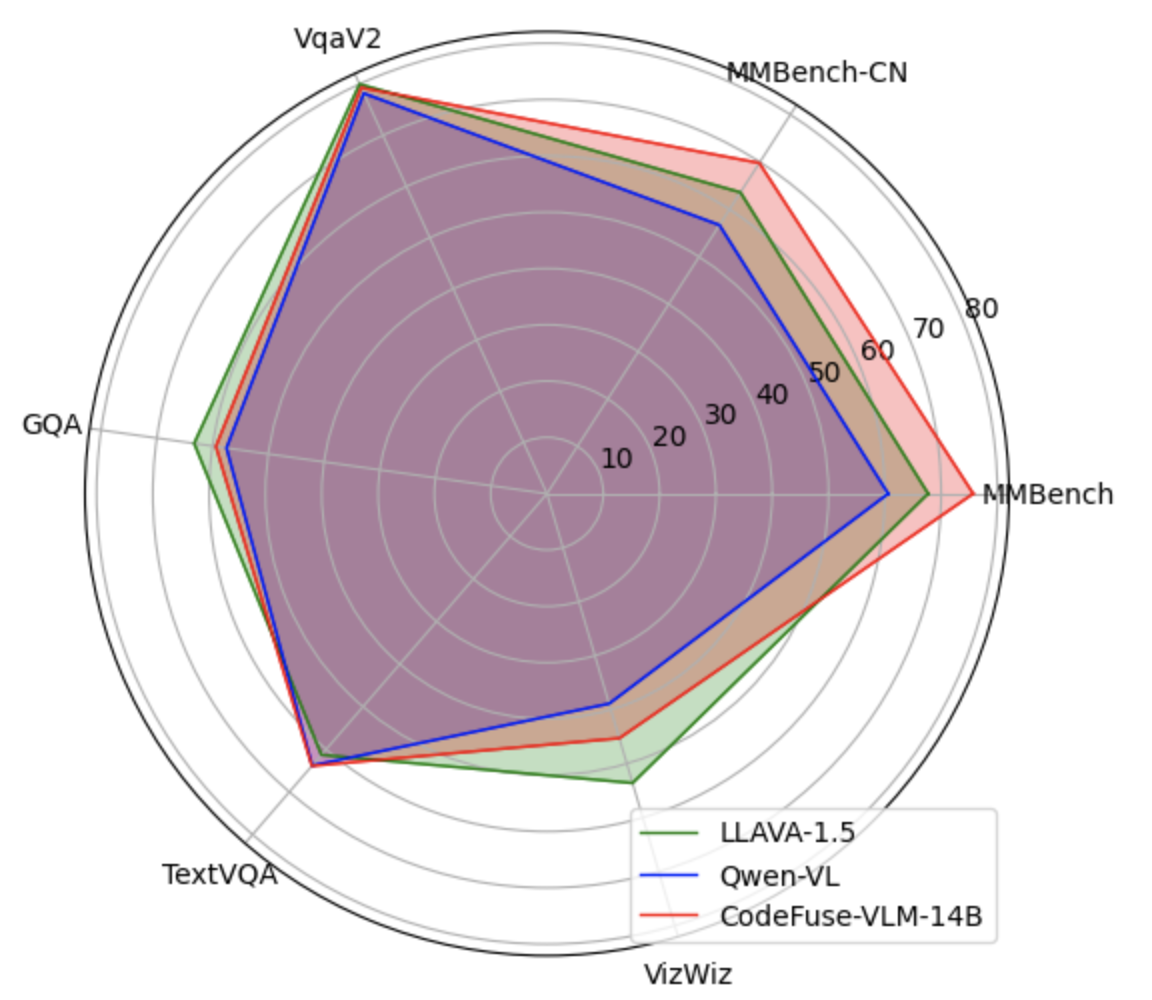
我们训练的CodeFuse-VLM-14B 模型在多个benchmark上的表现超过Qwen-VL和LLAVA-1.5, 具体得分参考下面的图表。
CodeFuse-VLM-14B-radar-chart.png

Benchmark

LLAVA-1.5

Qwen-VL

CodeFuse-VLM-14B

MM_Bench

67.7

60.6

75.7

MM_Bench_CN

63.6

56.7

69.8

VqaV2

80.0

78.2

79.3

GQA

63.3

57.5

59.4

TextVqa

61.3

63.8

63.9

VizWiz

53.6

35.25

45.3

Sketch2Code

-

90.7

94.4

我们的CodeFuse-VLM-14B 在MMBenchmark的中英文榜单分别取得第13/21名的排名,高于Qwen-VL第29/36名的排名
MMBench
 

产品图片

我们通过CodeFuse-VLM 在蚂蚁内部训练了网页图片到前端代码的多模态大模型,并把大模型集成到内部的Visual Studio Code插件中。如下面两站图所示,左边的图片是网页原图,右边的图片是大模型生成的前端代码渲染出的图片,多模态大模型生成的前端代码渲染出的图片对网页原图有很高的还原性,很大地提高了前端工程师开发的效率。
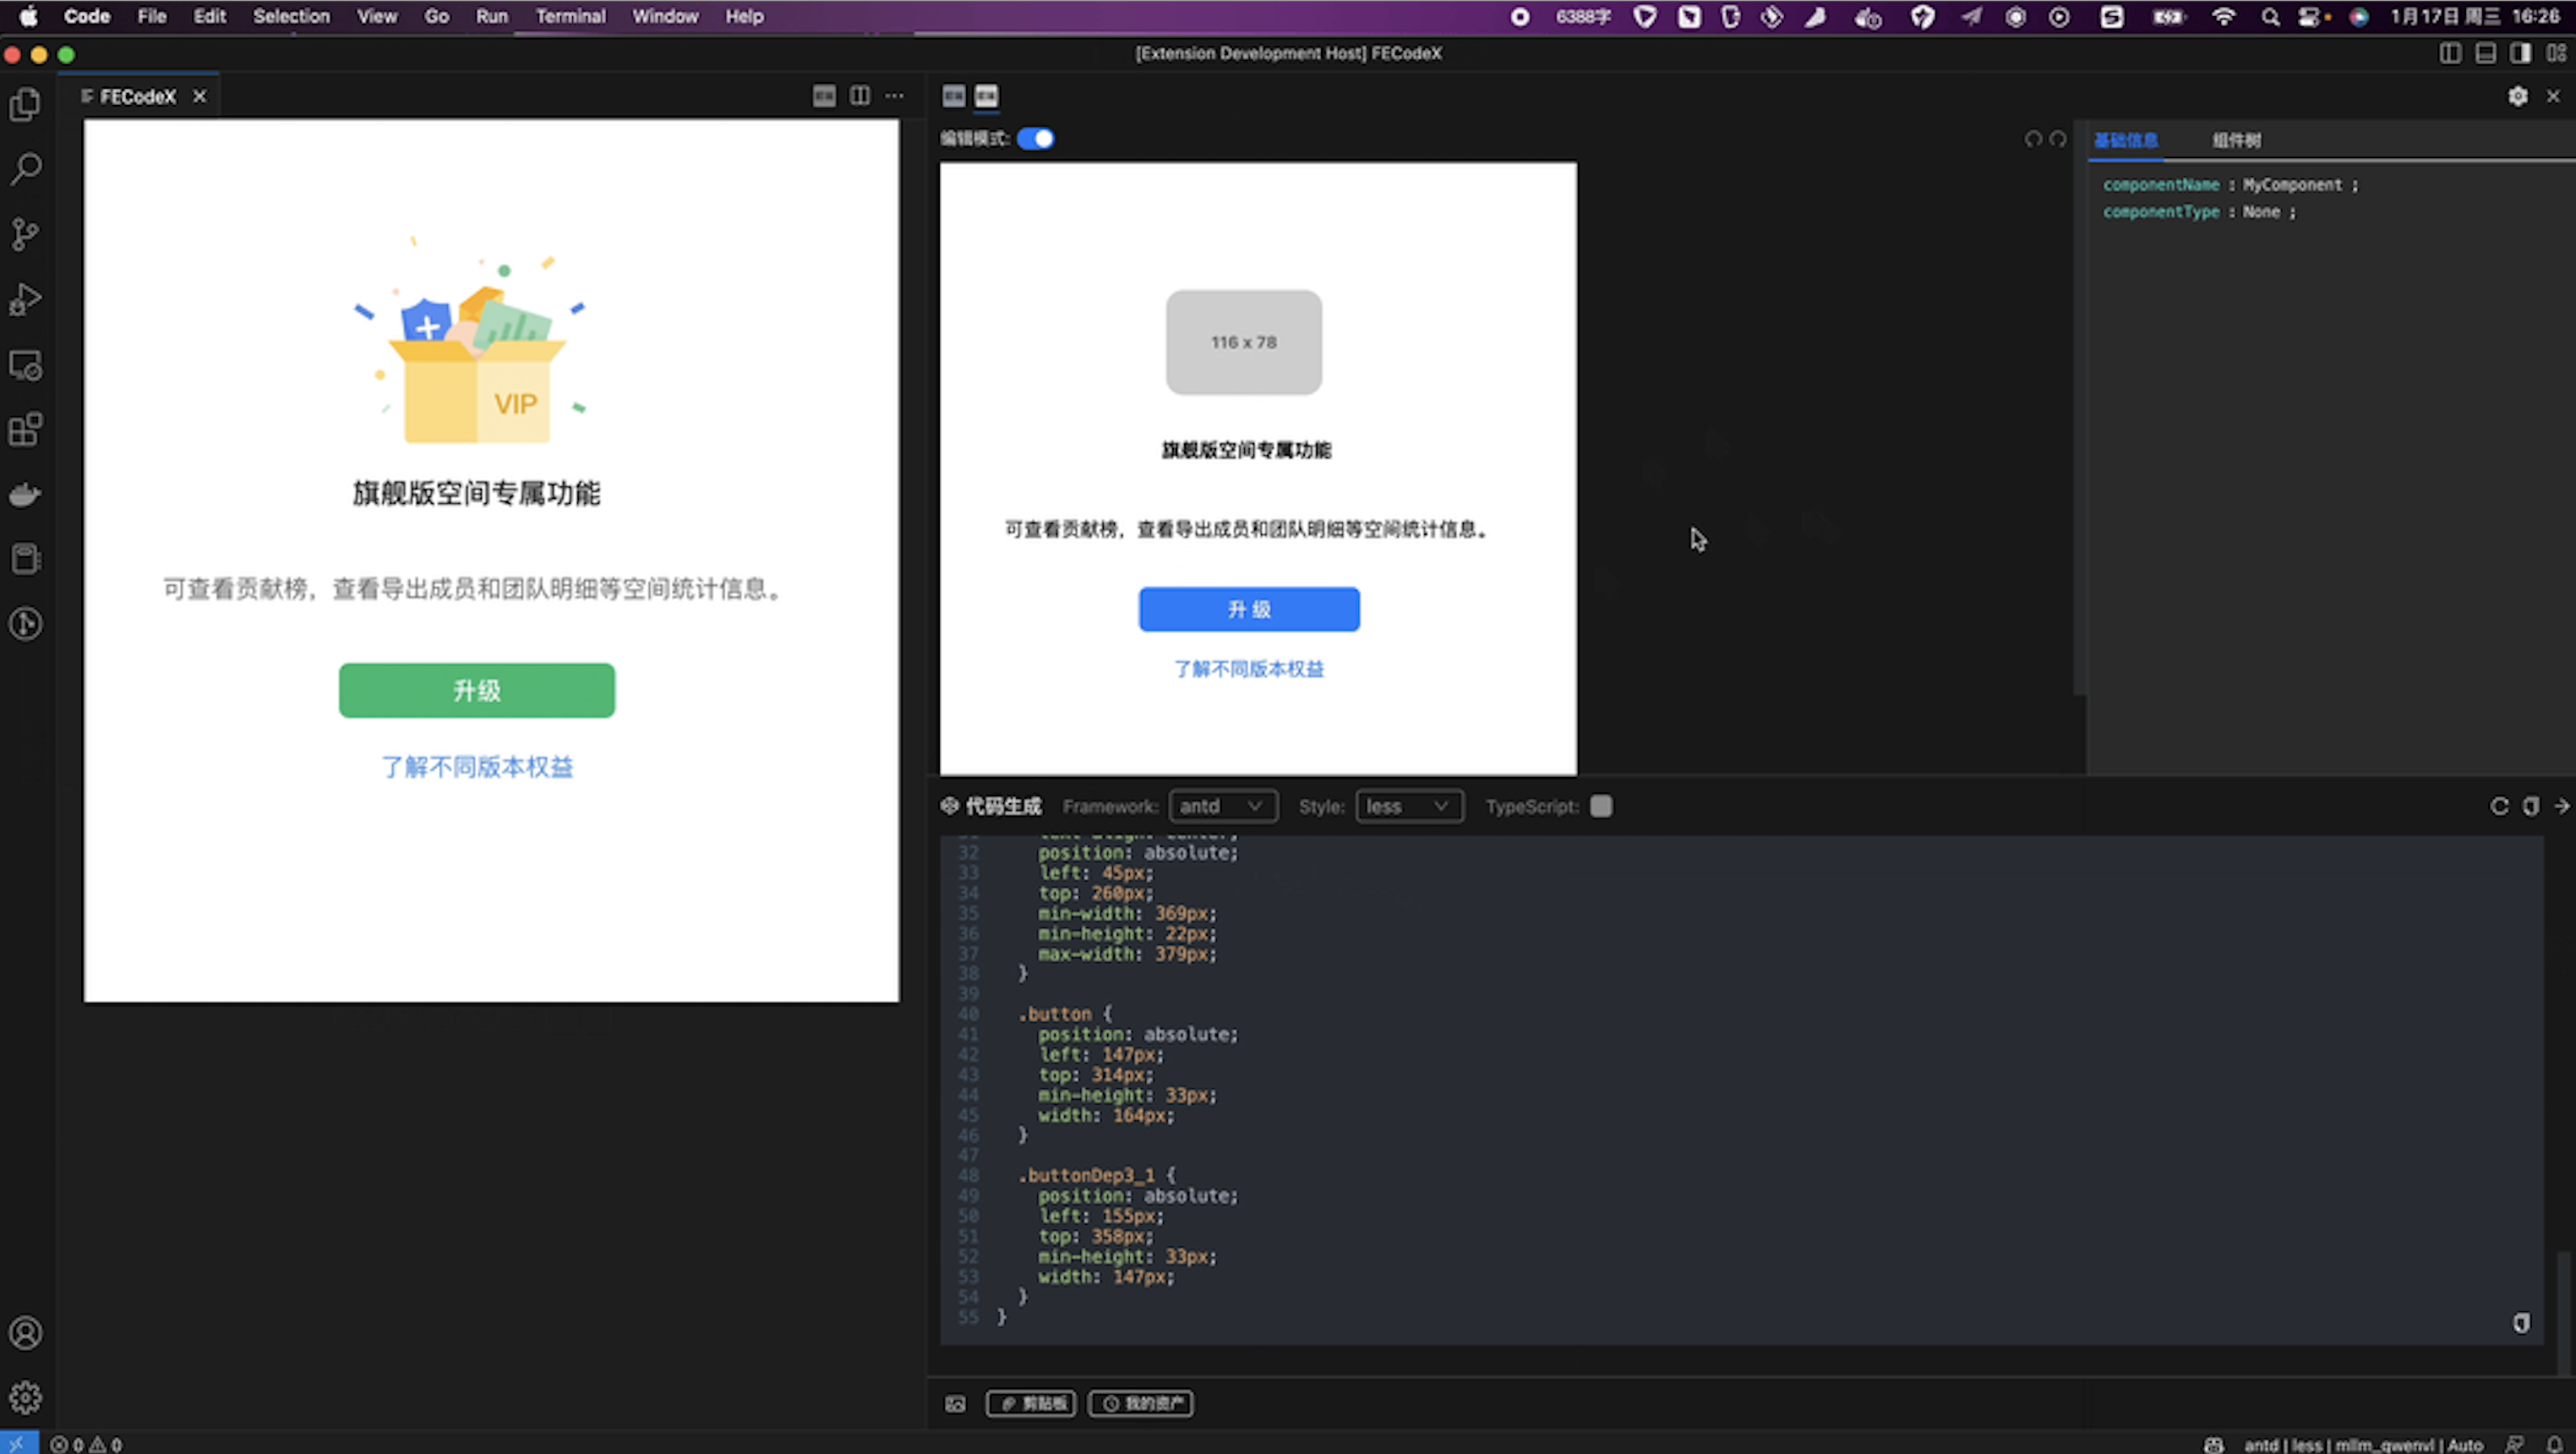
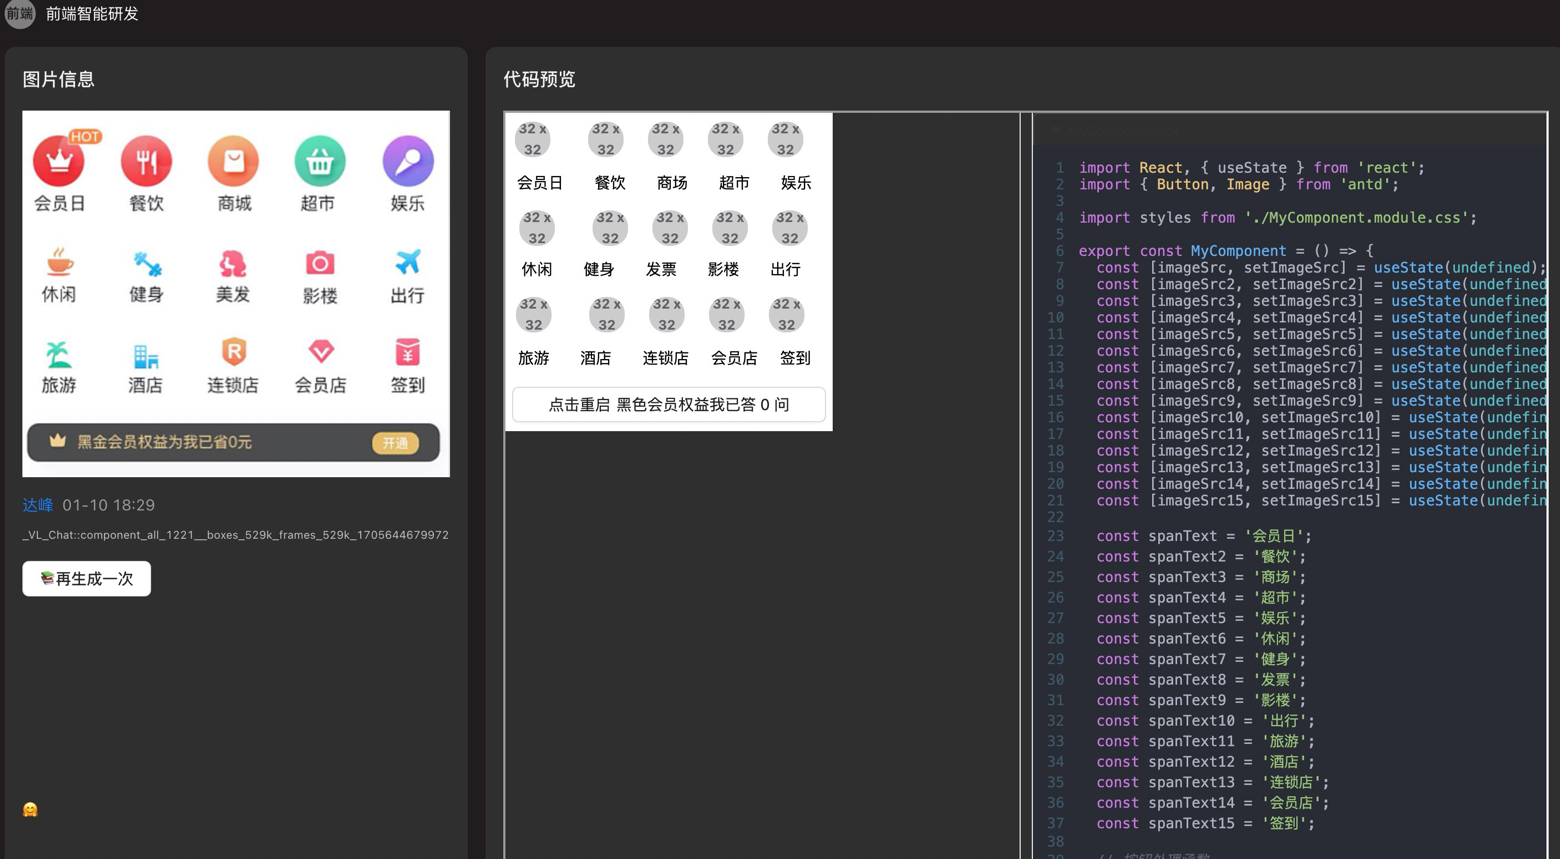
公众号产品图片.png

公众号产品图片2.png

IntelliJ IDEA 插件新选择:手把手教你安装配置蚂蚁CodeFuse AI编程助手(附与Copilot对比) 本文详细介绍了如何在IntelliJ IDEA中安装配置蚂蚁CodeFuse AI编程助手,并与GitHub Copilot进行多维度对比。CodeFuse作为蚂蚁集团推出的AI编程工具,提供代码补全、Chat功能、代码解释等核心功能,特别优化了中文支持,适合国内开发者提升编码效率。文章包含从申请内测到实际应用的完整指南,帮助开发者快速上手。 阅读详情

相关推荐

蚂蚁CodeFuse代码大模型技术解析:基于全仓库上下文的代码补全

背景 2023年CodeFuse完成了百亿级别的代码大模型从0到1的预训练,配合指令微调、量化部署等一系列配套技术,成功将AI大模型能力应用到多个下游研发场景,助力生产提效。在众多下游产品中,CodeFuse代码补全插件直接触及研发过程中最核心的编码场景,因此对开发效率的影响最显著。目前,CodeFuse代码补全插件是CodeFuse系列产品中用户数量最多、留存率最大,调用AI能力最多的产品。 目前,大部分代码语言模型在预训练阶段以文件为基本单位,随机选择代码文件拼接固定长度后组成训练样本。常见的代码评

CodeFuse的博客 4127

「CodeFuse」CodeFuse简介及项目应用实战

CodeFuse 是一款为国内开发者提供智能研发服务的产品,该产品是基于蚂蚁集团自研的基础大模型进行微调的代码大模型,旨在辅助开发者提高编码效率和代码质量。它提供了多项功能,包括辅助编码、代码优化和生成单测。通过海量数据提供实时的代码补全服务,包括行内补全和片段补全,并支持解释代码、生成注释等功能,帮助开发者快速完成功能研发,提高研发效率。此外,CodeFuse 还能对选定的代码段进行分析理解,提出优化和改进建议,并能直接基于改进建议形成代码补丁,帮助开发者写出更好的代码。

GIS摆渡人 1万+

Aspen Plus下载教程Aspen Plus V14 保姆级安装步骤(附安装包)

26、在WlmAdmin界面中,依次点击【Subnet Servers】、【admin】、【Add Feature】、【From a File】、【To Server and its File】。35、在产品选择页面,勾选需要安装的所有产品(重要:不要勾选【Aspen Online(Plant Data)】),然后点击【File Location】。回到桌面,点击任务栏的【开始菜单】,在【所有应用】中找到【Aspen Plus V14】软件图标,将其拖到桌面上创建快捷方式。9、这里可以更改软件的安装位置。

ps_xiaowang的博客 1万+

微调VLM要点

控制输入图像的尺寸,以避免过长的序列导致的内存问题。使用 Unsloth 工具,优化内存使用和加速训练过程。合理配置微调参数,根据硬件资源调整训练设置。Unsloth 节约内存的本质在于通过优化模型微调过程中的内存使用,使大型视觉语言模型(VLMs)在资源有限的硬件上也能进行微调。主要通过以下方式实现:优化的梯度检查点(Gradient Checkpointing)针对长序列的高效实现:Unsloth 提供了一种专门优化的梯度检查点功能,特别适用于处理长序列数据的模型,如视觉语言模型中的大量图像令牌。

m0_59235945的博客 2178

Modkit

Nmod- 通过过滤器分类为具有指定碱基修饰的残基的调用数量。Ncanonical- 通过过滤器分类为未修饰的碱基的调用数量。确切的碱基必须通过修饰代码推断。例如,如果修饰代码是m(5mC),则未修饰的碱基是胞嘧啶。如果修饰代码是a,则未修饰的碱基是腺苷。Nother mod- 通过过滤器分类为修饰的调用数量,但修饰不同于列出的碱基(且相应的未修饰碱基相同)。例如,对于给定的胞嘧啶,可能有 3 个读取带有h调用,1 个带有未修饰调用,2 个带有m调用。在h的 bedMethyl 行中,N。

生物信息学 1264

PLC模拟量输入电路设计:±10V与±20mA信号调理全解析

在工业自动化和数据采集系统中,模拟量输入是连接物理世界与数字控制的核心桥梁。无论是变送器输出的4-20mA电流环,还是伺服驱动与信号发生器提供的±10V电压信号,PLC和采集模块都需要在复杂现场环境下稳定、精准地完成信号采集。理解信号体制的原理——电流环抗长线干扰、电压环响应快——是设计模拟输入前端的基础。通过精密电阻网络实现分压与采样,利用运放完成双极性到单极性的电平搬移,配合TVS与滤波电路保障可靠性,并经过ADC量化与校准流程,最终构建出兼顾精度、成本和工业级鲁棒性的完整信号链路。本文面向硬件工程师与

weixin_29163797的博客 297

没搞错吧,图生代码?代码AI助手全解析

大家好,我是凡人。CodeFuse是蚂蚁集团自研的AI编程工具,旨在通过人工智能技术提升编程效率和代码质量。在实际应用中,CodeFuse的应用场景广泛,包括但不限于开发助手、IDE插件、数据分析器等。它能够助力开发者低门槛编程,例如通过自然语言编写H5小程序1,提供辅助编码、代码优化和生成单测等功能。CodeFuse的一个创新功能是“图生代码”,这一技术允许开发人员仅需提交产品设计图纸,就能快速生成对应的代码。

weixin_40780178的博客 3178

千兆网口电路设计中的EMC防护与TVS选型实战

本文深入探讨了千兆网口电路设计中面临的EMC挑战,并提供了TVS二极管选型的实战指南。文章分析了ESD、浪涌和EFT等主要威胁,重点阐述了如何根据工作电压、钳位电压和关键的低结电容等参数为PHY芯片选择匹配的TVS器件,以确保在严苛电磁环境下实现可靠的信号完整性与防护。

m3n5b7v8c9x的博客 530

Github斩获27.4k Star!一款超低门槛即可玩转大模型训练的开源神器,大模型入门到精通,收藏这篇就足够了!

MiniMind是一个开源的轻量级语言模型项目,能够在极低的计算资源成本下从头开始构建和训练自己的大型语言模型(LLM)。开源作者秉承“大道至简”的理念,让最普通的个人GPU也可快速训练。

pythonhy的博客 1179

Mumax3代码模板:从基础设置到材料参数优化

本文提供了一份详尽的Mumax3微磁学模拟代码模板,从基础网格设置、边界条件到核心材料参数(如钴的Msat、Aex、Ku1)配置与优化均有涵盖。文章深入解析了特征长度计算、初始化方法、弛豫与动力学模拟流程,并分享了并行计算与参数扫描等效率提升技巧,旨在帮助用户快速上手并优化模拟工作流。

moss5的博客 702

《FPGA DDR3权威实战:从基础到高速故障录波系统》专栏导览:从不知所措到心中有数

本文是一份DDR3实战指南,作者从自身学习经历出发,分享了一套循序渐进的DDR3应用路线图。专栏包含12篇文章,从基础配置(MIG IP核、AXI总线)、仿真测试到实际项目应用(功能测试、性能测试),最后深入原生MIG接口实战,通过一个高速故障录播系统案例完整展示DDR3开发流程。文章特别强调实践性,旨在帮助读者系统掌握DDR3开发技能,避免作者当年踩过的坑。每篇都配有优快云链接,适合FPGA开发者按顺序学习参考。

FPGA_小田老师的博客 331

MiniMind:低成本从 0 训练 26M 的小参数GPT,值得推荐的入门 LLM 教程

本文介绍一个很火的 github 项目:https://github.com/jingyaogong/minimind 。通过该项目,使用个人 GPU 资源,也可以复现主流的大模型架构。

2401_82469710的博客 620

【目标检测】IoU(交并比)详解及代码实现

1. IOU概述        IoU的全称为交并比(Intersection over Union),是目标检测中使用的一个概念,IoU计算的是“预测的边框”和“真实的边框”的交叠率-,即它们的交集和并集的比值。最理想情况是完全重叠,即比值为1。 2. IoU计算        IoU等于“预测的边框”和“真实的边框”之间交集和并集的比值。IoU计算如下图,B1为真实

Roaddd的博客 2万+

MiniMind:低成本从 0 训练 26M 的小参数GPT,值得推荐的入门 LLM 教程,大模型入门到精通,收藏这篇就足够了!

本文介绍一个很火的 github 项目:https://github.com/jingyaogong/minimind 。通过该项目,使用个人 GPU 资源,也可以复现主流的大模型架构。

pythonhy的博客 446

【WRF教程第3.5期】预处理系统 WPS 详解:以4.5版本为例

预处理系统 WPS 详解:以4.5版本为例

WW、forever的博客 1422

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

互联网摸鱼日报(2024-02-06)

那个叫“momo”的人,怎么这么能说?美国博士小哥打败女友的AI男友!7页论文让LLM降智,训出「负分男友」成功挽回音频秒生全身虚拟人像,AI完美驱动面部肢体动作!UC伯克利Meta提出Audio2Photoreal全栈智能才能兑现AI红利?约1.14万亿倍太阳质量,中国科学家算出了仙女星系“体重”!iPhone 16回归竖排双摄设计,为了空间计算?极越CEO夏一平:极越07 21.99万起微信偷偷更新!这新春限定功能全面上线输入法也能充VIP?体验两天下来,这AI功能有点绝极氪回应绍兴停车场车辆过火:车辆

weixin_43849685的博客 494

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

主流VLM原理深入刨析(CLIP,BLIP,BLIP2,Flamingo,LLaVA,MiniCPT,InstructBLIP,mPLUG-owl)

MLM(CLIP,BLIP,BLIP2,LLaVA,MiniCPT,InstructBLIP,mPLUG-owl)

ZhengrongYue的博客 1万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

机器人早期VLA大脑的发展史——从微调VLM起步:详解RoboFlamingo、Octo、TinyVLA

许多研究使用从机器人收集的大量轨迹数据集来训练策略这些工作主要集中在单一的embodiment上,而Octo则在跨多个体现组装的机器人数据集上训练策略,增加了训练数据集的有效规模,并允许对多种机器人设置进行微调最近,论文集中于扩展机器人策略的泛化能力。多项研究利用多样的非机器人数据或预训练的视觉-语言基础模型来提升策略对新场景和任务的泛化能力[86,103,96,16,38,11,84,36,4,37,7,3,46,15,23]

结构之法 算法之道 1万+

VLM视觉语言大模型微调实操记录

使用LoRA微调模型后,导出模型指合并LoRA并导出HuggingFace格式的模型,导出后,所有HuggingFace的接口和调用方式都可以兼容。使用VLM-R1训练后的模型也可以导出,理论上可以使用LLaMA-Factory的导出功能,也可以使用HuggingFace自己写代码导出。LLaMA-Factory 提供从训练、微调到推理的全流程支持,内置对多模态模型和 LoRA 的适配,支持多种最新模型,更新及时,且提供webui,非常适合新手入门。下的脚本,根据自己的微调需求准备一个运行脚本。

ferriswym的博客 1991

这款 AI 编码工具 CodeFuse 很惊艳

CodeFuse 是和 GitHub Copilot 类似的编码助手,是蚂蚁集团基于自研的基础大模型进行微调的代码大模型。CodeFuse 具备代码补全、添加注释、解释代码、生成单测,以及代码优化功能,以帮助开发者更快、更轻松地编写代码。我们知道在 IntelliJ IDEA 中安装 GitHub Copilot 并不能召唤出 chat 功能,目前这个功能还处于测试阶段,但 CodeFuse 直接就可以召唤出 chat 功能,并能很好的解释代码。

一个成长中的程序员,期待用技术的眼光生活 3237

字节跳动提出全能VLM预训练框架 | 超越所有多语言多模态方法,同时具备多粒度对齐与定位

视觉语言预训练旨在从大量数据中学习视觉和语言之间的对齐。大多数现有方法仅学习图像-文本对齐。其他一些方法利用预训练的目标检测器在目标 Level 利用视觉语言对齐。在本文中,作者提出通过一个统一的预训练框架来学习多粒度的视觉语言对齐,该框架同时学习多粒度对齐和多粒度定位。基于此提出了X-VLM,一个具有灵活模块化架构的一体化模型,作者在其中进一步统一了图像-文本预训练和视频-文本预训练。X-VLM能够学习与不同文本描述相关联的无限视觉概念。

m0_59164304的博客 2117

VLM训练——Trainer源码解读

VLM训练——Trainer解读

ZhengrongYue的博客 1970

CodeFuse代码优化实战:Java日期格式化时如何正确表示年份?

代码优化,是 CodeFuse 插件推出的功能之一,它可以对选定代码段进行分析理解,提出优化和改进建议。还能直接基于改进建议形成代码补丁,帮助开发者写出更好的代码。安装CodeFuse插件后,选中代码右键即可使用代码优化功能。

CodeFuse的博客 755

codefuse内测版的插件

zip链接: https://pan.baidu.com/s/1e_no-JV8nEVi3yMUx41MHA?本人用的pycharm,设置导入的zip文件,

一个过客 714

CodeFuse 开源一周年,焕新出发!

CodeFuse 是蚂蚁集团推出的开源项目,旨在通过大型代码语言模型(Code LLMs)支持软件开发生命周期各阶段,包括设计、编码、测试、部署等。自2023年9月开源以来,CodeFuse 不断迭代,推出了一系列创新产品和技术,如 CodeFuse IDE、muAgent 2.0 框架及 CGE 和 Rodimus 模型。项目已在蚂蚁集团内部广泛应用,并在多个行业会议上展示分享。未来,CodeFuse 将继续深耕开源,推出更多创新产品,并加强社区互动与合作。欢迎访问 CodeFuse 官网

CodeFuse的博客 2022

MoonDream2微调指南【最小VLM】

Moondream2 是一个开源小型视觉语言模型,源代码位于 GitHub 上,vikhyatk制作。虽然它不是最先进的模型,但它能够以合理的速度和准确性在设备上本地运行,这使它成为 VLM 的一个引人注目的选择,值得尝试进行微调,看看它是否适合您的用例。与其他 VLM 相比,它的得分相对较高。它甚至在 VQAv2 上击败了最近发布的 GPT-4o,考虑到 Moondream2 的本地、开源和小得多的模型,这令人印象深刻。

新缸中之脑 2707
上一篇: CodeFuse成功支持通义千问算法大赛,评测方案已开源
下一篇: CodeFuse代码优化实战:Java日期格式化时如何正确表示年份?
CodeFuse
博客等级 码龄3年 630粉丝 74原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值