


本文字数:9393;估计阅读时间:24 分钟
作者: ClickHouse Team
本文在公众号【ClickHouseInc】首发
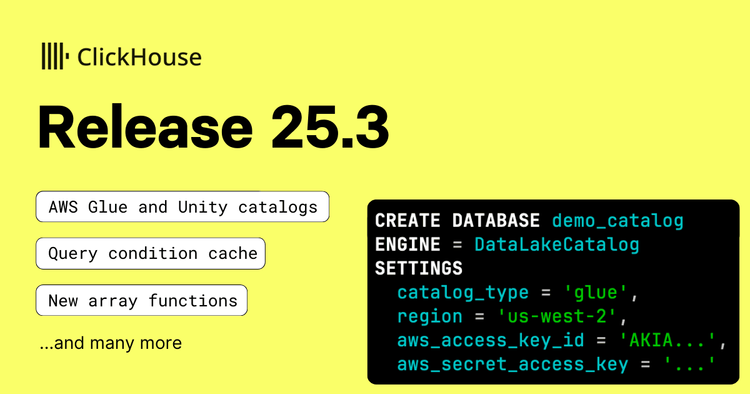
又到了新版本发布的时间!
发布概要
ClickHouse 25.3 版本正式发布,本次更新带来了18项新功能🌱、13项性能优化🐣、48个bug修复🌦️
本次更新新增了对 AWS Glue 和 Unity 目录 的查询支持,引入了 查询条件缓存,优化了 S3 查询的自动并行化,并新增了一些 数组函数!
欢迎新贡献者
我们热烈欢迎所有在 25.3 版本中首次贡献代码的开发者!ClickHouse 社区的不断壮大令人振奋,我们由衷感谢每一位贡献者的支持和努力,正是你们的参与让 ClickHouse 变得越来越强大。
以下是本次版本的新增贡献者名单:
Andrey Nehaychik, Arnaud Briche, Cheryl Tuquib, Didier Franc, Filipp Abapolov, Ilya Kataev, Jason Wong, Jimmy Aguilar Mena, Mark Roberts, Onkar Deshpande, Shankar Iyer, Tariq Almawash, Vico.Wu, f.abapolov, flyaways, otlxm, pheepa, rienath, talmawash
AWS Glue 和 Unity 目录
贡献者:Alexander Sapin
本次版本新增了对 AWS Glue 和 Unity 数据目录的支持,使 ClickHouse 能够更好地与 Lakehouse 生态集成。
现在,你可以通过 AWS Glue 查询 Apache Iceberg 表。首先,需要创建一个数据库引擎:
CREATE DATABASE demo_catalog
ENGINE = DataLakeCatalog
SETTINGS catalog_type = 'glue', region = 'us-west-2',
    aws_access_key_id = 'AKIA...', aws_secret_access_key = '...';
然后即可查询数据:
SHOW TABLES
FROM demo_catalog;

SELECT *
FROM "demo_catalog"."db.table";
Unity 目录 也支持 Apache Iceberg 和 Delta Lake 表。使用方式类似,先创建数据库引擎:
CREATE DATABASE unity_demo
ENGINE = DataLakeCatalog(
    'https://endpoint.cloud.databricks.com/api/2.1/unity-catalog')
SETTINGS catalog_type = 'unity',
    warehouse = 'workspace', catalog_credential = '...'
然后像查询普通表一样使用即可:
SHOW TABLES
FROM unity_demo;

SELECT *
FROM "unity_demo"."db.table";
JSON 数据类型现已正式可用于生产环境
贡献者:Pavel Kruglov
1.5 年前,我们发现 ClickHouse 的 JSON 存储 方案仍有很大优化空间,于是决定彻底重构。一年后,Pavel 开发出了一种全新的 列式 JSON 存储 方案,带来了更高效的数据存储与查询能力。详细过程请参考 [《我们如何为 ClickHouse 构建新的强大 JSON 数据类型》](How we built a new powerful JSON data type for ClickHouse)。
最终,我们实现了一种 性能、压缩率和易用性 远超现有 JSON 数据存储方案的技术,详见 [《十亿文档 JSON 挑战:ClickHouse vs. MongoDB、Elasticsearch 及更多》](The billion docs JSON Challenge: ClickHouse vs. MongoDB, Elasticsearch, and more)。
TL;DR:据我们所知,这是列式存储首次被正确地应用于半结构化数据。ClickHouse 的新 JSON 存储具备以下优势:
- 存储更紧凑,比磁盘上的压缩文件还小
- 查询速度快数千倍,远超 MongoDB 等传统 JSON 存储,同时保持简洁易用
- 支持完整的动态 JSON 路径,无需强制转换数据类型
现在,这一 JSON 存储方案已正式可用于生产环境,并深度集成 ClickHouse 查询加速功能! 你可以在 [《加速 ClickHouse 的 JSON 查询,助力 Bluesky 深入分析》](Accelerating ClickHouse queries on JSON data for faster Bluesky insights) 中了解更多。
此外,我们还开发了 JSONBench —— 业内首个 公正、中立的 JSON 文档分析基准测试。如果你尝试搜索类似的基准测试,会发现 目前没有其他可比的方案。
更重要的是,支撑该方案的核心技术 变体类型 (Variant type) 和 动态类型 (Dynamic type) 也已正式发布。它们不仅优化了 JSON 存储,还为未来 XML、YAML 等 半结构化数据格式 提供了支持。
我们迫不及待地想看看你会用它构建什么!快来试试吧! 如果你对 ClickHouse JSON 的未来发展感兴趣,欢迎查看我们的 [产品路线图](our roadmap)【https://github.com/ClickHouse/ClickHouse/issues/68428】。
查询条件缓存
贡献者:ZhongYuanKai
本次发布新增了 查询条件缓存 (Query Condition Cache),该功能可以 大幅加速重复查询,尤其适用于 仪表盘查询 和 可观测性分析 等场景。对于某些 无法利用主索引 的 高选择性 WHERE 条件,查询条件缓存能够有效优化查询性能。
例如,以下查询用于统计 Bluesky 上包含 椒盐卷饼表情符号 的所有帖子:
SELECT count()
FROM bluesky
WHERE (data.kind = 'commit')
  AND (data.commit.operation = 'create')
  AND (data.commit.collection = 'app.bsky.feed.post')
  AND (data.commit.record.text LIKE '%🥨%');
另一个查询用于分析 发布这些帖子时使用的主要语言:
SELECT
    arrayJoin(CAST(data.commit.record.langs, 'Array(String)')) AS language,
    count() AS count
FROM bluesky
WHERE (data.kind = 'commit')
  AND (data.commit.operation = 'create')
  AND (data.commit.collection = 'app.bsky.feed.post')
  AND (data.commit.record.text LIKE '%🥨%')
GROUP BY language
ORDER BY count DESC;
两个查询共享相同的 过滤条件 (predicate):
WHERE (data.kind = 'commit')
  AND (data.commit.operation = 'create')
  AND (data.commit.collection = 'app.bsky.feed.post')
  AND (data.commit.record.text LIKE '%🥨%')
查询条件缓存 机制会缓存 第一个查询 的扫描结果,并在 第二个查询 中直接复用,从而 大幅加速查询执行。如果你想深入了解 查询条件缓存 的具体实现、性能优化细节,以及上述查询的测试结果,可以参考我们的 [详细博客文章]【https://clickhouse.com/blog/introducing-the-clickhouse-query-condition-cache】。
自动并行化外部数据
贡献者:Konstantin Bogdanov
在上一节中,我们探讨了如何在 ClickHouse 的 MergeTree 表中查询 BlueSky 数据集,并统计其中的椒盐卷饼表情符号的出现次数。现在,让我们直接在 S3 上执行查询,看看所需时间:
SELECT count()
FROM s3('https://clickhouse-public-datasets.s3.amazonaws.com/bluesky/file_{0001..0100}.json.gz', 'JSONAsObject')
WHERE (json.kind = 'commit')
AND (json.commit.operation = 'create')
AND (json.commit.collection = 'app.bsky.feed.post')
AND (json.commit.record.text LIKE '%🥨%')
SETTINGS
  input_format_allow_errors_num = 100,
  input_format_allow_errors_ratio = 1;
┌─count()─┐
│ 69 │
└─────────┘
1 row in set. Elapsed: 64.902 sec. Processed 100.00 million rows, 13.35 GB (1.54 million rows/s., 205.75 MB/s.)
Peak memory usage: 2.68 GiB.查询耗时刚刚超过 1 分钟!我的 ClickHouse Cloud 集群包含 10 个节点,借助 s3Cluster 表函数,我可以将文件的读取任务分配到所有节点:
SELECT count()
FROM s3Cluster(default, 'https://clickhouse-public-datasets.s3.amazonaws.com/bluesky/file_{0001..0100}.json.gz', 'JSONAsObject')
WHERE (json.kind = 'commit')
AND (json.commit.operation = 'create')
AND (json.commit.collection = 'app.bsky.feed.post')
AND (json.commit.record.text LIKE '%🥨%')
SETTINGS
  input_format_allow_errors_num = 100,
  input_format_allow_errors_ratio = 1;
让我们测试一下查询所需的时间!
┌─count()─┐
│      69 │
└─────────┘

1 row in set. Elapsed: 16.689 sec. Processed 100.00 million rows, 13.38 GB (5.99 million rows/s., 801.86 MB/s.)
Peak memory usage: 2.06 GiB.
查询时间减少了 4 倍,虽然未能实现完全线性的加速,但优化效果仍然显著。
ClickHouse 提供了一系列 ...Cluster 函数(如 s3Cluster、azureBlobStorageCluster、deltaLakeCluster、icebergCluster 等),它们在任务分配方面类似于并行副本(parallel replicas),但有一个关键区别:并行副本按数据粒度范围(granule ranges)划分任务,而 ...Cluster 函数则按文件级别进行分配。我们用下图来展示上述查询的执行流程:

首先,查询发起服务器(即接收查询的服务器)解析通配符模式(glob pattern),连接到其他服务器,并动态分发文件。其他服务器在完成当前任务后,会向发起服务器请求新文件,直到所有文件处理完毕。每台服务器会利用自身 CPU 核心数,采用 N 个并行流处理文件的不同部分。所有的部分查询结果最终被合并,并返回给发起服务器,以组装完整的查询结果。由于需要协调任务和合并数据,整体加速比并非严格线性。
从 ClickHouse 版本 25.3 开始,无需调用 ...Cluster 版本的远程数据访问函数即可实现分布式处理。只要启用了并行副本(parallel replicas),ClickHouse 就会在集群环境下自动进行任务分发。
如果不希望使用分布式处理,可以通过以下参数禁用:
SET parallel_replicas_for_cluster_engines = 0;rraySymmetricDifferenc
贡献者:Filipp Abapolov
ClickHouse 提供了丰富的数组函数,能够解决多种数据处理问题。其中一个常见需求是:找出两个数组中只存在于其中一个,而不属于另一个的元素。
一种实现方式是先计算两个数组的并集,然后去除所有出现在交集中的元素:
WITH
    [1, 2, 3] AS a,
    [2, 3, 4] AS b
SELECT
    arrayUnion(a, b) AS union,
    arrayIntersect(a, b) AS intersect,
    arrayFilter(x -> (NOT has(intersect, x)), union) AS unionButNotIntersect;
这种方法可行,但如果有一个函数能直接完成这个操作,显然更为便捷。因此,我们引入了 arraySymmetricDifference:
WITH
    [1, 2, 3] AS a,
    [2, 3, 4] AS b
SELECT
    arrayUnion(a, b) AS union,
    arrayIntersect(a, b) AS intersect,
    arrayFilter(x -> (NOT has(intersect, x)), union) AS unionNotIntersect,
    arraySymmetricDifference(a, b) AS symmetricDifference;
┌─union─────┬─intersect─┬─unionNotIntersect─┬─symmetricDifference─┐
│ [3,2,1,4] │ [2,3] │ [1,4] │ [1,4] │
└───────────┴───────────┴───────────────────┴─────────────────────┘estimateCompressionRatio
贡献者:Tariq Almawash
本次发布新增的另一个函数是 estimateCompressionRatio,它可以评估对某列应用不同压缩算法可能产生的影响。
还记得 为何ClickHouse 如此快文章中数据压缩的部分吗?ClickHouse 在列级别进行数据压缩。
我们可以通过在 play.clickhouse.com 上的 hits 表中对 CounterID 列应用压缩算法,来观察其工作方式:
SELECT round(estimateCompressionRatio('NONE')(CounterID)) AS none,
       round(estimateCompressionRatio('LZ4')(CounterID)) AS lz4,
       round(estimateCompressionRatio('ZSTD')(CounterID)) AS zstd,
       round(estimateCompressionRatio('ZSTD(3)')(CounterID)) AS zstd3,
       round(estimateCompressionRatio('GCD')(CounterID)) AS gcd,
       round(estimateCompressionRatio('Gorilla')(CounterID)) AS gorilla,
       round(estimateCompressionRatio('Gorilla, ZSTD')(CounterID)) AS mix
FROM hits
FORMAT PrettyMonoBlock;
以下是查询的输出结果:
┏━━━━━━┳━━━━━┳━━━━━━┳━━━━━━━┳━━━━━┳━━━━━━━━━┳━━━━━━┓
┃ none ┃ lz4 ┃ zstd ┃ zstd3 ┃ gcd ┃ gorilla ┃  mix ┃
┡━━━━━━╇━━━━━╇━━━━━━╇━━━━━━━╇━━━━━╇━━━━━━━━━╇━━━━━━┩
│    1 │ 248 │ 4974 │  5110 │   1 │      32 │ 6682 │
└──────┴─────┴──────┴───────┴─────┴─────────┴──────┘
专用编解码器(GCD 和 Gorilla)对数据压缩影响较小。而更通用的编解码器,如 LZ4,尤其是 ZSTD,可以显著减少存储空间。此外,我们还可以调整 ZSTD 的压缩级别,数值越高,压缩比越大,但同时压缩过程也会更耗时,从而增加写入操作的时间。
该函数同样适用于尚未导入 ClickHouse 的数据。例如,以下查询返回存储在 S3 里的 Amazon Reviews Parquet 文件的模式信息:
DESCRIBE  s3(
  'https://datasets-documentation.s3.eu-west-3.amazonaws.com' ||
  '/amazon_reviews/amazon_reviews_2015.snappy.parquet'
)
SETTINGS describe_compact_output=1;
┌─name──────────────┬─type─────────────┐
│ review_date │ Nullable(UInt16) │
│ marketplace │ Nullable(String) │
│ customer_id │ Nullable(UInt64) │
│ review_id │ Nullable(String) │
│ product_id │ Nullable(String) │
│ product_parent │ Nullable(UInt64) │
│ product_title │ Nullable(String) │
│ product_category │ Nullable(String) │
│ star_rating │ Nullable(UInt8) │
│ helpful_votes │ Nullable(UInt32) │
│ total_votes │ Nullable(UInt32) │
│ vine │ Nullable(Bool) │
│ verified_purchase │ Nullable(Bool) │
│ review_headline │ Nullable(String) │
│ review_body │ Nullable(String) │
└───────────────────┴──────────────────┘接下来的查询计算了 product_category 列的压缩比:
SELECT round(estimateCompressionRatio(‘NONE’)(product_category)) AS none,
          round(estimateCompressionRatio(‘LZ4’)(product_category)) AS lz4,
          round(estimateCompressionRatio(‘ZSTD’)(product_category)) AS zstd
FROM
 s3(
  'https://datasets-documentation.s3.eu-west-3.amazonaws.com' ||
  '/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);
┌─none─┬─lz4─┬─zstd─┐
│ 1 │ 227 │ 1750 │
└──────┴─────┴──────┘我们还可以评估,如果将数据导入到不同的列类型中,压缩效果会如何:
SELECT round(estimateCompressionRatio(‘NONE’)(product_category)) AS none,
          round(estimateCompressionRatio(‘LZ4’)(product_category)) AS lz4,
          round(estimateCompressionRatio(‘ZSTD’)(product_category)) AS zstd
FROM
 s3(
  'https://datasets-documentation.s3.eu-west-3.amazonaws.com' ||
  '/amazon_reviews/amazon_reviews_2015.snappy.parquet',
  ‘Parquet’,
  ‘product_category LowCardinality(String)’
);
┌─none─┬─lz4─┬─zstd─┐
│ 1 │ 226 │ 1691 │
└──────┴─────┴──────┘或者,在更改数据排序方式后,压缩比是否有所不同:
SELECT round(estimateCompressionRatio(‘NONE’)(product_category)) AS none,
          round(estimateCompressionRatio(‘LZ4’)(product_category)) AS lz4,
          round(estimateCompressionRatio(‘ZSTD’)(product_category)) AS zstd
FROM (
  SELECT *
  FROM
   s3(
    'https://datasets-documentation.s3.eu-west-3.amazonaws.com' ||
    '/amazon_reviews/amazon_reviews_2015.snappy.parquet',
    ‘Parquet’,
    ‘product_category LowCardinality(String)’
  )
  ORDER BY product_category
);
┌─none─┬─lz4─┬─zstd─┐
│ 1 │ 252 │ 7097 │
└──────┴─────┴──────┘征稿启示
面向社区长期正文,文章内容包括但不限于关于 ClickHouse 的技术研究、项目实践和创新做法等。建议行文风格干货输出&图文并茂。质量合格的文章将会发布在本公众号,优秀者也有机会推荐到 ClickHouse 官网。请将文章稿件的 WORD 版本发邮件至:Tracy.Wang@clickhouse.com


 269


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


