


Cascade Residual Learning级联残差学习
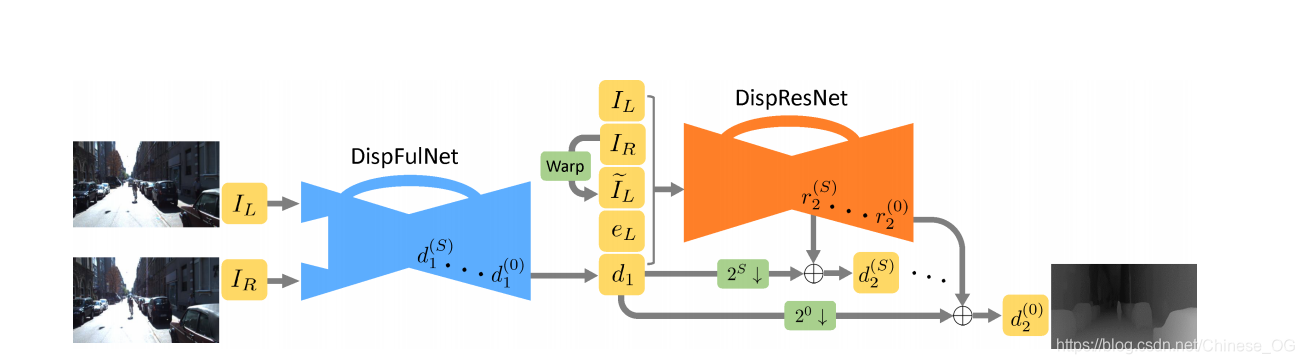
与DispNetC类似,本论文提出的CNN的第一阶段有一个带跳跃连接的沙漏结构。然而,DispNetC输出输入立体图像的半分辨率视差图像。而本论文的网络利用了额外的反卷积模块来放大视差,因此获得与输入图像具有相同尺寸的视差图。第一阶段的网络叫做DispFulNet(Ful表示全分辨率)。DispFulNet在目标的边界提供额外的细节和尖锐的转变,为第二阶段的精细化提供了一个理想的起点。
在本来论文的网络中,第一阶段和第二阶段的堆叠方式同FlowNet2.0。第一个网络输入立体图像对IL和IRIL和IR,产生左图的初始视差d1d1。然后根据视差d1d1扭曲右图像IRIR,获得一个合成的左图像,即
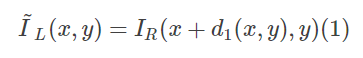
然后第二个网络的输入的是concat
IL,IR,d1,I˜L(x,y)和eL=|IL−I˜L(x,y)|IL,IR,d1,I~L(x,y)和eL=|IL−I~L(x,y)|.扭曲操作是可微的双线性插值,使得网络可以端到端训练。
第二个阶段精细化由第一阶段产生的初始视差。给出初始视差d1d1,第二个网络输出对应的残差信号r2,新的视差为d2=d1+r2. 因此第二个网络只关注于学习高度非线性的残差。与ResNet一样,如果第一阶段就已经产生了最优的视差,则第二阶段只需输出0残差以保持最优性。
第二阶段也是一个沙漏结构,在多个尺度上产生残差信号,称为DispResNet(Res表示残差)。在DispResNet的扩张部分,网络在多个尺度上产生残差,表示为{r(s)2}S=0,其中0代表全分辨率尺度。r(s)2r2(s)和下采样的视差d(s)1的和给出在尺度s上的新视差:

为了训练DispResNet,监督在S+1个尺度上估计的视差。

 2871


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


