信息、熵、信息增益、基尼指数

数据分析 | 信息增益与基尼系数的通俗解释(含实例) 信息增益是基于信息论的概念,用于度量在给定特征的情况下,数据集的不确定性减少程度。在决策树中,选择能够使得信息增益最大的特征作为划分节点。基尼系数是一种衡量数据集纯度(impurity)的指标,它表示从数据集中随机抽取两个样本,其类别标签不一致的概率。在决策树中,选择基尼系数最小的特征作为划分节点。 阅读详情

信息

信息是用来消除随机不确定性的东西,放在机器学习的语境里是这样的,每个类xi的信息为:
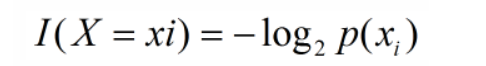
在这里插入图片描述
I表示信息,p(xi)表示指xi的概率

熵

熵是对随机变量不确定性的度量,是信息的期望值
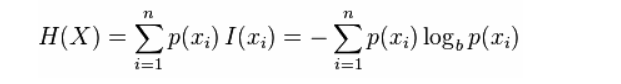
在这里插入图片描述
熵只依赖于随机变量的分布,和其取值没有关系
熵是用来度量不确定的,所以熵越大,X=xi的不确定性越大
给了样本集合D后,其经验熵为:
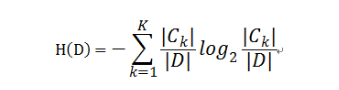
在这里插入图片描述
k表示有k个分类,|CK|为样本集中属于K类的样本数

条件熵

在一个条件下,随机变量的不确定性
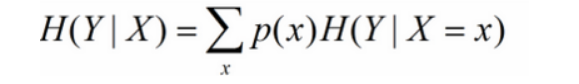
机器学习中可以理解为给定某个特征后的熵
比如在一个集合中,年龄特征下有青年、中年、老年三项,最后的分类分为是、否两类
那在年龄中==青年、中年、老年的情况下,在各自集合里都有样本属于是、否不同的类别
可以分贝算出H(Y|X=青年)、H(Y|X=中年)和H(Y|X=老年),以及p(青年)、p(中年)、p(老年),相乘求和就可以计算在年龄条件下的条件熵

经验条件熵
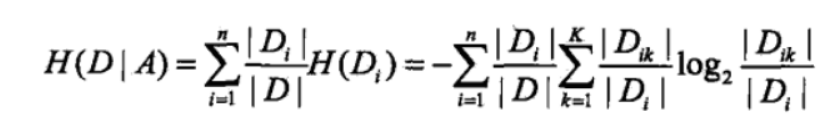
在这里插入图片描述

信息增益

熵 - 条件熵
信息增益可以作为决策树中用来选择特征的指标
由于 熵 是随机变量的不确定性, 条件熵是在某一条件下随机变量的不确定性,所以信息增益就是某一条件下随机变量不确定性减少的程度
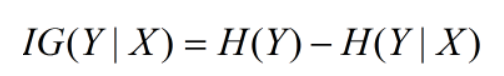
在这里插入图片描述
在决策树构建时,H(Y)表示划分前的熵,H(Y|X)表示划分后的条件熵,后者越小,说明在此条件下随机变量的不确定度越小,相应的信息增益越大,我们想要的正是随机变量的不确定性变小、纯度变高,也就是选择信息增益最大的,ID3算法中就以此为特征选择的方式(sklearn中决策树的critir参数为‘entropy’)

但是信息增益偏向取值较多的特征,要解决这个缺点可以用信息增益比

信息增益比
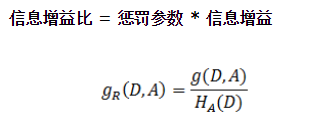
在这里插入图片描述
在这里插入图片描述就是上面在A条件下的熵

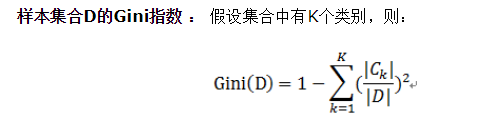
基尼指数

Gini系数是一种与信息熵类似的做特征选择的方式,可以用来数据的不纯度。在CART(Classification and Regression Tree)算法中利用基尼指数构造二叉决策树(选择基尼系数最小的特征及其对应的特征值)。
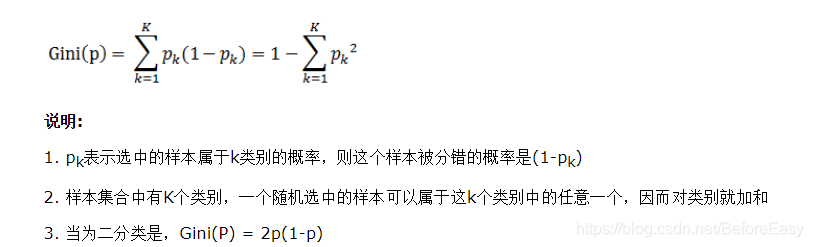
基尼指数(基尼不纯度):表示在样本集合中一个随机选中的样本被分错的概率。
是sklearn决策树的默认选择标准

注意: Gini指数越小表示集合中被选中的样本被分错的概率越小,也就是说集合的纯度越高,反之,集合越不纯。
基尼指数(基尼不纯度)= 样本被选中的概率 * 样本被分错的概率
在这里插入图片描述
在这里插入图片描述
CART是个二叉树,也就是当使用某个特征划分样本集合只有两个集合:1. 等于给定的特征值 的样本集合D1 , 2 不等于给定的特征值 的样本集合D2

实际上是对拥有多个取值的特征的二值处理。
某个特征划分后的Gini指数:
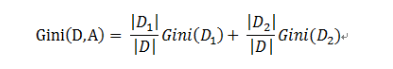
在这里插入图片描述(毕竟是二叉)
因而对于一个具有多个取值(超过2个)的特征,需要计算以每一个取值作为划分点,对样本D划分之后子集的纯度Gini(D,Ai),(其中Ai 表示特征A的可能取值)

然后从所有的可能划分的Gini(D,Ai)中找出Gini指数最小的划分,这个划分的划分点,便是使用特征A对样本集合D进行划分的最佳划分点。

机器学习---决策树的划分依据(熵、信息增益、信息增益率、基尼值和基尼指数) 当每⽀球队夺冠概率相等都是 1/16 的时侯,Ent(D) = -(16 * 1/16 * log1/16) = 4。假如有 16 ⽀球队,分别编号,先问是否在 1-8 之间,如果是就继续问是否在 1-4 之间, 以此类。从信息的完整性上进⾏的描述:当系统的有序状态⼀致时,数据越集中的地⽅熵值越⼩,数据。从信息的有序性上进⾏的描述:当数据量⼀致时,系统越有序,熵值越低;例子:假设我们没有看世界杯的⽐赛,但是想知道哪⽀球队会是冠军, 我们只能猜测某⽀球队是。其中:Ent(D) 的值越⼩,则 D 的纯度越⾼。 阅读详情

相关推荐

简单粗暴理解与实现机器学习之决策树算法(二): 决策树分类原理、熵、决策树的划分依据之信息增益and信息增益率and基尼值和基尼指数、常见决策树类型比较、cart剪枝(附手写笔记)

决策树算法    朴素贝叶斯要求特征相互独立,只能处理文本这种,更好的分类要用到决策树,决策树后面还有更更好的随机森林属于集成学习 可以解决很多的事情 文章目录决策树算法学完决策树算法,您应该掌握二、 决策树分类原理**重点**1 熵1.1 概念1.2 案例2 决策树的划分依据一------信息增益2.1 **概念**2.2 案例:3 决策树的划分依据二----信息增益率4 决策树的划分依据三——...

汪雯琦的博客 1698

决策树算法中基尼指数与信息增益的比较

问题提出 在自己实现决策树算法的时候,发现生成的id3树和cart树一模一样。竟然每个决策节点都选择了同一属性的同一划分。这让我很意外,于是改变了随机种子值,改变训练集的大小,结果发现无一例外它们都是一样的。由此我提出了一个疑问:基尼指数和信息增益是等价的吗? 如果等价,那干嘛还要两个算法?如果不等价,为什么生成的树总是一样的呢? 二者比较 直接取iris数据集中的一部分作为训练集,并指定一个属性...

qq_39408570的博客 6720

决策树及分类原理与划分依据:信息熵、信息增益、信息增益率、基尼值和基尼指数

决策树:是一种树形结构,其中每个内部节点表示一个属性上的判断,每个分支代表一个判断结果的输出,最后每个叶节点代表一种分类结果,本质是一颗由多个判断节点组成的树 熵(Entropy):物理学上是“混乱”程度的量度,系统越有序,熵值越低;系统越混乱或者分散,熵值越高 从信息的完整性上进行的描述:当系统的有序状态一致时,**数据越集中的地方熵值越小,数据越分散的地方熵值越大 从信息的有序性上进行的描述:当数据量一致时,系统越有序,熵值越低,系统越混乱或者分散,熵值越高 1948年香农提出了信息熵(Entro

我的个人博客 7768

[决策树]一步步详解信息增益、增益率、基尼指数

结合B站UP主:致敬大神的讲解和自己的理解作此文章以便自己日后的复习 熵:对一种事物的不确定性 信息:消除不确定性的事物 比如:以买榴莲举例,没任何信息的情况下买榴莲,50%挑到好的,50%挑到坏的,但是如果我们闻了一下后发现味道很香,那么这时,这个被我们闻过的榴莲是好榴莲的几率就上升了 噪音:不能消除对某件事情的不确定性 熵如何度量? ...

weixin_39564592的博客 2125

决策树算法与剪枝处理

一、决策树算法   决策树算法是一种逼近离散函数值的方法。它是一种典型的分类方法,首先对数据进行处理,利用归纳算法生成可读的规则和决策树,然后使用决策对新数据进行分析。   决策树算法的核心思想就是通过不断地决策来筛选出最终想要的结果,来看下面一个例子: 上图是一个女孩相亲中确定见不见男方的过程,她先根据年龄筛选,年龄大于30 的不见,小于30的看长相;长相丑的不见,不丑的见……

一路前行 4368

FlowPic实战:从流量到图像的端到端加密应用识别

本文深入解析了FlowPic技术如何将网络流量转化为图像,并利用CNN模型进行端到端加密应用识别。该方法通过分析数据包大小和时序信息生成流量图像,有效绕过加密内容,实现对视频、聊天、文件传输等应用的精准分类。文章提供了从流量抓取、图像生成到轻量级CNN模型设计与训练的完整实战指南,并探讨了在VPN、Tor等复杂场景下的应用与挑战。

weixin_29046035的博客 151

机器学习算法------(4.1 决策树算法简介、4.2 决策树分类原理(信息增益、信息增益率、基尼值和基尼指数))

文章目录决策树算法学习目标4.1 决策树算法简介学习目标4.2 决策树分类原理学习目标1 熵1.1 概念1.2 案例2 决策树的划分依据一----信息增益2.1 **概念**2.2 案例:3 决策树的划分依据二----信息增益率3.1 概念3.2 案例3.2.1 案例一3.2.2 案例二3.3 为什么使用C4.5要好4 决策树的划分依据三 ----基尼值和基尼指数4.1 概念4.2 案例**5 小结**5.1 常见决策树的启发函数比较**5.1.1 ID3 算法****5.1.2 C4.5算法**5.1.3

程序猿-凡白的博客 3261

树莓派安装snowboy

1、树莓派换源 参考链接:https://blog.youkuaiyun.com/qq_43556844/article/details/113615915 2、更新pip3 参考链接:https://blog.youkuaiyun.com/qq_43556844/article/details/113616214 3、存取麦克风 我们使用PortAudio作为音频输入/输出的跨平台支持。我们还使用sox作为快速实用程序来检查麦克风设置是否正确。 sudo apt-get install python-pyaudio python

qq_43556844的博客 1923

信息、信息熵、条件熵、信息增益、信息增益率、GINI指数、交叉熵、相对熵

在信息论与概率统计学中,熵(entropy)是一个很重要的概念。在机器学习与特征工程中,熵的概念也常常是随处可见。自己在学习的过程中也会常常搞混,于是决定将所有与熵有关的概念整理总结,方便查看和学习。 1. 信息 它是熵和信息增益的基础概念。引用香农的话,信息是用来消除随机不确定性的东西。如果一个带分类的事物集合可以划分为多个类别,则其中某个类(xi)的信息定义:              ...

江湖人称星爷 7139

告别瞎猜!用通达信/同花顺这些资金流向函数,一眼看穿主力动向(附实战公式)

本文详细解析了通达信/同花顺资金流向函数的实战应用,帮助投资者精准识别主力动向。通过12个核心资金函数的组合逻辑,构建主力行为监控体系,避免未来函数陷阱,识别主力对倒行为,并提前捕捉异动。适合股票投资者提升自选股分析能力。

weixin_42522964的博客 1201

windows中搭建sonic云真机环境/云真机环境搭建-基于docker容器部署

基于Windows系统搭建Sonic远程云真机环境实现通过浏览器操作手机端系统

雾林小妖的博客 1016

熵、信息增益、信息增益率与基尼指数

 本文主要介绍了熵,信息增益,信息增益率和基尼指数的基本概念,并使用数据样例进行了计算。 数据样例 名称 是否用鳃呼吸 有无鱼鳍 是否为鱼 鲨鱼 是 有 是 鲫鱼 是 有 是 河蚌 是 无 否 鲸 否 有 否 海豚 否 有 否 熵  熵是度量样本集合纯度最常用的...

知道不_zkl的博客 4538

2024美团秋招硬件开发笔试真题及答案解析

在 Linux 内核的网络设备驱动中,数据链路层的功能通常由网络协议栈的低层(如以太网驱动)实现,而不是作为网络设备驱动的一个独立层次。在 FreeRTOS 中,任务通知(Task Notifications)是一种轻量级的事件传递机制,用于在任务之间或任务与中断之间传递信号。小美正在开发一个简单的密码生成器,其中一个功能是将输入的字符串中的所有字母按字母顺序循环前移一位(即 'a' 变为 'z','B' 变为 'A',以此类推)。它包含了网络设备的各种参数和方法,用于管理网络设备的初始化、配置和操作。

XU157303764的博客 1675

决策树中的熵、信息增益、信息增益比以及基尼指数

决策树中的熵、信息增益、信息增益比一级基尼指数 决策树是机器学习的一种常用算法,可解释性强,可提取规则。决策时就是学习数据内部规律,找到数据之间的联系。决策树的构建就是递归选择最优特征,并根据该特征对数据进行分割,但是决策树是怎么选择最优的分裂属性呢? 决策树特征的选择有三种方法:信息增益、信息熵、Gini系数。 为了演示上面三种分裂属性的选择,我们选用一个例子来加以说明:通过数据来判断该生物是否...

Tracy_LeBron的博客 2506

CAPL编程规范与最佳实践

通过本文的学习,读者应该对CAPL编程规范与最佳实践有了初步的了解,并能够编写高质量的CAPL脚本。在实际项目中,CAPL的应用非常广泛,希望读者能够通过不断的学习和实践,掌握更多的CAPL技巧,提高自己的开发能力。

闲人编程的博客 1747

FFmpeg入门详解之110:RTSP协议讲解

TCP/IP 协议体系中的一个应用层协议,该协议定义了一对多应用程序如何有效地通过 IP 网络传送多媒体数据。RTSP在体系结构上位于RTP和RTCP之上,它使用TCP或UDP完成数据传输。HTTP与RTSP相比,HTTP传送HTML,而RTSP传送的是多媒体数据。正在上传…重新上传取消RTSP是基于文本的协议,采用ISO10646字符集,使用UTF-8编码方案。行以CRLF中断(\r\n:10,13:0x0A,0x0D),包括消息类型、消息头、消息体和消息长。

福优学苑@音视频+流媒体 2529

熵,信息增益,信息增益率,基尼指数(附案例)

熵(Entropy) 是度量样本集合纯度最常用的一种指标。 ID3决策树算法就是利用信息增益作为划分数据集的一种方法。 ID3的后继C4.5使用一种称为增益率(Gain Ratio) 的信息增益扩充。 CART中采用基尼指数来进行特征选择。

迷雾总会解 3333

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

信息(information)、熵(entropy)、信息增益(information gain)、基尼指数(Gini index)的概念

关于对信息、熵、信息增益是信息论里的概念,是对数据处理的量化,这几个概念主要是在决策树里用到的概念,因为在利用特征来分类的时候会对特征选取顺序的选择,这几个概念比较抽象,我也花了好长时间去理解(自己认为的理解),废话不多说,接下来开始对这几个概念解释,防止自己忘记的同时,望对其他人有个借鉴的作用,如有错误还请指出。 1、信息 这个是熵和信息增益的基础概念,我觉得对于这个概念的理解更应该把他认为...

ITYTI的博客 6374

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

决策树中信息、熵、信息增益、基尼指数的概念及其python实现

from:http://www.cnblogs.com/fantasy01/p/4581803.html?utm_source=tuicool and参考:周志华《机器学习》 决策树参考:https://blog.youkuaiyun.com/qq_40587575/article/details/80889223 关于对信息、熵、信息增益是信息论里的概念,是对数据处理的量化,这几个概念主要...

mike_jun的博客 3万+

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

机器学习之决策树(熵、信息、噪音、熵量化、信息增益、信息增益率、基尼值、基尼指数)和逻辑回归树的详解

机器学习21_决策树(decision tree)逻辑回归树(regression tree)详解(2021.09.02) 一. 究极总结 决策树:一个定义在特征空间与类空间上的条件概率分布。 逻辑回归树:解决逻辑回归问题的决策树。 二. 知识储备 什么是熵? 一种事物的不确定性就叫做熵。比如我想买一颗西瓜,该挑哪一颗我不知道,我很不确定,这种感觉就被称作为熵。用数学的角度来解释就是:熵是描述系统状态的函数,也就是用来计算系统的混乱程度。 什么是信息? 信息就是可以用来消除不确定的事物。其作用就是:调整

weixin_40247876的博客 1568

决策树算法---简介、分类原理(熵、信息增益、信息增益率、基尼值和基尼指数)、决策树构建基本步骤

文章目录一、简介二、决策树分类原理1.熵2.决策树的划分依据一------信息增益3. 决策树的划分依据二----信息增益率4.决策树的划分依据三——基尼值和基尼指数5. 决策树构建的基本步骤如下:6.总结 常见决策树类型比较6.1 ID3 算法6.2 C4.5算法6.3 CART算法 一、简介 决策树:是一种树形结构,其中每个内部节点表示一个属性上的判断,每个分支代表一个判断结果的输出,最后每个叶节点代表一种分类结果,本质是一颗由多个判断节点组成的树。 二、决策树分类原理 1.熵 熵 是指混乱程度(虽

alovelypeach的博客 1632

决策树算法 decision tree algorithm(ID3 and CART)

决策树是一种基本的分类与回归方法,从分类来说,svm也用于分类,我们为什么要用决策树呢? a. 决策树一般是模拟人类的行为,数据和算法更便于理解 b. 决策树不是黑盒,能让你看清他是怎么工作和解释数据的 下面是关于是否提供贷款给个人的一个决策树,简单明了 为了得到这课决策树,我们的训练数据类似下面的表格,只列了一点,需要更多数据完成训练: 现在的关键问题在于如何选取每一层的节点,原则在于尽...

weixin_43909872的博客 1857

熵理解及决策树算法

1、熵及条件熵 1.1熵 熵(entropy)代表随机变量的不确定性,熵越大随机变量的不确定性就越大,就越混乱,自然状态下向着熵值增加的方向发展。 熵值大->不确定性大(p值越小)->混乱程度大. 依据Boltzmann′sH−theorem,香农把随机变量X的熵值Η(希腊字母Eta)定义如下,其值域为x1,...,xn:依据Boltzmann′sH−theor...

howardact的博客 1529

一文全解经典机器学习算法之决策树(关键词:信息增益、ID3、基尼指数、C4.5、CART、剪枝、熵)

决策树(Decision Tree):是一种机器学习算法,广泛应用于分类和预测分析等领域。它基于树形结构进行决策,通过向下遍历该树实现对数据的分类或预测。在决策树中,每个节点表示一个特征或属性,每个分支表示该特征的一个取值,而叶子节点则表示最终的分类或者预测结果例如在判断好瓜和坏瓜这个二分类问题上,通常会进行一系列的决策,我们可以认为色泽、根蒂、敲声是一个西瓜的三个特征,每次我们做出抉择都是基于这三个特征来把一个节点分成好几个新的节点从上面的决策过程中我们可以看出下面几点因此,一棵决策树包含了一个根结点、若

快乐江湖的博客 1323

机器学习——入门基础(决策树)

文章目录决策树熵量化信息量化(信息增益)ID3决策树-信息增益C4.5决策树-增益率CART决策树-基尼指数预剪枝后剪枝决策树中连续值&缺失值 决策树 名词 解释 熵 一种事物的不确定性 信息 为消除不确定的事物,调整概率,排除相关的干扰因素 噪音 不能消除对某件事情的不确定性的事物 数据 噪音+信息称为数据 熵量化 1、对于不确定的事件作为单位,比如抛硬币,熵值相当于抛几次硬币的不确定性,比如1次,结果有两种,熵为2;两次,结果有4种,熵为4 2、对于等概率均匀分布

友培的博客 2582
上一篇: 激活函数
下一篇: leetcode 39组合总和
BeforeEasy
博客等级 码龄10年 92粉丝 207原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值