Python31 自然语言处理NLP之NLTK的使用

基于nltk的自然语言处理---stopwords停用词处理 一个nltk库的自然语言处理stopwords停顿词的测试脚本,先对一段字符串进行测试: import pandas as pd import nltk from nltk.corpus import stopwords from nltk.tokenize import word_tokenize from nltk.corpus import stopwords nltk.download(... 阅读详情

图片

图片

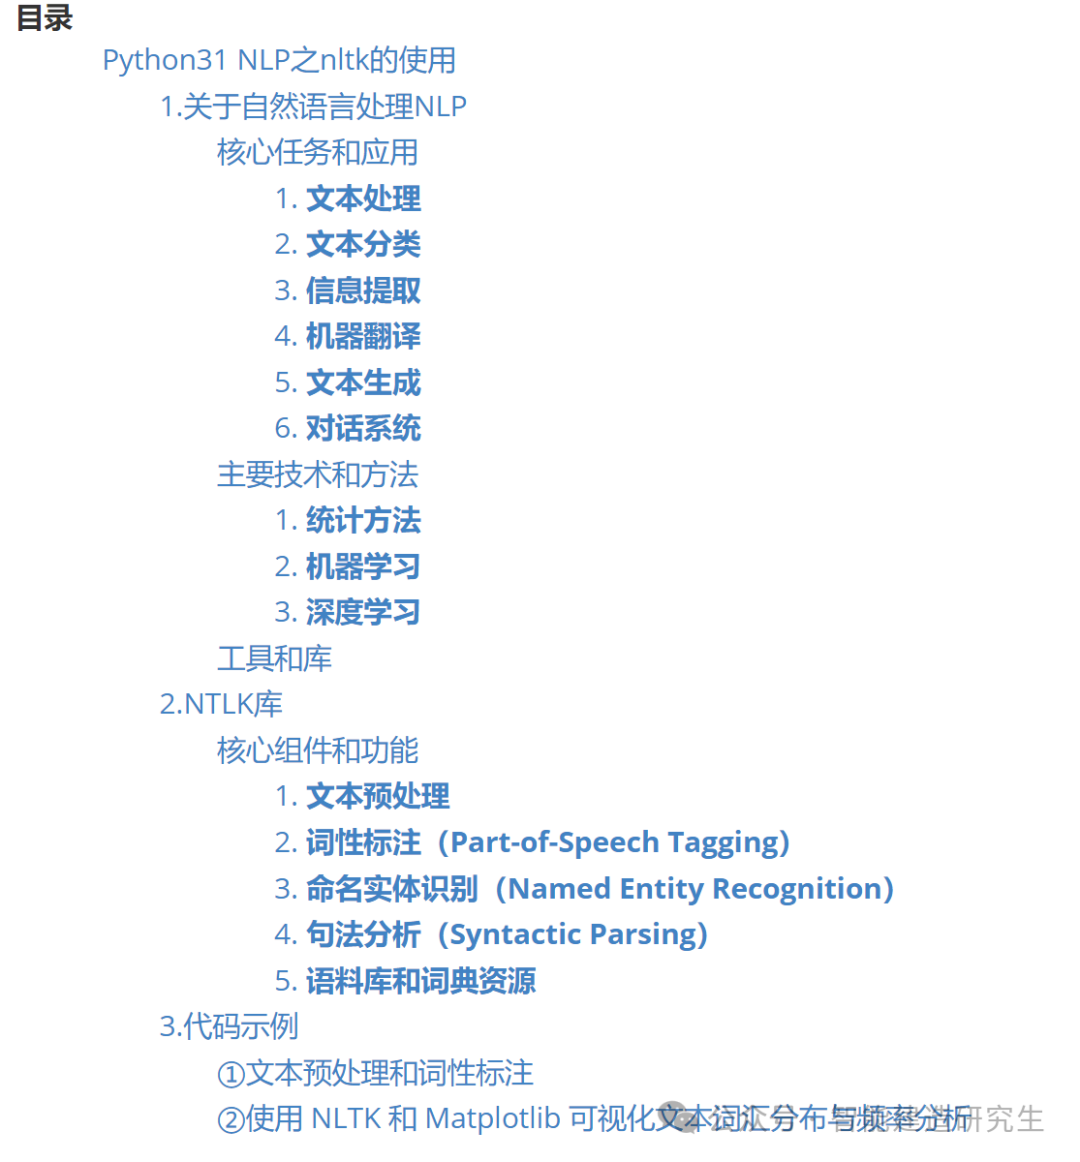
1.关于自然语言处理NLP

自然语言处理NLP是人工智能和计算机科学的一个子领域,专注于计算机与人类(自然)语言之间的互动。其目的是使计算机能够理解、解释和生成人类语言。NLP 涉及语言学、计算机科学和人工智能的多学科交叉,通过统计、机器学习和深度学习等方法处理和分析大量的自然语言数据。

核心任务和应用

NLP 包括多种任务和应用,主要分为以下几类:

1. 文本处理
  • 分词:将文本分割成独立的单词或短语。

  • 词性标注:标识每个单词在句子中的词性(如名词、动词、形容词等)。

  • 句法分析:解析句子的语法结构,包括依存关系和短语结构分析。

2. 文本分类
  • 情感分析:检测文本中的情感倾向,如积极、中立或消极。

  • 主题建模:识别文本中的主题或隐藏的语义结构。

  • 垃圾邮件过滤:检测并过滤电子邮件中的垃圾内容。

3. 信息提取
  • 命名实体识别(NER):识别文本中的实体,如人名、地名、组织等。

  • 关系抽取:从文本中提取实体之间的关系。

  • 事件抽取:识别和分类文本中的事件信息。

4. 机器翻译
  • 自动翻译:将文本从一种语言翻译成另一种语言,如 Google 翻译。

5. 文本生成
  • 语言生成:生成与输入语义相关的自然语言文本。

  • 摘要生成:从长文本中提取关键内容生成摘要。

6. 对话系统
  • 聊天机器人:与用户进行自然语言对话,如客服机器人。

  • 智能助理:提供信息查询、任务管理等服务,如 Siri、Alexa。

主要技术和方法
1. 统计方法

早期的 NLP 方法主要依赖于统计模型,如 n-gram 模型、隐马尔可夫模型(HMM)和条件随机场(CRF),用于各种语言处理任务。

2. 机器学习

传统机器学习方法,如支持向量机(SVM)、朴素贝叶斯、决策树等被广泛应用于文本分类、情感分析等任务。

3. 深度学习

近年来,深度学习技术在 NLP 中取得了显著进展,主要包括:

  • 循环神经网络(RNN):特别是长短期记忆(LSTM)和门控循环单元(GRU)被用于处理序列数据,如文本生成和机器翻译。

  • 卷积神经网络(CNN):用于文本分类和句子建模。

  • Transformer:由 Google 提出的 Transformer 结构及其衍生模型(如 BERT、GPT)在多种 NLP 任务中表现优异。

工具和库
  • NLTK:Python 的自然语言处理库,提供丰富的工具和资源。

  • spaCy:高效的 NLP 库,适用于工业应用。

  • Gensim:用于主题建模和文档相似性计算的库。

  • Transformers:Hugging Face 提供的库,包含多种预训练模型,如 BERT、GPT 等。

2.NTLK库

NLTK(Natural Language Toolkit)是一个广泛使用的开源 Python 库,专门用于处理自然语言文本。它提供了丰富的工具和资源,用于完成各种自然语言处理(NLP)任务,包括文本预处理、词性标注、句法分析、语义分析、机器翻译等。NLTK 适用于教育和研究领域,同时也是入门 NLP 的理想工具。

核心组件和功能

NLTK 包含多个模块和子包,提供了各种 NLP 功能。以下是一些核心组件和功能:

1. 文本预处理
  • 分词(Tokenization):将文本分割成独立的单词或句子。

    # 导入 NLTK 库
    import nltk
    
    # 下载 punkt 数据包,用于分句和分词
    nltk.download('punkt')
    
    # 定义一个句子
    sentence = "Natural language processing is fun."
    
    # 使用 NLTK 的 word_tokenize 函数对句子进行分词
    # word_tokenize 函数将输入的字符串按单词进行分割,生成一个单词列表
    words = nltk.word_tokenize(sentence)
    
    # 打印分词后的结果
    # 结果是一个包含句子中每个单词的列表
    print(words)
    
    # 输出:
    '''
    ['Natural', 'language', 'processing', 'is', 'fun', '.']
    '''
    
  • 去除停用词(Stopword Removal):去除无意义的常见词(如 "the", "is")。

    # 从 NLTK 的语料库模块中导入 stopwords
    from nltk.corpus import stopwords
    
    # 下载 stopwords 数据包,包含各种语言的常见停用词
    nltk.download('stopwords')
    
    # 获取英语的停用词集合
    stop_words = set(stopwords.words('english'))
    
    # 过滤掉分词结果中的停用词
    # 对于每个单词 w,如果该单词(转换为小写后)不在停用词集合中,则保留该单词
    filtered_words = [w for w in words if not w.lower() in stop_words]
    
    # 打印过滤后的单词列表
    # 结果是一个去除了停用词的单词列表
    print(filtered_words)
    
    # 输出:
    '''
    ['Natural', 'language', 'processing', 'fun', '.']
    '''
    
  • 词干提取(Stemming):将单词还原为词干形式。

    # 从 NLTK 的 stem 模块中导入 PorterStemmer
    from nltk.stem import PorterStemmer
    
    # 初始化 PorterStemmer 对象
    stemmer = PorterStemmer()
    
    # 对分词结果中的每个单词进行词干提取
    # stemmer.stem(w) 方法会提取单词的词干
    stemmed_words = [stemmer.stem(w) for w in words]
    
    # 打印词干提取后的单词列表
    # 结果是一个包含每个单词词干形式的列表
    print(stemmed_words)
    
    # 输出:
    '''
    ['natur', 'languag', 'process', 'is', 'fun', '.']
    '''
    
  • 词形还原(Lemmatization):将单词还原为其基本形式。

    # 从 NLTK 的 stem 模块中导入 WordNetLemmatizer
    from nltk.stem import WordNetLemmatizer
    
    # 下载 wordnet 数据包,包含用于词形还原的词典
    nltk.download('wordnet')
    
    # 初始化 WordNetLemmatizer 对象
    lemmatizer = WordNetLemmatizer()
    
    # 对分词结果中的每个单词进行词形还原
    # lemmatizer.lemmatize(w) 方法会将单词还原为其基本形式
    lemmatized_words = [lemmatizer.lemmatize(w) for w in words]
    
    # 打印词形还原后的单词列表
    # 结果是一个包含每个单词基本形式的列表
    print(lemmatized_words)
    
    # 输出:
    '''
    ['Natural', 'language', 'processing', 'is', 'fun', '.']
    '''
    
2. 词性标注(Part-of-Speech Tagging)
  • 标注句子中的每个单词的词性:

    # 下载词性标注器的模型数据包
    nltk.download('averaged_perceptron_tagger')
    
    # 对分词结果进行词性标注
    # nltk.pos_tag(words) 方法会为每个单词分配词性标签
    tagged_words = nltk.pos_tag(words)
    
    # 打印词性标注后的单词列表
    # 结果是一个包含单词及其词性
Please use the NLTK Downloader to obtain the resource nltk(natural language toolkit)是python的自然语言处理工具包 在环境中用 >>pip install nltk 之后,对于一些特定的包还需要进行下载才能调用。 例如以下报错: LookupError: ********************************************************************** ... 阅读详情

相关推荐

Python安装nltk 比较简单的方法

Python NLTK 安装经验 PS: 我从未想过,有一天卸载Python之后,还会给它装回来,憨憨落泪。 之所以想写这个,是真的希望能够帮助到大家少走弯路。 网上的错误解决方法都有点零零碎碎,且有些发表的时间有点早。 有建议按官网教程安装的,都全英界面,又下这个又下那个的,令人很是头大。 花点时间帮助像我一样的憨憨值得了…啥也不懂的来看就对了… 前言 1.看到有人说,Python要下32位的,但我就是倔的像头驴似的,偏偏下了64位,目前没有因为32/64的问题出现warning;

qq_20349393的博客 4629

python的NLTK库如何使用

NLTK是一个自然语言处理工具包,它可以完成词频统计,分词,词性标注等常见任务。要使用NLTK,首先需要安装它。NLTK库有一个非常丰富的资源库,可以用于分析文本、语音和词汇结构。这段代码先下载了一个停用词(stopwords)的语料库,然后对文本内容进行了分词,去除了停用词,最后使用NLTK的。函数统计了词频,并输出了前10个最高频的词。

zhangzhechun的专栏 2243

31、Python编程与自然语言处理入门

本文介绍了Python编程基础与自然语言处理(NLP)的入门知识。内容涵盖Python类与对象的基本操作、卡片洗牌模拟示例、继承与多态编程,以及NLP的基本概念、应用场景和主要任务。文章详细介绍了使用TextBlob进行文本分词、词性标注、情感分析和提取名词短语的方法,并提供了可视化词频、文本可读性评估、命名实体识别与相似度检测的实践示例。此外,还简要介绍了机器学习和深度学习在NLP中的应用,以及常用的NLP库和数据集。

nut55的博客 109

基于R语言 meta/metafor 包进行荟萃分析(一)

在此部分中,使用连续结果详细描述了通用逆方差方法及其在meta分析中的应用,还介绍了固定效应法和随机效应法。我们已经展示了如何分别将典型数据与metacont和metagen函数一起使用,以及如何print和绘制森林图。我们还讨论了估计研究间方差的各种方法,并将Hartung-Knapp平差描述为经典随机效应方法的替代方法。此外,我们还说明了byvar选项的使用,这使得亚组分析更加简单。关于亚组分析的更多细节见后续章节。

Dunaichuanyi的博客 1万+

单细胞转录组聚类分析R包——SC3的应用

前言 在做单细胞相关聚类分析的过程中,为了研究异质性,发现了一种专门用于单细胞转录组的聚类分析R包——SC3(single cell consensus clustering,单细胞一致性聚类)。该聚类算法发表于Nature Methods(2017),能够让单细胞RNA-seq基于转录组特征对细胞类型进行定量表征。这是一种用户友好的无监督聚类工具,它通过一致方法将多个聚类解决方案组合在一起,从而得到高精度和鲁棒性的分群结果。SC3包的官方具体使用教程见:http://www.bioconductor.or

m0_51042606的博客 5004

告别Keil!用VSCode+PlatformIO玩转STC单片机(附自动下载配置)

本文详细介绍了如何从Keil迁移到VSCode+PlatformIO进行STC单片机开发,包括环境搭建、自动下载配置等实用技巧。通过对比传统IDE与现代工具链的差异,展示了VSCode+PlatformIO在代码编辑体验、跨平台支持和开发效率上的优势,帮助开发者实现更流畅的STC单片机开发流程。

weixin_27252001的博客 457

运维系列【仅供参考】: Windos10和Windos11 配置intel网卡vlan的方法

Windos10和Windos11 配置intel网卡vlan的方法

weixin_54626591的博客 473

YOLOv8改进-bifpn

跨尺度连接通过添加一个跳跃连接和双向路径来实现,自此实现了加权融合和双向跨尺度连接。该结构是加权且双向连接的,即自顶向下和自底向上结构,通过构造双向通道实现跨尺度连接,将特征提取网络中的特征直接与自下而上路径中的相对大小特征融合,保留了更浅的语义信息,而不会丢失太多的深层语义信息。传统的特征融合时将尺度不同的特征图以相同权重进行加权,但是当输入的特征图分辨率不同时,以相同的权重进行加权对输出的特征图不平等。所以BiFPN根据不同输入特征的重要性设置不同的权重,同时反复采用这种结构来加强特征融合。

weixin_45303602的博客 8136

MTK Meta ISP 工具使用技巧与参数读取路径全解析

在联发科(MediaTek, MTK)平台上进行相机图像调试时,Meta ISP 工具是连接 PC 与设备进行参数调整、寄存器读取和图像输出的重要工具。本文以实战角度出发,系统梳理 Meta ISP 的使用流程、关键模块功能、典型调试技巧与参数读取路径,结合最新版平台(如MTK Genio/Dimensity 系列)架构,帮助工程师掌握联发科图像调优的核心流程。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1146

【Unity】【2D】用连续图片生成动画Animation的简明步骤

本文介绍了Unity中使用2D连续图片制作2D动画Animation的简明步骤。

O青草O的博客 Unity和游戏制作知识分享 714

【SI案例分享】1000 BASE-T1共模终端的分析与评估

以太网的MDI接口应用中,共模端接网络的应用广泛,并且,其电路参数从100 BASE-T1到1000 BASE-T1保持了相同的参数定义,这就不得不引起使用者的怀疑,毕竟百兆和千兆以太网的工作频段差异巨大,这样的设计真的可以做到上下兼容吗?本文针对此问题,进行了深入的探讨。

一只豌豆象的博客 1362

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

上一篇: Python29 Tensorflow的基本知识和使用
下一篇: Python32 极限学习机ELM
智能建造研究生
博客等级 码龄6年 2018粉丝 95原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
