警告!后端转大模型,这3类人必翻车(34岁过来人亲述)

大模型命名解码:从Sonnet、Opus到Qwen的四维工程逻辑 大语言模型命名并非营销噱头,而是承载能力定位、架构血统、量化精度与使用场景的高密度工程编码。理解如Sonnet(中端均衡)、Opus(旗舰全谱)、Qwen2.5(代际升级)等关键词,本质是掌握模型在推理延迟、上下文支持、显存占用和任务适配上的真实边界。这套命名逻辑直接决定私有部署成败、微调兼容性与线上SLA达标率,广泛应用于金融合同解析、政务工单处理、多轮客服系统等对稳定性与精度要求严苛的工业场景。本文基于12个主流模型实战拆解,揭示命名背后被忽略的rope_theta变更、tokenizer不兼容、时间戳 阅读详情

我做了8年Java后端,33岁那年,辞掉了干了5年的稳定工作——不是脑子一热,是看着身边同行要么被优化、要么困在重复开发里看不到头,s所以狠下心一头扎进了AI应用开发这个圈子。

这一年下来,我踩的坑真不少:面试时被面试官问得哑口无言、熬夜改RAG服务改到崩溃、好不容易做出来的功能,因为运行成本太高被老板打回重做……但现在回头看,这条路真的选对了——工资涨了30%,以前总觉得这辈子就这样了,一眼望到头,现在才发现,职业原来还有这么多可能。

今天不跟大家说虚的,也不故意制造焦虑,就以一个过来人的身份,跟那些还在纠结“要不要从后端转AI”的同行,说句实在话:2026年,AI应用开发找工作确实有机会,但早就不是那种“随便学个Python、调个接口就能蒙混过关”的年代了,瞎跟风转型,只会白浪费时间和钱。

这3类后端转大模型的同学,劝你慎重!别白忙活一场

转型这一路上,我见过太多同行栽跟头,尤其是这3类人,大多半途而废,甚至越转越迷茫,大家一定要避开,别重蹈我的覆辙:

❌ 觉得“会用LangChain,就等于懂大模型开发”

很多后端同行都有个误区,觉得只要会调用LangChain的接口,能搭个简单的框架,就能自称“大模型开发工程师”了。可真到面试的时候,面试官一句话就能把你问住:“你做的RAG服务,每秒能处理多少请求?检索速度怎么提快?要是向量数据库崩了,你怎么应对?” 连最基础的兜底、应急办法都不懂,还谈什么实际落地?纯属自欺欺人。

❌ 简历上只写“调用过大模型API”(最常见的坑!)

现在公司招的不是“只会调接口的工具人”,而是能解决实际问题的人。面试官真正想知道的是:你怎么设计反馈机制,让模型越用越好?怎么通过测试优化提示词,减少垃圾输出?线上模型不好用了,你怎么监控、怎么恢复?只写“调用API”,简历根本没人看,直接就被刷掉,纯属白费功夫。

❌ 以为“看几篇科普文,就准备好转型了”

我见过不少后端同行,刷了几篇AI科普文章、看了两个教学视频,就觉得自己能转型AI了,信心满满地去面试。可真到现场,被问到“多智能体一起工作,怎么保证数据不乱、状态不丢失”,瞬间就卡壳了,半天说不出一句完整的话。说句实在的,AI应用开发,比大家想的要复杂得多,光靠看几篇科普文,连入门都算不上。

🔥 2026年大模型应用开发真实现状:后端的老本事,才是你最硬的靠山

很多同行都以为,转AI应用开发,就得把后端的老本事全丢掉,一门心思学算法、学模型,从头开始。但我用一年的亲身经验告诉大家:恰恰相反,后端的那些老本事,才是你比纯AI背景的人更厉害的地方,是你转型的最大优势。

现在的大模型应用开发,早就不是算法工程师的专属领域了。真正难的,不是搞懂复杂的算法,而是把AI技术落地到实际业务中,这其中最关键的,就是我们后端的工程能力:

✅ 纯AI背景的人,大多不懂高并发、高可用:他们写的接口,自己测试的时候好好的,一上线,稍微多来点用户就崩了,连最基础的防崩、兜底办法都不会,根本扛不住实际业务的考验;

✅ 纯后端背景的人,大多不懂模型和数据流程:他们设计的架构虽然稳,不会崩,但模型响应慢、运行成本高,老板要的是“又快又省钱”,不是“只稳不快、还费钱”,这样的方案根本通不过。

所以,2026年,各大公司抢着要的,不是纯AI人才,也不是纯后端人才,而是既懂后端工程、又懂大模型应用的复合型人才。

面试的时候,除了问RAG、Agent这些AI相关的概念,面试官一定会追问你的工程落地能力,比如这3个问题,几乎每个面试官都会问,而这些,全是我们后端的老本行:

1. 怎么设计一套又快又稳的RAG服务? (缓存、异步处理、防崩兜底这些,都是我们后端最擅长的,不用重新学,直接就能用)

2. 线上大模型响应慢,你怎么找到问题出在哪? (追踪流程、分析性能,这是我们后端做监控的拿手活,轻车熟路)

3. 怎么降低模型服务的成本? (合理分配资源、按需调整,这也是我们后端常做的事,稍微结合AI特性就能落地)

我的转型路径,帮你避开90%的坑(真实可参考,不用踩我踩过的雷)

从Java后端转到AI应用开发,我没走任何捷径,没有报几万块的培训班,全靠自己一步一个脚印踩坑摸索,把我的转型路径分享给大家,建议收藏,照着学,能少走很多弯路:

✅ 第一阶段:入门感知(1-2个月)

先搞明白大模型能做什么、不能做什么,不用深钻复杂原理,先学会把大模型当工具用,简单试试Agent怎么玩、怎么互动。这一阶段重点学提示词怎么写,吴恩达的课程讲得很通俗易懂,推荐大家去学,能少走很多弯路,比自己瞎琢磨强太多。

✅ 第二阶段:深化理解(2-3个月)

大概了解下大模型的核心原理,比如Transformer、注意力机制、模型微调这些,不用搞得太深入,知道大概怎么回事、为什么这么做就行;学会用Pytorch框架,能自己部署Hugging Face上的开源模型,不用依赖第三方API。同时,搞懂OpenAI相关模型的API参数,比如topk、temperature,知道调不同的参数,会有不同的输出效果,能根据需求调整。

✅ 第三阶段:核心突破(3-4个月)

这是最关键的一步,也是很多后端转型同学卡壳的地方!Agent要落地,离不开知识补充,也就是RAG技术——这部分要学的东西很多,从选哪种向量数据库、怎么优化检索速度,到怎么更新知识库、避免数据不一致,每一步都要搞懂、练熟(我主页也分享过很多RAG相关的干货,感兴趣的可以去看看,都是我踩坑总结的经验)。

✅ 第四阶段:工程落地(2-3个月)

流式编程很重要,建议学Python(对AI最友好,上手也快,比Java简单不少)、Go或者TS这类轻量级、好上手的语言。Agent好不好用,用户买不买账,关键看响应速度,而这部分,正好能用到我们后端的性能优化能力,把后端的老本事用起来,就能解决AI应用的体验问题。

✅ 第五阶段:思维升级(长期坚持)

多关注AI领域的大佬和开源项目,别光顾着敲代码,结合自己做后端的经验,想想怎么用AI解决实际的业务问题。记住:我们做的是AI应用,不是底层模型,技术是为业务服务的,懂技术又懂业务、有产品思维的人,才最值钱,老板也愿意给你涨工资、委以重任。

总结一句:目前RAG这个方向真的很吃香,各大公司都在布局AI搜索,都需要懂Agent、懂RAG的人。最关键的不是你懂多少理论,而是你能不能跟上行业节奏(AI技术更新太快,不学习就会被淘汰)、有没有产品思维,多关注行业动态,说不定就能抓住一个创业的机会。

大家对AI的焦虑,我完全能理解。毕竟放弃干了多年的后端,去学一个全新的领域,难免会怕学不会、怕转型失败。但现在这个阶段,AI应用还没完全稳定,市场上这种“后端+AI”的复合型人才很少,薪资有溢价,这正是我们后端同行转型的最好时机,错过就太可惜了。

📈 给想转型大模型的后端同学,4条实用建议(我亲测有效,照着做少踩坑)

1. 别光学AI,把后端的老本事带上

面试官问你“怎么做RAG”,别只说怎么检索、怎么喂知识,要主动多说一句:“我做的RAG服务,会缓存常用的请求、做好防崩兜底,用异步的方式更新知识库,不影响主流程正常使用。” 这样说,面试官才会觉得你专业、能落地,不是只会纸上谈兵的混子。

2. 别只学个皮毛,深挖一个框架的底层逻辑

比如LangChain,别只满足于会用、会调用接口,多看看它的底层源码——比如检索功能是怎么实现的、对话记忆是怎么存储的。要是你能说出它的性能短板,还能给出改进办法,面试的时候绝对加分,面试官会觉得你是真懂,不是单纯的“调包侠”。

3. 少扯空话,多讲实际数据

别跟面试官说“我优化了响应速度”,太笼统了,没人信。你要具体说“我把请求响应时间从3秒降到了800毫秒,还把模型运行成本省了20%”,有数据支撑,才显得你真的做过事,有实际落地能力,而不是空讲理论。

4. 准备一个自己的踩坑案例

面试的时候,面试官特别喜欢问“你遇到过什么问题,怎么解决的”。比如你可以说:“我刚开始做RAG的时候,没考虑知识库更新的问题,导致刚更完的数据,用户搜不到。后来我加了版本号,每次更新都重新建索引,还做了灰度上线,能一键回滚,再也没出过错。” 真实的踩坑经历,比空讲一百句理论都管用。

💣 我亲身踩过的坑,大家别再犯!(血的教训)

转型路上,我踩过两个大坑,至今印象深刻,分享给大家,能帮你们少走很多弯路,避免白白浪费时间:

第一个坑:面试被问懵,当场尴尬到抠脚

有一次面试,面试官问我:“要是大模型服务突然崩了,你怎么保证用户用着不闹心?” 我当时脑子一懵,只想到了“提示用户出错了”,结果被面试官追问得哑口无言,半天说不出下一句。后来才知道,正确的做法是多做几层兜底——比如本地存个简单模型应急、缓存一些常用答案,实在不行,引导用户留言,后续再回复,这样才能保住用户体验,也能体现你的工程思维。

第二个坑:简历吹牛皮,被当场拆穿

我刚开始找工作的时候,为了提高通过率,简历上写“精通RAG”,结果面试官追问我:“你做的知识库,更新之后怎么保证数据不乱?要是刚更完,还没建索引,用户就搜索,怎么处理?” 我当时就慌了,因为我只做过简单的定时建索引,根本没考虑过这种生产环境下的问题。后来才明白,生产环境里,定时建索引根本不够用,得做实时更新、灰度索引,还要有兜底方案,别在简历上吹牛皮,不然只会搬起石头砸自己的脚。

最后再劝大家一句:后端转AI,顺序千万别搞反!

2026年,AI应用确实火得一塌糊涂,但市场缺的不是懂AI的人,是能把AI落地到业务里的人!我们做后端的,转型有天然优势——我们懂架构、懂稳定、懂怎么省钱,只要补补AI的相关知识,就能成为公司抢着要的稀缺人才,比那些纯AI背景、不懂工程的人,竞争力强多了。

就算你暂时不转岗,多学一点大模型、RAG、Agent这些新技术,也能在你现在的团队里脱颖而出,成为“最懂AI的后端”,机会自然会主动找你,不用你到处求着找工作。

📝 最后给大家说个福利:

我转型这一年,踩了太多坑,也整理了很多实用的资料,现在全部打包好,分享给想转型的同行。所有资料都整理成了PDF,包括:后端转大模型的完整学习路线、框架源码笔记、大厂面试真题(还有我自己的答题思路)、实战项目模板,照着学,能帮你避开我踩过的90%的坑,少走弯路。一句兄弟,我双手奉上!

2026年的AI风口,抓住了,就能实现薪资和职业的双重跃迁,别犹豫,赶紧行动起来,让我们后端的经验,发挥最大的价值!💪

2026 小白和在岗程序员该怎样系统学好 AI 大模型?

很多兄弟有心踏入大模型赛道,却总是卡在自学难题上面。

一部分人四处搜集零散网课、碎片化文档,知识结构杂乱无章,越学越迷茫;还有不少人冲动入手高价培训课程,花费不菲,学到的仅有演示 Demo,缺少企业级落地项目,白白浪费宝贵时间不停踩坑。

我这边整理好了一套适配 2026 行业招聘标准、免费且体系完整的 AI 大模型全套学习资源包。覆盖零基础入门、工程实战、底层原理深耕、大厂面试备考整条链路,所有资料已经规整完毕,不需要你到处搜集拼凑,拿到之后直接开启学习,小白循序渐进,老程序员专攻高阶内容实现薪资跃迁。
请添加图片描述

👇👇扫码免费领取全部内容👇👇
请添加图片描述

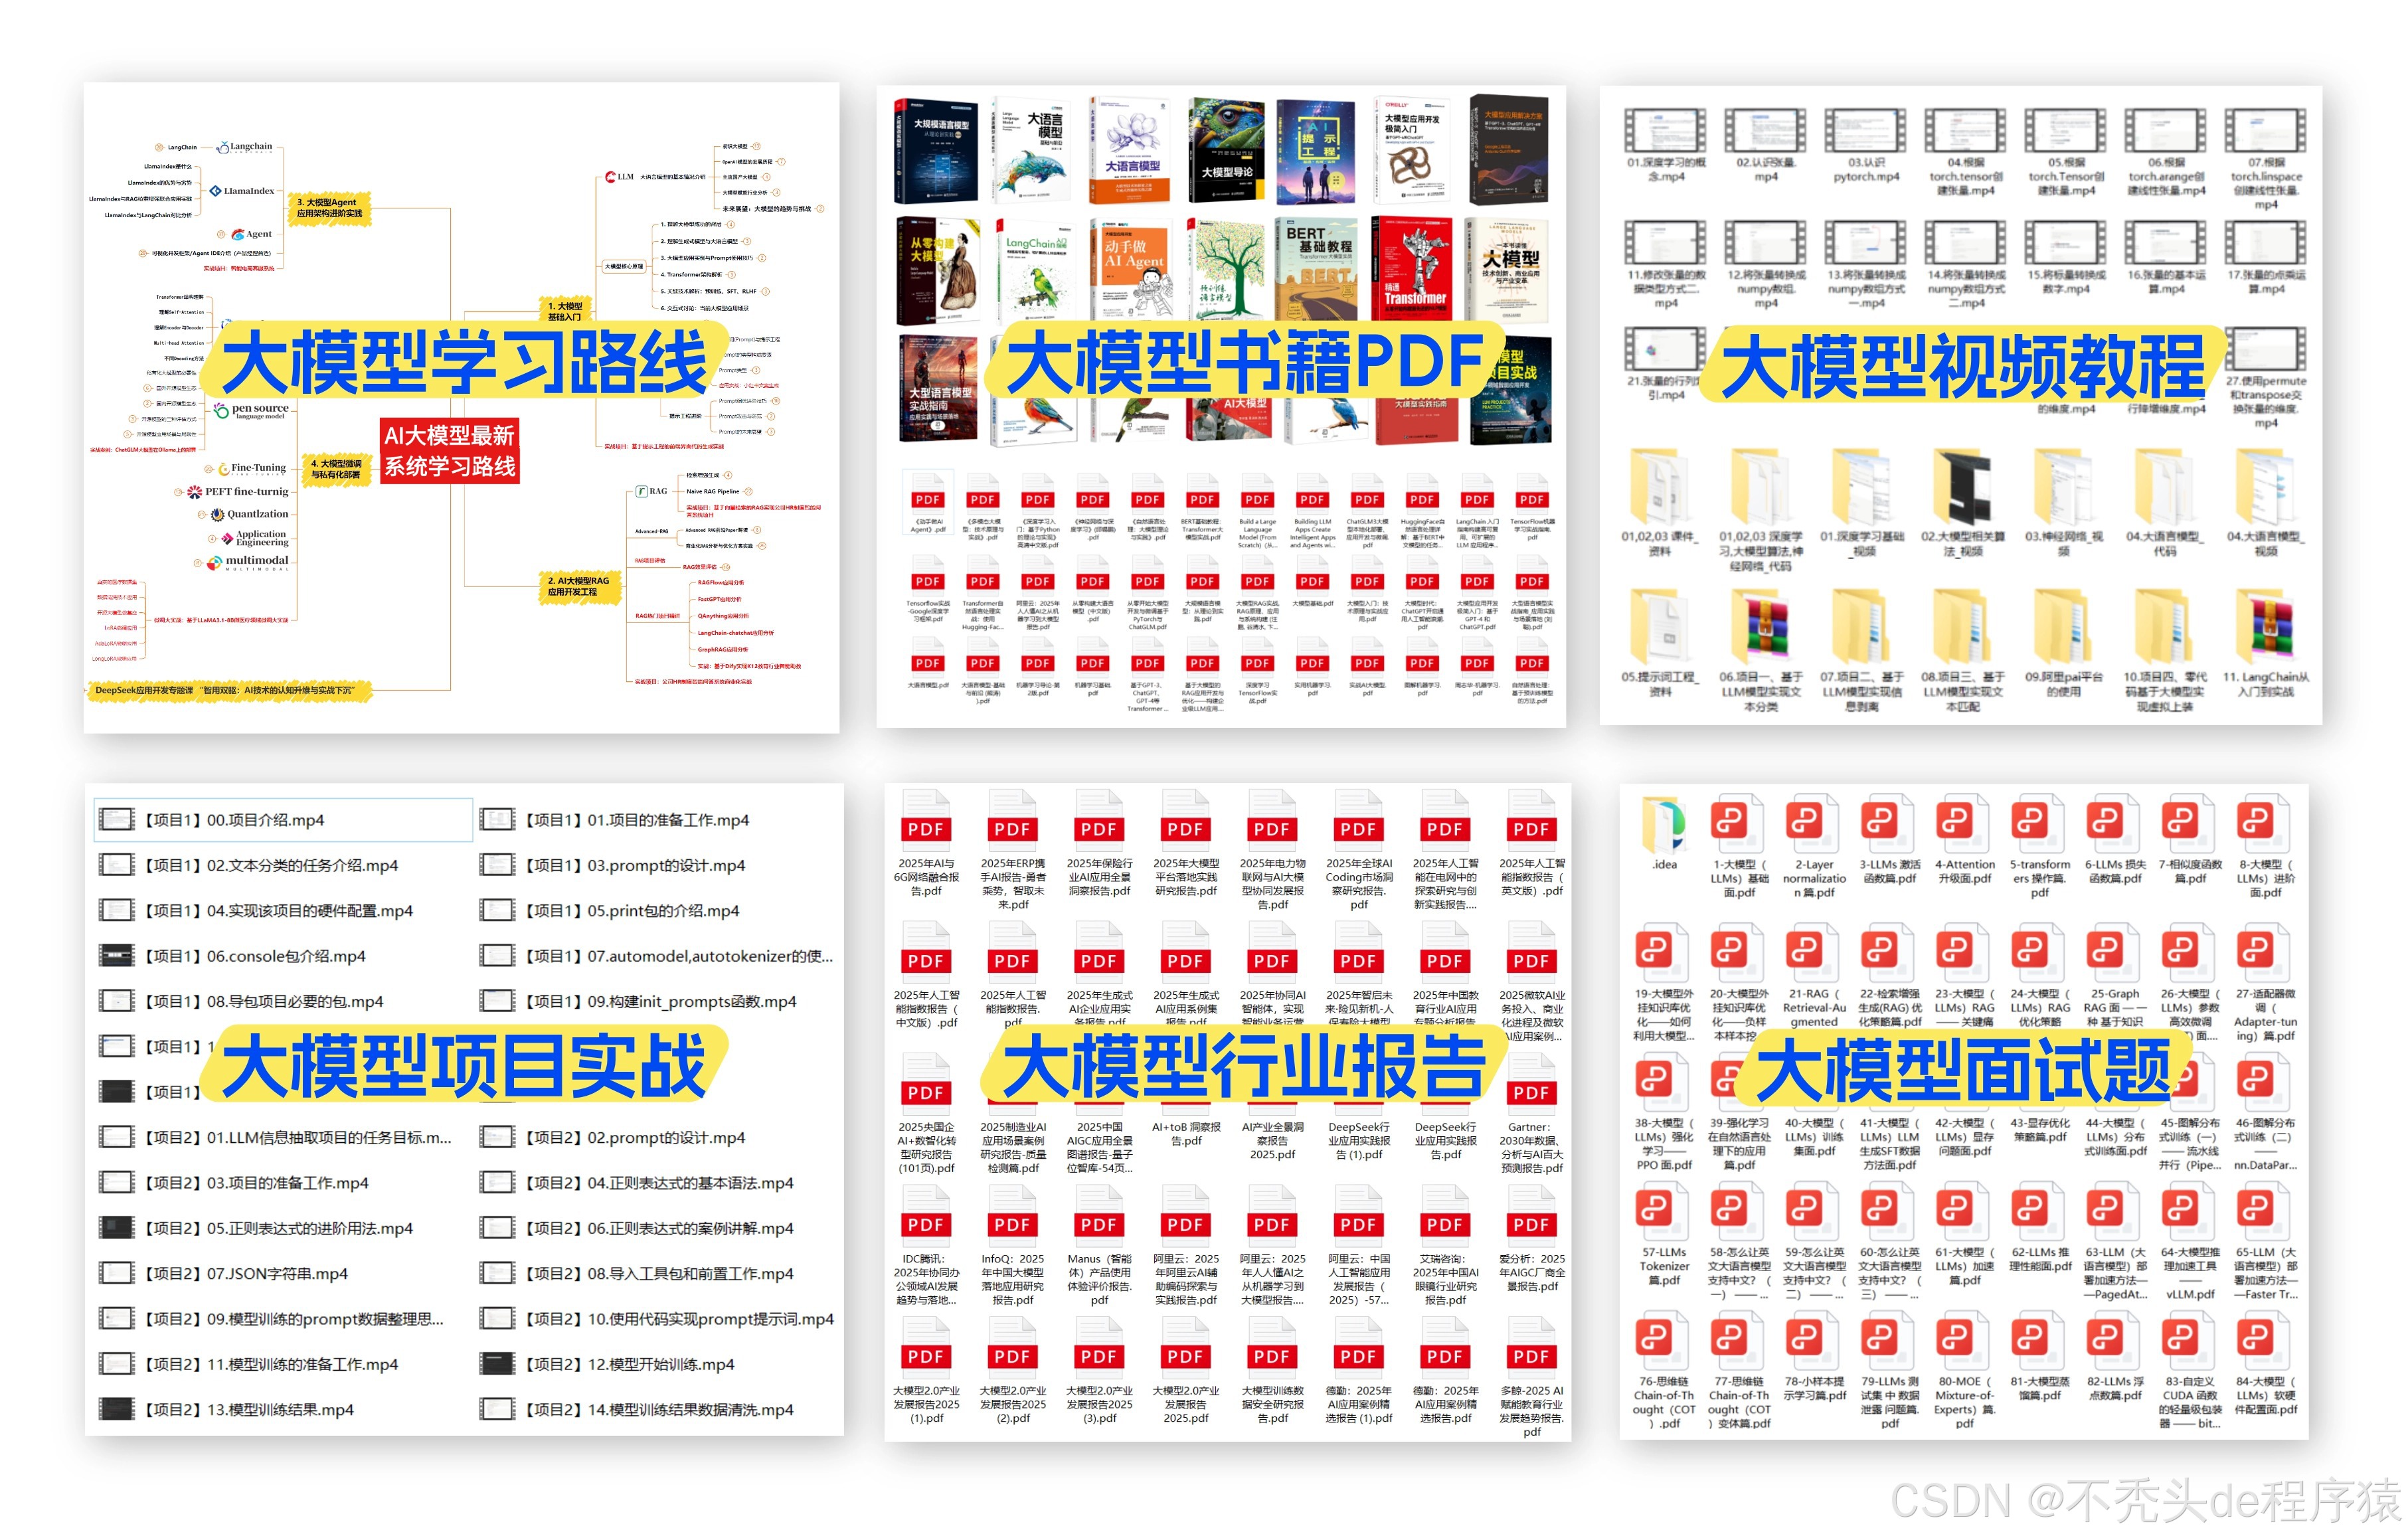
一、大模型专属系统化学习路线

整套学习路线参考今年企业用人标准和新手学习习惯定制,规划好从零基础到独立搭建企业级大模型项目的每一步,可以帮你规避八成以上无用功,躲开新手常见误区,高效完成技能升级。
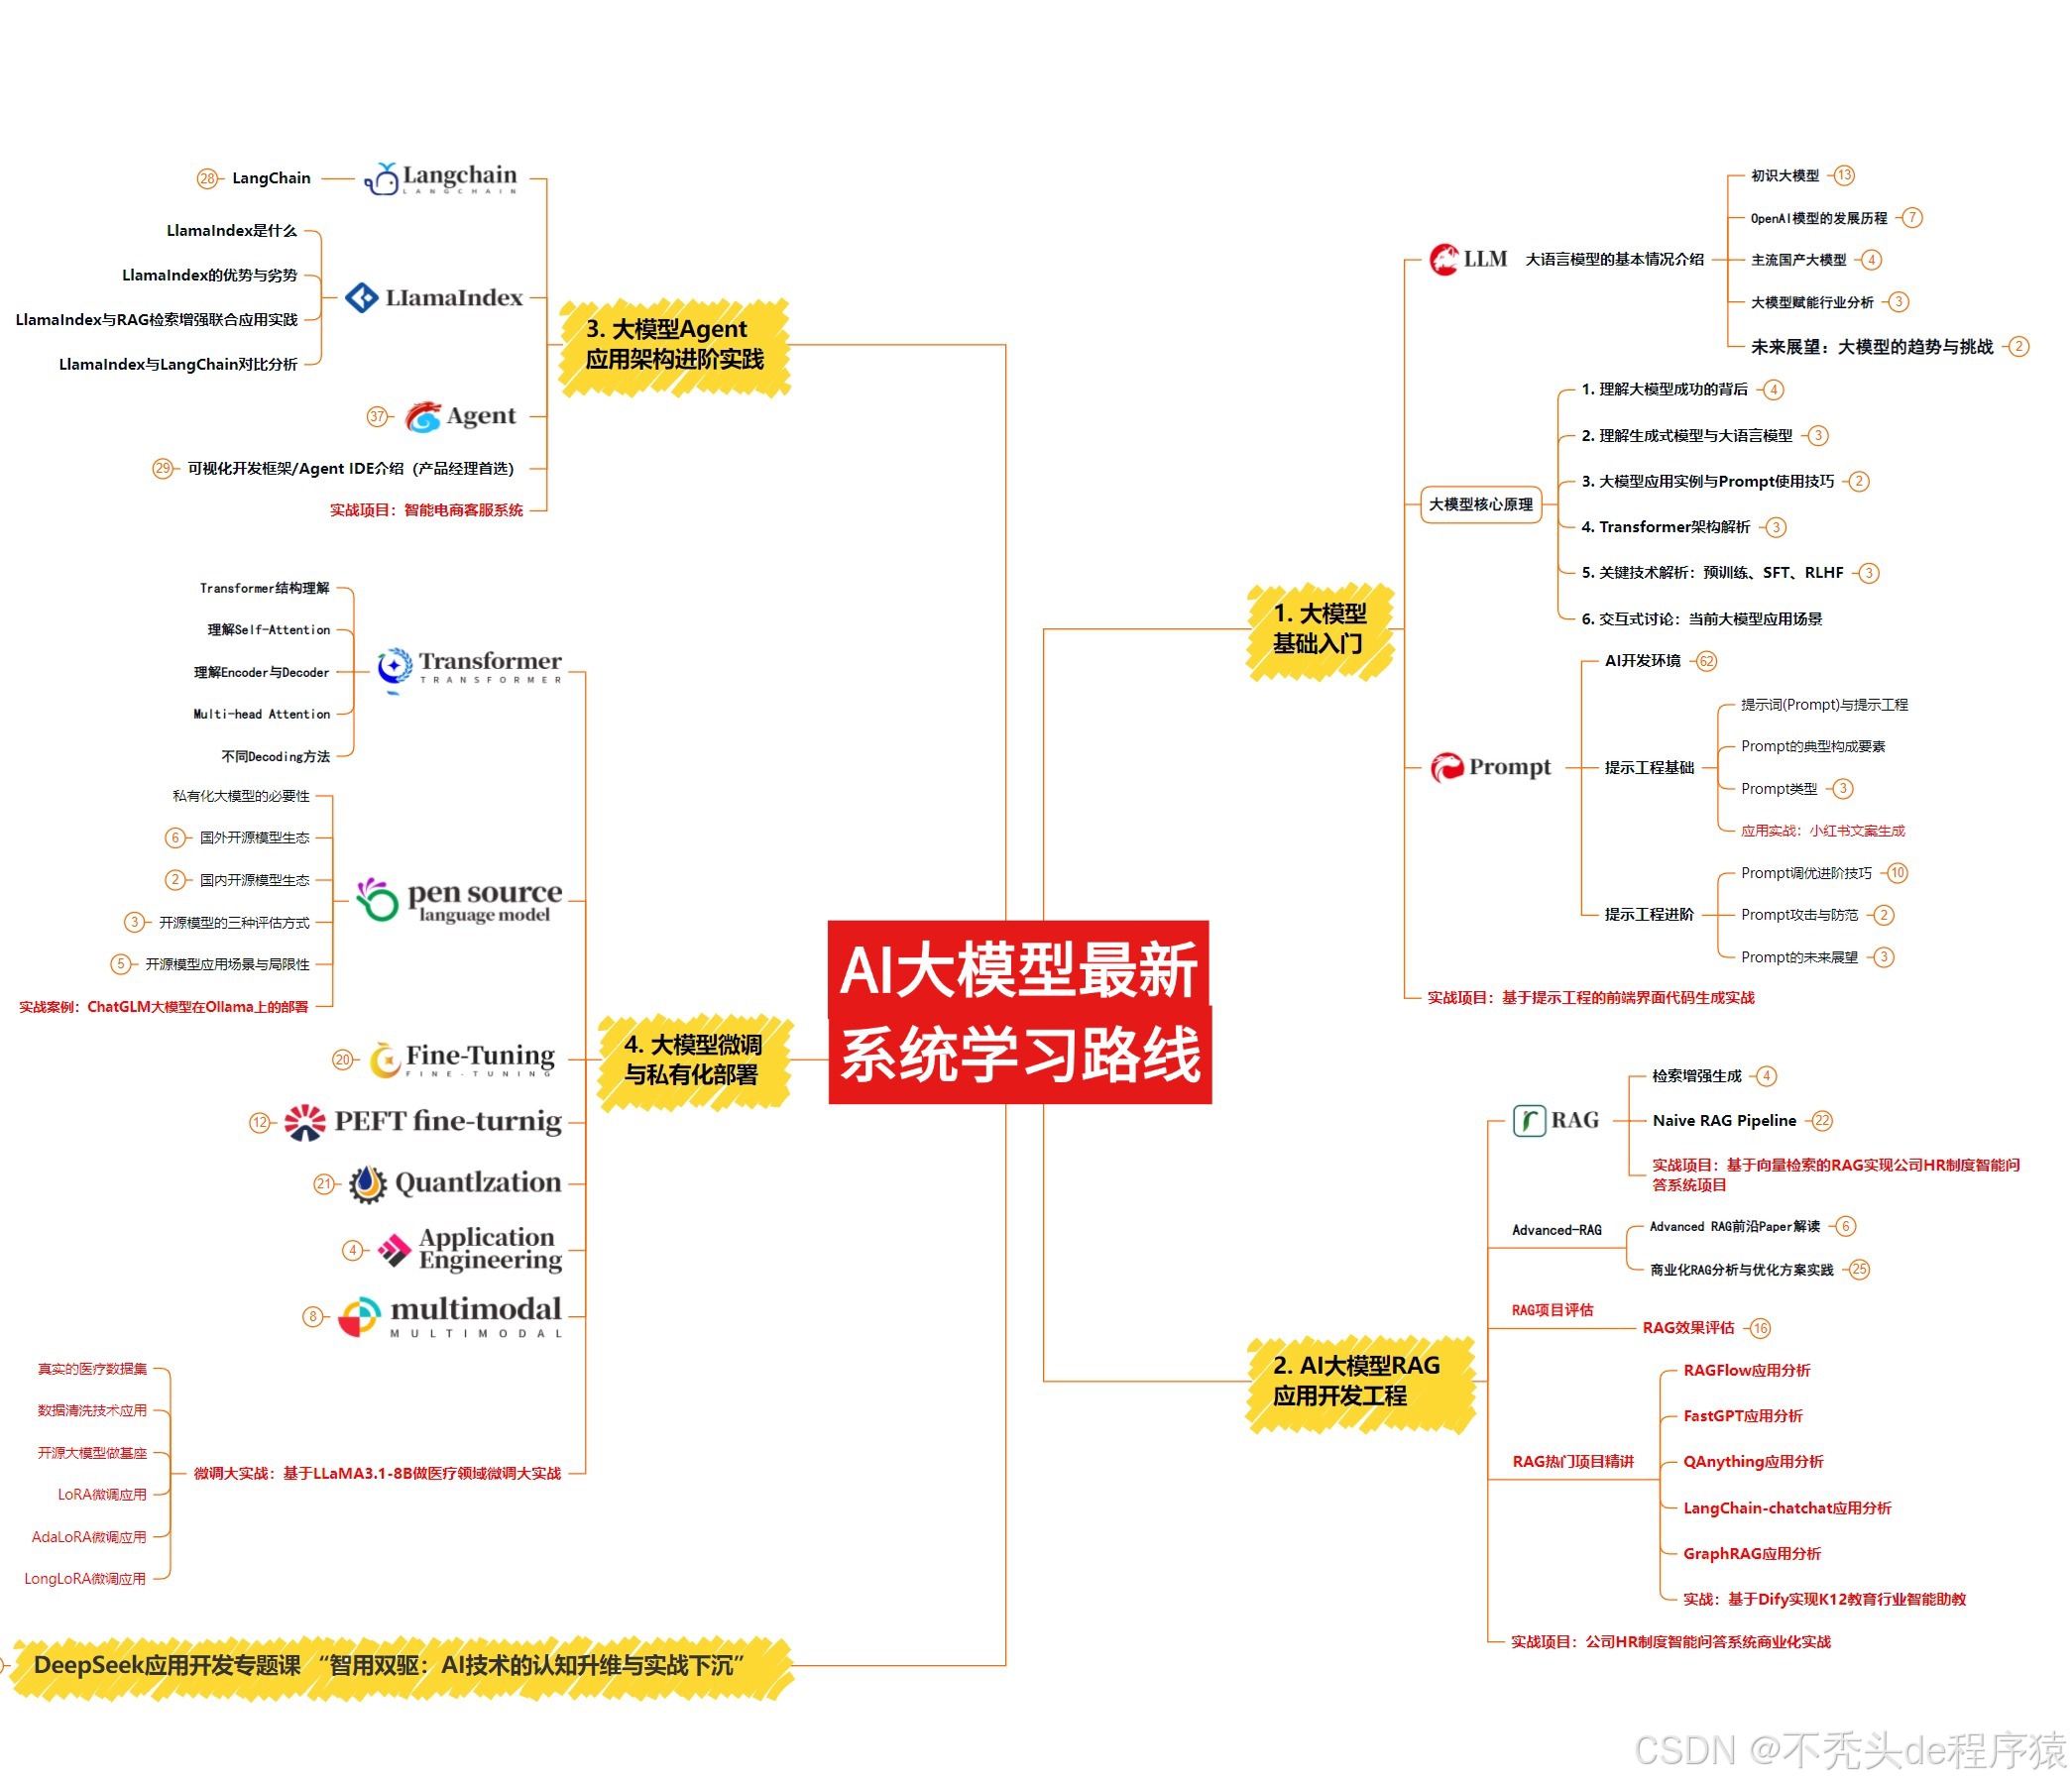
请添加图片描述

二、零基础到高阶实战全套视频教程

包含大模型基础认知、高阶提示词、RAG 检索增强、开源模型微调、向量数据库、私有化部署、AI‑Agent 智能体开发全套教学视频,跟着实操练习,降低自学门槛。
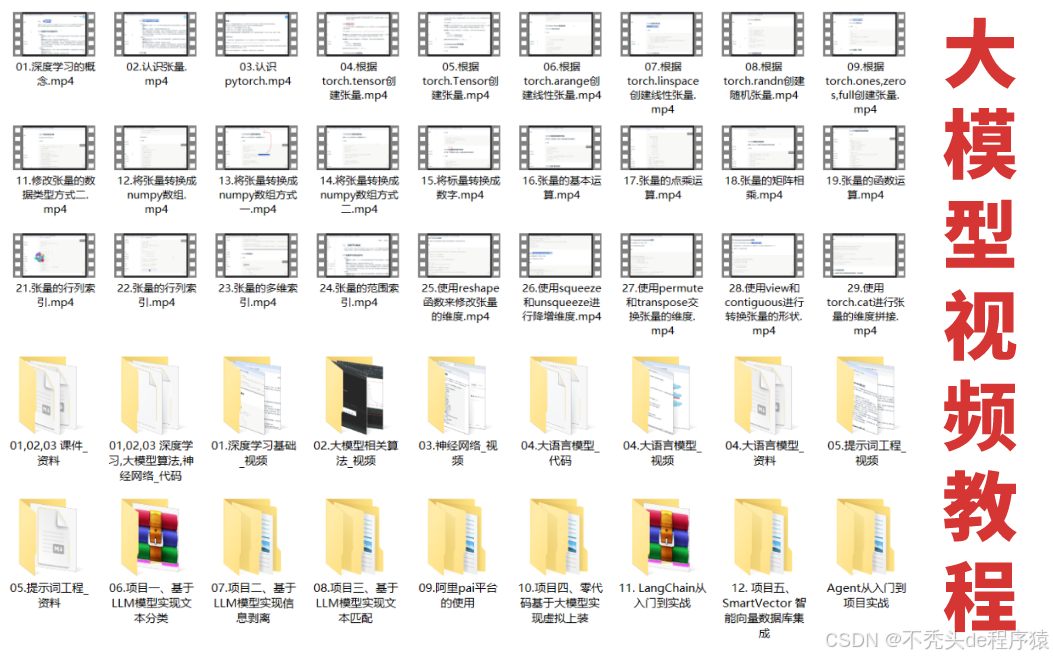
请添加图片描述

三、技术电子书与干货文档

收纳 2026 前沿技术要点,Transformer 底层架构、提示词工程、RAG 工程落地、轻量化微调、MCP 通信协议、vLLM 推理加速、大模型安全管控等全部具备详细讲解。
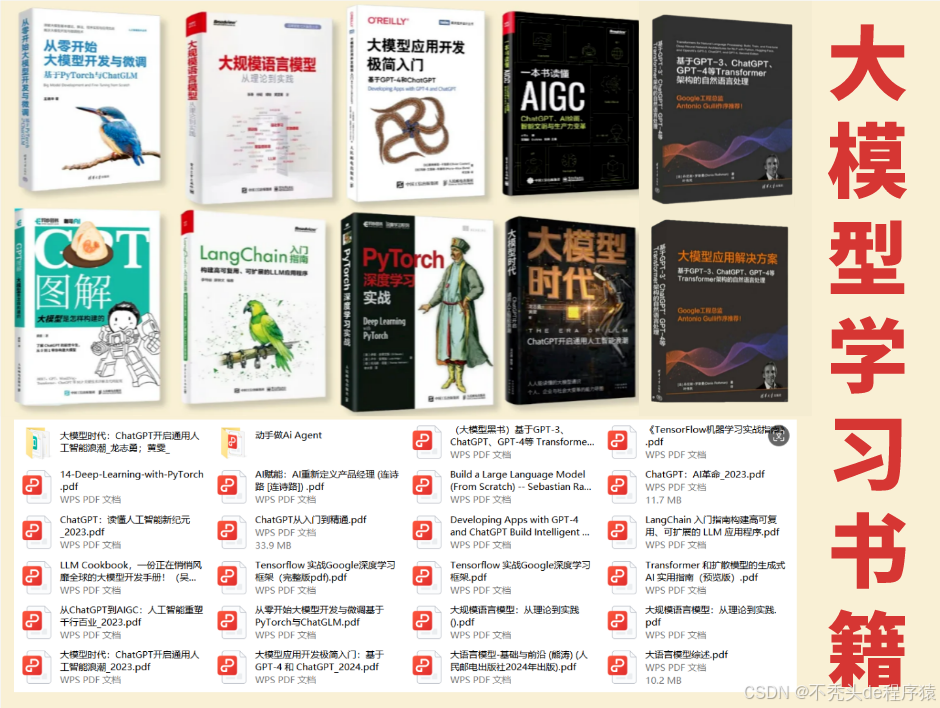
请添加图片描述

四、最新 AI 行业调研报告

汇集头部互联网厂商、第三方调研机构行业资料,国产主流大模型横向测评、企业 AI 落地白皮书、大模型岗位薪资调研报告,方便你紧跟行业风向,找准就业、副业方向。
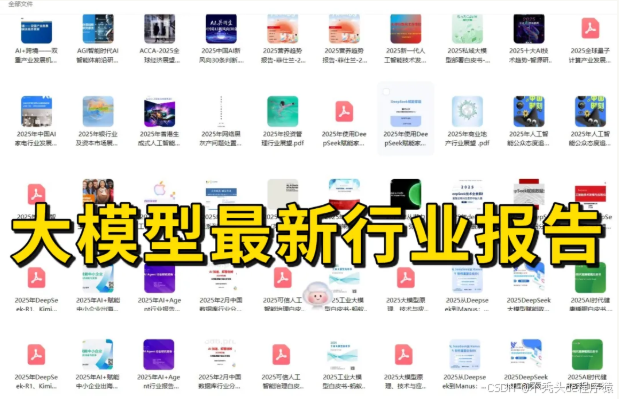
请添加图片描述

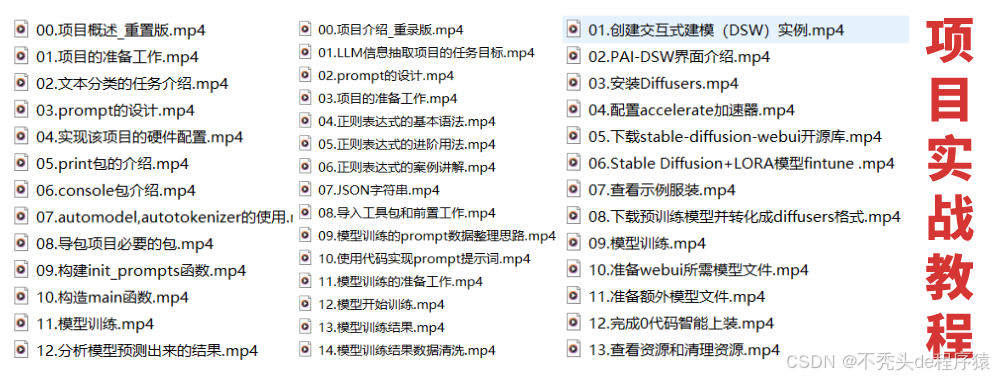
五、可直接运行实战项目以及配套源码

内置 DeepSeek 私有知识库搭建、多模态微调、RAG 企业文档问答、本地开源大模型部署、多智能体协同等当下热门实战案例,附带完整可运行源码。做完之后既可以锻炼实操能力,项目案例还能够直接写到简历用来求职。
请添加图片描述

六、2026 大厂大模型岗位面试真题

现如今大模型岗位面试早已不再只考察枯燥的理论原理,面试官重点考察项目落地、线上故障排查、业务改造经验。很多技术功底过硬的兄弟缺少针对性刷题准备,面试屡屡碰壁,这份真题补齐你的备考短板。
请添加图片描述

适配学习人群

零基础转行新人、Java 后端开发者、前端工程师、测试工程师、运维、数据分析从业者、打算拓展 AI 副业的职场人。

九十天可落地分阶段学习计划

第一阶段(10 天・基础应用入门)

学完之后你的大模型认知已经超越绝大多数普通使用者。旁人只会和 AI 闲聊对话,你可以定制专业提示词,编写简易代码,打通业务系统和大模型。

  • 熟悉各大主流大模型的商业化落地场景
  • 搞懂大模型产生智能的底层逻辑
  • 掌握借助 AI 提升工作效率的核心思路
  • 吃透 AI 应用业务架构、技术架构
  • 学习提示词结构、思维链、思维树实操
  • 了解提示词攻击风险以及对应的防御手段

第二阶段(30 天・RAG 高阶实战阶段)

主攻私有知识库搭建,开发专属对话智能体,吃透主流大模型开发框架,适配 Python、JavaScript 两类开发者。

  • 弄懂什么时候需要搭建检索增强知识库
  • 动手搭建 PDF 企业文档问答系统
  • 吃透 Embedding 向量嵌入基础知识点
  • 向量数据库实操、混合检索优化方案
  • 本地部署向量模型、性能调优

第三阶段(30 天・模型训练微调阶段)

到此阶段学习完毕,你已经具备应聘大模型岗位的硬性实力,可以独立微调垂直行业专属大模型,上手开源多模态大模型。

  • 分清预训练、全量微调、轻量化微调之间区别
  • 动手搭建简易神经网络小实验
  • 训练数据集清洗、搭建规范
  • Transformer 架构逐层拆解
  • 低成本本地微调实操方案

第四阶段(20 天・项目部署和商业闭环)

熟悉各类大模型吞吐量、推理成本参数,可以搞定云端、本地私有化部署,找寻适合自身的副业方向。

  • 大模型本地运行硬件配置挑选
  • 多款国产商用大模型优劣势对比
  • vLLM 推理加速部署教程
  • 公有云平台私有部署开源大模型实操案例
  • 完整开源 LLM 项目搭建流程
  • AI 项目内容安全、互联网算法备案相关知识

👇👇扫码免费领取全部内容👇👇!
请添加图片描述

不少兄弟疑惑,这套学习资源含金量如何?

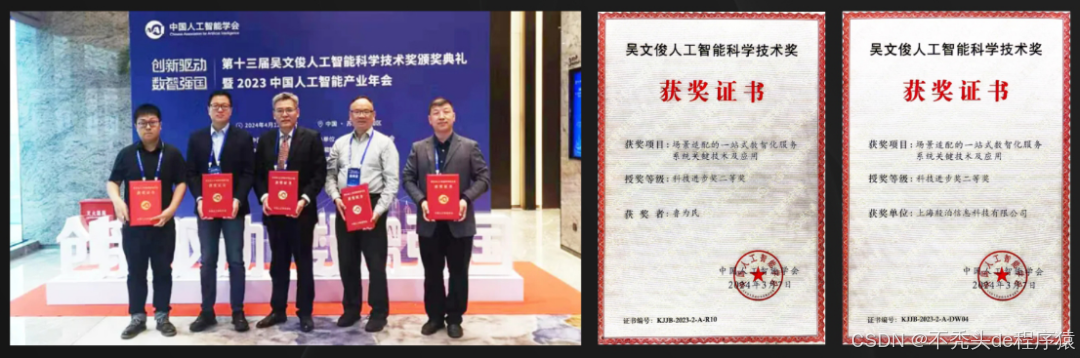
整套学习资料由我和鲁为民博士一同整理编撰。博士本科就读清华大学,于加州理工学院取得博士学位,现如今担任殷泊信息科技 CEO;他打造的 MoPaaS 云平台拿下国际权威机构认证,服务国家电网、航天科工等上千家大型企业;累计发表五十余篇 IEEE 专业论文,手握三十余项国内外 AI 相关专利,斩获吴文俊人工智能相关奖项。

整套教程全部立足于企业真实落地需求,摒弃花架子演示 Demo。不管你是零基础新手,还是拥有多年编程阅历的技术从业者,整套材料都能够助力你吃透大模型技术、实现薪资上涨、顺利转型 AI 高薪赛道。
请添加图片描述
请添加图片描述

完整版 AI 大模型全套学习资料已经上传 优快云,有需要的兄弟可以微信扫描 优快云 官方二维码免费领取,全套资源永久免费获取。
请添加图片描述

SGLang vs vLLM深度对比:大模型本地部署选型实战指南 大语言模型推理引擎是构建私有化AI应用的核心基础设施。vLLM以PagedAttention内存优化技术著称,主打高吞吐、低延迟与显存极致利用率;SGLang则定位为LLM编程框架,通过RadixAttention前缀缓存和Python原生控制流(如@function、fork)实现复杂Agent逻辑的内聚式开发。二者差异本质是工程效率与开发效率的权衡:vLLM适合标准化文本生成服务,SGLang胜在多工具调用、结构化输出与动态推理流程。当前主流百亿级模型(如Qwen3-32B、DeepSeek-V3)在A 阅读详情

相关推荐

RAG工程实战:从文档切分到高可用交付的完整方法论

RAG(检索增强生成)是一种将大语言模型与私有知识库深度耦合的基础性AI工程范式,其核心在于构建低失真、低延迟、高保真的知识通路。它不依赖模型微调或复杂提示词,而是通过语义检索、重排序与可控生成三层协同,解决‘模型知道但找不到’的关键瓶颈。技术价值体现在准确率跃升、响应确定性增强及知识可溯源性保障;广泛应用于智能客服、合规问答、SOP辅助决策等强专业场景。本文聚焦RAG落地中最易被忽视的工程细节——包括语义Chunking策略、OCR质量管控、混合检索设计、向量库选型与静默故障排查,覆盖从PDF预处理到AP

weixin_30621959的博客 426

警告!后端转大模型,这 3 类人必翻车(34 岁过来人亲述)

我做了8年Java后端,33岁,狠下心辞掉了干了5年的稳定工作,一头扎进了AI应用开发这个圈子。

python1234567_的博客 190

【WorkBuddy专栏14】专家不是「换皮」——角色切换、训练机制与自我进化深度拆解

WorkBuddy专栏14】专家不是「换皮」——角色切换、训练机制与自我进化深度拆解

AI人人懂 593

揭秘大模型MoE稀疏激活:参数量谣言与真实推理成本

混合专家(MoE)是现代大语言模型实现高效扩展的核心架构,其本质是在保持模型容量的同时,通过动态路由机制让每个token仅激活少量专家子网络。这一机制既非简单‘开关式’稀疏,也非全参数参与计算,而是涉及路由决策、专家加载、显存带宽调度与硬件协同的系统工程。理解MoE的关键在于厘清‘总参数量’与‘每token激活参数量’的本质区别——前者影响存储与部署规模,后者决定实时计算开销与延迟稳定性。当前广为流传的‘GPT-4使用2%参数’说法严重脱离MoE物理实现,实际中专家负载不均、路由开销显著、量化与并行策略深度

weixin_33991418的博客 689

【WorkBuddy专栏26】沙箱不是枷锁——WorkBuddy安全隔离机制的正确打开方式

【WorkBuddy专栏26】沙箱不是枷锁——WorkBuddy安全隔离机制的正确打开方式

AI人人懂 594

【WorkBuddy专栏48】学生党用WorkBuddy做基础科目作业——提高成绩的正确姿势

【WorkBuddy专栏48】学生党用WorkBuddy做基础科目作业——提高成绩的正确姿势

AI人人懂 216

DeepSeek-V3-0324中文能力深度解析:推理优化、前端辅助与安全部署实战

大语言模型的中文能力跃迁,已从单纯参数规模竞争转向真实业务场景下的语义精度、工程鲁棒性与合规可控性三重突破。DeepSeek-V3-0324并非通用性能升级,而是聚焦中文标点敏感建模、交互式重写机制与KV Cache INT8量化等关键技术,在政务公文生成、跨境电商客服响应、芯片设计代码辅助等强中文语境任务中实现‘接得住、改得准、跑得稳’。其核心价值在于将长文本理解、错误上下文修复、轻量实体图谱等能力内化为可部署、可监控、可灰度的生产级模块,而非依赖外部RAG或人工后处理。尤其在国产GPU集群适配、多卡通信

weixin_34072637的博客 401

Zynq实战:如何用AXI4-Stream To Video Out实现HDMI视频输出(附时序调试技巧)

本文详细介绍了基于Zynq平台使用AXI4-Stream To Video Out IP核实现HDMI视频输出的工程化解决方案。内容涵盖系统架构设计、AXI4-Stream接口优化、异步FIFO配置、时序同步调试技巧等核心环节,特别针对1080p60视频输出提供具体参数配置和性能优化建议,帮助开发者快速构建稳定的视频处理系统。

sql99的博客 462

2026轻量级AI模型落地指南:四款永久免费的生产级模型选型与协同架构

轻量级大模型正成为企业AI工程落地的新基建,其核心价值在于以确定性输出、低延迟响应和离线可控性,替代高成本通用API。本文围绕结构化信息抽取、多跳条件判断、长上下文语义一致性、中英混合术语理解等关键技术能力,解析Qwen2-0.5B-Instruct、Phi-3-mini-4K-instruct、Gemma-2B-it和TinyLlama-1.1B-Chat-v1.0四大生产验证模型的原理边界与部署范式。它们普遍支持CPU推理、全平台离线运行、LoRA微调及JSON强约束输出,适用于政务工单分派、工业故障诊

weixin_34007906的博客 370

openwrt编译及第一个安装包教程

Date: 2017.03.14 Made:SuperDeverloper Email: na1206@live.com Target: For mt7688 based board说明:本人在学习过程中走了不少弯路,希望本文档能为后来者提供便利。欢迎复制和使用本文档。本文档记录了搭建openwrt编译环境以及快速创建ipk包(openwrt上的安装程序)。本文档在实际应用中做过几次修改,以帮

SuperDevloper的博客 1万+

SQL注入-靶场通关 Less 1-21

打开Burp工具--打开内嵌浏览器--进入靶场第六关--打开拦截--输入?id=1',如果是正确的,说明不存在注入点,如果错误,说明存在注入点,这里是错误的,需要加上注释--+,在回车看结果是正确的,说明找到了注入点。工具,打开内嵌浏览器,打开拦截,输入http://127.0.0.1/sqli-labs-master/Less-9,然后发送到。id=1'--+,后面都注释了,单引号不闭合,报错说明是数字型SQL注入。设置休眠时间为10s,如果执行SQL语句就会加载,说明正确,存在注入点。

weixin_72104324的博客 1392

国产编程大模型选型指南:Kimi K2.5、GLM-5与M2.7工程化决策树

大语言模型在编程场景中的应用,本质是将AI能力嵌入真实软件工程流水线的过程。理解代码生成模型,需超越参数与榜单,聚焦其上下文处理机制、推理延迟特性、结构化输出稳定性及领域知识注入路径等底层工程约束。Kimi K2.5擅长长文本语义压缩与技术解释,GLM-5在企业级结构化代码(如OpenAPI/YAML)和私有知识微调上表现突出,而Minimax M2.7则以毫秒级首token响应和编译器级确定性生成见长,特别适配IDE实时补全与嵌入式开发等低延迟高可靠场景。本文提供基于输入形态、输出约束、交互粒度与容错边界

人生的意義在於修煉!修煉之路~ 469

大疆M3508电机使用CAN通信进行速度PID闭环控制详解

目录一. 简介二. 电机通信协议三. 电机PID控制原理四. 官方代码移植-中断接收五. 官方代码移植-查询接收 一. 简介 之前写过一篇文章STM32实现四驱小车(五)电机控制任务——电机速度PID控制算法,其中是以大疆的M3508电机为例进行讲解的(没错,就是RoboMaster机器人同款电机,不过Robomaster上的电机好像是小一号的M2006)。不少小伙伴私信问我要代码,我都回复说不是有官方demo么。后来问的人多了我大概明白了,看来官方的Demo还是有点门槛。可能是带FreeRTOS操作系统看

qq_30267617的博客 7万+

企业AI编程工具私有化部署实战指南:模型、服务与IDE三层闭环

AI编程工具正从开发者辅助演进为研发基础设施,其核心能力已不再仅限于代码生成质量,而更取决于能否在完全离线、等保合规、审计可控的前提下稳定运行。私有化部署的本质是模型权重本地加载、服务端全栈内网运行、IDE插件断网可用三者缺一不可的技术闭环。当前主流工具中,TRAE Solo与Tabnine Enterprise率先实现CPU级轻量化推理与全链路日志可溯,显著降低源码泄露与等保不达标风险;而GitHub Copilot Enterprise、Amazon Q等仍依赖公有云API,在政务、金融、医疗等强监管场

weixin_30561425的博客 439

基于HetConv与Dual策略的YOLOv8轻量化设计-CSPHet结构的优化与实现

在计算机视觉中,YOLOv8作为目标检测领域的最新版本,通过引入多种改进来提升检测精度和速度。然而,提升精度和保持实时性能往往需要更多参数与计算量。本文提出一种结合Dual思想与HetConv的新型轻量化结构,称为CSPHet。CSPHet能够在保持YOLOv8检测精度的基础上有效减少约70万参数量,实现模型的轻量化和速度的提升。HetConv(Heterogeneous Convolution)是一种混合卷积技术,通过同时使用1x1、3x3等不同大小的卷积核,来捕捉不同尺度的特征。

博客 1324

华为OD技术面八股文_C++_02

汇总华为OD面试C++方面计数八股文真题,提供详细解答。

qq_45776114的博客 766

2024年AI落地十大工程级论文实战指南

大模型与AI技术正从学术前沿加速走向工业现场,但‘可复现性’和‘硬件亲和力’成为横亘在实验室与产线之间的核心鸿沟。本文聚焦AI工程化落地的关键路径:解析轻量化知识蒸馏、FlashAttention-3硬件感知优化、Chain-of-Verification事实校验等真实可用的技术原理,强调其在低资源医疗影像、边缘工业质检、实时客服等场景中的模块化集成能力与显存/延迟实测表现。不谈SOTA排名,只讲哪些代码能今天clone、哪些组件可即插即用、哪些思路能直接迁移进你手头的项目——让算法工程师少踩坑,让CTO敢

cunbei2644的博客 423

2023年高教社杯全国大学生数学建模竞赛 E 题:《黄河水沙监测数据分析》真题解析与 MATLAB 解决方案

🏆 本文已收录于专栏:《滚雪球学数学建模(含历年真题)》,持续更新最新及历年数学建模竞赛资料,每篇内容力求做到“问题讲透、模型讲清、代码可用、论文可参考”,帮助你从零开始逐步建立完整的数学建模知识体系。

**My Coding Family** 904

11个可落地的AI增效工作流:前端开发者实战指南

AI增效工作流是将人工智能技术嵌入真实开发场景,实现重复任务自动化、决策过程结构化、知识沉淀显性化的工程实践方法。其核心原理在于用确定性规则替代经验依赖,通过工具链集成打通数据采集、内容生成、视觉呈现与效果追踪闭环。技术价值体现在可量化的时间压缩(如单任务耗时降低37%以上)、错误率下降及跨角色协同效率跃升。典型应用场景覆盖竞品监控、无障碍检测、会议纪要结构化、技术文档叙事转化等前端高频需求。本文聚焦Browse AI、Simplified、Notion AI等11个经8个月真实项目验证的工具组合,强调可持

wgyyh 404

0.嵌入式控制器EC实战 Embedded Controller开发概述

文章目录前言1.嵌入式控制器EC概述2.EC芯片框图(IT8502为例)3.General Purpose I/O Port (GPIO)4.SMBus(System Management Bus,系统管理总线)5.PWM、TACH6.KBC(KeyBoard Controller)7.PS/28.ADC(模数转换)总结 前言 例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。 1.嵌入式控制器EC概述 嵌入式控制器EC是挂在CPU的L

qq_30135687的博客 1万+

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【SenseNova U1.5 Lite实战】单卡4090D+32G内存家用设备也可高质量运行,多个国产芯片已验证,SenseNova多案例部署与踩坑

SenseNova-U1.5部署实战(多案例)

weixin_74701161的博客 1万+

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

从“文档懂王”到“工程落地”:我用LangChain造了一个会写代码的Agent

这篇文章摘要了作者在使用LangChain、LangGraph和Deep Agents开发编码助手项目时的经验教训与解决方案: 理想与现实的落差:作者发现官方文档的示例与真实项目存在巨大差距,200万字学习笔记在实际开发中失效,遭遇了token消耗失控、路径解析错误和死循环等问题。 框架关系解析:文章拆解了langchain-core(接口标准)、langgraph(运行时引擎)、langchain(应用框架)和deepagents(工具链)之间的层级依赖关系,指出这是从抽象到具体的实现链条。 开发环境搭建

General_zy的博客 610

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

HarmonyOS 6 效果实现:透明度 opacity 属性动态动画,消息提示淡入淡出效果,配合 animateTo 完成渐变动画

鸿蒙操作系统是华为推出的面向万物互联时代的分布式操作系统,其设计目标是实现跨设备的无缝协同与能力共享。在应用开发层面,鸿蒙提供了ArkUI框架,这是一套基于声明式编程范式的UI开发框架,支持开发者以极简的代码描述复杂的界面结构与交互逻辑。ArkTS是在TypeScript基础上扩展而来的语言,它在保留了TypeScript完整类型系统的基础上,针对UI声明式编程做了深度优化。ArkTS引入了一系列装饰器(Decorator)来标注组件、状态、构建器等概念,使编译器能够在编译期进行更严格的类型检查和性能优化。

2401_89578244的博客 292

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 390

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 219

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+
上一篇: 34岁,深耕 AI 工程化 5 年|想对想转型的同行说些真话
下一篇: 互联网已死,Agent永生!!!
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值