


一. 人工智能的基本概念
人工智能(Artificial Intelligence,简称AI)是一门研究如何使计算机完成以往需要人类智慧才能完成的任务的学科。这包括学习、推理、问题解决、感知、语言理解和决策等能力。
-
实现方式:
通过多种技术和方法来实现这些能力,包括:
-
机器学习 (Machine Learning):
使计算机能够从数据中学习模式和关系,而无需明确编程。
-
深度学习 (Deep Learning):
机器学习的一个子集,利用多层神经网络处理复杂数据,如图像和语音。
-
符号AI (Symbolic AI):
依赖于逻辑规则和知识表示来模拟人类推理过程。
-
专家系统 (Expert Systems):
模拟人类专家的决策过程,解决特定领域的复杂问题。
-
自然语言处理 (Natural Language Processing, NLP):
使计算机能够理解、解释和生成人类语言。
-
计算机视觉 (Computer Vision):
使计算机能够“看”并理解图像和视频内容。
-
机器人学 (Robotics):
将AI技术应用于物理机器人,使其能够感知环境并执行任务。
- 能力细化:
-
学习 (Learning):
系统能够从经验中改进其性能,例如通过观察数据、识别模式并调整其内部模型。
-
推理 (Reasoning):
系统能够根据已知信息和规则得出结论或进行逻辑推断。
-
问题解决 (Problem-solving):
系统能够分析问题并找到解决方案,通常通过搜索、规划或优化算法。
-
感知 (Perception):
系统能够通过传感器(如摄像头、麦克风)获取并解释环境信息。
-
语言理解 (Language Understanding):
系统能够理解人类口语或书面语的含义和意图。
-
决策 (Decision-making):
系统能够根据可用信息和目标选择最佳行动方案。
-
应用领域: AI
已经渗透到我们生活的方方面面,包括自动驾驶、医疗诊断、金融交易、智能助手、推荐系统、内容创作等。

二. 机器学习和深度学习
机器学习 (Machine Learning, ML)概念
机器学习是一种人工智能技术,它使计算机系统能够从数据中学习并改进其性能,而无需进行明确的编程。
核心思想: 通过分析大量数据,识别模式并做出预测或决策。
学习过程: 算法通过训练数据来构建模型,然后使用该模型对新数据进行预测或分类。
常见任务:
l 分类 (Classification): 将数据分配到预定义的类别中(例如,垃圾邮件检测)。
l 回归 (Regression): 预测连续值(例如,房价预测)。
l 聚类 (Clustering): 将相似的数据点分组(例如,客户细分)。
l 典型算法: 线性回归、逻辑回归、支持向量机 (SVM)、决策树、随机森林等。
深度学习 (Deep Learning, DL)概念
深度学习是一种机器学习的分支,其核心思想是通过模拟人脑神经网络的结构和功能来实现对数据的学习和模式识别。深度学习模型通常包含多层神经网络,这些网络被称为深度神经网络,因为它们具有多个层次的抽象表示。
l 监督学习(Supervised Learning):在监督学习中,算法通过从带有标签的训练数据中学习映射关系,然后将这种映射关系应用于新的、未标记的数据。
l 无监督学习(Unsupervised Learning):无监督学习中,算法没有标签的训练数据,其目标是发现数据中的结构或模式。
l 半监督学习(Semi-Supervised Learning):这是介于监督学习和无监督学习之间的一种学习方式,其中模型使用带有标签的一部分数据和无标签的一部分数据进行训练。
l 强化学习(Reinforcement Learning):强化学习是通过观察和与环境互动,从而学会选择动作以最大化某种潜在的累积奖励的一种学习方式。
l 特征工程(Feature Engineering):特征工程是指通过选择、转换、组合原始数据来创建新特征,以提高机器学习模型性能的过程。
三. AI算法:
随机森林(Random Forest)
随机森林是一种集成学习方法,通过构建多个决策树并对其结果进行平均或投票来提高模型的准确性和泛化能力。随机森林引入了随机性,通过对数据和特征的随机抽样来构建多个不同的决策树。


应用场景:
l 分类问题:随机森林广泛用于分类问题,如信用评分、医学诊断等。
l 回归问题:对于连续型的目标变量,随机森林也可以用于回归问题,如房价预测等。
l 特征选择:随机森林可以用于评估特征的重要性,帮助进行特征选择。
决策树(Decision Tree):
决策树是一种树状模型,用于对一个问题进行决策。它是一种监督学习算法,常用于分类和回归问题。决策树的构建过程就像是对一系列问题的回答,每个问题都涉及到某个特征,并且每个答案都导向树的下一层或叶子节点,最终得出一个决策。

聚类算法(Clustering Algorithms):
聚类算法是一类无监督学习算法,其目标是将数据集中的样本划分为不同的组,使得同一组内的样本彼此相似,而不同组之间的样本差异较大。聚类的目标是发现隐藏在数据中的结构,而无需事先知道这些结构的信息。(包括 K-Means、层次聚类等,用于在数据中发现自然分组)。
应用场景:
l 市场细分:将顾客划分为不同的市场细分,以便更好地定制市场策略。
l 图像分割:在计算机视觉中,聚类可用于图像分割,将相似的像素分为同一类别。
l 异常检测:通过聚类,可以发现与其他样本不同的样本,从而用于异常检测。
l 文档分类:将大量文档划分为不同的主题或类别,以帮助文本挖掘。

K-近邻(K-Nearest Neighbors, KNN):
KNN(K-Nearest Neighbors)是一种基本的机器学习算法,用于分类和回归。它基于一个简单的思想:新样本的类别或数值取决于其邻近的样本。
应用场景:
l 分类问题: KNN广泛应用于分类问题,如手写数字识别、垃圾邮件过滤等。
l 回归问题: 在回归问题中,KNN可以用于预测数值型数据,例如房价预测、股票价格预测等。
l 推荐系统: KNN可以用于推荐系统,基于用户行为或物品相似度为用户推荐物品。

BM25
BM25 是一个基于概率的检索模型,广泛应用于搜索引擎、推荐系统和各种信息检索任务中,用于对搜索结果进行排序。它的核心思想是,一个文档与查询的相关性取决于查询词在文档中出现的频率(Term Frequency, TF)以及这些词在整个文档集合中的稀有程度(Inverse Document Frequency, IDF),并对文档长度进行归一化处理。
工作原理
BM25 算法通过以下几个关键因素来计算文档与查询的相关性得分:
l 词频 (Term Frequency, TF):
查询词在文档中出现的次数越多,文档与查询的相关性越高。BM25 引入了一个饱和函数,这意味着词频的增加对相关性得分的贡献会逐渐减小,避免了过度强调高频词。这个饱和度由参数 k1 控制。
l 逆文档频率 (Inverse Document Frequency, IDF):
查询词在整个文档集合中越稀有,其重要性越高。例如,“Nokia”比“the”更有区分度。IDF 衡量了一个词的独特性,稀有词对相关性得分的贡献更大。
l 文档长度归一化 (Document Length Normalization):
较长的文档更有可能包含更多的查询词,这可能导致它们被错误地认为更相关。BM25 通过将文档长度与平均文档长度进行比较来调整得分,从而避免对长文档的偏爱。这个归一化程度由参数 b 控制。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
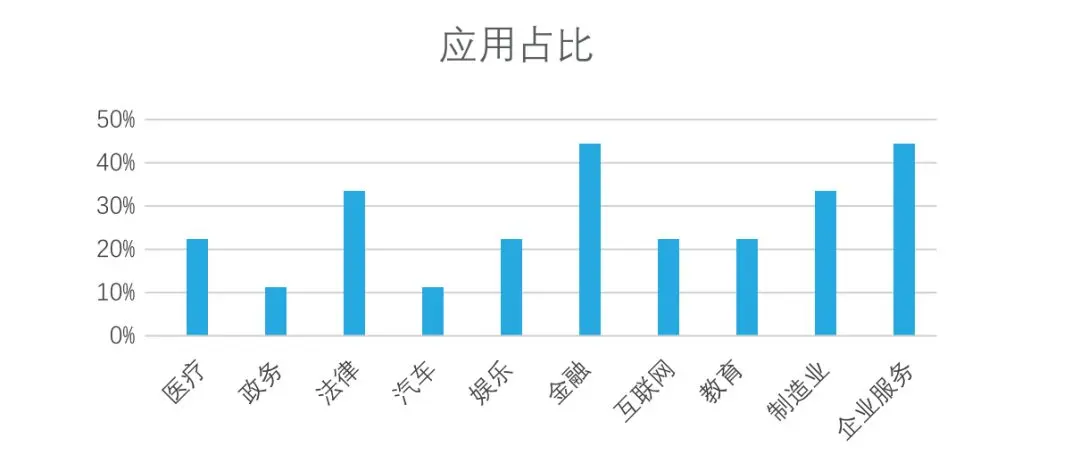
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
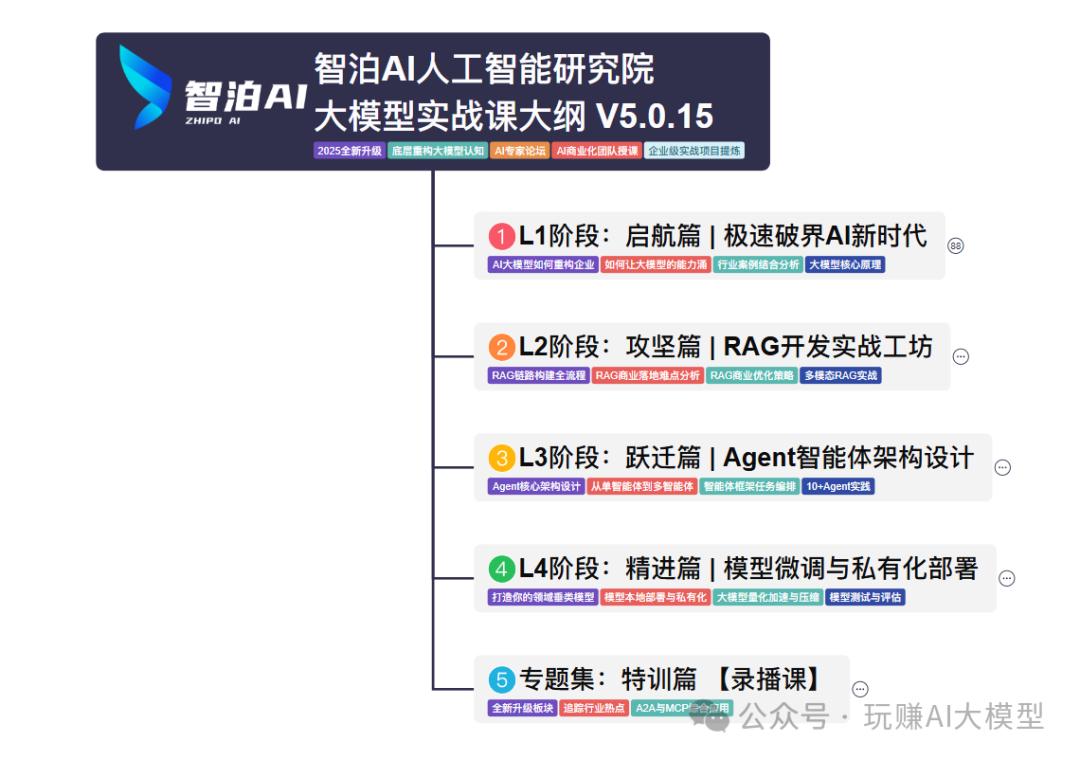
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
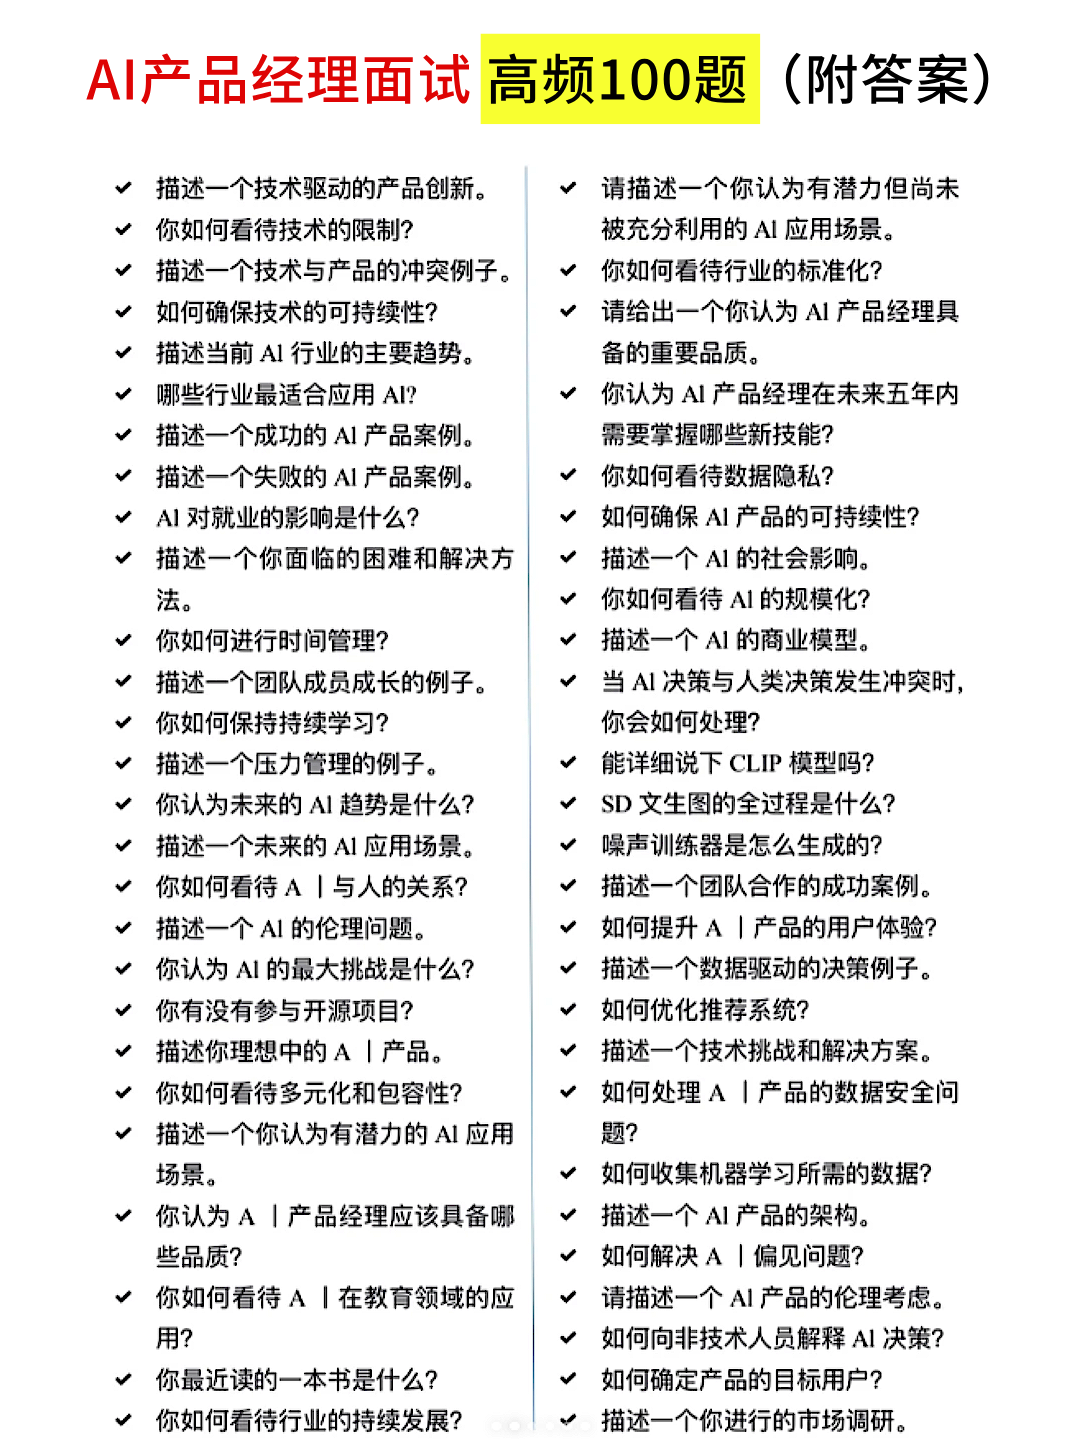
07 deepseek部署包+技巧大全
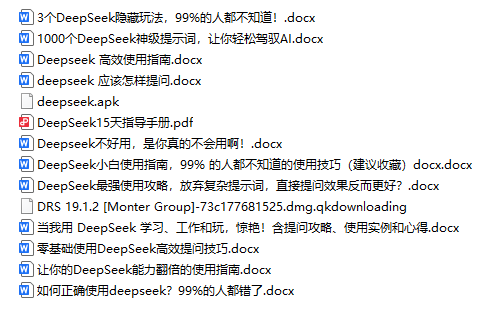
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 197


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


