


前序准备
在使用LangGraph之前,我们先提前准备一些基础知识以及相关概念的了解,方便我们了解后续代码
Langchain的ChatModel
我们清楚Agent的主要通过设计提示语,然后调用模型,完成对应流程与目标输出,所以在构建智能体之前,我们首先搞明白如何调用大模型,langchain框架提供了很多厂商的调用方式,使用文档在这里:
https://python.langchain.com/api_reference/langchain/chat_models.html
虽然聊天模型在底层使用了语言模型,但它们暴露的接口略有不同。它们并没有暴露“文本输入、文本输出”的 API,而是暴露了一个以“聊天消息”作为输入和输出的接口。下面支持的模型厂商列表
- openai -> langchain-openai
- anthropic -> langchain-anthropic
- azure_openai -> langchain-openai
- azure_ai -> langchain-azure-ai
- google_vertexai -> langchain-google-vertexai
- google_genai -> langchain-google-genai
- bedrock -> langchain-aws
- bedrock_converse -> langchain-aws
- cohere -> langchain-cohere
- fireworks -> langchain-fireworks
- together -> langchain-together
- mistralai -> langchain-mistralai
- huggingface -> langchain-huggingface
- groq -> langchain-groq
- ollama -> langchain-ollama
- google_anthropic_vertex -> langchain-google-vertexai
- deepseek -> langchain-deepseek
- ibm -> langchain-ibm
- nvidia -> langchain-nvidia-ai-endpoints
- xai -> langchain-xai
- perplexity -> langchain-perplexity
langchain有个方法init_chat_model,可以初始化各种厂商的模型,同时也提供了不同大模型的调用sdk,下面是deepseek的例子:
from langgraph.prebuilt import create_react_agent
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv

load_dotenv(verbose=True)

model=ChatDeepSeek(
    model="deepseek-chat",
    temperature=0,
    max_tokens=None,
    timeout=None,
    max_retries=2,
)

response=model.invoke("你好,请帮我生成一首儿歌")
print(response)
模型输出如下:
{
  "content": "当然!这里有一首温馨可爱的儿歌,适合小朋友传唱:\n\n---\n\n**《小星星的梦》**  \n✨🌙🎵  \n\n小星星,眨眼睛,  \n躲在云端放光明。  \n月亮船,摇啊摇,  \n载着梦儿轻轻飘。  \n\n萤火虫,提灯笼,  \n照亮花园小草丛。  \n风儿唱,树叶响,  \n伴我进入甜梦乡。  \n\n——  \n希望这首简单又充满画面感的儿歌能让宝贝喜欢!如果需要主题调整(比如动物、季节等),可以告诉我哦 😊",
  "additional_kwargs": {
    "refusal": null
  },
  "response_metadata": {
    "token_usage": {
      "completion_tokens": 120,
      "prompt_tokens": 12,
      "total_tokens": 132,
      "completion_tokens_details": null,
      "prompt_tokens_details": {
        "audio_tokens": null,
        "cached_tokens": 0
      },
      "prompt_cache_hit_tokens": 0,
      "prompt_cache_miss_tokens": 12
    },
    "model_name": "deepseek-chat",
    "system_fingerprint": "fp_feb633d1f5_prod0820_fp8_kvcache",
    "id": "866e04cd-5b1c-41cd-a7c6-a4140f4bcd05",
    "service_tier": null,
    "finish_reason": "stop",
    "logprobs": null
  },
  "id": "run--d3ffbc2a-d62b-49e5-8daa-981205501093-0",
  "usage_metadata": {
    "input_tokens": 12,
    "output_tokens": 120,
    "total_tokens": 132,
    "input_token_details": {
      "cache_read": 0
    },
    "output_token_details": {}
  }
}
这个JSON输出代表了一次完整的AI生成过程的结果,整个结构可以分为两大部分:核心内容和元数据。
核心内容
这是用户直接收到的、最有价值的部分:
content:主要输出内容。包含了AI生成的完整儿歌《小星星的梦》,包括标题、歌词、表情符号和友好的结束语。这是整个响应的核心。additional_kwargs:附加参数字典。这里的"refusal": null表明AI没有拒绝该请求,顺利完成了任务。
元数据 (系统信息)
这些字段提供了关于此次生成过程的背景技术信息,对开发者非常有用:
response_metadata:响应元数据。包含了本次请求的详细技术细节:-
token_usage:Token消耗统计。显示本次生成消耗了12个输入token(问题很短)和120个输出token(儿歌内容较长),总计132个token。model_name:模型标识。表明由deepseek-chat模型生成。finish_reason:完成原因。值为stop,表示模型正常输出了完整结果后结束。id,system_fingerprint: 本次请求的唯一标识和系统指纹,用于追踪和诊断。
usage_metadata:用量元数据。以另一种格式再次提供了token使用情况,并特别指出了没有从缓存读取("cache_read": 0),说明这是一个全新的计算请求。id:本次运行(Run)的唯一标识符。用于在日志系统中追踪这一次特定的AI调用。

ReAct框架
《REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS》,由Shunyu Yao等人撰写,发表在2023年的ICLR会议上。论文探讨了如何在大型语言模型(LLMs)中结合推理(reasoning)和行动(acting)的能力,以提高模型在语言理解和交互式决策制定任务中的性能。
其中ReAct Agent就是核心动作就是推理+行动

主要观点:
- 大型语言模型(LLMs)在语言理解和交互式决策制定任务中表现出色,但它们的推理(例如链式思维提示)和行动(例如行动计划生成)能力通常被分开研究。
- 作者提出了一种新的方法ReAct,它通过交错生成推理轨迹和特定于任务的行动,使两者之间产生更大的协同效应。推理轨迹帮助模型诱导、跟踪和更新行动计划,以及处理异常情况,而行动则允许它与外部资源(如知识库或环境)接口并收集额外信息。 具体步骤:
ReAct(Reasoning and Acting)是一种结合了**推理(reasoning)和行动(acting)**的方法,旨在提高大型语言模型(LLMs)在解决复杂任务时的性能和可解释性。ReAct的具体步骤如下:
- 定义任务和目标:首先,明确模型需要解决的任务和目标。这可能包括问题回答、事实验证、文本游戏或网页导航等。
- 生成推理轨迹:模型生成一系列推理轨迹,这些轨迹是模型内部的思考过程,用于解决问题。这些推理轨迹可能包括分解任务目标、提取重要信息、执行常识推理、指导搜索重构、跟踪进度和处理异常等。
- 执行行动:模型根据推理轨迹执行一系列行动。在ReAct中,行动是通过与外部环境(例如Wikipedia或其他知识库)的交互来完成的。行动可以是搜索信息、选择产品、选择选项或购买等。
- 交替推理和行动:在解决任务的过程中,模型会交替进行推理和行动。这意味着模型在执行每个行动后可能会生成新的推理轨迹,然后再执行新的行动,以此往复。
- 更新上下文:每次行动后,模型会更新上下文信息,这包括之前的行动、观察结果和新生成的推理轨迹。这种上下文更新帮助模型跟踪任务的当前状态,并为未来的推理和行动提供信息。
- 生成任务解决轨迹:通过上述步骤,模型生成一个包含行动、观察和推理轨迹的任务解决轨迹。这个轨迹不仅展示了模型如何解决问题,而且提供了模型决策的透明度,使得人类用户可以理解和评估模型的行为。
- 评估和调整:在实际应用中,模型生成的任务解决轨迹可能会被人类用户评估和调整。用户提供的反馈可以用来进一步指导模型的行为,或者在模型自身无法正确解决问题时进行干预。
下面是一个 ReAct 提示的示例(摘自论文,为简单起见缩短为一个示例):
问题 科罗拉多造山带东部区域延伸到的区域的海拔范围是多少? 思考 1 我需要搜索科罗拉多造山带,找到科罗拉多造山带东段延伸的区域,然后找到该区域的海拔范围。 操作 1 搜索 [科罗拉多造山带] 观察 1 科罗拉多造山带是科罗拉多及其周边地区造山运动的一段。 思考 2 它没有提到东部地区。所以我需要查一下东部地区。 操作 2 查找 [东部地区] 观察 2 (结果 1 / 1) 东部区域延伸至高平原,称为中原造山带。 思考 3 科罗拉多造山运动的东部区域延伸到高平原。所以我需要搜索高平原,找到它的海拔范围。 操作 3 搜索 [高平原] 观察 3 高平原指的是两个截然不同的陆地区域之一。 思考 4 我需要搜索高平原(美国) 操作 4 搜索 [高平原(美国)] 观察 4 高平原是大平原的一个分区。从东到西,高平原的海拔从 1800 到 7000 英尺 (550 到 2130 米) 不等。[3] 思考 5 高平原海拔高度从 1800 到 7000 英尺,所以答案是 1800 到 7000 英尺。 操作 5 结束 [1800 到 7000 英尺] ...
ReAct的核心在于通过交错的推理和行动步骤,使模型能够在执行任务时动态地进行推理和行动,从而提高任务解决的准确性和效率。这种方法特别适用于需要与外部环境交互并从中获取信息以支持决策的任务。
LangGraph快速入门
构建ReactAgent
为了避免缺少环境,我们可以提前安装langchain套件:
pip install langchain langchain-core
安装 LangGraph:
pip install -U langgraph
然后,使用预构建的组件(这里指的react_agent模板)创建智能体:
from langgraph.prebuilt import create_react_agent
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv

load_dotenv(verbose=True)

model=ChatDeepSeek(
    model="deepseek-chat",
    temperature=0,
    max_tokens=None,
    timeout=None,
    max_retries=2,
)

# response=model.invoke("你好,请帮我生成一首儿歌")
# print(response)
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f" {city}的天气是晴朗的!"

agent = create_react_agent(
    model=model,
    tools=[get_weather],
    prompt="你是一个有用的助手"
)

# Run the agent
response=agent.invoke(
    {"messages": [{"role": "user", "content": "请问北京的天气怎么样"}]}
)

print(response)
我们可以答应下输出,这里为了方便查看,我整理成json了:
{

"messages"
: [

    {

"type"
:
"human"
,

"content"
:
"请问北京的天气怎么样"
,

"additional_kwargs"
: {},

"response_metadata"
: {},

"id"
:
"72b50e8e-e20f-4d2e-8add-4993747de54e"

    },

    {

"type"
:
"ai"
,
{
  "messages": [
    {
      "type": "human",
      "content": "请问北京的天气怎么样",
      "additional_kwargs": {},
      "response_metadata": {},
      "id": "72b50e8e-e20f-4d2e-8add-4993747de54e"
    },
    {
      "type": "ai",
      "content": "我来帮您查询北京的天气情况。",
      "additional_kwargs": {
        "tool_calls": [
          {
            "id": "call_0_4e1e8263-3930-4052-b272-26d618f4301d",
            "function": {
              "arguments": "{\"city\": \"\\u5317\\u4eac\"}",
              "name": "get_weather"
            },
            "type": "function",
            "index": 0
          }
        ],
        "refusal": null
      },
      "response_metadata": {
        "token_usage": {
          "completion_tokens": 28,
          "prompt_tokens": 155,
          "total_tokens": 183,
          "completion_tokens_details": null,
          "prompt_tokens_details": {
            "audio_tokens": null,
            "cached_tokens": 0
          },
          "prompt_cache_hit_tokens": 0,
          "prompt_cache_miss_tokens": 155
        },
        "model_name": "deepseek-chat",
        "system_fingerprint": "fp_feb633d1f5_prod0820_fp8_kvcache",
        "id": "41400771-a017-484c-970c-d697720af00b",
        "service_tier": null,
        "finish_reason": "tool_calls",
        "logprobs": null
      },
      "id": "run--09d15b9b-e85f-4ec2-968a-ca1051321606-0",
      "tool_calls": [
        {
          "name": "get_weather",
          "args": {
            "city": "北京"
          },
          "id": "call_0_4e1e8263-3930-4052-b272-26d618f4301d",
          "type": "tool_call"
        }
      ],
      "usage_metadata": {
        "input_tokens": 155,
        "output_tokens": 28,
        "total_tokens": 183,
        "input_token_details": {
          "cache_read": 0
        },
        "output_token_details": {}
      }
    },
    {
      "type": "tool",
      "content": "北京的天气是晴朗的!",
      "name": "get_weather",
      "id": "f47a51d0-9b26-4eb4-8d3b-f1e4f02520bb",
      "tool_call_id": "call_0_4e1e8263-3930-4052-b272-26d618f4301d"
    },
    {
      "type": "ai",
      "content": "根据查询结果,北京目前的天气是晴朗的!天气状况很好,适合外出活动。如果您需要更详细的天气信息(如温度、湿度、风力等),请告诉我,我可以为您提供更全面的天气情况。",
      "additional_kwargs": {
        "refusal": null
      },
      "response_metadata": {
        "token_usage": {
          "completion_tokens": 45,
          "prompt_tokens": 187,
          "total_tokens": 232,
          "completion_tokens_details": null,
          "prompt_tokens_details": {
            "audio_tokens": null,
            "cached_tokens": 128
          },
          "prompt_cache_hit_tokens": 128,
          "prompt_cache_miss_tokens": 59
        },
        "model_name": "deepseek-chat",
        "system_fingerprint": "fp_feb633d1f5_prod0820_fp8_kvcache",
        "id": "63d43631-9171-4fb0-98c0-6470313d7798",
        "service_tier": null,
        "finish_reason": "stop",
        "logprobs": null
      },
      "id": "run--47611254-733a-4d55-b002-96a17b131a02-0",
      "usage_metadata": {
        "input_tokens": 187,
        "output_tokens": 45,
        "total_tokens": 232,
        "input_token_details": {
          "cache_read": 128
        },
        "output_token_details": {}
      }
    }
  ]
}
这是一个多轮对话的完整记录,描述了用户查询北京天气后,AI调用工具并返回结果的整个过程。对话包含4条消息:
用户提问 (HumanMessage): 询问"北京的天气怎么样"AI响应 (AIMessage): 回复将帮忙查询,并调用天气查询工具 get_weather,参数为 {“city”: “北京”}工具返回 (ToolMessage): 工具执行结果返回"北京的天气是晴朗的!"AI最终回复 (AIMessage): 整合工具结果,告诉用户北京天气晴朗,适合外出,并询问是否需要更多详细信息
记忆持久化
为了允许与智能体进行多轮对话,我们需要在创建智能体时提供检查点来启用持久性thread_id。在运行时,LangGraph需要提供一个配置,其中包含对话(会话)的唯一标识符,下面是一个例子:
from langgraph.prebuilt import create_react_agent
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv
from langgraph.checkpoint.memory import InMemorySaver
load_dotenv()
model=ChatDeepSeek(
    model="deepseek-chat",
    temperature=0,
    max_retries=2,
)
# 定义一个简单的工具函数
def get_weather(city: str) -> str:
    """获取天气信息"""
    weather_data = {
        "北京": "晴天,25°C",
        "上海": "多云,28°C",
        "深圳": "小雨,26°C"
    }
    return weather_data.get(city, f"{city}天气暂无数据")

# 创建内存检查点
checkpointer = InMemorySaver()

# 创建带记忆的代理
agent = create_react_agent(
    model=model,
    tools=[get_weather],
    checkpointer=checkpointer
)

# 配置会话ID
config = {"configurable": {"thread_id": "chat-001"}}

# 第一轮对话
print("=== 第一轮对话 ===")
response1 = agent.invoke(
    {"messages": [{"role": "user", "content": "你好,我叫张三,请查询北京天气"}]},
    config
)
print("用户: 你好,我叫张三,请查询北京天气")
print("助手:", response1['messages'][-1].content)

# 第二轮对话 - 测试记忆功能
print("\n=== 第二轮对话 ===")
response2 = agent.invoke(
    {"messages": [{"role": "user", "content": "我叫什么名字?"}]},
    config
)
print("用户: 我叫什么名字?")
print("助手:", response2['messages'][-1].content)

# 第三轮对话 - 继续使用记忆
print("\n=== 第三轮对话 ===")
response3 = agent.invoke(
    {"messages": [{"role": "user", "content": "上海天气怎么样?"}]},
    config
)
print("用户: 上海天气怎么样?")
print("助手:", response3['messages'][-1].content)
下面是输出:
=== 第一轮对话 === 用户: 你好,我叫张三,请查询北京天气 助手: 根据查询结果,北京目前的天气情况是: - 天气状况:晴天 - 温度:25°C 今天北京的天气很不错呢,是个晴朗的好天气,温度也很舒适! === 第二轮对话 === 用户: 我叫什么名字? 助手: 你刚才告诉我你叫张三!很高兴认识你,张三! === 第三轮对话 === 用户: 上海天气怎么样? 助手: 根据查询结果,上海目前的天气情况是: - 天气状况:多云 - 温度:28°C 上海今天是多云天气,温度比北京稍高一些,28°C,也是比较舒适的天气呢!
结构化输出
要生成符合特定模式的结构化响应,我们可以使用response_format参数。该模式可以使用Pydantic模型或定义TypedDict。结果可通过structured_response字段访问。
我们设置好调用大模型:
from langgraph.prebuilt import create_react_agent
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv
from pydantic import BaseModel
from typing import List, Optional
load_dotenv()
model=ChatDeepSeek(
    model="deepseek-chat",
    temperature=0,
    max_retries=2,
)
下面是一个例子:
# 定义工具函数
def get_weather(city: str) -> str:
    """获取城市天气信息"""
    weather_data = {
        "北京": "晴天,气温25°C,空气质量良好",
        "上海": "多云转阴,气温28°C,湿度80%",
        "深圳": "小雨,气温26°C,风力3级",
        "广州": "阴天,气温30°C,空气质量中等"
    }
    return weather_data.get(city, f"{city}暂无天气数据")

def search_restaurant(city: str, cuisine: str = "") -> str:
    """搜索餐厅信息"""
    restaurants = {
        "北京": "老北京炸酱面馆、全聚德烤鸭店、海底捞火锅",
        "上海": "小笼包店、本帮菜馆、外滩西餐厅",
        "深圳": "潮汕牛肉火锅、茶餐厅、海鲜大排档"
    }
    return restaurants.get(city, f"{city}暂无餐厅推荐")

# 示例1: 天气查询结构化响应
class WeatherResponse(BaseModel):
    """天气查询响应格式"""
    city: str                    # 城市名称
    conditions: str              # 天气状况
    temperature: Optional[str]   # 温度信息
    additional_info: Optional[str]  # 附加信息

# 创建天气查询代理
weather_agent = create_react_agent(
    model=model,
    tools=[get_weather],
    response_format=WeatherResponse
)

print("=== 示例1: 天气查询结构化输出 ===")
weather_response = weather_agent.invoke(
    {"messages": [{"role": "user", "content": "查询北京的天气情况"}]}
)
然后我们可以通过字典属性来获取对应的输出值:
print("用户: 查询北京的天气情况")
print("结构化响应:")
print(f"  城市: {weather_response['structured_response'].city}")
print(f"  天气状况: {weather_response['structured_response'].conditions}")
print(f"  温度: {weather_response['structured_response'].temperature}")
print(f"  附加信息: {weather_response['structured_response'].additional_info}")
输出如下:
=== 示例1: 天气查询结构化输出 ===
用户: 查询北京的天气情况
结构化响应:
  城市: 北京
  天气状况: 晴天
  温度: 25°C
  附加信息: 空气质量良好
我们定义一个餐厅推荐结构化输出:
# 示例2: 餐厅推荐结构化响应
class RestaurantRecommendation(BaseModel):
    """餐厅推荐响应格式"""
    city: str                           # 城市
    restaurants: List[str]              # 餐厅列表
    cuisine_type: Optional[str]         # 菜系类型
    recommendation_reason: str          # 推荐理由

# 创建餐厅推荐代理
restaurant_agent = create_react_agent(
    model=model,
    tools=[search_restaurant],
    response_format=RestaurantRecommendation
)

print("\n=== 示例2: 餐厅推荐结构化输出 ===")
restaurant_response = restaurant_agent.invoke(
    {"messages": [{"role": "user", "content": "推荐上海的好餐厅"}]}
)

print("用户: 推荐上海的好餐厅")
print("结构化响应:")
print(f"  城市: {restaurant_response['structured_response'].city}")
print(f"  餐厅列表: {restaurant_response['structured_response'].restaurants}")
print(f"  菜系类型: {restaurant_response['structured_response'].cuisine_type}")
print(f"  推荐理由: {restaurant_response['structured_response'].recommendation_reason}")
输出如下:
=== 示例2: 餐厅推荐结构化输出 ===
用户: 推荐上海的好餐厅
结构化响应:
  城市: 上海
  餐厅列表: ['小笼包店', '本帮菜馆', '外滩西餐厅']
  菜系类型: None
  推荐理由: 上海作为国际化大都市,既有传统本帮菜和小笼包等特色美食,也有高档西餐厅,能够满足不同口味需求
最后我们可以将这两个例子整合成一个旅行的综合查询结构化输出样例:
# 示例3: 综合查询结构化响应
class TravelInfo(BaseModel):
    """旅行信息响应格式"""
    destination: str                    # 目的地
    weather_info: str                   # 天气信息
    restaurant_suggestions: List[str]   # 餐厅建议
    travel_tips: List[str]              # 旅行建议
    overall_rating: str                 # 总体评价

# 创建旅行助手代理
travel_agent = create_react_agent(
    model=model,
    tools=[get_weather, search_restaurant],
    response_format=TravelInfo
)

print("\n=== 示例3: 旅行信息结构化输出 ===")
travel_response = travel_agent.invoke(
    {"messages": [{"role": "user", "content": "我想去深圳旅游,给我一些建议"}]}
)

print("用户: 我想去深圳旅游,给我一些建议")
print("结构化响应:")
print(f"  目的地: {travel_response['structured_response'].destination}")
print(f"  天气信息: {travel_response['structured_response'].weather_info}")
print(f"  餐厅建议: {travel_response['structured_response'].restaurant_suggestions}")
print(f"  旅行建议: {travel_response['structured_response'].travel_tips}")
print(f"  总体评价: {travel_response['structured_response'].overall_rating}")
我们可以看到输出如下:
=== 示例3: 旅行信息结构化输出 ===
用户: 我想去深圳旅游,给我一些建议
结构化响应:
  目的地: 深圳
  天气信息: 小雨,气温26°C,风力3级
  餐厅建议: ['潮汕牛肉火锅', '茶餐厅', '海鲜大排档']
  旅行建议: ['携带雨具出行,准备轻便夏装和薄外套', '使用深圳地铁系统出行,下载"深圳通"APP', '参观世界之窗、欢乐谷、深圳湾公园等景点', '考虑去香港一日游(需提前办理港澳通行证)']
  总体评价: 现代化大都市,购物和美食天堂,交通便利,适合城市旅游和商务出行
LangGraph教程合集
- 1⃣ 官方文档 & 快速入门
LangGraph 官方教程站(持续更新)

https://langchain-ai.github.io/langgraph/
- 2⃣ 中文翻译 + 入门级实战
LangGraph 官方文档翻译 1:快速入门

https://blog.youkuaiyun.com/lovechris00/article/details/148014663
- 3⃣ 进阶实战(带完整源码)
构建数学 Agent:工具调用 + 结果验证 + 流程总结

文章:https://blog.youkuaiyun.com/sjxgghg/article/details/147250916

源码:https://github.com/JieShenAI/csdn/tree/main/25/04/math_agent
- 4⃣ 视频课程(2025 年 3 月录制,B 站)
《2025 吃透 LangGraph 全套教程》47 集合集

https://www.bilibili.com/video/BV1wsoiYQENQ/
- 5⃣ 开源示例合集
GitHub 官方示例仓库

https://github.com/langchain-ai/langgraph-example

Awesome LangGraph 精选项目列表

https://github.com/von-development/awesome-LangGraph

Tools_and_Agents:多工具 Agent 实战代码

https://github.com/anmolaman20/Tools_and_Agents
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
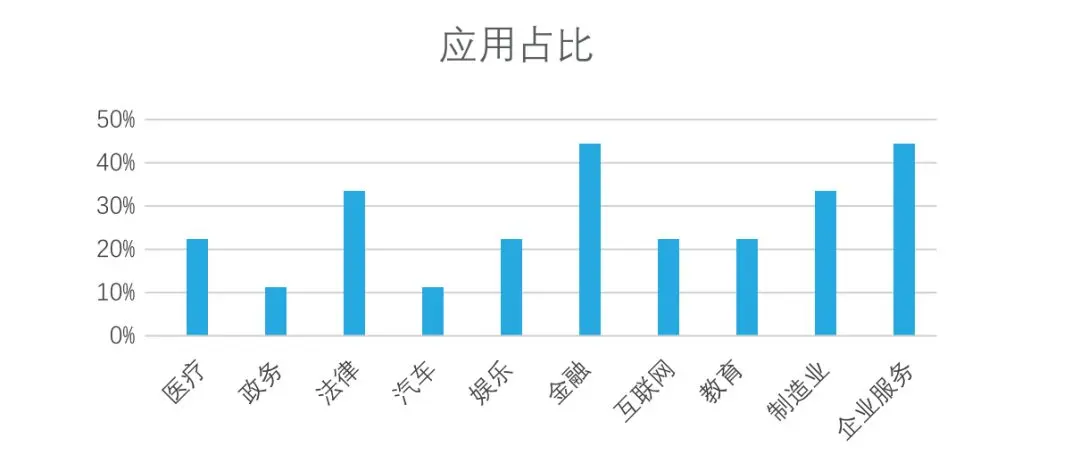
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
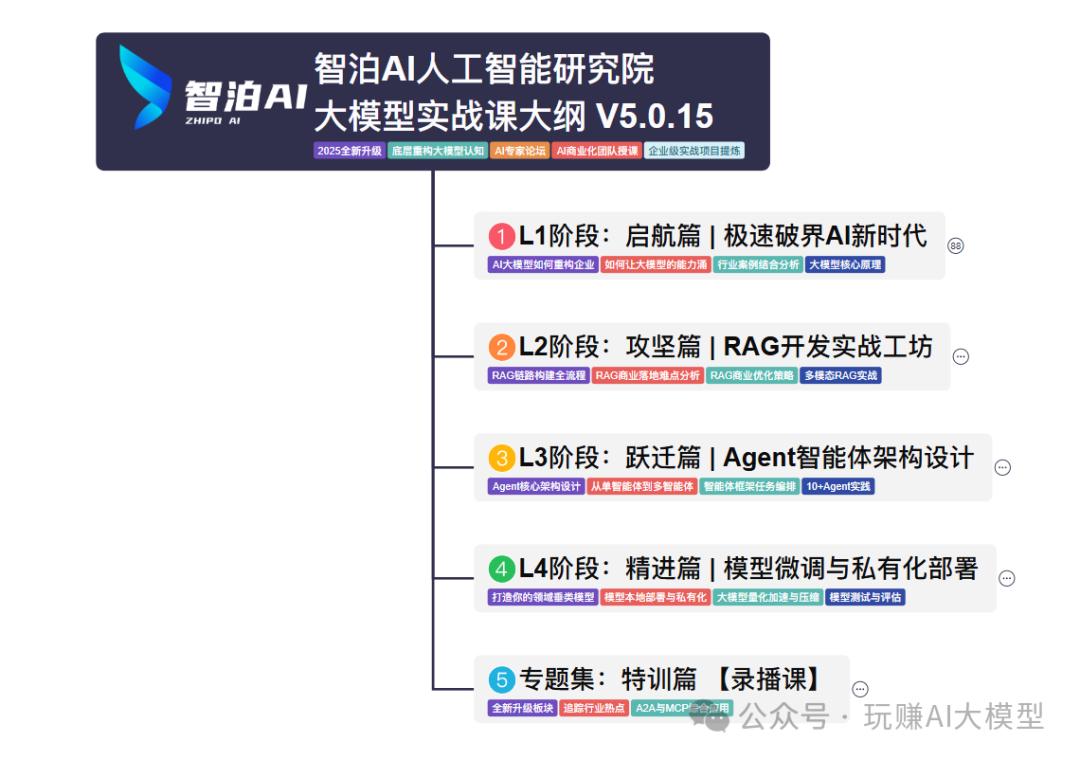
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

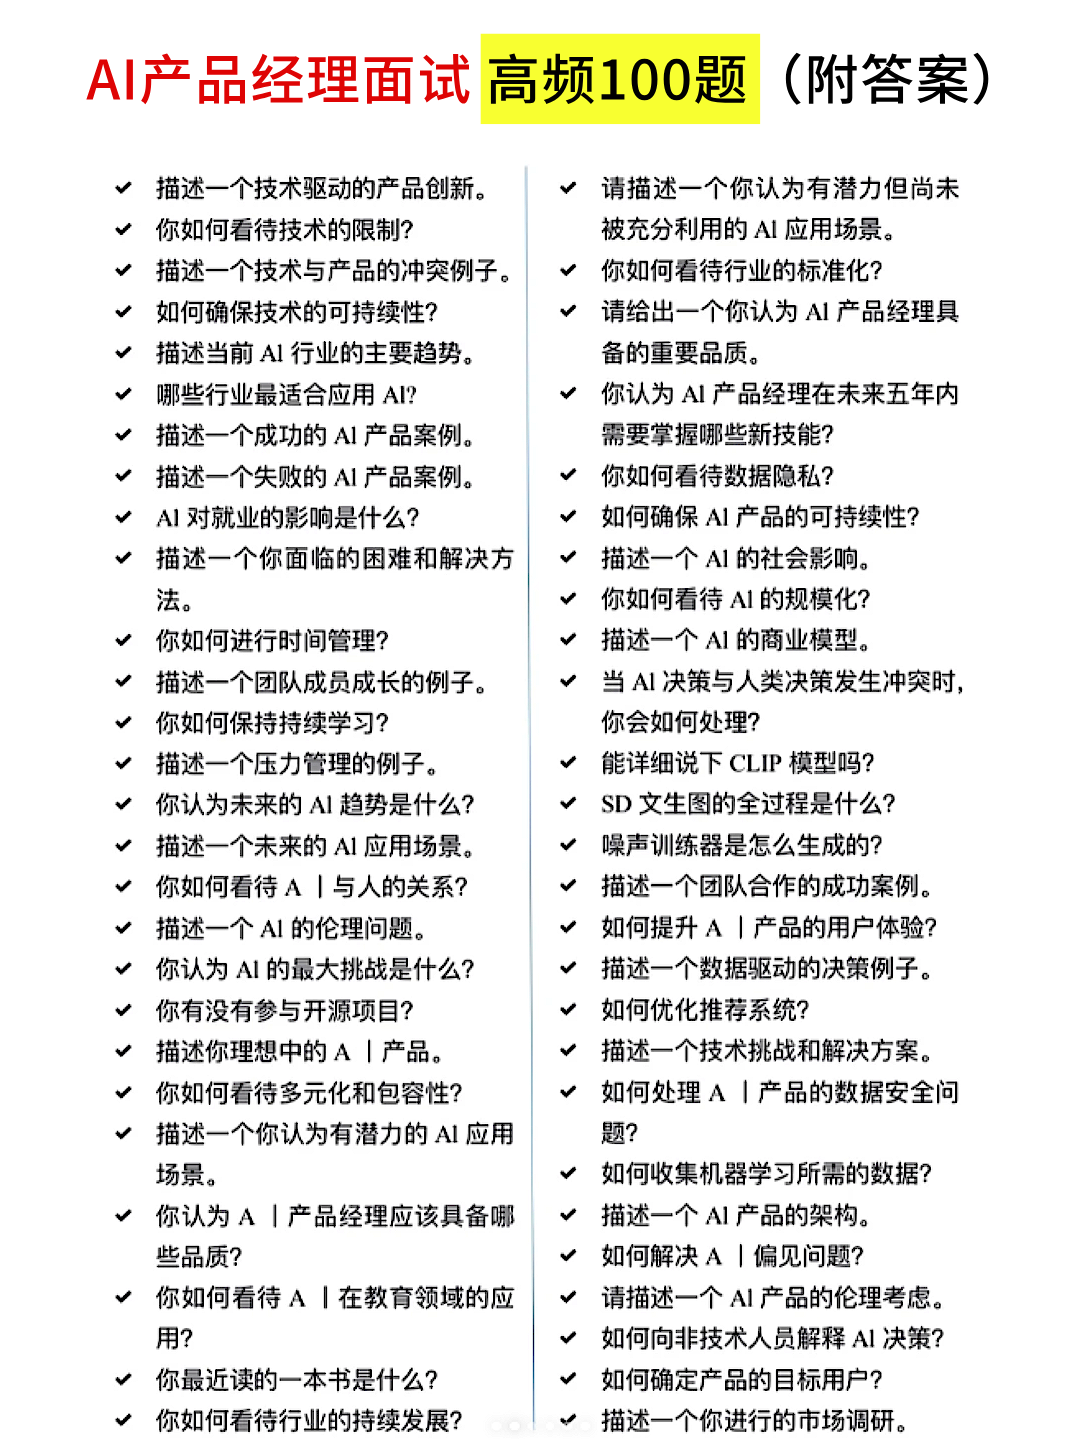
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 3397


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


