大模型必备技能:RAG技术详解与实战,含学习资料,建议收藏

从 SOAUTH2 到系统用户,SAP AS ABAP 里配置 OAuth 2.0 Client 的完整落地思路 SAP OAuth 2.0客户端配置的核心在于建立系统级信任关系。在AS ABAP中,每个OAuth 2.0客户端必须关联一个System类型的用户账号(通过SU01创建),并建议采用业务语义明确的命名规范(如ZBTP_PO_APPROVAL_APP)。关键配置包括:客户端认证方式(推荐SSL证书而非共享密钥)、Token生命周期(默认3600秒)、Scope访问范围,以及根据应用场景选择Authorization Code或SAML 2.0 Bearer等授权模式。项目实践中应避免混合配置不同授权类型,而 阅读详情

RAG虽然是最早应用的技术,也在不断的进化,AI系统的好坏,RAG的质量几乎起着决定性作用。优秀的RAG系统召回率几乎能做到100%,准确率能做到99%以上。本文来聊聊这些新技术。

RAG(检索增强生成)的5种文本分块策略
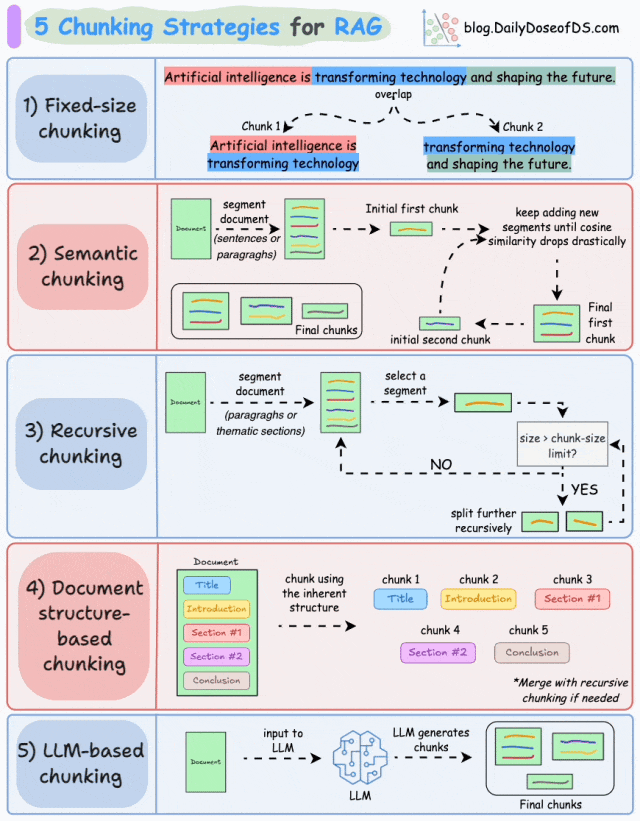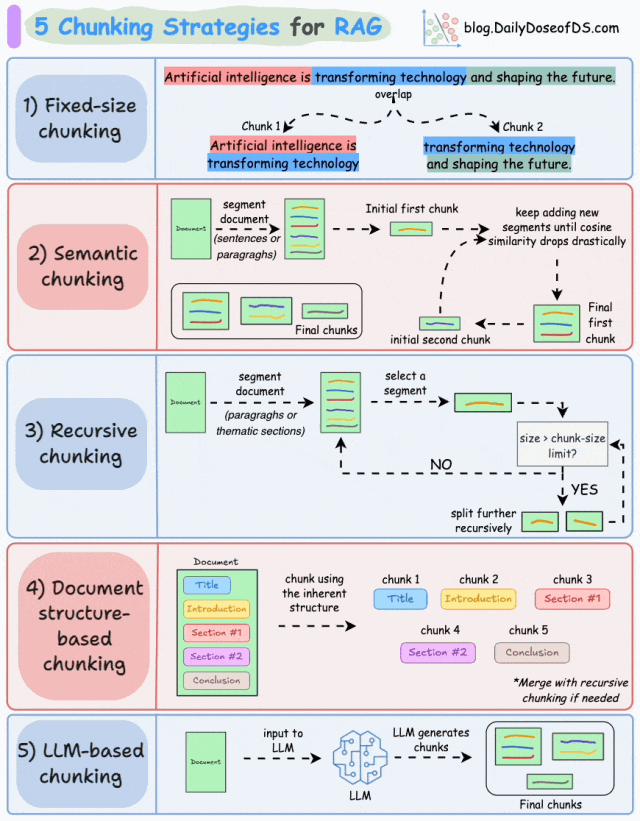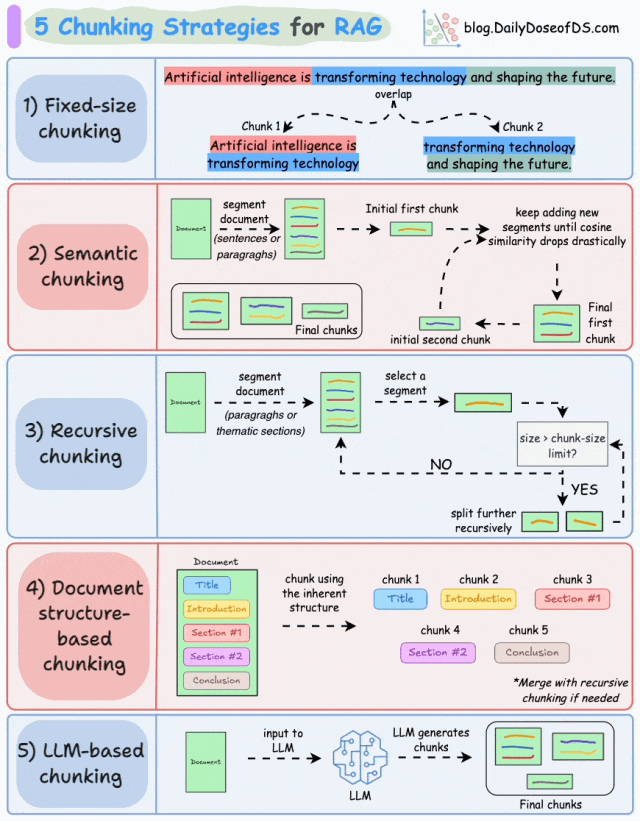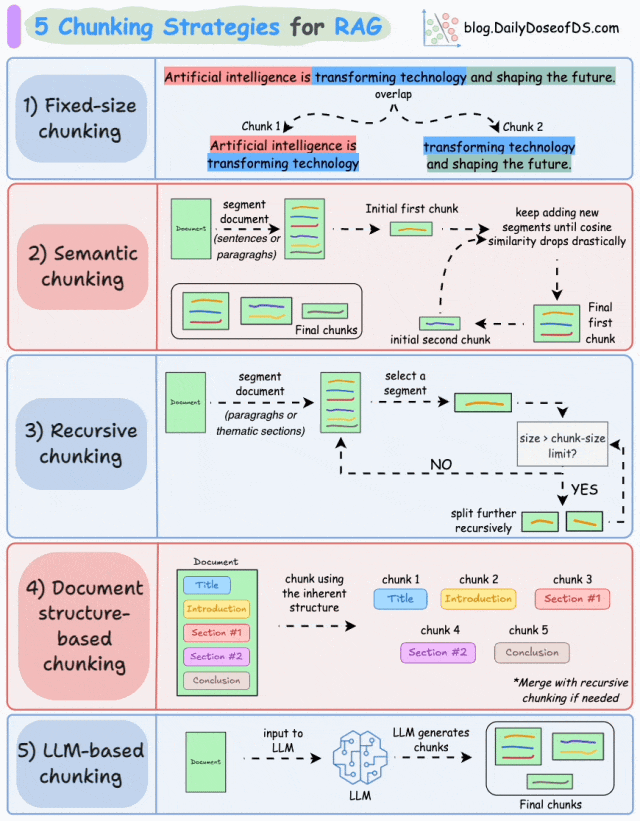

分块(Chunking)是RAG流程中的关键预处理步骤,其目的是将冗长的文档切分成更小、更易于管理的片段(chunks),以便于后续的向量化、检索,并最终提高大模型生成答案的质量。

1. 固定大小分块 (Fixed-size chunking)
  • 原理:这是最简单、最常用的策略。它预先设定两个关键参数:块的大小(如字符数或token数)和重叠量(overlap)。
  • 操作方式:像一个固定大小的滑动窗口一样在文本上移动。如图所示,它会先取第一段文本“Artificial intelligence is transforming technology”作为 Chunk 1。然后,窗口向后移动,但会包含上一块末尾的一部分内容(“transforming technology”)作为 Chunk 2 的开头,以此类推。
  • 优点:简单、快速、计算开销小。
  • 缺点:可能会生硬地切断完整的语义单元(如一个句子或一个概念),导致信息不完整。
  • 适用场景:文档结构不明确或对处理速度要求极高的场景。
2. 语义分块 (Semantic chunking)
  • 原理:根据文本内容的语义相关性或语义连贯性来动态确定分块的边界,目标是让每个块都包含一个尽可能完整的语义主题。
  • 操作方式:如图所示,流程从创建一个初始块开始。系统会持续向当前块添加新的文本段落(sentences),并实时计算块内内容的余弦相似度(一种衡量向量间相似度的指标)。当新加入的文本导致整体相似度急剧下降时,说明语义发生了显著转折,此时就在此处切断,形成最终的块。然后开始下一个块的过程。
  • 优点:能产生语义上更连贯、更完整的块,检索质量通常更高。
  • 缺点:计算复杂度高,需要嵌入模型(Embedding Model)来将文本转化为向量并计算相似度。
  • 适用场景:对检索精度要求高的场景,如学术文献、技术文档等。
3. 递归分块 (Recursive chunking)
  • 原理:采用“分而治之”的思想,通过分层、递归的方式将文档由大变小。它使用一组预定义的分隔符(如 \n\n, \n, ., !, ?, …),并按优先级尝试分割。
  • 操作方式:如图所示,流程从整个文档开始。首先尝试用最高优先级的分隔符(如双换行符\n\n)进行分割。如果分割后得到的块仍然太大,就对这块大的文本递归地使用下一优先级的分隔符(如单换行符\n)再次分割,重复此过程,直到所有块的大小都满足要求。
  • 优点:比固定大小分块更能尊重段落和句子的自然边界,是实践中非常流行且有效的折中方案。
  • 缺点:分隔符的选择和优先级设置需要根据文档类型进行调整。
  • 适用场景:通用性很强,尤其适用于格式良好、有段落结构的文档。
4. 基于文档结构的分块 (Document structure-based chunking)
  • 原理:利用文档固有的逻辑结构或标记(Markup)来进行分块。它假设文档本身具有清晰的结构,如标题、章节、段落等。
  • 操作方式:如图所示,直接按照 Title(标题)、Introduction(引言)、Section #1(章节1)、Section #2(章节2)、Conclusion(结论)等结构单元来划分文本。每个单元或其组合可以形成一个块。图中备注提到,如果某个结构单元(如一个章节)本身内容过长,可以与递归分块策略结合使用,对该章节进行进一步的递归分割。
  • 优点:分块的逻辑性与人类的理解方式高度一致,块的质量非常高。
  • 缺点严重依赖于文档本身是否具有良好的结构,对于纯文本或无格式文档效果不佳。
  • 适用场景:处理HTML、Markdown、PDF(带书签)、LaTeX等具有明确标签和结构的文档。
5. 基于大语言模型的分块 (LLM-based chunking)
  • 原理:将分块任务直接交给大语言模型来完成,利用其强大的语义理解能力。
  • 操作方式:如图所示,将整个或部分文档输入给LLM,并指令模型根据内容语义,自主地将文档划分为一系列连贯的、有意义的块。LLM可能会生成像 Chunk 1: [Title, Introduction], Chunk 2: [Introduction, Section #2, Conclusion] 等这样的输出。这种方法非常灵活,甚至可以理解跨段落的概念聚合。
  • 优点:智能化程度最高,能产生语义上最优的分块结果。
  • 缺点:成本最高、速度最慢,并且需要精心设计提示词(Prompt)。
  • 适用场景:当其他分块方法都无法满足极致精度要求,且不计较成本时的备选方案。

这五种策略从简单机械到复杂智能,各有优劣。在实际应用中,通常需要根据文档类型、应用场景和对成本与性能的权衡来选择最合适的策略,有时也会将多种策略组合使用。

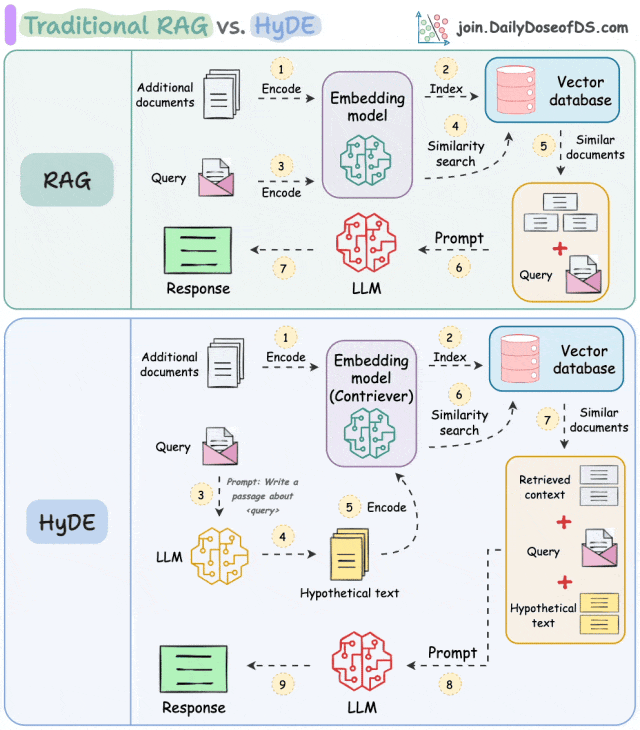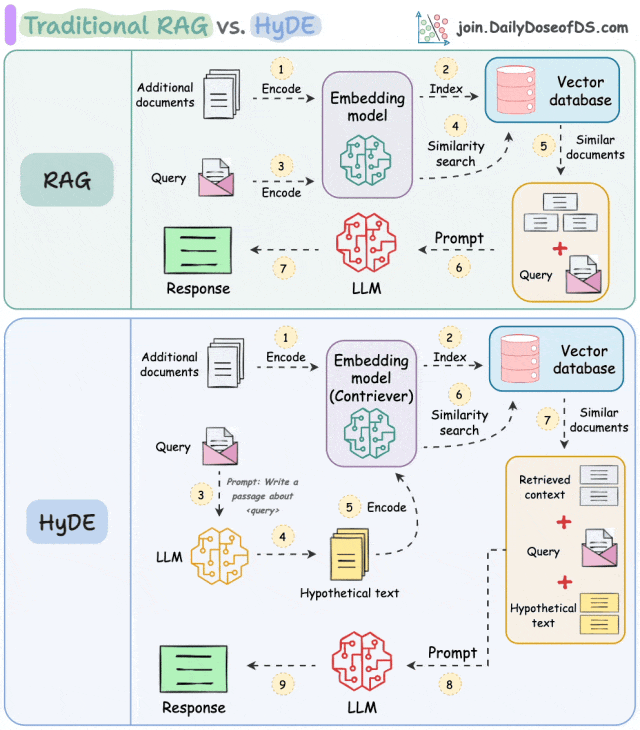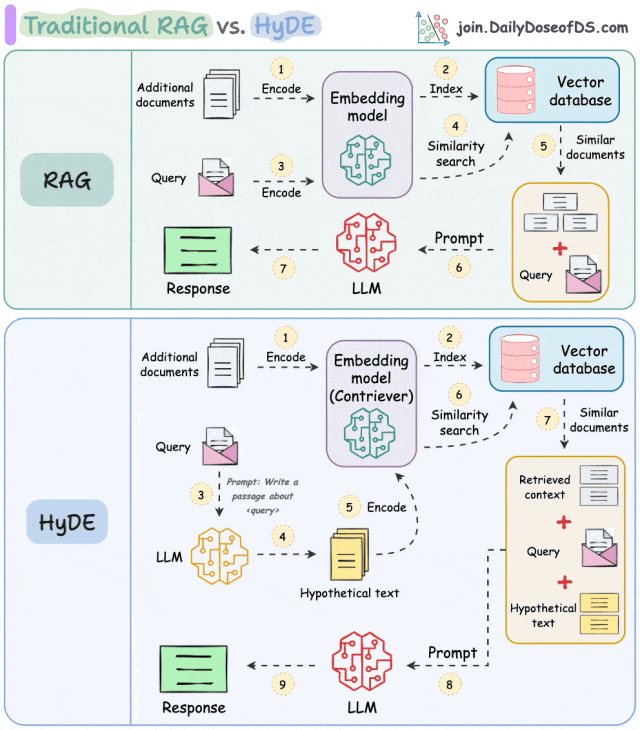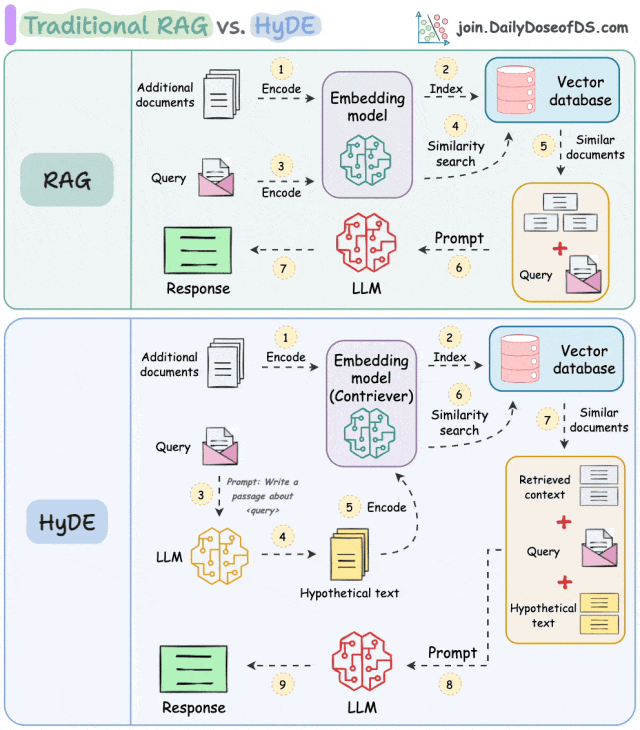
传统RAG(检索增强生成)与HyDE、Graph RAG 和 Agentic RAG。

1. 传统 RAG (Traditional RAG)

这是所有方案的基础,也是其他方案改进的起点。

  • 核心流程(如图的上半部分所示):

    1. 索引阶段:将“额外文档”通过嵌入模型编码成向量,并存入向量数据库中建立索引。
    2. 检索与生成阶段:当用户提出“查询”时,同样用嵌入模型将其编码为向量,然后在向量数据库中进行相似性搜索,找到最相关的文档片段。
    3. 将这些检索到的文档作为上下文,与原始查询一起组合成一个提示,发送给大语言模型,由LLM生成最终响应。
  • 优点:简单直接,能有效利用外部知识,减少LLM的幻觉。

  • 缺点:高度依赖“词袋”模型的向量相似性。如果用户查询用语和文档中的用语不匹配(例如,查询是“怎么养盆栽”,而文档中是“室内植物养护指南”),就可能检索不到最相关的信息,导致效果下降。

2. HyDE (Hypothetical Document Embeddings)

HyDE 旨在解决传统RAG查询与文档用语不匹配的问题。

  • 核心创新:在检索之前,先让LLM根据查询生成一个假设的答案或文档。

  • 流程(如图下半部分所示):

    1. 用户输入“查询”。
    2. 首先将查询发送给LLM,让其生成一段“假设的文本”(Hypothetical text)。这段文本是LLM认为的、可能包含答案的理想文档的样式。
    3. 将这段生成的假设文本(而不是原始查询)通过嵌入模型编码,去向量数据库中进行相似性搜索。
    4. 后续步骤与传统RAG相同:用检索到的真实文档和原始查询一起提示LLM,得到最终响应。
  • 优点:生成的假设文本更丰富、更规范,能更好地与向量数据库中的文档在语义上对齐,从而显著提升检索质量,特别是在处理模糊或简短的查询时。

  • 缺点:增加了一次LLM调用,开销稍大,且生成的假设文本如果偏离太远,也可能带来噪声。

3. Graph RAG
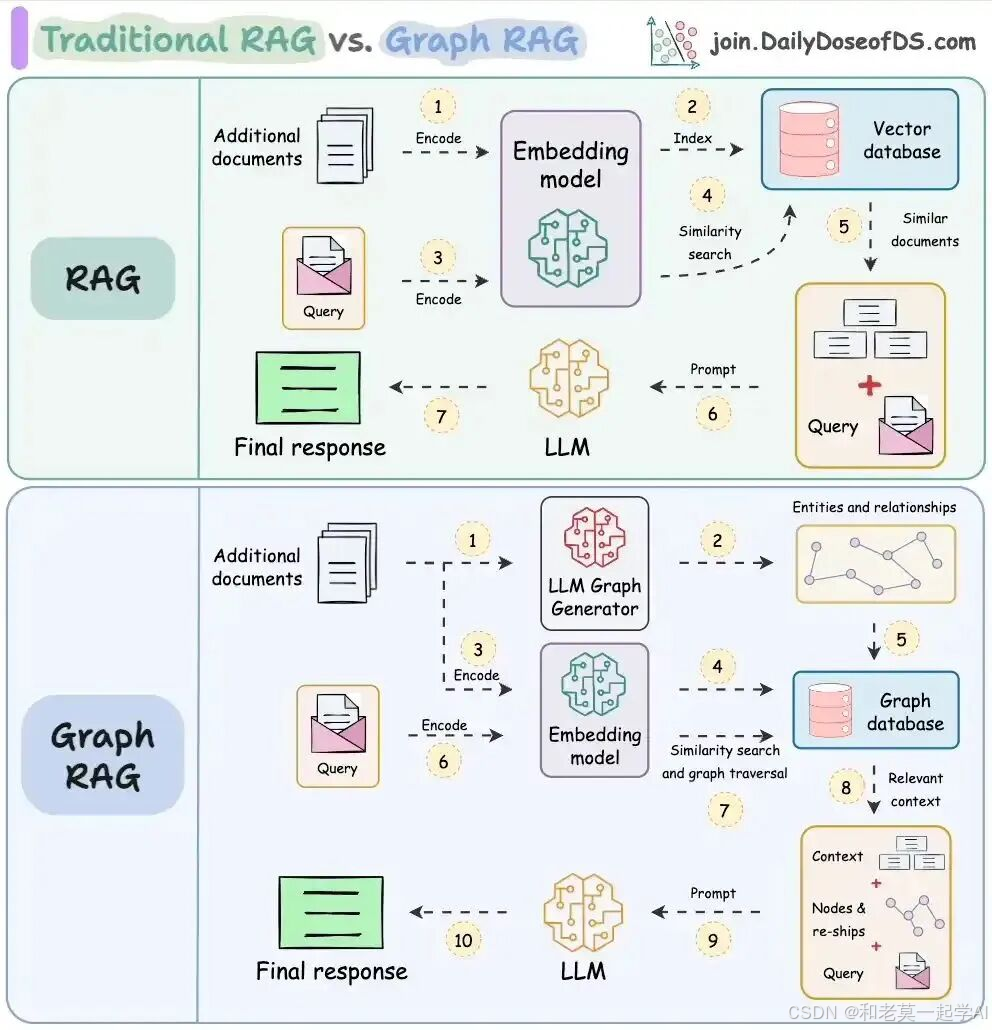
Graph RAG 引入了知识图谱来捕捉文档中深层的、结构化的语义关系,超越传统的向量匹配。

  • 核心创新:在索引阶段,不是简单地将文档切成片段并向量化,而是先用LLM从文档中提取实体(Nodes)和关系(Relationships),构建成一个知识图谱。

  • 流程(如第二张图下半部分所示):

    1. 图生成:使用“LLM图生成器”处理“额外文档”,抽取出实体和关系,形成知识图谱。
    2. 对图谱中的实体和关系进行编码和索引(可能同时使用向量索引和图数据库)。
    3. 对于查询,既可以通过传统的向量相似性搜索,也可以利用图的特性进行图遍历,找到相关联的实体簇,从而获得更广泛、更相关的上下文信息。
  • 优点:能理解“苹果->生产->iPhone”这种复杂关系,可以进行多跳推理(例如,通过公司CEO关联到其公司的产品)。检索到的上下文不再是孤立的文本片段,而是一个相互关联的知识子图,信息量更大、逻辑性更强。

  • 缺点:构建图谱的成本高昂,技术复杂度也远高于前两种方案。

4. Agentic RAG
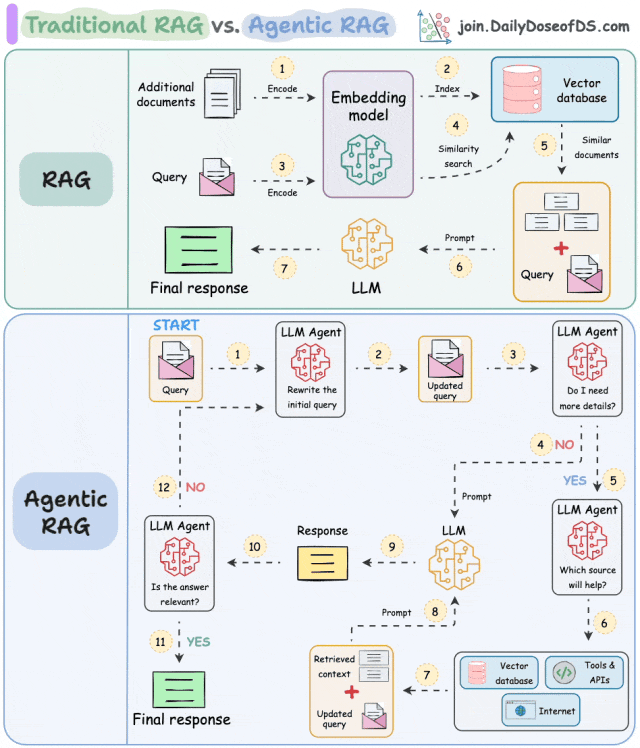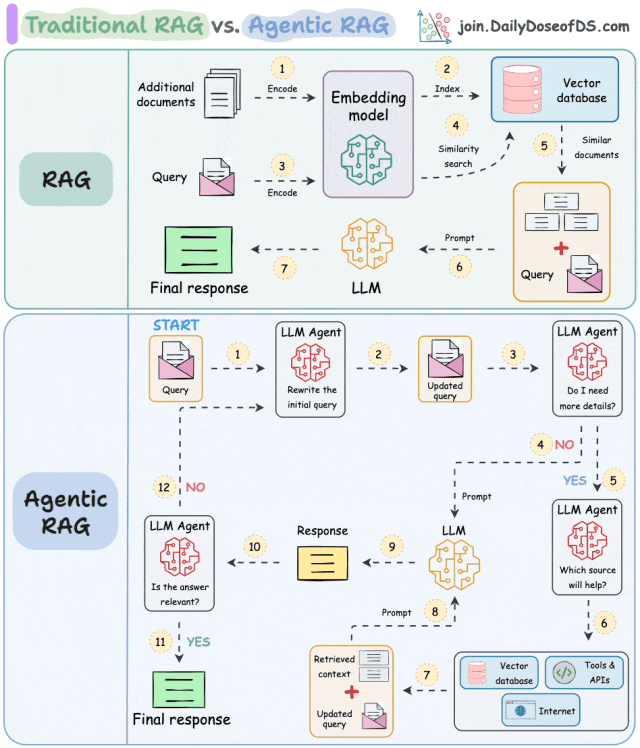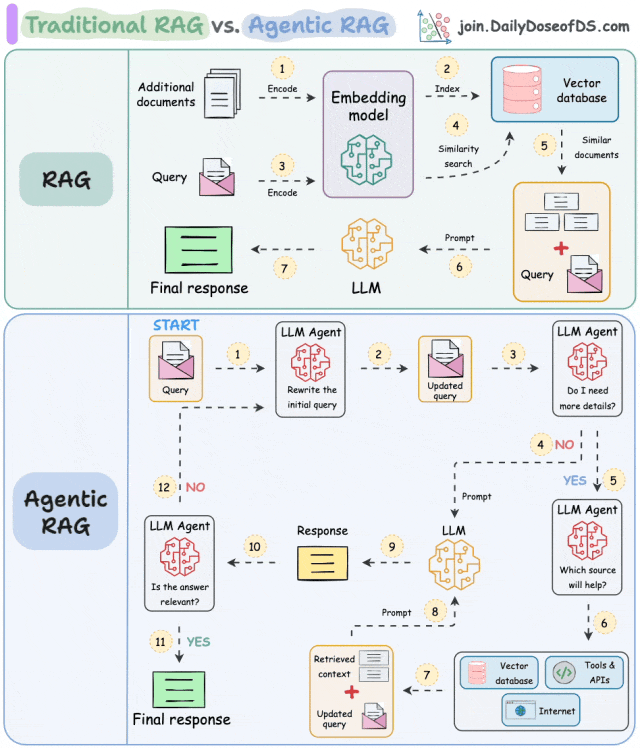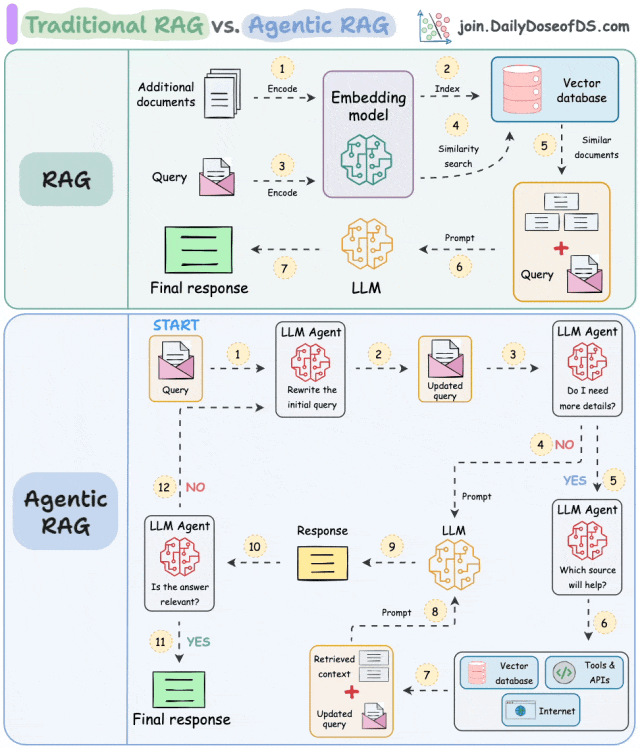
Agentic RAG 将智能体概念引入RAG,使整个过程从静态流程变为动态、循环的决策过程。

  • 核心创新:由一个LLM智能体作为“大脑”,自主决定如何执行检索任务。它可以根据情况重写查询、选择数据源、判断信息是否足够、决定是否进行多轮检索。

  • 流程(如第三张图下半部分所示):

    1. 用户输入“查询”。

    2. LLM智能体开始工作,其步骤可能包括:

      • 重写查询(Rewrite the initial query)以优化检索。
      • 判断是否需要更多细节(判断是否需更多细节)。
      • 选择工具/数据源(选数据源),可能包括向量数据库、互联网搜索、API工具等。
      • 执行检索并评估检索结果的相关性(相关性判断)。
    3. 这个“决策-执行-评估”的循环可能会进行多次,直到智能体认为它拥有了足够的信息来回答问题。

    4. 最终,智能体综合所有检索到的信息生成“最终响应”。

  • 优点:极其灵活和强大,能处理复杂、多步骤的查询任务,更接近人类的研究方式。它不再是一次性的检索,而是一个多轮的、目标驱动的过程。

  • 缺点:延迟最高,计算成本最大,并且需要非常精心地设计智能体的提示词和工具。

这四种方案代表了RAG技术从简单到复杂、从静态到动态的演进路径。

  • 传统RAG是基础且高效的方案。
  • HyDE通过优化查询端来提升基础RAG的效果。
  • Graph RAG通过优化知识表示(索引端)来挖掘深层信息。
  • Agentic RAG则通过引入智能体,彻底改变了RAG的执行范式,使其具备了解决超复杂问题的能力。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

1、掌握 Microsoft Dynamics 365 Business Central 开发全解析 本文全面解析了Microsoft Dynamics 365 Business Central的开发全流程,涵盖开发环境搭建、AL语言扩展开发、定制解决方案实现、高级开发技术、文件与报表处理、打印功能、调试与性能优化、API使用、Azure和Power Platform集成、DevOps实践以及生成式AI应用。同时探讨了开发工具技巧、常见问题解决、开发流程优化、团队协作要点及未来技术趋势,帮助开发者系统掌握Business Central开发核心技能,提升企业级应用开发效率与质量。 阅读详情

相关推荐

当NetApp 7-mode遇到单控制器故障:HA模式手动修复全记录

本文详细记录了NetApp 7-mode存储系统在单控制器故障时的应急修复过程,包括HA配置重建、磁盘初始化和业务恢复等关键步骤。通过实战案例解析如何解决`VIA Interconnect is down`等典型问题,为企业级存储系统的高可用保障提供实用指南。

yolo5detector的博客 247

程序员必学:RAG技术核心分块策略与演进方案【建议收藏】

文章介绍了RAG技术的两大核心:五种文本分块策略(固定大小、语义、递归、文档结构、LLM-based)和四种演进方案(传统RAG、HyDE、Graph RAG、Agentic RAG)。RAG质量对AI系统起决定性作用,优秀系统召回率近100%,准确率超99%。各种策略从简单到复杂,各有优劣,需根据文档类型和应用场景选择,有时需组合使用。技术演进从静态流程到动态决策,不断提升检索质量和问题解决能力。

2401_85373691的博客 1086

从d、q轴电流到电机性能:FOC控制中角度偏移的实战影响与调试策略

本文深入探讨了永磁同步电机FOC控制中d、q轴电流与角度偏移对电机性能的影响及调试策略。通过分析角度偏移导致的效率下降、电流异常等问题,提供了实用的四步调试法和参数优化技巧,帮助工程师有效提升电机控制精度和效率。

weixin_29264201的博客 294

使用假设文档嵌入 (HyDE) 改进检索

使用假设文档嵌入 (HyDE) 改进检索

安静的软件工程师 4867

VN5620硬件接口介绍

VECTOR, VN5620, 诊断

Fecostar的博客 7485

2024高项范文-论项目成本管理

例如,在需求分析和设计阶段,安排了较多经验丰富的人员,确保基础工作的高质量完成,同时也避免了后续因需求变更等问题导致的时间和成本浪费。虽然项目进度略有延迟,但通过有效的成本管理和调整,最终在可控的成本范围内完成了项目,并且软件的质量也得到了保障。通过这个案例可以看出,在项目成本管理过程中,要紧密结合时间管理,根据实际情况灵活调整策略,注重风险的防范和应对,才能实现时间和成本的平衡,确保项目的成功。资源规划是成本基准形成的基础。识别和评估项目中的成本风险,并制定相应的应对措施,以降低风险对项目成本的影响。

xjflion的博客 1188

RAG技术全解析:打造下一代智能问答系统

检索增强生成(RAG)技术通过结合大型语言模型(LLM)和外部知识库来克服传统语言模型在特定领域任务上的局限。RAG通过索引、检索和生成的三步流程,增强了语言模型的能力,提高了生成内容的准确性和相关性。本文详细介绍了RAG的工作原理、实现过程和评估方法,并展望了其在多模态领域的应用前景。RAG不仅优化了问答系统的性能,还通过多样的技术整合和灵活的检索过程,推动了智能问答系统的发展。

alysblmd 1万+

TDISP(TEE Device Interface Security Protocol)软件操作流程

/ 1. SPDM会话相关定义(🔶1-37、🔶1-187)// SPDM会话ID// AES-256-GCM加密密钥(TDISP要求)// 初始向量// 会话是否激活// 2. IDE流配置(🔶1-52、🔶1-625)// IDE流ID// 4个子流的AES密钥(覆盖所有子流类型)// 密钥是否已配置// 3. TDI状态与配置(🔶1-207、🔶1-210)TDI_CONFIG_UNLOCKED = 0, // 初始配置态。

inquisiter 1432

Agentic RAG 详解 - 从头开始​​构建你自己的智能体系统

​虽然检索增强生成(RAG)在 2023 年占据主导地位,但代理工作流正在推动 2024 年的巨大进展。智能体的使用为构建更强大、稳健且多功能的 大型语言模型(LLM)应用程序开辟了新的可能性。其中一种可能性是在 RAG 流水线中引入智能体,形成代理式 RAG 流水线。 本文将介绍 Agentic RAG 的概念、其实现方式,以及其优势和局限性。

Elastic 中国社区官方博客 1万+

LTspice导入德州仪器SPICE模型的实用指南与常见问题解析

本文详细介绍了如何在LTspice中导入德州仪器的SPICE模型,包括模型文件获取、路径管理、导入步骤及常见问题解析。通过实用指南帮助工程师精确仿真电路性能,提升设计效率,重点涵盖了第三方模型的导入教程和最佳实践。

kk1234的博客 309

青岛鼎信Java开发面试题及参考答案(3万字长文,多张原理图)

MySQL 的事务特性有哪些? MySQL 事务具有四个重要特性,被称为 ACID 特性。 原子性(Atomicity):事务是一个不可分割的工作单位,事务中的操作要么全部执行,要么全部不执行。例如,在银行转账场景中,从账户 A 转账到账户 B,包括扣减账户 A 的金额和增加账户 B 的金额这两个操作必须作为一个整体来完成。如果在执行过程中发生错误,比如系统崩溃或者数据库出现故障,那么已经执行的部分必须全部回滚,就好像整个转账操作从未发生过一样。 一致性(Consistency):事务必须

大模型大数据攻城狮的专栏 1089

一文详谈RAG优化方案与实践

导读RAG通过检索现有的大量知识,结合强大的生成模型,为复杂的问答、文本摘要和生成任务带来了全新的解决方案。本文详细的介绍了RAG遇到的挑战、通用范式、工程实践、优化实现策略等。一、RAG的背景介绍随着ChatGPT的兴起,大语言模型再次走进人们的视野,其在NLP领域表现出的语言识别、理解以及推理能力令人惊叹。越来越多的行业开始探索大语言模型的应用,比如政务、医疗、交通、导购等行业。通义系列、GP...

weixin_45583158的博客 1886

【Bluetooth|蓝牙开发】三、一篇文章,带你总览蓝牙协议

1、开篇词 2、蓝牙开发入门 3、蓝牙协议栈总览 4、蓝牙协议栈——物理层 5、蓝牙协议栈——链路层 6、蓝牙协议栈——传输层 7、蓝牙协议栈——L2CAP协议 8、蓝牙协议栈——ATT协议 9、蓝牙协议栈——GATT协议 10、蓝牙通信流程分析 11、蓝牙协议栈——Bluez交叉编译 12、蓝牙调试工具汇总

Donge's Blog 1万+

大模型必备技能:RAG检索增强生成技术全攻略,建议收藏

大模型必备技能:RAG检索增强生成技术全攻略,建议收藏

kaka0722ww的博客 1838

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

入行AI必备三大核心技能:大模型微调、RAG构建与本地部署实战指南

2025年的AI行业,已从"模型竞赛"转向"落地比拼"。大模型微调赋予你定制化能力,RAG构建让AI具备行业知识,本地部署实现技术价值转化——这三大技能构成了AI工程师的"铁三角"竞争力。建议从实际项目出发:先用Ollama体验模型部署,再用LLaMA Factory微调个人知识库模型,最终构建多模态RAG系统并通过vLLM/SGLang部署上线。记住,AI技术的终极价值在于解决实际问题,将本文所学转化为行业解决方案,你将在AI浪潮中占据先机。行动清单。

1741

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大模型学习必备:20种RAG技术详解,建议收藏反复研读

本文全面解析了RAG技术的20种实现方式,从基础检索增强到高级智能体、图谱、多模态等变体,涵盖各方案的关键特征、优势、应用场景及工具库。文章指出RAG已转型为智能体基础设施,未来竞争焦点将聚焦于多智能体协同效率、跨模态证据融合与低成本边缘部署,需把握"Agentic+图谱+轻量化"三条主线,推动技术向更智能、更实用方向发展。

Android_XG的博客 800

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

从零到全栈AI工程师:大模型应用开发必备技能与学习路径(建议收藏)

本文系统介绍了AI大模型应用开发者所需的技能体系,包括Python编程、机器学习基础、大模型专项技术(如Prompt工程、RAG、微调等)以及数据处理能力,并强调问题分解、持续学习等软技能的重要性。文章提供了从入门到进阶的学习路径和常用工具栈,帮助开发者成为"全栈AI工程师",抓住AI大模型时代的发展机遇。 ---

2401_84815887的博客 1748

【建议收藏】大模型核心技术精讲:Agent、RAG、工作流与微调

本文系统介绍大模型应用开发核心技术,包括具有记忆和决策能力的Agent智能体及其幻觉解决方案;解决大模型幻觉和实时性问题的RAG知识库构建;通过工作流搭建提升复杂任务处理能力;MCP与Tool自定义实现功能扩展;针对不同需求的微调技术;以及支持各环节的数据处理要点,为开发者提供完整技术体系。

Android_XG的博客 1122

大模型必备技能:RAG检索增强生成技术详解+实战(建议收藏学习)

文章介绍了检索增强生成(RAG)技术,解决LLM无法处理专有数据的问题。RAG结合检索模块与生成模型,使LLM能访问外部知识源,减少幻觉。文章详细解释RAG工作原理(检索、增强、生成),并提供使用LangChain、OpenAI和Weaviate实现RAG的完整代码示例。相比传统微调,RAG更灵活、资源需求更低且易于维护。

2401_85325726的博客 719

建议收藏:程序员必学!从RAG到Graph RAG,大模型检索增强技术完全指南

本文系统介绍了RAG、Graph RAG和Agentic RAG三种AI技术。RAG使大模型能实时获取外部信息,提升时效性与准确性;Graph RAG结合知识图谱,赋予AI理解多领域知识间联系的能力,支持复杂推理;三者各有优势,适用于不同场景,为AI应用与投资决策提供思路。掌握这些技术有助于专业人士精准把握各自特点,优化AI应用策略。

2401_85375186的博客 1423

【收藏级干货】RAG技术实战:让大模型理解企业知识,AI落地必备技能

RAG技术是让大模型理解企业私有知识的关键解决方案,通过检索增强生成实现基于真实数据的准确回答。文章详细介绍了RAG技术的演进历程、系统架构设计、检索质量优化方法、生产部署最佳实践,以及未来发展趋势。从基础RAG到智能RAG,再到多模态、实时学习和联邦RAG,为企业构建可信任的AI应用提供了完整的技术路径。

2401_85375186的博客 1286

【收藏必备】AI大模型技术栈完整指南:从LLM到Agent系统,RAG与MCP协议实战解析

AI技术正在快速发展,我们可以预见几个重要的趋势:模型能力的持续提升、技术栈的完善和标准化、应用场景的不断扩展。

大模型研究中心 1583

【建议收藏】RAG技术全解析:从基础架构到企业级应用,掌握大模型落地必备技能

保证100%免费。

EnjoyEDU的博客 1140

【收藏必备】RAG与Agent RAG技术详解:大模型知识获取的现在与未来

【收藏必备】RAG与Agent RAG技术详解:大模型知识获取的现在与未来

xxue345678的博客 900

【收藏必备】Java开发者转型大模型领域:技术路径与核心技能详解

【Java开发者AI转型指南】针对AI浪潮下Java开发者的职业转型需求,提出渐进式转型路径:从AI赋能传统开发到全栈AI工程师。文章剖析Java开发者的工程化思维与企业级经验优势,提供关键技术栈过渡对照表,详解设计模式迁移、性能优化等经验转化方法。包含分阶段学习计划、实战项目路线及资源推荐,帮助开发者规避数学恐惧等常见陷阱,实现向AI领域的平滑过渡。资料涵盖大模型技术体系、实战案例及面试题库,由清华-加州理工双料博士团队研发,助力开发者把握AI时代机遇。

qq_46094651的博客 955

收藏必备!RAG技术详解:解决大模型知识滞后与事实虚构问题

RAG(检索增强生成)是一种创新AI架构,结合大语言模型生成能力与外部知识库检索功能。其工作流程包括检索相关知识、增强提示词和生成回答三大环节,能有效解决大模型知识滞后和事实虚构问题。通过知识预处理、检索优化和增强生成三个阶段,RAG技术使AI能基于最新、最专业的知识提供准确回答,广泛应用于数字政府、专业咨询等领域,为普通用户提供更智能、可靠的AI服务。

Android23333的博客 1628
上一篇: 【必收藏】LLM红队测试完全指南:发现并修复大模型安全漏洞
下一篇: 大模型+MCP=超级AI助手!从入门到实战的全栈工程师必备指南(建议收藏)
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值





