大模型性能优化指南:Continuous Batching技术原理与实现,收藏必备!

大模型-batch之continuous batching 看下Continuous Batching 技术的开山之作ORCA,这个其实是融合的思路。。目前业界把依据ORCA思想实现的方案叫做连续批处理是一种优化技术,它允许在生成过程中。具体来说,一旦一个序列在批处理中完成生成,就可以立即用新的序列替代它,从而提高了GPU的利用率。这种方法的关键在于实时地适应当前的生成状态,而不是等待整个批次的序列都完成。与静态批处理不同,连续批处理采用了迭代级别的调度。它并不等待每个序列在批次中完成生成后再进行下一个序列的处理。 阅读详情

在使用 Qwen、Claude 或 ChatGPT 等大模型服务时,你可能观察到一个现象:首个字的生成往往有短暂延迟(Time to First Token),随后文字便如流水般逐个出现。这背后的核心在于 LLM 的工作本质——它是一个昂贵的“下一个 Token 预测器”。为了在生产环境中同时服务数千用户并最大化 GPU 利用率,业界引入了一系列推理优化技术。其中,Continuous Batching(连续批处理) 是目前最关键的优化手段之一。本文将从 Attention 机制和 KV Cache 出发,逐步拆解 Continuous Batching 如何通过消除 Padding 浪费和动态调度,实现推理吞吐量的质的飞跃。

1. 技术基石:Attention 机制与生成过程

要理解推理优化,首先必须回顾 LLM 处理 Token 的基本方式。

1.1 Token 的交互与计算

语言模型通过将文本切分为 Token(词元)进行处理。虽然许多网络操作(如层归一化)是逐 Token 独立进行的,但为了理解语义,Token 之间必须产生联系。这就是 Attention(注意力) 层的用武之地——它是模型中唯一让不同 Token 相互“看见”并计算相关性的地方。

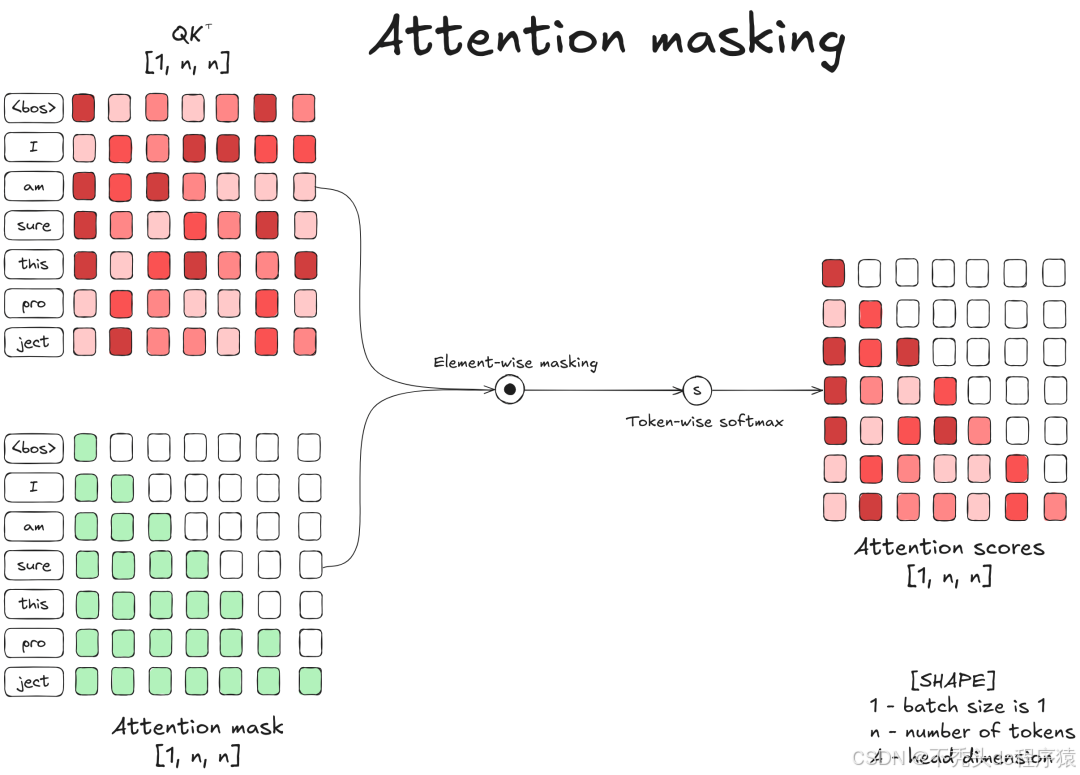
假设输入提示词为 I am sure this project(共7个 Token),模型会通过以下步骤处理:

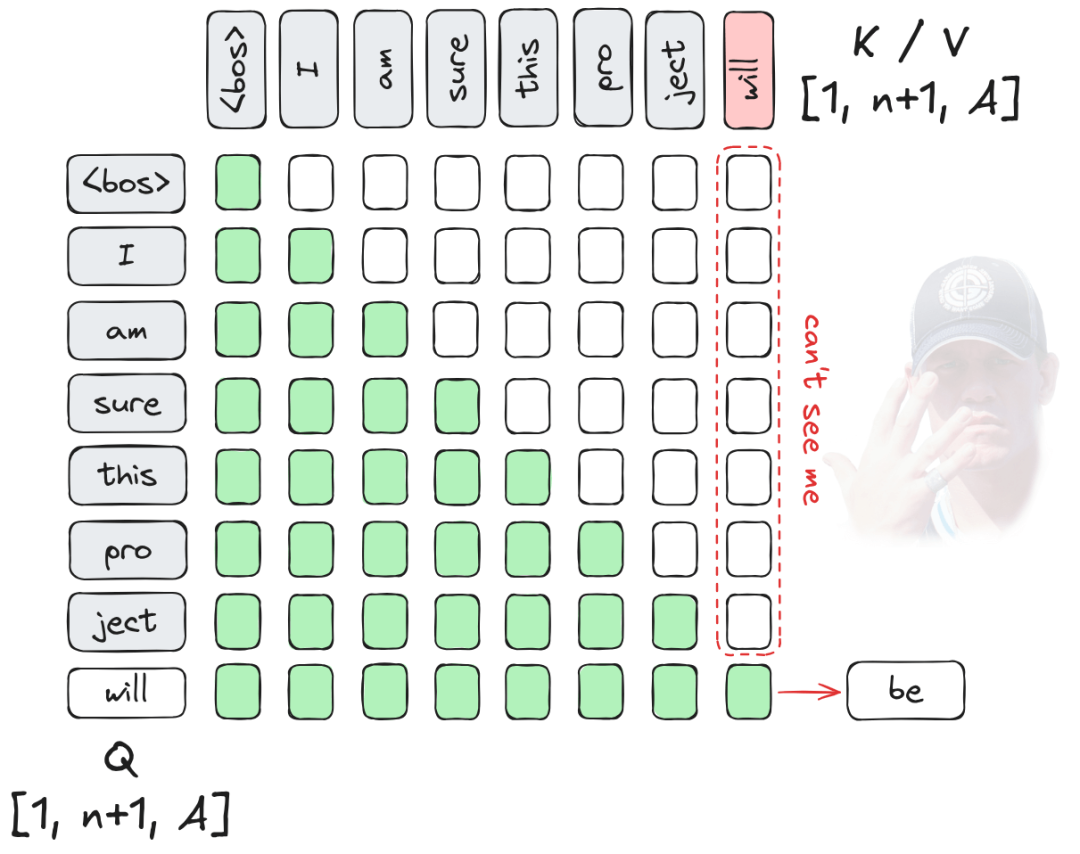
  1. 投影(Projection): 输入张量 分别通过 矩阵投影,生成 Query ()、Key () 和 Value () 向量。在这里插入图片描述

  2. 相似度计算: 计算 和 的乘积(),衡量 Token 间的相似度。其复杂度为 。

  3. 掩码(Masking): 应用 Causal Mask(因果掩码)。这至关重要,它确保位置 的 Token 只能看到 及其之前的 Token(过去不能被未来影响)。在这里插入图片描述

  4. 输出: 经过 Softmax 归一化后与 相乘,得到注意力输出。

1.2 Prefill(预填充)与 Decode(解码)

LLM 的推理过程分为两个截然不同的阶段:

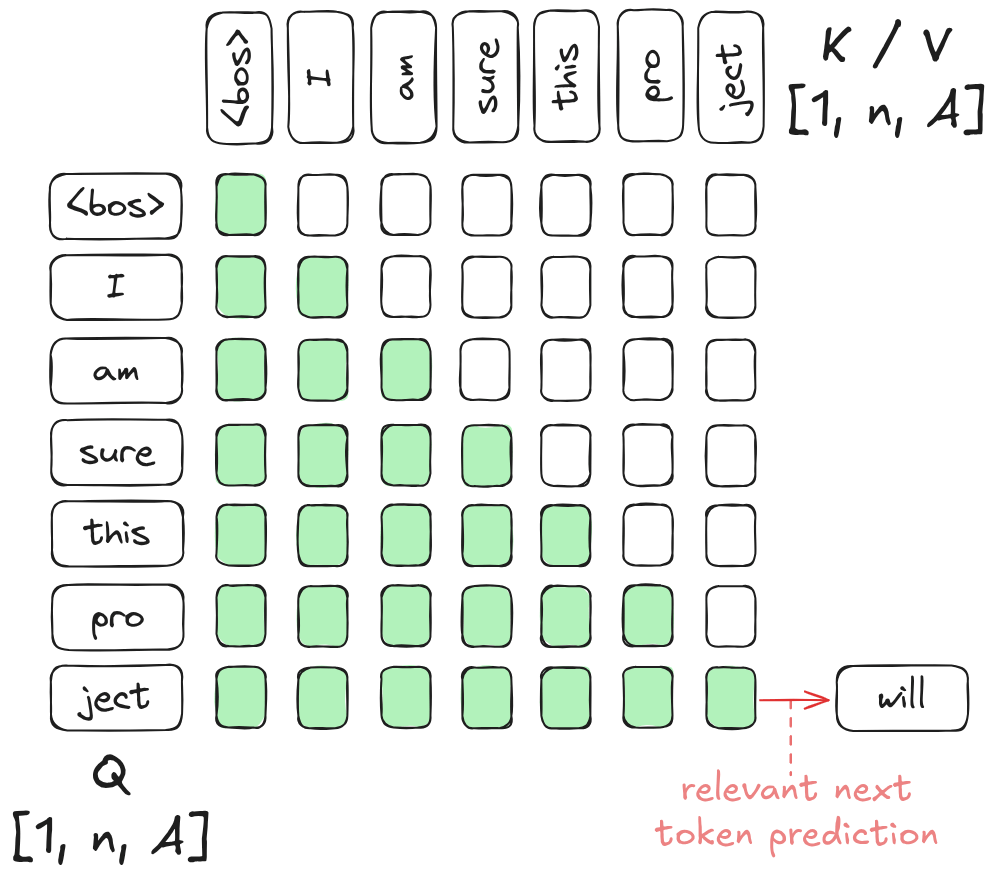
  • Prefill 阶段: 模型并行处理完整的输入 Prompt(如上文的 7 个 Token),计算并缓存中间状态,生成第一个新 Token(如 “will”)。此时计算密度高,主要利用 GPU 的并行计算能力。
  • Decode 阶段: 基于之前所有 Token,逐个生成下一个 Token。这是一个自回归过程,每生成一个新 Token,都需要“回顾”之前的上下文。
2. 核心优化一:KV Cache (键值缓存)

在 Decode 阶段,如果简单粗暴地执行前向传播,会产生巨大的计算浪费。
2.1 为什么需要缓存?

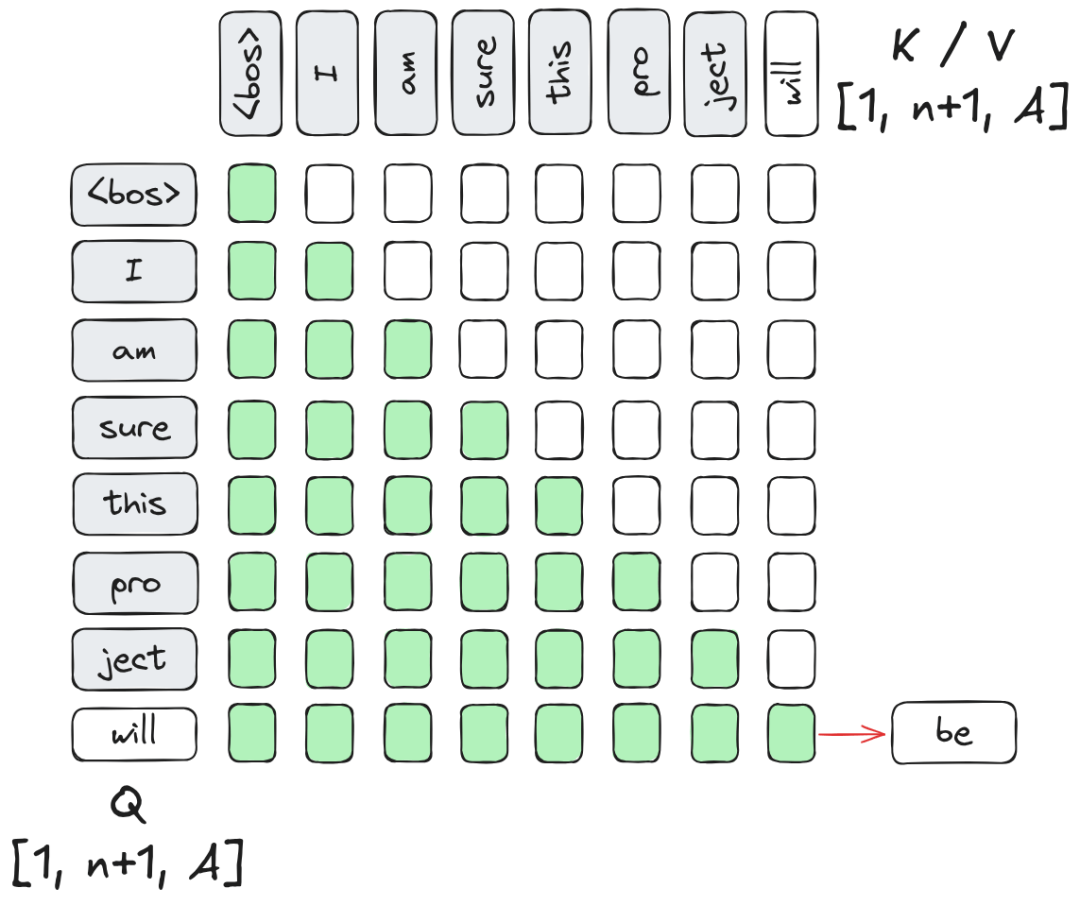
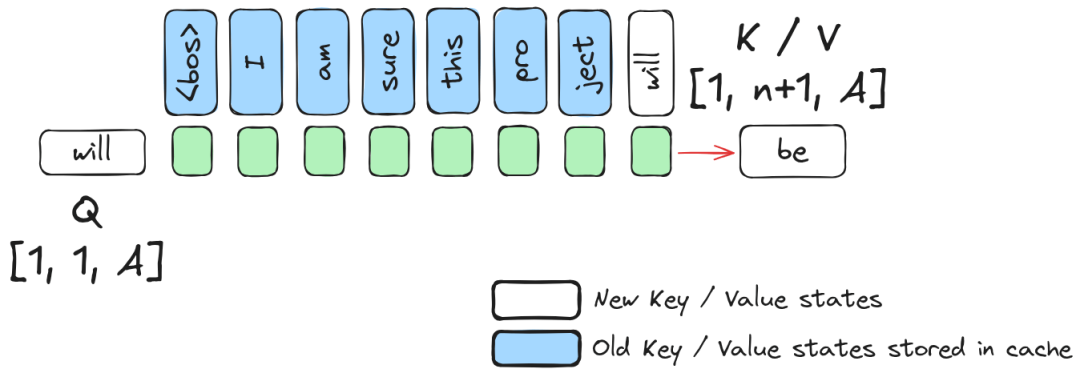
当我们生成了第 8 个 Token “will” 并想预测第 9 个 Token 时,根据因果掩码的特性,前 7 个 Token(“I am sure…”)的 Key 和 Value 投影结果并不会因为新 Token 的加入而改变。

如果我们每次都重新计算前 7 个 Token 的 和 ,计算复杂度将维持在 。通过 KV Cache,我们将之前步骤计算好的 和 向量存储在显存中,生成新 Token 时仅计算当前 Token 的 ,并与缓存拼接。

  • 收益: 将解码复杂度从 降低到 。
  • 代价: 显存占用增加。对于 Llama-2-7B(32层,32头,维度128),每个 Token 约占用 16KB 显存(FP16精度)。随着上下文长度增加,显存压力呈线性增长。
3. 核心优化二:Chunked Prefill (分块预填充)

KV Cache 不仅用于解码,还解决了长文本(Long Context)的内存瓶颈问题。
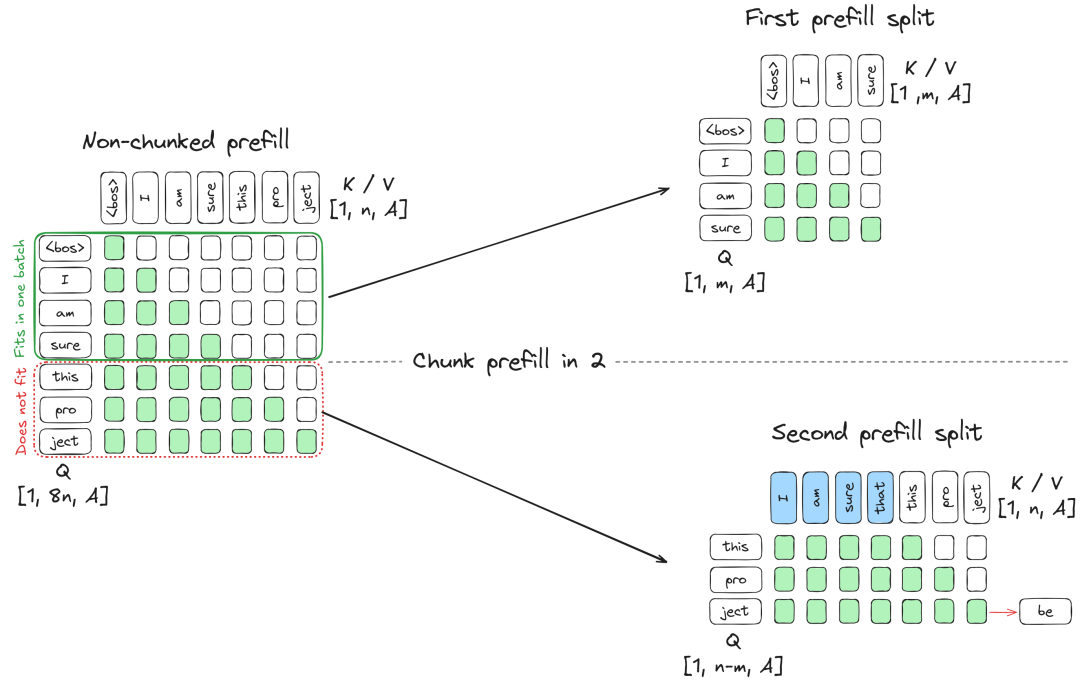
在处理超长 Prompt(如使用 Cursor 将整个代码库作为上下文)时,Token 数量可能导致中间激活值超出显存上限。Chunked Prefill 允许我们将长 Prompt 切分为多个小块(Chunk)分批进入模型:

  1. 处理第一个 Chunk,将生成的 KV 状态存入缓存。
  2. 处理第二个 Chunk 时,读取缓存并拼接,确保注意力计算覆盖之前的上下文。

这种机制不仅避免了 OOM(显存溢出),也为后续的细粒度调度奠定了基础。

4. 终极形态:Continuous Batching (连续批处理)

在理解了基础组件后,我们来看看如何通过批处理(Batching)提升服务吞吐量。

4.1 传统 Batching 的痛点:Padding 带来的浪费
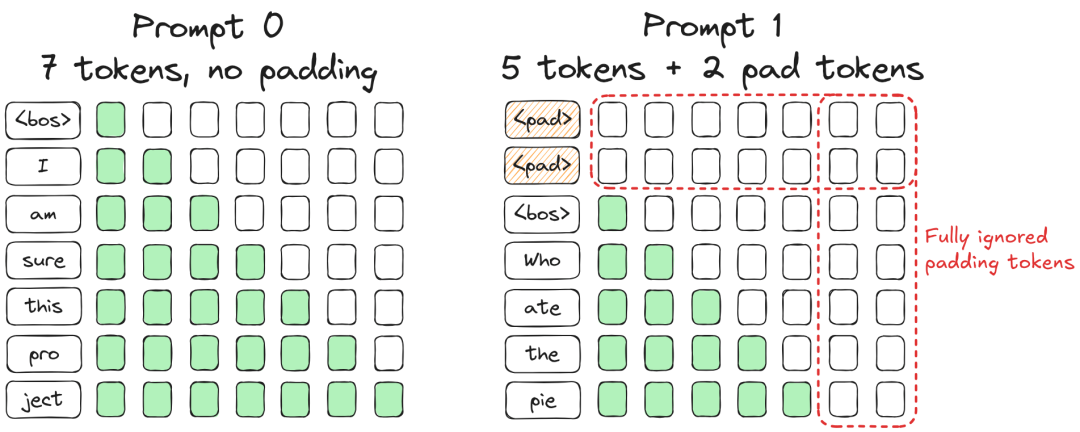
为了并行处理多条请求,传统方法是将多个 Prompt 组合成一个 Batch。由于张量运算要求形状规整(矩形),我们必须对短序列进行 Padding(填充),使其与最长序列对齐。

这种方法在 LLM 推理中有两个致命缺陷:

  1. “木桶效应”: 整个 Batch 必须等待最长的序列生成结束(遇到 <eos>)才能释放资源。短序列虽然生成完了,但显存和算力仍被占用。
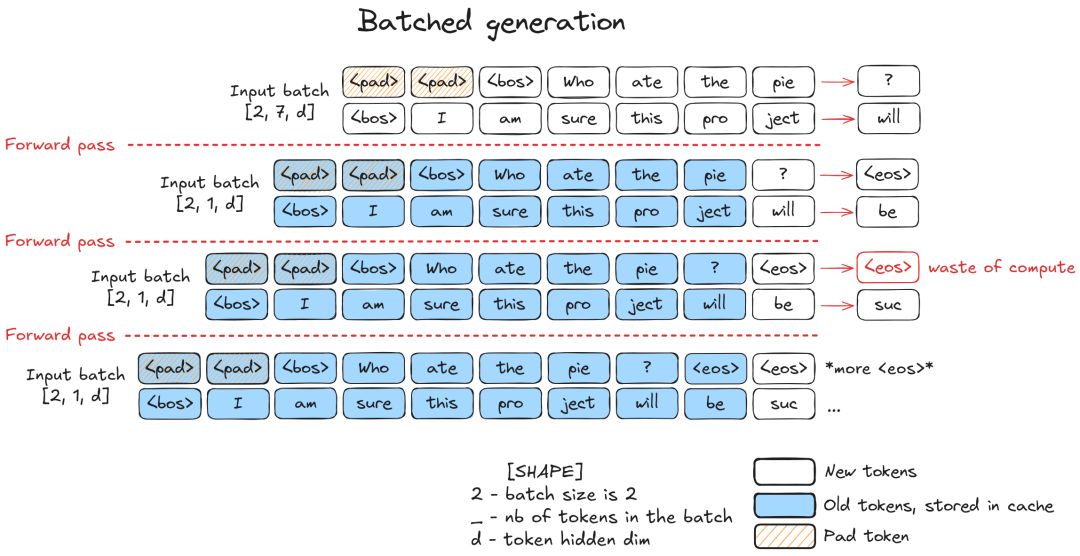
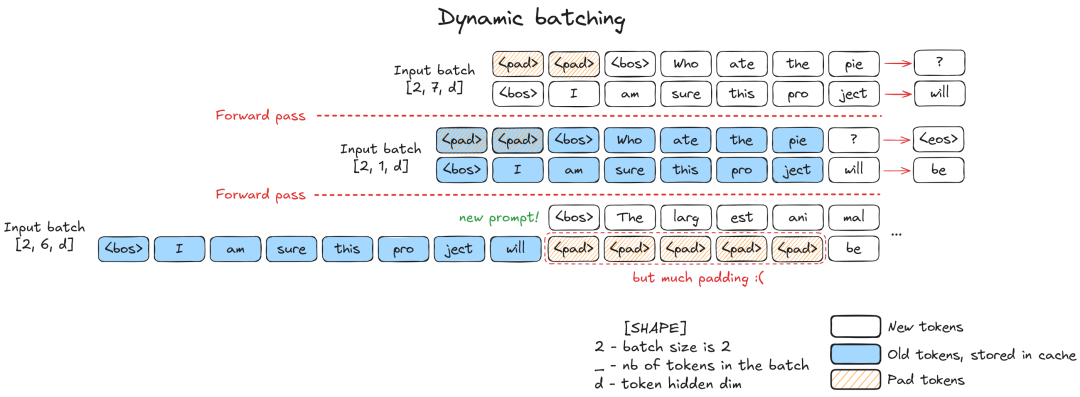
  2. 无效计算: 在动态调度(Dynamic Batching)中,如果我们在一个 Batch 中插入一条新请求(处于 Prefill 阶段),而其他请求处于 Decode 阶段,由于长度差异巨大,会导致大量的 Padding 填充。
  • 数据示例: 若 Batch Size=8,新插入请求长度=100,则需要填充 个无效 Token。这意味着大量算力被浪费在计算 Padding 上。
4.2 解决方案:Ragged Batching (参差批处理)

Continuous Batching 的核心思想是打破张量的几何束缚。如果不强制要求 Tensor 是矩形的,我们就不需要 Padding。
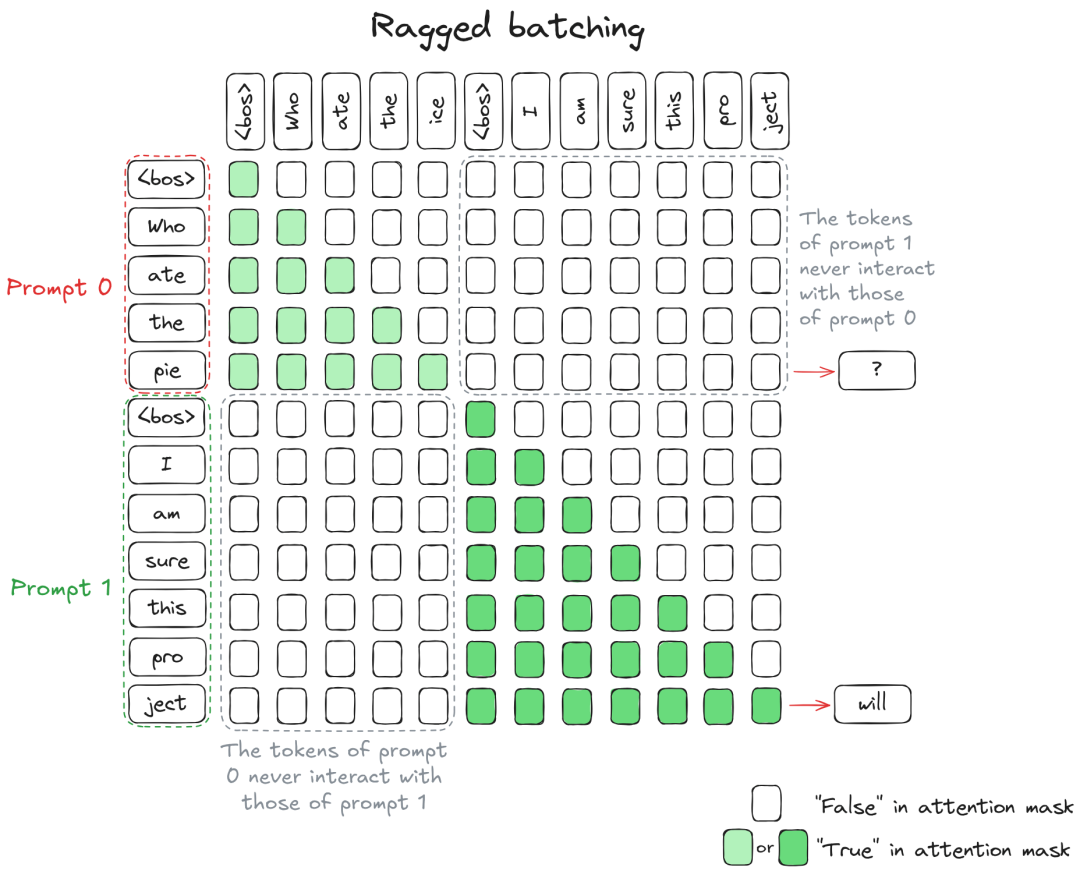
实现逻辑:

  1. 物理拼接: 将 Batch 中所有请求的 Token 在一维数组上直接拼接(Concatenate)。
  • 输入:[Prompt A Tokens] [Prompt B Tokens] ...
  1. 逻辑隔离: 利用 Attention Mask 这种“软件逻辑”来控制可见性。
  • 构建一个分块对角掩码(Block-diagonal Mask),确保 Prompt A 的 Token 只能看到 Prompt A 的内容,完全屏蔽 Prompt B。

这种方式被称为 Ragged Batching,它彻底消除了 Padding token,让 GPU 的每一次计算都作用于真实数据。

4.3 连续批处理调度算法
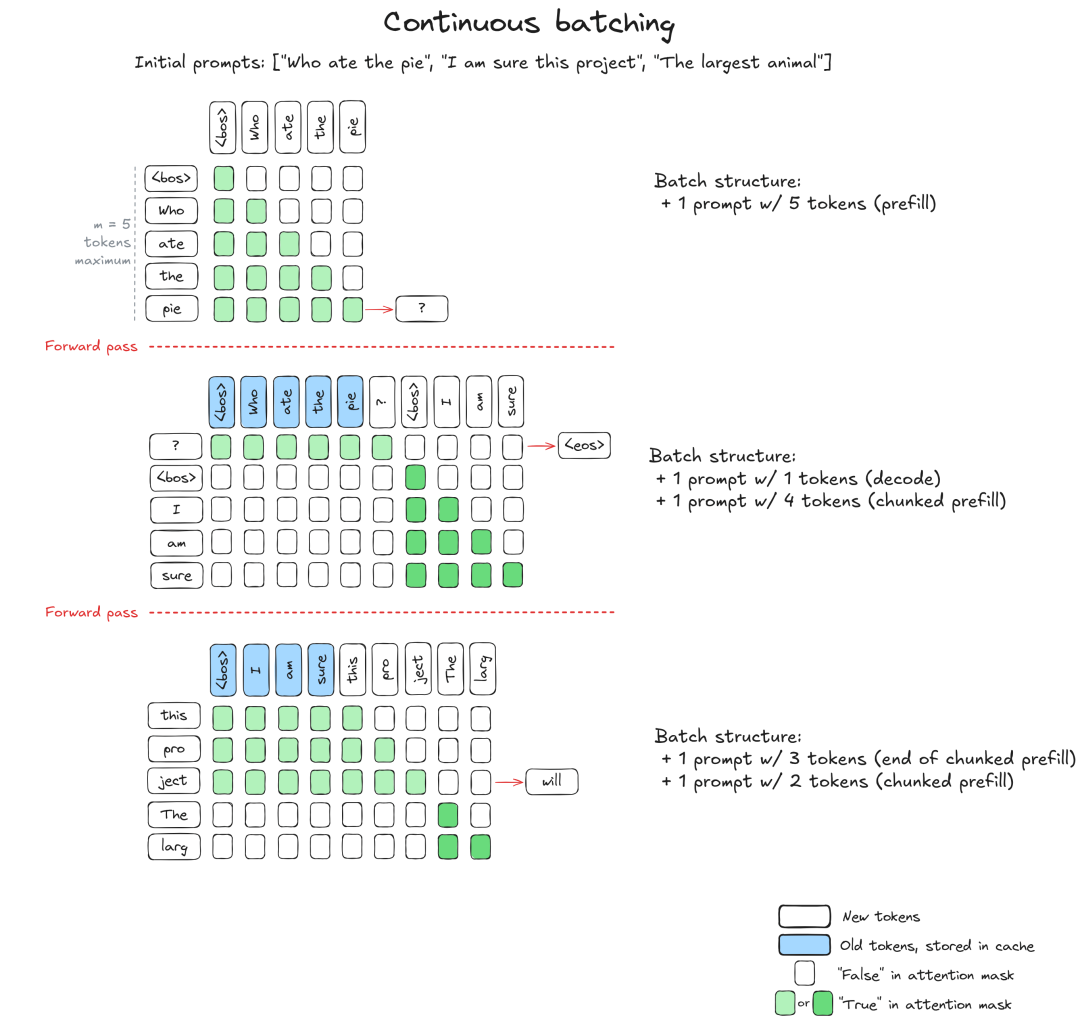
结合 KV Cache、Chunked Prefill 和 Ragged Batching,Continuous Batching 实现了一个极其高效的调度循环。

**调度策略:**我们设定一个总的显存/计算预算(Token 数量上限,记为 )。在每一个推理步(Step):

  1. 优先解码(Decode): 将所有正在生成中的请求加入 Batch。因为解码阶段每个请求仅贡献 1 个 Token,开销较小。
  2. 填充预处理(Prefill): 利用剩余的预算空间,插入新到达请求的 Prefill 数据。
  • 如果新请求太长,使用 Chunked Prefill 将其拆分,只填满剩余预算即可。
  1. 动态更替: 一旦某个请求生成了 <eos>,立即将其移除,释放的空间在下一个 Step 马上被新请求填补。

伪代码逻辑解析:

# 这是一个概念性的调度逻辑简化描述def continuous_batching_step(running_requests, waiting_queue, memory_budget):    batch_tokens = []        # 1. 优先处理正在解码的请求 (每个请求贡献1个token)    for req in running_requests:        batch_tokens.append(req.get_next_input_token())            # 2. 计算剩余容量    remaining_budget = memory_budget - len(batch_tokens)        # 3. 用新请求的 Prefill 填满剩余容量 (利用 Chunked Prefill)    while remaining_budget > 0andnot waiting_queue.is_empty():        new_req = waiting_queue.peek()        # 获取新请求的下一块 Token,大小不超过剩余预算        chunk = new_req.get_next_chunk(size_limit=remaining_budget)                batch_tokens.append(chunk)        remaining_budget -= len(chunk)                if new_req.is_prefill_complete():            running_requests.add(new_req)            waiting_queue.pop()    # 4. 执行无 Padding 的前向传播 (Ragged Batching)    run_model_forward(batch_tokens)

这种机制允许 Prefill(计算密集型)和 Decode(显存带宽密集型)任务在同一个 Batch 中混合运行,极大地提升了 GPU 的利用率和整体吞吐量。

结语

Continuous Batching 并非单一技术,而是三种核心技术的巧妙结合:

  1. KV Cache:以空间换时间,避免历史信息的重复计算。
  2. Chunked Prefill:打破内存墙,灵活处理变长输入。
  3. Ragged Batching & Dynamic Scheduling:消灭 Padding,实现纳秒级的细粒度资源调度。

正是这些底层技术的革新,支撑起了 ChatGPT 等服务在面对海量并发时的高效运转。对于致力于构建生产级 LLM 应用的开发者而言,理解并正确配置支持 Continuous Batching 的推理后端(如 vLLM, TGI, TensorRT-LLM),是实现降本增效的关键一步。

**下一步建议:**如果您对显存管理感兴趣,建议深入研究 PagedAttention 技术,它是为了解决 KV Cache 带来的显存碎片化问题而生的,通常与 Continuous Batching 配合使用以进一步提升性能。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大语言模型推理加速技术:计算加速篇 其中Q,K,V是模型的三个矩阵。context phase也叫prefill phase:需要计算整个prompt的自注意力,q_input, k_input, v_input大小都为[seq_len, emb_dim],即整个prompt的embedding,context phase只需要进行一次,生成第一个token。 阅读详情

相关推荐

LLM batch

llm batch策略

MichaelWang的博客 6062

大模型推理核心技术:Continuous Batching详解

作者:方佳瑞,腾讯 · Principal Software Engineer,清华大学计算机科学与技术博士个人主页:https://fangjiarui.github.io整理:青稞AIContinuous Batching现已成为大型模型推理框架的关键技术,也是框架性能优化的主战场。通过将多个在线请求进行批处理(Batching),可以提高 GPU 的使用效率。在 Transformer 出现...

zenRRan的博客 1万+

AI大模型学习路线:从Python基础到RAG与本地部署

大模型作为生成式AI的核心,本质是基于Transformer架构的概率预测器,通过海量数据预训练获得通用能力。理解其原理、掌握提示工程与API调用,是进入AI应用开发的基础。随着技术演进,检索增强生成(RAG)与智能体(Agent)成为解决知识更新与复杂任务的关键方案,而本地部署与推理优化则关乎数据安全与成本控制。本文梳理了一条从Python编程、机器学习基础到微调、RAG、Agent及生产落地的完整学习路径,结合实战代码与常见问题排查,帮助学习者避开误区,高效构建自己的AI应用。

weixin_33851177的博客 422

大模型推理服务调度优化技术-Continuous batching

本文先介绍了不同批处理基本概念区别,然后,讲述了 LLM 推理框架中提升吞吐性能最重要的技术 Continuous batching。同时,分析了其在不同框架中的应用实现。

weixin_72959097的博客 3014

企业AI工程化落地:可靠性、高性能与安全三大核心模式详解

在软件工程领域,构建稳定、高效且安全的服务是核心挑战,尤其当人工智能(AI)模型从演示环境走向生产系统时。其原理在于通过系统性的架构设计,将前沿的模型能力封装为可运维、可扩展的服务组件。这带来了显著的技术价值:它使得智能应用能够满足企业级对服务连续性、响应速度和数据合规的严苛要求,是AI技术产生实际商业效益的基石。典型的应用场景包括智能客服、内容生成与数据分析平台等,这些场景对服务的**可靠性**、**高性能**与**安全性**有着共同的诉求。本文聚焦于此,深入探讨了确保AI服务稳健运行的三大工程范式,涵盖

cuiyingchan0663的博客 379

AI推理框架的连续批处理(Continuous)与动态批处理(dynamic batching)

本文介绍了AI推理框架中的批处理技术,重点分析连续批处理和动态批处理的原理与应用。静态批处理适用于批量任务,但会增加延迟;动态批处理通过设置批处理大小和等待窗口,更适合图像生成等实时场景;而连续批处理在token级别处理请求,能显著提升LLM推理的吞吐量,避免GPU资源闲置。不同批处理方法需根据模型类型和业务需求选择,连续批处理是LLM部署的最佳选择,而动态批处理更适合大多数其他生成模型。

zg_hover的专栏 2063

大模型落地指南:从语言模型到AI汽车行业应用,收藏必备

BERT:采用了双向编码器,能够同时考虑一个词左侧和右侧的上下文信息,并通过MLM和NSP任务学习语言表示。这使得BERT在理解句子中的语义关系方面具有明显优势,尤其是在需要深刻理解上下文的任务中表现突出,如问答系统、文本分类等。不过,BERT的生成能力相对较弱,因为它主要用于理解和分析文本,而不是生成新的内容。GPT:是一个单向解码器模型,其训练目标是预测下一个词,基于当前词之前的上文进行推理。这种设计使得GPT特别擅长于生成连贯且自然的语言文本,比如文章创作、代码编写或对话生成等领域。

大模型研究中心 747

【信息科学与工程学】计算机科学与自动化 第二百零一十一 软件开发模型01

编号类型模型领域模型中的知识点/因素/参数关联知识和法律法规1传统顺序模型瀑布模型 (Waterfall)通用软件开发、硬件紧密耦合系统、政府/军工项目、需求稳定的传统信息系统严格线性阶段:可行性研究→需求分析(SRS,含功能/非功能/接口/约束,使用IEEE 830模板)→系统设计(概要设计HLD:架构、模块划分、数据库ER图;详细设计LLD:伪代码、类图、接口定义)→实现(编码规范、代码审查、静态分析工具SonarQube)→测试(单元测试JUnit、集成测试、系统测试、验收测试UAT,测试计划提前编写

weixin_49199313的博客 167

AI大模型系统化学习路径与实战指南

人工智能领域的Transformer架构已成为大模型的核心技术,其背后的数学原理如线性代数和概率统计构成了深度学习的基础。通过PyTorch等框架实现自定义神经网络模块,开发者能够深入理解梯度下降和反向传播机制。在工程实践中,Docker容器化和Kubernetes编排技术显著提升了模型部署效率,而8bit量化与知识蒸馏等优化方法则大幅降低了推理延迟。针对当前AI大模型学习中普遍存在的知识碎片化问题,本文提供从数学基础到分布式训练的全链路学习方案,特别适合需要处理自然语言处理(NLP)和计算机视觉(CV)任

weixin_30565199的博客 289

vLLM介绍

介绍vLLM

MichaelWang的博客 2479

深入解析璞致PZ-ZU47DR RFSoC核心板:硬件架构与多通道ADC/DAC设计实战

本文深入解析璞致PZ-ZU47DR RFSoC核心板的硬件架构与多通道ADC/DAC设计实战。作为Xilinx Zynq UltraScale+ RFSoC系列的代表产品,PZ-ZU47DR集成了8通道5GSPS ADC和8通道9.85GSPS DAC,支持直接射频采样,大幅简化射频链路设计。文章详细介绍了其技术优势、设计挑战及实战技巧,为5G小基站、毫米波等应用场景提供高效解决方案。

meat5的博客 843

【AI Infra小白入门④】AI Infra学习路线图:从入门到精通的完整指南(附核心思维方法)

AI Infra的知识体系太庞大了——CUDA、分布式训练、编译器、推理引擎、量化、Serving……随便拎出来一个都是深坑。盲目跟风:今天学CUDA,明天听说量化火又去学量化,结果每样都只懂皮毛迷失细节:一头扎进某个细节里,学了半天不知道学了有什么用所以,在动手学习之前,先搞清楚"全貌"和"路线"非常重要。五个阶段:前置基础 → CUDA/算子 → 分布式训练 → 推理部署 → 项目实战核心思维:任何技术都是"不可能三角"的取舍——"牺牲了什么,换取了什么"是检验理解的最好问题四条学习建议。

Dawson Zhu的博客 329

YOLOv8-seg模型后处理实战:从输出解析到mask生成的完整流程

本文详细解析了YOLOv8-seg实例分割模型的后处理完整流程,从理解output0与output1的双输出结构,到实现检测框的置信度过滤、坐标转换与NMS,再到核心的掩膜生成数学原理与矩阵乘法实现。文章深入探讨了如何将掩膜系数与原型掩膜库结合,生成像素级分割结果,并提供了掩膜上采样、边缘优化、性能提升及解决实际应用难题的实战方案。

xgboost6farmer的博客 318

2026年AI时代程序员学习路线图:从零基础到拿大厂Offer的完整规划(2万字深度长文)

本文为不同阶段的程序员绘制完整学习路线图,覆盖零基础入门到架构深挖四个阶段,附在职跳槽和应届校招时间规划模板及常见误区避坑指南。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 1090

开关变换器分析:大信号模型与小信号模型

是电力电子系统建模中的两类基本方法,分别用于描述系统在不同工作条件下的动态行为。它们的核心区别在于是否对变量进行线性化近似,以及适用的分析场景。

创新改变世界! 1913

用python提取PDF中各类文本内容的方法

用python提取PDF中各类文本内容的方法

安静的软件工程师 6089

Continuous Batching:解锁LLM潜力!让LLM推断速度飙升23倍,降低延迟!

©作者 | 时空猫的问答盒单位 | 北京大学本文介绍一篇 LLM 推理加速技术相关的文章,值得读一读。LLMs 在现实应用中的计算成本主要由服务成本所主导,但是传统的批处理策略存在低效性。在这篇文章中,我们将告诉你,为什么 Continuous Batching 连续批处理成为了解决这一问题的新方法,而不再把 LLMs 视为“黑匣子”。这个技术如何利用内存,而不是计算能力,来实现 10 倍以上的性...

Paper weekly 1759

基于KiCad的STM32最小系统设计实战案例(含PCB布线)

手把手带你用KiCad完成STM32最小系统设计,涵盖原理图绘制、封装匹配、规则约束设置及关键信号PCB布线技巧;全程基于开源EDA工具KiCad,强调实操细节与常见坑点规避。

weixin_42452483的博客 361

AI菜鸟向前飞 — LLM简介

AI菜鸟向前飞 — LLM简介

2401_82469710的博客 2577

Esp32蓝牙Hid调用方案 http执行设备、鼠标、键盘相关操作

本文主要介绍 Esp32 蓝牙 Hid 相关的多种操作方式,详细的设备、鼠标、键盘相关操作的 http 调用方法。下面是整理出的所有 http 调用方法和 rhino 引擎方式。本机调用的话直接使用http://localhost:8080 如果是局域网调用则使用软件里的地址 比如我的是http://192.168.1.5:8080。文件地址: https://www.123865.com/s/Qtm4jv-xyZbd?使用前需要一块烧录好的ESP32板子并在手机安装好embedded软件用于蓝牙通信。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 571

正弦波、方波、三角波和锯齿波信号发生器——Multisim电路仿真

调节方波信号的占空比,也就是改变输出信号的高低电平时间比例,可以设置电容不同的充放电时间来达到目的,RP2可以使得电容具有不同的充放电时间,其中二极管起到限制电流流向的作用。假设U+>U,那么输出端就达到正向饱和,电容开始充电,当电容电压大于同相输入端电压时,此时电容开始放电,由此往复,从而产生方波信号。3,正反馈支路占优势,电路开始起振并不是稳定的,振荡会不断增大,最终将导致运放饱和,输出的波形是削波失真的正弦波。通常在电路中引入负反馈,例如使用负温度系数的热敏电阻,以自动稳定增益,防止输出波形失真。

XU157303764的博客 5325

Continuous Batching:吞吐量十倍提升的调度革命

静态批处理让整个 batch 等最慢的请求,显存与算力在等待中空转;Continuous Batching 把调度粒度从"请求级"降到"迭代级",每步都能补位与退出,配合 PagedAttention 的显存弹性,vLLM 实现了对 HF Transformers 最高 23 倍的吞吐提升。本文拆解木桶效应的量化损失、迭代级调度的执行细节、Prefill-Decode 干扰与分离方案,并给出吞吐收益的来源拆解与适用边界。

深耕人工智能底层逻辑,专注大模型架构、分布式训练与推理优化。在这里,不贩卖焦虑,只拆解硬核技术。从Transformer的数学之美到Agent的工程落地,用代码和论文说话,记录在AI浪潮中探索技术边界的每一步的专栏 267

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

continuous batching、chunked-prefill相关概念

decode那个batch的token较少填不满batch时,才会把prefill加进来。DeepSpeed是chunked prefill,即把input拆分,和decode阶段的batch到一起。continuous batching是每完成1个request,就让1个新request加入到batch里。好处:可以让decode阶段的一个batch的token数目不减少,确保计算密度。batching是所有requests的output都生成完毕之后,才能开始处理下一个batch。

smartcat2010的博客 1276

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【推理与部署篇09】连续批处理Continuous Batching深度解析:吞吐量革命的底层引擎

本文深入解析了连续批处理(Continuous Batching)技术,这是现代LLM推理引擎实现吞吐量革命的核心技术。文章首先分析了GPU在LLM推理中的"吞吐-延迟"矛盾,指出解码阶段的小批量计算导致GPU利用率极低(仅5-15%)。随后对比了静态批处理的局限性和连续批处理的创新之处,后者通过细粒度的迭代级调度,实现了请求的动态加入/退出和KV Cache的高效管理,使GPU利用率提升至50-70%。文章还详细探讨了连续批处理的核心实现机制、调度策略、与PagedAttention的协同优化,以及各主流

weixin_54908067的博客 390

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

上一篇: 大模型必学技术:RAG检索增强生成实战指南 | 程序员收藏必备
下一篇: 【建议收藏】AI Agent技术剖析:让AI从“会聊“到“会干“的进阶之路
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1478原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值