收藏!从零构建RAG智能问答系统:知识库设计与实战全攻略

从零构建企业级RAG智能问答系统:FastAPI工程化落地全攻略 很多同学学完RAG基础后,都能写出一个"能跑"的Demo:加载文档→切块→向量化→检索→大模型生成答案。怎么把功能变成API给前端调用?用户问的问题高频重复,每次都走RAG太慢怎么办?大模型输出要等好几秒,用户体验差怎么解决?多轮对话怎么处理?历史记录存哪?怎么评估RAG系统效果好不好?手动写测试用例?并发请求一来,服务直接卡死?这些问题,文档解析和向量检索都解决不了——它们属于工程化落地的范畴。本文将围绕一个真实的企业级RAG问答系统,把这些问题一个个讲透。 阅读详情

在人工智能浪潮的推动下,智能问答系统正日益成为企业服务、在线教育、智能客服等领域的核心交互工具。其中,基于检索增强生成(Retrieval-Augmented Generation,简称RAG)的技术架构,因其能够有效结合外部知识、缓解大模型“幻觉”问题、并保持信息的实时性,而受到了广泛青睐。

在探讨RAG的优化之道时,我们往往会接触到诸如问题改写、重排序、混合检索等多种精妙的技巧。这些技术方案在很大程度上是“可复用”的通用组件。然而,当我们拨开这些技术迷雾,会发现整个系统的效能根基,深深扎在一个独特且无法取巧的领域——知识库的构建。

可以说,知识库的构建不仅重要,更是一项需要深刻理解业务、充满“匠心”的定制化工程。
在这里插入图片描述

一、 RAG的运作机理:知识库是不可或缺的“外部大脑”

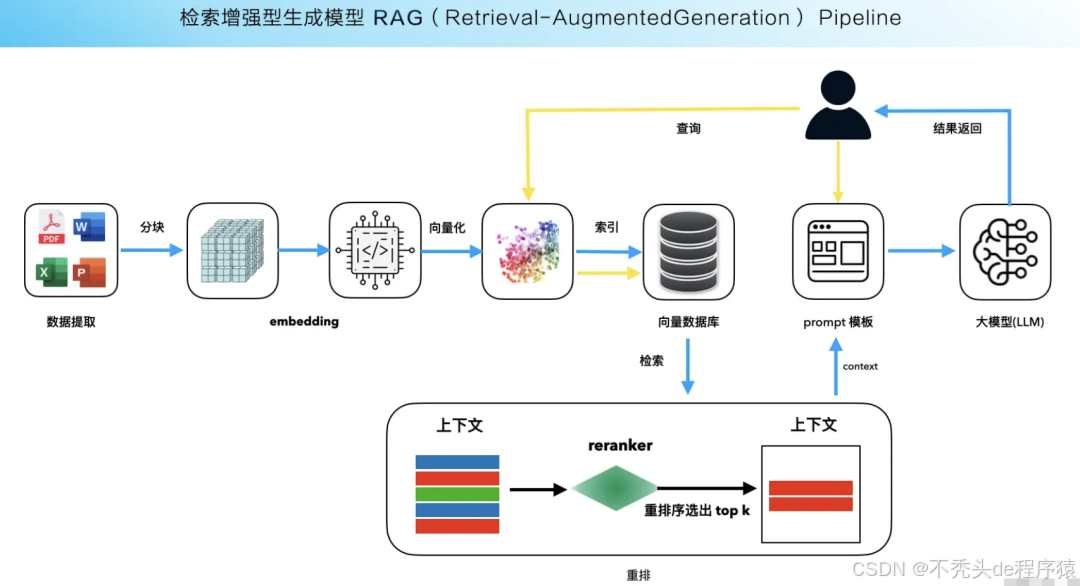
要理解知识库的重要性,首先需要明晰RAG的基本工作原理。RAG并不完全依赖大模型自身在训练时学到的、可能过时或泛化的知识。它将生成过程分为两大核心阶段:

  • 检索(Retrieval):当用户提出一个问题时,系统并非直接让大模型回答,而是首先从一个外部的、专门构建的知识库中,检索出与问题最相关的信息片段。
  • 生成(Generation):随后,系统将这些检索到的、高质量的参考信息,与用户的原始问题一同作为提示(Prompt),提交给大模型。大模型基于这些“证据”进行加工、整合和润色,最终生成一个准确、有据可依的答案。

在这个流程中,大模型扮演了一位“博学的撰稿人”角色,而知识库则是这位撰稿人专属的、精心编排的“资料库”。

无论撰稿人的文笔多么精湛,如果资料库本身杂乱无章、资料陈旧或缺斤短两,那么他最终写出的文章也必然错误百出或答非所问。

因此,知识库的质量,直接决定了RAG系统能力的上限;后续所有的优化手段,都只是在尽可能地逼近这个上限。
二、 “通用”与“专用”的辩证:为何知识库难以通用化?

在RAG的检索环节,许多优化方案是通用的。例如:

  • 问题改写:将简短、模糊的用户查询,扩展成更全面、更易于检索的句式。
  • 历史记录管理:利用多轮对话的上下文,更精准地理解用户的当前意图。
  • 重排序:使用更精细的模型对初步检索出的大量结果进行二次排序,挑出最相关的几条。

这些技术如同精良的工具,可以应用于不同的业务场景,提升检索的精度和召回率。它们的“通用性”源于其解决的是“如何找”的流程性问题。

然而,知识库构建解决的则是“从哪里找”的根源性问题。它的“专用性”和“不可通用化”主要体现在以下几个方面:

1. 业务场景的独特性决定了知识内容与结构
不同的行业和业务,其知识体系天差地别。

  • 法律咨询:知识库需要包含严密的法律条文、司法解释和典型案例。其结构要求高度精确,章节、条款、颁布时间等元数据至关重要。
  • 医疗诊断:知识库需要涵盖疾病百科、药品说明书、临床指南等。它对准确性要求极高,且需要复杂的医学术语体系和关联关系。
  • 企业内部知识管理:知识库可能由大量的产品手册、技术文档、会议纪要和项目报告构成。其结构松散,格式多样(Word, PDF, PPT),且需要频繁更新。

试图用一个通用的知识库模板来承载法律、医疗和企业管理这三种截然不同的知识,其结果必然是任何一种都无法满足需求。

2. 数据形态的多样性催生差异化的存储方案
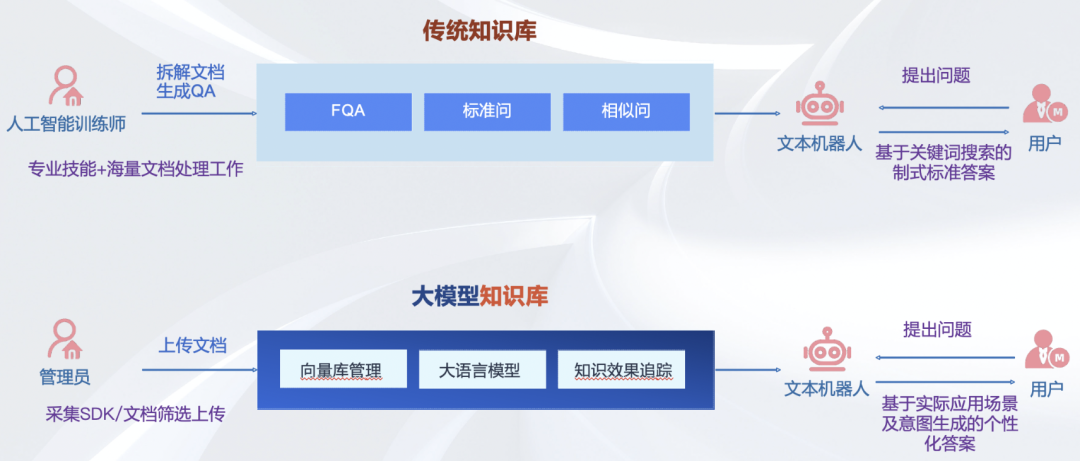
知识库的构建并非简单地将文档堆砌在一起。面对不同类型的数据,我们需要“因材施教”,选择最合适的存储和检索方案,而这本身就构成了知识库的独特结构。

  • 传统关系型数据库:适用于存储高度结构化、模式固定的数据,如产品规格参数、用户信息等。当查询条件明确(如“查询型号为A123的手机的电池容量”)时,其效率极高。
  • 向量数据库:这是RAG的核心组件之一,擅长处理非结构化数据(如文本、图片)。它将文本内容转换为数学向量(Embedding),通过计算向量间的相似度来找到语义上最相关的文档片段。它完美解决了“根据意思找资料”的需求,例如用户问“如何解决设备无法开机的问题”,系统能匹配到关于“故障排查”、“电源检查”的段落。
  • 知识图谱:当业务需要理解实体间复杂的关系时,知识图谱是无可替代的选择。例如,在金融风控场景中,我们需要知道“公司A”的“法定代表人”是“某人B”,而“某人B”又“控股”了“公司C”。这种关系的推理能力,是向量检索难以直接实现的。

一个成熟的RAG系统知识库,往往是多种存储方案相结合的混合体。如何为特定的业务数据设计这种混合结构,是一项高度定制化的任务。

3. 知识质量与治理的直接体现
知识库的“构建”远不止是技术上的导入,更是一个持续的知识治理过程。这包括:

  • 数据清洗与预处理:去除无关内容、纠正错别字、统一格式。
  • 知识切片:如何将长文档切割成大小适中、语义完整的片段(Chunks)。切片策略直接影响检索效果,过大则信息冗余,过小则语义缺失。
  • 元数据标注:为每个知识片段打上丰富的标签,如文档来源、所属部门、更新时间、机密等级等。这些元数据是进行高效过滤和重排序的关键。
  • 更新与维护机制:知识是流动的。如何确保知识库能够及时、准确地反映最新变化,建立一套可持续的更新流程,是知识库保持生命力的核心。

这些工作的质量,无一不深深烙印着特定业务的印记,无法通过一个通用的解决方案一劳永逸地完成。

三、 构建卓越知识库:一项精密的系统工程

认识到知识库的独特性和重要性后,我们应将其构建视为一项系统工程,重点关注以下几个环节:

  1. 需求分析与知识审计:明确系统的核心目标用户和要解决的典型问题。盘点现有的知识资产,评估其质量、数量和形态。
  2. 技术选型与架构设计:根据知识的特点,设计混合存储架构。确定是以向量数据库为主,还是需要深度融合知识图谱;明确关系型数据库需要承载哪些结构化信息。
  3. 数据管道与 embedding 模型选择:建立自动化的数据处理管道,完成清洗、切片和向量化。选择与业务领域匹配的Embedding模型至关重要,一个在通用语料上训练的模型,在法律或医疗领域的表现可能大打折扣。
  4. 迭代与优化:知识库的构建不是一次性的。需要通过真实的用户问答数据,持续评估检索效果,反过来调整切片策略、元数据方案甚至Embedding模型,形成一个闭环的优化流程。

结论

在基于RAG的智能问答系统中,知识库绝非一个简单的“数据容器”,而是整个系统的价值核心与智慧源泉。那些通用的检索优化方案,是让系统“跑得更快、更准”的润滑剂和加速器,但知识库本身,决定了系统“在哪里跑”以及“能跑多远”。

它是一项深度融合了业务洞察、数据科学和工程实践的匠心工程。忽视知识库构建的复杂性和独特性,企图寻找通用捷径,无异于舍本逐末。只有沉下心来,像雕琢艺术品一样精心构建和维护属于自己业务的知识库,才能打造出真正智能、可靠且具有实用价值的问答系统,让技术真正赋能于业务,释放出知识的最大力量。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

智能问答系统:知识库构建与查询优化 1. 背景介绍 随着信息技术的飞速发展,海量数据不断涌现,如何高效地获取和利用这些信息成为一个重要挑战。传统的搜索引擎往往只能返回与关键词匹配的文档列表,无法直接给出用户想要的答案。而智能问答系统(Question Answering System,QA System)则能够理解用户的问题,并从海量数据中找到准确的答案,为用户提供更便捷、高效的信息获 阅读详情

相关推荐

聊天机器人基础知识库

web开发智能机器人需要的基础问答知识库

基于知识图谱的智能问答

基于neo4j的知识图谱智能问答;采用JointBERT完成意图识别、实体识别、属性识别;用GrapthSAGE图神经网络完成失信行为预测

weixin_46571822的博客 1万+

智能客服知识库,任务,问答

智能客服知识库,任务,问答 AI_CHAT: 1.知识库逻辑:class LexiconIndexesSet(ModelViewSet) 新建知识库并存到redis: Request: url = url+"/knowbase/" data = {"kbId": kbid, "name": name} Deal: LexiconIndexes.objects.create(**data) cache.set(str(data['id']), "0", timeout=1209600) 删除知识库: Request: url = url + "/knowbase/" + id + "/" Deal: LexiconIndexes.objects.all().filter(id__startswith=std_id).delete() cache.delete_pattern(str(std_id)) 2.问答对逻辑:class QuestionsSet(ModelViewSet) 新建单个问答对: Request: url = url + "/qapairs/" data = { "kbId": kbid, "questionId": questionid, "questions": [ { "question": "沒有那海洋的寬闊" }, { "question": "我只要熱情的撫摸" }, { "question": "所謂不安全感是我" } ], "answer": "我沒有滿腔的熱火" } 批量创建问答对: Request: url = url + "/qapairs/" + "?batch=True" data = { "kbId": "lnn072401", "qas": [ { "questionId": "test_q2_by_lnn", "questions": [ { "question": "你好123" }, { "question": "您好123" }, { "question": "nihao123" } ], "answer": "bsfe4b25-3ddf0-4114-92bd-7c254d145d96" }, { "questionId": "test_q3_by_lnn", "questions": [ { "question": "在1" }, { "question": "在吗1" }, { "question": "zaima1" } ], "answer": "bsfdsb25-3ddf0-3323-92fd-7c252dfsf97" } ] } Deal: 1.验证知识库是否存在 LexiconIndexes.objects.get(id=kb) 2.循环问题列表,将第一个问题作为标准问题id为questionId,其他问题的id使用questionId + '_' + str(i)拼接 3.objs中存放问答对处理后的对象,用于批量创建 infos存放问答对的dict格式,用于更新操作 objs = [Questions(**qa_dict)] infos = [qa_dict] Questions.objects.bulk_create(_objs) 更新问答对: Request: url = url + "/qapairs/" + id + "/" data= { "kbId": "lnn071602", "questions": [ { "question": "你好96" }, { "question": "您好96" }, { "question": "nihaonihao96" } ], "answer": "bsfe4b25-3ddf0-4114-92bd-7c254d145d39" } Deal: 1.将问题id更新到data中 request.data.upd

基于Bert的知识库智能问答系统

利用预训练的 BERT模型来实现自然语言理解和问答,同时将知识库和问答系统进行整合,从而能够对用户提出的问题进行准确、高效的回答。该系统通过将问题和知识库中的实体和关系进行匹配,从而找到最佳答案。具体来说,本系统先将三个属性:实体(问题),实体关系(实体属性),实体(答案)存储进 mysql 数据库。当提出问题时,用 BertCrf模型来识别出问题中所包含的实体,识别出实体之后就可以进行数据库的查询;识别出实体后就需要进行实体与属性的连接,利用BertForSequenceClassification模型进

a1105425455的博客 7034

告别Docker Desktop!Colima在Mac上的5分钟极速安装与配置指南(M1芯片实测)

本文详细介绍了如何在Mac(尤其是M1芯片)上快速安装和配置Colima,作为Docker Desktop的免费替代品。通过优化配置和实战指南,帮助开发者提升容器运行效率,减少资源占用,实现丝滑的开发体验。

weixin_28839601的博客 445

深入解析五大ADC芯片架构及其应用场景

本文深入解析了五大ADC芯片架构及其应用场景,包括逐次逼近型ADC、Σ-Δ型ADC、流水线型ADC、闪存型ADC和积分型ADC。通过详细的架构分析和实际应用案例,帮助工程师理解不同ADC芯片的特点和适用场景,提升电路设计效率。

weixin_28702105的博客 355

RAG系统核心揭秘:为何知识库构建是智能问答的基石

在人工智能浪潮的推动下,智能问答系统正日益成为企业服务、在线教育、智能客服等领域的核心交互工具。其中,基于检索增强生成(Retrieval-Augmented Generation,简称RAG)的技术架构,因其能够有效结合外部知识、缓解大模型“幻觉”问题、并保持信息的实时性,而受到了广泛青睐。 在探讨RA

2401_84204207的博客 991

PLL锁相环基础知识(一)

本文介绍了锁相环(PLL)的核心组件及其工作原理,重点阐述了压控振荡器(VCO)的结构与调谐机制。VCO作为PLL的关键部分,通过变容二极管实现频率调谐,但易受温度、电压等因素影响稳定性。文章详细讲解了VCO的谐振电路原理、硅基集成方案,以及通过分频器和调制器实现的频率控制技术。特别分析了整数型和分数型N分频器的差异,指出高阶德尔塔-西格玛调制器可有效降低分数杂散。文章还探讨了预分频器的应用及其对频率分辨率的影响,揭示了PLL通过反馈环路实现频率锁定的基本原理。

weixin_49761275的博客 3035

AI知识库与大模型的智能问答实现

本文将探讨AI知识库与大模型如何通过智能问答技术实现知识自动化,包括其工作原理、实际应用场景及对企业决策的支持。通过分析实际案例,展现如何利用智能问答提升信息获取效率与知识管理的自动化水平,助力企业更快适应市场变化。

liju_yang的博客 876

Microsemi Libero使用技巧11——CoreUARTAPB RX管脚分配时不显示

调用串口IP核CoreUARTAPB,并例化到顶层设计,发现UART_RX管脚在进行管脚分配时没有显示出来,最后发现是CoreAPB3总线IP核配置不对导致,改为如下配置后正常。

whik1194的博客 758

windows一键安装部署wvp-GB28181-pro视频监控平台

我们可以看到redis、mysql、zlm和wvp都正常运行了。该ip需要修改为wvp服务安装的 服务器的IP。默认用户名和密码分别为admin和admin。

zengliguang的专栏 5748

收藏!企业知识库智能问答系统实践:从30%到90%准确率的RAG优化全攻略

召回阶段:相关文档命中率达到95%(较初期提升65个百分点);生成阶段:答案准确率达到90%(较初期提升60个百分点);用户体验:响应时间控制在1秒内,用户满意度达到85%以上,已成功投入企业内部生产运营,为员工提供高效的知识库查询服务。

大模型研究中心 1043

解决Jupyter Notebook中Plotly图表显示问题

摘要:在Jupyter Notebook中使用Plotly绘图时遇到图表无法显示的问题。通过分析发现Python 3.12版本与Jupyter存在兼容性问题。解决方案是将Python降级到3.11版本,重新创建虚拟环境后图表正常显示。这表明版本兼容性对数据可视化工具至关重要,环境配置检查是解决问题的关键步骤。该案例为遇到类似问题的开发者提供了参考方案。

m0_74337424的博客 125

【强烈收藏】LangChain+RAG:从理论到实践,零基础构建智能问答系统全攻略

文章详细介绍了LangChain框架与RAG技术的结合应用,通过模块化组件构建智能问答系统。从LangChain核心模块解析到Chain Type选择,再到完整示例展示如何使用DeepSeek和Faiss构建本地知识库检索,文章提供了从理论到实践的全面指导。这种结合不仅提高了答案的实时性和可追溯性,还大幅降低了开发难度,适合开发者快速构建企业级智能应用。

2401_84815887的博客 953

图注意力网络(GAT)原理与代码实战案例讲解

1. 背景介绍 图注意力网络(Graph Attention Network,简称GAT)是一种基于图神经网络(Graph Neural Networks,简称GNN)的深度学习方法。它能够处理具有复杂关系的节点数据,并在多个领域取得了显著的效果,如社交网络分析、推荐系统等。 2. 核心概念与联系

AI架构师小马 2712

时间序列分析(Time Series Analysis) 原理与代码实例讲解

时间序列分析(Time Series Analysis) - 原理与代码实例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 关键词:时间序列预测,ARIMA模型,状态空间模型,SARIMA模型,机器学习

AI天才研究院 1248

【收藏必学】RAG原理到实战:LlamaIndex构建智能问答系统全攻略

本文是一篇关于RAG检索增强生成技术与LlamaIndex框架的全面教程。通过《长安的荔枝》案例,从RAG基本原理出发,详细介绍了chunk_size、top_k等关键参数对系统效果的影响,并展示了用不到30行代码构建问答系统的实战方法。文章还深入剖析了LlamaIndex的架构设计,以及如何结合AgentBay工具扩展RAG系统的能力,为开发者提供了从入门到实践的完整指导。

2401_85154887的博客 871

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【技术收藏】从朴素到高阶:RAG技术演进与智能问答系统全攻略

本文系统阐述了检索增强生成(RAG)技术从基础到高阶的演进过程,详细分析了朴素RAG的局限性,提出了涵盖数据预处理、增强检索和精炼后处理的高级RAG框架。介绍了混合检索、查询转换、重排序和上下文压缩等关键技术,并通过端到端项目实战展示了如何构建生产级RAG管道,旨在帮助AI工程师将问答能力从"可用"提升至"卓越",实现更准确、可信赖的智能问答体验。

2401_85375186的博客 1687

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

本地RAG知识库搭建全攻略,一文搞定大模型文档检索技术,值得收藏!

文章介绍了如何使用开源模型nomic-embed-text搭建本地RAG知识库,实现高效文档检索。详细说明了模型的基本信息、特性和性能优势,提供了完整的搭建步骤,包括下载模型、创建工作区、文档向量化与存储,以及检索测试。同时展示了模型的两种使用方式,通过Hugging Face Transformers或Nomic官方API,满足不同开发需求,让新手也能轻松上手构建自己的知识库。有些努力,虽然暂时看不见结果,却在悄悄改变你。-摘。

2401_85375298的博客 2062

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

RAG 知识库开发全攻略:从原理到实战,初学者也能轻松掌握,大模型入门到精通,收藏这篇就足够了!

本文将从学习目标、技术原理到实战操作,全方位拆解 RAG 知识库开发流程,确保每一步都有扎实的理论支撑和可落地的实操指南。

huang9604的博客 1542

【必看收藏】大模型RAG技术全攻略:从原理到实践,构建有据可依的智能问答系统

RAG技术通过检索外部知识增强大模型回答,减少"幻觉"并提高准确性。文章系统介绍了RAG的核心逻辑、三大流程(索引、检索、生成),并详细阐述了优化策略,包括提问优化、多路召回、索引结构优化等。同时提供了全面的评估方法,从检索到生成环节的量化指标,以及人类评估维度,最后针对RAG幻觉问题提出了具体解决方案,形成优化与评估的闭环思路。

2401_85325726的博客 1184

让你的笔记“活”过来!从个人AI到企业大脑,高精度RAG知识库构建全攻略!

在企业中,垂直RAG知识库包含了特定领域的专属术语、事实信息和内部规范,使得问答系统能够处理高度专业化的问题,同时能避免敏感数据泄露。

weixin_58753619的博客 1053

【必学收藏】Dify知识库搭建全攻略:从零开始构建企业级AI应用

Dify通过知识库索引优化、多模态支持和动态参数校验,构建了企业级 AI 知识库的完整技术栈。其本地化部署方案在数据安全(GDPR/HIPAA 合规)、性能和成本上具有显著优势。无论是医疗、金融还是制造业,均可通过 Dify 实现私有数据的智能管理与精准应用。建议企业结合自身业务场景,灵活运用 FireCrawl 爬取、Xinference 模型部署等扩展方案,打造贴合需求的行业级知识库系统。

大模型教程的博客 1075

【程序员必读】知识库建设全攻略:提升RAG系统性能的核心秘诀(建议收藏)

摘要:知识库作为RAG系统的核心组件,其质量直接决定智能问答系统的性能表现。构建高效知识库面临多数据源兼容、复杂格式处理、数据更新与版本管理等关键挑战。通过模块化架构设计,包括数据对接、文档标准化、切片向量和召回优化等环节,可显著提升系统稳定性和扩展性。研究表明,在大模型时代,完善的知识库建设是智能问答系统成功的基础,需要重点关注数据处理、语义保持和检索优化等核心技术环节。(149字)

m0_63171455的博客 701

【建议收藏】2026年RAG技术全攻略:从基础架构到智能Agent的实战指南

文章系统介绍了2025年检索增强生成(RAG)技术的架构演进,从基础Naive RAG到智能Agent的发展路径,对比了主流RAG工具的特点与适用场景,并详细阐述了构建高效RAG系统的最佳实践,包括数据处理、检索优化、生成策略和评估迭代方法。文章还展望了多模态融合、自适应技术等未来发展方向,以及企业应用中面临的挑战。

datian1234的博客 1866

RAG知识库搭建全攻略:检索增强生成技术详解与企业应用(建议收藏)

RAG(检索增强生成)是一种融合信息检索与大模型生成能力的技术架构,通过检索相关文档片段、增强上下文并生成精准答案。本文详细介绍了搭建RAG知识库问答系统的完整流程,包括数据准备、向量生成与存储、文档检索(关键词、语义、混合等多种方式)及答案生成,并提供了后续优化建议,为企业构建高效知识库系统提供了实用指南。

bugyinyin的博客 770
上一篇: AI Agent框架选型攻略:LangGraph、Agno、Parlant全方位对比与实战指南(建议收藏)
下一篇: 稳定AI输出质量的秘密:提示工程四大核心要素,收藏起来慢慢学
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值





