大模型技术学习指南:从基础到应用的全面梳理(必收藏版)

MacOS下Mixly 2.0安装避坑指南:从Java环境到终端权限全解析 本文详细解析了在MacOS系统上安装Mixly 2.0时可能遇到的核心问题与解决方案。针对Java环境版本不兼容、MacOS Gatekeeper安全机制拦截以及终端权限不足三大常见障碍,提供了从检查并配置正确Java版本、安全设置绕过到彻底解决应用内部工具链权限的完整避坑指南,帮助用户顺利完成安装并正常使用。 阅读详情

“ 学习是一个从围观到宏观,从宏观到微观的一个过程 ”

学习大模型技术也有几个月的时间了,之前的学习一直是东一榔头,西一棒槌,这学一点那学一点,虽然弄的乱七八糟,但对大模型技术也算有了一个初步的认识。

因此,今天就来整体梳理一下大模型技术的框架,争取从大模型所涉及的理论,技术,应用等多个方面对大模型进行梳理。‍‍‍‍‍‍‍‍

01 大模型技术梳理

这次梳理大模型不仅仅是大模型本身的技术,而是一个以大模型为核心的涉及到多个方面的理论,技术和应用实践,也可以说是对自己学习大模型技术的总结吧。

话不多表,下面开始进入正题。‍

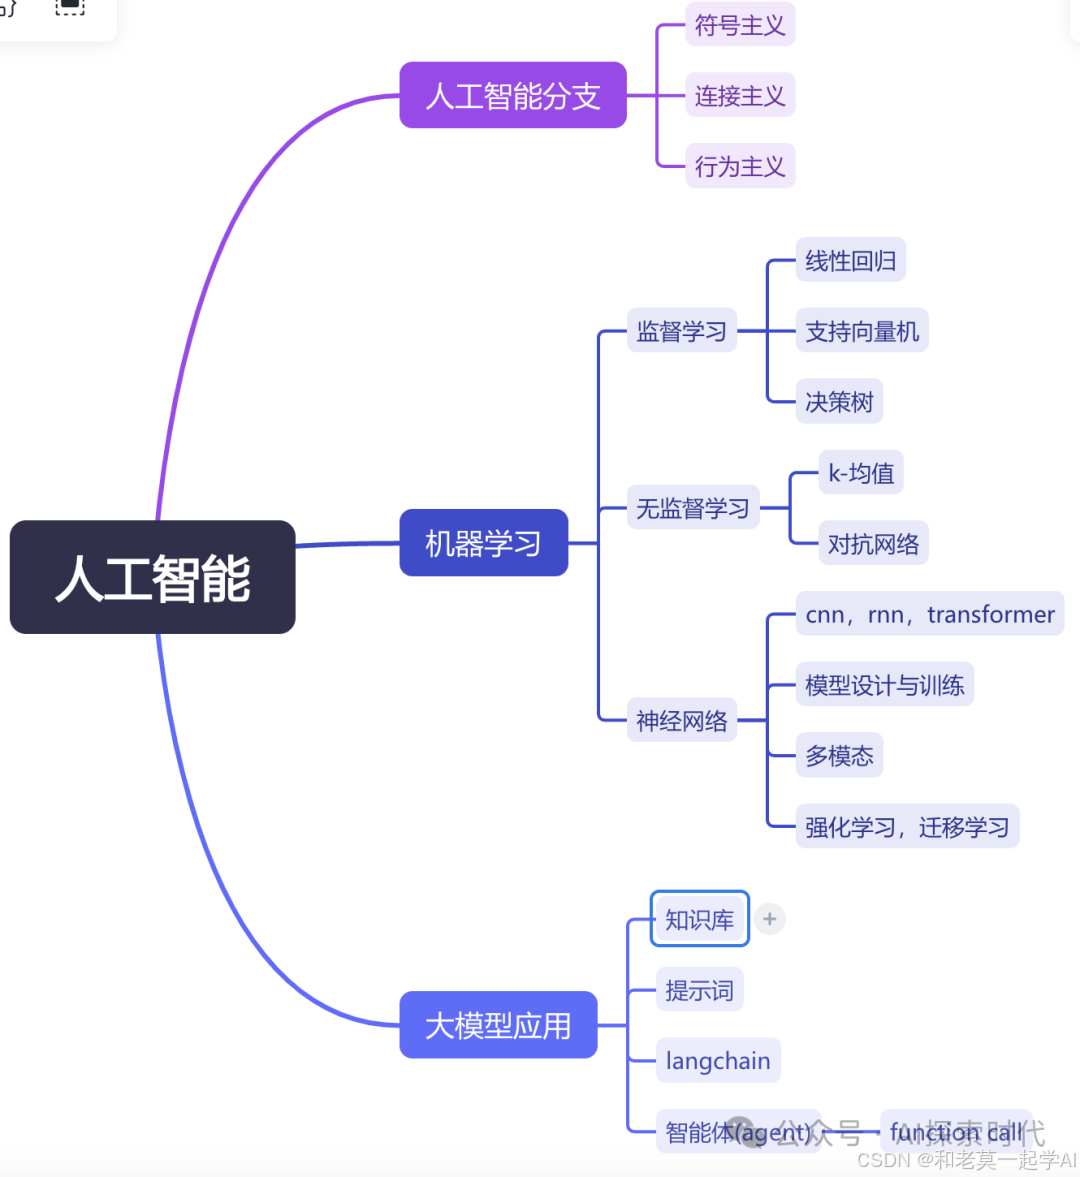
首先,大家应该明白一件事,大模型技术是人工智能技术的一个分支,是目前主流的一个研究方向,但并不是唯一的方向。‍‍‍‍‍

在这里插入图片描述

人工智能技术是一个通过某种技术手段人为的创建一个具有类人智能的系统(软件或硬件),而大模型技术是一种仿造人类学习进化的一种方式,使用深度学习(机器学习)算法模仿人类大脑神经元,来实现智能的一种方式,其主要载体是神经网络。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

神经网络之所以得到发展的原因是因为,基于神经网络架构进行预训练之后,神经网络会产生一种无法解释的涌现能力,而这个涌现能力特别像是具有了智能一样。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

神经网络模型架构‍‍‍‍‍

既然是模仿神经网络,那么就需要一种深度学习模型来模仿人类大脑神经系统,比如CNN(卷积神经网络),RNN(循环神经网络),以及目前主流的Transformer模型,还有LSTM,ResNet,GANs等。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

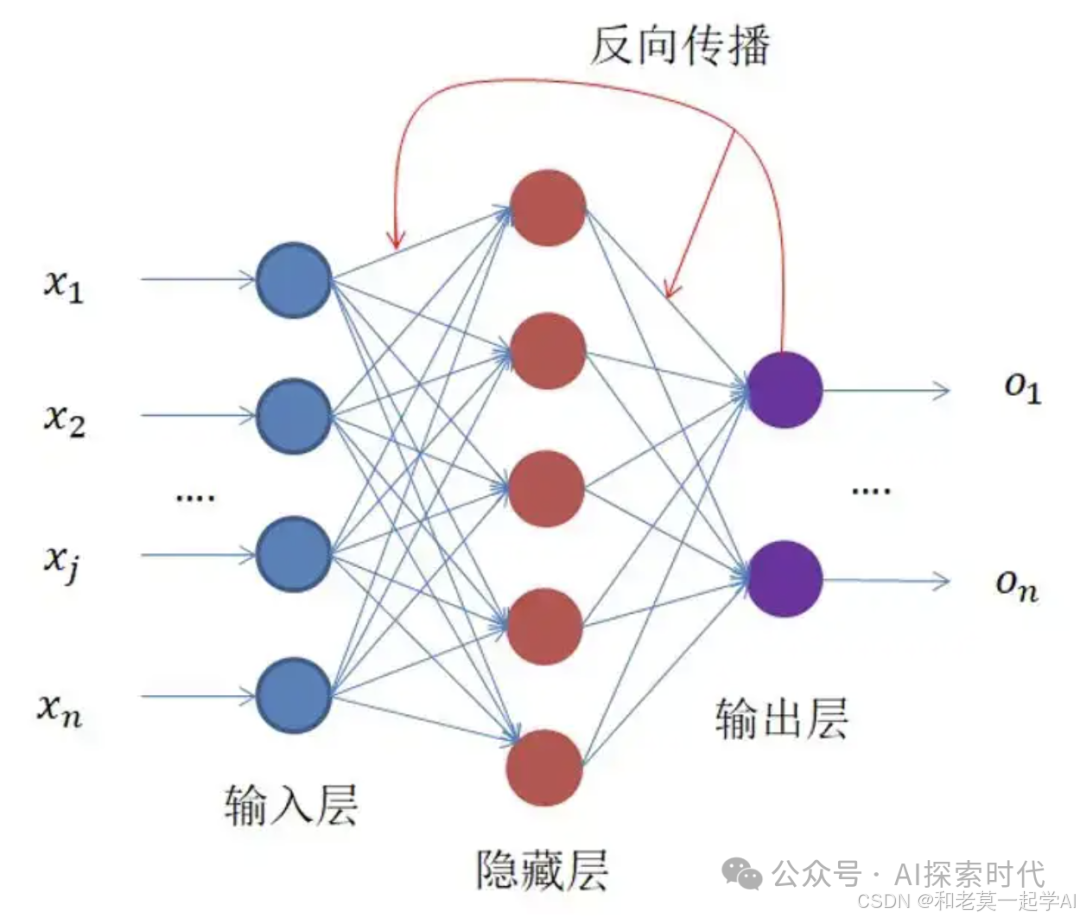
神经网络的主要结构为一个输入层,一个输出层,以及隐藏层(一个或多个层组成),不同网络层之间使用全连接的方式进行连接,每一个圆都代表着一个神经元,如下图所示:‍‍‍‍‍‍‍‍‍‍‍‍‍‍

在这里插入图片描述

在神经网络中,除了输入/输出层之外,每一个神经元都有其参数,神经网络的效果就是由这些参数值决定的。

神经网络模型通过一种叫正向传播,损失计算和反向传播的方式来调整神经网络模型中每个神经元的参数。‍‍‍‍‍‍‍‍‍‍‍‍

通过把大量的训练数据输入到神经网络中,让神经网络进行“学习”(不断的调整参数),来达到类智能的能力。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

不同神经网络的架构和实现有所不同,但其核心点都是基于此模型实现的,对想学习神经网络的朋友来说,先学会基础的神经网络架构,然后再针对不同的神经网络模型进行深化是最好的选择。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

目前的大模型主要采用的是预训练的方式来实现智能的,简单来说就是给神经网络模型一堆资料,让它自己学,自己看,自己总结;其中给答案的叫做监督学习,没答案的叫无监督学习。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

然后根据不同的任务需求,又设计出用来解决不同类型任务的神经网络,比如分类任务,图片处理任务,自然语言处理任务等。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

至于大模型技术细节方面的东西,就不详细描述了,感兴趣的可以自己学习,比如编码器,损失计算和反向传播怎么实现等。‍‍‍‍

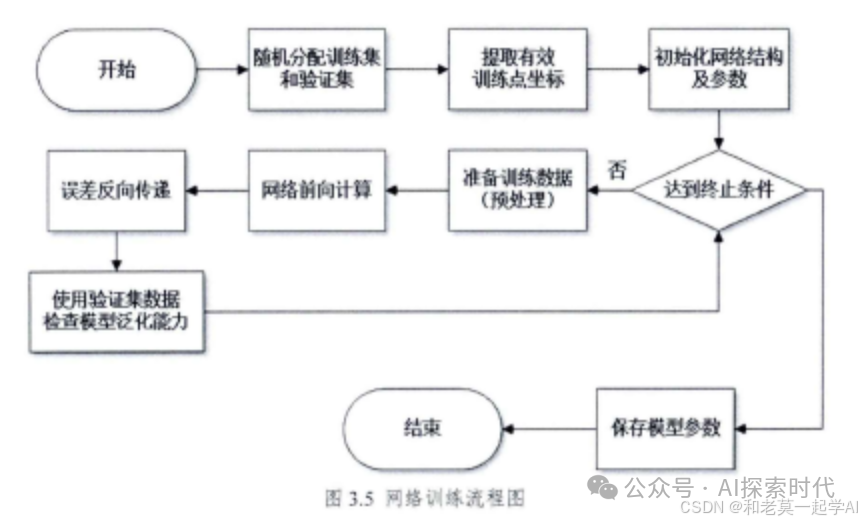
再有,设计并训练一个完整可用的神经网络模型是一个复杂的工程,比如模型的设计,训练数据的收集与处理,损失函数与反向传播算法的设计,模型过拟合,欠拟合等问题。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

在这里插入图片描述

而且随着模型规模的增大,模型的训练难度成几何式增长,比如分布式训练,并行计算等问题;以及为了提升大模型的学习效率,节约成本而设计的强化学习,迁移学习等。‍‍‍‍‍

最后,为了使得大模型更像人,也为了实现真正的AGI(通用人工智能),现在多模态大模型大行其道,而多模态大模型技术比传统大模型的技术复杂度又上升了不止一个台阶。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

基于知识库的向量检索——RAG‍‍

大模型技术虽然很强大,但其有几个明显的缺点,第一就是知识是有限制的,因为采用的是预训练方式,因此大模型的知识最多只能到训练开始的时间节点,之后产生的新的知识大模型无法获取。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

其次,由于训练大模型的成本问题,导致很多企业无法承担大模型的训练成本,因此只能使用第三方的大模型,但第三方大模型没有在特定领域的数据上进行训练或微调,因此,其表现能力一般。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

这时RAG就出现了,RAG中文是检索增强,是通过外挂知识库的方式,提问大模型之前先从向量数据库中查询数据,然后一起输入到大模型,这样大模型就相当于有了一个外部资料库,遇到不懂的问题就可以通过查资料的方式解决。‍‍‍‍‍‍‍

以目前的技术来说,RAG是大模型技术的一个重要节点,即是大模型能力范围的扩展,也是对大模型短板的补充。‍‍‍‍‍‍‍

微调与提示词工程

我们一般使用的大模型都是预训练模型,也就是用某些数据集训练过的模型;但这些模型一般情况下只会在特定领域表现出色,但如果用来解决自己的实际问题可能就不太好用了。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

这时怎么让预训练模型在其它任务中表现更好就是一个值得思考的问题,而这就是微调与提示词工程存在的意义。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

微调

微调从技术手段上来说和模型训练没有区别,只不过微调是在相似任务的预训练模型的基础之上,通过少量的数据对模型参数进行调整,使得其能够更加适应当前任务的一种方式。由于其成本低,对资金和技术要求要比完全重新设计和训练一款模型要低的多。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

因此,微调存在的意义是为了节约成本和降低门槛,如果资金充足的情况下,根据任务需求设计并训练一款模型是最好的选择,微调是退而求其次的一种方式。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

提示词工程

如果说微调是为了让大模型去适应特定的任务,那么提示词的作用就是怎么更好的使用一个大模型。‍‍‍‍‍‍‍‍‍

根据研究发现,对待同样的问题使用不同的提示词有时会得到完全不一样的效果,因此根据这一现象就提出了提示学习的方法.
用人类来举例就是,假如有人问你吃饭了吗这种简单的问题,你可以下意识的回答,而且可以回答的很好;大模型也是如此,如果你问大模型很简单的问题,它也能回答的比较好。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

但如果问到一些复杂的问题就需要更加准确的描述,比如说根据当前的就业环境,从经济,市场,贸易,国际局势等多个方面来分析一下产生当前情况的原因,以及后续的应对方法。‍‍‍‍‍‍‍‍‍‍‍‍‍

这种复杂的问题,不论是问人还是问大模型,你说的越准确,它回答的才能更好,这就是提示词存在的意义。‍

智能体Agent‍‍‍‍‍‍

在前面的描述中,神经网络架构讲的是怎么构建一个大模型,知识库是怎么补充和强化大模型,微调和提示词是怎么更好的使用大模型,那么智能体就是真正的使用大模型,研究大模型的具体应用。‍‍‍‍‍‍‍‍‍‍‍

如果把大模型比做人类的大脑,那么智能体就是大模型的手和脚。‍‍

在此之前使用大模型,我们能够让它回答问题,写文章,生成图片和视频,但这都是大模型天生具备的能力,就类似于人类可以写写画画一样。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

但如果让大模型完成更加复杂的任务,这时就需要借助外部工具,比如外出旅行需要设计旅行路线,定酒店和车票等。‍‍‍‍‍‍

这种任务就完全超出大模型或者人类本身的能力圈,如果想完成这些任务就需要借助外部工具,比如说手机APP。‍‍‍‍‍‍‍‍‍‍‍‍‍

智能体就是大模型+外部工具实现的一种能够独自分析和解决复杂任务的一种载体,利用大模型的独立规划能力,让它根据自己的判断去调用外部工具完成任务。
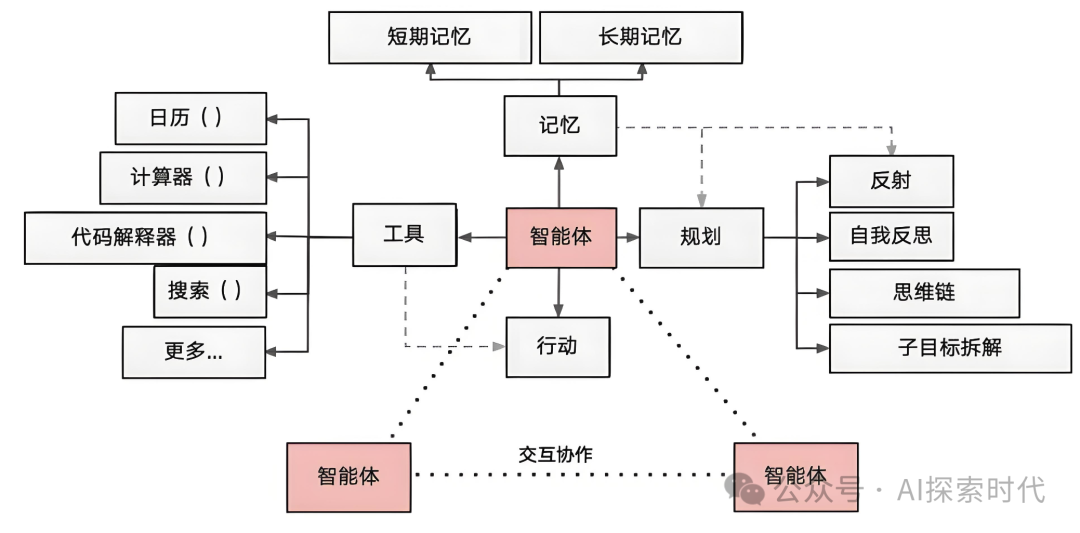
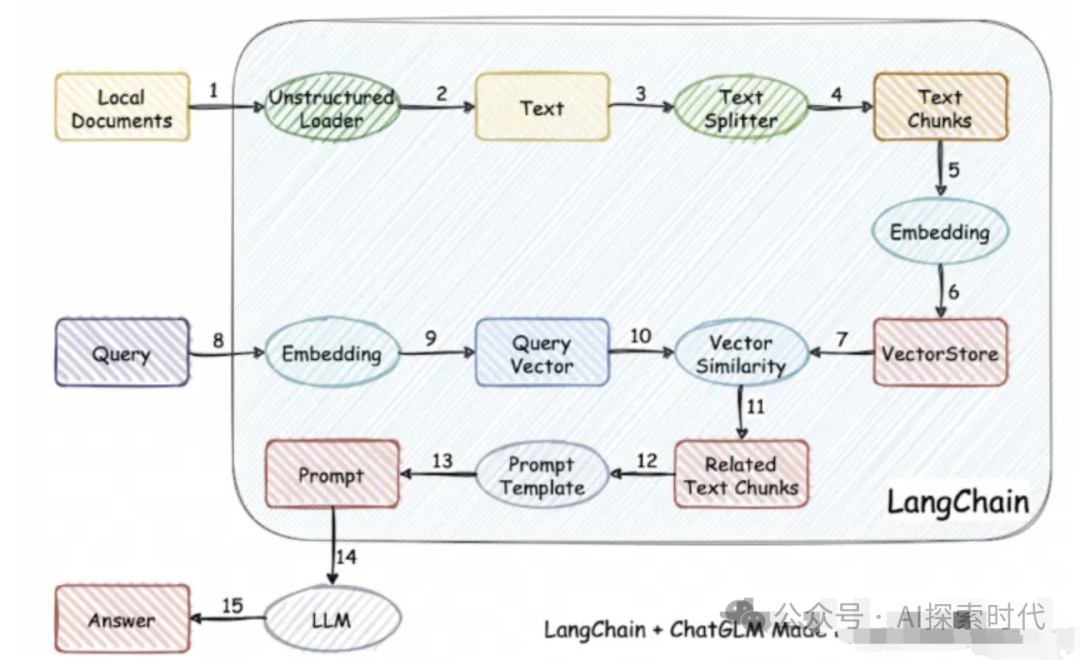
使用的技术主要有function call,langchain等;如上图所示,大模型使用function call的方式调用外部工具,使用自身能力完成规划和行动,并且由于大模型没有足够的记忆能力,需要增加记忆模块来记录对复杂任务的分析过程。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

目前,大模型解决复杂任务,主要通过思维链(CoT)的方式来实现对复杂问题的分解。‍‍‍‍‍‍‍‍‍‍‍‍‍

langchain是一种人工智能开发框架,它封装了大部分调用大模型的细节,以及其它辅助功能,比如文档的加载,多个大模型的链式调用,提示词模板的封装等,与其类似的还有LlamaIndex等。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

总结‍‍‍‍‍‍‍

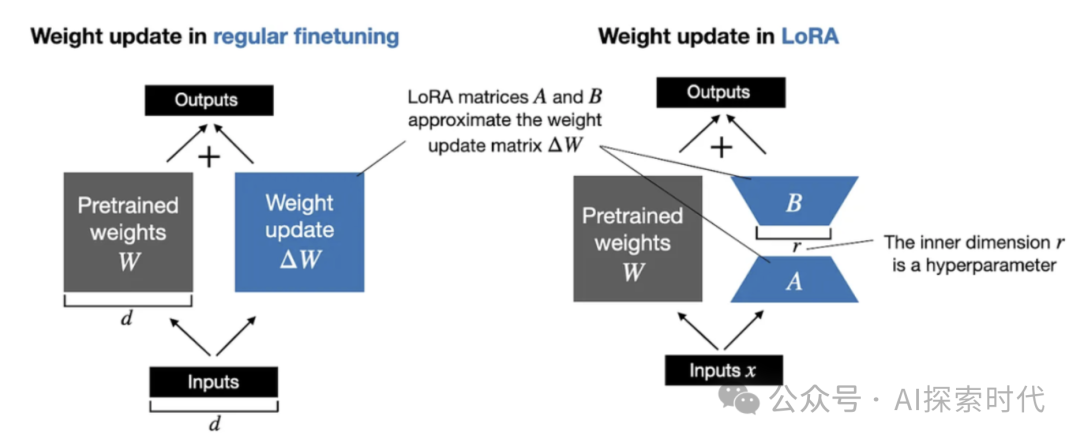
从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。‍‍‍‍‍‍‍‍‍‍‍‍

还有多模态模型中的知识对齐,数据融合等复杂技术。‍‍‍

基于大模型开发的人工智能机器人,感兴趣的可以点击查看:

因此,大模型技术到应用到学习是一个系统性的复杂过程,中间涉及到无数的技术细节和理论,并且还在不断的产生新的技术和理论。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

千里之行,始于足下。‍‍‍‍‍‍‍‍‍‍‍

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

AI幻觉缓解的成本效益分析:投入产出比优化 在当今AI技术飞速发展的时代,AI幻觉成为了一个不容忽视的问题。AI幻觉就像是AI在“做梦”,会给出一些不符合实际或者错误的答案。我们这篇文章的目的就是要分析缓解AI幻觉所需要投入的成本和能够获得的效益,看看怎么能让投入和产出的比例达到最优。范围涵盖了常见的AI应用场景,比如智能客服、自动驾驶等领域。接下来,我们会先介绍一些和AI幻觉、成本效益分析相关的术语。然后用一个有趣的故事引出核心概念,解释什么是AI幻觉、成本效益分析等,以及它们之间的关系。 阅读详情

相关推荐

Rust练手:从零手撸RISC-V架构虚拟机(一)(附完整代码)

使用Rust实现一个简单的RISC-V架构的CPU雏形,支持add,sub,addi三个指令。

qq_45983373的博客 2570

大模型开发理论与技术——大模型应用体系梳理,对大模型应用整体认识

随着对大模型技术应用的理解加深,以及和身边朋友和同事的交流,最近发现一个问题,很多人对大模型技术和应用并没有一个整体的认识;而且由于大模型属于一个新兴领域,也因此产生了很多新的概念和名词,所以这也间接导致了很多人认为大模型很难很复杂。

weixin_72959097的博客 873

ArchLinux下用Wine运行钉钉全攻略:从字体配置到中文输入法避坑

本文详细介绍了在ArchLinux系统上使用Wine运行钉钉的完整配置流程。从最新的WoW64架构环境准备、中文字体配置与DPI优化,到钉钉安装、关键系统库替换,再到解决中文输入法失效等核心难题,提供了实战避坑指南。旨在帮助Linux用户在企业办公场景下,获得接近原生的稳定使用体验。

alice7model的博客 588

大模型技术与应用体系梳理:小白入门必看,建议收藏

文章梳理了大模型技术的两大核心:大模型技术(如何构建和改进模型本身,包括数学基础、架构和训练方法)和大模型应用技术(如何有效使用模型,包括AIGC生成、RAG检索增强和Agent扩展)。建议学习者选择细分领域切入,根据能力和兴趣选择合适方向。大模型技术开发是一个复杂的领域,我们需要对其形成基础的认知体系,才能知道我们在做什么以及怎么做。随着对大模型技术应用的理解加深,以及和身边朋友和同事的交流,最近发现一个问题,很多人对大模型技术和应用并没有一个整体的认识;

m0_48891301的博客 783

UE5抗锯齿实战:如何用TAA解决闪烁问题(附参数优化指南)

本文深入探讨了UE5中TAA(时间性抗锯齿)技术如何有效解决画面闪烁问题,并提供了详细的参数优化指南。通过基础参数配置、高级优化技巧以及材质层面的策略,帮助开发者显著提升视觉质量。文章还介绍了诊断工具链,助力快速定位并解决顽固闪烁问题。

solidity8miner的博客 428

QT5.14.2离线安装包保姆级教程:断网、选组件、避坑全记录

本文详细介绍了QT5.14.2离线安装包的完整流程,特别针对Windows平台开发者提供断网安装、组件选择及避坑指南。作为QT5系列中最后一个免费离线版本,5.14.2具有免注册、全组件离线安装等独特优势,是开源开发者的理想选择。文章涵盖从环境准备到安装后配置的全方位指导,帮助开发者高效完成安装并避免常见问题。

weixin_30924087的博客 578

大模型技术学习指南:从零基础到进阶,超详细梳理,看这一篇!AI大模型2025最新学习路线!

学习是一个从围观到宏观,从宏观到微观的一个过程学习大模型技术也有几个月的时间了,之前的学习一直是东一榔头,西一棒槌,这学一点那学一点,虽然弄的乱七八糟,但对大模型技术也算有了一个初步的认识。因此,今天就来整体梳理一下大模型技术的框架,争取从大模型所涉及的理论,技术,应用等多个方面对大模型进行梳理。‍‍‍‍‍‍‍‍。

2401_84204207的博客 2318

用CentOS 7安装cadence搭建适合IC Design的科研环境(四)——IC617、MMSIM151、calibre2015安装过程step by step

以下操作都在root权限下执行。建立安装目录建议把这种大型软件装在/opt目录下。mkdir -p /opt/cadence/installscape mkdir -p /opt/mentor/Calibre2015其中-p参数是直接建立父目录。因为IC617和MMISM151会自己建立安装目录,所以在这里没有建相关目录。而calibre则是默认安装在安装包所在的目录下,所以需要提前建立。解压安

maxwell2ic的博客 7万+

【强烈收藏】大模型技术体系详解:从基础到应用的全面梳理

本文系统梳理了大模型技术的完整框架,从神经网络基础到智能体应用。文章介绍了大模型作为人工智能分支的核心原理,包括预训练、微调、提示词工程等技术,以及RAG检索增强和Agent智能体等应用方向。作者强调学习大模型是一个从围观到宏观再到微观的系统过程,需要掌握理论知识、技术细节和实践应用,并指出大模型技术仍在不断发展中。

2401_85373691的博客 1063

HyperLynx(三十一)高速串行总线仿真(三)

(5)选择 “File”→ “Open Touchstone”,打开路径 C:\Adv_HL_Tmg\SERDES_Interface\models,选中connector.s4p,单击打开,如图所示。接下来,找出将要分配模型的S参数连接。(12)单击“Assign”按钮,选择模型类型为“Touchstone models”,在库中选择“connector.s4p”,如图所示。(14)单击“OK”按钮,选中“connector.s4p”这一行,单击“Connection Editor”按钮,如图所示。

小幽余生不加糖 3367

Python 爬虫实战:社交媒体(Facebook)评论数据抓取与情感分析

在当今数字化时代,社交媒体平台如 Facebook 已成为人们日常生活中不可或缺的一部分。它不仅是人们分享生活点滴、交流思想的场所,也为企业和研究人员提供了丰富的数据资源。通过分析社交媒体上的评论数据,我们可以了解用户的情感倾向、产品反馈以及社会热点话题等。本文将详细介绍如何使用 Python 爬虫技术抓取 Facebook 上的评论数据,并进行情感分析。这不仅是一次技术实战,更是一次数据探索之旅。

yansideyucsdn的博客 672

AI大模型开发理论与技术——大模型应用体系梳理,对大模型应用整体认识

“ 大模型技术开发是一个复杂的领域,我们需要对其形成基础的认知体系,才能知道我们在做什么以及怎么做。” 随着对大模型技术应用的理解加深,以及和身边朋友和同事的交流,最近发现一个问题,很多人对大模型技术和应用并没有一个整体的认识;而且由于大模型属于一个新兴领域,也因此产生了很多新的概念和名词,所以这也间接导致了很多人认为大模型很难很复杂。

2401_85327249的博客 974

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

大模型入门必看,我的大模型学习路线完整版,AI大模型核心技术全解析:从基础到应用的系统性学习指南

本文系统介绍AI大模型的五个核心层次(基础层、智能体层、增强层、安全协议层及多模态),涵盖18个关键概念。基础层包括大语言模型、Transformer架构、向量表示等技术;智能体层涉及自主决策系统、记忆机制和任务编排;增强层和安全层则聚焦模型优化与风险防控。每个概念详细解释定义、技术原理、应用场景及未来趋势,并通过实际案例展示应用价值。文章为初学者提供从基础到应用的系统性学习指南,包含技术演进路线和实用资源,是掌握大模型技术的全面参考。

2401_85390073的博客 1309

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

零基础学大模型——大模型技术学习过程梳理

从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。还有多模态模型中的知识对齐,数据融合等复杂技术。基于大模型开发的人工智能机器人,感兴趣的可以点击查看:

python1222_的博客 1295

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

你了解大模型的生态体系吗?大模型从技术到应用的内容梳理

神经网络技术从理论到应用是一个庞大的体系,我们需要知道的是这个体系是怎么构成的,每一层都有哪些内容关于大模型我想很多人都会有这样或那样的问题,最基础的就是不知道大模型是什么,技术场景和业务场景分不清楚;也不知道大模型有哪些能力,然后利用大模型能做些什么。因此,今天我们就来梳理一下大模型体系,从技术到应用之间的关系,以及各个环节所涉及到的技术。大模型体系——从技术到应用大家之所以搞不明白大模型,最根本的原因就是对大模型没有一个完整的认知;所以我们今天从多个维度来了解一下大模型的构成和应用。

2401_84495872的博客 924

大模型应用和体系梳理,大模型开发理论与技术,对大模型应用整体认识

随着对大模型技术应用的理解加深,以及和身边朋友和同事的交流,最近发现一个问题,很多人对大模型技术和应用并没有一个整体的认识;而且由于大模型属于一个新兴领域,也因此产生了很多新的概念和名词,所以这也间接导致了很多人认为大模型很难很复杂。

m0_74942241的博客 794

LLM技术全景图:技术人必备的技术指南,一张图带你掌握从基础设施到AI应用的全面梳理

LLM 技术图谱(LLM Tech Map)是将 LLM 相关技术进行系统化和图形化的呈现,此图谱主要特点是“”,不求从 LLM 产业角度汇聚信息,而是希望让从事相关工作或是想了解 LLM 的技术人有一个快速感知。LLM 技术图谱(LLM Tech Map)从基础设施、大模型、Agent、AI 编程、工具和平台,以及算力几个方面,为开发者整理了当前 LLM 中最为热门和硬核的技术领域以及相关的软件产品和开源项目。

m0_59235699的博客 1049

大模型技术学习过程梳理

‍‍‍‍‍‍‍从大的方向上来说,大模型从技术到应用,主要涉及到以上几个大的模块;而每个模块又涉及到大量的技术和细节。比如打造不同任务的神经网络模型,强化学习,迁移学习,知识蒸馏,分布式训练与存储等;以及RAG使用的向量检索,向量数据库,语义理解等,还有复杂任务的思维链(CoT),模型训练使用的LoRa等微调方法。还有多模态模型中的知识对齐,数据融合等复杂技术。‍‍‍基于大模型开发的人工智能机器人,感兴趣的可以点击查看:

weixin_58753619的博客 1197
上一篇: 【必藏】AI Agent与大模型实战指南:从理论到开发全流程(附全套学习资料)
下一篇: 【必收藏】大模型微调全攻略:从RAG对比到实战资源,一文掌握大模型定制化核心技术
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值