建议收藏!一文彻底搞懂 Positional Encoding:Transformer 中的位置编码原理全解析

LangChain入门指南 LangChain是一个强大的框架,旨在帮助开发人员使用语言模型构建端到端的应用程序。它提供了一套工具、组件和接口,可简化创建由大型语言模型 (LLM) 和聊天模型提供支持的应用程序的过程。LangChain 可以轻松管理与语言模型的交互,将多个组件链接在一起,并集成额外的资源,例如 API 和数据库。官方文档:https://python.langchain.com/en/latest/ 阅读详情

Transformer 架构因其强大的并行能力与建模效果,在自然语言处理和图像理解等领域大放异彩。它的一大特点就是摒弃了传统的 RNN/CNN 顺序结构,转而完全依赖注意力机制。然而,这也带来了一个问题:

没有序列顺序,模型如何知道一个词在句子中的“位置”?

为了解决这个问题,原始 Transformer 在输入 Embedding 中加入了“位置编码(Positional Encoding)”,并采用了一种非常独特的方式 —— 正弦和余弦函数构造的位置向量。

这篇文章将带你从原理、公式、可视化和优势等多个角度,彻底理解这项设计。

希望大家带着下面的问题来学习,我会在文末给出答案。

  • 为什么原始 Transformer 要使用正弦和余弦函数来构造位置编码,而不是简单地使用位置索引?
  • 位置编码是“绝对的”,那模型怎么知道两个词之间的相对距离?是否会限制模型的泛化能力?
  • 位置编码向量是固定的数学函数,那模型真的能从中“学会”位置信息吗?它是否会过于僵化?

1. 为什么需要 Positional Encoding?

Transformer 是一个完全并行计算的模型。不像 RNN/CNN 那样通过结构隐含顺序,它处理输入序列是无顺序感知的。

为了解决这个问题,Transformer 在每个词的表示上添加了一个与它在句中位置有关的向量,也就是 Positional Encoding。

2. 原始公式长啥样?

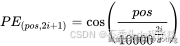
在原始论文《Attention is All You Need》中,位置编码被定义为如下公式:
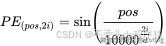
在这里插入图片描述

在这里插入图片描述

  • pos:表示该词在句子中的位置(从 0 开始)
  • i:表示当前维度的位置
  • d:表示词向量维度

也就是说,对于输入的每个 token(例如第 5 个词),我们遍历维度,对每一个维度使用公式计算出其数值,为其生成一个长度为 d_model 的向量,交替使用 sin 和 cos 来填充奇偶维度。


3.为什么要用正弦函数?

这种设计有多个深意:

3.1多尺度建模能力

通过 10000^{2i/d} 这样的频率控制,sin/cos 的周期从大到小,可以编码不同粒度的顺序信息。低维捕捉长距离位置变化,高维捕捉局部变化。

3.2平滑变化

随着位置 pos 变化,编码向量是连续的,符合自然语言中位置是连续变量的特点。

3.3支持序列泛化

因为是数学函数,位置可以扩展到比训练时更长的序列,而不会像可学习位置编码那样固定在训练长度上。

3.4简单高效

不需要额外学习参数,占用显存小,适合参数紧凑的场景。


4.可视化:位置编码长啥样?

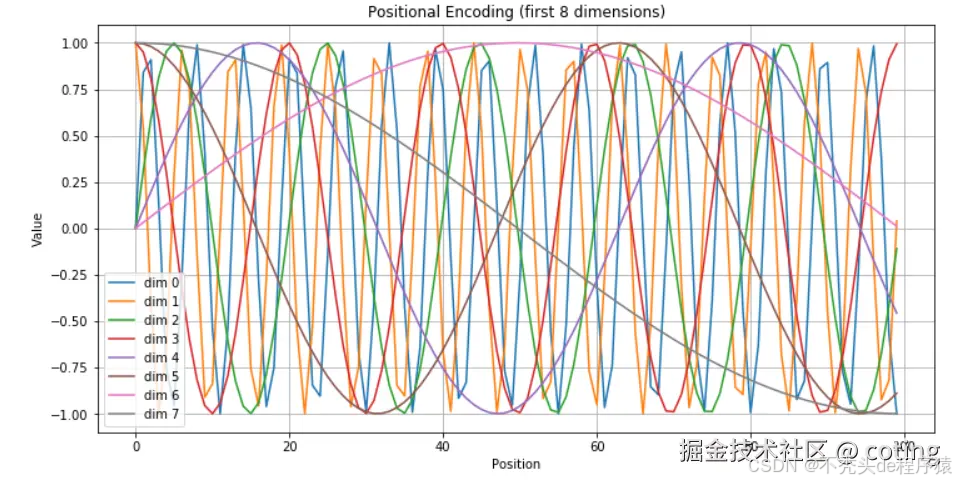
我们可以绘制前 100 个位置编码在不同维度上的曲线图:

python 体验AI代码助手 代码解读复制代码import numpy as np
import matplotlib.pyplot as plt

def get_positional_encoding(seq_len, d_model):
    pos = np.arange(seq_len)[:, np.newaxis]
    i = np.arange(d_model)[np.newaxis, :]
    angle_rates = 1 / np.power(10000, (2 * (i // 2)) / np.float32(d_model))
    angle_rads = pos * angle_rates

    # apply sin to even indices, cos to odd indices
    pos_encoding = np.zeros_like(angle_rads)
    pos_encoding[:, 0::2] = np.sin(angle_rads[:, 0::2])
    pos_encoding[:, 1::2] = np.cos(angle_rads[:, 1::2])
    return pos_encoding

# visualize
pe = get_positional_encoding(100, 16)
plt.figure(figsize=(12, 6))
plt.plot(pe[:, :8])
plt.legend([f"dim {i}" for i in range(8)])
plt.title("Positional Encoding (first 8 dimensions)")
plt.xlabel("Position")
plt.ylabel("Value")
plt.grid(True)
plt.show()

可以得到如下图中一些类似于正弦波的图像,这些波动就是位置信息。
在这里插入图片描述


5.Positional Encoding 是怎么用的?

Transformer 中,每个词的最终输入是:
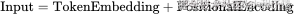
在这里插入图片描述

两者直接相加,给词向量注入位置感知能力。


6.有什么缺点?

虽然原始的 PE 简洁有效,但也有一些限制:

缺点说明
固定函数,缺乏灵活性无法根据具体任务进行优化
是绝对位置不考虑 token 之间的相对距离
表达能力弱于学习式编码在复杂任务上可能不够强

7.后续改进方案有哪些?

方法特点应用模型
Learned PE可学习,更灵活BERT、GPT-2
Relative PE编码 token 间的相对位置Transformer-XL, T5
RoPE使用旋转矩阵建模相对位置LLaMA, Grok, GLM
ALiBi添加 attention bias 表示距离BLOOM, Falcon

8.总结

原始 Transformer 的 Positional Encoding 是一种简单而有效的机制,它:

  • 使用 sin/cos 编码不同频率的周期信号
  • 为每个词添加绝对位置感知能力
  • 能够支持长序列泛化、计算高效

虽然现代 Transformer 更偏向使用 RoPE 或相对位置编码,但理解原始 Positional Encoding 是学习 Transformer 的基础之一,也是很多架构演进的出发点。

最后,我们回答一下文章开头提出的问题。

  • 为什么用正弦/余弦函数?
    因为它们可以以多尺度周期性编码不同的距离变化,且是连续函数,可以外推到未见过的位置,具有良好的泛化能力。简单位置索引无法提供这种连续性和周期层次结构。
  • 绝对位置是否限制了模型?
    是的,原始位置编码只表达绝对顺序,不直接提供相对距离信息。这也是后续相对位置编码(如 Transformer-XL、T5)和 RoPE 等改进方案出现的原因。
  • 固定函数是否太僵化?
    虽然不可学习,但 Transformer 会通过训练过程自动学会如何“解读”这些编码。这种固定性使模型对长序列有更好的拓展能力。但在某些任务中,确实比可学习位置编码表现略弱。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型之LangChain介绍 LangChain 就是一个 LLM 编程框架,你想开发一个基于 LLM 应用,需要什么组件它都有,直接使用就行;甚至针对常规的应用流程,它利用链(LangChain中Chain的由来)这个概念已经内置标准化方案了。下面我们从新兴的大语言模型(LLM)技术栈的角度来看看为何它的理念这么受欢迎。其官方的定义。 阅读详情

相关推荐

一文搞懂位置编码Positional Encoding

Transformer 架构因其强大的并行能力与建模效果,在自然语言处理和图像理解等领域大放异彩。它的一大特点就是摒弃了传统的 RNN/CNN 顺序结构,转而完全依赖注意力机制。然而,这也带来了一个问题:没有序列顺序,模型如何知道一个词在句子中的“位置”?为了解决这个问题,原始 Transformer 在输入 Embedding 中加入了“位置编码(Positional Encoding)”,并采用了一种非常独特的方式 —— 正弦和余弦函数构造的位置向量。

和大家一起涨芝士 1213

什么是LangChain?从零开始入门 LangChain

LangChain 作为一个新兴的开源 LLM 开发框架,它的设计理念和一些实现方法都有值得我们借鉴的地方。当然一个开源项目必然有自己的优点的同时也会存在不少的缺点。我们在实际使用的时候,应该按照自己的需求和实际情况去选择,切记,不要简单的因为网上的评论而做出选择。毕竟,好不好用,只有你自己才清楚。

2401_85375151的博客 3万+

DETR模型全解析:基于Transformer的端到端目标检测实战指南

目标检测是计算机视觉的核心任务之一,旨在识别和定位图像中的物体。传统方法通常依赖锚框和非极大值抑制等手工设计组件,流程复杂且难以优化。Transformer架构凭借其强大的全局关系建模能力,为视觉任务提供了新的解决方案。DETR首次将Transformer成功应用于目标检测,通过编码器-解码器结构和集合预测,实现了真正的端到端检测,摒弃了复杂的后处理步骤。这一创新不仅简化了模型架构,还统一了训练流程,在COCO等基准数据集上展现了与成熟方法相媲美的性能。对于希望深入理解Transformer在CV中应用,或

weixin_33928137的博客 514

从零开始入门 LangChain

本篇文章中将和大家讲述什么是 LangChain ,以及 LangChain 解决了现在大模型发展的哪些问题,然后会讲解LangChain 中基础的概念和组件。

2301_81940605的博客 1万+

一文彻底搞懂什么是LangChain?

LangChain赋予了开发人员将LLM与其他计算和知识来源相结合以构建应用程序的能力。使用LangChain,开发人员可以使用一个抽象LLM应用程序的核心构建块的框架。探索LangChain的能力并尝试其各个组件,会发现可能性几乎无限。LangChain框架提供了一种灵活和模块化的语言生成方法,允许创建根据用户特定需要量身定制的定制解决方案。

女王の专属领地 2万+

OLED的字模提取(保姆级)---基于PCtoLCD2013

做为一个刚刚开始接触编程不久的白菜,这个OLED想做一个信息显示,可是商家给我的例程里就是88,816两种字体的格式,我的屏幕是0.91寸的8*16的字体显示上感觉特别丢丢儿小,我就想整个大的,哎,只怪直接学习习惯不好,总是学一半,绕了好大一圈,才搞好,想写一篇博客,时刻提醒踏实学习,第一次写博客,小白一枚,勿喷。。 OLED屏幕驱动程序功能 我们对Markdown编辑器进行了一些功能拓展与语法支...

qq_44886611的博客 7782

如何理解Transformer论文中的positional encoding,和三角函数有什么关系?

如何理解Transformer论文中的positional encoding,和三角函数有什么关系?

独立开发,substack顶级编辑 1176

endnote让参考文献整整齐齐

这篇文章主要是针对利用 endnote 插入参考文献时,参考文献第一行和后面的行对不齐的问题 下面是示意图 可以看到我们的参考文献对的整整齐齐的,比较好看。 下面介绍具体步骤 1、打开endnote。编辑我们使用的参考文献样式。我这儿是叫 ZZ_MODIFIED_GEEBINF 复制 2、找到布局,每个参考开头,将光标放在在参考开头后面,点插入字段,制表符 3、右下角悬挂式输出哪儿选择全部段...

雾隐雾现的至渝博客 5万+

【值得收藏】用生活化比喻彻底搞懂Transformer:AI大模型的基石,小白到程序员必学

Transformer是现代AI的核心架构,通过自注意力机制让每个词理解全局上下文。它将文本分解为Token,使用Q、K、V向量计算词语关系,通过多头注意力从多角度理解文本。位置编码保留词序信息,Encoder-Decoder结构使模型能理解输入并生成输出。Transformer支持并行计算,捕捉长距离依赖,已成为大语言模型的基础架构。

2401_85375186的博客 1131

U8+ 新建账套

一、登录 账套主管:demo 对账套有修改权限,有账套库权限 系统管理员:admin 其他所有权限 二、新建账套 admin登录–>点击系统管理–>账套–>建立 选择了参照已有账套结转期初:就是上一个的期末数据作为这一次新表的期初数据 启用会计期一旦选择更改不了。 ...

茶茶很困i 3695

实战演练:基于Veristand Custom Device的硬件在环(HIL)数据流控制模块开发

本文详细介绍了基于Veristand Custom Device的硬件在环(HIL)数据流控制模块开发实战。通过LabVIEW环境配置、动态路由逻辑构建、实时处理核心开发及性能优化等关键步骤,帮助工程师快速掌握定制化HIL测试系统的开发技巧,提升测试效率与准确性。

weixin_29206669的博客 475

【大模型入门必备】大模型理解语言的奥秘:词嵌入与位置编码详解(建议收藏)

文章揭示了大模型理解人类语言的两大核心技术:词嵌入(Embeddings)和位置编码(Positional Encoding)。词嵌入将词语转换为数学表示,使语义相近的词在向量空间中距离更近;位置编码解决了Transformer架构无法理解词语顺序的问题。两者协作使模型既能理解词义又能把握语序,真正"理解"语言,而非简单统计词频。这种将语言数学化的方法是大模型出现的关键。

m0_59162248的博客 889

“华为杯”研究生数学建模竞赛2016年-【华为杯】A题:多无人机协同任务规划

题分别求解,保证了攻击方无人机滞留在防御方雷达有效探测范围内的时间总和最小,接着,通过提出巡检待命无人机的设想,型无人机携带炸弹的具体清单和攻击的目标清单),保证攻击方的无人机滞留防御方雷。在使用基于贪心算法的覆盖法时,覆盖的目标点中必须首先不含配备雷达站的目标点。步优化保证攻击方的无人机滞留防御方雷达有效探测范围内的时间总和最小,需首先。的“灵巧”炸弹,采用抛投方式对地攻击,即投放后炸弹以飞机投弹时的速度作抛物。运动,当炸弹接近目标后,可主动寻的攻击待打击的目标,因此炸弹落点位于目标中。

getusushu的博客 1038

【AI大模型】Transformer为什么一定要添加一个Positional Encoding模块?

之前老喜欢死记硬背transformer的网络架构,虽然内容并不复杂,但是发现这个transformer模块中的positional encoding在死记硬背的情况之下很容易被忽略。为了更好地理解为什么transformer一定需要有一个positional encoding,简单推了一下公式

bugyinyin的博客 933

ANSYS软件二次开发(2):二次开发环境搭建与配置

ADK是ANSYS提供的一个开发工具包,它包含了用于二次开发的API、示例代码和开发指南。ADK支持Python和Tcl,但Python因其易用性和强大的社区支持,成为首选。在ANSYS软件中,自定义菜单与工具栏是实现二次开发的重要途径之一,它允许用户根据自己的需求和工作流程,创建个性化的操作界面。通过自定义菜单与工具栏,可以将常用的功能、自定义的脚本或宏命令整合到一起,提高工作效率。原因:材料参数输入错误,或者模型的物理假设与实际情况不符。解决方案仔细校验材料参数,确保与实验数据一致。

kkchenjj的博客 2206

HDMI接口及其在编程中的应用

在编程中,我们可以使用HDMI接口来控制和管理连接到计算机的HDMI设备。本文将介绍HDMI接口的基本原理以及如何在编程中使用HDMI接口。在编程中,我们可以使用HDMI接口来控制和管理连接到计算机的HDMI设备。本文介绍了HDMI接口的基本原理,并提供了使用Python编程语言和相关库实现HDMI接口应用的示例代码。我们可以使用编程语言提供的音频库来生成和播放音频,并将其通过HDMI接口输出到连接的设备上。我们可以使用编程语言提供的音频库来生成和播放音频,并将其通过HDMI接口输出到连接的设备上。

CodeByte的博客 804

从入门到精通:Transformer大模型原理深度解析(收藏版)

在注意力机制的上下文中,K“键”、Q“查询”和V“值”这些术语是从信息检索和数据库领域借鉴来的,在这些领域中,类似的概念被用于存储、搜索和检索信息。关系型数据库的查询,我们有查询条件、查询索引、数据记录本身,我们通过查询条件(查询索引)去匹配数据记录(值),从而拿到我们想要的数据记录。而且为了查询效率,我们通常会使用B+树索引,而不是全表扫描。与之类比的,自注意力机制也是通过查询、键和值来计算注意力权重,从而计算出上下文向量,且缓存了计算结果(K和V),在自回归模型中,可以避免重复计算,提高效率。

EnjoyEDU的博客 385

OpenClaw实战:拒绝复制粘贴,用 xlsx 技能打通“带公式模板”的月报自动化

本文详解了如何利用 OpenClaw 框架搭载的 xlsx skill,解决 AI 自动化处理“带复杂公式与格式”Excel 月报时极易翻车的业务痛点。针对传统大模型粗暴写入导致模板报废的问题,OpenClaw 创新采用“双核微创”工作流:首先利用 pandas 高效清洗并聚合海量原始明细数据,随后切换至 openpyxl 将计算结果精准注入目标模板,完美保留原有的底色、边框与跨表动态公式。

我有一个梦想 153

Transformer教程“从娶到删”:核心原理与PyTorch实战

Transformer作为深度学习的重要架构,以自注意力机制为核心,通过Query、Key、Value的交互捕捉序列全局依赖,在并行计算和长距离建模上优势明显。从NLP到CV,BERT、GPT、ViT等模型广泛应用,使得理解Multi-Head Attention和位置编码成为工程实践基础。面对海量学习资料,如何选择适合自己的教程成为困扰开发者的难题。本文以“从娶到删”的视角,盘点主流Transformer学习资料,手写PyTorch注意力模块,并通过HuggingFace完成情感分析,帮助读者建立从原理到

weixin_30607029的博客 429

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

收藏级干货!Transformer 架构分步计算流程(小白 & 程序员必看)

Transformer的计算流程可概括为"输入处理→Encoder特征提取→Decoder序列生成→输出处理"四大环节,核心依赖位置编码、多头自注意力、交叉注意力、残差连接+层归一化四大关键技术。正是这些设计的组合,让Transformer实现了并行计算、长距离依赖捕捉、深层堆叠三大优势,成为现代大模型的基础架构。无论是NLP领域的文本理解、生成、翻译,还是CV领域的图像分类、目标检测,Transformer都已成为核心模型框架。

m0_48891301的博客 932

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Balena Etcher 镜像烧录完全指南:三步搞定 SD 卡烧录与 U 盘启动盘制作

这篇文章带你完整掌握 Balena Etcher 这个跨平台镜像烧录工具:选对安装方式、三步完成第一次烧录 SD 卡,并学会制作 U 盘启动盘时常见问题的排查方法。 [![Balena Etcher 镜像烧录工具界面:把镜像写入 SD 卡或 USB 驱动器](https://raw.gitcode.com/GitHub_Trending/et/etcher/raw/1e2500e4f11cf98

gitblog_00238的博客 195

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

强烈推荐收藏!2026年Transformer完全解读:起源、原理、变体、应用一次讲透——从Attention Is All You Need到GPT-5,AI时代最该读懂的一篇论文

保留完整架构。代表:T5、BART。用途:机器翻译、文本摘要。2017: Attention Is All You Need → 革命开始2018: BERT → 横扫 NLP,Google 搜索用上了2020: GPT-3 → Scaling Law:只管堆大2022: ChatGPT → Transformer 走进大众2023-24: GPT-4, Claude 3, Gemini → 多模态2025-26: GPT-5, DeepSeek V3, MoE → 推理能力爆发。

在渔村里看AI,偶尔捕点新鲜的。 959

小白也能懂!收藏这份Transformer大模型深度解析,开启智能驾驶新认知!

Attention 机制就是为了同时拿到全局信息和计算速度,而 Transformer 就是用 Attention 搭起来的一套 “理解 + 生成” 的完整框架,现在的大模型都是在这个基础上发展来的。注意力层负责找关联、挑重点,理清各个信息之间的关系,而前馈网络就是独立处理每一个信息,把特征变得更丰富、区分度更高,相当于给内容做细化加工。六、线性层(Linear)咱们现在再说说 Transformer 里最右上角那个Linear 层的作用:它是干嘛的?

m0_48891301的博客 325

大模型原理深度解析:小白程序员轻松入门收藏版

在注意力机制的上下文中,K“键”、Q“查询”和V“值”这些术语是从信息检索和数据库领域借鉴来的,在这些领域中,类似的概念被用于存储、搜索和检索信息。关系型数据库的查询,我们有查询条件、查询索引、数据记录本身,我们通过查询条件(查询索引)去匹配数据记录(值),从而拿到我们想要的数据记录。而且为了查询效率,我们通常会使用B+树索引,而不是全表扫描。与之类比的,自注意力机制也是通过查询、键和值来计算注意力权重,从而计算出上下文向量,且缓存了计算结果(K和V),在自回归模型中,可以避免重复计算,提高效率。

2601_95385583的博客 440

从RNN到Transformer:吴恩达教程与PyTorch实战,彻底搞懂注意力机制与序列建模

在序列建模领域,循环神经网络(RNN)及其变体长期面临并行化困难与长程依赖衰减两大核心挑战。注意力机制(Attention Mechanism)作为一种革命性的解决方案,通过计算序列元素间的全局关联,实现了高效的并行计算与任意距离依赖的捕获。其技术价值在于为大规模语言模型奠定了高效的架构基础,广泛应用于机器翻译、文本生成等自然语言处理任务。Transformer模型将自注意力(Self-Attention)与多头注意力(Multi-Head Attention)、位置编码、残差连接等组件系统集成,构成了支撑

chuiqi9947的博客 374

第03篇-大模型技术全景-从Transformer到大语言模型

本系列是一套面向全栈架构师的 AIaaS 系统化教程,覆盖从概念全景、模型训练/微调底层原理、推理部署优化、Go 平台工程、GPU 集群编排到平台核心服务与运维前沿的完整知识体系。技术栈以 Go 为主,Python/C++ 为辅。

m0_68987304的博客 524
上一篇: LangChain vs LangGraph:对话记忆实现有何不同?
下一篇: 建议收藏!大模型面试必考题:微调+蒸馏核心技术全解析(含高频考点+面试真题)
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1478原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值