如何使用StableDiffusion对图片进行高清、优化、放大

【AI绘画-stableDiffusion】图片放大;高清修复;重绘幅度调参讲解;SD upscale 放大脚本 区块重绘,再拼接(优点:效果更好。1.可以在 图库浏览器 中打开我们生成过的图片(也可以直接图生图,但那就会丢失关键词了)3.等比缩放比例调节为 2~3 之间(或其他,自行尝试,这只是一个推荐值)4.选择神经网络,推荐使用 BSRGAN,或者 SwinIR_4x。,但如果你需要让画面更明亮一些,而非真实一些,那就使用后者。用于没有现有图片的时候,我们想要直接生成高分辨率版本的时候。设置 -> 放大 -> 图生图的放大算法(1.在“图生图”中选择脚本“使用SD”放大。2.SD upscale(SD放大) 阅读详情

今天这篇文章,主要想分享下如何优化图片,核心目的就是让图片变得更好看。

StableDiffusion默认生成的图片分辨率为512*512,“只可远观,不可近赏”来形容怕是再合适不过了。好不容易抽到了一张自己心仪的图,但苦于颜色暗淡,分辨率低下,有什么办法能在原画的基础上,让它的细节更丰富吗?答案是肯定且简单的。
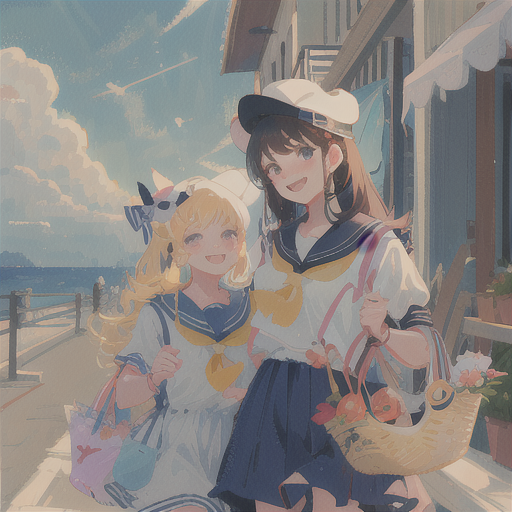
原始图

一、高分辨率修复(Hires.fix)
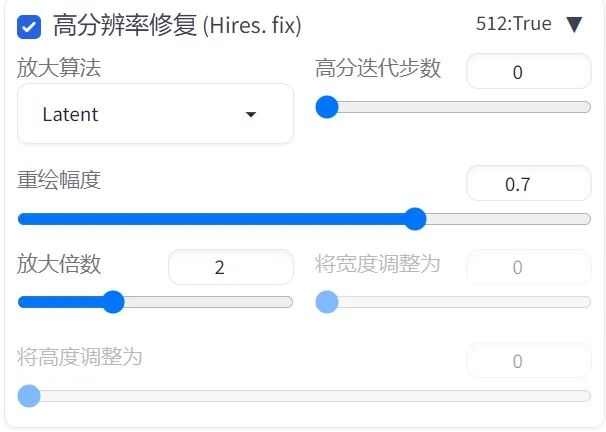
使用方法:

1、勾选高分辨率修复,输入放大倍数;

2、调整数据(高分迭代步数、重绘幅度)

2.1高分迭代步数:是StableDiffusion等图像生成模型中的一个关键参数,控制生成过程中的迭代次数。更多的迭代步数通常会带来更高的图像质量和细节,但同时也会增加生成时间。一般来说,较少的迭代步数(如50到100)生成速度快但图像细节可能不足;较多的迭代步数(如150到300或更多)生成速度慢但图像细节更丰富。
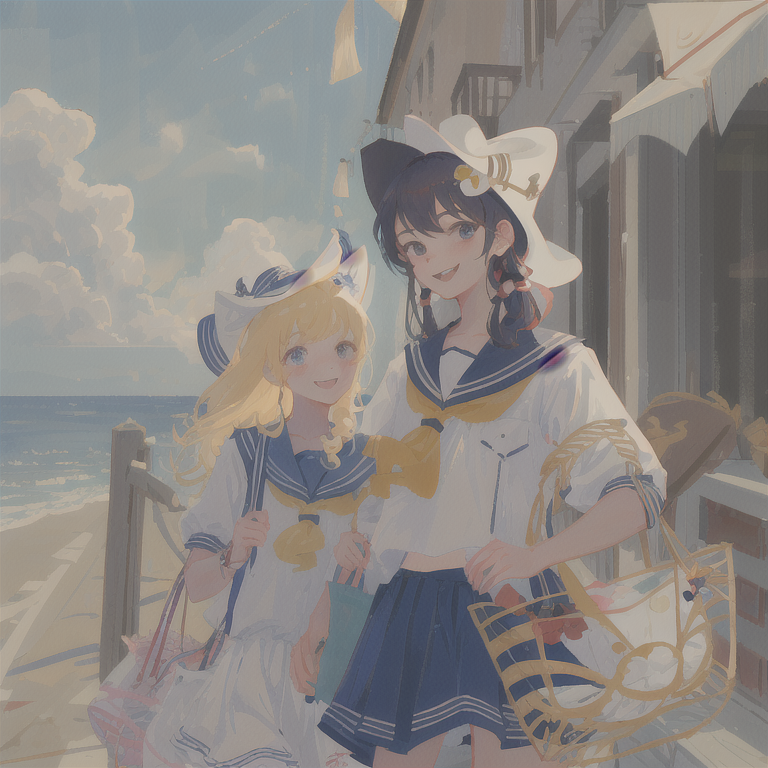
(上图设置为150,出图生成时间明显变长)

2.2 重绘幅度:用于控制图像重绘的程度。它决定了在从噪声图像生成最终图像时,模型对输入提示词的依赖程度。重绘幅度的值通常在0到1之间:

0:表示没有重绘,即保持原始图像不变。

1:表示完全重绘,即生成的图像完全依赖于提示词,不参考原始图像。
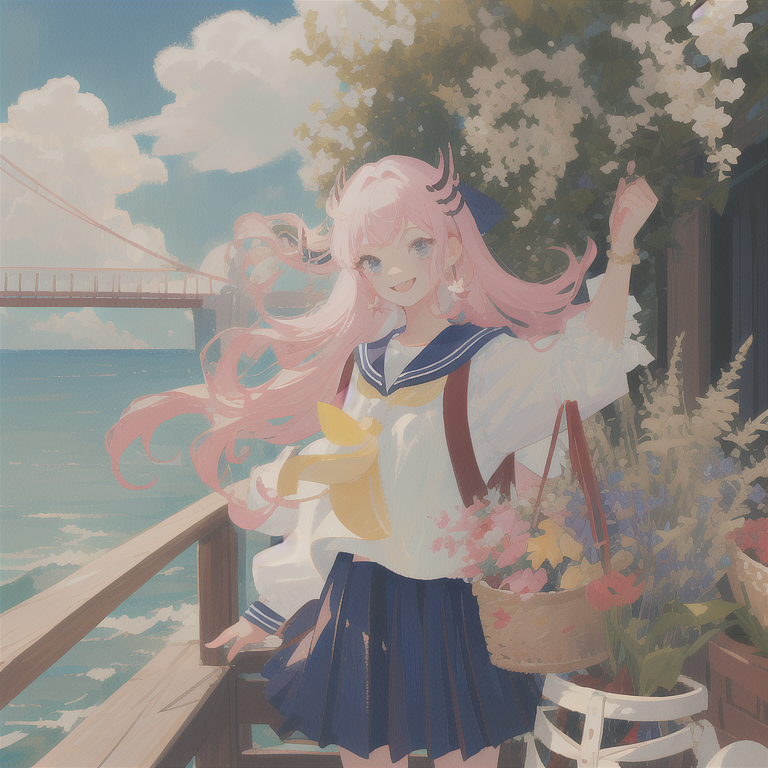
当调整到0.9时,生成了一张跟原图完全不沾边的图,可见该数值对原图的影响非常大。

3、选择放大算法;

有一种说法是无脑选择 R-ESRGAN 4x+ 算法就好,如果是二次元就选择 R-ESRGAN 4x+
Anime6B,但就我个人体会来说似乎影响不大,如果有多余时间可以几种算法都尝试。

画面都显得有些灰暗,颜色并不鲜艳,可以通过勾选模型旁边地外挂VAE模型,效果提升明显。
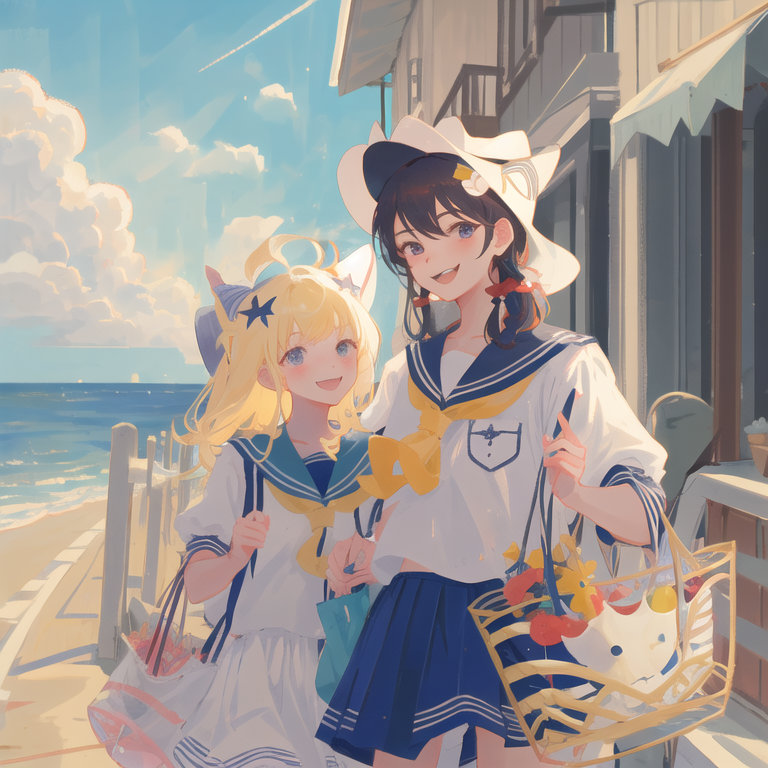
二、图生图

1、调整重绘尺寸;效果与将图片发送到后期处理效果看不出区别。

2、脚本-SD放大。

使用方法:

1、在脚本下拉菜单中选择SD upscale;

2、在放大倍数中填入合适的数字。

3、在分块重叠像素宽度中保持默认值64即可,或者其他值X。

4、在重绘尺寸栏中,将步骤3中填入的数值加上原有的值,得出一个新值填入其中。例如原始图片尺寸为512512,扩大成原来的两倍即1024,再加上重叠像素值64,最终填入10881088。

5、可以根据需要需要对CFG Scale值和重绘幅度值进行调整。
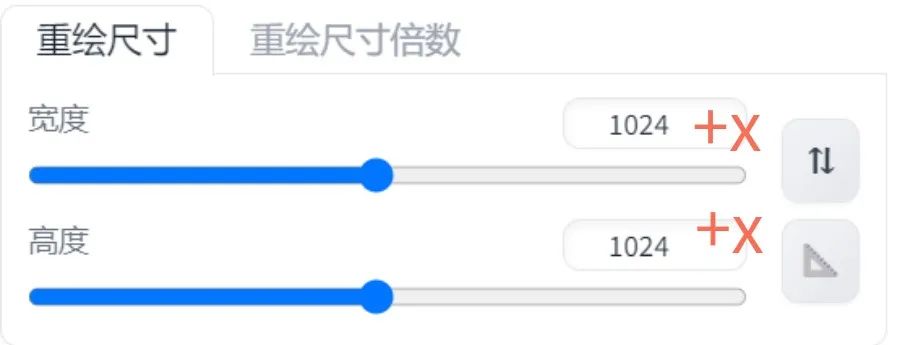
**这么做的原因在于,该功能实现的原理是放大的原理把原图切成若干份,各自生成后再拼接成一张更大的图,而这多出来的像素就是用来重合时做缓冲使用。
**
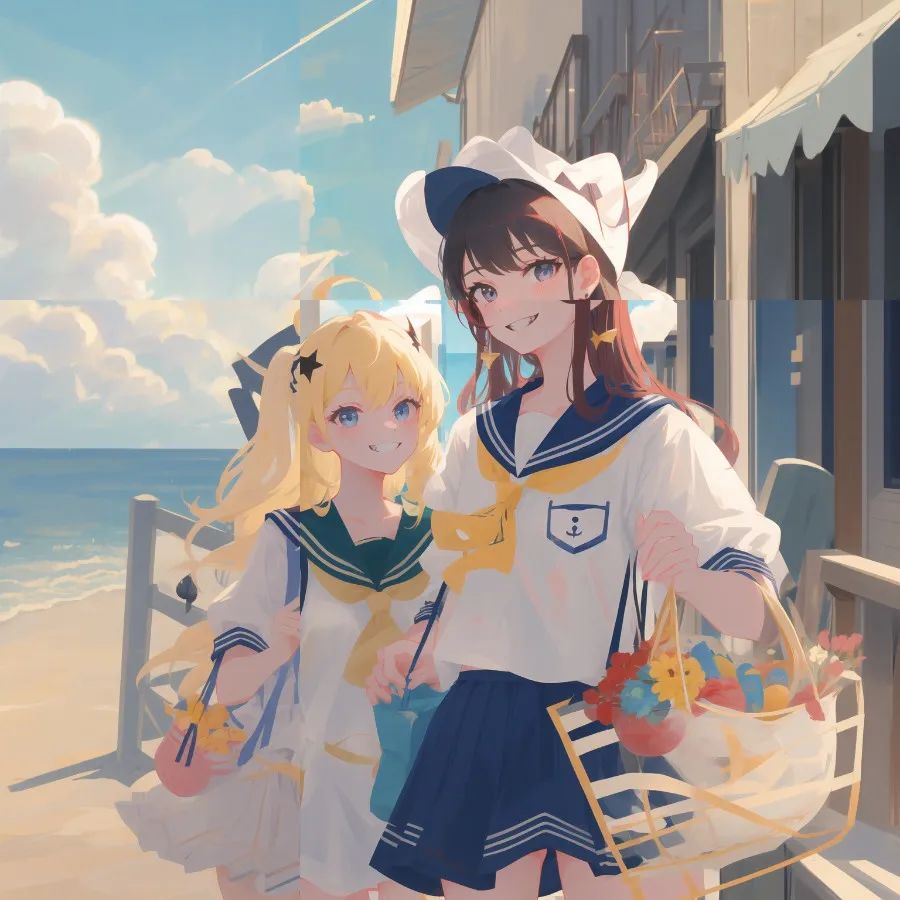
可以看出明显的拼接痕迹

三、Tiled Diffusion + Tiled VAE

在StableDiffusionUI上的操作很容易,只需要勾选这两个框、调整放大倍数,其他保持默认也可以实现放大功能。
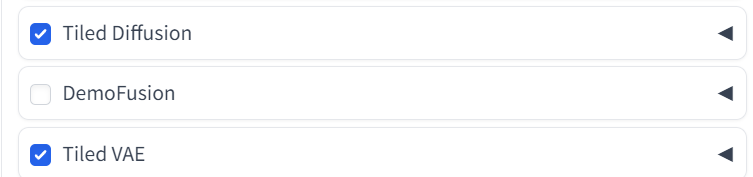
以下是它们的工作原理:

Tiled
Diffusion****通过将图像分割成较小的块,每个块单独进行处理,然后将处理后的块重新拼接成完整的高分辨率图像。这种方法的关键步骤包括:

  • 图像分割:将原始图像分割成多个重叠的较小块。重叠部分可以帮助在拼接时避免明显的边缘或接缝。

  • 块处理:对每个块单独进行扩散过程,即逐步去噪和细化图像。每个块可以独立处理,这样可以避免处理整个图像时的高内存占用。

  • 图像重建:将处理后的块重新拼接成完整的图像。重叠部分的像素可以通过加权平均或无缝拼接算法处理,确保块之间的过渡平滑自然。

Tiled VAE****也采用分块处理的方式,将图像分割成较小的块,每个块单独进行编码和解码。具体步骤包括:

  • 图像分割:将原始图像分割成较小的块,块的大小可以根据具体需求进行调整。

  • 块编码:使用VAE对每个块进行编码,将高维图像数据压缩成低维潜在向量。

  • 块解码:将潜在向量解码回高分辨率图像块。解码后的图像块可能会进行一些细化处理,以提高图像质量。

  • 图像重建:将解码后的图像块重新拼接成完整的图像,同样需要处理块之间的过渡部分,以确保拼接效果自然。

以下是使用Tiled Diffusion和Tiled VAE对图像进行放大和修复的具体步骤:

  • 准备图像:加载需要放大和修复的原始图像。

  • 设置块大小:选择合适的块大小,通常根据图像分辨率和可用的计算资源进行选择。

  • 图像分割:将原始图像分割成指定大小的块,确保块之间有一定的重叠区域。

  • 处理每个块:

  • 对于Tiled Diffusion,逐步去噪和细化每个块。

  • 对于Tiled VAE,先对每个块进行编码,再进行解码和细化。

  • 图像重建:将处理后的块拼接回原始图像,处理重叠区域以确保图像的平滑过渡。


在这里插入图片描述

[Stable Diffusion进阶篇]SD V1.6版本强势推出 V 1.6 的版本迎来大量新功能,以下是官方的更新日志:https://github.com/AUTOMATIC1111/stable-diffusion-webui/releases/tag/v1.6.0让我们一起来看下更新的功能点。 阅读详情

相关推荐

一文了解向量数据库在RAG中扮演的角色

向量数据库:AI新纪元的基石。探索如何通过这一创新技术优化RAG,提高语言模型的信息处理能力

2401_82452722的博客 2456

StableDiffusion对图片进行高清、优化、放大

StableDiffusion默认生成的图片为512*512,“只可远观,不可近赏”来形容怕是再合适不过了。好不容易抽到了一张自己心仪的图,但苦于颜色暗淡,分辨率低下,有什么办法能在原画的基础上,让它的细节更丰富吗?答案是肯定且简单的。2、调整数据(高分迭代步数、重绘幅度)2.1高分迭代步数:是StableDiffusion等中的一个关键参数,控制生成过程中的迭代次数。更多的迭代步数通常会带来更高的图像质量和细节,但同时也会增加生成时间。

HJS123456780的博客 1068

聚类教程:cisTopic——来自单细胞表观基因组学数据的顺式调控主题的概率建模

之前运行这步的时候报错了如下: 后来发现原因是Ubuntu自动把R包更新到4.2版本,但是Rstudio版本没有更新,更新Rstudio即可,更新Rstudio的教程看此教程:。

watermel__的博客 1053

【StableDiffusion教程】对图片进行高清、优化、放大

StableDiffusion默认生成的图片[分辨率]为512*512,“只可远观,不可近赏”来形容怕是再合适不过了。好不容易抽到了一张自己心仪的图,但苦于颜色暗淡,分辨率低下,有什么办法能在原画的基础上,让它的细节更丰富吗?答案是肯定且简单的。

m0_56144365的博客 1375

基于WEKWS模型的语音唤醒关键词识别

本文所使用的模型网络结构继承自论文《Compact Feedforward Sequential Memory Networks for Small-footprint Keyword Spotting》,文中研究了将低秩矩阵分解与传统FSMN相结合的紧凑型前馈顺序记忆网络(cFSMN)用于远场关键字检测任务。

YuZhou的博客 6601

破晓之光:GTK#框架让C# WinForm程序跨平台运行的终极指南

GTK#框架的出现,彻底打破了C# WinForm只能在Windows上运行的桎梏。

墨夶的博客 605

【AI绘画】如何使用StableDiffusion 对图片进行高清、优化、放大

今天这篇推文,主要想分享下如何优化图片,核心目的就是让图片变得更好看。 StableDiffusion默认生成的图片分辨率为512*512,“只可远观,不可近赏”来形容怕是再合适不过了。好不容易抽到了一张自己心仪的图,但苦于颜色暗淡,分辨率低下,有什么办法能在原画的基础上,让它的细节更丰富吗?答案是肯定且简单的。

HJS123456780的博客 1637

6、 实时家禽健康识别与疾病检测系统的深入解析

本文深入解析了一种基于物联网的实时家禽健康识别与疾病检测系统,结合图像分析和音频分析技术,能够有效识别病鸡并防止疾病传播。文章详细介绍了系统的测试环境、数据采集与预处理方法、图像与音频分析流程,并对系统性能进行了全面评估。最后提出了未来改进方向,包括多模态融合、深度学习应用及实时性优化等。

weixin_28840811的博客 187

如何使用AI绘画工具StableDiffusion :对图片进行高清、优化、放大

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。也采用分块处理的方式,将图像分割成较小的块,每个块单独进行编码和解码。

A13531922962的博客 2195

Transformer实战(39)——多模态生成式Transformer

能够理解多种类型输入的模型被称为多模态模型。多模态学习是人工智能 (Artificial Intelligence, AI) 领域的重要研究方向之一,长期受到众多研究人员的关注。本节将介绍使用多模态模型的生成式 AI,包括文本到图像 (text-to-image) 和文本到音乐 (text-to-music) 的生成模型。将介绍 Stable Diffusion 及其工作原理,同时也将介绍 MusicGen 和 AudioGen 模型。

盼小辉丶的博客 2511

SCADA|KingSCADA实现有新报警时声音报警提示

在SCADA项目中有的现场系统比较多,每个调度员可能会一个人盯好多个系统,因此不会一直盯着一个系统,这时候就需要当有新的报警产生时,有报警声音提示,提示调度员查看报警,进行处理。$NewAlarm是一个离散型的变量,是新报警的意思,即当前系统中有新的报警信息产生时,该变量会自动置为1;以上为一最简单的报警提示的实现,实际中可能还会要求语音播报啥啥报警的声音,具体有时间再进行测试。通过创建测试界面,创建一个内存变量,内存变量,配置报警,界面按钮制造报警,测试效果。

做有价值的事,积累有价值的笔记! 1411
上一篇: 【stable diffusion】ComfyUI 使用 LoRA 极简工作流
下一篇: [Kolors-MZ]可图已可用SD灵魂插件:可控性CN组件与风格一致IPA组件,可图生态里程碑的新跃进
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1480原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值