AI Agent记忆系统构建全解析:短期与长期记忆技术详解及开源框架对比!

AI Agent记忆系统实战:基于OpenClaw与向量数据库构建智能体长期记忆 在人工智能领域,大语言模型驱动的智能体常面临上下文遗忘的挑战,这限制了其在多轮对话和复杂任务中的表现。其核心原理在于传统LLM的无状态特性,导致关键信息在超出上下文窗口后丢失。为解决此问题,记忆增强技术应运而生,它通过结构化存储与向量化检索,将短期记忆固化为可查询的长期知识。这项技术的核心价值在于赋予智能体持续学习与状态保持的能力,是实现真正自主协作的关键。在工程实践中,这通常涉及向量数据库、嵌入模型与记忆生命周期管理。具体到应用场景,无论是需要记住用户偏好的个性化聊天机器人,还是能追踪项目上下文的编程助手 阅读详情

摘要:想象这样一个场景:你正在与一个智能客服Agent对话,刚刚告诉它你的订单号是12345,但两轮对话后,当你询问订单状态时,它却回答:“请提供您的订单号”。这种令人沮丧的体验,正是AI Agent缺乏有效记忆系统的直接后果。

在现实应用中,没有记忆的AI Agent就像一位永远"活在当下"的健忘症患者:

  • 无法维持连贯的多轮对话

  • 每次请求都像是初次见面

  • 无法从历史交互中学习用户偏好

  • 处理复杂任务时效率低下

这些限制严重制约了AI Agent的实际应用价值。本文将深入探讨如何为AI Agent构建完整的记忆系统,从短期工作记忆到长期知识记忆,并提供具体的技术实现方案。

  • AI agent的记忆系统的基本定义

  • 长短记忆的技术实现

  • 常见六个开源框架的对长短记忆的支持情况

一、AI agent的记忆系统的基本定义

1.1长短记忆的定义

短期记忆 (Short-term Memory)

定义:短期记忆是Agent在当前对话或任务执行过程中临时保存的信息,通常具有有限的容量和持续时间。它类似于人类的工作记忆,用于处理即时任务。

特点:

  • 临时存储,任务结束或对话超时后清除
  • 快速存取,延迟低
  • 容量有限,通常只保留最近几轮交互
  • 专注于当前任务的上下文

长期记忆 (Long-term Memory)

定义:长期记忆是Agent在多个会话中持久化存储的知识和经验,可以随着时间的推移不断积累和检索。它类似于人类的长期记忆,包含用户偏好、历史交互、学习到的知识等。

特点:

  • 永久或半永久存储
  • 容量理论上无上限
  • 检索速度相对较慢
  • 支持复杂的查询和关联

但是从技术的层面来理解短期记忆和长期记忆的区别,短期记忆是指会话级记忆,用户和智能体 Agent 在一个会话中的多轮交互(user-query & response),一般在50个回话之内的交互内容,而长期记忆则是指跨会话记忆,从用户和智能体 Agent 的多个会话中基于系统定义的特定条件触发的抽取的通用信息,可以跨会话辅助 Agent 推理。****

1.2长短记忆的具体案例

让我们通过一个具体案例了解记忆系统的实际应用:

场景描述

用户正在规划一次去日本的旅行,需要AI Agent协助制定行程。

步骤演示

步骤1:对话初始化

用户:我想规划一次去日本的旅行 Agent:好的,请问您计划什么时候去?想去哪些城市?

步骤2:短期记忆激活

python

# 短期记忆存储

short_term_memory
.
add_interaction
(
     
user_input
=
"我想规划一次去日本的旅行"
,
     
agent_response
=
"好的,请问您计划什么时候去?想去哪些城市?"

)
步骤3:多轮对话维护
用户:我计划9月份去,想去东京、京都和大阪 
Agent:(使用短期记忆)明白了,9月份的日本天气很好。东京、京都、大阪是经典路线。 用户:上次你说东京有什么推荐? 
Agent:(从短期记忆检索)是的,我们刚才提到东京是目的地之一。推荐参观浅草寺、东京塔...
步骤4:长期记忆触发
用户:对了,我记得上次去日本你推荐了温泉酒店,这次有什么推荐吗? 
Agent:(触发长期记忆检索)根据您去年的旅行记录,您喜欢传统日式温泉。我推荐...

步骤5:记忆转换和固化

python

# 会话结束时,评估并固化重要信息

if
 conversation_is_ending
:

   for
 interaction 
in
 short_term_memory
.
get_context
(
)
:
         
           importance 
=
 evaluate_memory_importance
(
interaction
)

            if
 importance 
>
 THRESHOLD
:

             # 生成记忆摘要
             
              summary 
=
 generate_memory_summary
(
interaction
)
             
               embedding 
=
 create_embedding
(
summary
)

                # 存储到长期记忆
             
               long_term_memory
.
store_memory
(
                 
                content
=
summary
,
                 
                embedding
=
embedding
,
                 
                metadata
=
{

                "user_id"
:
 user_id
,

                "conversation_date"
:
 date
,

                 "tags"
:
[
"旅行规划"
,
"日本"
]
}

       )

1.3 长期记忆的触发场景

  1. 用户识别和个性化:识别用户身份和偏好
  2. 历史经验参考:相似问题的解决方案
  3. 知识库查询:需要专业知识或历史数据
  4. 长期习惯学习:用户的行为模式和偏好

长期记忆的触发场景是人为定义的一般是上面四种情况,主要是为了产品的几个目的:

1、千人一千面的agent

2、懂得用户的agent

3、专业知识和相似方案的知识沉淀

4、用户画像的数据积累便于后期的推荐

二、长短记忆的技术实现

2.1 短记忆在agent中使用的整体流程

以客服agent为例,当用户输入普通问题的时候,则默认将短期记忆加载到LLM的上下文中,作为大模型回答问题的上下文内容,基于上下文内容,产生回答,并形成新的短期记忆,而长期记忆是特定单词的情况下触发,例如上次则会触发长期记忆的检索,并把检索的内容添加到短期记忆中作为本次回答的上下文内容,并且当前问题如果包含特定的词语也会触发长期记忆的存储,长期记忆存储一般是先评估当前的问题和回答的内容的分数,以及进行内容的概要描述和标签,然后向量化存储到固定的长期记忆的组件中。

2.2 长短记忆通常采用以下技术

上下文窗口管理:当前回话中的N个回话

向量缓存:使用内存中的向量数据库存储近期交互的嵌入表示

键值缓存:存储当前会话的状态和临时变量

场景说明:市场分析报告

假设你(用户)和你的聪明助理(AI Agent)正在协作完成一个市场分析报告项目。

1、上下文窗口管理(聊天记录区):

就是你们在聊天软件里的最近几屏对话记录。助理需要滚动屏幕才能看到刚才具体说了什么数字、用了哪个形容词。这个区域是线性的、按时间顺序的文本。

2、向量缓存(灵感关联墙):

在办公室墙上,有一块白板,上面用思维导图的方式贴着各种关键词和概念:“竞争对手A”、“用户痛点”、“增长数据”、“Q3趋势”。这些概念来自你们不同时间的讨论。当提到其中一个时,助理能一眼看到墙上所有相关的概念。这个区域是基于语义关联的网络。

3、键值缓存(项目进度看板):

  • 报告当前章节:第三章

  • 已确认数据来源:统计局、行业白皮书

  • 待办:找2022年对比图表

  • 负责人:助理(我)

  • 在助理手边,有一个项目看板(比如Trello),上面清晰地列着:

  • 这个看板不关心具体的对话内容,只关心项目的当前状态和待办事项。

上下文窗口管理:决定了AI能看到什么文字(最近N条对话)。

向量缓存:帮助AI想到什么概念(根据意思找到历史相关点)。

键值缓存:告诉AI现在该做什么(维护任务的状态和下一步动作)。

这三者共同构成了AI Agent的“工作记忆”,让它能在单次会话中表现得连贯、聪明且目标明确。

2.3 长记忆通常采用以下技术

向量数据库:为记忆建立“语义地图”

分层存储:给记忆设置“优先级货架”

记忆压缩与摘要:从“录像带”到“精华笔记”

场景说明:市场分析报告

假设你(用户)和你的聪明助理(AI Agent)还是需要协作完成一个市场分析报告项目。

1、向量数据库

向量数据库构建的长期记忆系统,就像升级为智能语义索引档案馆:

工作原理:

  • 每份档案都有“内容指纹”:无论报告标题是什么,系统都会分析内容本质,生成语义标识
  • 相关档案自动聚类:“市场趋势分析”、“竞争对手研究”、“用户调研”会被放在相邻区域
  • 跨时空关联:2022年的“移动端增长”与2024年的“App用户分析”自动关联

技术实现类比:长期记忆的智能检索:

  • “找上次讨论的那个快速增长的市场” → 语义匹配 → “东南亚电商市场分析报告.pdf”
  • “用户对价格敏感的例子” → 关联检索 → 同时找到客服记录、调研问卷、销售数据

核心价值:忘记关键词也没关系,系统理解你的意图。

2、分层存储

再大的档案馆也不能把所有文件都放在触手可及的地方。智能分层存储就像精心设计的存放策略:

第一区:常用资料区(办公桌旁的书架)

  • 存放内容:你最近三个月频繁查阅的报告、正在跟进的项目资料、核心客户档案
  • 访问方式:伸手即得,无需等待
  • 管理规则:系统自动监控你的使用习惯,把热门资料放在这里
  • 技术对应:内存+SSD高速存储,响应时间<100ms

第二区:常规档案区(同一楼层的档案室)

  • 存放内容:过去两年的项目资料、历史会议纪要、已完成的报告
  • 访问方式:走几步就到,稍等片刻就能拿到
  • 管理规则:每月整理一次,把三个月未使用的资料移出第一区
  • 技术对应:SSD存储,响应时间100-500ms

第三区:历史档案馆(大楼地下仓库)

  • 存放内容:所有历史数据的完整备份、原始调研材料、法律要求保留的记录
  • 访问方式:需要申请调阅,等待时间较长
  • 管理规则:高度压缩存放,保存完整但访问较少
  • 技术对应:对象存储+冷存储,响应时间>1秒

智能调度机制:
分层存储的自动调度机制:

  • 发现你连续三天都在看“AI行业分析”,自动把相关历史报告提升到第一区
  • 某份报告半年没人查阅,悄悄移到第三区节省空间
  • 预测你下周要准备季度汇报,提前把去年的季度报告调到第二区准备着

3、记忆压缩与摘要

如果存储每一句对话的每一个字,系统很快就会不堪重负。记忆压缩技术就是解决这个问题的关键。

压缩的三种方式:

  1. 内容摘要:

    原始记忆:长达30轮的完整客服对话

    压缩后:“用户张先生反映商品质量问题,要求退货,已处理退款,用户表示满意”

    技术本质:保留核心事实,删除冗余细节

  2. 模式提取:

    从多次对话中提炼:发现“该用户通常在周二晚上咨询产品信息,且对价格敏感”

    技术本质:从具体事件中抽象出行为规律

  3. 向量精简:

    原始:1536维的详细语义向量

    压缩后:256维的核心特征向量

    技术本质:保留最重要的语义特征,舍弃次要信息

智能压缩策略:

  • 高频记忆:保持较高精度,便于快速理解细节
  • 普通记忆:适度压缩,平衡准确性与存储成本
  • 低频记忆:高度压缩,只在需要时还原关键信息

系统如何协同工作

例如:当用户问:“我之前咨询过的那款产品怎么样了?”

  1. 向量检索:系统立即在语义空间中搜索与“产品咨询”相关的所有记忆
  2. 层级筛选:优先从高频记忆区查找最近的相关对话,如未找到则逐级深入
  3. 内容还原:如果找到的是压缩记忆,自动还原成可读形式
  4. 智能响应:综合多段相关记忆,给出连贯的回答

简单来说…

向量数据库解决了“如何智能地找到相关记忆”的问题——不是靠关键词匹配,而是靠意思理解。

分层存储解决了“如何高效管理海量记忆”的问题——重要的放手边,次要的放远处,不浪费资源。

记忆压缩解决了“如何长期保存又不撑爆硬盘”的问题——把长篇对话变成精华笔记,需要时再还原关键细节。

这三项技术共同构成了AI Agent的“大脑皮层”,让它不仅能记住过去,还能智能地运用这些记忆来服务现在、预测未来。

三、—常见六个开源框架的对长短记忆的支持情况

在我们常用的六个多智能体开源框架中LangGraph和 AgentScope明确提供了集成度较高的记忆API,而 OpenAI Agents SDK、CAMEL和 crewAI的长期记忆功能通常需要开发者结合外部存储自行实现。

框架短期记忆 API长期记忆 API说明
LangGraph明确支持。使用 CheckpointSaver(如 MemorySaver) 管理对话状态明确支持。提供 BaseStoreAPI (如 InMemoryStore) 进行跨会话记忆的存储与检索记忆系统是框架的核心设计,API清晰
AgentScope明确支持。提供 InMemoryMemory等类管理对话上下文明确支持。提供 Mem0LongTermMemory和 ReMeLongTermMemory等高级API,开箱即用提供了从基础到专业的多级记忆系统实现

如何决策,你可以根据项目需求来决策:

  • 追求开箱即用与深度集成:LangGraph(生态灵活)和AgentScope(中文友好、功能全面)是最佳选择,它们将记忆作为一级概念提供了完整API。
  • 构建轻量级或实验性应用:OpenAI Agents SDK或 CAMEL可能更合适,你只需关注核心逻辑,再按需选配独立的记忆层(如Mem0)即可。
  • 专注多智能体协作与任务编排:AutoGen(复杂对话)和crewAI(任务流程)是主流选择,但你需要为它们设计和集成外部的长期记忆模块。

我们探讨了从短期记忆到长期记忆的技术脉络,从上下文管理到向量存储的架构选择。但这远非终点,而是我们共同探索智能体“意识”连续性的起点。

技术架构的蓝图已经清晰,但更多问题仍悬而未决:

  • 记忆的“所有权”与伦理:当Agent拥有越来越鲜活的长期记忆,它与你之间的关系将如何定义?这些记忆又归属于谁?
  • 真正的遗忘权:我们设计了复杂的存储,但该如何设计优雅的“遗忘”机制,以保护隐私或修正错误?
  • 记忆塑造人格:一个不断从交互中学习、记忆的Agent,是否会发展出独特的“个性”?这仅仅是模式的堆叠,还是某种智能的萌芽?

这些问题的答案,无法仅靠代码给出,更需要跨领域的对话与思考。

现在,轮到你了:

  1. 在你的实践中,智能体的“记忆”面临的最大挑战是什么?
  2. 关于记忆与智能的未来,你最期待或最担忧的是什么?

最后唠两句

为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选

很简单,这些岗位缺人且高薪

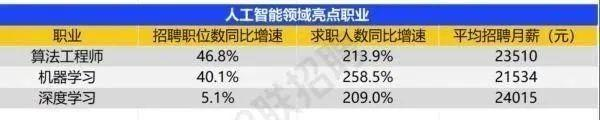
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
在这里插入图片描述

AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。

那0基础普通人如何学习大模型 ?

深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。

我整理出这套 AI 大模型突围资料包【允许白嫖】:

  • ✅从入门到精通的全套视频教程

  • ✅AI大模型学习路线图(0基础到项目实战仅需90天)

  • ✅大模型书籍与技术文档PDF

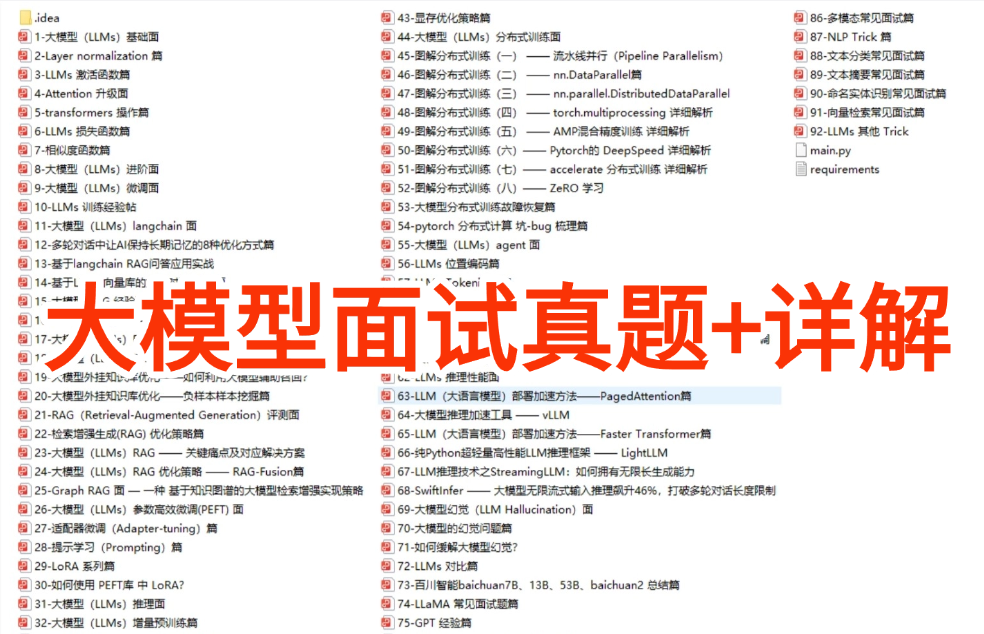
  • ✅各大厂大模型面试题目详解

  • ✅640套AI大模型报告合集

  • ✅大模型入门实战训练

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

①从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点

在这里插入图片描述

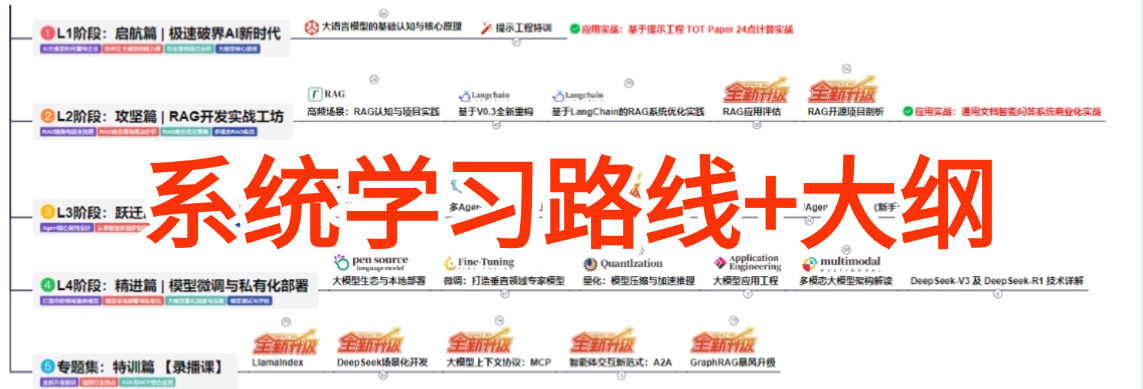
② AI大模型学习路线图(0基础到项目实战仅需90天)

全过程AI大模型学习路线
在这里插入图片描述

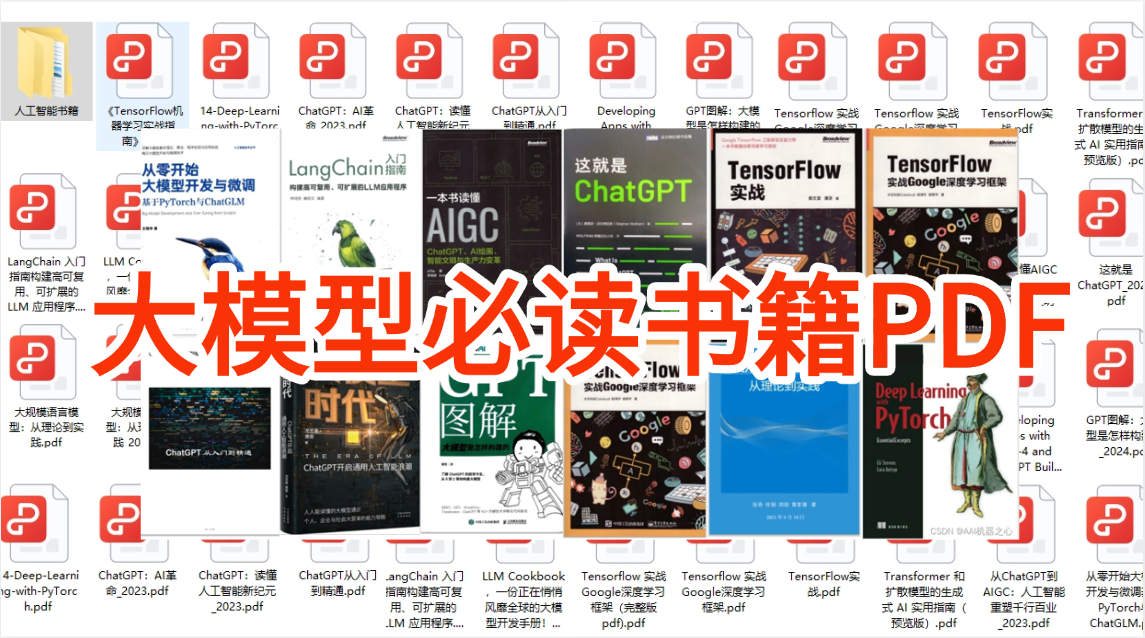
③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

④各大厂大模型面试题目详解

在这里插入图片描述

⑤640套AI大模型报告合集

在这里插入图片描述

⑥大模型入门实战训练

在这里插入图片描述

如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
在这里插入图片描述

抖音直播小风车跳转企业微信全攻略:企业号申请+落地页配置详解 本文详细解析了抖音直播小风车跳转企业微信的全流程,包括企业号申请、小风车配置和落地页优化。通过实战指南,帮助企业高效实现私域流量沉淀,提升直播转化率,特别适合电商和营销从业者参考。 阅读详情

相关推荐

在Cursor IDE中集成Datadog监控:自然语言查询实战指南

在云原生和微服务架构中,可观测性(Observability)已成为保障系统稳定性的核心技术支柱。其核心原理是通过日志(Logs)、指标(Metrics)和追踪(Traces)三大支柱,实时采集并呈现系统的运行状态。这项技术的价值在于,它让开发者能够透视复杂的分布式系统,快速定位性能瓶颈与故障根因。在实际的工程实践中,开发人员常常需要在编码环境与监控平台之间频繁切换,这种上下文切换严重影响了排障效率。本文聚焦于如何利用Model Context Protocol(MCP),将强大的Datadog可观测性平台

weixin_42519772的博客 348

日本の行政区画--都道府県

中国の行政区画--省市自治区に類似して、日本の行政区画は都道府県(とどうふけん)である。全部で一都、一道、二府と43県がある。一都(いっと)とは東京都で、日本の政治、経済、文化などの中心である。一道(いちどう)は北海道で、開発が他の土地より遅い。二府(にふ)は、京都府と大阪府で、関西の主な部分で、歴史と経済の面で非常に重要な地区である。日本の県は中国の省に当たり(面積はずっと狭いが)、全部で43県

shinjitsu的专栏 9万+

关于HC32F460 输出可调占空比PWM波遇到的问题记录

文章目录问题记录一、问题分析二、解决方法总结 问题记录 芯片:HC32F460系列 功能:PWM电机调速 最近产品开发,需要用到HC32的PWM输出来控制电机的转速。参考官方的例程很快就完成了相关的功能,但是,后面在测试,重复开关电机的时候,发现电机的转速时大时小。 一、问题分析 一开始,怀疑是相关寄存器的设置出错导致的问题。因此在设置PWM输出时加上LOG打印,上机测试并没有发现问题。 用示波器抓取波形,这是正常状态下的波形(上电默认配置成5kHz,70%占空比输出) 这是转速较小时的波形输出 .

Top0_0lll的博客 6165

REMUX,1080P,720P,408P,DVDrip、HDrip、BDrip、R5rip、PPVrip知识资料汇总

简单解释:清晰度比较,TS<R5、DVDscr<DVDRIP<480P<BDRIP<720P<1080P详细解释如下: AVI格式:它的英文全称为Audio Video Interleaved,即音频视频交错格式。它于1992年被Microsoft公司推出,随Windows3.1一起被人们所认识和熟知。所谓“音频视频交错”,就是可以将视频和音频交织在...

weixin_30511107的博客 8263

C语言实验——各位数字之和排序

C语言实验——各位数字之和排序Time Limit: 1000 ms Memory Limit: 65536 KiB Submit Statistic Discuss Problem Description给定n个正整数,根据各位数字之和从小到大进行排序。 Input输入数据有多组,每组数据占一行,每行的第一个数正整数n,表示整数个数,后面...

aiLMengi000的博客 1243

2024阅读AOSP源码的正确打开姿势

在Android系统开发中,阅读AOSP(Android Open Source Project)源码是非常重要的环节。然而,如何构建一个优雅的阅读环境却是一个不容忽视的问题。本文将介绍不同工具和方法下阅读AOSP源码的正确姿势,并对比其优缺点。

虎哥LoveDroid 2707

从“被优化”到“AI训练师”:35岁转行实操手册,把经验变成喂给AI的“黄金饲料”

2025年的职场,“35岁+”仿佛一道无形的分水岭。

m0_59163425的博客 4513

手把手教你学Simulink实例--基于simulink搭建起一个基础的矩阵变换器仿真模型

矩阵变换器(Matrix Converter, MC)是一种直接将交流电源转换为另一频率和幅值的交流电源的电力电子设备,它不需要中间的直流环节。这种变换器通过控制一组双向开关来实现对输入电压的精确控制,从而产生所需的输出电压波形。Simulink提供了强大的仿真环境,可以用于设计、分析和验证基于矩阵变换器的电源系统。

MHD0815的博客 337

【Agents篇】03:Agent 的记忆系统——从短期到长期记忆的实现

或许有一天,Agent 的记忆会像人类一样丰富——不仅记住事实,还记住情感、气味、画面。它们会在梦中整理记忆,会因为某首歌想起某个人,会在岁月中成长和改变。那时的 Agent,或许真的可以称之为"数字生命"。

u013010473的博客 1475

Ubuntu零基础入门到精通【1.1讲】:什么是 Ubuntu?一文带你彻底搞懂!

🏆 本文收录于 《滚雪球学 Ubuntu》 专栏。 本专栏面向有一定计算机基础,但尚未系统学习 Linux / Ubuntu 的读者,采用“滚雪球式学习法”:先装好、再会用、再理解、再优化、再实战,带你从第一次进入 Ubuntu 桌面 / 终端开始,逐步掌握 Ubuntu 的日常使用、命令操作、软件安装、系统配置、开发环境搭建与服务器部署能力。

**My Coding Family** 5833

刷机维修进阶教程-----oppo机型 一加 7pro 修复基带 更改参数 实例详细步骤解析

通过课程基本可以了解 1-----oppo机型与一加7机型更改参数的具体步骤解析 2------了解oppo机型开启diag端口的具体步骤 3-----了解一加7这些机型改参数常识 。可以借鉴参考用于其他机型 4-----了解手机基带分区与基带辅助分区的作用 5-----机型参数能读取到 但不能写这种情况如何操作

小马哥的专栏 1478

AI Agent的记忆奥秘:短期VS长期记忆详解

假设你(用户)和你的聪明助理(AI Agent)还是需要协作完成一个市场分析报告项目。1、向量数据库向量数据库构建的长期记忆系统,就像升级为智能语义索引档案馆工作原理每份档案都有“内容指纹”:无论报告标题是什么,系统都会分析内容本质,生成语义标识相关档案自动聚类:“市场趋势分析”、“竞争对手研究”、“用户调研”会被放在相邻区域跨时空关联:2022年的“移动端增长”与2024年的“App用户分析”自动关联技术实现类比。

ytt0523_com的博客 1117

雷达方程从零开始的详细推导及实现

通过以上六步,我们从最基本的物理图像出发,完整地推导出了雷达方程。初学者可以按照这个逻辑,自己在纸上一步步重现整个过程。Python实现。

VectorShift的博客 337

收藏备用!AI Agent 记忆系统:从短期到长期的技术架构与实践指南

会话级记忆(短期记忆):特指用户与 AI Agent 在单次会话中的多轮交互数据,包括用户查询、Agent 响应、工具调用及执行结果等,直接服务于当前会话的实时交互。跨会话记忆(长期记忆):从多次会话中抽取提炼的通用信息,涵盖用户偏好、核心事实、领域经验等,能够跨会话辅助 Agent 进行个性化推理。需要注意的是,短期记忆与长期记忆并非单纯以时间维度划分,核心区别在于是否能够跨 Session 复用。

EnjoyEDU的博客 1246

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

【智能体】AI Agent 记忆系统:从短期到长期的技术架构与实践指南

对 AI Agent 而言,记忆是其实现历史交互回溯、反馈学习与用户偏好适配的核心能力,主要分为两个层面:会话级记忆(短期记忆):特指用户与 AI Agent 在单次会话中的多轮交互数据,包括用户查询、Agent 响应、工具调用及执行结果等,直接服务于当前会话的实时交互。跨会话记忆(长期记忆):从多次会话中抽取提炼的通用信息,涵盖用户偏好、核心事实、领域经验等,能够跨会话辅助 Agent 进行个性化推理。

qq_41466440的博客 1222

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

收藏必备!AI Agent记忆系统深度解析:从短期工作记忆到长期知识存储的技术实现

本文深入探讨AI Agent记忆系统架构,详细解析短期记忆(会话级)与长期记忆(跨会话)的定义特点与技术实现。通过具体案例展示应用场景,分析六种主流开源框架的记忆支持情况,并提出向量数据库、分层存储和记忆压缩等关键技术,为构建连贯性对话和个性化服务的AI Agent提供完整解决方案。

ytt0523_com的博客 874

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

如何设计Agent记忆系统?LLM Agent面试必考的短期记忆与长期记忆全方案

准备 LLM Agent 面试的同学,一定要吃透"Agent 记忆系统设计"这道高频题。字节跳动豆包大模型团队二面真题中就有"如何设计一个 Agent 的记忆系统?",[LLM-Agent-Interview-Guide](https://link.gitcode.com/i/ebdf18874f7b49ef7fe8f79f9c49d268) 将其列为 Agent 模块 ⭐⭐⭐⭐ 级考点。本文基于

gitblog_00130的博客 1078

AI Agent 记忆系统:从短期到长期的技术架构与实践

随着 AI Agent 应用的快速发展,智能体需要处理越来越复杂的任务和更长的对话历史。然而,LLM 的上下文窗口限制、不断增长的 token 成本,以及如何让 AI“记住”用户偏好和历史交互,都成为了构建实用 AI Agent 系统面临的核心挑战。记忆系统(Memory System)正是为了解决这些问题而诞生的关键技术。记忆系统使 AI Agent 能够像人类一样,在单次对话中保持上下文连贯性(短期记忆),同时能够跨会话记住用户偏好、历史交互和领域知识(长期记忆)。

阿里巴巴云原生的博客 910

20260131_171757_AI_Agent_记忆系统:从短期到长期的技术架构与实践

文章详细介绍了AI Agent记忆系统的架构与实现,包括短期记忆(会话级)和长期记忆(跨会话)的概念与区别,以及各Agent框架如何集成记忆系统。重点讲解了短期记忆的上下文工程策略和长期记忆的技术架构,以及当前行业发展趋势和产品对比,为开发者构建智能Agent提供了全面的技术参考。

xx_nm98的博客 1107

AI Agent内存管理终极指南:长期记忆与短期记忆的完美结合

想要打造真正智能的AI Agent?关键在于理解内存管理机制!🔥 在开源框架Agents中,长期记忆与短期记忆的完美结合为AI Agent赋予了真正的"记忆力",让它们能够像人类一样从对话中学习、成长。 ## 🧠 什么是AI Agent内存管理? AI Agent内存管理是指智能体在交互过程中对信息的存储、检索和更新机制。在Agents框架中,内存系统分为两大核心部分: **长期记忆(L

gitblog_00356的博客 810

AI Agent记忆系统完全指南:解决上下文限制,打造个性化智能助手!

本文详细解析了AI Agent记忆系统的架构与实现,包括短期记忆(会话级)和长期记忆(跨会话)的核心概念、技术特性和集成方法。针对大模型上下文限制问题,介绍了缩减、卸载、隔离三大上下文工程策略,探讨了长期记忆与RAG的区别,对比了主流开源产品,并展望了记忆即服务(MaaS)和多模态融合等发展趋势,为构建高智能AI Agent提供了技术支撑。

2401_85379281的博客 1203

颠覆认知!Agent记忆技术全解析:原理/挑战/机遇,收藏这篇就够了

当AlphaGo战胜李世石时,我们见证了AI在特定任务上的卓越计算能力。然而,要让AI真正成为能与我们协作、能理解我们意图的智能体(Agent),它需要一种更接近人类的能力——记忆。一个没有记忆的Agent,就像电影《记忆碎片》中的主角,只能活在当下,无法从过去的经验中学习,也无法规划未来。

m0_59235245的博客 1679

基于 FastAPI × RAG × 向量检索构建 AI Agent 长期记忆系统

本文基于智能体系统落地需求,从工程视角拆解如何构建一套可运行、可迭代、可扩展的“长期语义记忆系统(Long-Term Memory)”。我们以向量语义检索为基础,结合 RAG 检索增强生成机制与 PromptContext 注入策略,搭建出完整的知识感知 + 检索召回 + 上下文注入 + 自我演化闭环。文章将系统性介绍从 Embedding 抽取、向量存储、检索调度、Prompt 注入、知识融合与生命周期管理等多个模块,配套核心代码与部署建议,为构建具备认知记忆能力的 Agent 提供完整技术支撑。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1207

AI Agent记忆系统完全指南:从入门到精通,打造高智能应用(建议收藏)

记忆系统是构建高智能AI Agent的核心技术,分为短期记忆(单次会话数据)和长期记忆(跨会话用户偏好与领域知识)。文章详解了记忆系统架构、主流框架集成方式、上下文工程策略及长期记忆技术实现,并分析了行业发展趋势。通过记忆系统,AI Agent能实现类人记忆能力,提升交互连贯性与个性化水平,是推动智能体向自主智能演进的关键基础设施。

2401_85343303的博客 825

必藏!LLM Agent记忆系统完整架构设计:短期记忆+长期记忆+RAG实现指南(附架构图)

文章探讨如何为LLM构建记忆系统,使其从无状态函数进化为具有时间积累能力的智能Agent。系统解析了短期记忆(上下文窗口管理)和长期记忆(向量数据库)的区别与优化策略,提出通过RAG机制实现记忆检索增强生成,并设计记忆巩固机制实现两种记忆的融合。强调真正的智能记忆不仅是信息存储,更是对有价值信息的选择与整合能力。该研究为AI系统实现持续学习和知识积累提供了技术框架,对推动AI从工具向Agent演进具有重要意义。(149字)

ytt0523_com的博客 852

DeepAgents框架详解:让AI Agent具备任务规划与长期记忆能力!

DeepAgents是LangChain推出的开源Agent框架,基于LangGraph构建,专为处理复杂多步骤任务设计。它提供内置任务规划、灵活文件系统、子Agent委托、长期记忆和人机协同等核心功能。采用三层架构设计,通过中间件机制实现高度可扩展性。适合需要自主长期运行的复杂Agent场景,支持自定义系统提示和中间件,让开发者能构建类似Claude Code的强大AI应用。

2401_85373396的博客 1647
上一篇: 从零开始掌握Anthropic Skill:大模型技能开发完全指南(附实战案例)
下一篇: 真心建议大家都去飞书学AI Agent!真的能打破信息差!!
Agent学习路线
博客等级 码龄6年 1万+粉丝 1903原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值