给35岁Java/数据开发的转型地图:避开算法红海,用现有优势精准卡位AI工程岗(附避坑指南)

华为OD机试真题 2026.11.4. 新系统 【河流水系流量评估】 华为OD机试真题 新系统【河流水系流量评估】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【河流水系流量评估】多语言题解。 阅读详情

35岁程序员转型,最忌讳“跟风从零学起”,核心逻辑是“技术迁移+经验复用”。第一步必须先梳理自身核心优势:比如你是后端开发,Docker/K8s、服务部署经验可直接复用;若是数据开发,数据清洗、模型基础能力是天然优势。转型方向要精准避开“纯算法研究员”这类需要长期深耕底层数学的红海赛道,优先锁定工程化、应用落地、行业解决方案等能快速兑现经验价值的岗位,降低转型周期与风险。

在这里插入图片描述

一、精准转型定位:按技术栈匹配两大方向
  1. 有数据/算法基础的程序员(数据开发、大数据工程师、传统机器学习工程师、算法工程师):可直接冲刺“大模型工程化”核心赛道,比如大模型微调工程师、模型部署专家、大模型数据策略师等岗位。核心发力点是补充大模型专属技术栈(Transformer架构、高效微调框架、模型优化工具),将原有数据处理、模型训练、运维监控经验迁移到大模型场景,实现“经验增值”。
  2. 纯业务开发程序员(后端Java/Go/Python、前端Vue/React、移动端iOS/Android):无需恐慌“不懂算法”,可走“大模型应用落地”黄金赛道,比如RAG系统开发工程师、大模型插件开发工程师、AI全栈应用工程师、行业AI解决方案顾问等岗位。核心是“大模型工具+原有开发能力”的组合,比如后端开发可聚焦大模型API集成、服务封装与性能优化;前端开发可专攻AI交互界面设计、生成式UI开发;有行业业务经验的(如电商、金融、医疗),可重点打造“行业+AI”的差异化竞争力。

在这里插入图片描述

二、35岁适配的大模型岗位清单:避开内卷,发挥经验优势

结合35岁“重落地、重经验、重稳定”的职业诉求,筛选出以下4类高适配、低内卷的岗位,每类岗位都明确了核心要求与经验复用点,帮你快速匹配:

  • 大模型工程化工程师:核心职责是大模型训练、微调、量化、部署全流程落地。核心要求:Python/PyTorch基础、熟悉LoRA/QLoRA微调技术、掌握Docker/K8s云原生技术、具备模型性能优化经验。经验复用点:原有后端运维、云原生部署、数据工程经验,转型门槛低、需求旺盛。
  • 大模型应用开发工程师:核心职责是基于大模型API/开源模型,开发行业应用系统。核心要求:熟悉OpenAI/通义千问等大模型API、掌握LangChain/RAG技术栈、具备全栈开发能力、能拆解业务需求。经验复用点:原有业务系统开发、API集成、前后端联动经验,上手最快,2-3个月可积累项目经验。
  • 大模型行业解决方案顾问:核心职责是结合行业痛点,设计大模型落地方案并推动实施。核心要求:具备某一行业(金融、医疗、工业、教育)深度业务经验、懂大模型基础能力、具备方案撰写与客户沟通能力。经验复用点:多年行业业务开发、需求分析经验,年龄越大、行业经验越深厚,竞争力越强,是35+程序员的“黄金岗位”。
  • 大模型技术支持/运维专家:核心职责是大模型服务的日常运维、故障排查、性能监控、安全防护。核心要求:熟悉Linux系统、掌握容器化部署、具备日志分析与问题定位能力、了解大模型基础架构。经验复用点:原有IT运维、后端支撑、系统监控经验,转型难度最低,适合追求稳定的程序员。

确定岗位方向后,学习就要“靶向发力”。35岁转型的核心是“高效、实用、不贪多”,下面分两大转型方向,给出分阶段、可落地的学习路径,每一步都明确“学什么、怎么学、做什么项目”。

三、有数据/算法基础:转型大模型工程化(3步进阶,4-6个月落地)

适合有数据处理、模型训练经验的程序员,重点补充大模型专属技术,复用原有工程能力,快速成为“大模型工程化专家”。

第一步:补全大模型基础,衔接原有经验

无需重新学数学(原有概率、线性代数基础足够),重点理解大模型核心架构与工具使用,快速打通“旧经验”与“新场景”的衔接。

  1. 核心知识学习
    1. 大模型核心架构:重点学Transformer架构、注意力机制(必读论文《Attention Is All You Need》,结合原有机器学习基础理解,1周可掌握核心逻辑);
    2. 主流大模型认知:了解GPT、LLaMA、ChatGLM、文心一言的技术特点与适配场景(无需深入底层,知道“什么场景用什么模型”即可);
    3. 学习资源:李沐《动手学深度学习》大模型章节(B站有视频)、Hugging Face官方文档(最权威的大模型工具教程)。
  2. 核心工具实操
    1. 编程语言:强化Python(原有Java/Go可快速迁移,重点掌握NumPy、Pandas数据处理,1-2周搞定);
    2. 大模型框架:Hugging Face Transformers(模型加载、微调)、PyTorch(张量操作、自定义数据集,复用原有机器学习框架经验);
    3. 必做小项目:用Hugging Face加载ChatGLM-6B模型,实现“文本生成+多轮对话”功能(1-2周完成,快速熟悉大模型工具链)。
第二步:攻克大模型工程化核心能力

这是转型核心,重点掌握“微调、优化、部署”三大核心技能,这些能力直接对接岗位需求,是求职的核心竞争力。

  1. 大模型微调技术
    1. 重点掌握LoRA、QLoRA高效微调技术(中小模型首选,落地场景广,无需大量算力,3-4天可掌握基础用法);
    2. 数据准备:学习大模型训练数据的清洗、标注、格式转换(复用原有数据处理经验,重点关注“数据质量对模型效果的影响”);
    3. 实战练习:用ChatGLM-6B微调金融领域文本数据(如金融新闻分类、风险事件识别),完成“数据准备→模型微调→效果评估”全流程。
  2. 模型优化与部署
    1. 模型优化:学习INT4/INT8量化技术(降低模型体积与算力需求)、剪枝技术,推荐工具:GPTQ、AWQ、LLaMA.cpp;
    2. 部署落地:复用Docker/K8s经验,学习大模型容器化部署、用FastAPI封装模型API、实现服务高可用(重点练习“量化后模型的部署流程”);
    3. 必做项目:将微调并量化后的ChatGLM-6B模型,部署到K8s集群,实现支持并发访问的对话服务(完整复刻企业级落地流程,求职加分项)。
第三步:行业落地+项目沉淀,对接求职

35岁转型,“项目经验”比“证书”更重要,重点沉淀1-2个有行业属性的完整项目,突出工程化落地能力。

  1. 行业场景实战
    1. 结合原有行业经验,开发大模型行业应用(如原有金融经验:做“大模型金融舆情分析系统”;原有医疗经验:做“医学文献问答系统”);
    2. 补充运维监控能力:学习大模型服务的性能监控(响应时间、吞吐量)、异常检测、版本管理(复用原有运维经验,重点关注大模型特有的监控指标)。
  2. 项目沉淀与求职准备
    1. GitHub项目沉淀:每个项目需包含“需求文档、技术方案、代码实现、部署流程、效果评估”,突出“工程化落地”和“经验复用”亮点;
    2. 开源贡献:参与Hugging Face生态、vLLM(大模型部署工具)等开源项目的Issue修复、文档优化,提升行业认可度;
    3. 简历优化:重点写“原有经验如何迁移到大模型场景”“完成的大模型项目及业务价值”,避开“纯算法理论”描述。

四、纯业务开发:转型大模型应用落地(3步上手,2-4个月见效)

适合后端、前端、移动端等纯业务开发程序员,无需深入大模型底层原理,核心是“用好大模型工具,解决业务问题”,快速复用原有开发经验,实现转型。

第一步:掌握大模型API与核心工具(1-2个月)

核心是“快速上手能直接落地的工具”,利用原有编程基础,实现大模型能力的快速集成,完成从“业务开发”到“AI应用开发”的初步过渡。

  1. 大模型API实战
    1. 熟练使用主流API:OpenAI API、通义千问API、百度文心一言API(重点学习接口调用、参数调优、多轮对话、上下文管理);
    2. Prompt工程基础:掌握“角色设定+任务描述+约束条件”的黄金指令结构(如“作为电商客服助手,精准回答用户订单查询问题,语气亲切,简洁明了”),提升API调用效果;
    3. 必做小项目:用Python+Flask/FastAPI封装OpenAI API,开发“智能问答接口”,支持多轮对话(复用原有后端API开发经验,1周可完成)。
  2. 核心应用工具学习
    1. RAG系统核心工具:LangChain(大模型应用开发框架)、Milvus/Pinecone(向量数据库),学习“文档加载→文本分割→向量存储→检索问答”全流程(RAG是大模型应用的核心场景,必须掌握);
    2. 全栈能力补充:若有前端经验,学习React+AI组件开发(如集成文本生成、图像生成的前端界面);若无前端经验,可复用后端经验,重点做“API服务+数据处理”;
    3. 学习资源:LangChain中文教程、Milvus官方文档、B站“大模型应用开发”实战视频(跟着做1-2个案例,快速上手)。
第二步:聚焦业务场景,开发完整AI应用(1-2个月)

这是转型的关键一步,重点锻炼“将大模型能力与行业业务结合”的能力,沉淀可展示的完整项目,直接对接岗位需求。

  1. 经典场景实战
    1. RAG系统开发:基于LangChain+Milvus开发“企业知识库问答系统”(如公司内部文档查询助手),覆盖“文档上传→检索→问答→权限管理”全流程(复用原有业务系统开发经验,是求职高频项目);
    2. 大模型插件开发:开发适配ChatGPT的“电商订单查询插件”“天气查询插件”,学习插件开发规范、API对接、身份验证逻辑(复用原有第三方API集成经验);
    3. 全栈AI应用:开发“智能写作助手”(前端+后端+大模型API),实现文本生成、编辑、导出、模板管理功能(展示全栈能力,适合转型AI全栈工程师)。
  2. 工程化落地优化
    1. 复用Docker/K8s经验,将AI应用容器化部署,实现服务高可用、可扩展;
    2. 性能优化:学习大模型API调用缓存、并发控制、错误重试、限流熔断机制(复用原有后端性能优化经验,提升应用稳定性)。
第三步:沉淀行业解决方案,提升求职竞争力(1个月)

35岁程序员的核心竞争力是“行业经验+技术能力”,这一步要将“AI应用开发”与“原有行业经验”深度绑定,打造差异化优势。

  1. 行业解决方案沉淀
    1. 结合原有行业经验,输出1份“大模型行业落地方案”(如原有电商经验:《电商智能客服+商品推荐大模型落地方案》;原有教育经验:《智能题库生成与个性化辅导大模型方案》);
    2. 方案需包含“行业痛点、大模型应用场景、技术架构、实施步骤、预期效果”,突出“用技术解决业务问题”的核心逻辑。
  2. 求职准备与投递
    1. 项目与方案沉淀:将完整项目代码上传GitHub,方案文档整理成PDF,作为求职附件;
    2. 岗位投递:优先选择有你原有行业经验的AI公司(如原有金融经验,投递金融科技AI公司),这类公司更看重你的行业认知,年龄不是障碍;
    3. 面试技巧:重点讲解“原有经验如何迁移到AI项目”“项目解决的业务问题”“工程化落地的难点与解决方案”,少讲纯理论,多讲实战细节。

五、两大转型方向核心对比(一目了然)

对比维度大模型工程化方向大模型应用落地方向
适配人群数据开发、大数据、传统机器学习、算法工程师后端、前端、移动端等纯业务开发程序员
核心技能1. Python/PyTorch;2. LoRA/QLoRA微调;3. 模型量化与部署;4. 云原生(Docker/K8s)1. 大模型API调用;2. LangChain/RAG开发;3. 全栈开发;4. 业务需求拆解
学习周期4-6个月(复用数据/工程经验)2-4个月(复用业务开发经验,见效最快)
核心工具Hugging Face、PyTorch、GPTQ/AWQ、vLLM、K8sOpenAI/通义千问API、LangChain、Milvus、FastAPI/Flask、React/Vue
代表项目1. 金融大模型微调项目;2. 大模型量化部署系统;3. 行业大模型落地平台1. 企业RAG知识库系统;2. 大模型电商插件;3. 智能写作全栈应用
职业发展大模型工程化工程师→高级专家→技术负责人→架构师AI应用开发工程师→行业解决方案专家→AI业务负责人→创业
薪资水平25-40K/月(一线城市),需求稳定20-35K/月(一线城市),入门门槛低,晋升空间大

六、35岁转型避坑指南:4个关键提醒

  • 避坑1:不要盲目学底层算法。35岁转型不是“重返校园”,无需深入研究大模型数学原理,重点放在“工程化落地”“应用开发”上,快速兑现价值。
  • 避坑2:不要忽视项目沉淀。HR招聘35+程序员,最看重“能不能解决实际问题”,1个完整的行业项目,比10个理论课程更有说服力。
  • 避坑3:不要脱离原有行业经验。转型时优先选择有你原有行业经验的AI公司,你的行业认知是年轻从业者不具备的核心优势,能快速建立竞争力。
  • 避坑4:不要追求“全能”。大模型技术体系庞大,聚焦一个细分赛道(如工程化、RAG应用、行业解决方案)深耕,成为“细分领域专家”,比“什么都懂一点”更易求职。

最后想对你说:35岁程序员转型大模型,不是“被迫转行”,而是“技术升级”。你多年的编程积淀、工程经验、行业认知,都是转型的底气。不用害怕年龄,不用焦虑不懂新技术,只要找准方向、高效复用经验、扎实沉淀项目,就能平稳过渡到新赛道,甚至实现职业的“二次腾飞”。


说真的,这两年看着身边一个个搞Java、C++、前端、数据、架构的开始卷大模型,挺唏嘘的。大家最开始都是写接口、搞Spring Boot、连数据库、配Redis,稳稳当当过日子。

结果GPT、DeepSeek火了之后,整条线上的人都开始有点慌了,大家都在想:“我是不是要学大模型,不然这饭碗还能保多久?”

我先给出最直接的答案:一定要把现有的技术和大模型结合起来,而不是抛弃你们现有技术!掌握AI能力的Java工程师比纯Java岗要吃香的多。

即使现在裁员、降薪、团队解散的比比皆是……但后续的趋势一定是AI应用落地!大模型方向才是实现职业升级、提升薪资待遇的绝佳机遇!

这绝非空谈。数据说话

2025年的最后一个月,脉脉高聘发布了《2025年度人才迁徙报告》,披露了2025年前10个月的招聘市场现状。

AI领域的人才需求呈现出极为迫切的“井喷”态势
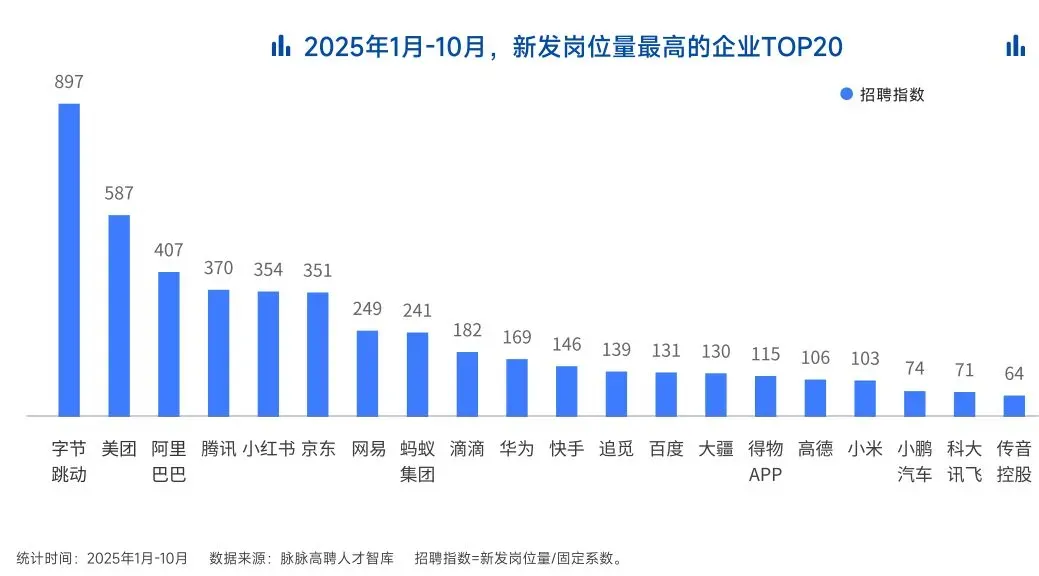
2025年前10个月,新发AI岗位量同比增长543%,9月单月同比增幅超11倍。同时,在薪资方面,AI领域也显著领先。其中,月薪排名前20的高薪岗位平均月薪均超过6万元,而这些席位大部分被AI研发岗占据。

与此相对应,市场为AI人才支付了显著的溢价:算法工程师中,专攻AIGC方向的岗位平均薪资较普通算法工程师高出近18%;产品经理岗位中,AI方向的产品经理薪资也领先约20%。

当你意识到“技术+AI”是个人突围的最佳路径时,整个就业市场的数据也印证了同一个事实:AI大模型正成为高薪机会的最大源头。

最后

我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。

我整理出这套 AI 大模型突围资料包【允许白嫖】:

  • ✅从入门到精通的全套视频教程

  • ✅AI大模型学习路线图(0基础到项目实战仅需90天)

  • ✅大模型书籍与技术文档PDF

  • ✅各大厂大模型面试题目详解

  • ✅640套AI大模型报告合集

  • ✅大模型入门实战训练

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

①从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点

在这里插入图片描述

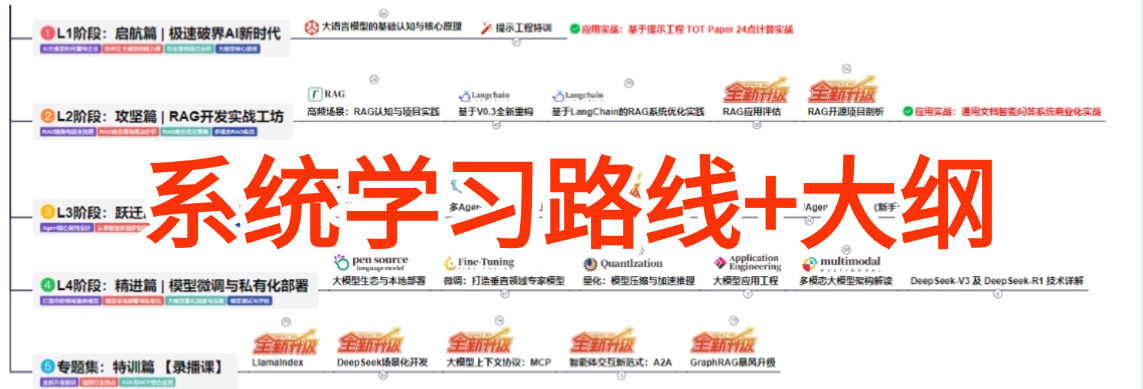
② AI大模型学习路线图(0基础到项目实战仅需90天)

全过程AI大模型学习路线
在这里插入图片描述

③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

④各大厂大模型面试题目详解

在这里插入图片描述

⑤640套AI大模型报告合集

在这里插入图片描述

⑥大模型入门实战训练

在这里插入图片描述

👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

在这里插入图片描述

SpringBoot+Vue+MySQL 高校学科竞赛平台 完整可运行版(源码+文档) 本项目基于SpringBoot+Vue+MySQL构建高校学科竞赛管理平台,覆盖学生、教师、领队教师、管理员四大角色,实现竞赛发布、报名、刷题、评分、公示等全流程闭环管理。系统架构清晰,技术主流,配套完整源码、数据库脚本、万字论文、开题报告、答辩PPT及部署文档,支持一键运行,适用于毕业设计、课程设计及院系二次开发,真正实现“开箱即用”。 阅读详情

相关推荐

HI3403烧录全流程:从ToolPlatform安装到eMMC配置避坑指南

本文详细介绍了海思HI3403芯片的完整烧录流程,涵盖从ToolPlatform工具安装、驱动配置到eMMC分区策略的实战指南。文章深入解析了BurnTool工具的使用方法、关键配置项,并提供了烧录过程中的常见问题排查与解决方案,旨在帮助开发者高效、稳定地完成HI3403嵌入式系统的部署。

weixin_29279101的博客 333

InnoDB 内存结构总览:Change Buffer、AHI 与 Log Buffer

本文系统梳理InnoDB内存结构中的ChangeBuffer、Adaptive Hash Index(AHI)与LogBuffer。ChangeBuffer缓存二级索引页不在内存时的变更,减少随机IO,仅在页加载时合并;聚簇索引修改立即执行,因数据本身不可延后。AHI基于高频等值查询自动构建哈希索引,加速定位,仅支持等值操作。LogBuffer为redo log内存缓冲,配合磁盘日志实现崩溃恢复。三者均服务于性能优化,其中ChangeBuffer与AHI共享BufferPool空间,而LogBuffer独立

bksczm的博客 284

MySQL服务启动失败?手把手教你排查NET HELPMSG 3534错误(附完整修复流程)

本文针对Windows平台上MySQL服务启动失败并提示NET HELPMSG 3534错误的常见问题,提供了系统性的排查与修复指南。文章深入剖析了错误本质,并手把手教你通过查看MySQL错误日志、检查并初始化数据目录、修正Windows服务配置、排查my.ini配置文件陷阱等核心步骤,彻底解决这一棘手问题,帮助开发者和运维人员快速恢复数据库服务。

wdx0123456的博客 894

V8 机制、手写核心函数与 TypeScript 类型体操

或固定初始化(如数组先定长、对象先给全字段)保持类型与形状稳定;这些都比"换框架"更基础。只能处理纯数据(丢函数、Date、RegExp、循环引用报错)。生产级深拷贝要处理:原始值短路、循环引用、V8(Chrome / Node 的 JS 引擎)不是"解释一行跑一行"那么简单,它用。图:V8 执行流程——解释执行 + 热点优化,优化失败会 Deopt 回退。JS 内存自动管理,但"自动"不等于"不会漏"。是"固定间隔最多执行一次"。手写 Promise 是"懂异步"的试金石。是"停下后才执行最后一次",

qq_38468358的博客 346

记录一次小项目中的重放攻击与解决方案

文章目录1、重放攻击简介2、重放攻击演示3、解决方案4、重放攻击验证 欢迎各位 前(提)来(出)讨(意)论(见)。 1、重放攻击简介 重放攻击(Replay Attacks)又称重播攻击、回放攻击,是指攻击者发送一个目的主机已接收过的包,来达到欺骗系统的目的,主要用于身份认证过程,破坏认证的正确性。 举个简单的小例子。 我们往系统里面插入一条数据,如果此次操作的数据包被攻击者获取,又恰巧后台没有对重复内容进行验证,那么攻击者就可以利用该数据包重复的发起请求,无限制的往数据库插入数据,即使请求包是加密的也

fiveSix 8726

基于FPGA的时间数字转换(TDC)设计(五:基于Carry4的高精度TDC设计)

基于FPGA的时间数字转换(TDC)设计,此为第五篇:基于Carry4的高精度TDC设计。提供工程文件及MATLAB测试分析代码

sdau2005的博客 8801

Spring Boot 数据源与 MyBatis(-Plus) 自定义配置详解

本文详解 Spring Boot 中单数据源环境下 HikariCP 与 MyBatis-Plus 的自定义配置。通过手动声明 SqlSessionFactory,实现下划线转驼峰、日志输出、一级缓存策略等精细化控制。结合 HikariCP 核心参数调优(如最大连接数、连接生命周期),确保高性能与稳定性。适用于仅需访问单一数据库的场景,避免多数据源复杂性,兼顾性能与可维护性。

BADAO_LIUMANG_QIZHI的博客 197

通过Python实现物联网金橙子自动打标

对于自家公司使用金橙子打标卡时,为了与生产线或者PLC联动等,往往需要对金橙子打标卡进行二次开发,而在二次开发中不得不涉及到MarkEzd.dll这个文件,而这个dll文件网上版本多不说,一般都没法直接使用,最后还不得不花大价钱购买专用库。而本文针对这个问题,涉法通过python来绕过MarkEzd.dll文件,直接进行自动化控制EzCad来实现联动,可应用于实际生产。文章最后拓展一下以物联网的形式,实现手机平台等登录网页,输入想要的印字内容后,远程打印的案例。

lylelo的博客 3365

Java EE 进阶:8.MyBatis 操作数据库(入门)(第一弹)

Java EE 进阶:8.MyBatis 操作数据库(入门)(第一弹)

要努力去发光,而不是被照亮~ 126

TC8:SOMEIPSRV_SD_MESSAGE_07-09

TTL为服务实例的生命周期。在此生命周期之后,不提供服务实例。

jasonj333 908

【FPGA教程案例55】深度学习案例2——基于FPGA的CNN卷积神经网络之ReLu激活层verilog实现

在本课程中,我们将对CNN的ReLu函数模块的FPGA实现做详细的介绍和学习。从仿真结果可知,通过Rule激活函数之后,小于的输入数据输出为0,否则输出是输入本身。,我们对CNN的基本原理有了初步认识。ReLu函数具备如下优缺点。按照课程1相似的操作方式。

FPGA/MATLAB学习教程/源码/项目合作开发 2693

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 493

【MTK平台】【wpa_supplicant】关于wpa_supplicant/p2p_supplicant.c文件的介绍

本文主要介绍external/wpa_supplicant_8/wpa_supplicant/p2p_supplicant.c 这个文件这个文件里面有个核心的方法就是。

专业开发者的博客,一个从事Android WiFi和蓝牙的工程师 725

LeetCode Hot 100 二叉树专题(二)3 题(Java)

本篇文章共 3 题:543. 二叉树的直径、102. 二叉树的层序遍历、108. 将有序数组转换为二叉搜索树。 每道题都统一按「① 题目分析 & 解题思路 → ② 常见解法(附代码)及讲解 → ③ 知识点总结」的顺序组织;代码使用 Java 编写,节点定义沿用 LeetCode 默认的 TreeNode。

2401_88612756的博客 365

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

JDK 下载安装:装完 Java 提示「不是内部或外部命令」?环境变量没配

JDK 是写 Java 程序必须装的东西。它包含运行 Java 的虚拟机(JRE)和编译 Java 的编译器(javac)——装了它,能跑、.java文件能编译成可执行程序。免费,学习和小规模生产都不花钱。

科小怪的博客 631

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

java框架大全

java框架大全

qq_39326137的博客 183

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Java 多态 学习笔记

多态是面向对象编程的重要特性,指同一操作作用于不同对象时产生不同行为。其核心在于“父类引用指向子类对象”,结合方法重写实现运行时动态绑定。多态使代码更灵活、可扩展,如用Person p = new Student();统一处理各类人员注册,无需修改调用逻辑。但多态无法直接调用子类特有方法,需通过instanceof判断并强制转换。编译时看左边(类型),运行时看右边(实际对象),实现解耦与维护便利。

AA_AA114514的博客 359

SecureRandom做随机源,这个Java随机字符串工具类有3个方法

本文分享一款JDK17环境下的Java随机字符串工具类,内置3个开箱即用的方法,全部采用SecureRandom加密安全随机源,不存在弱随机、可预测、取模偏差等问题。工具类支持默认62字符集随机串、纯数字随机串、自定义字符集随机串三种生成模式,支持Unicode码点级别的字符集处理,兼容Emoji等增补字符,边界处理严格,异常信息明确,适合验证码、邀请码、盐值、随机口令、短链码等场景,源码可直接复制使用。

Java后端 | AI智能体应用实战派 | 电脑技能行家 298

IDEA 简介:从零认识 IntelliJ IDEA

IDEA 全称,是由 JetBrains 公司开发的一款主流 Java 集成开发环境(IDE)。它集代码编辑、编译、调试、测试、版本控制、构建管理等功能于一体,被大量 Java 开发者视为日常开发的首选工具。所谓 IDE(Integrated Development Environment,集成开发环境),就是把写代码所需的各类工具整合到同一个界面中。相比只用文本编辑器加命令行编译,IDE 能显著减少重复操作,让开发者把精力集中在业务逻辑上。

ztI10的博客 149

Java实现批量线段相交检测(跨积判定+扫描线优化与踩坑复盘)

【代码】Java实现批量线段相交检测(跨积判定+扫描线优化与踩坑复盘)

m0_64476639的博客 328

ubuntu安装hadoop系统

本文详细介绍了基于VMware克隆虚拟机搭建三节点Hadoop分布式集群的全过程:使用同一Ubuntu镜像克隆出master、worker1、worker2三台虚拟机,依次配置主机名、固定IP(如192.168.82.10/11/12)、SSH服务及免密登录,确保节点间网络互通。随后安装Java,下载配置Hadoop并分发至各节点,最终初始化启动集群,验证其存储与计算功能,实现高效的大数据环境部署。

qq_43592674的博客 330

TRingBuffer两端都能增删(快递站版)

TRingBuffer 是一个支持两端增删、下标访问且容量动态增长的环形双端队列。它通过无符号索引的永不归零设计,利用减法自动模运算实现空满判断与元素计数,避免了传统环形缓冲浪费格子的问题。内部以票号(索引)标记首尾,扩容时重排元素为连续存储,保证 O(1) 操作与高缓存效率。虽不线程安全,但其高效性使其成为游戏开发中事件队列、命令缓冲等场景的理想选择。

u013768914的博客 224

Mac上装了最新版本的Android Studio,但是没找到jdk的设置选项也没找到jbr的目录

新版Android Studio(2025.3.1+)因三项变更导致常见问题:一、JDK设置移至“DaemonJVM criteria”,新项目默认自动探测或下载JDK;二、JBR目录改名为带版本号的jbr-21等,需进入.app/Contents/查看,或通过About窗口确认运行时;三、命令行缺adb因platform-tools未加入PATH,需在SDK Manager中勾选并配置~/.zshrc中的ANDROID_HOME及PATH。重装或清理残留可解决缺失问题,切勿手动设JAVA_HOME或安装冲

Programming is a highly artistic endeavor 351

Spring事务和事务传播机制

3. 可重复读(REPEATABLE READ): 事务不会读到其他事务对已有数据的修改, 即使其他事务已提交. 也就可以确保同⼀事务多次查询的结果⼀致, 但是其他事务新插⼊的数据, 是可以感知到的. 这也就引发了幻读问题. 可重复读, 是 MySQL 的默认事务隔离级别.p1事务可以认为是⽗事务, 嵌套事务是⼦事务. ⽗事务出现异常, ⼦事务也会回滚, ⼦事务出现异常, 如果不进⾏处理, 也会导致⽗事务回滚.

txxzjmzlh的博客 205

Java Arrays.asList 常见坑详解|UnsupportedOperationException、数组联动、基本类型 bug

解析 Arrays.asList 常见开发陷阱,演示 UnsupportedOperationException、底层数组引用共享、基本类型数组问题,区分 Arrays 内部 ArrayList 与 java.util.ArrayList,给出数组转 List 的各种场景正确代码。

weixin_42617033的博客 472

读懂 Dart Future:从 async/await 到并发等待

Dart 中的 Future 用于处理异步操作,如网络请求、文件读取等。它表示一次可能延迟完成的计算,成功时返回指定类型值(如 Future<String>),失败时抛出异常。通过 async/await 可以同步式编写异步代码,提升可读性。await 暂停当前函数执行,但不影响事件循环。Future.wait() 可并发等待多个异步任务,timeout() 设置超时限制,catchError() 处理错误。注意:async 不自动开启新线程,耗时计算仍可能阻塞主线程;避免丢弃未处理的 Future,必要时

侯仕奇的博客 355
上一篇: 避开99%的认知陷阱:一张图给小白和程序员讲透大模型(LLM)核心,没弄懂别往下学!
下一篇: RLLaVA开源!一个专为多模态大模型设计的强化学习框架!
Agent学习路线
博客等级 码龄6年 1万+粉丝 1902原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值