


一、前言
MCP 让 LLM “看起来”具备了调用外部程序的能力,进而能够完成一些自动化工作,如自动获取上下文、操作文件系统等。而本篇文章主要介绍 RAG 在 LLM 中的作用,与 MCP 相同的是,RAG 也能够让 LLM “看起来”可以自动获取外部信息,进而增强其上下文;不同的是,MCP 更偏向于工具调用,由于可以调用各种不同的工具,因此其用途会更加广泛。而 RAG 更偏向于知识检索,可以从数据库中检索出与问题相关联的知识,来增强 LLM 的上下文信息,相当于一个增强知识的工具。
本篇文章将基于 RAG 的背景、原理,以及其在 Spring AI 框架下的实践展开介绍。
二、概述
2.1 背景
目前 LLM 生成的内容都是基于其训练时已知的信息,其无法访问外部的信息,因此无法回答训练数据以外的内容。例如,我们提出了一个问题,而这个问题是关于某个内部文档的,那么 LLM 就很有可能一本正经的胡说八道,这种情况称为大模型的幻觉。针对幻觉问题,我们可以把文档的内容和问题一起发送给 LLM,这样 LLM 就具有充足的上下文来回答问题。但是,当文档十分庞大时,与问题有关联的上下文可能只是文档中的某一小段话,这时候 LLM 就很可能无法准确找到重点,于是又胡乱地回答问题。那此时我们可能又想到一种解决方案,就是不把整个文档都发送给 LLM,而只发送与问题相关联的几段话给它,这个动作由我们人工来完成会显得很低效,因此需要一个具备“检索”能力的工具来帮我们找出与问题相关度最高的上下文,并将其交给 LLM,实际上 RAG 解决的正是这个问题。
2.2 RAG
RAG(Retrieval Augmented Generation),即检索增强生成,其核心思想是在 LLM 回答之前,先通过检索系统从外部知识库找出与问题相关的内容,然后将这些内容与原始问题一起输入到 LLM 中。
结合了 RAG 的 LLM 在回答内容时的大致流程如下所示:

(1)用户提出问题。
(2)检索系统搜索知识库中与问题相关联的内容。
(3)知识库返回相关知识给检索系统。
(4)检索系统将问题、相关知识都发送给 LLM。
(5)LLM 生成回答内容并展示给用户。
2.3 Embedding
基于上面的流程,我们不难发现这里会存在几个关键的问题:
(1)如何高效地检索出与问题相关联的知识内容?
(2)知识库采用何种方式存储知识,是采用关系型数据库直接存储,还是采取其他方式?
针对第一个问题,RAG 引入一种新的模型,称为 Embedding 模型,其输入是一段文字,而输出是一个固定长度的浮点型数组,例如 OpenAI 的 text-embedding-3-small 模型,其输出的数组长度为 1536,而 text-embedding-3-large 模型输出的数组长度为 3072。内容越相似,其经过 Embedding 模型生成的数组则也会越相似,因此我们可以通过数组之间的距离来判断两段文字的相似程度。
这就类似于我们以往在学校中学习过的坐标系,输出的数组也可以映射在一个很大维数的坐标系中的某个点,例如 1536 维坐标系中的某个点,而我们可以通过两个点的距离来判断其相似程度(相关计算方式在原理部分会介绍),这里以三维坐标系举例,如下图所示,可以看到越接近的文字,其映射的点也会越接近。

针对第二个问题,传统的关系型数据库存储的是结构化数据,适合于检索精确匹配的数据,而 RAG 中需要进行语义相似度检索,非精确匹配,所以不适用于传统的关系型数据库,因此,RAG 引入向量数据库作为知识库。
向量数据库是一种专门用于存储和检索高维向量数据的数据库,主要用于处理相似性搜索的任务,其可以存储非结构化数据(如文本、音频、视频等)经过 Embedding 模型后生成的向量,并可以通过一个给定的向量来迅速找到最相似的若干个向量。向量数据库在存储向量时,不仅会存储向量本身,还会存储其原始文本和元信息(如时间、语言等),来方便通过向量找到其原始文本。目前市面上常用的向量数据库有 Pinecone、Chroma、PostgreSQL + PGVector 等。
三、原理
3.1 工作流程
RAG 的工作流程可以分为离线和在线两个部分:
- • 离线部分:指的是知识准备的过程。我们可以提前上传文档资料,这些文档会经过 Embedding 模型转换为高维向量,然后存储进向量数据库。
- • 在线部分:指的是实时问答的过程。用户提出问题后,问题文本会经过 Embedding 模型转换为高维向量,然后依据这个向量在知识库中找寻最相似的若干个知识片段,之后将知识和问题一起传入 LLM,最后由 LLM 生成答案。
RAG 的完整流程如下图所示。后续也会介绍关键部分的技术原理细节。

3.2 Chunking
Chunking,即分块,指的是将文档分割成若干个片段,文档分割的质量将直接决定了后续检索的准确性和 LLM 回答的效果。在 RAG 中做 Chunking 操作的原因正如前面提到过的,有时与问题相关联的知识片段可能只是文档中的一小部分,如果将所有的文档都交给 LLM,它可能无法马上理解到重点,因此需要先将文档切分成若干个片段,再将每个片段转换成各自的向量。
常见的 Chunking 策略有:
| 名字 | 描述 | 优点 | 缺点 |
|---|---|---|---|
| 固定大小拆分 | 按指定字数或 token 数来切分 | 实现简单、速度块 | 可能会割裂语句,打断语义完整性 |
| 结构拆分 | 基于文档格式(如 Html、Markdown)拆分,本质上是借助这些文档特有的格式来拆分语句 | 可以保留原始文档的结构逻辑,语义完整度高 | 依赖于结构清晰、规范的文档,对于无结构的语句(如纯文本)无法使用 |
| 语义拆分 | 根据语义边界(如段落、句子、主题变化等)拆分,可以采用 NLP 方法,如如分句、主题检测或 Embedding 聚类 | 最符合人类理解,可保留语义一致性 | 实现复杂,需要依赖 NLP 模型、Embedding 计算或聚类等,且计算开销大,效率低 |
| 递归拆分 | 先按大分隔符(如段落)拆分,再按句子等进行拆分,直到拆分得到的块满足长度限制 | 在语义完整性和长度控制两个度量之间保持平衡 | 设计较复杂,需要合适的层级和递归停止条件 |
这些策略可以组合使用,即一类文档可以使用多种策略,但目前没有一种策略适用于所有的文档,因此需要根据情况来选择合适的策略。
3.3 Indexing
在 RAG 中,需要对向量构建索引以便能够高效地计算向量之间的相似程度。向量索引是一种用于高效索引和检索高维向量的数据结构,能帮助我们高效筛选与查询向量最接近的少量数据。
目前常用的构建向量索引的方法是 ANN(Approximate Nearest Neighbor,近似最近邻搜索算法),其能够在牺牲少量准确性的同时,显著提高搜索速度和计算性能,常见的几种实现方式如下:
(1)LSH
LSH(Locality Sensitive Hashing,局部敏感哈希算法),是一种基于哈希结构的算法,其通过设计一种哈希函数族,使得相似的向量被映射到相同哈希桶的概率高,而不相似的概率低。在查询时,只会搜索同一个桶或若干相似的痛中的数据,进而能够避免全表扫描。

(2)Annoy
Annoy 算法是一种基于树结构的算法,其核心思想是构建一棵“随机投影二叉树”,每一棵树就是向量空间划分后的小区域。

算法核心流程如下:
① 在所有向量中随机挑选两个向量,用它们的方向生成超平面,进而来切割向量空间。
② 将所有的向量都投影到这个方向上,得到每个向量在这个方向上的数值。
③ 根据投影值的中位数,把向量空间分成左右两部分(类似于左侧数值小,右侧数值大)
④ 对左右两个空间继续重复上面的过程,直到每个空间的向量数量小于指定阈值,就不再进行划分。
⑤ 每个节点的父节点就是切割前的空间,子节点就是当前空间切割后的左右子空间。
在搜索时,会在每棵树中递归查找与查询向量最接近的叶结点,然后将这些叶结点表示的向量作为候选向量,并计算所有的候选向量与查询向量的实际距离,最后选择距离最近的 k 个向量作为近似最近邻。
(3)HNSW
HNSW(Hierarchical Navigable Small World,分层导航小世界算法),是一种基于图结构的算法,该算法会构建一个分层图的结构,每一层都是一个由相互连接的节点组成的可导航小世界网络,图的高层用于快速定位,跳跃大量的无关节点,低层则用于精细搜索近似节点,有点类似于跳表。

(4)IVF
IVF(Inverted File Index,倒排文件索引),是一种基于聚类的算法,通过 k-means 聚类把向量分为多个簇,然后对每个簇建立一个倒排表,存放簇内的所有向量。查询时,会首先找到最近的几个簇,之后就只在这些簇中找到最近邻的向量,进而避免了全局搜索。

从以上四种算法可以看出,ANN 本质上并不保证找出真正最相近的向量,而是找到一个足够接近的向量,以换取更快的搜索速度。原因在于 ANN 中并不是全局搜索,而是在部分候选区域中查找,这样就有概率漏掉实际上最近的向量。而每种算法都有其独特的优势和局限性,目前还不存在一种适用于所有场景的算法,需要权衡性能、准确性和计算资源三个方面。
这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

3.4 Similarity Search
在 RAG 中,需要通过计算向量之间的距离来判断两个向量的相似程度,常见的计算方式有以下几种:
(1)欧几里得距离
用于计算两个向量之间的直线距离,其公式如下:

其优点是简单直观,适合表示距离感的任务,如定位或聚类,但缺点是对长度比较敏感,不适合语义相似的向量,因为有时两个语义相似的向量在长度上会有所差别。
(2)点积
用于直接计算两个向量的乘积之和,其公式如下:

其优点是简单高效,适合于含有权重意义的 Embedding 模型,如推荐场景,原因是它的计算公式的组成如下:
- • ∣A∣:向量 A 的长度。
- • ∣B∣:向量 B 的长度。
- • cos(θ):两个向量的语义方向相似性。
因此,点积不仅可以衡量语义相似性(方向),也可以根据向量的长度进行加权。
(3)余弦相似度
用于计算两个向量之间夹角的余弦值,其公式如下:

其优点是度量与语义方向一致,即两段语义相近的文本,即使它们的长度不同,也会有较高的余弦相似度,因此这种方式在自然语言处理领域很常用。余弦相似度的取值范围为 [-1, 1],越接近 1 表示两个向量越相似。
3.5 Re-ranking
前面介绍了向量索引构建的几种常用算法,而这些算法虽然计算速度快,但牺牲了一些准确性,即最终检索出来的文档虽然相似度高,但实际并不是真正相关,因为“相似度”不等于“相关性”,相似度只是衡量语义是否相似,而不一定对问题有帮助。这里举个例子:
查询:“介绍一下李清照的文学风格”
此时向量相似度高的文档可能有:
(1)文档 A:“李清照是宋代著名女词人,擅长婉约词,情感细腻……”(真正相关)
(2)文档 B:“杜甫是唐代伟大诗人,以沉郁顿挫著称,写了许多反映民生疾苦的诗……”(不相关)
向量模型可能会觉得李清照和杜甫都是古代诗人,属于语义相似的场景,因此文档 B 的相似度也会很高,但这与问题并不相关。
因此这里需要做 Re-ranking 的操作,即重排序,假如我们最终要交给 LLM 的文档数量为 5,那么一般在初步检索阶段,也就是从向量数据库查询相似性靠前的文档时,会检索出数量比 5 大的候选文档集合(如 top-20),然后再进行重排序,此时会使用其他模型对候选文档与查询条件更精细的匹配,选出最相关的 5 个文档。其中重排序模型在文档相关性排序上会更加准确,但计算代价会更高,因此通常只在 top-20 或 top-50 上运行。

3.6 Prompt Template
在 RAG 中,Prompt Template 会将检索到的文档(context)和用户的问题(User Query)组合成一个格式化的 prompt,最终交给 LLM。其最大的好处在于能够让 LLM 更聚焦于上下文,减少幻觉问题,让回答更加稳定和专业。
我们可以根据任务的类型来自定义模板,常见的模板如下:
You are a helpful assistant. Based on the following context, answer the question.

Context:
{retrieved_documents}

Question:
{user_query}

Answer:
3.7 总结
在介绍完 RAG 工作流程中关键部分的技术细节后,再回看一下流程图,整个流程的详细描述如下。

离线部分:
(1)对上传的文档进行分块(Chunking),将文档分割成若干个片段。
(2)使用 Embedding 模型将切分后的片段转换为向量。
(3)将向量存储到向量数据库中,并建立索引(Indexing)。
在线部分:
(1)使用 Embedding 模型将用户问题转换为向量。
(2)在向量数据库中检索出与查询向量最相似的 top-k 个知识片段(Similarity Search)。
(3)对检索出的片段进行重排序,保留最相关的 top-n 个片段(Re-ranking)。
(4)将知识片段与问题组合成一个格式化的 prompt(Prompt Template)。
(5)将 prompt 提交给 LLM,最终得到生成的答案。
四、实践
这里主要讲述使用 Spring AI 框架完成基于 RAG 的应用开发的方式。
4.1 环境说明
| 环境名 | 说明 |
|---|---|
| JDK | 17 |
| SpringBoot | 3.5.0 |
| Spring AI | 1.0.0 |
| 构建工具 | Maven |
| LLM | Qwen2.5-72B-Instruct |
| Embedding | text-embedding-ada-002 |
| 向量数据库 | PostgreSQL + PGVector |
4.2 Embedding
本篇文章使用 OpenAI 的 Embedding 模型完成向量化操作。
pom 依赖:
<dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-starter-model-openai</artifactId></dependency>
配置文件:
spring:
  ai:
    openai:
      base-url: [这里填url]
      api-key: [这里填密钥]
      embedding:
        options:
          model: text-embedding-ada-002 # Embedding 模型
之后就可以注入 EmbeddingModel 的 Bean,并调用相应的 API 完成向量化,代码示例如下:
@Autowired
private EmbeddingModel embeddingModel;

@GetMapping("/embedding")
public void embedding(String input){
    System.out.println("input = " + input);
    float[] embeddings1 = embeddingModel.embed(input);
    System.out.println("length = " + embeddings1.length + ", array = " + Arrays.toString(embeddings1));}
测试结果如下,可以看到文本被转换为了一个 1536 维的向量。

4.3 向量数据库
本篇文章使用 PostgreSQL 配合 PGVector 插件作为向量数据库,插件安装方式可以参考 PGVector-github。
pom 依赖:
<!-- 向量数据库(pgvector) --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-starter-vector-store-pgvector</artifactId></dependency>
配置文件:
spring:
  ai:
    vectorstore:
      pgvector:
        initialize-schema:true# 是否自动初始化 schema
        index-type:HNSW# 最近邻搜索索引类型
        distance-type:COSINE_DISTANCE# 计算向量距离方式
        dimensions:1536# 向量维度
        max-document-batch-size:10000# 单次批量处理的最大文档数
datasource:
    url:jdbc:postgresql://localhost/postgres
    username: [这里填用户名]
    password: [这里填密码]
当 initialize-schema 为 true 时,Spring AI 会自动初始化向量数据库,上面的配置相当于如下的 sql 脚本:
CREATE TABLE IF NOT EXISTS vector_store (id uuid DEFAULT uuid_generate_v4() PRIMARY KEY,
    content text,
    metadata json,
    embedding vector(1536) // 1536 is the default embedding dimension
);

CREATE INDEX ON vector_store USING HNSW (embedding vector_cosine_ops);
然后就可以注入 VectorStore 的 Bean,并调用相应的 API 完成存储向量和寻找最近相似度向量的操作,代码示例如下:
@Autowired
private VectorStore vectorStore;

@GetMapping("/storeVector")
publicvoidstoreVector(@RequestParam List<String> input){
    List<Document> documents = input.stream().map(Document::new).collect(Collectors.toList());
    vectorStore.add(documents);}

@GetMapping("/similaritySearch")
publicvoidsimilarSearch(String input){
    // topK 可以指定搜索出的向量数
    SearchRequestquery= SearchRequest.builder().query(input).topK(2).build();
    List<Document> similarDocuments = vectorStore.similaritySearch(query);Stringresult= similarDocuments.stream()
            .map(Document::getText)
            .collect(Collectors.joining(System.lineSeparator()));
    System.out.println("result:\n" + result);}
注意,在调用 VectorStore 的 add 方法时时,无需自己调用上面提到的 Embedding API,因为 add 方法底层会去调用 Embedding API 将文本转换为向量,因此无需我们手动转换,但是这里一定要提前在 pom 依赖和配置文件中对 Embedding 模型进行配置,否则启动时会报错缺少 EmbeddingModel 的 Bean,如下所示:

这里先调用 /storeVector 存储一些向量,结果如下:

然后再调用 /similaritySearch 搜索最相似的文本,问题是:“小璐的职业是什么”,结果如下,可以看到这里成功搜索出了 2 条最相似的文本。

4.4 ETL
ETL,即 Extract(提取)、Transform(转换)、Load(加载),用于将数据从不同的来源中提取出来,并经过清洗、格式转换等处理后,加载到目标数据库中。在 RAG 中,ETL 的作用就是对数据进行预处理,是从原始数据源到结构化向量存储的流程。
在 Spring AI 中,也提供了 ETL 相关的 API,主要包含三个组件:
- • DocumentReader:完成 Extract 操作,实现了 Supplier
DocumentReader,常用的实现类有 TextReader(处理纯文本文件)、JsoupDocumentReader(处理 HTML 文件)、MarkdownDocumentReader(处理 MarkDown 文件)、PagePdfDocumentReader(处理 PDF 文件) 等。 - • DocumentTransformer:完成 Transform 操作,实现了 Function<List, List>。常用的实现类有 TokenTextSplitter、ContentFormatTransformer 等。
- • DocumentWriter:完成 Load 操作,实现了 Consumer
。常用的实现类有 FileDocumentWriter、各种 VectorStore 类(如本篇文章使用的 PgVectorStore)。
三个组件共同完成 ETL 的流程如下图所示。

这里演示 TextReader、TokenTextSplitter、PgVectorStore 的组合,代码如下所示。
@Autowired
private VectorStore vectorStore;

@GetMapping("/storeVector")
publicvoidstoreVector(@RequestParam List<String> input){
    List<Document> documents = input.stream().map(Document::new).collect(Collectors.toList());
    vectorStore.add(documents);}

@GetMapping("/similaritySearch")
publicvoidsimilarSearch(String input){
    // topK 可以指定搜索出的向量数
    SearchRequestquery= SearchRequest.builder().query(input).topK(2).build();
    List<Document> similarDocuments = vectorStore.similaritySearch(query);Stringresult= similarDocuments.stream()
            .map(Document::getText)
            .collect(Collectors.joining(System.lineSeparator()));
    System.out.println("result:\n" + result);}
这里解释一下 TokenTextSplitter 的几个细节,TokenTextSplitter 使用 CL100K_BASE 编码根据标记计数将文本拆分成块,即按 token 对文档进行切分,tokenizer 编码的标准是 CL100K_BASE,对应于前面 3.2 节讲述的 Chunking。其构造函数的几个参数如下:
- • chunkSize:每个文本块的目标 token 数量,用于控制 chunk 的最大长度,默认 800。
- • minChunkSizeChars:每个文本块中,最少必须包含的字符数(不是 token),用于防止生成非常短、碎片化的文本块,默认 350。
- • minChunkLengthToEmbed:对每个 chunk,只有在长度超过这个值时,才会包含进最终的结果(比如用于 Embedding 向量生成),用于避免处理无意义的超短段,默认 5。
- • maxNumChunks:从一段文本中最多能切出多少个 chunk,默认 1000
- • keepSeparator:是否在分割后保留原始文本中的分隔符,如 \n、空格、句号等,默认 true。
这里由于我的文本内容只包含了 652 个字符,因此这里对参数进行了相应的调整,防止只生成一个文本块,对于不同的文本内容,你可以自行设定这些参数。
生成的结果如下所示。

可以看到,最终这一个文件的内容被分成了 4 个文本块,然后再看向量数据库中对应的结果,如下所示。

4.5 RAG
前面的部分大多数都是对数据的处理(对应于 RAG 的离线部分),还没有涉及到 LLM 的交互,这里讲述 RAG 的在线部分。
pom 依赖:
<!-- RAG --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-advisors-vector-store</artifactId></dependency><!-- RAG --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-rag</artifactId></dependency>
这里为了显示 LLM 交互时的日志,在配置文件中声明了日志级别,如下所示:
spring:
  ai:
    openai:
        base-url: [这里填url]
      api-key: [这里填密钥]
      chat:
        options:
          model:Qwen/Qwen2.5-72B-Instruct# chat 模型# LLM 对话日志
logging:
level:
    org:
      springframework:
        ai:
          chat:
            client:
              advisor:
                DEBUG
LLM Bean 的配置:
  @Bean
public ChatClient chatClient(ChatClient.Builder chatClientBuilder){return chatClientBuilder
      .defaultAdvisors(new SimpleLoggerAdvisor())
      .build();}
实现 RAG 流程代码:
@Autowired
private ChatClient chatClient;

@Autowired
private VectorStore vectorStore;

@GetMapping("/rag")
publicvoidchatWithRag(String input){
    System.out.println("input: " + input);AdvisorretrievalAugmentationAdvisor= RetrievalAugmentationAdvisor.builder()
            .documentRetriever(VectorStoreDocumentRetriever.builder()
                    .similarityThreshold(0.5)
                    .vectorStore(vectorStore)
                    .build())
            .queryAugmenter(ContextualQueryAugmenter.builder()
                    .allowEmptyContext(true)
                    .build())
            .build();Stringresult= chatClient.prompt()
            .advisors(retrievalAugmentationAdvisor)
            .user(input)
            .call()
            .content();
    System.out.println("result: " + result);}
测试结果如下所示,这里由于开启了日志,因此整个整个交互流程都会显示在上面。从结果中还能够看出,Spring AI 在 RAG 中也设置了 Prompt Template(对应于 3.6 节),它不仅将检索到的文档和用户提的问题组合成一个格式化的 prompt,还告诉了 LLM 两条回答的规则,即“如果答案不在上下文中,就说你不知道”、“避免使用“根据上下文……”或“提供的信息……”之类的说法”。
  input: 小璐是谁,他是干什么的
2025-06-12T16:00:04.143+08:00 DEBUG 1183 --- [nio-8080-exec-1] o.s.a.c.c.advisor.SimpleLoggerAdvisor    : request: ChatClientRequest[prompt=Prompt{messages=[UserMessage{content='Context information is below.

---------------------
小璐的职业是做Java开发的
小璐的职业是计算机相关的
小璐,男(/女),一名专注于Java开发的计算机从业者,自大学起便对编程与软件工程抱有浓厚兴趣。凭借对技术的热爱与不断钻研的精神,他逐步走上了专业的开发之路。
大学期间,小璐主修计算机科学与技术,系统学习了数据结构、操作系统、计算机网络、数据库原理、Java编程语言等核心课程。在课程之外,他积极参与各类编程实践与项目开发,多次参加编程竞赛与开发挑战,积累了
力。
除了日常开发工作,小璐也不断关注新技术的发展,积极学习微服务架构、分布式系统、容器化部署(如Docker、Kubernetes)等前沿知识。他相信技术永无止境,持续学习和思考是保持竞争力的关键。
作为一名开发者,小璐不仅追求技术上的成长,也重视团队协作与沟通效率。他乐于帮助他人,愿意分享自己的经验,同时也虚心接受他人的建议。在工作中,他秉持认真负责、追求完美
---------------------

Given the context information and no prior knowledge, answer the query.

Follow these rules:

1. If the answer is not in the context, just say that you don't know.
2. Avoid statements like "Based on the context..." or "The provided information...".

Query: 小璐是谁,他是干什么的

Answer:
', properties={messageType=USER}, messageType=USER}], modelOptions=OpenAiChatOptions: {"streamUsage":false,"model":"Qwen/Qwen2.5-72B-Instruct","temperature":0.7}}, context={rag_document_context=[Document{id='8d730d2c-5d35-4ff2-89c8-6bbacc642dde', text='小璐的职业是做Java开发的', media='null', metadata={distance=0.113830574}, score=0.8861694261431694}, Document{id='768fd0ba-c853-48dd-ad95-01bd0ababce4', text='小璐的职业是计算机相关的', media='null', metadata={distance=0.11950535}, score=0.8804946467280388}, Document{id='b6d0b193-c852-4e8a-9929-2918932a31c0', text='小璐,男(/女),一名专注于Java开发的计算机从业者,自大学起便对编程与软件工程抱有浓厚兴趣。凭借对技术的热爱与不断钻研的精神,他逐步走上了专业的开发之路。
大学期间,小璐主修计算机科学与技术,系统学习了数据结构、操作系统、计算机网络、数据库原理、Java编程语言等核心课程。在课程之外,他积极参与各类编程实践与项目开发,多次参加编程竞赛与开发挑战,积累了', media='null', metadata={charset=UTF-8, source=file.txt, distance=0.16311505}, score=0.8368849456310272}, Document{id='e3578e33-00f7-4e0a-a046-00ae0bdc8482', text='力。
除了日常开发工作,小璐也不断关注新技术的发展,积极学习微服务架构、分布式系统、容器化部署(如Docker、Kubernetes)等前沿知识。他相信技术永无止境,持续学习和思考是保持竞争力的关键。
作为一名开发者,小璐不仅追求技术上的成长,也重视团队协作与沟通效率。他乐于帮助他人,愿意分享自己的经验,同时也虚心接受他人的建议。在工作中,他秉持认真负责、追求完美', media='null', metadata={charset=UTF-8, source=file.txt, distance=0.17335716}, score=0.8266428411006927}]}]2025-06-12T16:00:11.587+08:00 DEBUG 1183 --- [nio-8080-exec-1] o.s.a.c.c.advisor.SimpleLoggerAdvisor    : response: {"result":{"metadata":{"finishReason":"STOP",
      "contentFilters":[],
      "empty":true},
    "output":{"messageType":"ASSISTANT",
      "metadata":{"role":"ASSISTANT",
        "messageType":"ASSISTANT",
        "refusal":"",
        "finishReason":"STOP",
        "index":0,
        "annotations":[],
        "id":"0197632746fcc873321a1dc9b0fabbcb"},
      "toolCalls":[],
      "media":[],
      "text":"小璐是一名专注于Java开发的计算机从业者。他在大学期间主修计算机科学与技术,系统学习了数据结构、操作系统、计算机网络、数据库原理、Java编程语言等核心课程,并积极参与编程实践与项目开发。在工作中,他不仅专注于技术成长,还重视团队协作与沟通效率。"}},
  "metadata":{"id":"0197632746fcc873321a1dc9b0fabbcb",
    "model":"Qwen/Qwen2.5-72B-Instruct",
    "rateLimit":{"requestsLimit": null,
      "requestsRemaining": null,
      "requestsReset": null,
      "tokensLimit": null,
      "tokensRemaining": null,
      "tokensReset": null
    },
    "usage":{"promptTokens":330,
      "completionTokens":65,
      "totalTokens":395,
      "nativeUsage":{"completion_tokens":65,
        "prompt_tokens":330,
        "total_tokens":395}},
    "promptMetadata":[],
    "empty":false},
  "results":[{"metadata":{"finishReason":"STOP",
      "contentFilters":[],
      "empty":true},
    "output":{"messageType":"ASSISTANT",
      "metadata":{"role":"ASSISTANT",
        "messageType":"ASSISTANT",
        "refusal":"",
        "finishReason":"STOP",
        "index":0,
        "annotations":[],
        "id":"0197632746fcc873321a1dc9b0fabbcb"},
      "toolCalls":[],
      "media":[],
      "text":"小璐是一名专注于Java开发的计算机从业者。他在大学期间主修计算机科学与技术,系统学习了数据结构、操作系统、计算机网络、数据库原理、Java编程语言等核心课程,并积极参与编程实践与项目开发。在工作中,他不仅专注于技术成长,还重视团队协作与沟通效率。"}}]}
result: 小璐是一名专注于Java开发的计算机从业者。他在大学期间主修计算机科学与技术,系统学习了数据结构、操作系统、计算机网络、数据库原理、Java编程语言等核心课程,并积极参与编程实践与项目开发。在工作中,他不仅专注于技术成长,还重视团队协作与沟通效率。
4.6 完整代码
pom 依赖:
<dependencies><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter</artifactId></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-test</artifactId><scope>test</scope></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-web</artifactId></dependency><!-- RAG --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-advisors-vector-store</artifactId></dependency><!-- RAG --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-rag</artifactId></dependency><!-- OpenAI --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-starter-model-openai</artifactId></dependency><!-- 向量数据库(pgvector) --><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-starter-vector-store-pgvector</artifactId></dependency></dependencies><dependencyManagement><dependencies><dependency><groupId>org.springframework.ai</groupId><artifactId>spring-ai-bom</artifactId><version>1.0.0</version><!-- spring-ai 版本 --><type>pom</type><scope>import</scope></dependency></dependencies></dependencyManagement>
配置文件:
spring:
  ai:
    openai:
      base-url: [这里填url]
      api-key: [这里填密钥]
      chat:
        options:
          model:Qwen/Qwen2.5-72B-Instruct# chat 模型
      embedding:
        options:
          model:text-embedding-ada-002# Embedding 模型
    vectorstore:
      pgvector:
        initialize-schema:true# 是否自动初始化 schema
        index-type:HNSW# 最近邻搜索索引类型
        distance-type:COSINE_DISTANCE# 计算向量距离方式
        dimensions:1536# 向量维度
        max-document-batch-size:10000# 单次批量处理的最大文档数
datasource:
    url:jdbc:postgresql://localhost/postgres
    username: [这里填用户名]
    password: [这里填密码]# LLM 对话日志
logging:
level:
    org:
      springframework:
        ai:
          chat:
            client:
              advisor:
                DEBUG
Java 代码:
import org.springframework.ai.chat.client.ChatClient;import org.springframework.ai.chat.client.advisor.SimpleLoggerAdvisor;import org.springframework.context.annotation.Bean;import org.springframework.context.annotation.Configuration;

@Configuration
publicclassAIConfig {

    @Bean
    public ChatClient chatClient(ChatClient.Builder chatClientBuilder){return chatClientBuilder
                .defaultAdvisors(newSimpleLoggerAdvisor())
                .build();}}

@RestController
publicclassQwenController {

    @Autowired
    private ChatClient chatClient;

    @Autowired
    private EmbeddingModel embeddingModel;

    @Autowired
    private VectorStore vectorStore;

    @Value("classpath:/file.txt")
    private Resource resource;

    @GetMapping("/embedding")
    publicvoidembedding(String input){
        System.out.println("input = " + input);
        float[] embeddings1 = embeddingModel.embed(input);
        System.out.println("length = " + embeddings1.length + ", array = " + Arrays.toString(embeddings1));}

    @GetMapping("/storeVector")
    publicvoidstoreVector(@RequestParam List<String> input){
        List<Document> documents = input.stream().map(Document::new).collect(Collectors.toList());
        vectorStore.add(documents);}

    @GetMapping("/similaritySearch")
    publicvoidsimilarSearch(String input){
        // topK 可以指定搜索出的向量数
        SearchRequestquery= SearchRequest.builder().query(input).topK(2).build();
        List<Document> similarDocuments = vectorStore.similaritySearch(query);Stringresult= similarDocuments.stream()
                .map(Document::getText)
                .collect(Collectors.joining(System.lineSeparator()));
        System.out.println("result:\n" + result);}

    @GetMapping("/etl")publicvoidetl(){
        // extract
        TextReadertextReader=newTextReader(this.resource);
        List<Document> extractedDoc = textReader.read();
        System.out.println("extract result: " + extractedDoc);
        // transform
        TokenTextSplittersplitter=newTokenTextSplitter(200, 200, 5, 10000, true);
        List<Document> transformedDoc = splitter.apply(extractedDoc);
        System.out.println("transform length = " + transformedDoc.size() + ", result: " + transformedDoc);
        // load
        vectorStore.add(transformedDoc);}

    @GetMapping("/rag")
    publicvoidchatWithRag(String input){
        System.out.println("input: " + input);AdvisorretrievalAugmentationAdvisor= RetrievalAugmentationAdvisor.builder()
                .documentRetriever(VectorStoreDocumentRetriever.builder()
                        .similarityThreshold(0.5)
                        .vectorStore(vectorStore)
                        .build())
                .queryAugmenter(ContextualQueryAugmenter.builder()
                        .allowEmptyContext(true)
                        .build())
                .build();Stringresult= chatClient.prompt()
                .advisors(retrievalAugmentationAdvisor)
                .user(input)
                .call()
                .content();
        System.out.println("result: " + result);}}
五、展望
RAG 作为一种融合外部知识与 LLM 强大生成能力的技术路径,正在成为企业内各种 AI 应用的解决方案,它在增强 LLM 的专业性、个性化能力上展现出了巨大潜力,我相信随着技术的不断演进,以及框架能力的不断完善,RAG 将在更多真实场景中发挥重要的作用。
最后唠两句
为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选
很简单,这些岗位缺人且高薪
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
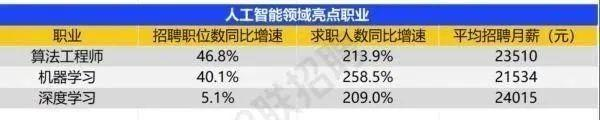
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
那0基础普通人如何学习大模型 ?
深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。
我整理出这套 AI 大模型突围资料包【允许白嫖】:
-
✅从入门到精通的全套视频教程
-
✅AI大模型学习路线图(0基础到项目实战仅需90天)
-
✅大模型书籍与技术文档PDF
-
✅各大厂大模型面试题目详解
-
✅640套AI大模型报告合集
-
✅大模型入门实战训练
这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
② AI大模型学习路线图(0基础到项目实战仅需90天)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
 278


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


