玩转 DeepSeek-R1 本地部署+知识库搭建+多轮RAG,保姆级教程!

本地部署Deepseek R1,并利用本地知识库创建RAG 巧用 Ollama,本地部署 DeepSeek R1 构建智能聊天新体验。 阅读详情

前言

最近,深度求索开源的 DeepSeek-R1 系列模型火遍全球,但因为“服务器繁忙”劝退不少人。为了解决这个问题,我们将以 UltraRAG 框架为例,为大家介绍 DeepSeek-R1 的本地部署流程,同时带领大家熟悉 UltraRAG 的细节和功能。在成功跑通 VanillaRAG 后,我们还简单尝试了在 DeepSeek-R1 加持下的 Adaptive-Note,提出法律领域的问题,效果居然出乎意料地好,有截图为证:
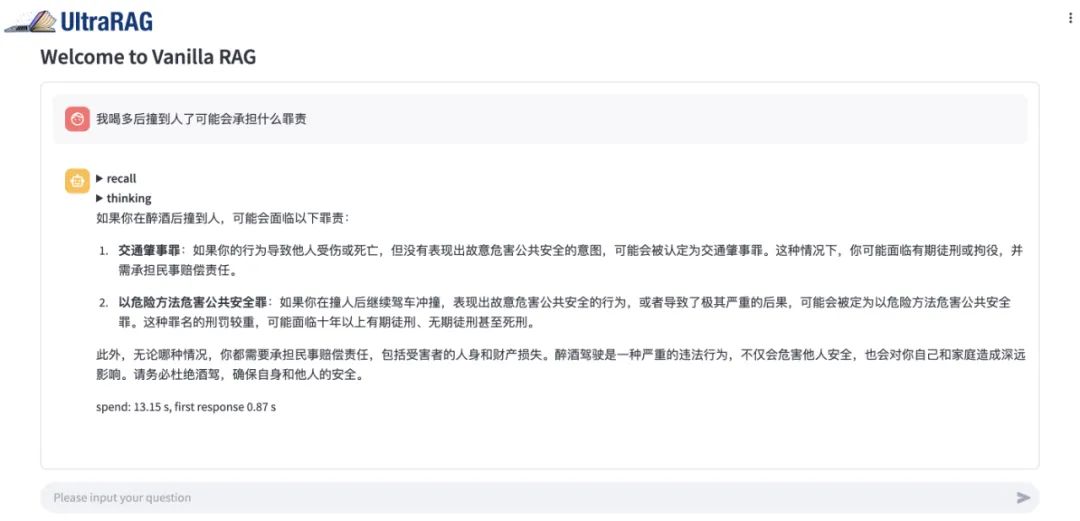
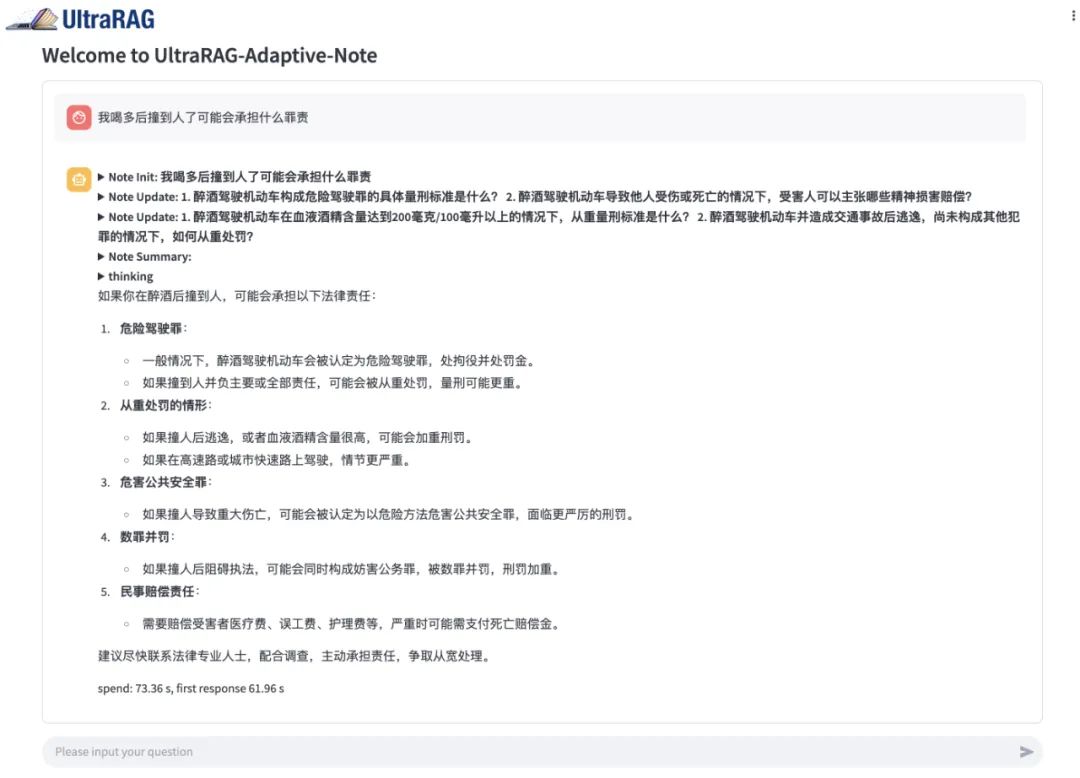
如上图,在 UltraRAG 上对 VanillaRAG 和 Adaptive-Note 分别提问“我喝多后撞了人可能会承担什么罪责?”VanillaRAG 简单直接,分别列出了罪名和建议,内容全面,但是稍微有点不够细致。再看看 Adaptive-Note 的回答,不光总结了可能的几点罪名,并且分析了酒精含量和事后处理态度对量刑和赔偿的影响,引经据典,令人信服。整体来看, Adaptive-Note 的回答更加可信。

VanillaRAG:是最基础的 RAG(Retrieval-Augmented Generation,检索增强生成)架构,通常指的是未经优化或改进的标准 RAG 方法。它的基本流程包括:查询构造(Query Formation)、检索(Retrieval)、生成(Generation)

Adaptive-Note: 一种用于复杂问答任务的自适应笔记增强 RAG 方法,采用 检索-记忆(Retriever-and-Memory) 机制, iteratively 收集和优化知识结构。它通过自适应记忆复审和任务导向生成提高知识交互质量,并采用基于笔记的探索终止策略确保信息充分获取,以提升答案质量。论文: https://arxiv.org/abs/2410.08821

看到这里,我猜大家已经迫不及待想要体验 UltraRAG 了,所以接下来我们将手把手详细介绍 UltraRAG 的部署流程。

硬件环境准备

DeepSeek-R1 的模型有多个蒸馏版本,分别是 7B、14B、70B 以及满血的 671B 版本。权衡了条件和效果后,我们选择 14B 的模型进行部署,以下是运行 UltraRAG 的基本硬件要求:
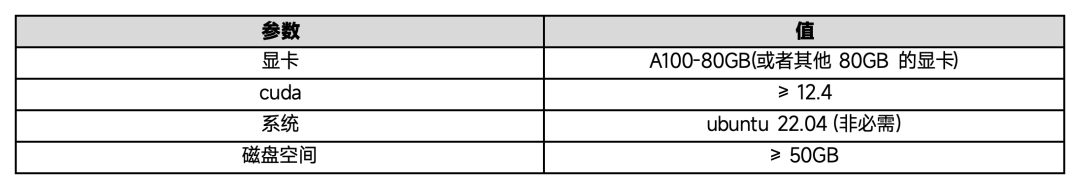
这里需要注意 nvidia 的显卡驱动需要和 cuda 版本兼容,否则 vllm 运行模型有可能出现报错的情况。如果你的显卡出现不兼容的情况,可以尝试重装驱动和 cuda。这里推荐一个简单好用的安装方法,可以有效避免 cuda 和驱动的不兼容问题:登录 nvidia 官方网站(https://developer.nvidia.com/cuda-toolkit-archive),选择适合 cuda-toolkit 版本安装和安装参数(推荐使用 runfile 方式安装,真的简单好用!)。
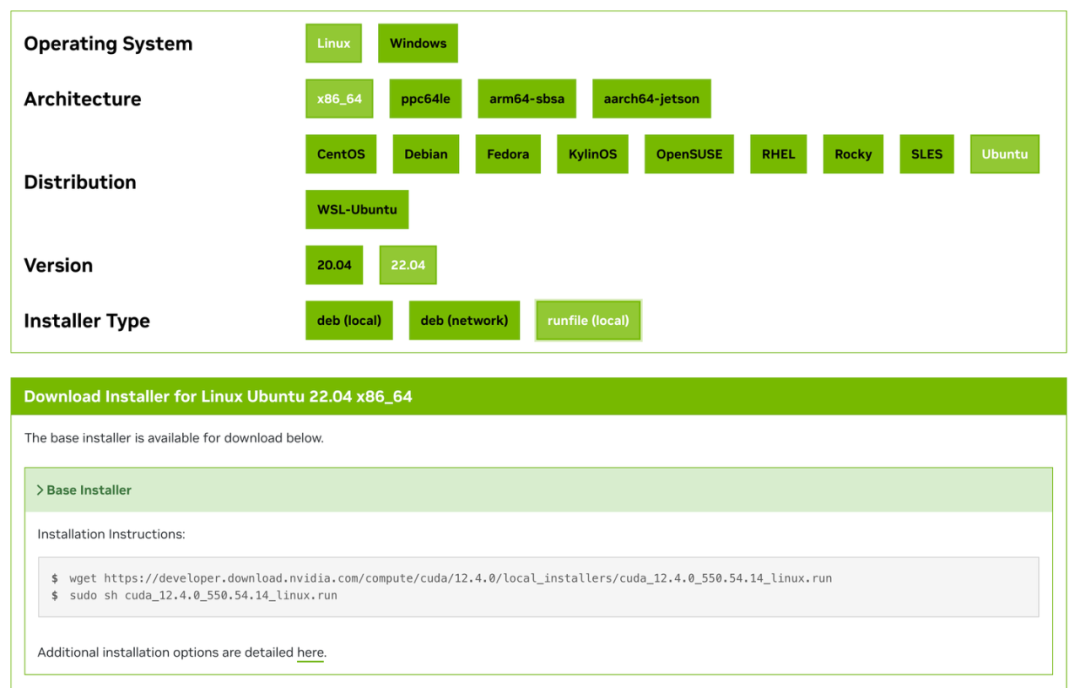
cuda-toolkit参数配置页面

UltraRAG配置

好了,现在你已经拥有了一个稳定的运行环境,可以配置 UltraRAG 了。

运行 UltraRAG 有两种方法,一种通过 docker 运行,这种方式最简单,需要你的机器上已经安装配置好了 nvidia-docker ,并拥有它的运行的权限(一般情况下需要 root 权限)。这种情况下,你只需要执行这行代码就行了:


`docker-compose up --build -d`


如果你的机器上没有 nvidia-docker 也不要紧,可以配置 conda 环境来运行。

要确保你的本地机器安装了 conda,没有的话也可以在这个网址(https://docs.anaconda.com/miniconda/install/)中找到安装的方法,使用普通账户直接安装,几行代码很好执行~
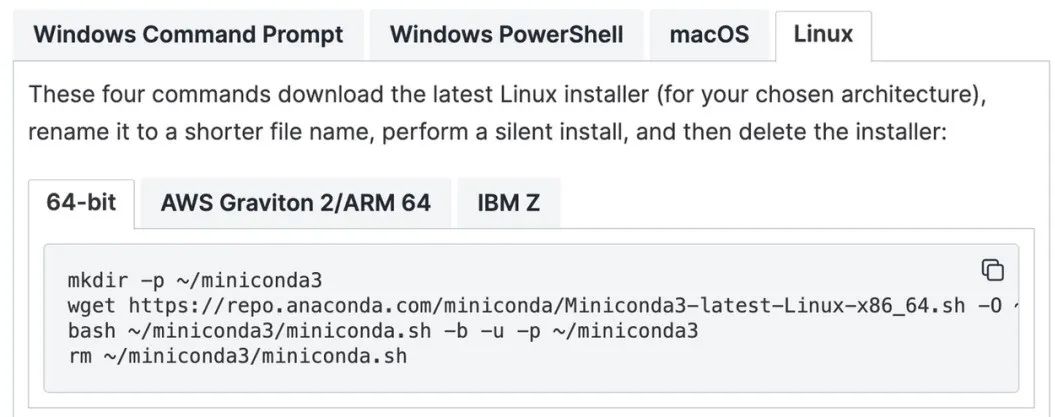
接着,就是在 conda 环境上安装 UltraRAG 的依赖,下面的代码依次执行就好了~


`#创建conda环境conda` `create -n ultrarag python=3.10#激活conda环境conda activate ultrarag安装相关依赖pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple`


以上步骤操作完成之后,环境依赖就准备好了。接下来开始下载模型。

我们需要下载以下 3 个模型,分别执行命令。
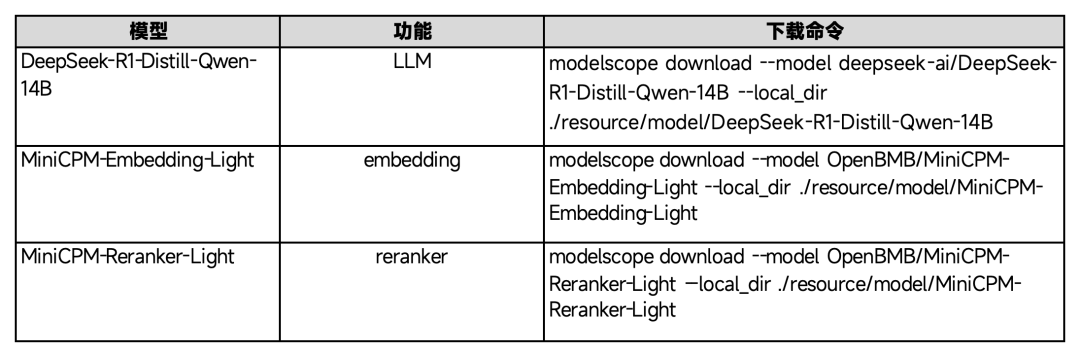
模型下载完成之后,紧接着运行 llm 服务,具体执行这个命令即可~

`vllm serve DeepSeek-R1-Distill-Qwen-14B --gpu-memory-utilization 0.8 --dtype auto --api-key token-abc123`

这里简单说明一下参数的含义:

–gpu-memory-utilization 0.8:表示 GPU 的占用率,显存 80G 时,0.8 意味着最大占用 64GB 的显存。

–dtype auto:表示 vllm 自动选择模型参数类型。

–api-key token-abc123:自定义模型 API 的密钥为 token-abc123。

vllm 服务部署完成后将会启动 OpenAI-Compatibly 的服务,默认参数为:
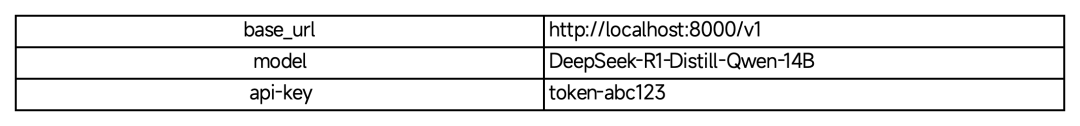
为了常驻后台,你也可以使用以下命令运行:

nohup vllm serve DeepSeek-R1-Distill-Qwen-14B --gpu-memory-utilization 0.8 --dtype auto --api-key token-abc123 &

好了,现在环境搭好了,模型也下载好了,我们现在来运行 UltraRAG :


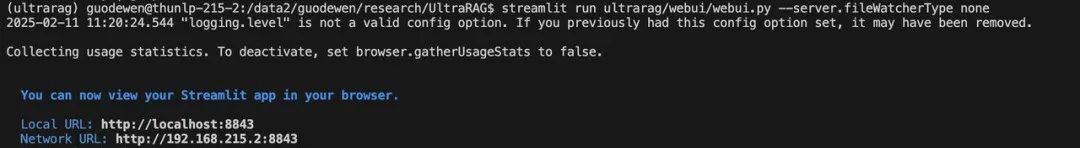
`streamlit run ultrarag/webui/webui.py --server.fileWatcherType none`


如果一切顺利,我们会看到下图的结果。这意味着 WebUI 已经跑起来了,我们把 URL 复制到浏览器,应该就能访问页面了,你可以使用 3 个 URL 中的任何一个进行访问:
什么是 UltraRAG?
UltraRAG 框架由清华大学 THUNLP 联合东北大学 NEUIR 、面壁智能团队及 9#AISoft 团队共同提出,基于敏捷化部署与模块化构造,引入了自动化的“数据构建-模型微调-推理评测”知识适配技术体系,提供了一站式、科研与开发双重友好的 RAG 系统解决方案。UltraRAG 显著简化了 RAG 系统在领域适配过程中,从数据构建到模型微调的全流程,助力科研人员与开发者高效应对复杂任务:
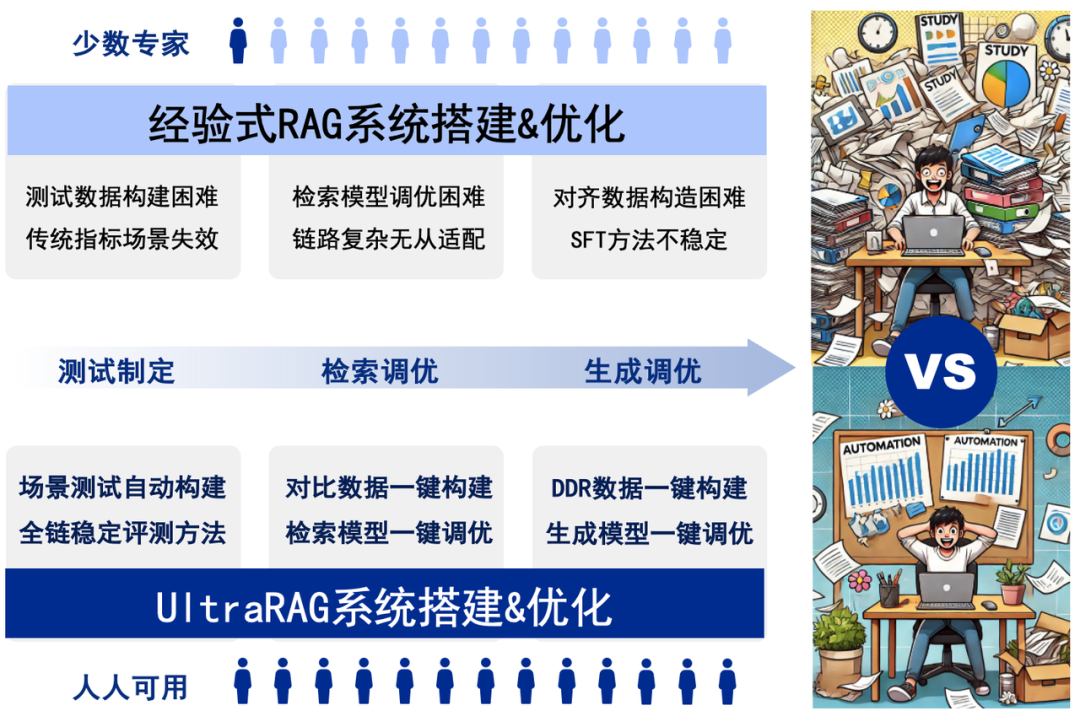
UltraRAG 框架具有以下优势:

零代码编程 WebUI 支持:零编程经验用户亦可上手操作全链路搭建和优化过程,包括多模态 RAG 方案 VisRAG ;

合成与微调一键式解决:以自研 KBAlign、RAG-DDR 等方法为核心,一键式系统化数据构建 + 检索、生成模型多样微调策略支持下的性能优化;

多维多阶段稳健式评估:以自研 RAGEval 方法为核心,融入面向有效/关键信息的多阶段评估方法,显著提升“模型评估”的稳健性;

科研友好探索工作集成:内置 THUNLP-RAG 组自研方法及其他前沿 RAG 方法,支持模块级持续探索与研发。

以上全部功能,都可以直接通过 web 前端快速实现。

最后的最后

感谢你们的阅读和喜欢,作为一位在一线互联网行业奋斗多年的老兵,我深知在这个瞬息万变的技术领域中,持续学习和进步的重要性。

为了帮助更多热爱技术、渴望成长的朋友,我特别整理了一份涵盖大模型领域的宝贵资料集。

这些资料不仅是我多年积累的心血结晶,也是我在行业一线实战经验的总结。

这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。如果你愿意花时间沉下心来学习,相信它们一定能为你提供实质性的帮助。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
DeepSeek全套安装部署资料

在这里插入图片描述

大模型知识脑图

为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

经典书籍阅读

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

在这里插入图片描述

实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

面试资料

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

在这里插入图片描述

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

基于DeepSeek-R1模型实现的RAG训练的AI点餐系统 DeepSeek-R1与RAG技术的结合,不仅重新定义了智能点餐系统的可能性,更展现了开源AI生态在垂直领域落地的巨大潜力。随着强化学习技术的持续突破,我们正在见证餐饮服务业从"数字化"向"智能化"的质变跃迁。 阅读详情

相关推荐

【DeepSeek应用实践】手把手教程:用 AnythingLLM + Ollama + DeepSeek-R1 搭建本地企业知识库

在众多的技术方案中,我们选择了 AnythingLLM、Ollama 和 DeepSeek-R1 这一组合来搭建本地知识库。Ollama 作为一个轻量级的本地化大语言模型部署工具,支持多种模型,易于安装和使用,能够快速在本地运行强大的语言模型。DeepSeek-R1 是一个专为知识库问答设计的检索增强生成(RAG)模型,它结合了检索和生成的优势,能够快速从知识库中检索相关信息并生成精准答案。而 AnythingLLM 则是一个用户友好的界面工具,可以方便地连接 Ollama 和 DeepSeek-R1

寻道AI,探索AI无限可能! 2569

UltraRAG:通过先进技术革新检索增强生成

在自然语言处理(NLP)领域快速发展的背景下,作为一种强大的范式,结合了检索模型和生成模型的优势。RAG 模型通过利用外部知识源来提升生成文本的质量和相关性,使其在问答系统、对话系统和内容生成等任务中表现出色。然而,尽管 RAG 模型取得了显著成功,传统方法仍面临诸多挑战,例如检索效率低下、处理复杂查询的能力有限,以及整合多样化知识源的困难。作为一种下一代框架,突破了传统 RAG 模型的限制。它引入了一系列先进技术,旨在解决上述问题,显著提升检索效率、查询处理能力和知识整合效果。

神探阿航的博客 1599

10分钟训练你的AI歌手:RVC WebUI声音克隆保姆级教程

本文提供了一份详细的RVC WebUI声音克隆保姆级教程,指导用户如何在10分钟内利用Retrieval-based-Voice-Conversion技术训练专属AI歌手。教程涵盖从环境配置、数据准备、模型训练到最终推理应用的全流程,即使是新手也能快速上手,实现高质量的声音克隆与歌曲生成。

weixin_29073241的博客 821

UltraRAG介绍

UltraRAG 框架由清华大学THUNLP联合东北大学NEUIR面壁智能团队及9#AISoft团队共同提出,基于敏捷化部署与模块化构造,引入了自动化的“数据构建-模型微调-推理评测”知识适配技术体系,提供了一站式、科研与开发双重友好的 RAG 系统解决方案。零编程经验用户亦可上手操作全链路搭建和优化过程,包括多模态RAG方案VisRAG;以自研KBAlign、RAG-DDR等方法为核心,一键式系统化数据构建 + 检索、生成模型多样微调策略支持下的性能优化;以自研RAGEval。

puzhinan7781的博客 580

PCIe ATS介绍

主机侧使用IOMMU完成设备地址到物理memory地址的转换,以及设备访问权限的检查。但如果所有PCIe设备都在进行DMA操作,则TA(Translation Agent)和ATPT(Address Translation and Protection Table)则会成为瓶颈,从而影响系统的latency。

maxwell2ic的博客 6023

王道考研操作系统笔记(第一章)附:王道考研408所有PPT和思维导图

学习感想 别人的笔记对你的学习基本上没有用处,容易培养人的惰性,如需ppt和思维导图请拉到最后,有github链接 记笔记并不是一件浪费时间的事情,还有利于多次学习 真心希望大家在学习的过程中记笔记 操作系统 第一章 计算机系统概述 1.1 操作系统 1.1.1 操作系统的概念和功能 概念 操作系统(Operating System, OS)是指控制和管理整个计算机系统的硬件和软件资源,并合理地组织调度计算机的工作和资源的分配;以提供给用户和其他软件方便的接口和环境;它是计算机系统中最基本的系统软

qq_41732756的博客 1万+

【GitHub项目推荐--UltraRAG:低代码RAG框架加速科研创新】⭐⭐⭐

​UltraRAG​ 是清华大学THUNLP实验室、东北大学NEUIR实验室、OpenBMB与AI9stars联合推出的基于Model Context Protocol (MCP)架构的低代码RAG框架。它专为科研人员设计,通过YAML配置文件即可构建复杂的检索增强生成系统,大幅降低RAG系统的实现门槛。🔗 ​GitHub地址🚀 ​核心价值​:RAG框架 · 低代码 · 科研加速 · MCP架构 · 开源免费​项目背景​:​科研需求​:RAG科研实验需求增长​工程复杂度​:复杂RAG系统实现困难。

j8267643的博客 1189

目标检测: 一文读懂 YOLOX

论文:YOLOX: Exceeding YOLO Series in 2021 论文链接:https://arxiv.org/pdf/2107.08430.pdf 代码链接:https://github.com/Megvii-BaseDetection/YOLOX. 文章目录1 为什么提出YOLOX2 YOLOX 网络架构3 YOLOX 实施细节3.1 backbone3.2 neck3.3 Head3.3.1 Decoupled Head3.3.2 Anchor-free3.4 如何计算Loss3.5 如

weixin_46142822的博客 3万+

UltraRAG离线部署:无网络环境下的RAG系统搭建指南

UltraRAG是一款功能强大的RAG(检索增强生成)系统构建工具,支持在无网络环境下实现本地化部署。本文将详细介绍如何在完全离线的环境中搭建和配置UltraRAG,让你轻松拥有属于自己的本地知识库问答系统。 ## UltraRAG离线部署的核心优势 在当今数据安全日益重要的环境下,离线部署RAG系统成为许多企业和个人的首选。UltraRAG提供了完整的本地化解决方案,无需依赖外部网络即可实现

gitblog_01114的博客 663

uniapp无感刷新token实现过程

可以看到已经触发了刷新token接口,并且重新请求上次失败的列表接口,无感刷新token逻辑已经正常,但为什么列表接口请求成功,还一直loading没关闭捏,就是因为后续代码未执行,await接口的返回没有成功resolve。路漫漫其修远兮,前端道路逐渐迷茫,时隔好久好久终于想起了我还有一个小博客,最近在一直在弄uniapp,属实有被恶心到,但也至少会用了,最近实现了一个比较通用的功能,就是无感刷新token,但在过程中发现一个问题就是。3、排查await的列表接口为何没有成功resolve。

weixin_40618068的博客 3594

用 YOLOv11‑Seg 做工地实例分割:从 0 起步到效果调优,真香!

这不是一篇“官方文档翻译”,而是一篇。

weixin_43199439的博客 776

【必学收藏】UltraRAG:基于MCP架构的零代码RAG框架,小白也能轻松构建专业级应用

在 UltraRAG 中,检索器(Retriever)、生成器(Generator)、路由器(Router)等都被封装为独立的 MCP Server。Server 层:每个功能模块都是一个独立的 Python 进程,功能通过函数级的@tool接口暴露。Client 层:负责解析用户的 YAML 配置文件,并根据定义的逻辑调度各个 Server。这种设计的优势在于:开发者只需要编写YAML 配置文件,就能定义包含串行、循环、条件分支的复杂推理流程,真正实现了“配置即代码”。

大模型研究中心 1667

【教程4>第10章>第13节】基于FPGA的图像双边滤波开发——单通道双边滤波Verilog实现

本文介绍了基于Vivado 2022.2的单通道高斯滤波FPGA实现方案。主要内容包括:1)采用3×3窗口像素提取、高斯权值计算、exp指数运算等模块构建双边滤波系统;2)详细分析了Verilog HDL实现的顶层设计文件,包含窗口数据生成、指数计算、混合权重、归一化处理等关键模块;3)展示了图像双边滤波器的RTL结构图。该设计为后续实现RGB三通道图像高斯滤波及MATLAB联合仿真奠定了基础。

FPGA/MATLAB学习教程/源码/项目合作开发 263

离线也能用!DeepSeek-R1与本地化RAG联合,创建你的私有智能文档助手

DeepSeek-R1 自从1-20号开源/发布十天以来,鲶鱼效应应接不暇,OpenAI o3-mini 也在 10个小时前向免费用户推送。官方开源的版本除了满血的 671b 外,还有 1.5b,7b,8b,14b,32b,70b 六个蒸馏后的尺寸,笔者使用 Ollama 在电脑本地部署了 7b 的模型,在终端中测试了虽然回答没有满血版的那么惊艳,但凑活能用。作为一款高阶模型开源,确实要 salute 一下。

m0_63171455的博客 5097

以 Joule 驱动的生成式开发:把需求文档直接变成可运行的 SAP 应用

摘要:SAP BTP的AI助手Joule正在改变开发方式,支持从自然语言描述自动生成数据模型、服务、UI及测试代码。在SAP Business Application Studio中,Joule能根据业务需求生成结构化代码,并提供代码补全、重构、解释等功能。开发者需注意避免上传敏感数据,并对AI生成的代码进行人工审核。Joule特别针对ABAP开发进行了优化,提供符合SAP规范的代码建议,帮助迁移遗留系统。此外,它还能快速生成CAP项目原型,但所有AI生成内容都需经过严格测试验证。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 342

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【2025最新】DeepSeek-R1+Open-WebUI双系统部署全攻略:从Linux到Windows保姆级教程,手把手搭建可视化AI对话平台

DeepSeek-R1+Open-WebUI双系统部署全攻略:从Linux到Windows保姆级教程,手把手搭建可视化AI对话平台

likunxing的博客 3498

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

springai+ollama+deepseek R1+RAG定量数据库本地化部署学习

Spring AI是一个面向人工智能工程的应用框架。它的目标是将Spring生态系统的设计原则(如可移植性和模块化设计)应用于AI领域,并推广使用pojo作为AI领域应用的构建模块。官网:https://ollama.com/1> Ollama是一个用于部署和运行各种开源大模型的工具;【支持78种模型】2> 它能够帮助用户快速在本地运行各种大模型,极大地简化了大模型在本地运行的过程。用户通过执行几条命令就能在本地运行开源大模型,如Llama 2等;

qq_34960590的博客 2435

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

【DeepSeek R1构建本地RAG知识库】RAG十大误区和提高准确率

随着人工智能技术的发展,Retrieval-Augmented Generation(RAG)作为一种结合信息检索与文本生成的技术框架,正逐渐成为许多应用的核心。然而,在实际使用中,开发者们往往会遇到一些常见误区,这些误区可能会显著影响模型的表现。本文将探讨RAG的十大误区,并提供一些实用的建议来提高其准确率。RAG的误区分析:其实小伙伴的很多问题都是对RAG的认知不深引起的。结构化数据:知识库怎么准备数据,结构化是关键部分。问"黑暗森林法则的核心思想" → 返回第三部第200页的早餐描写。

少说,多做 1479

无需联网!DeepSeek-R1+本地化RAG,打造私有智能文档助手

DeepSeek-R1 自从1-20号开源/发布十天以来,鲶鱼效应应接不暇,OpenAI o3-mini 也在 10个小时前向免费用户推送。官方开源的版本除了满血的 671b 外,还有 1.5b,7b,8b,14b,32b,70b 六个蒸馏后的尺寸,笔者使用 Ollama 在电脑本地部署了 7b 的模型,在终端中测试了虽然回答没有满血版的那么惊艳,但凑活能用。作为一款高阶模型开源,确实要 salute 一下。

m0_59164520的博客 3435

【详细教程】本地部署DeepSeek+构建私有知识库+调用大模型API

本文主要介绍了用LMStudio部署大模型,并结合AnythingLLM构建本地知识库,后续简单介绍了如何调用大模型的在线API。

2301_81888214的博客 2627

DeepSeek-R1-Distill-Qwen-1.5B实战教程:集成RAG扩展知识库的本地化改造方案

本文介绍了如何在星图GPU平台自动化部署DeepSeek-R1-Distill-Qwen-1.5B本地智能对话助手镜像,实现完全本地化的智能对话应用。该镜像基于Streamlit驱动,支持多轮对话和逻辑推理,适用于私有化知识问答、代码编写辅助等场景,保障数据安全的同时提供高效交互体验。

GoldenleafHawk37的博客 710
上一篇: 智能体Agent:怎样用自然语言重构数据开发?看完这一篇你就懂了!!
下一篇: 【AI大模型】DeepSeek+dify 本地知识库:真的太香了!收藏这篇就够了!!
Agent学习路线
博客等级 码龄6年 1万+粉丝 1904原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值