


巧用 Ollama,本地部署 DeepSeek R1 构建智能聊天新体验。
微信搜索关注《AI科技论谈》

1 引言
想探索大语言模型,却怕硬件限制?
本教程带你用 Ollama 在 8GB 内存笔记本上部署 Deepseek R1 模型,再结合 LlamaIndex 和 Flask,构建 RAG 聊天机器人。
跟着教程操作,你可以用最少的资源在本地打造 RAG 聊天机器人。它能稳定运行,随时给出精准答案和深刻见解,助力你轻松踏入 AI 应用开发的大门。
2 DeepSeek R1:推理模型新高度
AI飞速发展,创新的脚步从未停歇,推理模型不断打破机器理解和处理复杂查询的极限。
其中,DeepSeek 研发的 DeepSeek R1 推理模型备受行业关注。
DeepSeek R1 创新性地将思维链(Chain of Thought,CoT)推理融入工作流程,旨在提升 AI 生成回复的准确性与透明度。
2.1 DeepSeek R1是什么
DeepSeek R1,也称为deepseek-reasoner,是一款利用思维链(CoT)来提高回复质量的推理模型。
与直接生成答案的传统模型不同,DeepSeek R1在给出最终输出之前,会先生成详细的推理过程(CoT)。这个中间步骤让模型能够“思考”问题,从而得出更准确、更可靠的答案。
该模型在需要逻辑推理、解决问题或多步分析的任务中特别有用。通过让用户能够查看思维链内容,DeepSeek R1还具备了透明度,开发者和用户可以借此了解模型是如何得出结论的。
2.2 DeepSeek R1主要特性
-
思维链(CoT)推理:DeepSeek R1在生成最终答案之前,会生成一个逐步的推理过程。这个思维链内容可以通过API访问,用户能够查看和分析模型的思考过程。
-
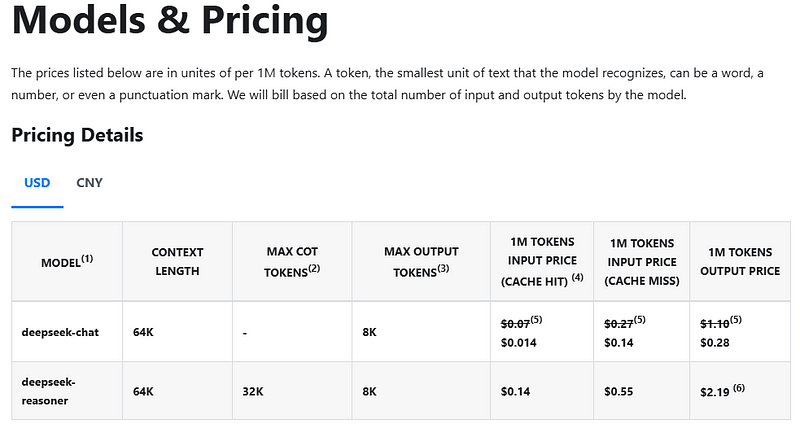
高上下文长度支持:API支持最大64K令牌的上下文长度,这使得它适合处理冗长复杂的查询。值得注意的是,思维链输出(最长32K令牌)不计入这64K的限制内。
-
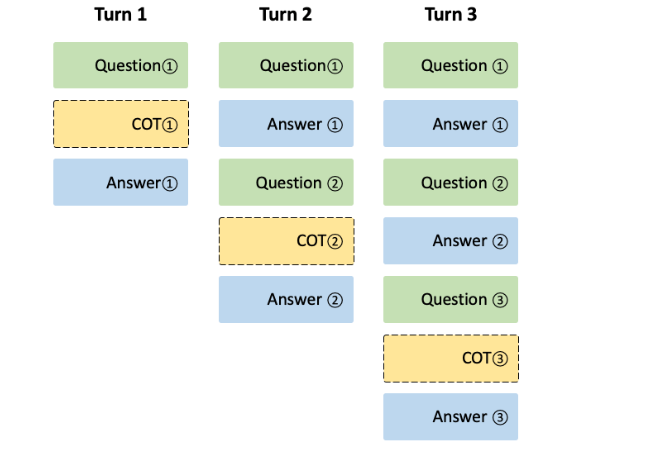
多轮对话:在多轮对话中,DeepSeek R1在每一轮都会输出思维链和最终答案。不过,前一轮的思维链不会延续到下一轮,以确保上下文保持聚焦且易于管理。
-
API集成:DeepSeek R1可通过API访问,便于集成到现有应用程序中。API支持聊天补全和聊天前缀补全(测试版)等功能,但函数调用和JSON输出等功能暂不支持。
2.3 DeepSeek R1工作原理
当你与DeepSeek R1交互时,模型会遵循以下两步流程:
-
生成思维链(CoT):模型首先会生成一个详细的推理过程(CoT),将问题分解为更小的逻辑步骤。这个中间输出会存储在
reasoning_content字段中。 -
生成最终答案:基于思维链,模型生成最终答案,并存储在
content字段中。这确保了回复是经过充分推理且准确的。
例如,如果你向模型提出一个复杂的数学问题,它会先列出解题步骤(思维链),然后再给出最终答案。
2.4 DeepSeek R1 API:参数与用法全解析
要使用DeepSeek R1,你需要与其API进行交互。下面为大家简要梳理其关键参数与使用要点:
- 输入参数:
-
max_tokens:控制最终回复的最大长度。默认值为4K令牌,最大值为8K令牌。注意,思维链输出最长可达32K令牌。 -
reasoning_effort(即将推出):这个参数将允许用户控制思维链输出的长度。
-
- 输出参数:
-
reasoning_content:模型生成的逐步推理过程。 -
content:模型生成的最终答案。
-
- 重要注意事项:
-
API不支持
temperature、top_p、presence_penalty和frequency_penalty等参数。设置这些参数不会触发错误,但对输出没有任何影响。 -
输入消息中不应包含
reasoning_content字段,否则会导致400错误。
-


 4611


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


