


前言
知识图谱(Knowledge Graph,KG)或任何图(Graph)都由节点(Node)和边(Edge)组成。KG 的每个节点代表一个概念,每条边则表示两个概念之间的关系。在本文中,我将分享一种将任意文本语料库转换为“概念图”(Graph of Concepts,GC)的方法。我会交替使用“概念图”(GC)和“知识图谱”(KG)这两个术语,以更准确地描述我的演示内容。
该方法所需的所有组件都可以在本地部署。因此我需要使用较小的开源模型,我选择了强大的 Mistral 7B Openorca instruct 和 Zephyr 模型。这些模型可以使用 Ollama 进行本地部署。
虽然 Neo4j 这类专门的图数据库使存储和检索图数据变得更加便捷。不过,为了简化实现,我这里使用的是****内存中的 Pandas DataFrame 和 NetworkX Python 库。
我们的目标是将任意文本语料库转换为“概念图”(GC)并进行可视化,效果类似于下图。
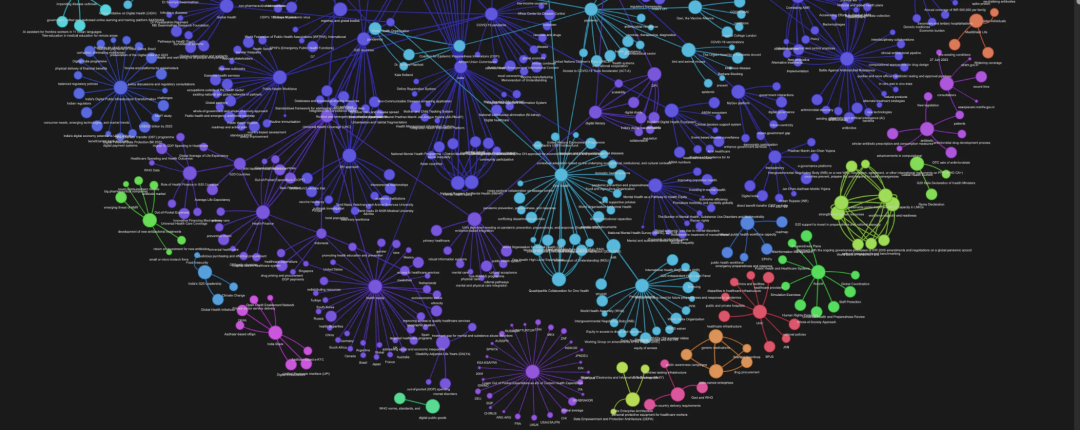
我们甚至可以与图交互,调整节点和边的位置、放大缩小,甚至改变图的物理特性,使其符合我们的需求。
但在开始之前,我们先深入探讨一下知识图谱的基本概念以及它的必要性。如果你已经熟悉这一概念,可以直接跳过下一部分。
知识图谱
知识图谱(Knowledge Graph),也称为语义网络(Semantic Network),表示一个由现实世界实体(如对象、事件、情境或概念)组成的网络,并展示它们之间的关系。这些信息通常存储在图数据库中,并以图结构的形式进行可视化,因此被称为“知识图谱”。
来看下面这段文本:
Mary had a little lamb,
You’ve heard this tale before;
But did you know she passed her plate,
And had a little more!
上面这段文本大致的中文翻译:
玛丽有一只小羊羔,
你以前听过这个故事;
但你知道吗,她把盘子伸过来,
又吃了一点!
以下是一个可能的知识图谱表示该文本的方式。
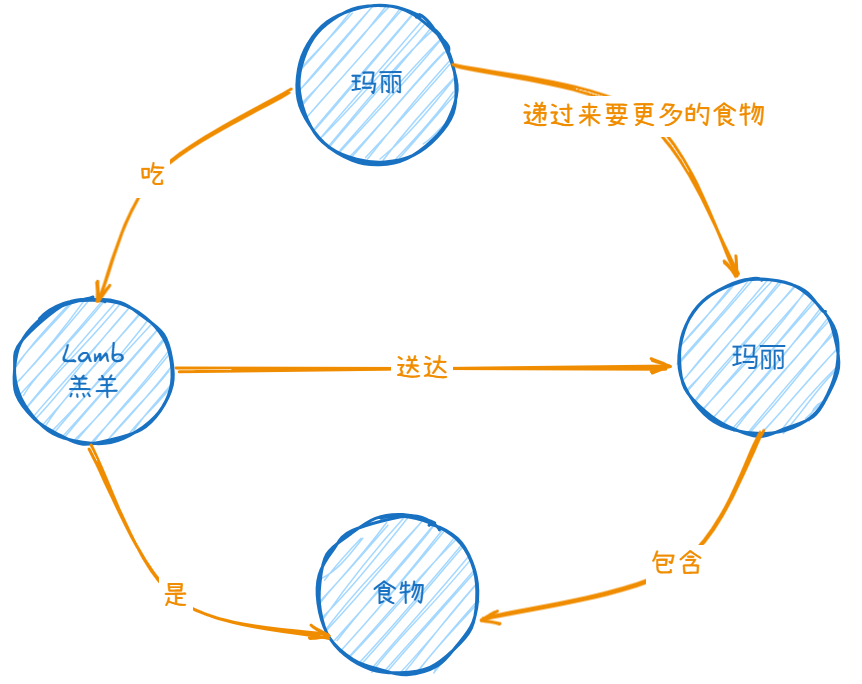
为什么要使用知识图谱?
知识图谱在多个方面都非常有用。我们可以运行图算法并计算任意节点的中心性,以了解某个概念(节点)在整个知识体系中的重要性。我们还可以分析相连和不相连的概念集,或计算概念的社区结构,以深入理解特定主题。此外,我们可以识别看似不相关概念之间的联系。
知识图谱还可以用于构建“图检索增强生成”(Graph Retrieval Augmented Generation,GraphRAG 或 GAG),并与我们的文档进行对话。这种方法相比传统的 RAG(检索增强生成)能够提供更优质的结果,因为 RAG 存在一些明显的局限性。例如,单纯使用语义相似度检索来查找最相关的上下文并不总是有效,尤其是在以下情况下:
- 查询未提供足够的上下文信息,导致难以确定真正的意图;
- 相关上下文分散在庞大的文本语料库中难以通过简单的检索获取完整信息。
例如,考虑以下查询:
请告诉我《百年孤独》中何塞·阿尔卡迪奥·布恩迪亚的家族树。
这本书记录了 7 代何塞·阿尔卡迪奥·布恩迪亚的家族史,其中一半的角色都叫这个名字!使用简单的 RAG 方法来回答这个问题将是一个巨大挑战,甚至可能根本无法完成。
RAG 的另一个缺陷在于:它不会告诉你应该问什么问题。然而,很多时候,问对问题比找到答案更重要。
图增强生成(Graph Augmented Generation, GAG) 在一定程度上可以弥补 RAG 的这些缺陷。更进一步,我们可以结合两者的优点,构建一个“图增强检索增强生成”(Graph Augmented Retrieval Augmented Generation, GARAG)流水线,以获得最佳效果。
总之,知识图谱不仅有趣、实用,而且看起来还很美观!
如何创建概念图?
如果你向 DeepSeek 询问如何从文本中构建知识图谱,它可能会给出如下步骤:
- 从文本中提取概念和实体(这些是节点);
- 识别概念之间的关系(这些是边);
- 将节点(概念)和边(关系)存储到图数据结构或图数据库中;
- 进行可视化(即使只是为了美观)。
第 3 和第 4 步看起来很好理解,但第 1 和第 2 步该如何实现呢?
下面是我设计的方法流程图,它用于从任意文本语料库中提取“概念图”。这个方法与上面提到的通用流程类似,但有一些细微的区别。
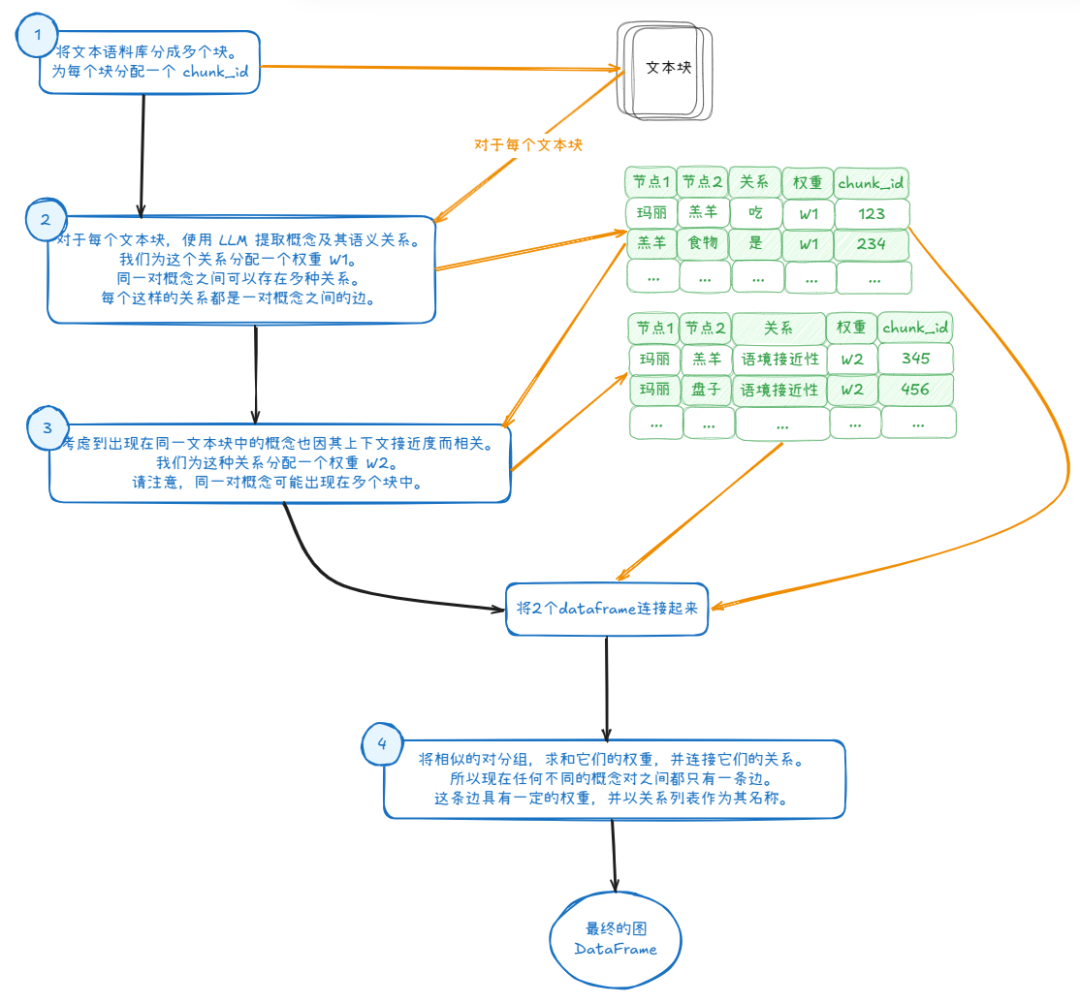
- 将文本语料库拆分成块。为每个块分配一个 chunk_id。
- 对于每个文本块,使用 LLM 提取概念及其语义关系。我们为该关系分配一个权重 W1。同一对概念之间可以存在多种关系。每个这样的关系都是一对概念之间的一条边。
- 考虑到出现在同一个文本块中的概念也通过它们的上下文接近度相关。我们为该关系分配一个权重 W2。请注意,同一对概念可能出现在多个块中。
- 将相似的对分组,求和它们的权重,并连接它们的关系。所以现在我们在任何一对不同的概念之间都只有一条边。边具有一定的权重和一个关系列表作为其名称。
你可以在本文我分享的 GitHub 仓库中看到此方法的 Python 代码实现。我将在接下来的几节中简要介绍实现的关键思想。
Mistral 与 Prompt(提示)设计
在上面的流程图中,第 1 步相对简单。LangChain 提供了大量的文本分割器(text splitters),我们可以使用它们将文本拆分成多个小块。
第 2 步才是真正有趣的部分!为了提取概念及其关系,我使用了 Mistral 7B 模型。在确定最适合我们需求的模型变体之前,我尝试了以下几种版本:
- Mistral Instruct
- Mistral OpenOrca
- Zephyr(Hugging Face 版本,基于 Mistral 训练)
我使用了这些模型的 4-bit 量化版本,以便能够在本地运行它们,而不会让我的 Mac 彻底崩溃😂。这些模型都可以使用 Ollama 本地运行。
这些模型都是经过指令微调的模型,它们使用了系统提示(system prompt)和用户提示(user prompt)。只要我们清楚地告诉它们要求,它们都能很好地遵循指令,并将答案格式化为 JSON,输出清晰整洁。
经过多轮试错实验后,我最终选择了 Zephyr 模型,并设计了以下提示词(prompt)。
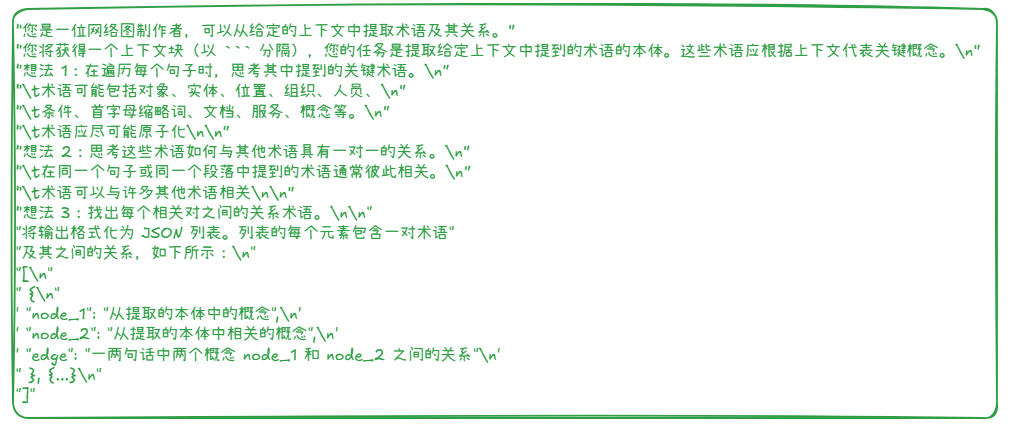
如果我们使用这个提示词处理我们的童谣文本(虽然这首诗并不适合给幼儿园小朋友😂),会得到如下输出:
SYS_PROMPT = (    "You are a network graph maker who extracts terms and their relations from a given context. "    "You are provided with a context chunk (delimited by ```) Your task is to extract the ontology "    "of terms mentioned in the given context. These terms should represent the key concepts as per the context. \n"    "Thought 1: While traversing through each sentence, Think about the key terms mentioned in it.\n"        "\tTerms may include object, entity, location, organization, person, \n"        "\tcondition, acronym, documents, service, concept, etc.\n"        "\tTerms should be as atomistic as possible\n\n"    "Thought 2: Think about how these terms can have one on one relation with other terms.\n"        "\tTerms that are mentioned in the same sentence or the same paragraph are typically related to each other.\n"        "\tTerms can be related to many other terms\n\n"    "Thought 3: Find out the relation between each such related pair of terms. \n\n"    "Format your output as a list of json. Each element of the list contains a pair of terms "    "and the relation between them, like the following: \n"    "[\n"    "   {\n"    '       "node_1": "A concept from extracted ontology",\n'    '       "node_2": "A related concept from extracted ontology",\n'    '       "edge": "relationship between the two concepts, node_1 and node_2 in one or two sentences"\n'    "   }, {...}\n"    "]")
USER_PROMPT = f"context: ```{input}```\n\n output: "
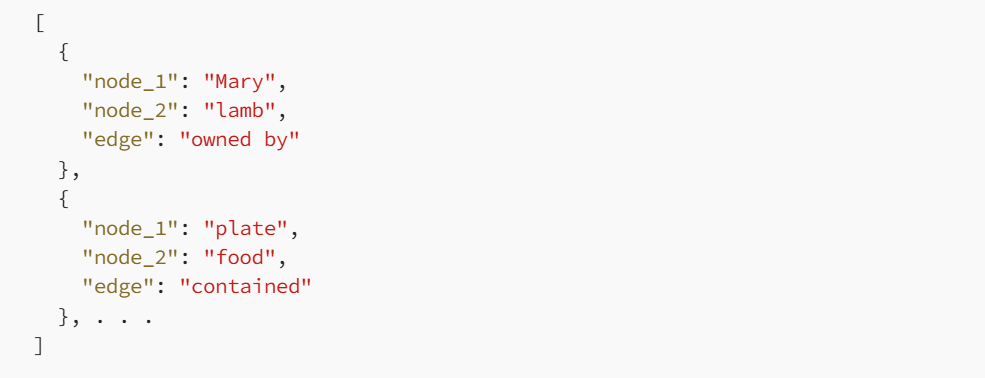
请注意,它甚至猜测“食物”是一个概念,而文本块中并未明确提及这个概念。这非常强大!
如果我们在示例文章的每个文本块中运行此代码,并将 json 转换为 Pandas DataFrame,那么最终结果看起来如下所示。
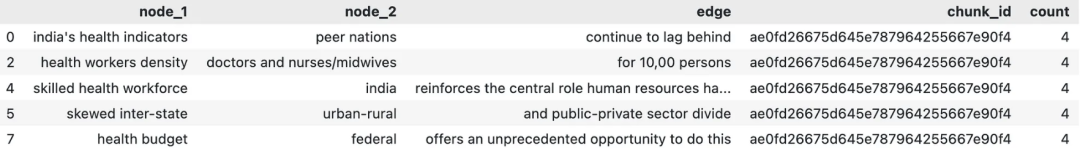
在这个 DataFrame 中,每一行都代表两个概念之间的关系。换句话说,每一行都是知识图谱中两个节点(node)之间的一条边(edge)。
需要注意的是:
- 同一对概念之间可能存在多条边(多种关系)
- 权重(weight)在 DataFrame 中被任意设定为 4(只是一个示例值)。
语境接近性(Contextual Proximity)
我假设在文本语料库中相互靠近的概念是相关的,我们称这种关系为语境接近性(contextual proximity)。为了计算这些语境接近性边,我们采取以下步骤:
- DataFrame 合并:将 node_1 和 node_2 合并为同一列,这样可以更方便地进行配对操作。
- 自连接(Self-Join):然后,我们使用 chunk_id 作为关键字,对 DataFrame 进行自连接(self-join)。这样一来,相同 chunk_id 下的所有概念都可以相互配对,形成一条新的关系边。这意味着,每个 chunk_id 内部的所有节点都会被两两配对,生成新的关系行。
- 移除自环(Self-Loop)但这种方法会引入“自环”(self-loop)——即概念与自身的关系(比如 “Mary” -> “Mary” )。为了解决这个问题,我们需要删除所有 node_1 == node_2 的行。这样,每个概念只会与其他概念建立关系,而不会连接自己。
- 得到新的数据框
最终,我们得到了一个新的 DataFrame,其结构与原始 DataFrame 类似,但现在包含了额外的语境接近性关系。
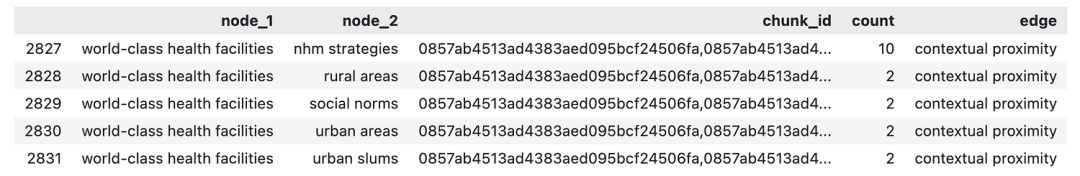
这里的 count 列是 node_1 和 node_2 同时出现的块数。chunk_id 列是所有这些块的列表。
所以我们现在有两个 DataFrame,一个具有语义关系,另一个具有文本中提到的概念之间的上下文接近关系。我们可以将它们组合起来形成我们的网络图 DataFrame。
我们已经为我们的文本构建了概念图。但就此止步将是一项相当不尽人意的练习。我们的目标是将图表可视化,就像本文开头的特色图片一样,我们离目标并不远。
创建概念网络
NetworkX 是一个 Python 库,它使处理图表变得非常容易。
只需几行代码就可以将我们的
DataFrame 添加到 NetworkX 图。
G = nx.Graph()## Add nodes to the graphfor node in nodes: G.add_node(str(node))## Add edges to the graphfor index, row in dfg.iterrows(): G.add_edge( str(row["node_1"]), str(row["node_2"]), title=row["edge"], weight=row['count'] )
这是我们开始利用 Network Graph 功能的地方。NetworkX 提供了大量现成的网络算法供我们使用。
在这里,我使用社区检测算法(Community Detection Algorithm)为节点添加颜色。社区(Communities) 是指内部连接更紧密、与图中其他部分相比关系更紧密的节点群组。概念的社区可以帮助我们识别文本中讨论的主要主题。
在我们分析的这篇综述文章:中 Girvan-Newman 算法检测出了 17 个概念社区。
以下是其中的一个社区示例:
[ 'digital technology', 'EVIN', 'medical devices', 'online training management information systems', 'wearable, trackable technology']
这让我们立刻对综述文章中讨论的健康技术这一广泛主题有了清晰的认识,并且能够提出相应的问题,然后通过 RAG 流水线来解答。是不是很棒?
接下来,我们还可以计算图中每个概念的度(degree)。节点的度指的是其连接的总边数。在我们的案例中,度数越高的概念,在文本主题中就越核心。在可视化时,我们可以使用度数来决定节点的大小,以突出核心概念。
图可视化(Graph Visualization)
可视化是整个过程中最有趣的部分,它不仅帮助我们理解数据,还能带来某种艺术上的满足感。
在这里,我使用 Pyvis 库来创建交互式图。Pyvis 是一个用于可视化网络的 Python 库。
Pyvis 内置了一个 NetworkX Helper,可以将我们的 NetworkX 图 转换为 PyVis 对象,因此我们不需要再编写更多代码了……太棒了!!
记住,我们已经计算了每条边的权重(用于确定边的粗细),节点的社区(用于确定颜色),以及每个节点的度(用于确定节点的大小)。
有了这些附加功能,我们的图就完成了,以下是最终的图示:
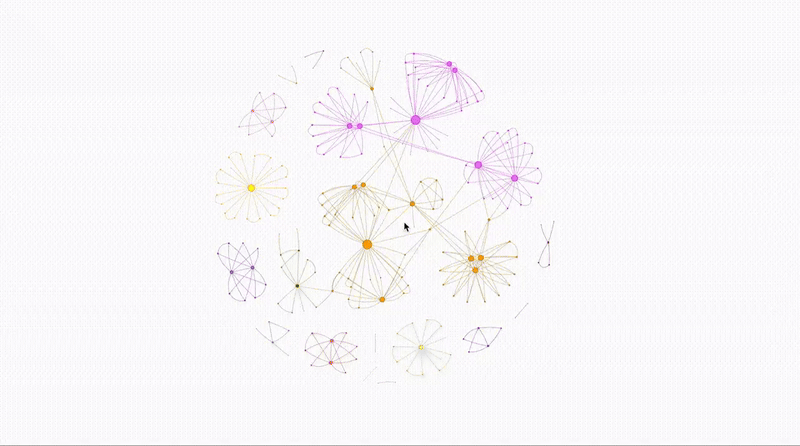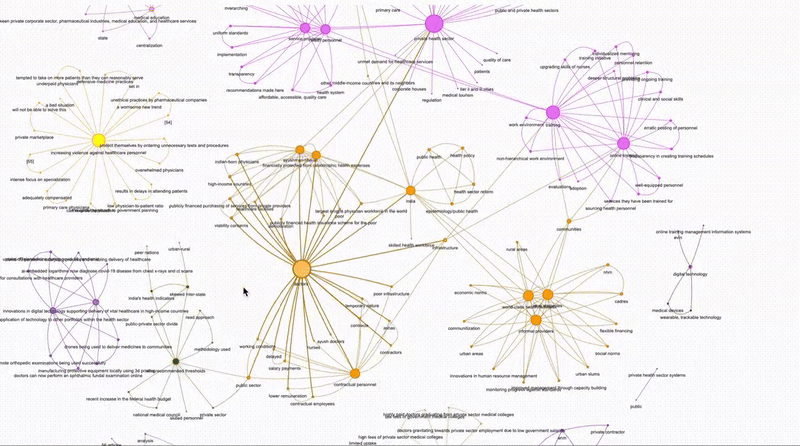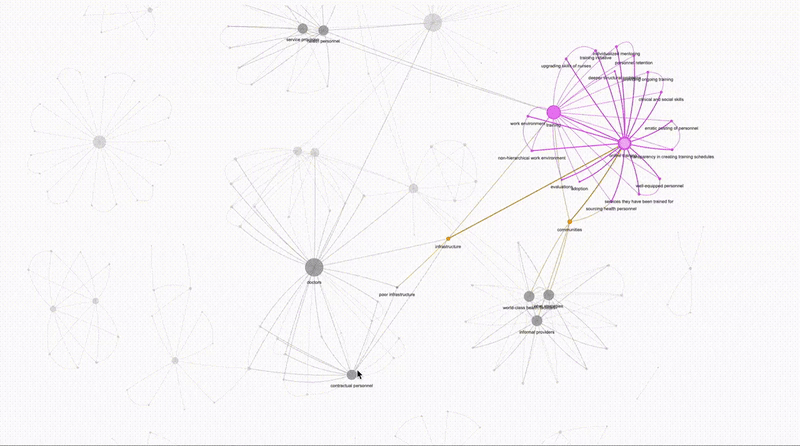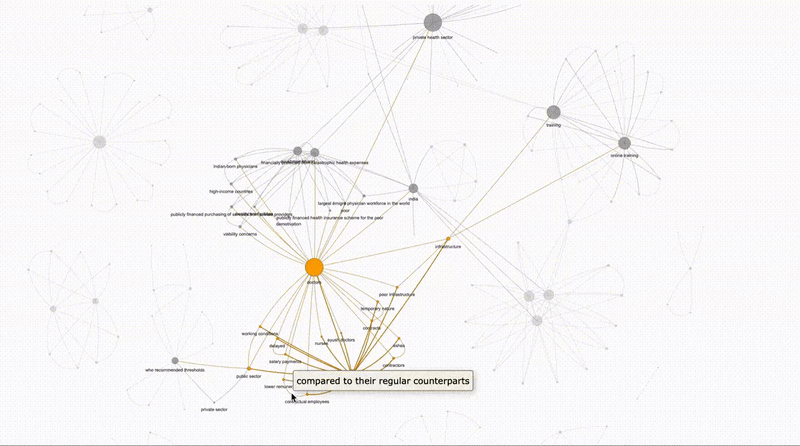
你可以访问下面提供的在线交互式演示地址来感受一下最终的成果。我们可以随意缩放、移动节点和边。页面底部还有一个滑动面板,可以用来调整图的物理属性。看看这个图是如何帮助我们提出正确的问题,并更好地理解主题内容的!
最后的最后
感谢你们的阅读和喜欢,作为一位在一线互联网行业奋斗多年的老兵,我深知在这个瞬息万变的技术领域中,持续学习和进步的重要性。
为了帮助更多热爱技术、渴望成长的朋友,我特别整理了一份涵盖大模型领域的宝贵资料集。
这些资料不仅是我多年积累的心血结晶,也是我在行业一线实战经验的总结。
这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。如果你愿意花时间沉下心来学习,相信它们一定能为你提供实质性的帮助。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
大模型知识脑图
为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

经典书籍阅读
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

实战案例
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

面试资料
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1159


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


