毕业设计:基于计算机视觉的街景交通标志识别与分类

计算机视觉(一)-----街景字符识别简介及代码实例 目录1.简介1.1 思路1.2 运行环境及安装示例2.代码实例2.1. 导入常用的包:2.2. 定义好读取图像的Dataset2.3. 定义好训练数据和验证数据的Dataset2.4. 定义好字符分类模型,使用renset18的模型作为特征提取模块2.5. 定义好训练、验证和预测模块2.6. 迭代训练和验证模型2.7. 对测试集样本进行预测,生成提交文件2.8. 加载保存的最优模型 1.简介 数据集来源为Google街景图像中的门牌号数据集(The Street View House Numbers Dat 阅读详情

目录

前言

项目背景

数据集

设计思路

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于计算机视觉的街景交通标志识别与分类

项目背景

       交通标志是道路交通管理的重要组成部分,能够有效指导驾驶员的行为,确保交通安全。然而,随着交通环境的复杂化,传统的交通标志识别方法面临着识别速度慢、准确率低等问题。利用深度学习和计算机视觉技术开发交通标志识别系统,可以实现对交通标志的快速、准确识别,为智能交通系统的发展提供支持。

数据集

       图像采集采用自主拍摄和互联网采集。在不同城市和街道环境中进行,捕捉各种真实场景下的交通标志,确保数据的多样性与代表性。通过访问公开的图片数据库和交通标志相关网站,收集大量的标志图像,以补充自主拍摄的不足,丰富数据集的内容。
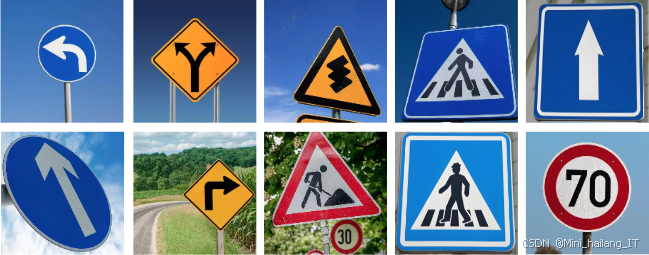
毕业设计:基于计算机视觉的街景交通标志识别与分类 人工智能专业 目标检测

       数据标注使用专业工具如LabelImg进行,通过绘制边界框准确标识每个交通标志的位置,并为其赋予相应的类别标签,如“停车标志”或“限速标志”。这一过程确保数据的准确性和一致性,直接影响模型的训练效果和识别能力。标注完成后,生成的标注文件以XML或JSON格式保存,为后续的数据处理和模型训练奠定了坚实的基础。
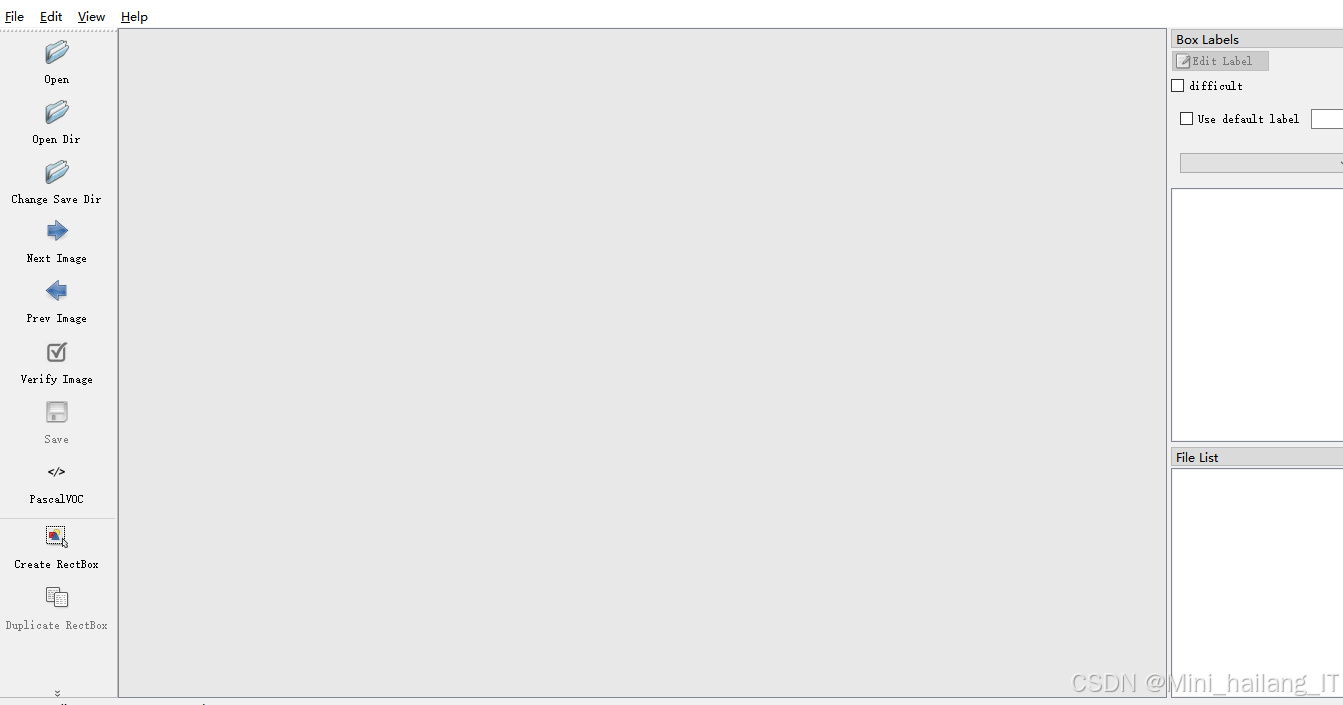
       在数据集划分阶段,将数据分为训练集、验证集和测试集,以便于模型的有效评估和泛化能力。进行数据扩展,通过旋转、翻转、缩放等图像变换技术,增加数据的多样性。这不仅提升了模型的鲁棒性,还帮助缓解了模型过拟合的问题。

设计思路

       卷积神经网络(CNN)是人工智能领域的研究热点,受到神经元结构的启发,模仿生物神经细胞的连接方式。其结构主要包括卷积层、池化层、全连接层和输出层。网络通过前向传播生成输出,输出的预测值与真实值之间的误差通过反向传播进行参数更新,从而优化网络结构。

       在卷积层中,每个神经元仅与相邻层的神经元进行局部连接,对输入图像进行特征提取,消除噪音,并对同一特征图的神经元共享参数。每个卷积核共享相同的参数。池化层则通过下采样降低计算量,去除无效信息。反向传播优化训练过程,首先计算预测值与真实值之间的误差,利用损失函数(通常为均方误差)来实现。
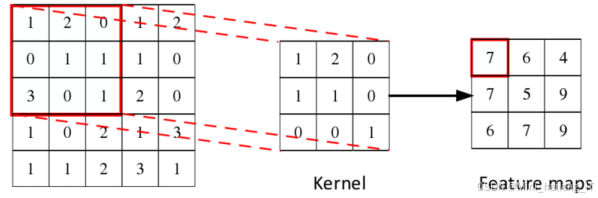
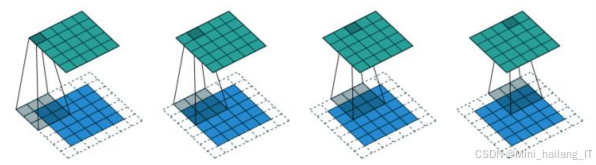
       反向传播过程的方向与前向传播相反,从输出层到输入层,根据梯度的大小和方向更新卷积层的参数。图像区域经过划分后进行卷积运算,滑动计算时对应位置的像素值与卷积核进行内积,以提取图像特征。卷积操作的核心思想包括局部连接和权值共享,局部连接减少了参数,降低了过拟合风险,权值共享则加快了学习速度。
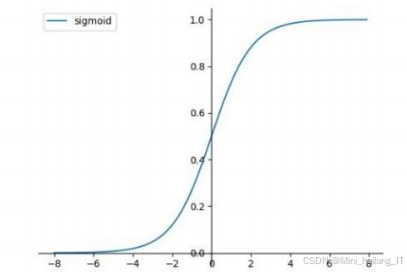
       激活层的作用是将线性输入映射为非线性输出。没有激活层,神经网络无法模拟非线性数据分类。激活层通常位于卷积层之后,常见的激活函数包括sigmoid、tanh和ReLU。通过激活函数,卷积神经网络具备了多层级的非线性映射能力。
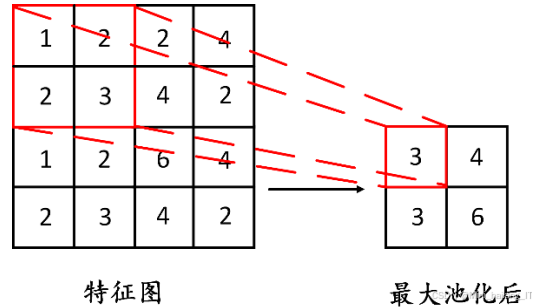
       池化层通常在相邻的卷积层中加入,主要用于对输入数据进行降采样,保留重要特征信息,防止模型过拟合。池化层不改变通道数,常见的类型包括最大池化和平均池化。最大池化选择池化窗口中的最大值,保留显著特征,平均池化则计算窗口内的平均值以保留较为完整的信息。池化的参数设置包括池化窗口大小、步长和填充,这些都会影响池化效果。卷积神经网络的最后通常添加一个或多个全连接层,每个神经元与前一层的所有神经元相连,用于区分卷积或池化后的类别信息。全连接层提取特征后得到特征向量,通过处理这些向量实现分类结果。
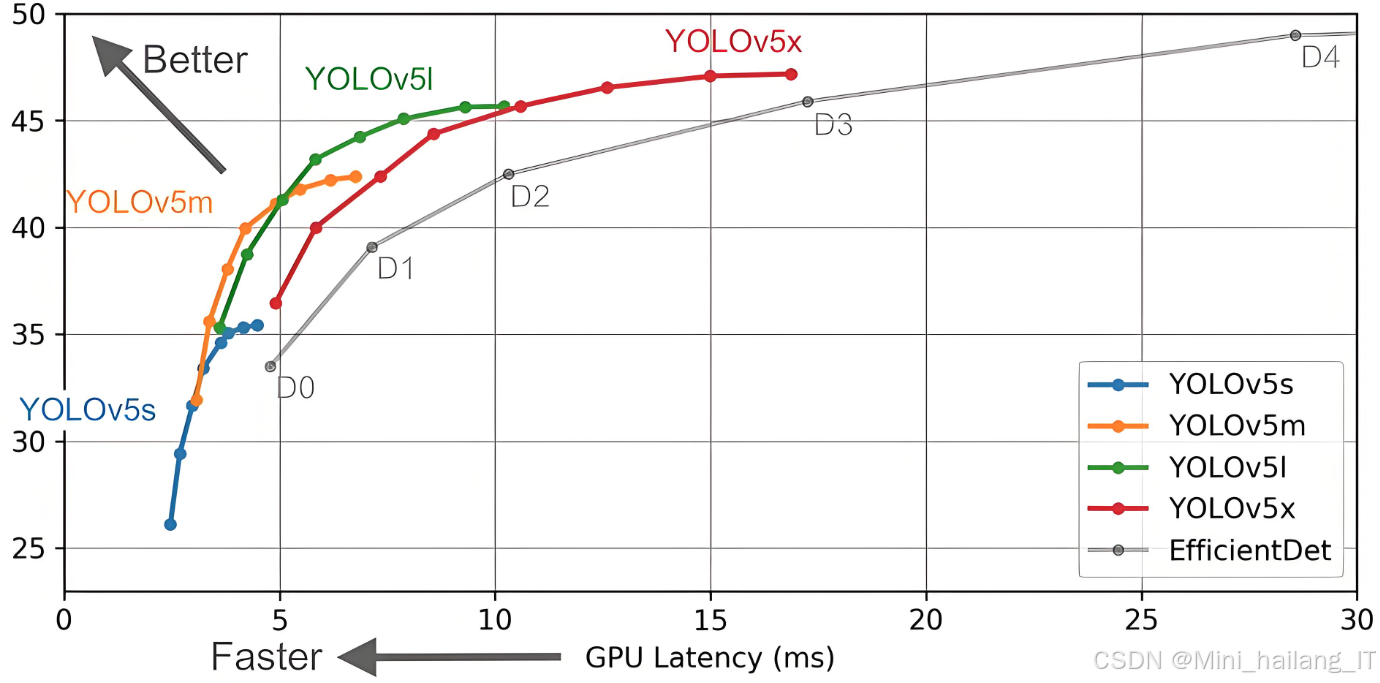
       YOLOv5被广泛应用于目标检测领域,具有灵活便捷的部署特点。其模型结构主要分为输入端、骨干网络、颈部和预测层。输入端负责接收RGB三通道图像,并进行Mosaic数据增强、自适应锚框计算以及图像分辨率处理。骨干网络通过不同大小的卷积提取多尺度的图像特征,去除无效特征,而颈部网络则将不同尺度的有效特征进行拼接,为后续的预测层做好准备,最终在预测层进行目标的预测。
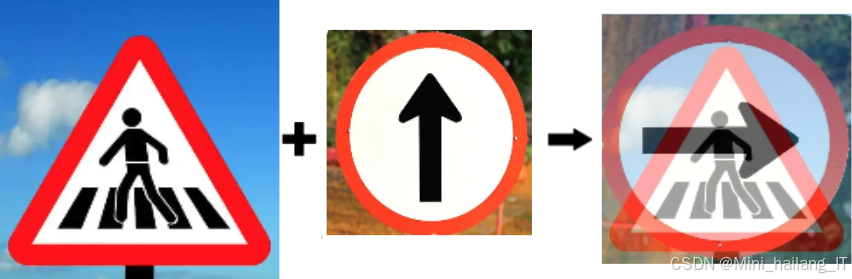
       输入端不仅负责输入图像,还实施Mosaic数据增强技术,通过将不同图像拼接在一起并进行放大、缩小、旋转等操作,丰富检测目标的图像。这种增强方法有效提升了模型对不同场景和目标的识别能力。此外,自适应锚框计算在每次训练开始前,根据不同数据集计算相应的锚框,确保模型能够更好地适应特定任务。
       骨干网络主要由Focus模块、CBS模块、Bottleneck模块和SPP模块等组成。Focus模块通过切片操作减少计算量和参数量,以保留图像信息。具体而言,Focus模块在输入图像中每隔固定像素取一个值,从而缩小图像尺寸,同时增加维度。经过Slice与Concat操作后,输出特征映射,随后通过卷积层进一步提取特征。C3模块通过CBS和多个Bottleneck模块计算,并结合卷积计算,获得残差特征和细微特征,从而避免网络退化。
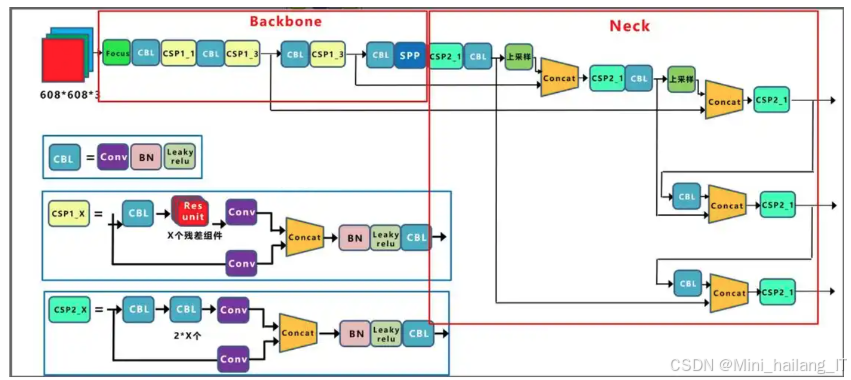
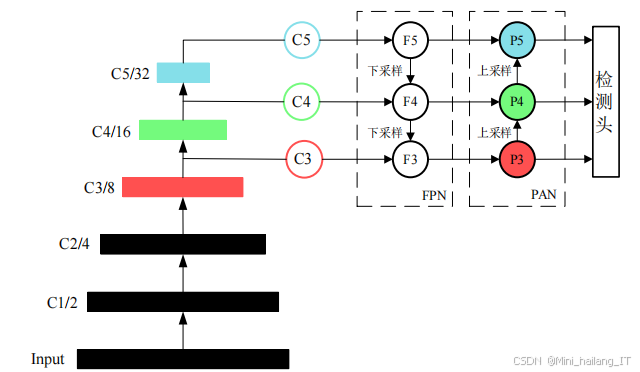
       颈部网络包含路径聚合网络(PAN)和特征金字塔网络(FPN)。FPN层通过自上而下的特征融合,将高层语义信息传递并进行预测。然而,随着特征层级的增加,高层特征的抽象性使得底层目标信息变得模糊。PAN层引入自下而上的通路,增强底层语义信息,特别是位置信息,从而提高检测精度。这样的特征融合策略有效提升了模型对目标类别和位置信息的识别能力。
       YOLOv5的损失函数由边界框损失、置信度损失和分类损失组成,其中采用CIOU作为边界框回归的损失函数。损失函数的值由模型的预测值与真实值决定,直接影响模型的训练效果,值越小代表拟合程度越高。

       数据准备包括数据集的收集、清洗和标注。收集的数据应包括多样化的交通标志图像,标注工具会为每个图像生成相应的标签文件。数据清洗过程涉及移除模糊或低质量的图像,确保只有清晰且具有代表性的样本被用于训练。通过对训练数据进行旋转、翻转、缩放、色彩调整等操作,可以生成新的训练样本,增加数据的多样性。这一过程可以有效降低过拟合风险,使模型能够更好地适应不同的场景和光照条件。

# 示例代码:数据增强
from keras.preprocessing.image import ImageDataGenerator

datagen = ImageDataGenerator(
    rotation_range=20,
    width_shift_range=0.2,
    height_shift_range=0.2,
    shear_range=0.2,
    zoom_range=0.2,
    horizontal_flip=True,
    fill_mode='nearest'
)

# 假设有一张图片需要增强
image = cv2.imread('path/to/image.jpg')
image = image.reshape((1,) + image.shape)  # 调整为符合datagen的输入形状

# 生成增强样本
for batch in datagen.flow(image, batch_size=1):
    # 保存或使用增强样本
    break

       选择合适的深度学习框架并设计模型架构。常见的选择包括卷积神经网络,可根据需求选择预训练模型,如YOLO、MobileNet等,或从头开始构建模型。使用YOLOv5进行模型训练时,首先需要安装YOLOv5的依赖包并下载YOLOv5代码库。然后,配置训练参数,指定训练集和验证集的路径,以及超参数,如学习率和批次大小。通过调用YOLOv5的训练函数,开始训练过程。设计时需考虑层的数量、每层的神经元数、激活函数等参数。将准备好的数据集分为训练集和验证集,使用训练集对模型进行训练,并利用验证集监控模型性能。通过调整超参数来优化训练过程,并使用回调函数防止过拟合。

# 示例代码:训练模型
from keras.callbacks import EarlyStopping

early_stopping = EarlyStopping(monitor='val_loss', patience=3)

model.fit(training_data, training_labels, 
          validation_data=(validation_data, validation_labels), 
          epochs=50, 
          batch_size=32, 
          callbacks=[early_stopping])

       模型评估使用独立的测试集来检验模型的性能。可以使用准确率、召回率、F1-score等指标评估模型效果。此外,还可以通过可视化工具(如混淆矩阵)分析模型在不同类别上的表现。将训练好的模型进行部署,使其能够在实际应用中进行交通标志识别。这一过程可以通过将模型导出为适合的格式,并在服务器或边缘设备上进行部署,以便实时处理图像数据。

# 示例代码:评估模型
from sklearn.metrics import classification_report, confusion_matrix

test_loss, test_accuracy = model.evaluate(test_data, test_labels)
predictions = model.predict(test_data)
print(classification_report(test_labels, predictions.argmax(axis=1)))
print(confusion_matrix(test_labels, predictions.argmax(axis=1)))

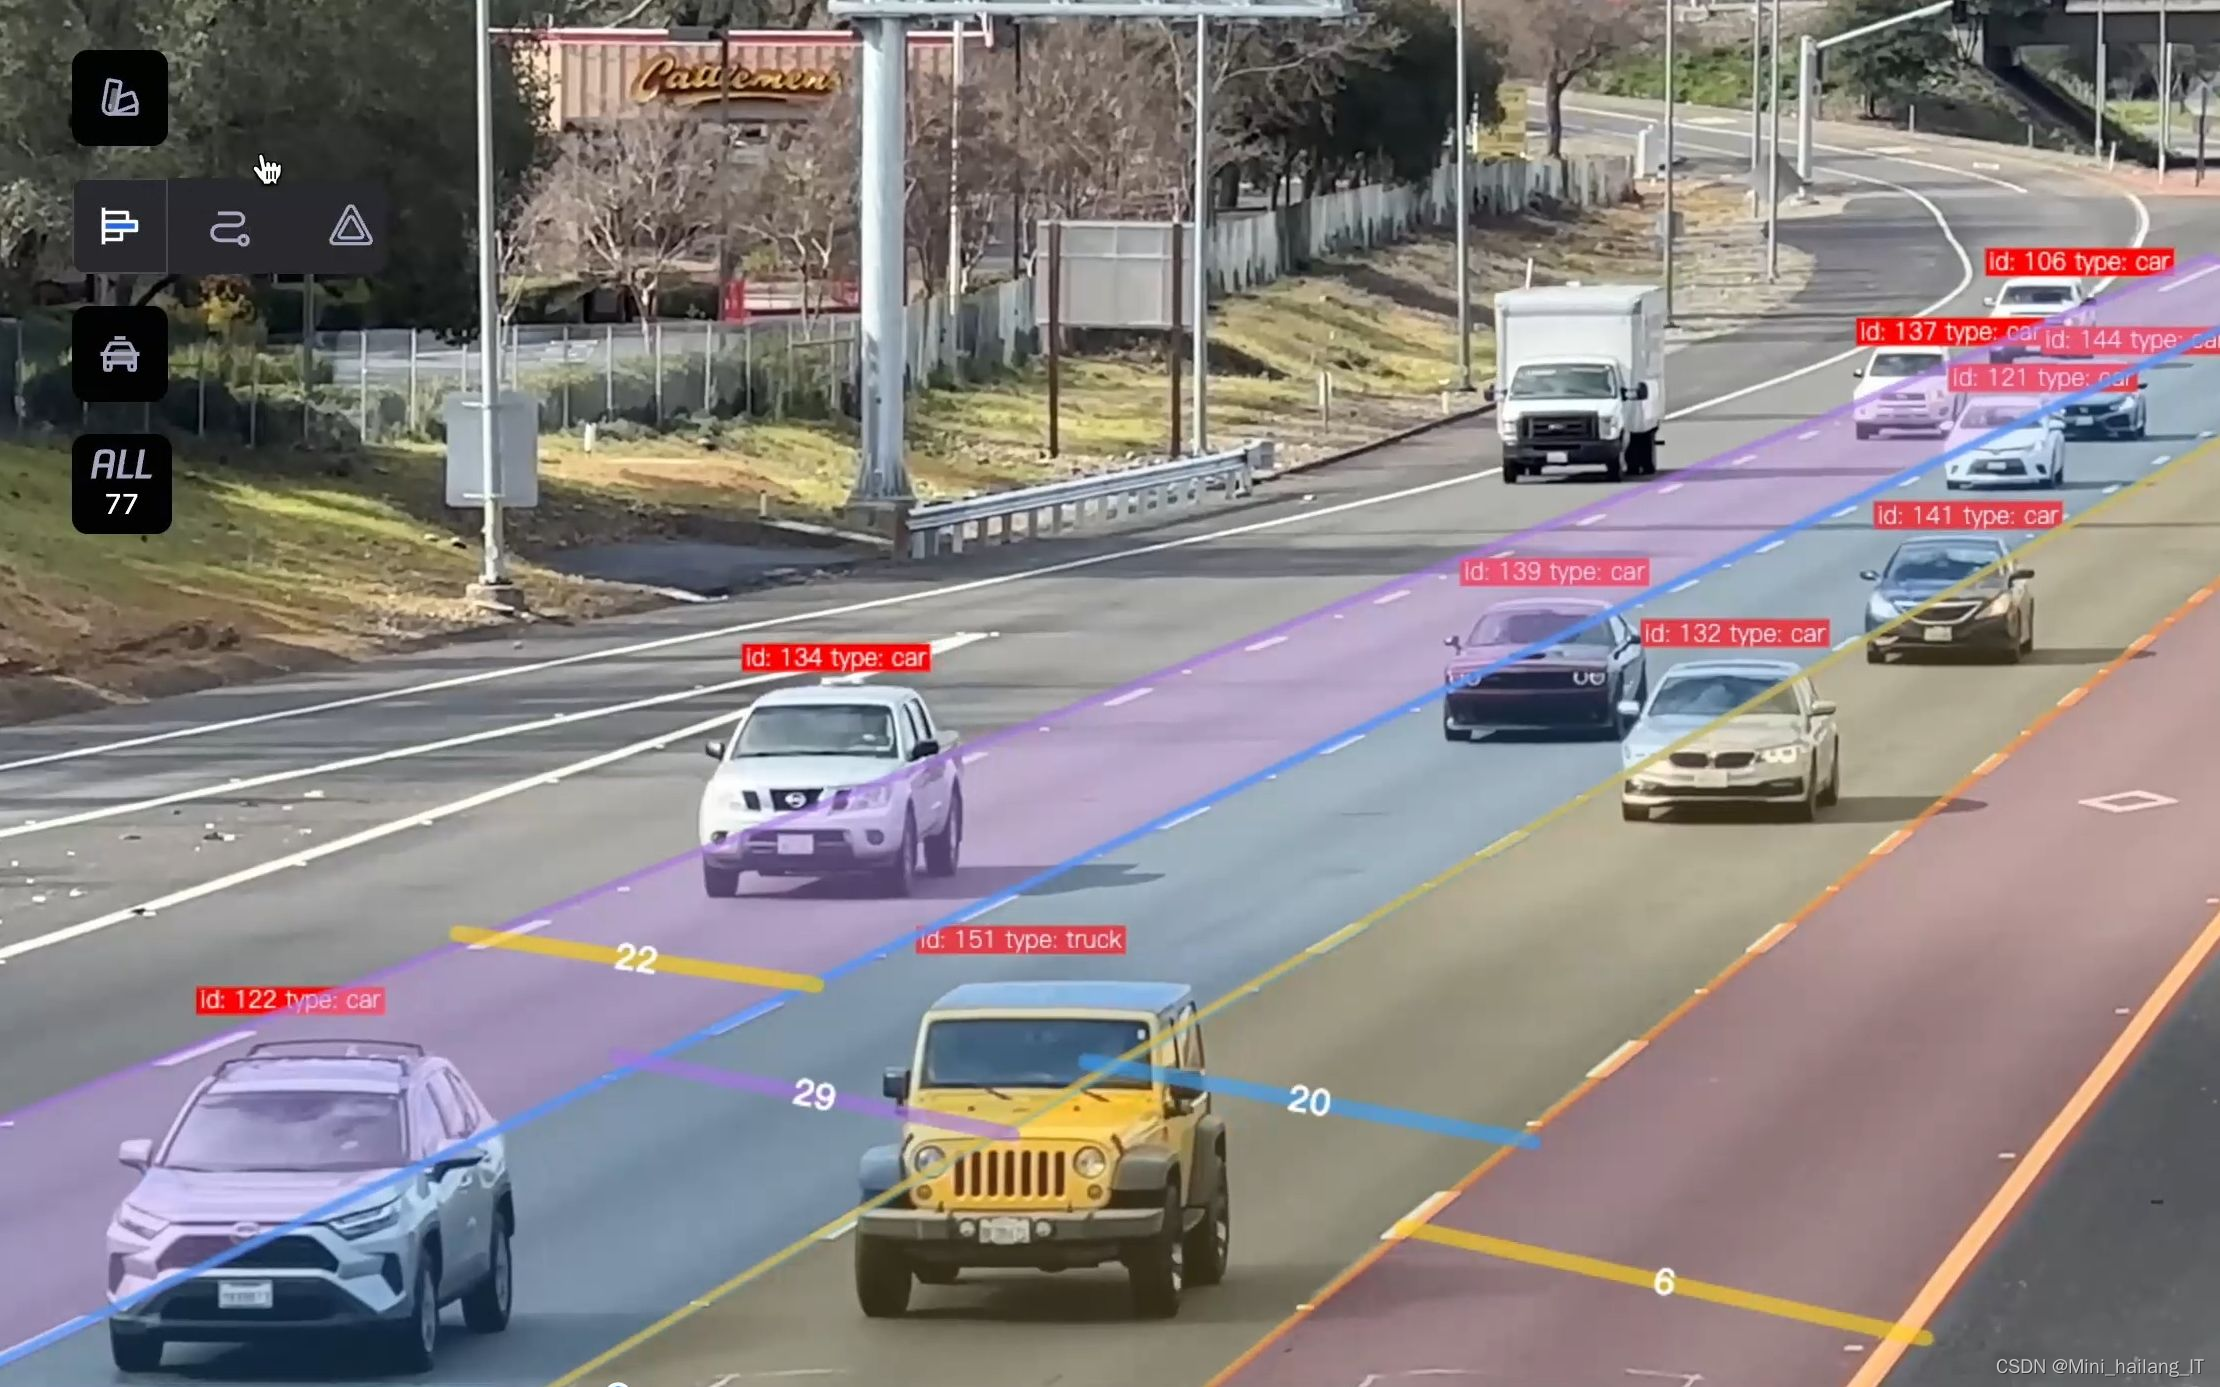
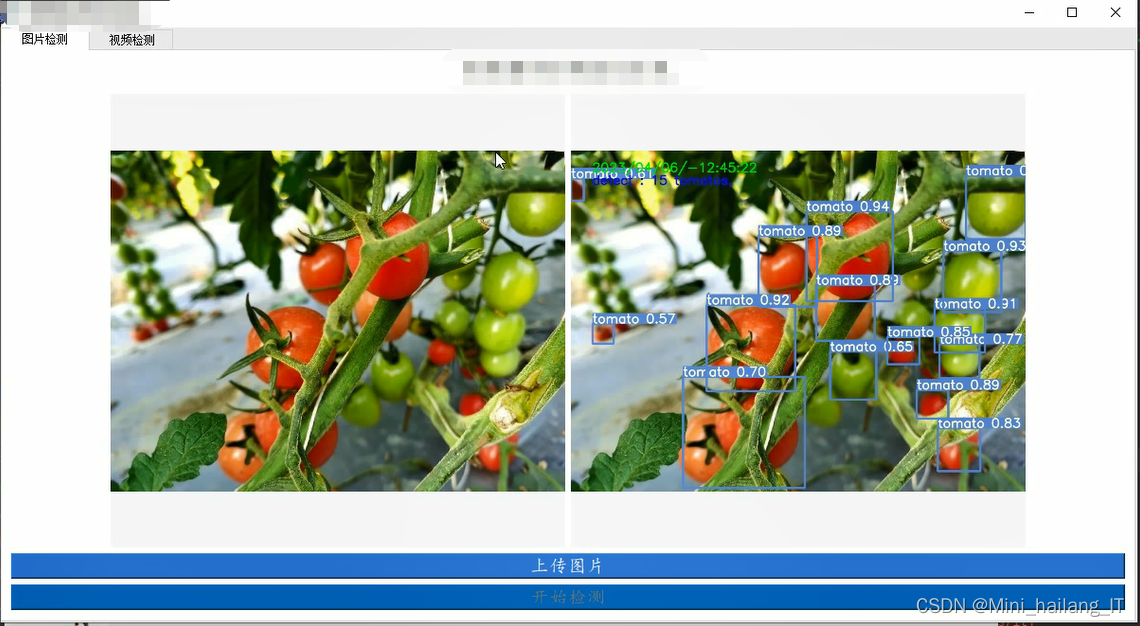
海浪学长项目示例:
更多帮助

嵌入式人工智能应用- 第十章街景分类 我们有时候在一些科幻电影里看到类似 所示的画面,感觉很是高端大气上档次,那么我们能不能做到类似的识别效果呢?这和我们的实验七类似,实验九是识别视野中的主要物体,这里不仅识别到了,还将识别到的物体框选出来了。如果从最开始的基础到现在,关于常用的算法、各种神经网络已经了解得够多了,这里我们再加一个 YOLO 算法。当我们谈起计算机视觉时,首先想到的就是图像分类。图像分类是计算机视觉最基本的任务之一,但是在图像分类的基础上,还有更复杂和有意思的任务,如目标检测,物体定位,图像分割等。 阅读详情

相关推荐

SVT谷歌街景数据集

svt有112M,这里分成两部分上传。 这是第1部分。

利用PP-OCR对街道门牌号进行识别

AI达人特训营二期】PaddleOCR街景地图门牌号识别

m0_63642362的博客 1797

MTK MT6833平台屏幕与TP驱动移植实战:从FAE伪代码到内核模块集成

本文详细介绍了在MTK MT6833平台上进行屏幕与TP驱动移植的完整实战流程。文章从解析供应商提供的初始化伪代码入手,逐步拆解了在LK阶段点亮屏幕、在内核层集成Panel驱动以支持休眠唤醒,以及移植并调试sitronix_ts触摸驱动的核心步骤与关键技巧,为嵌入式开发人员提供了从零到一集成新硬件的清晰指南。

rnn9storyteller的博客 441

SVHN街道实景门牌识别

对模型进行训练,并在每个epoch后输出训练集和测试集上的准备率/损失。

qq_43607118的博客 5353

【项目实战】小智AI MCP协议在IoT设备控制中的深度应用解析

本文深度解析小智AI MCP协议在IoT设备控制中的应用实践。通过MCP协议作为AI与物联网设备的翻译桥梁,实现大语言模型与ESP32等硬件的无缝通信。文章详细介绍了环境搭建、工具注册、消息路由机制,并以语音控制RGB灯光系统为例展示完整开发流程,为AIoT开发者提供实用指南。

oauth7security的博客 824

JAVA + 海康威视SDK + FFmpeg+ SRS 实现海康威视摄像头二次开发

海康威视SDK接入方案摘要 本文介绍了使用海康威视官方SDK开发物联网平台摄像头接入功能的完整方案。系统采用Java后端集成HCNetSDK控制摄像头,通过FFmpeg将RTSP流转为RTMP推送到SRS流媒体服务器,前端基于HTTP-FLV协议实现视频播放。文章详细说明了开发准备工作,包括SDK下载、SRS部署、FFmpeg安装等关键步骤,并提供了数据库表设计和接口定义。核心部分展示了如何集成海康SDK,包括提取必要代码、加载DLL文件、配置打包插件等具体实现细节,最终形成了一套支持实时预览、回放和下载的

2401_83057947的博客 2263

街景图片地理位置识别系统设计方案

通过AI技术实现:输入任意街景图片 → 输出拍摄地点的地理位置(经纬度坐标+地址描述),定位精度达到城市级(95%+准确率)或街道级(80%+准确率)

q339179198的博客 2111

Win10安装Nek5000

1 安装wsl 2 2 安装Nek5000 3 安装依赖项 4 安装openmpi 5 配置Nek5000 6 编译Nek5000 7 运行Nek5000算例 8 安装paraview并查看结果

weixin_43176703的博客 3451

【阿里云天池】实战:街景符号识别(背景介绍+思路)

赛题来源自Google街景图像中的门牌号数据集(The Street View House Numbers Dataset, SVHN),并根据一定方式采样得到比赛数据集。赛题的要求是根据给出的图片,识别图片上的数字(门牌号)。对于每张图片还会给予数据标签,目的是确定字符的具体位置。Score=编码识别正确的数量/测试集图片数量。

daweq的博客 707

S7-1200 PLC PID功能 | 调节PID参数

S7-1200 PLC PID功能 | 调节PID参数

Robot_PLC_HMI_Automation 1万+

AI Agent开发第85课-DeepSeek-OCR 安装全指南:从 Transformers 到 vLLM,手把手教你跑通企业级 OCR

本文系统讲解 DeepSeek-OCR 的两种部署方式——基于 Hugging Face Transformers 的标准推理与基于 vLLM 的高性能加速推理。详细说明 CUDA 与 PyTorch 版本匹配、环境验证、依赖安装等关键细节,并提供可直接运行的完整代码示例。无论你是单卡调试还是高并发服务部署,都能在这里找到清晰路径。

打造全国最全的AI Agent开发知识领域的博客 2542

上手OpenMMLab——写在最前面:OpenMMLab概述

随着深度学习、计算机视觉等学科的发展,各大研究机构和公司陆续开源自己的深度学习框架,论文发表同时开源代码也成了行业内的习惯。无论身处什么领域,都可以站在OpenMMLab巨人肩膀上,使用开箱即用的模型开发自己的人工智能项目~首推的就是目标检测算法库MMDetection,它可以解决目标检测实例分割全景分割和目标追踪任务这是OpenMMLab在业界最有影响力的算法库,在github上有2万多star~OpenMMLab是开源算法体系,它已经提供了各个计算机视觉方向的大量开箱即用的预训练模型和算法。

Yuetian_w的博客 6048

OpenAI Error: 403 Country, region, or territory not supported [Python]

从OpenAI的API服务中获取数据时,由于你所在的国家、地区或领土不被支持,因此请求被拒绝了

suiusoar 5668

openmmlab AI实战营第二期第一课 openmmlab 综述

无论身处什么领域,都可以站在OpenMMLab巨人肩膀上,使用开箱即用的模型开发自己的人工智能项目首推的就是目标检测算法库MMDetection,它可以解决目标检测实例分割全景分割和目标追踪任务这是OpenMMLab在业界最有影响力的算法库,在github上有多达2万+starOpenMMLab是开源算法体系,它已经提供了各个计算机视觉方向的大量开箱即用的预训练模型和算法。也就是说OpenMMLab的算法研究员已经帮我们把这些cv任务的常见算法都现好了!

weixin_42567071的博客 314

RT-DETR升级:TGRS2026 CKConv结合RepC3 | 方向特征与跨阶段融合协同,小目标漏检率大幅下降

小目标鲁棒性提升:CKConv方向选择性抑制背景噪声,RepC3跨阶段传递保留深层微弱热信号,显著改善低对比度、低信噪比场景下的检测精度。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 151

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

50+行业级目标检测数据集实战指南:农业、医疗、自动驾驶等场景落地全解析

目标检测是计算机视觉落地最广泛的技术之一,其核心挑战不在模型本身,而在真实场景下的数据适配性。理解不同行业数据的物理特性(如农业图像的光照变化、医疗超声的斑点噪声、自动驾驶的域偏移)是提升模型鲁棒性的前提。本文聚焦工业级目标检测数据集选型与工程化实践,系统梳理农业、医疗、自动驾驶、卫星遥感、水下探测等9大垂直领域的代表性数据集,深入剖析其标注规范、许可证风险、硬件适配要求及典型失败模式,并提供可复现的Colab Notebook、统一数据加载器设计与端到端部署方案,助力开发者跨越从学术mAP到产业可用的鸿沟

weixin_30693683的博客 589

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

【毕业设计】基于YOLO和卷积神经网络的交通标志检测与识别 计算机视觉 数据集 YOLO

毕业设计:交通标志检测通过构建一个结合YOLO算法的交通标志检测模型,利用卷积神经网络进行特征提取和分类。研究将收集多种环境和条件下的交通标志图像数据,重点关注数据预处理、模型训练和性能评估等关键环节。实验结果表明,该系统在复杂的交通场景中能有效检测和识别多种类型的交通标志,具备较高的准确性和实时性,为智能交通系统的应用提供了技术支持。

机器学习,深度学习,计算机视觉爱好者,整理分享技术资料与项目案例。 2290

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

街景识别-零基础入门-task1

这里写自定义目录标题街景识别-理解篇名称目标数据思路评测指标 街景识别-理解篇 名称 街道字符识别 目标 1.以计算机视觉为背景,预测街道字符编码,完成字符识别。 2.走进计算机视觉领域,锻炼并提高对数据建模的能力。 数据 数据集来自Google街景图像中的门牌号数据集(The Street View House Numbers Dataset, SVHN),并根据一定方式采样得到实验数据集。数据集在阿里云 天池报名后可见并可下载,该数据来自真实场景的门牌号。训练集数据包括3W张照片,验证集数据包括1W张照

secker123的博客 3822

遥感论文 | ISPRS | 图神经网络也能做城市街道功能感知?纯视觉方案,效果可观!

提出一种用于街景尺度城市功能识别的纯视觉、强大而可靠的方法。引入了一种基于两层空间相关图神经网络结构的方法,该方法将连续的街景图像作为输入(通常在Google Street View、百度地图和Mapillary等服务中可用),充分考虑了道路网络之间的空间依赖关系。以武汉市为例,使用OpenStreetMap数据构建了一个城市拓扑地图网络,并使用大规模预训练模型计算了在街景尺度上整个场景的语义表示。基于由75,628个街景图像和5,458条街道构建的28,693个映射关系,以街道为节点构建了图网络。

开着奔驰种地的博客 2105

毕业设计-基于计算机视觉的道路交通标志目标检测算法 YOLO python 卷积神经网络 人工智能

毕业设计-基于深度学习的道路交通标志目标检测算法系统的毕业设计。该系统旨在利用深度学习技术,自动化地检测和识别道路交通标志,提高交通安全和智能化交通管理水平。我们采用了预训练的 Faster R-CNN 模型作为基础,通过使用大规模的道路交通标志数据集进行模型训练和优化,实现了高准确性和高效率的目标检测。该系统能够快速准确地识别道路交通标志,并输出其位置和类别信息,为交通管理部门和驾驶员提供准确的道路指引和警示。还探讨了算法的性能评估和改进方法,为道路交通标志目标检测领域的研究人员和工程师提供了有价值的参考

2301_79555157的博客 2934

【技术教程】结合深度学习的街景分析(绿视率篇)

下载 deeplabv3plus_r101-d8_4xb2-40k_cityscapes-512x1024 系列的 py 配置和 pth 权重文件。图为基于 deeplabv3plus_r101-d8_4xb2-40k_cityscapes-512x1024 语义分割结果。在 Encoder 中,对压缩四次的初步有效特征层利用并行的 Atrous Convolution,分别用不。务可以提供完整的街景请求 URL 地址,并提供街景中所需要设置的完整的参数,包括位置,𝑅𝐺为每张图片的绿视率。

LFSJXS的博客 3253

Python语义分割与街景识别(3):Cityscapes数据集准备

本文主要用于记录我在使用python做图像识别语义分割训练集的过程,由于在这一过程中踩坑排除BUG过多,因此也希望想做这部分内容的同学们可以少走些弯路。本文是python语义分割与街景识别第三篇,关于数据集准备的内容。

qq_41904236的博客 3354

真*零基础入门CV--街景字符识别(阿里天池学习赛)

最新玩了一下阿里天池学习赛(当调参侠),觉得街景字符识别这个比赛还是对新手相对友好的,感兴趣的可以去参加。 传送门:https://link.zhihu.com/?target=https%3A//tianchi.aliyun.com/competition/entrance/531795/introduction 下面大概记录一下我大概的操作以及心得: 简介 首先看它们的数据组成以及特点,链接比赛里面的论坛的Task1-5是对这个比赛大致的讲解,大家可以先去看看。总的来说,train是3W张,val是1W

weixin_47349091的博客 1672

【阿里云天池】实战:街景符号识别(baseline优化方式之数据增强)

测试集,训练集和验证集他们虽然都是街景图片,但是由于照片角度的问题,这三个集的照片所处的“环境”不太一样,这就导致,我们训练出的数据,可能在验证集和测试集上不能达到更好地效果。正确率这次来到了0.747,感觉还可以,就是有点玩花招的感觉了,当然了这也可以算是数据处理的一部分,不过第一时间很难看出来了。具体的做法就是,在读取数据的时候,对数据进行预处理时,对不同的集,采用不同的图片大小预处理方法。具体的来说,测试集和验证集的图片距离更远,也就是更加不好识别,测试集的图片反而更好识别一些。

daweq的博客 661

街景字符识别

赛事介绍 比赛连接:https://tianchi.aliyun.com/competition/entrance/531795/introduction 一、赛题数据 赛题来源自Google街景图像中的门牌号数据集(The Street View House Numbers Dataset, SVHN),该数据来自真实场景的门牌号。训练集数据包括3W张照片,验证集数据包括1W张照片,每张照片包括颜色图像和对应的编码类别和具体位置;为了保证比赛的公平性,测试集A包括4W张照片,测试集B包括4W张照片。所有的

土豆 833
上一篇: 算法类毕业设计选题题目汇总117例:毕设课题创新
下一篇: 毕业设计:基于Python的济南市天气数据的爬取与可视化的实现
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值