


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于计算机视觉的校园危险行为检测系统
项目背景
校园安全是社会关注的重点之一,尤其是在当前社会治安环境复杂的背景下,校园内的危险行为(如刀、枪等武器的持有和使用)对学生的生命安全构成了严峻威胁。近年来,校园暴力事件频发,导致了严重的人员伤亡和心理创伤,因此,建立有效的校园安全监控和危险行为检测机制显得尤为重要。传统的校园安全管理主要依靠人工巡查和监控,存在反应慢、覆盖面小等不足,难以有效预防和应对突发事件。随着计算机视觉、深度学习和图像处理技术的快速发展,基于智能监控系统的校园危险行为检测成为可能。通过实时监控和智能分析,这些系统能够快速、准确地识别出校园内的危险行为,及时发出警报,从而保障学生的安全。
数据集
制作校园内危险行为(如刀、枪等武器的持有和使用)数据集的步骤如下:首先,团队需要在校园的关键位置(如出入口、操场和走廊)安装高分辨率摄像头,并在核心计算单元上部署视频采集软件,以录制校园内的实时监控视频。这些视频记录了学生的日常活动和行为,为后续的数据集构建提供了基础。在视频采集过程中,确保摄像头覆盖的区域能够捕捉到可能出现的危险行为,形成多样化的场景数据。利用视频处理工具,对录制的视频进行剪辑,删除无效或模糊的视频段落,确保保留的内容是清晰且与危险行为相关的。使用Python编写的多线程程序将有效的视频段落转换为静态图像数据,为模型训练做好准备。

使用图像标注工具(如LabelImg或VGG Image Annotator)对保留下来的图像进行标注。研究人员需要对图像中的危险物品(如刀、枪等)进行框选,并生成相应的标签文件,标签内容包括“刀”、“枪”、“正常行为”等类别。采用YOLO的标注格式进行标注,以确保数据集的标注格式与后续模型训练的兼容性。每张图片会对应一个txt文件,其中包含了相应的标注信息。这一流程不仅确保了数据集的准确性和一致性,也为模型训练提供了可靠的数据基础,为校园安全管理的智能化贡献力量。

设计思路
YOLOv5算法与前几代相比,采用了自适应锚框计算和CSPNet结构,从而实现了更丰富的梯度组合,能够更好地适应在校园内实时检测异常行为及可疑物品。YOLOv5网络结构包括四种类型:YOLOv5s、YOLOv5m、YOLOv5l和YOLOv5x。其中,YOLOv5s是最小的网络,其余三个网络在此基础上不断深化和拓宽,这将导致准确性不断提高,但速度可能会有所下降。因此,本研究的校园安全分析系统在对校园内异常物品的检测中,选择了YOLOv5s算法。该系统旨在使用视频数据以直观的形式展示预测结果。

在算法设计的基础上,输入图像在被馈送到骨干层之前通过随机缩放、掩蔽和裁剪等方式进行数据增强,这些方法增加了样本数据的复杂性。引入修正器来优化地面实况边界(GT)的宽度和高度预测,并提高帧边界的准确性。主干部分采用焦点结构和跨阶段部分(CSP)网络结构,焦点层将宽高平面中的信息转换为通道维度,并通过3×3卷积提取不同特征。通过这种方法,能够最小化在下采样过程中信息的损失。颈部层在处理和选择从前一步主干层提取的重要特征方面起着至关重要的作用,这促进了后续阶段的基本任务,包括分类、回归和关键点识别。

输入层采用了三种数据增强方法:镶嵌、剪切以及矩形训练。镶嵌方法通过随机缩放将四张训练图像融合为一张,以提升对小目标的检测性能。剪切方法随机选择固定大小的正方形区域,并对数据进行中心归一化处理,以最小化填充并减少冗余信息。矩形训练方法则调整图像大小,使其能被步长整除且最接近输入大小,从而进一步减少填充并优化模型训练效率。这些训练方法的选择不仅关注了提高检测性能,还考虑了模型训练的效率和资源利用率。
运用YOLOv5算法针对数据集进行大型箱体目标检测算法训练,并通过训练模型对实际获取的校园内异常物体视频进行检测识别,得到实时的大型箱体标识、位置信息和时间信息。针对校园内的特殊环境,为了更适应固定摄像头的情况,在预警算法中采用YOLOv5算法框架来检测校园内的可疑物品。首先,引入新的激活函数高斯误差线性单元(GELU),解决了原先sigmoid函数的梯度消失问题,帮助神经网络在权重和偏置变化的过程中朝正确的方向调整,从而改善模型性能。

数据集的准备,包括数据的收集、预处理和标注。通过固定摄像头采集校园内的异常行为视频,并将其转换为图像帧。接着,使用标注工具(如LabelImg)对图像中的危险物品进行手动标注,生成相应的标签文件。标注信息应包括物体类别与位置(边界框),以便后续训练使用。为了提高模型对各种场景的适应能力,应用数据增强技术。包括随机缩放、旋转、剪裁和颜色调整等。数据增强能够有效扩展训练集,提高模型的泛化能力,减少过拟合的风险。
# 示例:使用Albumentations进行数据增强
import albumentations as A

transform = A.Compose([
    A.RandomResizedCrop(height=640, width=640, scale=(0.8, 1.0)),
    A.HorizontalFlip(),
    A.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.1),
])

# 应用增强到一张图片
augmented_image = transform(image=image)['image']
选择YOLOv5作为基础模型,并根据校园环境的特点对网络结构进行配置。引入高斯误差线性单元(GELU)激活函数,解决sigmoid函数的梯度消失问题,提升模型性能。配置文件中需要设置训练参数,如学习率、批大小、迭代次数等。在Pytorch框架下,使用准备好的数据集训练YOLOv5模型。通过设置适当的学习率和批大小,启动训练过程。可以使用TensorBoard等工具监控训练进程,观察损失函数和精度的变化。
# 示例:配置YOLOv5模型的超参数
# 修改yolov5/models/yolov5s.yaml中的激活函数为GELU
activation: 'GELU'
训练完成后,使用未见过的测试数据对模型进行评估。计算精确率、召回率和平均精度均值(mAP)等指标,以评估模型的性能。通过这些指标,验证模型在校园内异常物体检测中的有效性。训练好的模型可以用于实时检测。通过摄像头采集校园内的视频流,将视频帧输入到YOLOv5模型中进行目标识别,返回目标的位置、类别以及时间信息。将检测结果以可视化的形式展示,便于监控和预警。
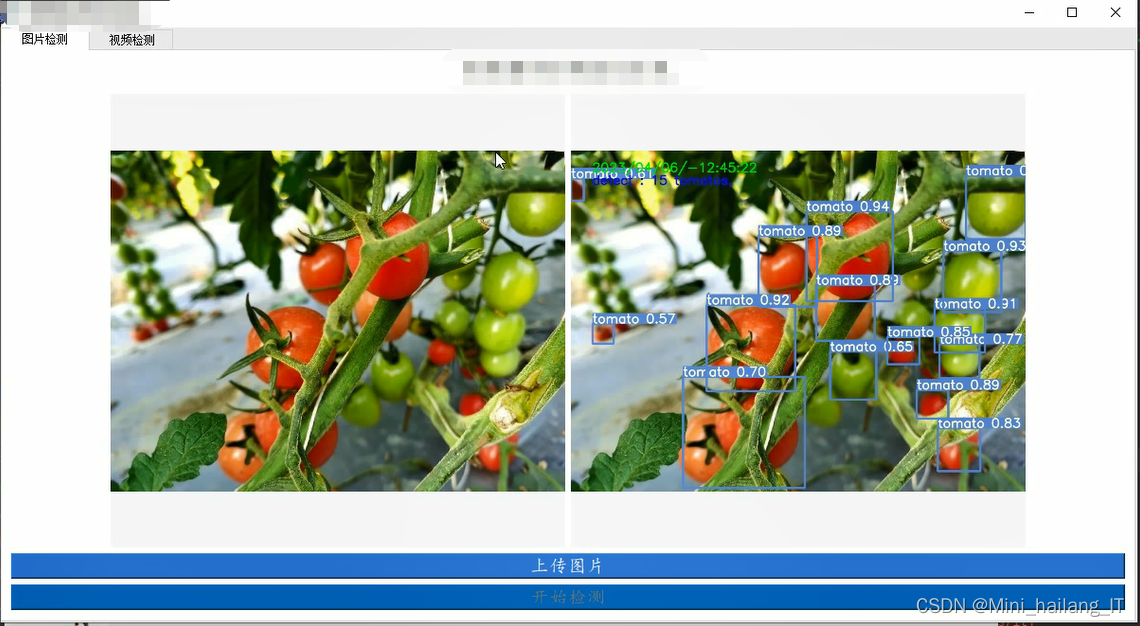
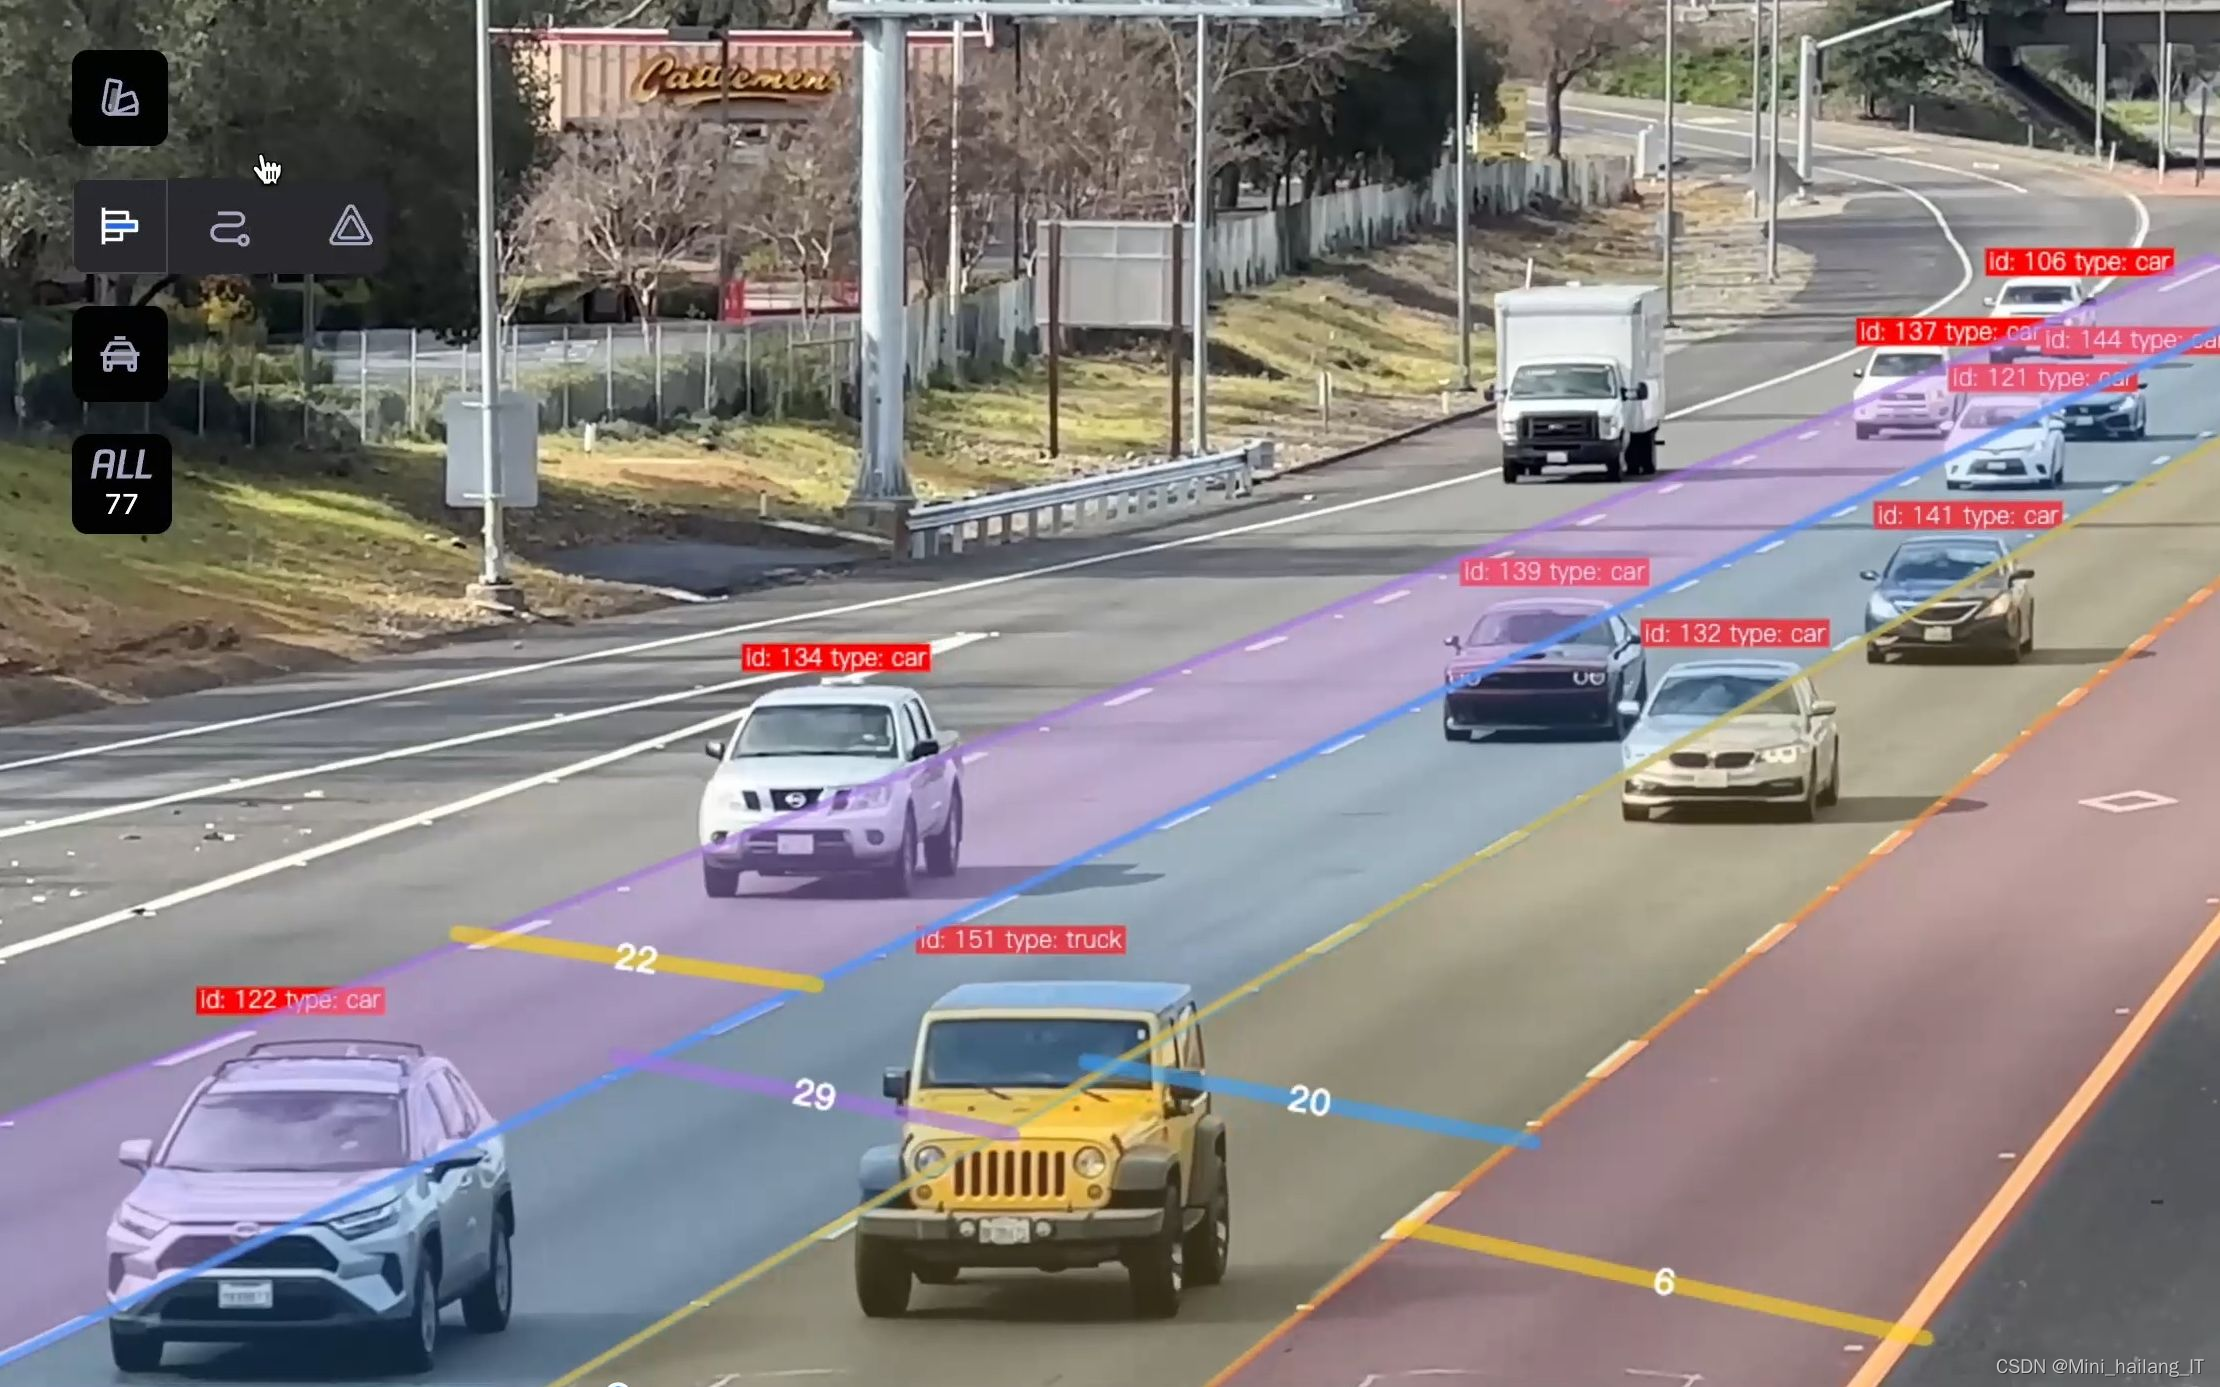
海浪学长项目示例:


 3456


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


